Comment valider des données ? Guide pour les pipelines modernes
|
8
minute de lecture

Si vous vous posez cette question, c’est probablement que quelque chose a déjà cassé. Un chiffre de tableau de bord a bondi pendant la nuit, un modèle a commencé à produire des résultats étranges, ou un rapprochement a échoué et plus personne ne fait confiance au pipeline tant que quelqu’un n’a pas fouillé les logs. C’est tout le contexte de la question comment valider des données. Elle n’a rien d’académique. Elle est opérationnelle.
Une bonne validation ne consiste pas à ajouter quelques contrôles de valeurs nulles et à considérer le travail comme terminé. Elle consiste à décider ce qui doit être vrai au niveau de chaque enregistrement, ce qui doit rester stable tout au long du pipeline, ce qui peut dériver sans danger et ce qui doit arrêter immédiatement la chaîne. Dans les architectures modernes, cela implique aussi de se prémunir contre des problèmes que les guides de base ignorent, en particulier la dérive silencieuse des schémas et le coût d’une application excessive de règles sans importance pour le métier.
Table des matières
Pourquoi la validation des données ne se résume pas à cocher des cases
Mettre en œuvre la validation au niveau des enregistrements et du pipeline
Pourquoi la validation des données ne se résume pas à cocher des cases
Un tableau de bord du chiffre d’affaires échoue rarement parce qu’un ingénieur a oublié un contrôle. Il échoue parce que les équipes traitent la validation comme une étape de nettoyage ponctuelle plutôt que comme une composante de la conception du pipeline. Le temps que quelqu’un remarque que les chiffres sont faux, les données erronées ont déjà traversé les transformations, les jointures, les modèles BI et les rapports en aval.
C’est pourquoi la validation des données doit intervenir à plusieurs points de contrôle, et pas seulement sur le résultat final. L’approche la plus solide privilégie la prévention. Les règles de validation doivent détecter les problèmes là où les données entrent dans le système, puis à nouveau après les étapes de transformation, où la logique peut introduire de nouvelles erreurs. La présentation de la validation des pipelines par Great Expectations l’explique clairement en insistant sur la validation à l’ingestion et après chaque transformation, ainsi que sur une documentation reproductible à des fins d’audit.
La confiance est le véritable résultat
Les organisations disent vouloir des données propres. Ce qu’elles veulent vraiment, ce sont des décisions fiables. Si la finance doit remettre en question chaque rapport, si les analystes doivent inspecter manuellement chaque actualisation ou si les ingénieurs ML ne font pas confiance aux données d’entraînement, la plateforme fonctionne techniquement mais échoue sur le plan opérationnel.
La validation protège la confiance de plusieurs manières concrètes :
Elle bloque les entrées erronées connues : les champs obligatoires, les formats valides et les règles métier arrêtent tôt les défauts évidents.
Elle réduit le périmètre des incidents : lorsque des contrôles s’exécutent à chaque point sensible, les équipes savent où le problème est apparu.
Elle rend les échecs exploitables : une règle en échec est plus utile qu’une vague plainte du type « le tableau de bord a l’air faux ».
Elle soutient la conformité : une validation reproductible et des métadonnées publiées offrent aux équipes un processus auditable.
Règle pratique : ne validez pas les données uniquement sur la base de ce que vous avez déjà observé. Validez-les par rapport à ce que le métier considère comme devant être vrai.
Le nettoyage réactif arrive trop tard
De nombreuses équipes s’appuient encore sur un nettoyage en aval. Cela paraît pragmatique jusqu’à ce qu’un champ défectueux ait déjà été agrégé dans des rapports ou transmis à des systèmes en contact avec les clients. Nettoyer après coup est plus lent, plus coûteux et plus difficile à auditer.
Un meilleur modèle opérationnel ressemble à ceci :
Définir les attentes métier avant d’écrire le code.
Les appliquer dès l’ingestion.
Les revérifier après chaque transformation significative.
Journaliser les résultats pour que les échecs soient traçables et reproductibles.
La validation n’est pas de la bureaucratie. C’est le contrôle d’ingénierie qui empêche les enregistrements erronés, les données obsolètes et les schémas cassés de se transformer en décisions métier.
Les dimensions fondamentales de la validation des données
Un pipeline peut réussir tous les contrôles de base et malgré tout nuire à la confiance. La défaillance typique n’est pas une valeur nulle dans un champ obligatoire. Ce sont des données qui semblent acceptables, traversent toute l’architecture et cessent de refléter la réalité métier, sans que personne ne le détecte, après un changement de source, un chargement retardé ou un nouveau chemin de code en amont.
C’est pourquoi la validation a besoin de plus de structure qu’un simple point de contrôle réussite/échec. Les équipes doivent pouvoir décider ce qui doit être imposé, ce qui doit être surveillé et ce qui peut être toléré brièvement parce que le coût d’un blocage dépasse celui d’une revue. Six dimensions de qualité constituent un bon point de départ. Elles donnent aux équipes un vocabulaire commun pour déterminer où se situe le risque et quel degré de rigueur appliquer à chaque contrôle.
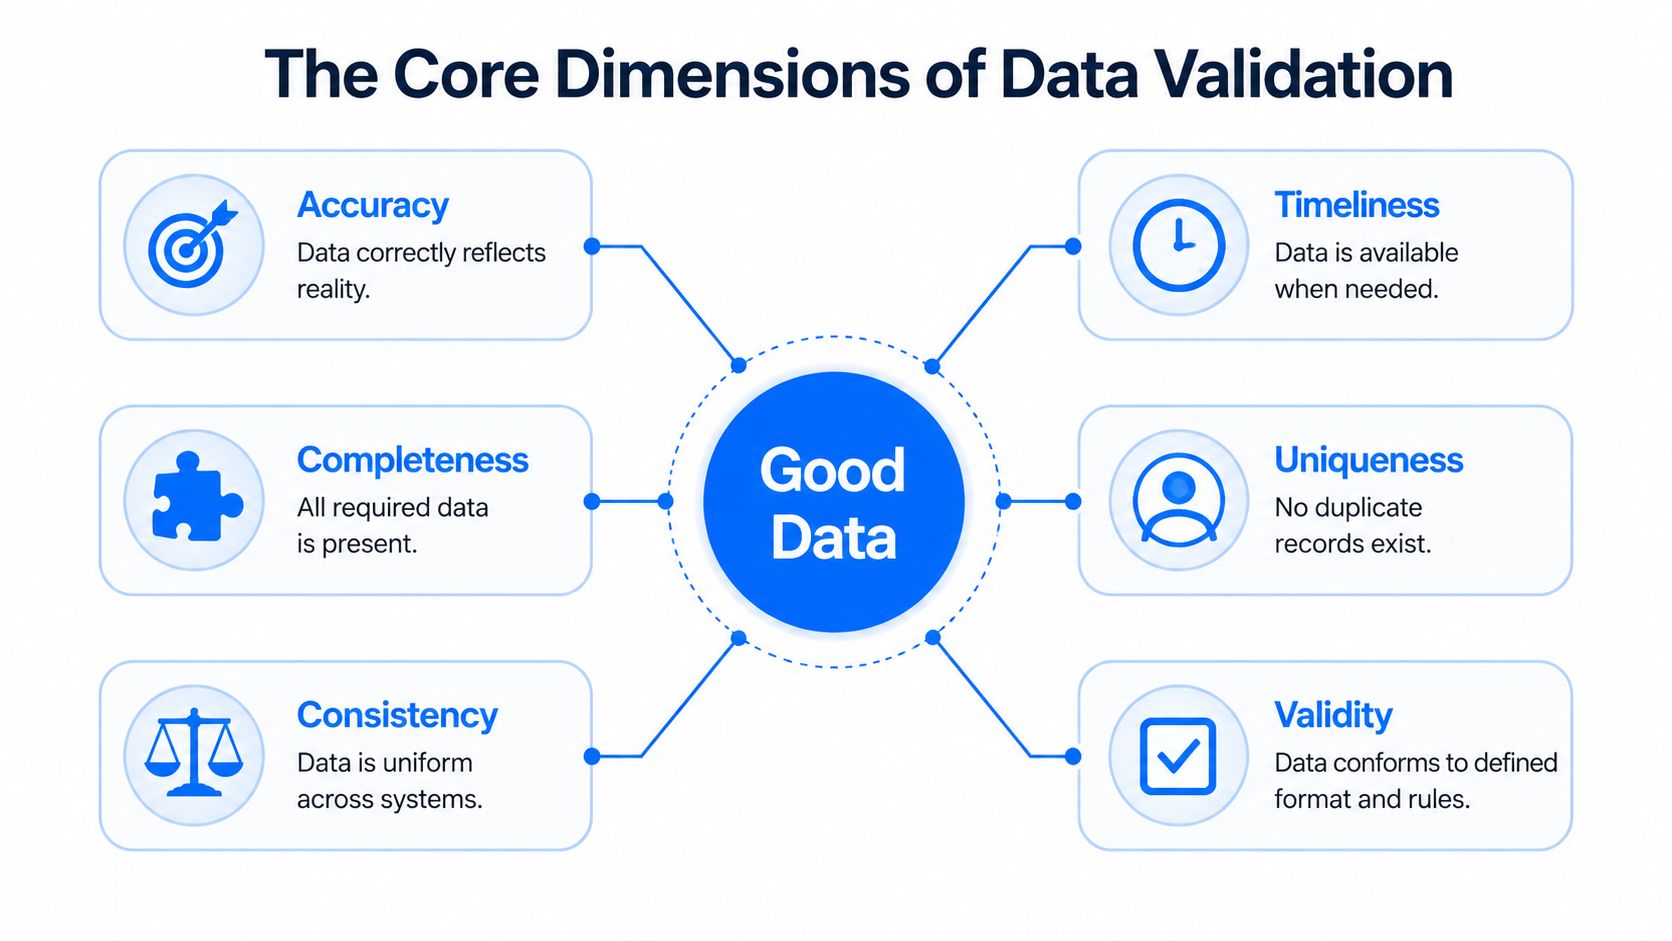
Des données de qualité ont six dimensions
Ces dimensions vous semblent familières, et pour cause. L’erreur consiste à les traiter comme une liste de contrôle plutôt que comme des catégories de défaillance distinctes, avec des coûts métier différents.
Dimension | Signification en pratique | Impact typique en cas d’échec |
|---|---|---|
Exactitude | La valeur reflète l’événement ou l’entité du monde réel | Prix erronés, soldes erronés, statut client erroné |
Complétude | Les données obligatoires sont présentes là où le processus en dépend | Jointures cassées, rapports inutilisables, features de modèle manquantes |
Cohérence | Un même concept est représenté de la même manière dans tous les systèmes | Problèmes de rapprochement, logique dupliquée, litiges sur les rapports |
Ponctualité | Les données arrivent dans le délai attendu par le métier | Tableaux de bord obsolètes, opérations retardées, SLA non respectés |
Unicité | Un enregistrement ou une entité n’apparaît qu’une seule fois lorsque c’est attendu | Clients en double, facturations en double, comptages gonflés |
Validité | Les valeurs respectent les formats, domaines et règles autorisés | Erreurs d’analyse, événements rejetés, transactions invalides |
La ponctualité mérite plus d’attention qu’elle n’en reçoit habituellement. J’ai vu des équipes approuver un jeu de données parce que chaque champ passait les contrôles de type et de plage, alors que les opérations travaillaient sur les données de la veille. La table était valide. La décision était pourtant erronée.
Il en va de même pour l’unicité et la cohérence. Une transaction en double peut coûter plus cher qu’un champ facultatif manquant. Un code de statut qui signifie une chose dans le système source et autre chose dans l’entrepôt de données peut passer la validation du schéma tout en cassant le reporting financier. La validation fonctionne mieux lorsque la sévérité suit l’impact métier, et non l’élégance technique.
Chaque type de validation détecte une catégorie de risque différente
Chaque dimension nécessite un type de contrôle différent. Si les équipes ne valident que la structure, elles passent à côté du sens. Si elles ne surveillent que les distributions, elles passent à côté des violations de règles strictes. Une bonne couverture résulte de la combinaison de plusieurs types de contrôles, chacun associé à un mode d’application.
Utilisez cette correspondance :
La validation du schéma contrôle la structure : présence des colonnes, type de données, possibilité de valeurs nulles et changements de contrat.
La validation syntaxique contrôle le format : dates, codes de devise, identifiants, booléens et motifs de texte normalisés.
La validation sémantique contrôle le sens métier : date de fin postérieure à la date de début, transitions de statut conformes au processus, prix conformes aux règles produit.
La validation relationnelle contrôle l’intégrité entre tables : clés étrangères, enregistrements orphelins et complétude parent-enfant.
La validation statistique contrôle la dérive comportementale : variations de volume, évolution du taux de valeurs nulles, changements de cardinalité et anomalies de distribution.
La dérive silencieuse des schémas se situe entre ces catégories et provoque certains des incidents les plus difficiles à diagnostiquer. Une équipe source peut élargir un champ, réaffecter une énumération, modifier la gestion des fuseaux horaires ou commencer à envoyer une nouvelle colonne facultative que le code en aval ignore. Rien ne plante. Les chiffres cessent simplement de concorder. Dans ces situations, les contrôles de contrat automatisés et les moniteurs fondés sur des profils prouvent toute leur utilité. Les équipes qui évaluent des outils gratuits de validation des données pour les contrôles de schéma et la surveillance de la dérive doivent rechercher à la fois l’application de règles strictes et des alertes fondées sur les tendances, car l’un sans l’autre laisse des angles morts.
Un champ peut être valide du point de vue de son type tout en étant invalide pour la décision qu’il alimente.
C’est la lacune que les guides de base négligent souvent.
Une démarche pratique de conception des règles commence en langage clair. Définissez ce qui doit être vrai, qui en dépend, ce qui se passe en cas d’échec et si le pipeline doit bloquer, mettre en quarantaine, avertir ou journaliser l’événement pour examen. La présentation par IBM des principales dimensions de la qualité des données est utile ici, car elle définit la qualité comme l’adéquation à l’usage, ce qui correspond exactement à la manière dont la validation doit être priorisée dans les systèmes de production.
Le dernier choix de conception est économique. Bloquer chaque anomalie semble rigoureux, mais cela peut interrompre les opérations génératrices de revenus, retarder les consommateurs en aval et submerger les équipes d’alertes de faible valeur. Tout laisser passer est pire encore. Les programmes de validation solides distinguent les défaillances à haut risque des variations tolérables, imposent automatiquement les premières et surveillent les secondes avec une responsabilité clairement attribuée. C’est ainsi que la validation améliore la fiabilité sans transformer le pipeline en générateur permanent d’incidents.
Mettre en œuvre la validation au niveau des enregistrements et du pipeline
La validation fonctionne le mieux lorsqu’elle s’applique simultanément à deux niveaux. D’abord, examinez chaque enregistrement pour détecter les violations de règles. Ensuite, examinez le pipeline en tant que système pour repérer les pertes, les incohérences et les ruptures structurelles. Si vous ne faites que l’un des deux, des lacunes subsistent.
Commencer par des règles au niveau des lignes
Au niveau des enregistrements, la base est simple. Les bonnes pratiques du secteur imposent une validation au niveau des lignes appliquant huit règles précises (champs obligatoires, contrôle de type, validation de format, contraintes de plage, unicité, intégrité référentielle, logique métier et validation entre champs) à chaque enregistrement, associée à une journalisation d’audit qui suit le nombre de réussites et d’échecs par exécution à des fins de conformité et de débogage, comme le décrit le guide de la validation des données de Flatfile.
Un modèle SQL pratique ressemble à ceci :
Ce n’est pas spectaculaire, mais c’est efficace. L’objectif est de rendre chaque échec explicite et classable.
Vous aurez généralement besoin d’une combinaison de contrôles :
Champs obligatoires : bloquez les valeurs nulles dans les clés, les dates et les attributs critiques pour l’exploitation.
Contrôles de type et de format : imposez que les dates soient des dates, que les booléens soient des booléens et que les codes respectent des formats de référence.
Contraintes de plage : détectez les valeurs impossibles ou dangereuses avant qu’elles ne faussent la logique en aval.
Règles entre champs : validez des relations telles que les dates de début et de fin, les signes des débits et des crédits ou les combinaisons de pays et de format de code postal.
Valider ensuite le pipeline en tant que système
Les contrôles de lignes ne détectent pas tout. Un pipeline peut satisfaire les règles au niveau des enregistrements et être malgré tout cassé si la moitié des données n’est jamais arrivée, si une jointure a démultiplié des lignes en double ou si les comptages de la source et de la cible ne concordent plus.
C’est là que les contrôles au niveau du pipeline prennent toute leur importance :
Comparaison du nombre de lignes : comparez les comptages de la source et de la cible après les chargements et les transformations.
Surveillance des doublons : vérifiez que les clés censées être uniques le restent après les jointures ou les unions.
Intégrité référentielle : confirmez que les valeurs de clés étrangères existent dans les tables référencées.
Contrôles de cohérence des agrégats : comparez les totaux, les distributions et les profils de valeurs nulles entre les étapes.
Contrôles de parité lors des migrations : pour les champs critiques lors des migrations, validez chaque ligne lorsque le métier ne peut tolérer aucune perte silencieuse.
Les recommandations de digna sur la validation lors des migrations sont particulièrement utiles ici. Elles indiquent que pour les champs critiques lors des migrations de données, une validation à 100 % au niveau des lignes est nécessaire pour confirmer que le nombre d’enregistrements correspond entre la source et la cible, tout en vérifiant qu’aucun doublon n’a été créé, qu’aucun enregistrement n’a disparu sans être remarqué et qu’aucun enregistrement partiel n’existe, tandis que les grands jeux de données peuvent recourir à un échantillonnage statistiquement significatif combiné à la détection d’anomalies lorsqu’un contrôle manuel exhaustif n’est pas réaliste.
Garder les contrôles lourds dans l’entrepôt de données
La validation de grandes tables échoue souvent parce que les équipes extraient trop de données de l’entrepôt pour les inspecter dans le code applicatif. C’est lent, coûteux et difficile à faire évoluer. Confiez autant que possible le travail lourd à la base de données.
La validation dans la base de données est mieux adaptée pour :
les contrôles d’unicité sur des clés métier composées
l’intégrité référentielle entre jeux de données
les contrôles de seuils et de plages sur de grandes tables
les comparaisons de profils sur les taux de valeurs nulles ou les distributions de catégories
Si vous souhaitez un point de départ léger avant de construire votre propre cadre, ces outils gratuits de validation des données proposés par digna méritent d’être examinés aux côtés d’options comme les tests dbt, Great Expectations et les contrôles SQL natifs de l’entrepôt.
L’entrepôt de données est déjà optimisé pour parcourir, comparer, agréger et joindre. Laissez-le valider sur place au lieu d’exporter le problème ailleurs.
Automatiser la validation et gérer les échecs
Les contrôles ponctuels manuels conviennent au débogage. Ils ne constituent pas un modèle opérationnel. Si la validation ne s’exécute pas automatiquement chaque fois que les données changent, votre équipe compte sur la chance et la curiosité.
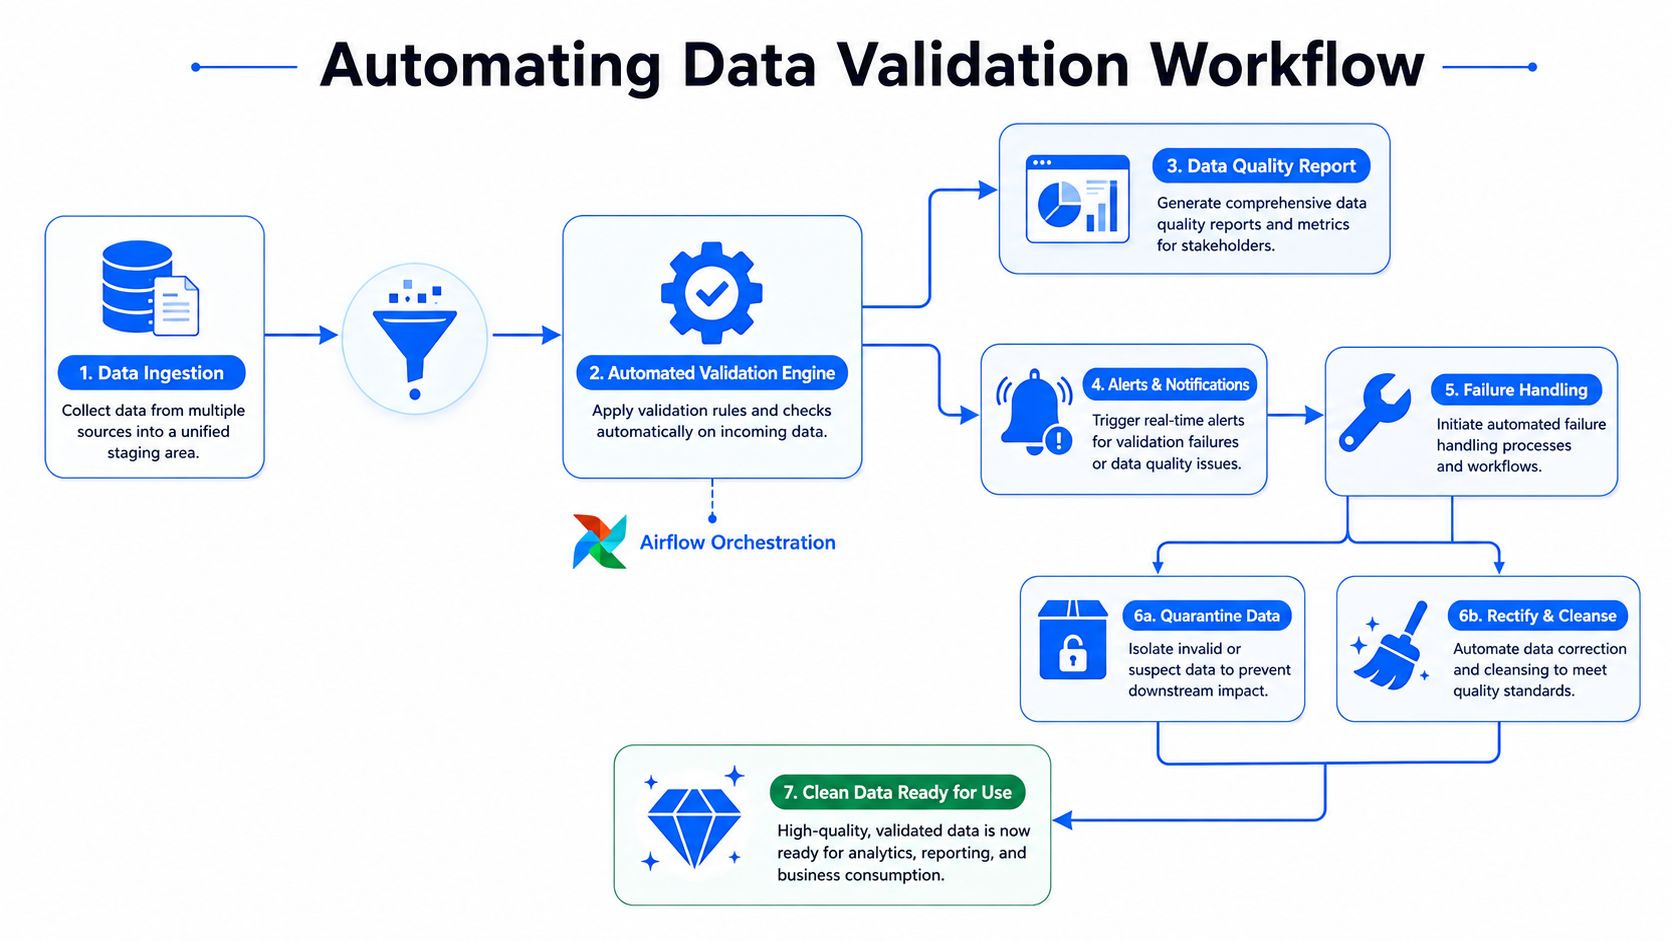
Automatiser les contrôles là où les données changent
Le modèle d’automatisation le plus propre est piloté par les événements ou par l’orchestration. Exécutez des contrôles après l’ingestion, après les transformations majeures et avant de publier les données vers les couches de restitution. Airflow, dbt et les tâches de l’entrepôt prennent tous en charge ce modèle.
Une séquence durable ressemble à ceci :
Ingérer les données et valider immédiatement le schéma.
Exécuter les règles au niveau des enregistrements sur les tables d’atterrissage.
Exécuter les contrôles d’agrégats et de parité après les transformations.
Écrire les résultats de réussite et d’échec dans une table d’audit.
Déclencher l’action appropriée en cas d’échec.
Observabilité et validation commencent à converger. La validation vous indique si une règle a été respectée. L’observabilité vous aide à comprendre les évolutions de tendance, les retards de livraison et si le même échec se répète d’une exécution à l’autre. Pour une bonne introduction, consultez cette présentation des concepts d’observabilité des données et de conception des processus.
Une courte démonstration peut aider à concrétiser le modèle d’orchestration :
Choisir les actions en cas d’échec selon le risque métier
Tous les contrôles en échec ne méritent pas la même réponse. C’est à ce stade que les équipes ont souvent tendance à surréagir ou à sous-réagir.
Un modèle de décision utile consiste à classer les échecs en trois catégories :
Type d’échec | Exemple | Meilleure action |
|---|---|---|
Arrêt immédiat | Clé primaire manquante, période financière invalide, rupture référentielle dans une table de faits critique | Arrêter le pipeline |
Quarantaine | Un sous-ensemble de lignes enfreint le format ou la logique métier | Rediriger les enregistrements erronés pour examen |
Avertir et continuer | Légère dérive dans un champ descriptif non critique | Alerter et surveiller |
L’arbitrage est économique, et pas seulement technique. Les données du secteur montrent que les problèmes de qualité des données provoquent 20 à 30 % de pertes de revenus dans la finance et la santé, alors qu’il n’existe aucun cadre standard pour calculer le point de bascule à partir duquel l’effort de validation dépasse la réduction marginale du risque, selon l’analyse de Twilio sur les techniques de validation et leur impact métier. Cette lacune compte. Les équipes doivent décider où une application stricte se rentabilise et où elle crée des frictions sans réduire sensiblement le risque.
Si votre architecture alimente aussi des systèmes génératifs, la qualité des données et la surveillance des modèles commencent à se recouper. Lorsque vous évaluez les contrôles en aval, il est utile de trouver la bonne plateforme de surveillance des LLM afin de comprendre comment la fiabilité des entrées, le comportement des prompts et la surveillance en production s’articulent.
Éviter la fatigue des alertes
Trop d’équipes inondent Slack et les e-mails d’alertes de faible valeur, jusqu’à ce que plus personne ne les lise. Une bonne automatisation produit des signaux, pas du bruit.
Quelques habitudes fonctionnent bien :
Acheminer selon la sévérité : les appels d’astreinte doivent rester rares. La plupart des problèmes ont leur place dans des tableaux de bord ou des files de tickets.
Regrouper les échecs liés : si dix tables échouent parce qu’un seul schéma en amont a changé, envoyez un seul incident.
Inclure le contexte : chaque alerte doit indiquer ce qui a échoué, où, quand et ce que le système a fait ensuite.
Analyser régulièrement les tendances : le guide des bonnes pratiques de validation de Cube décrit un rythme utile en entreprise, où les équipes analysent les schémas d’erreurs chaque trimestre et mettent à jour les règles chaque année, plutôt que de laisser en place des seuils obsolètes.
Les alertes doivent indiquer à un ingénieur ce qui s’est passé et ce qu’il doit faire ensuite. Si elles se contentent d’annoncer « échec de la validation », le travail n’est pas terminé.
Stratégies avancées à l’échelle de l’entreprise
À l’échelle de l’entreprise, les règles statiques restent importantes, mais elles ne suffisent plus. Vous avez besoin de contrôles pour des changements que personne n’a explicitement prévus dans le code, surtout lorsque les outils BI, les services ETL et les applications sources ne cessent d’évoluer en arrière-plan.
La dérive silencieuse des schémas, le problème d’entreprise que les guides de base ignorent
Beaucoup de défaillances ne proviennent pas d’une valeur nulle ou hors plage. Elles proviennent d’un changement structurel subtil. Une colonne est renommée, un type passe d’entier à chaîne de caractères, ou un outil en amont ajuste automatiquement un schéma de façon à ce que l’ingestion continue de fonctionner tout en cassant la logique en aval.
C’est pourquoi le suivi des schémas doit être considéré comme de la validation, et pas seulement comme de l’hygiène des métadonnées. Le risque est plus important que ne le pensent beaucoup d’équipes. Des rapports sectoriels récents de 2025-2026 indiquent que 65 % des défaillances de pipelines de ML proviennent de changements de schéma non détectés plutôt que d’erreurs dans les valeurs des données, alors que les protocoles de validation standard incluent rarement le suivi des versions de schéma, comme le cite cette discussion sur la dérive des schémas et les défaillances de pipelines.
Une pratique mature de validation des schémas comprend :
Le suivi des versions : enregistrer les changements structurels au fil du temps.
Les contrôles de compatibilité : déterminer quels changements sont rétrocompatibles et lesquels doivent bloquer la publication.
La responsabilité : confier à une équipe l’approbation des changements de schéma.
Les contrôles d’impact en aval : relier les alertes de changement de schéma aux modèles, tableaux de bord ou API concernés.
Ajouter la détection d’anomalies et le suivi de la ponctualité
Les règles codées en dur ne détectent que ce que vous savez déjà chercher. Les systèmes d’entreprise ont besoin d’une couche supplémentaire capable de détecter les changements inattendus dans les distributions, les profils de valeurs nulles, la répartition des catégories et les délais de livraison.
C’est un domaine où le support d’une plateforme est utile. Des outils comme les tests dbt et Great Expectations gèrent bien la validation à base de règles. Pour la surveillance dans la base de données des anomalies, de la ponctualité, des règles au niveau des enregistrements et des changements de schéma, une option est digna, qui exécute les analyses dans l’environnement du client et fait ressortir les tendances, les retards et les changements structurels sans exporter les données de production.
La ponctualité mérite le même traitement que les contrôles de contenu. Des données en retard peuvent invalider des tableaux de bord alors même que chaque ligne respecte les règles de type et de format. Surveillez les fenêtres d’arrivée attendues et signalez les chargements retardés avant que les parties prenantes ne découvrent elles-mêmes des rapports obsolètes.
Les équipes qui conçoivent des processus de support fondés sur l’IA rencontrent un problème similaire au niveau applicatif. Des données peuvent être structurellement valides et conduire malgré tout à des résultats peu fiables si les entrées et les instructions ne sont pas maîtrisées. C’est pourquoi les conseils sur la conception de prompts pour une IA de support fiable sont utiles en complément de la validation des données. Ils traitent une autre facette de la même discipline : définir les entrées acceptables et réduire les modes de défaillance silencieux.
La gouvernance empêche les règles de se dégrader
Les règles de validation vieillissent mal lorsque personne n’en est responsable. Une équipe les écrit, une autre modifie le processus source, et six mois plus tard, les contrôles sont soit bruyants, soit sans pertinence.
Un modèle durable comprend :
Des définitions de règles en langage clair : les parties prenantes métier doivent pouvoir les relire sans lire de SQL.
Des responsables désignés : un propriétaire des données, un data steward ou une équipe de gouvernance doit maintenir chaque règle.
Une journalisation d’audit : conservez les comptages de réussites et d’échecs ainsi que les métadonnées d’exécution.
Une revue planifiée : réexaminez régulièrement les seuils, les hypothèses et les exceptions.
C’est cette couche de gouvernance qui transforme la validation, d’une collection de scripts, en un véritable système de contrôle opérationnel.
Un cadre pragmatique pour la validation des données
Un programme de validation pragmatique part du risque, et non de la couverture. Les équipes se mettent en difficulté lorsqu’elles écrivent des dizaines de contrôles pour des données à faible impact, puis passent à côté des quelques modes de défaillance capables de corrompre le reporting du chiffre d’affaires, de casser des processus clients ou d’injecter de mauvaises features dans les modèles. Un meilleur cadre pose d’abord deux questions : qu’est-ce qui peut échouer sans être détecté, et quel en serait le coût pour le métier ?

Un modèle opérationnel pour les équipes qui ont besoin de résultats
Commencez par les actifs de données qui présentent le risque opérationnel ou réglementaire le plus élevé. En pratique, il s’agit généralement des indicateurs financiers, des identifiants clients, des champs de conformité et des entrées des modèles. Définissez un petit ensemble de règles pour chacun, puis associez chaque règle à une action. Si un contrôle échoue, décidez si le pipeline doit s’arrêter, mettre en quarantaine les données concernées ou continuer avec une alerte.
Adoptez un modèle d’application mixte, car tous les défauts ne doivent pas être traités de la même manière :
Appliquer des règles strictes aux invariants : clés primaires, champs obligatoires, intégrité référentielle et formats fixes.
Utiliser la détection d’anomalies pour les changements difficiles à énumérer à l’avance : variations de distribution, pics de valeurs nulles, variations de volume et arrivées tardives.
Suivre explicitement la dérive des schémas : les changements silencieux de colonnes et de types cassent souvent la logique en aval avant que quiconque ne s’en aperçoive.
Attribuer un responsable à chaque règle : quelqu’un doit analyser le bruit, approuver les exceptions et retirer les contrôles obsolètes.
De nombreux guides de base sont insuffisants sur ce point. Ils traitent la validation comme un simple point de contrôle réussite/échec. Les systèmes de production ont plutôt besoin d’un modèle fondé sur le risque. Une clé primaire manquante dans une table financière justifie un arrêt immédiat. Une légère variation d’un attribut peu prioritaire peut ne nécessiter qu’un avertissement et un ticket. L’objectif n’est pas une application maximale. L’objectif est d’obtenir des données fiables à un coût que l’équipe peut assumer durablement.
Par quoi commencer cette semaine
Commencez par un pipeline contesté. Choisissez celui que l’on remet déjà en question en réunion, car il a déjà un impact métier visible et une boucle de retour naturelle.
Faites ensuite cinq choses :
Nommez les cinq conditions métier qui doivent être respectées.
Associez chaque condition à un contrôle technique au niveau des enregistrements ou du pipeline.
Classez chaque échec selon son impact : arrêt, quarantaine, avertissement ou simple journalisation.
Ajoutez un historique des exécutions pour que l’équipe puisse voir les échecs répétés et la dérive dans le temps.
Analysez les faux positifs après la première semaine et resserrez les règles trop bruyantes.
Cette séquence fonctionne parce qu’elle impose des arbitrages dès le départ. Les équipes apprennent quels contrôles protègent la confiance et lesquels ne font que générer de la fatigue d’alerte. Elle met aussi au jour les modes de défaillance réels avant que quiconque n’investisse dans un vaste catalogue de règles qui sera coûteux à maintenir.
La validation des données fonctionne au mieux comme un véritable système d’exploitation de la fiabilité. Elle combine règles déterministes, détection de dérive, connaissance des schémas, responsabilités et gestion des échecs en un seul processus capable de résister à l’évolution des sources et à la complexité croissante des pipelines.
Si vous recherchez un moyen pratique de combiner validation dans la base de données, détection d’anomalies, surveillance de la ponctualité et suivi des schémas dans un seul processus, découvrez digna. Il est conçu pour les équipes qui doivent valider des enregistrements, détecter la dérive et surveiller la fiabilité des pipelines sans sortir les données de production de leur propre environnement.
Comme la dérive silencieuse des schémas échappe aux règles au niveau des enregistrements, digna Schema Tracker couvre le volet suivi des versions de la validation en détectant les colonnes ajoutées, supprimées ou dont le type a changé, avant que la logique en aval ne casse.
Questions fréquentes
Comment valider des données dans un pipeline ?
Validez à plusieurs points de contrôle plutôt que seulement sur le résultat final. La séquence proposée dans l’article est la suivante : valider le schéma à l’ingestion, exécuter les règles au niveau des enregistrements sur les tables d’atterrissage, exécuter les contrôles d’agrégats et de parité après les transformations, écrire les résultats de réussite et d’échec dans une table d’audit, puis déclencher l’action d’échec correspondant au risque métier.
Quelles sont les six dimensions de la qualité des données ?
Les six dimensions sont l’exactitude, la complétude, la cohérence, la ponctualité, l’unicité et la validité. L’article les traite comme des catégories de défaillance distinctes, avec des coûts métier différents : une transaction en double peut coûter plus cher qu’un champ facultatif manquant, et une table peut réussir tous les contrôles de type alors que les opérations travaillent encore sur les données de la veille.
Quelles règles de validation au niveau des lignes chaque enregistrement doit-il respecter ?
Le guide de Flatfile, cité dans l’article, en énumère huit : champs obligatoires, contrôle de type, validation de format, contraintes de plage, unicité, intégrité référentielle, logique métier et validation entre champs. Associez-les à une journalisation d’audit des réussites et des échecs par exécution. Un simple modèle SQL CASE permet de signaler les identifiants de commande nuls, les montants négatifs ou les dates de commande futures.
Que faire lorsqu’un contrôle de validation des données échoue ?
Adaptez la réponse au risque métier. Un arrêt immédiat interrompt le pipeline pour des problèmes comme une clé primaire manquante ou une période financière invalide. La quarantaine redirige un sous-ensemble de lignes erronées pour examen. L’option « avertir et continuer » convient à une légère dérive dans un champ descriptif non critique, qui fait l’objet d’une alerte et d’une surveillance plutôt que d’un blocage.
Pourquoi la dérive des schémas est-elle un problème de validation des données ?
Les changements structurels échappent souvent aux contrôles de valeurs : une colonne renommée ou un type passé d’entier à chaîne peut laisser l’ingestion fonctionner tout en cassant la logique en aval. Des rapports cités dans l’article attribuent 65 % des défaillances de pipelines de ML à des changements de schéma non détectés ; le suivi des versions, les contrôles de compatibilité et la responsabilité relèvent donc de la validation.


