Visor de archivos Parquet: cómo elegir la herramienta adecuada
|
7
minuto de lectura

Seguramente alguna vez te han pasado un archivo .parquet por Slack, por correo o en un bucket en la nube y necesitabas una respuesta rápida. Qué columnas contiene. Si el esquema coincide con la exportación de ayer. Si el archivo tiene filas reales o es solo otro artefacto de un pipeline roto.
En ese momento uno se da cuenta de que Parquet no es un formato de hoja de cálculo con una extensión más bonita. Es eficiente, compacto y está pensado ante todo para máquinas. Si eliges mal la forma de inspeccionarlo, o pierdes tiempo peleándote con las herramientas o creas un problema de seguridad evitable al mover datos sensibles al entorno equivocado.
Índice
Por qué los archivos Parquet requieren visores especializados
Comparativa de los principales métodos para ver archivos Parquet
Por qué los archivos Parquet requieren visores especializados
Un editor de texto normal no sirve de mucho con un archivo Parquet. No verás filas ni columnas legibles. Verás un blob binario con los fragmentos reconocibles justos para hacerte perder el tiempo.
Es así por diseño. Apache Parquet nació en 2013 como un proyecto conjunto de Twitter y Cloudera, se publicó por primera vez el 1 de julio de 2013 y más tarde se convirtió en un proyecto de nivel superior de Apache. Su formato se construyó en torno al almacenamiento columnar, los row groups y los metadatos basados en Thrift, que es precisamente la razón por la que un visor de texto normal no puede interpretarlo (contexto sobre el formato Parquet).
Qué falla en la práctica
Un escenario habitual en producción es este:
Un analista recibe una exportación de archivos de un proveedor.
Un data engineer necesita comprobar si el esquema ha cambiado.
Un equipo de plataforma necesita verificar si los campos anidados se codificaron como esperan los procesos posteriores.
Alguien intenta abrir el archivo en un editor de texto o en un explorador de archivos genérico y no llega a ninguna parte.
En ese punto, un visor de archivos Parquet deja de ser una comodidad y se convierte en una herramienta básica. Su trabajo no es solo mostrar filas. Tiene que traducir un formato de almacenamiento optimizado para la analítica eficiente en algo que las personas puedan inspeccionar de forma segura y rápida.
Si necesitas un repaso rápido del propio formato, esta explicación de qué es Parquet es un buen complemento antes de elegir un visor.
Por qué fallan los visores de archivos genéricos
El fallo es predecible. Los visores genéricos dan por hecho que el archivo es texto orientado a líneas, un contenedor binario simple o un documento con su propio renderizador. Parquet no es ninguna de esas cosas.
Un buen visor entiende cosas como:
Extracción del esquema a partir de los metadatos del archivo
Proyección de columnas, para mostrar solo los campos que te interesan
Estructuras anidadas, incluidos arrays y valores que admiten nulos
Vistas previas conscientes del almacenamiento, en lugar de un falso comportamiento de “abrir archivo” que intenta cargarlo todo
Regla práctica: si una herramienta trata un archivo Parquet como un CSV con otra extensión, es la herramienta equivocada.
El requisito oculto
Es habitual pensar que hace falta un visor porque Parquet no es legible para las personas. Es cierto, pero incompleto. El requisito de fondo es que inspeccionar Parquet exige una lógica que entienda el formato.
No estás simplemente abriendo un archivo. Estás interrogando una estructura de almacenamiento. Eso significa que la mejor herramienta depende de lo que necesites inspeccionar: filas, esquema, row groups, estadísticas, comportamiento de la codificación o metadatos a nivel de archivo. El visor adecuado te da esas respuestas sin obligarte a un escaneo completo ni a mover datos innecesariamente.
Entender la estructura interna de Parquet
La diferencia entre un visor de archivos Parquet rápido y uno torpe empieza en la disposición del archivo. Si no entiendes esa disposición, es difícil juzgar si una herramienta es eficiente o simplemente esconde lecturas costosas detrás de una interfaz.
Parquet organiza los datos como archivo → row groups → column chunks → páginas. Dentro de un row group, los column chunks se escriben uno tras otro, y la página es la unidad más pequeña que se codifica y se comprime (disposición de las páginas de datos de Parquet).

Lo que realmente te muestra un visor
Cuando un visor muestra los row groups y los column chunks, no está añadiendo una función avanzada para usuarios expertos. Está dejando ver el modelo de almacenamiento.
Esto importa en producción porque una vista previa de tabla puede engañar. Una vista previa genérica puede mostrar diez filas y hacer que el archivo parezca trivial, mientras que el archivo real puede contener muchos row groups, chunks de tamaño desigual, columnas anidadas y decisiones de metadatos que afectan a cómo lo leen los motores posteriores.
Para los equipos que trabajan con contratos de datos cambiantes, entender la disposición del archivo también ayuda a seguir la evolución del esquema. Un tema complementario útil es el diseño de tipos de esquema y la gestión de cambios, porque inspeccionar archivos es mucho más fácil cuando tu equipo ya sabe qué deriva estructural buscar.
Por qué importa el footer
Parquet guarda metadatos críticos en un footer al final del archivo. Los lectores suelen saltar a los últimos 8 bytes para encontrar la longitud del footer y los magic bytes PAR1 finales antes de analizar el esquema, los row groups y las estadísticas de columnas (visión general del formato Apache Parquet).
Este único detalle explica en gran parte por qué algunos visores parecen instantáneos y otros no. Un visor inteligente no empieza leyendo el archivo desde arriba y volcándolo todo en memoria. Salta al final, analiza los metadatos y decide qué leer a continuación.
Un visor de Parquet que empieza por el footer puede responder muchas preguntas estructurales antes de tocar la mayor parte del conjunto de datos.
Los campos anidados y nulables no son detalles cosméticos
El funcionamiento interno de Parquet también explica por qué las columnas anidadas se muestran de forma extraña en herramientas poco sólidas. Un column chunk puede incluir como máximo una página de diccionario y, si existe, debe ser la primera página del chunk. Después, las páginas de datos contienen niveles de repetición, niveles de definición y valores codificados, en ese orden (funcionamiento interno de los column chunks de Parquet).
No es una curiosidad. Afecta a lo que un visor necesita decodificar para presentar correctamente arrays, structs y nulos. Si una herramienta lo aplana todo mal, suele ser señal de que esconde la complejidad en lugar de manejar bien el formato.
Qué buscar en un visor que entienda la estructura
Un visor suele merecer la pena si muestra con claridad estos elementos:
Capacidad del visor | Por qué importa |
|---|---|
Navegador de esquema | Ayuda a verificar nombres de columnas, tipos y estructura anidada |
Vista de row groups | Muestra cómo se particionan los datos horizontalmente |
Detalles de los column chunks | Revela los límites de almacenamiento por columna |
Metadatos de páginas o codificación | Útil para depurar campos anidados, nulabilidad o problemas de compresión |
Si una herramienta solo ofrece “vista previa de filas”, puede bastar para una comprobación rápida. No será suficiente cuando estés diagnosticando el comportamiento de un pipeline, validando exportaciones de proveedores o intentando entender por qué un motor de consultas rinde de forma muy distinta a otro.
Comparativa de los principales métodos para ver archivos Parquet
No existe un único mejor visor de archivos Parquet. Hay cinco enfoques habituales y cada uno resuelve un problema distinto. En producción, el error no es elegir un producto flojo. Es usar la clase de herramienta equivocada para la tarea.
Herramientas de línea de comandos
Si necesitas una inspección local rápida, las herramientas de línea de comandos suelen ser la opción más directa. parquet-tools es el ejemplo clásico.
Funcionan bien cuando quieres volcar el esquema, inspeccionar metadatos o muestrear registros sin abrir un IDE. También encajan muy bien en flujos de trabajo de shell y en la depuración de CI.
El precio es la usabilidad. Las herramientas de línea de comandos son eficientes para los ingenieros y hostiles para todos los demás. Además, dificultan la inspección colaborativa salvo que la salida se capture y se comparta de forma deliberada.
Bibliotecas de Python
Para los data engineers, PyArrow y pandas suelen ser la vía más flexible. Puedes inspeccionar el esquema, cargar columnas concretas, aplicar filtros rápidos y combinar la inspección con lógica de validación ad hoc.
Esa flexibilidad es precisamente la razón por la que se convierten en la opción por defecto. Y también por la que es fácil usarlas mal.
Un notebook o un script tiende a pasar de “inspección rápida” a “he cargado sin querer demasiados datos en memoria”. Y en cuanto se normaliza el scripting local contra extracciones de producción, los límites de seguridad empiezan a difuminarse. Si tu equipo ya está evaluando prácticas más amplias de inspección y monitorización, merece la pena comparar las categorías de software de data profiling junto con los visores de archivos.
Spark y motores distribuidos
Spark no es un visor en el sentido habitual, pero los equipos lo usan así constantemente. Si el archivo está en un entorno lakehouse y ya tienes acceso al clúster, leerlo con Spark puede ser la opción más coherente desde el punto de vista operativo.
Funciona mejor cuando el objetivo es inspeccionar dentro de una plataforma existente, no abrir un archivo puntual. Spark maneja con naturalidad grandes conjuntos de datos y almacenamiento remoto. El coste es una configuración pesada, una respuesta más lenta en tareas sencillas y demasiada infraestructura para preguntas básicas del tipo “qué hay en este archivo”.
Si necesitas un clúster para responder una pregunta que una herramienta que lee el footer podría responder en local, tu forma de inspeccionar es demasiado pesada.
Extensiones de VS Code y visores de escritorio
Son útiles para ingenieros que quieren una interfaz visual sin salir de su flujo de trabajo local. Suelen ser más sencillos que las herramientas CLI y más ligeros que arrancar notebooks o sesiones de Spark.
El problema es la calidad desigual. Algunas extensiones solo ofrecen vistas previas superficiales. Otras no muestran en absoluto los row groups, las estadísticas ni los detalles de codificación. Para una inspección sencilla, puede bastar. Para depurar en producción, a menudo no.
Además, las herramientas de escritorio solo son tan seguras como la estación de trabajo en la que se ejecutan. Esto importa cuando el archivo contiene datos regulados o confidenciales.
Visores de Parquet online
Los visores online resultan atractivos porque eliminan la fricción de la configuración. Abres la web, subes el archivo e inspeccionas el contenido.
Esa comodidad hay que sopesarla con cuidado. Algunos equipos pueden usarlos con seguridad para muestras no sensibles. Muchos equipos no pueden usarlos en absoluto por motivos de gobernanza.
Un visor actual describe un modelo más sólido. Afirma que puede abrir archivos Parquet locales o remotos, leerlos en su ubicación mediante solicitudes de rango HTTP y descargar solo los bytes necesarios para la vista actual, lo que permite que archivos de varios gigabytes se abran en un momento mientras los datos permanecen en el equipo del usuario (descripción del producto Parquet Viewer). Es una mejora importante frente a los diseños ingenuos de subir y procesar.
Una tabla de decisión práctica
Método | Ideal para | Qué funciona | Qué falla |
|---|---|---|---|
Herramientas CLI | Ingenieros que hacen comprobaciones locales rápidas | Inspección rápida de esquema y metadatos | Mala experiencia para usuarios no técnicos |
PyArrow o pandas | Análisis de ingeniería ad hoc | Flexible, programable y fácil de ampliar | Es fácil leer datos de más o crear flujos locales desordenados |
Spark | Inspección nativa de la plataforma a escala | Encaja en grandes entornos de data lake | Demasiada sobrecarga para comprobaciones sencillas |
VS Code o visores de escritorio | Inspección visual ligera | Interfaz local cómoda | La profundidad funcional varía mucho |
Visores online | Acceso rápido sin configuración | Cómodos para una exploración rápida | Problemas de privacidad, gobernanza y movimiento de datos |
Los mejores equipos no estandarizan un único método para todos los casos. Estandarizan cuándo se permite cada método, quién lo usa y qué tipo de datos se puede inspeccionar con él.
Cómo inspeccionar archivos Parquet de forma segura
La inspección segura empieza antes de hacer clic en “abrir”. La primera pregunta no es qué visor te gusta. Es si el archivo se puede inspeccionar sin copiar más datos de los necesarios y sin moverlo al entorno equivocado.
Parquet te da ventaja en este punto. Un visor puede reducir mucho la E/S aprovechando los metadatos del footer del archivo. Como Parquet guarda los metadatos al final del archivo, incluidas las ubicaciones de los row groups y los column chunks, un visor puede analizar primero el footer y después leer solo los row groups o las columnas que necesita, en lugar de escanear todo el conjunto de datos. Esa disposición es también lo que permite la inspección selectiva y el predicate pushdown, ya que los row groups son la principal unidad de partición horizontal y cada row group contiene exactamente un column chunk por columna (comportamiento de los metadatos en el formato de archivo Parquet).
Empieza por la estructura, no por las filas
La secuencia más segura es:
Abre primero los metadatos. Revisa el esquema, los row groups y la información a nivel de archivo antes de previsualizar registros.
Proyecta solo las columnas necesarias. Si estás validando un campo, no cargues veinte.
Aplica filtros selectivos cuando estén disponibles. Deja que el visor evite grupos o chunks irrelevantes.
Previsualiza fragmentos pequeños. Una muestra suele bastar para confirmar el formato o el tratamiento de los nulos.
Pasa a lecturas completas solo cuando la tarea lo requiera.
Parece obvio, pero muchos equipos siguen inspeccionando archivos cargándolos enteros en notebooks. Es aceptable para muestras de desarrollo pequeñas y no sensibles. En entornos compartidos o regulados es un mal hábito.
Adapta el método al entorno
El mismo archivo merece un tratamiento distinto según dónde esté.
Archivo de desarrollo local: una herramienta CLI o un visor local suele estar bien si el conjunto de datos no es sensible y el acceso está controlado.
Exportación en almacenamiento de objetos: prefiere una herramienta que pueda inspeccionar en remoto y leer de forma selectiva en lugar de obligar a una descarga completa.
Datos de producción o regulados: mantén la inspección dentro de la infraestructura aprobada y limita quién puede previsualizar registros reales.
Flujo de depuración compartido: documenta primero lo que encuentres sobre el esquema y los metadatos. Muchas incidencias se resuelven sin exponer valores en bruto.
Gran parte de la protección de los datos de clientes consiste en reducir el movimiento innecesario. Es el mismo principio que los equipos aplican en prácticas más amplias de protección de datos de clientes.
Comprobación de seguridad: si tu flujo de inspección exige por defecto descargar extracciones de producción en bruto a equipos personales, el problema no es el formato de archivo. Es el proceso.
Usa la inspección solo del footer cuando la pregunta es estructural
No todas las tareas de inspección necesitan registros. A veces solo hay que confirmar el esquema, la disposición de los row groups, los metadatos clave-valor o estadísticas básicas.
Por eso la inspección basada en el footer es una línea divisoria tan práctica. Apache Doris ofrece este patrón directamente con su función de tabla PARQUET_META, que puede leer los metadatos del footer de Parquet sin escanear páginas de datos y mostrar el esquema, las estadísticas de row groups, los metadatos a nivel de archivo, los metadatos clave-valor, los resultados de consultas a bloom filters e incluso metadatos de versión o de cifrado (referencia de PARQUET_META en Apache Doris).
Es una comprobación de cordura útil para evaluar cualquier visor. Si una función de base de datos puede responder tu pregunta solo con metadatos, un visor de archivos tampoco debería necesitar leer todos los datos.
Un flujo de trabajo que funciona en producción
Cuando los equipos manejan Parquet de forma segura, su proceso suele ser así:
Haz el triaje primero con los metadatos
Inspecciona valores solo en las columnas mínimas necesarias
Evita exportar copias intermedias
Documenta las discrepancias de esquema por separado de las anomalías a nivel de valor
Prioriza la inspección dentro de la plataforma para conjuntos de datos sensibles
No es sobreingeniería. Es lo que evita que la depuración se convierta en una exfiltración accidental.
Optimizar el rendimiento del visor
La velocidad de un visor no depende solo de la aplicación. A menudo es consecuencia de cómo se escribió el archivo Parquet en primer lugar.
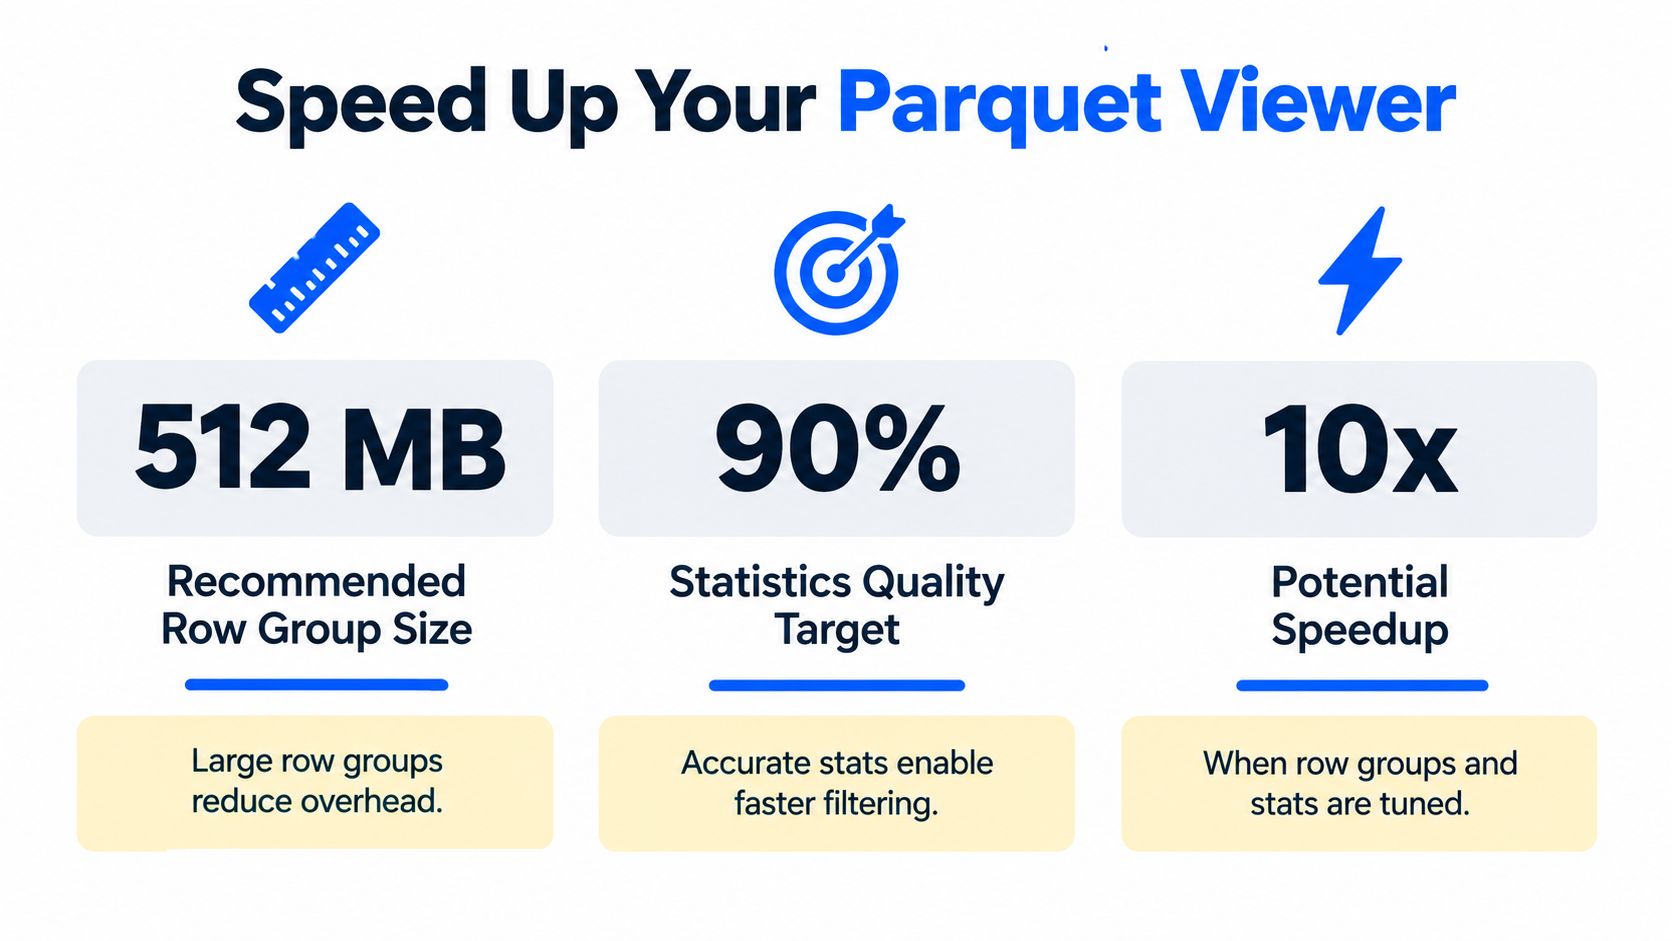
Apache Parquet recomienda row groups grandes, de entre 512 MB y 1 GB aproximadamente, para optimizar las lecturas, porque un row group completo suele ser la unidad mínima que hay que leer. Cuando los row groups son demasiado pequeños, aumenta la sobrecarga de metadatos y cae la eficiencia del escaneo. Los grupos más grandes mejoran el acceso secuencial y el procesamiento en paralelo. Al mismo tiempo, las estadísticas de los row groups, como los valores mínimo y máximo por columna, permiten a un visor o a un motor de consultas saltarse chunks irrelevantes, algo que importa sobre todo en tablas anchas y con filtros selectivos (recomendaciones de configuración de Parquet).
Qué mejora realmente el rendimiento
Si quieres que un visor de archivos Parquet responda con agilidad, cuida la ruta de escritura tanto como la de lectura.
Los row groups deben dimensionarse a propósito. Los archivos con row groups fragmentados son más difíciles de inspeccionar de forma eficiente.
Las estadísticas tienen que ser fiables. Unas estadísticas pobres o ausentes restan valor a la inspección selectiva.
Los esquemas anchos requieren disciplina. Cuantas más columnas tengas, más importante es la proyección.
Los datos anidados necesitan pruebas cuidadosas. Un visor puede abrir el archivo rápido y aun así tardar en decodificar estructuras complejas.
Por qué esto importa más allá de la inspección de archivos
Una inspección rápida es un síntoma de un diseño de almacenamiento sano. Una inspección lenta y torpe suele apuntar a problemas más amplios de la plataforma de datos: configuraciones de escritura incoherentes, una gobernanza del esquema débil o poca observabilidad en la generación de archivos.
Por eso considero la visualización de Parquet algo más que una función de comodidad. A menudo es el primer lugar donde los ingenieros notan que los archivos se generan de una forma que también perjudica el rendimiento de las consultas posteriores. Los mismos hábitos que ayudan a una persona a inspeccionar datos con eficiencia ayudan a los motores a escanearlos con eficiencia. Eso incluye tamaños de archivo razonables, buenas estadísticas y esquemas claros.
Si tus cargas de trabajo SQL también tienen problemas, los principios de la optimización de consultas suelen coincidir con lo que descubrirás al inspeccionar Parquet.
Seguridad empresarial y alternativas in situ
En entornos regulados, la cuestión principal no suele ser si un visor de archivos Parquet es cómodo. Es si usarlo obliga a sacar los datos de los límites aprobados.
Ahí los equipos tienen que ser estrictos. En finanzas, sanidad, telecomunicaciones y sector público, a menudo no se permite que analistas o ingenieros suban extracciones sensibles a servicios externos ni que repartan copias locales por los portátiles. Aunque el visor en sí sea competente, el flujo de trabajo puede incumplir los requisitos de gobernanza.
Un modelo in situ es más seguro porque mantiene la inspección y la monitorización dentro del propio entorno del cliente. En la práctica, eso significa que los equipos inspeccionan la estructura, validan registros y supervisan los cambios de esquema sin exportar los datos subyacentes a sistemas de terceros. También significa que el cómputo debe ejecutarse cerca de los datos, idealmente dentro de la base de datos, para que los equipos eviten movimientos innecesarios solo para responder preguntas operativas.
En el trabajo diario de ingeniería, eso cambia el objetivo. En lugar de preguntar “¿Qué visor debería abrir este archivo?”, los equipos empiezan a preguntar “¿Podemos responder a esto sin mover el archivo en absoluto?”. Es el mejor punto de partida para las operaciones empresariales.
Si tu equipo necesita ese enfoque in situ, digna ofrece una plataforma empresarial de calidad de datos y Data Observability que se ejecuta dentro de tu propio entorno. Ayuda a los equipos a seguir los cambios de esquema, validar registros, monitorizar el comportamiento de los datos y mantener el análisis cerca de los datos, que es exactamente el patrón más seguro cuando la inspección de Parquet afecta a conjuntos de datos de producción sensibles.
Abrir el footer a mano responde si el esquema ha cambiado en un archivo; para detectar automáticamente columnas añadidas, eliminadas o con un tipo distinto en todas las tablas, Schema Tracker de digna supervisa los cambios estructurales dentro de tu propio entorno, de modo que los datos nunca tienen que salir de él.
Preguntas frecuentes
¿Cómo abro un archivo Parquet?
Usa una herramienta que entienda el formato, no un editor de texto, porque Parquet es un formato columnar binario con metadatos basados en Thrift. Entre las opciones están parquet-tools en la línea de comandos, PyArrow o pandas en Python, Spark, extensiones de VS Code y visores online, cada una adecuada para un tipo de inspección y un nivel de sensibilidad de los datos.
¿Por qué no puedo abrir un archivo Parquet en un editor de texto?
Un editor de texto solo muestra un blob binario porque Parquet almacena los datos como row groups, column chunks y páginas comprimidas, con el esquema en un footer al final del archivo. Para leerlo hay que analizar ese footer, que se localiza mediante los últimos 8 bytes y los magic bytes PAR1 finales.
¿Es seguro usar un visor de Parquet online?
Depende de los datos. Los visores que suben y procesan el archivo pueden ser aceptables para muestras no sensibles, pero muchos equipos de finanzas, sanidad, telecomunicaciones y sector público no pueden usarlos por motivos de gobernanza. Los visores que leen los archivos in situ con solicitudes de rango HTTP y mantienen los datos en local son un diseño más seguro.
¿Puedo comprobar el esquema de un Parquet sin leer los datos?
Sí, porque el esquema, las ubicaciones de los row groups y las estadísticas de columnas están en el footer del archivo. Las herramientas que leen el footer analizan primero esos metadatos, y Apache Doris ofrece la función de tabla PARQUET_META, que devuelve el esquema, las estadísticas de row groups y los metadatos clave-valor sin escanear ninguna página de datos.
¿Por qué mi visor de Parquet es lento con archivos grandes?
La lentitud suele deberse a cómo se escribió el archivo más que al propio visor. Apache Parquet recomienda row groups de entre 512 MB y 1 GB aproximadamente, ya que un row group completo suele ser la unidad mínima de lectura. Los row groups fragmentados, la falta de estadísticas y los esquemas muy anchos ralentizan la inspección.



