Qué es la ingesta de datos: pipelines, herramientas y mejores prácticas
|
6
minuto de lectura

La ingesta de datos consiste en recopilar datos brutos de múltiples fuentes y moverlos a un repositorio centralizado con una transformación mínima, preservando la fidelidad de la fuente para que los equipos posteriores puedan crear análisis fiables e inteligencia artificial sobre ellos. Esto suena sencillo, pero en la práctica es la primera puerta de fiabilidad en el flujo de trabajo, y los equipos sienten el coste más tarde cuando los paneles de control se retrasan, las características de los modelos se quedan obsoletas o los cambios de esquema se rompen silenciosamente.
Tabla de contenidos
Introducción a por qué la calidad de la ingesta determina todo lo que viene después
Componentes del flujo de trabajo que hacen que la ingesta sea fiable
Mejores prácticas para ingenieros de datos que crean flujos de trabajo de ingesta
Conclusión: De la ingesta como transferencia a la ingesta como confianza
Introducción a por qué la calidad de la ingesta determina todo lo que viene después
La ingesta es más que un trabajo de copia, es una disciplina de fiabilidad que determina en qué pueden confiar los equipos posteriores. Si los registros brutos llegan tarde, incompletos o malformados, el problema no se queda en el límite del flujo de trabajo. Aparece más tarde como BI desactualizado, alertas ruidosas, entradas de modelos débiles y equipos discutiendo sobre qué números son los correctos.
El significado práctico de ingestar datos es sencillo. Es el proceso de recopilar datos brutos de las fuentes y moverlos a un sistema de destino con la menor transformación posible, de modo que las etapas posteriores puedan limpiarlos, validarlos, modelarlos y gobernarlos mientras el registro de origen sigue intacto. Esa idea básica aparece en las guías de proveedores de Databricks, IBM y Microsoft.
La confusión empieza porque la gente oye «ingesta» y piensa en «transferencia». En un flujo de trabajo real, la transferencia es solo una parte del trabajo. Una buena ruta de ingesta tiene que respetar los presupuestos de latencia, preservar la integridad, mantener bajo control los duplicados y hacer visibles los cambios de esquema antes de que los consumidores de destino se enteren por las malas. Esa es la diferencia entre los datos que simplemente llegan y los datos que pueden respaldar decisiones. También se manifiesta en trabajos operativos como cómo funciona la transcripción de IA, donde el tiempo, la estructura y la precisión afectan a si el resultado se puede utilizar o no.
Regla práctica: si los datos no son de confianza cuando llegan, ninguna cantidad de modelado posterior hará que sean de confianza más adelante.
Por eso las secciones siguientes pasan de la definición a los modos de funcionamiento, luego a los componentes del flujo de trabajo, los casos de uso reales, los patrones de fallo y los hábitos que mantienen la ingesta utilizable a escala. Si desea una visión concreta de cómo encajan esas piezas del flujo de trabajo, comience con una descripción general del flujo de trabajo de ingesta de datos.
Qué significa la ingesta de datos
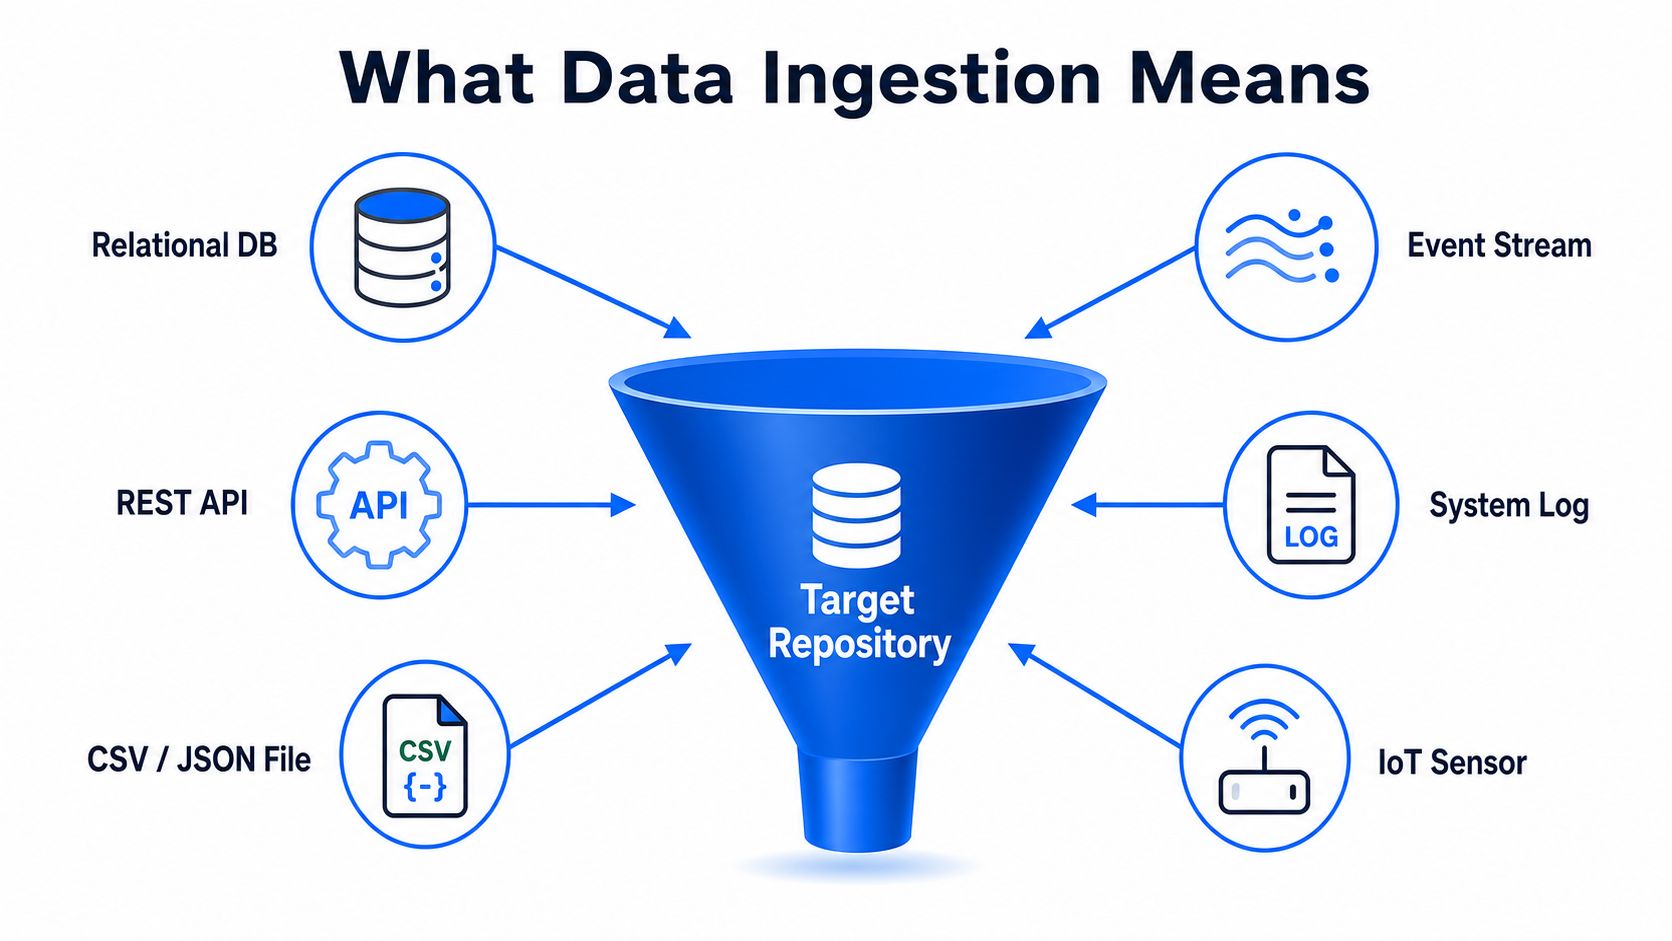
La ingesta es el mostrador de recepción de un sistema de datos. Recibe el registro, comprueba lo que ha entrado, captura lo básico y lo dirige al lugar adecuado para su uso posterior. Ese trabajo es práctico, repetitivo y fácil de subestimar, por lo que los equipos a menudo descubren su coste solo después de que algo se rompa en las fases posteriores.
Ese es el núcleo del significado de la ingesta de datos en una pila moderna. El trabajo consiste en recopilar datos brutos de sistemas fuente, bases de datos, aplicaciones SaaS, API, sistemas de archivos, registros, dispositivos IoT y fuentes de streaming, para luego colocarlos en un lago de datos, almacén o lago de datos (lakehouse) donde se puedan realizar análisis y automatizaciones. La verdadera medida no es si los datos se han movido, sino si el sistema de destino puede utilizarlos sin conjeturas. Si los cambios de esquema, los registros duplicados o los desfases temporales se filtran, el flujo de trabajo puede seguir pareciendo activo mientras los análisis y los modelos de IA pierden fiabilidad de forma constante.
Una buena capa de ingesta también protege la fidelidad de la fuente. Los datos aterrizan en un estado mínimamente transformado para que la limpieza, la validación y el gobierno puedan realizarse con el registro original aún disponible para su comparación. Esto importa cuando un analista necesita rastrear una métrica hasta la fila de origen exacta, o cuando el equipo de un modelo necesita comparar la entrada bruta con las características seleccionadas antes de confiar en el resultado.
El valor operativo es más amplio que el almacenamiento. A medida que las organizaciones pasaron de bases de datos aisladas a plataformas de análisis basadas en la nube, la ingesta se convirtió en el puente que copiaba la información dispersa en sistemas compartidos a un ritmo que la empresa pudiera utilizar. Informatica describe este cambio como algo más que una carga, es la capa que soporta la transferencia segura, la preparación del flujo de trabajo y el análisis de confianza.
Si desea una guía práctica de cómo encajan esas piezas, la guía del flujo de trabajo de ingesta de datos traza el camino desde la recopilación hasta el uso posterior. El mismo pensamiento operativo aparece en cómo funciona la transcripción de IA, donde la entrada bruta debe prepararse cuidadosamente antes de que pueda dar soporte a un resultado útil.
Modos y métodos principales de la ingesta de datos
La primera decisión tiene que ver con la frecuencia con la que deben moverse los datos. La segunda, con quién inicia el movimiento. Esas dos opciones, lotes frente a streaming, y push frente a pull, dan forma al resto del flujo de trabajo más de lo que muchos equipos esperan.
Lotes frente a streaming
La ingesta por lotes mueve los datos en bloques programados. Se adapta a los informes, al análisis histórico y a muchos flujos de trabajo de ML donde el sistema puede tolerar un retraso. La ingesta de streaming mueve los datos de forma continua, lo que se adapta mejor cuando la empresa necesita registros recientes para la detección de fraudes, paneles de control operativos o sistemas basados en eventos.
Modo o método | Latencia típica | Ideal para | Compromiso clave |
|---|---|---|---|
Ingesta por lotes | Programada, no continua | Informes, análisis histórico, actualizaciones periódicas de ML | Menor complejidad operativa, pero frescura más lenta |
Ingesta de streaming | Llegada continua | Detección de fraudes, paneles de control en vivo, flujos de trabajo basados en eventos | Mayor complejidad, necesidades de monitoreo más estrictas |
Ingesta push | La fuente envía los datos automáticamente | Flujos de trabajo de menor latencia con productores capaces | Más responsabilidad en los sistemas fuente |
Ingesta pull | El flujo de trabajo recupera los datos según un programa | Integraciones controladas y sistemas heredados | Más fácil de gestionar centralmente, pero con más retraso |
Esa tabla es realmente un filtro de decisión. Si su consumidor de destino no necesita datos actualizados cada pocos segundos, la opción por lotes suele ser la más sensata. Si un retraso cambia la acción que toma un equipo, el streaming empieza a tener sentido.
Push frente a Pull
La ingesta push reduce la latencia porque la fuente emite los datos tan pronto como están listos. La desventaja es que los productores tienen que ser fiables, lo que significa que un mal comportamiento de la fuente puede derramarse directamente en el flujo de trabajo. La ingesta pull traslada la carga de la orquestación al lado del consumidor. Se obtiene un mayor control sobre los tiempos, pero también se hereda el retraso entre las recuperaciones.
Para los equipos que trabajan en entornos con gran presencia de IA, esta distinción importa más que antes. Un flujo de trabajo de monitoreo de marca, por ejemplo, puede necesitar una captura rápida de señales de muchas fuentes, mientras que otros conjuntos de datos pueden esperar a una extracción programada. La guía de GetIntel para el monitoreo de marcas con IA es una referencia útil si está comparando los requisitos de frescura en múltiples canales y alertas orientadas al usuario.
Regla de decisión: elija el modo más lento que siga soportando el resultado empresarial, luego monitoree la frescura con la suficiente agresividad como para demostrar que funciona.
Componentes del flujo de trabajo que hacen que la ingesta sea fiable
Una ruta de ingesta fiable funciona como una cadena de relevos. Si un eslabón es débil, la ruptura puede permanecer oculta mientras los volúmenes son bajos, y aparecer más tarde como latencia, registros perdidos o malas uniones posteriores una vez que cambien los sistemas anteriores.
Recopilación y transporte
El recopilador de datos o conector es donde vive la realidad específica de la fuente. Maneja protocolos, autenticación y descubrimiento de esquemas, que es la razón por la que los equipos utilizan conectores en lugar de desarrollar manualmente cada integración. La capa de transporte mueve los registros de forma segura al destino, y en los sistemas reales a menudo tiene que gestionar el almacenamiento intermedio y el control de flujo (backpressure) para que los picos de tráfico no saturen el flujo de trabajo.
Almacenamiento intermedio y orquestación
El área de almacenamiento intermedio (staging) es donde se asientan los registros brutos antes de la transformación. Ese búfer es importante porque preserva la carga útil original si los trabajos posteriores fallan o necesitan ser reproducidos, y da a los equipos un lugar para inspeccionar duplicados, campos malformados o registros que llegan tarde antes de que lleguen a los informes y modelos. El programador u orquestador gestiona los reintentos, las dependencias y los tiempos, para que el sistema se comporte de forma predecible en lugar de depender de que alguien se acuerde de una tarea de cron.
Para los patrones de arquitectura, la página de arquitectura de flujos de trabajo de datos es un punto de referencia útil porque sitúa la ingesta dentro del flujo operativo más amplio en lugar de aislarla como un paso de copia independiente.
Monitoring and observability
La última pieza es donde muchas organizaciones invierten menos de lo debido. El monitoreo tiene que cubrir la puntualidad, la integridad, los cambios de esquema, los duplicados y las anomalías, no solo si un trabajo finalizó correctamente. Esa es la diferencia entre un flujo de trabajo que se ejecutó y un flujo de trabajo que demuestra que su resultado es utilizable.
digna es una opción en esa capa. Su plataforma se ejecuta dentro del entorno del cliente y se centra en los programas de llegada, los cambios de esquema, la validación y la detección de anomalías, lo que coincide con la forma en que se mide la fiabilidad de la ingesta en producción. Dado que las comprobaciones se ejecutan en la base de datos, los datos permanecen en su sitio, lo que ayuda a los equipos a mantener la Observability cerca de los sistemas que ya gobiernan.
Una forma práctica de analizar estos componentes es preguntarse dónde se detiene un registro erróneo. Si el recopilador pasa por alto un cambio de campo, el almacenamiento intermedio debería exponerlo. Si los reintentos de transporte crean duplicados, la Observability debería marcar el pico antes de que los análisis o los trabajos de IA empiecen a confiar en las filas incorrectas.
Si falta una etapa, el fallo suele aparecer en otra parte, normalmente como una queja empresarial en lugar de una alerta técnica.
Ejemplos reales de ingesta de datos en la práctica
Una forma útil de evaluar la ingesta es preguntarse qué se rompe cuando no es correcta. La respuesta cambia en función de si los datos alimentan una lógica de fraude, informes ejecutivos o el entrenamiento de un modelo.
Detección de fraudes
In un flujo de pagos, la ingesta en streaming de los registros de transacciones y las API de pago tiene que llegar lo suficientemente rápido como para que las decisiones automatizadas sigan siendo relevantes. Si el flujo de trabajo se retrasa, el modelo de fraude estará analizando el historial en lugar del flujo de eventos en vivo. La señal operativa que hay que vigilar es la frescura, porque unos datos obsoletos pueden significar un bloqueo omitido o una respuesta retrasada.
Informes ejecutivos
La ingesta por lotes es habitual para los datos de ERP y CRM porque a los informes de dirección les suele importar más la consistencia y el tiempo de entrega que las actualizaciones instantáneas. La pregunta clave es si los datos llegan antes del cierre de los informes. Si no es así, el panel de control puede seguir pareciendo impecable mientras los números subyacentes ya están desactualizados.
Flujos de trabajo de características de ML
Los flujos de trabajo de características viven y mueren por la frescura. Si la ingesta se ralentiza, el conjunto de entrenamiento empieza a desviarse del estado del sistema, y el modelo aprende de condiciones antiguas. Esto es especialmente arriesgado cuando el negocio depende de patrones que cambian rápidamente, porque las características obsoletas pueden hacer que un modelo parezca correcto en las pruebas y no sea fiable en producción.
Esos ejemplos conectan con un punto que aparece constantemente en las guías modernas, incluida la discusión de Unstructured sobre la calidad de la ingesta. Los equipos están pasando de la idea de «mover los datos» a la de «demostrar que los datos son utilizables», especialmente cuando las decisiones posteriores dependen de la puntualidad, las cargas omitidas y los esquemas estables.
En los tres casos, la pregunta de ingeniería es la misma. ¿Cómo sabe que los datos llegaron a tiempo, completos y con un formato que el siguiente sistema pueda utilizar?
Errores comunes de la ingesta y cómo se propagan
La parte costosa de los problemas de ingesta es que rara vez se quedan a nivel local. Un pequeño problema en el origen puede convertirse en un problema empresarial varias capas más adelante, y para entonces la causa raíz parece no tener relación.
Desviación de latencia
La desviación de latencia ocurre cuando los datos empiezan a llegar más tarde de lo esperado y nadie se da cuenta de inmediato. El síntoma inmediato suele ser un panel de control que parece «correcto» pero refleja condiciones antiguas. Para un equipo que toma decisiones diarias, ese retraso puede ser suficiente para cambiar lo que hacen a continuación.
Registros duplicados
Los registros duplicados son más complicados porque pueden hacer que las cifras parezcan más saludables de lo que son. La entrega de al menos una vez (at-least-once) es útil para la fiabilidad, pero puede inflar los recuentos si el flujo de trabajo no elimina los duplicados de forma inteligente. El daño suele aparecer en los embudos, los ingresos totales y las métricas basadas en eventos que la gente asume que están limpias.
Desviación de esquema
La desviación de esquema es el fallo más silencioso de los tres. Un equipo ascendente añade una columna, cambia un tipo o cambia el nombre de un campo, y los consumidores descendentes se rompen o siguen funcionando con suposiciones erróneas. Lo peor es que el fallo puede ser parcial, de modo que algunas consultas tienen éxito mientras que otras fallan o devuelven tonterías.
Verdad operativa: los datos retrasados, los datos duplicados y los cambios de formato suelen deberse menos a errores de transporte y más a la falta de visibilidad.
Por eso los equipos de finanzas, sanidad, telecomunicaciones y sector público han avanzado hacia comprobaciones de ingesta basadas en evidencias. Necesitan pruebas de que la ruta de ingesta es lo suficientemente fiable para tomar decisiones reguladas o de misión crítica, no solo pruebas de que se han movido bytes. Cuando la Observability es débil, el flujo de trabajo puede seguir teniendo «éxito» mientras la empresa ve resultados obsoletos, inflados o incompletos.
Mejores prácticas para ingenieros de datos que crean flujos de trabajo de ingesta
Los equipos de ingesta más sólidos no confían en la suerte ni en una configuración única. Crean hábitos que hacen que los fallos sean visibles de forma temprana y que la recuperación resulte rutinaria.
Comenzar con la preservación en bruto
Conserve los datos de origen brutos en el almacenamiento intermedio antes de la transformación. Eso le proporciona una vía de escape limpia cuando falla un trabajo posterior o cambia una regla de negocio. También facilita mucho la auditoría y el reprocesamiento, ya que la carga útil original sigue estando disponible.
Hacer que los reintentos sean seguros
Utilice cargas idempotentes para que el reintento de un trabajo no cree una inflación de duplicados. Si un flujo de trabajo tiene que ejecutarse dos veces, la segunda ejecución no debería reescribir la realidad. Esa única elección de diseño evita mucha confusión con las métricas más adelante.
Monitorear antes de que los usuarios se quejen
Establezca acuerdos de nivel de servicio (SLA) de puntualidad con ventanas de llegada realistas, y envíe alertas cuando el sistema no las cumpla. Realice un seguimiento continuo de los cambios de esquema y no espere a que una consulta posterior descubra un campo roto. En la práctica, los mejores equipos combinan comprobaciones deterministas con aprendizaje de referencias basado en IA para poder detectar tanto fallos conocidos como nuevos patrones.
Mantener corta la lista de verificación operativa
Preservar los datos brutos: almacene los originales en una etapa intermedia para poder reproducirlos o auditarlos más tarde.
Utilizar cargas idempotentes: diseñe los reintentos para que no creen duplicados.
Monitorear de forma temprana: configure alertas antes de que el flujo de trabajo sea crítico para el negocio.
Seguir la evolución del esquema: marque rápidamente los campos añadidos, eliminados o modificados.
Documentar la propiedad: asigne guías de ejecución, rutas de escalada y comprobaciones de regresión.
Una plataforma como el software de ingesta de datos de digna encaja en ese tipo de modelo operativo porque se centra en el comportamiento de llegada, la desviación de esquema y la validación a nivel de registro dentro del entorno del cliente. Ese diseño dentro de la base de datos es importante cuando los requisitos de seguridad y governance hacen que el movimiento de datos sea más difícil de justificar.
El punto principal es sencillo. No espere a que el flujo de trabajo sea «lo suficientemente grande» para preocuparse por la Observability. Para entonces, el coste del desconocimiento ya formará parte de la arquitectura.
Conclusión: De la ingesta como transferencia a la ingesta como confianza
La ingesta de datos comienza como un paso de transferencia, pero se convierte en una capa de confianza en el momento en que otros equipos dependen de ella. Una vez que los paneles de control de BI, los almacenes de características y las decisiones automatizadas dependen de esos registros, la ruta de ingesta deja de ser fontanería y pasa a ser un punto de control empresarial.
Las elecciones fundamentales siguen siendo las mismas en todos los entornos. El lote y el streaming definen el modelo de frescura. El push y el pull definen el modelo de propiedad. Los cinco componentes del flujo de trabajo (recopilación, transporte, almacenamiento intermedio, orquestación y Observability) deciden si el sistema puede sobrevivir al cambio en el mundo real. Los errores comunes (desviación de latencia, duplicados y desviación de esquema) se manifiestan como una pérdida de confianza si no se detectan a tiempo.
Ese cambio de mover datos a demostrar la usabilidad ya es visible en los programas de datos modernos, especialmente donde las decisiones conllevan riesgos operativos o de Compliance. Los equipos no solo quieren registros en un almacén. Quieren pruebas de que la ruta de ingesta es oportuna, completa y lo suficientemente estable como para respaldar la siguiente acción.
Si está reforzando esa parte de su pila tecnológica, concéntrese en las señales que más importan a sus usuarios y luego cree comprobaciones en torno a ellas. Los equipos que lo hacen bien pasan menos tiempo discutiendo sobre los paneles de control y más tiempo utilizándolos.
Si está listo para hacer visible la fiabilidad de la ingesta en lugar de adivinarla, explore digna. Está diseñada para monitorear la puntualidad, los cambios de esquema, la validación y las anomalías dentro de su propio entorno, lo que la convierte en una solución práctica para los equipos que necesitan flujos de trabajo de confianza sin movimientos de datos adicionales.


