S3 como sistema de archivos
|
7
minuto de lectura

Montar S3 como un sistema de archivos suele ser la opción predeterminada incorrecta. Los equipos recurren a ello porque la ruta les resulta familiar, las herramientas heredadas siguen funcionando y la promesa de "simplemente montar el bucket" parece más barata que reescribir los pipelines. Ese atajo oculta un desajuste semántico, y en la analítica empresarial ese desajuste se manifiesta como picos de latencia, comportamientos de consistencia extraños, una gobernanza desordenada y costes operativos sorpresa.
La regla más segura es sencilla. Utilice S3 para lo que es, almacenamiento de objetos, a menos que tenga una carga de trabajo muy específica que necesite semántica de archivos. Si trata el montaje como una capa de conveniencia en lugar de una decisión de arquitectura, acabará depurando la abstracción en lugar de entregar datos.
Tabla de contenidos
Por qué montar S3 como un sistema de archivos suele ser la opción predeterminada incorrecta
Comparación entre el almacenamiento de objetos y los sistemas de archivos POSIX
Asignar la operación de archivo al comportamiento de S3
Comportamiento de consistencia que no puede ignorar
Las operaciones que todavía desconciertan a la gente
Opciones de montaje desde s3fs y FUSE a S3 Files
Compare la pila tecnológica, no el marketing
Cargas de trabajo analíticas en una capa de sistema de archivos S3
Optimice para la carga de trabajo que realmente tiene
Gobernanza empresarial y Observability para el acceso a archivos S3
Audite la capa de objetos, no solo el montaje
Cuándo tiene sentido realmente S3 como sistema de archivos
Utilícelo cuando el compromiso sea deliberado
Por qué montar S3 como un sistema de archivos suele ser la opción predeterminada incorrecta
El error común es asumir que si un bucket puede parecer un directorio, debería comportarse como tal. Esa suposición perjudica a los equipos porque el montaje oculta el hecho de que S3 sigue siendo un almacenamiento de objetos por debajo, con un rendimiento, una consistencia y un comportamiento de metadatos diferentes a los de un disco local o un recurso compartido NFS. El almacenamiento de objetos guardará encantado sus bytes, pero no heredará las garantías con las que su aplicación podría estar contando.
En producción, es en esa brecha donde empieza el dolor. Los ingenieros utilizan montajes para mantener vivos scripts antiguos, y luego descubren que los trabajos con muchos cambios de nombre, las escrituras compartidas y los recorridos de metadatos se comportan como una capa de traducción, no como un sistema de archivos nativo. El resultado suele ser más piezas móviles, más reintentos ocultos y más lugares por donde se escapan los costes debido a la dispersión de solicitudes y la saturación de la caché.
Regla práctica: si la carga de trabajo solo "necesita una carpeta", eso no significa que necesite un sistema de archivos.
La propia AWS ha evolucionado S3 de una manera que demuestra este punto. Desde su lanzamiento el 14 de marzo de 2006 con aproximadamente 1 petabyte de capacidad en unos 400 nodos de almacenamiento distribuidos en 15 racks y con un ancho de banda total de 15 Gbps, S3 creció hasta convertirse en una plataforma que almacena más de 500 billones de objetos y atiende más de 200 millones de solicitudes por segundo a nivel mundial para marzo de 2026, a lo largo de 123 Zonas de Disponibilidad en 39 Regiones de AWS (AWS S3 history and scale). Esa escala hace que S3 sea excelente para cargas de trabajo de objetos, pero no lo convierte mágicamente en un disco POSIX. Si su arquitectura depende del comportamiento de un archivo local, debe justificar por qué el montaje debe estar ahí.
Para los equipos que diseñan una plataforma desde cero, la primera pregunta no es "¿podemos montarlo?", sino "¿qué modo de fallo estamos asumiendo?". Si desea realizar una revisión limpia del diseño del sistema en torno a esa pregunta, el punto de partida adecuado es this data system architecture guide.
Comparación entre el almacenamiento de objetos y los sistemas de archivos POSIX
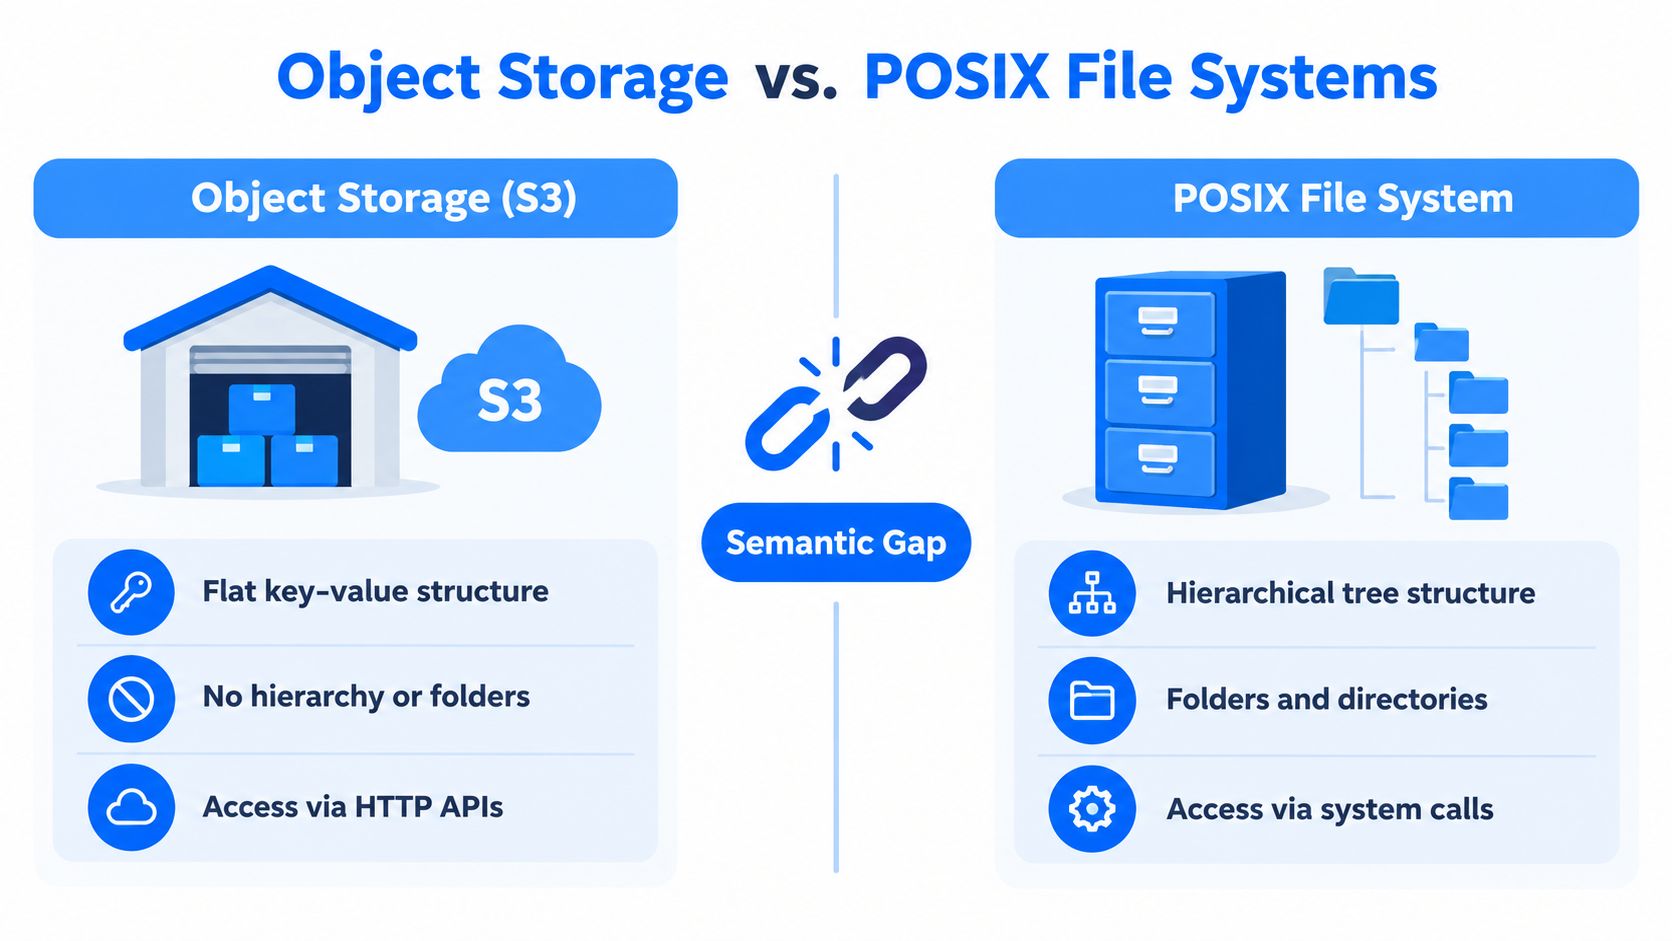
Piense en términos de un almacén. Un bucket es un almacén, un objeto es una caja sellada y la clave es la etiqueta de la caja. Puede mover cajas, reemplazar cajas y listar etiquetas, pero no puede abrir una caja y editar una sola página en su interior de la forma en que editaría un documento en un ordenador portátil. Esa es la brecha semántica que toda capa de montaje tiene que ocultar.
Asignar la operación de archivo al comportamiento de S3
Comience con la operación open. En POSIX, abrir un archivo es una llamada del sistema normal dentro de un sistema de archivos jerárquico. En S3, "abrir" es en realidad una decisión del cliente de recuperar un objeto o preparar una ruta de escritura a través de una capa de traducción. El sistema puede hacer que parezca familiar, pero el mecanismo sigue basándose en objetos.
Ahora asigne la escritura parcial y la sobrescritura. En un sistema de archivos, a menudo se pueden modificar bytes in situ. En S3, el objeto se reemplaza. Es por eso que los flujos de trabajo orientados a archivos que asumen ediciones incrementales pueden volverse costosos o complicados cuando se traducen a operaciones de objeto (object-store behavior and overwrite differences). El modelo de almacenamiento no se comporta como un bloque mutable de memoria compartida.
Por último, considere el cambio de nombre y el cambio de nombre atómico. En POSIX, la semántica de cambio de nombre forma parte del contrato del sistema de archivos. En S3, el cambio de nombre es un patrón de emulación, generalmente copiar y eliminar o una reescritura de metadatos en la capa de montaje. Ahí es donde aparecen las sorpresas, porque mover un directorio puede convertirse en una ráfaga de operaciones de objetos en lugar de una única acción atómica.
Un montaje puede traducir nombres. No puede inventar semánticas.
La explicación de un minuto para una parte interesada es directa. S3 es un espacio de nombres de objetos plano con una presentación tipo archivo superpuesta. POSIX es un sistema de archivos jerárquico con semántica nativa de directorios y mutaciones. Cuanto más dependa su carga de trabajo de ediciones atómicas, bloqueos y comportamientos de cambio de nombre, más tendrá que simular la capa de traducción lo que el backend de almacenamiento nunca prometió.
Comportamiento de consistencia que no puede ignorar
La consistencia de S3 es el punto donde muchas suposiciones de sistemas de archivos comienzan a tambalearse. Amazon S3 ahora ofrece una consistencia sólida de lectura después de la escritura para GET, PUT y LIST en todas las regiones de AWS, y AWS afirma que lo que se escribe es lo que se leerá (S3 consistency model). Esto elimina una clase importante de sorpresas, pero no convierte a S3 en un sistema de archivos POSIX.
Las operaciones que todavía desconciertan a la gente
Un lector aún puede tener problemas cuando la aplicación asume una coordinación de sistema de archivos que no existe. Los flujos de trabajo de sobrescritura, los patrones de cambio de nombre de estilo directorio y las rutas de acceso con uso intensivo de metadatos siguen dependiendo de que la capa de montaje añada sincronización o comportamiento de almacenamiento en caché que el propio S3 no proporciona. Cuando los equipos ignoran esto, eventualmente experimentan lecturas obsoletas, condiciones de carrera o patrones de inconsistencia de red en flujos de trabajo de múltiples clientes, especialmente cuando varios escritores acceden al mismo espacio de nombres.
El riesgo no es teórico. Un trabajo puede escribir datos, un segundo trabajo puede listar el mismo prefijo y ambos trabajos pueden creer que poseen la misma ruta lógica. Si el pipeline espera un reemplazo atómico de directorios o bloqueo de archivos, la abstracción debe proporcionar coordinación sobre la semántica de objetos, y esa coordinación se convierte en otra superficie de fallo.
Operación | Comportamiento POSIX | Comportamiento de S3 | Riesgo para usuarios de sistemas de archivos |
|---|---|---|---|
Crear y leer | Creación de archivo nativo y posterior lectura inmediata | Fuertemente consistente para nuevos objetos | Menor riesgo, pero el comportamiento del montaje sigue importando |
Sobrescribir | Semántica de actualización de archivos in situ | Semántica de reemplazo de objetos | Es posible que los lectores no obtengan un comportamiento de actualización de tipo archivo |
Cambiar nombre de directorio | Movimiento de espacio de nombres de apariencia atómica | Emulado mediante operaciones de objeto o capa de metadatos | Claves huérfanas, movimientos parciales, reintentos ocultos |
Listar directorio | Metadatos de directorio nativos | Listado basado en prefijos de claves de objetos | Los listados grandes pueden volverse lentos y ruidosos operativamente |
AWS S3 Files añade otra señal de que la abstracción tiene límites. La documentación expone cuotas explícitas como 25.000 conexiones por sistema de archivos y 10.000 puntos de acceso por sistema de archivos, lo que recuerda que el montaje no es lo mismo que un disco local (S3 Files limits and behavior). Diseñe teniendo en cuenta esos límites, no pretenda ignorarlos.
Para los equipos de pipeline, el hábito más seguro es dirigir cada flujo de trabajo sensible a la consistencia a través de un propietario claro y un paso de validación explícito. Si necesita una lista de verificación práctica para ese tipo de detección de desviaciones, utilice data consistency checks como modelo de cómo abordar el problema.
Opciones de montaje desde s3fs y FUSE to S3 Files
No todos los montajes de S3 se construyen de la misma manera. Algunas opciones existen para mantener vivas las herramientas heredadas, otras para reducir la fricción operativa y algunas se describen mejor como capas de acceso que como verdaderos sistemas de archivos. La elección correcta depende de si necesita acceso de lectura, comportamiento de escritura directa, mutación compartida o una forma más limpia de alimentar los motores de analítica que ya se comunican mediante almacenamiento de objetos.
Compare la pila tecnológica, no el marketing
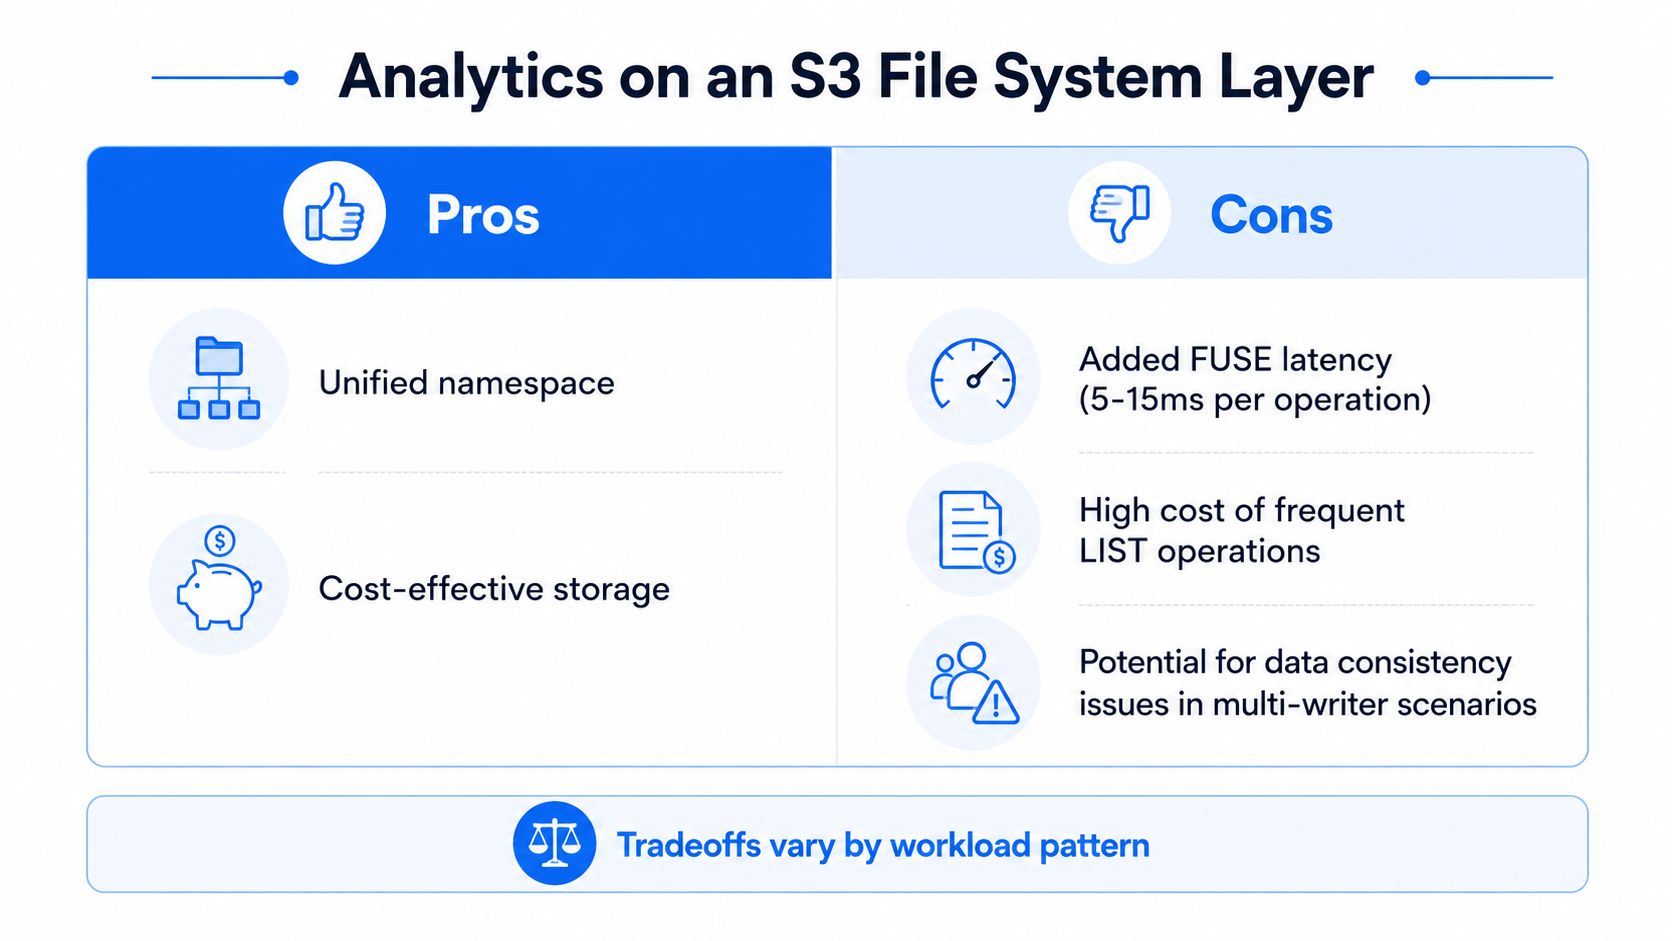
s3fs y los montajes similares basados en FUSE suelen ser la primera parada para los equipos que necesitan un puente de compatibilidad rápido. Son convenientes, pero añaden una capa de proceso adicional, latencia extra y más margen para cuellos de botella cuando un solo nodo se convierte en el punto de estrangulamiento. Pueden estar bien para un uso interactivo ligero o como andamiaje de migración, pero son una mala opción predeterminada para pipelines empresariales con mucha actividad.
Goofys y Mountpoint for S3 pertenecen a la misma gran familia de capas de compatibilidad. Pueden mejorar patrones de acceso específicos, pero siguen sin eliminar el desajuste semántico entre el almacenamiento de objetos y la semántica de archivos. Utilícelos cuando el objetivo principal sea "hacer que esta herramienta funcione ahora", no "construir la plataforma en torno a esto indefinidamente".
El más reciente S3 Files de AWS tiene una intención diferente. AWS lo posiciona como un sistema de archivos compartido para EC2, Lambda, EKS y ECS, con acceso NFS 4.1 y 4.2 y sincronización bidireccional entre el sistema de archivos montado y el bucket (S3 Files behavior and regions). Eso lo hace más nativo que un simple shim de FUSE, pero sigue sin ser un disco POSIX. El compromiso de diseño es mejor para el acceso compartido que para las escrituras aleatorias de estilo base de datos.
Las API nativas de almacenamiento de objetos son la respuesta más limpia cuando su motor ya las admite. Spark, Trino y DuckDB obtienen un mejor paralelismo y un escalado más limpio cuando se comunican con S3 directamente en lugar de recorrer un montaje que intenta imitar directorios. Si la herramienta ya sabe cómo realizar listados paralelos, lecturas vectorizadas o pushdown de predicados, no la obligue a pasar por una apariencia de archivo.
Opción | Pila tecnológica | Soporte de escritura | Límite de rendimiento | Mejor ajuste |
|---|---|---|---|---|
s3fs | Cliente basado en FUSE | Limitado, orientado a la compatibilidad | A menudo con cuello de botella por el nodo cliente | Herramientas heredadas y trabajo de migración de corta duración |
Otros montajes FUSE | Capa de compatibilidad | Varía según la implementación | Depende de la sobrecarga de traducción | Acceso con uso intensivo de lectura con baja concurrencia |
S3 Files | Interfaz de sistema de archivos gestionada por AWS sobre S3 | Sincronización bidireccional | Mejor para acceso compartido, aún no nativo de POSIX | Cómputo compartido y colaboración orientada a archivos |
API nativas de objetos | SDK directo de S3 o integración del motor | Semántica completa de objetos | Escala con el paralelismo del almacenamiento de objetos | Spark, Trino, DuckDB y analítica moderna |
La recomendación es clara. Utilice montajes de solo lectura cuando deba preservar herramientas antiguas. Utilice montajes de escritura directa solo con reintentos explícitos, reglas de propiedad y rutas de reversión. Prefiera las API nativas de objetos siempre que la herramienta las admita, porque ese es el camino que escala limpiamente para la analítica. Si desea una perspectiva de diseño de pipeline más amplia, la ETL data pipeline guide es el tipo de marco que su equipo de plataforma debería utilizar antes de aprobar un montaje.
Cargas de trabajo analíticas en una capa de sistema de archivos S3
Las cargas de trabajo analíticas exponen los puntos débiles rápidamente porque acceden tanto a los bytes como a los metadatos. Los trabajos de Spark e Hive pueden tolerar lecturas estructuradas por etapas si el patrón de acceso es mayoritariamente secuencial, pero una vez que la carga de trabajo comienza a escanear directorios, cambiar el nombre de las particiones o generar pequeños archivos, la capa de montaje se vuelve costosa tanto en tiempo como en actividad del plano de control. Trino y DuckDB suelen funcionar mejor cuando pueden comunicarse directamente con S3, porque evitan una abstracción de archivos que nunca fue diseñada para metadatos de alta rotación.
Optimice para la carga de trabajo que realmente tiene
Si el trabajo está orientado a lotes, estructurar los datos a través de S3 puede seguir teniendo sentido cuando el patrón de lectura es predecible y la salida se escribe una sola vez. En ese caso, concéntrese en reducir los recorridos de directorio innecesarios y permita que el motor lea bloques más grandes en lugar de pretender que cada fila merece un acceso de archivo independiente. Las herramientas que admiten lectura anticipada, rangos GET paralelos o pushdown de predicados generalmente superarán a un montaje genérico porque se mantienen más cerca de la semántica de objetos.
El otro punto de tensión son los archivos pequeños. Una capa de sistema de archivos hace que la proliferación de archivos pequeños parezca inofensiva hasta que las operaciones de listado y metadatos dominan el trabajo. Las escrituras de tablas con muchos cambios de nombre también se convierten en un problema, porque el montaje tiene que emular un comportamiento que el almacenamiento de objetos no proporciona de forma nativa. Ahí es donde los formatos de tabla como Iceberg y Hudi demuestran su valor, porque codifican sus propias capas de consistencia y metadatos en lugar de depender de trucos de directorio.
Regla práctica: si el diseño de sus datos depende del cambio de nombre como mecanismo de confirmación (commit), está resolviendo un problema de formato de tabla con fontanería de almacenamiento.
La cuestión del coste también importa. Las operaciones LIST frecuentes en buckets grandes son un antipatrón para la analítica basada en montajes, porque cada conveniencia orientada a archivos puede convertirse en solicitudes adicionales y latencia extra. Es por eso que una ruta directa de S3 suele ser la mejor opción para grandes conjuntos de datos empresariales, especialmente cuando el equipo de la plataforma ya cuenta con supervisión sobre los patrones de consulta, el recuento de archivos y la rotación de objetos.
Para los equipos que necesitan instrumentación en torno a estos compromisos, la visión operativa importa tanto como el motor de consultas. El patrón de supervisión correcto debe estar en data lake monitoring, no en un script de montaje único.
Gobernanza empresarial y Observability para el acceso a archivos S3
Una vez que S3 se expone como un sistema de archivos, la gobernanza debe seguir a los datos, no a la ilusión de las carpetas. Los límites de IAM siguen importando a nivel de bucket o prefijo, el cifrado de KMS sigue importando en reposo y las políticas de endpoints de VPC siguen importando si desea detener la salida pública accidental. La ruta del archivo puede parecer familiar para los usuarios, pero el plano de control que hay debajo sigue siendo el almacenamiento de objetos, por lo que su modelo de políticas debe coincidir con la semántica de objetos.
Audite la capa de objetos, no solo el montaje
Los registros de auditoría del sistema de archivos no son suficientes aquí. El montaje puede ocultar operaciones a nivel de objeto a las personas que solo miran las trazas de estilo POSIX, lo que significa que el equipo de seguridad necesita registros de acceso de S3, eventos de datos de CloudTrail y telemetría de almacenamiento en el mismo pipeline de supervisión. Sin eso, se pueden pasar por alto desviaciones, montajes obsoletos, credenciales filtradas en hosts bastión y patrones GET que parecen normales para el cliente de archivos pero sospechosos para un encargado de responder a incidentes.
La clasificación de datos también se vuelve más difícil. Una ruta de archivo en un espacio de nombres montado no se asigna uno a uno a una ACL o política de objetos, por lo que los equipos necesitan reglas explícitas sobre quién puede ver qué y dónde se aplican esas reglas. Si el mismo bucket es accedido por múltiples herramientas, también deseará convenciones de propiedad que eviten rutas de escritura ambiguas y colisiones accidentales de espacios de nombres.
AWS S3 Files añade una regla operativa particularmente útil. Si el mismo elemento se modifica tanto en el sistema de archivos como directamente en el bucket, AWS trata al bucket como la fuente de verdad y mueve el archivo en conflicto a un directorio de objetos perdidos, y AWS recomienda elegir el sistema de archivos o S3 como el escritor principal (S3 Files best practices). Esa es una política de gobernanza tanto como un detalle técnico, porque obliga a los equipos a elegir una fuente de verdad antes de crear un caos.
Para las plataformas de datos empresariales, el trabajo consiste en la supervisión continua de la propia capa. Si un montaje se desvía, se filtra una credencial o una carga de trabajo comienza a realizar GETs de una manera que no se ajusta al patrón esperado, el equipo de la plataforma debería verlo antes que el negocio. Ese es exactamente el tipo de visibilidad que una plataforma como data observability está diseñada para ofrecer.
Cuándo tiene sentido realmente S3 como sistema de archivos
Utilice S3 como un sistema de archivos solo cuando la carga de trabajo justifique la abstracción. La preparación efímera para un único trabajo por lotes está bien. Las herramientas heredadas vinculadas a POSIX que no se pueden reescribir dentro del cronograma del proyecto están bien. La analítica principalmente de lectura en Parquet o formatos de tabla que ya gestionan sus propios metadatos también está bien, especialmente cuando el objetivo es evitar copias duplicadas y movimientos de datos innecesarios.
Utilícelo cuando el compromiso sea deliberado
Lo que no pertenece a un montaje respaldado por S3 es una base de datos de escritura aleatoria, un espacio de trabajo compartido de alta rotación o una arquitectura de microservicios que utiliza el montaje como si fuera un disco compartido de baja latencia. Esos sistemas requieren una semántica de archivos más sólida de la que el almacenamiento de objetos puede proporcionar a través de una capa de traducción, y tienden a fallar en los lugares exactos donde la concurrencia y la mutación más importan.
El patrón de decisión limpio consiste en evaluar la carga de trabajo candidata frente a seis preguntas.
Frecuencia de escritura. Si las escrituras son frecuentes y pequeñas, descarte la opción.
Patrones de listado. Si la aplicación recorre directorios constantemente, descarte la opción.
Tolerancia a la latencia. Si unos pocos viajes de ida y vuelta adicionales interrumpen el flujo de trabajo, descarte la opción.
Límite de coste. Si el crecimiento de las solicitudes importa más que el coste de almacenamiento, descarte la opción.
Postura de seguridad. Si la aplicación de políticas depende únicamente de la semántica de la ruta, descarte la opción.
Ruta de reversión. Si no puede recurrir a las API directas de S3 u otro almacenamiento, no comience.
La recomendación honesta es simple. Utilice el montaje cuando el objetivo sea la compatibilidad y la carga de trabajo sea limitada. Evítelo cuando el requisito sea la mutación compartida, la concurrencia compleja o un comportamiento similar al de una base de datos. S3 es un excelente elemento primitivo para plataformas de datos, pero un contenedor de sistema de archivos no lo convierte en un NAS de propósito general.

Si su equipo está decidiendo si exponer S3 como un montaje, digna puede ayudarle a mantener la honestidad de la capa de datos con una Observability que rastrea la Timeliness, los cambios de esquema, las anomalías y el comportamiento de la plataforma dentro de su propio entorno. Visite digna para ver cómo su plataforma de Data Observability puede ayudarle a supervisar los efectos secundarios de decisiones de arquitectura como esta, antes de que un montaje se convierta en un incidente de producción.
Preguntas frecuentes
¿Conviene montar S3 como sistema de archivos?
Normalmente no. Montarlo es el valor por defecto equivocado porque oculta que debajo sigue habiendo un almacén de objetos, con comportamiento de rendimiento, consistencia y metadatos distinto al de un disco local o un recurso NFS. Use S3 como almacenamiento de objetos salvo que una carga muy concreta necesite semántica de ficheros.
¿Por qué un bucket que parece un directorio no se comporta como tal?
Porque la apariencia de directorio es una emulación. El error habitual es suponer que si un bucket puede parecer una carpeta, debería comportarse como una, y en producción esa suposición es justo donde empieza el dolor.
¿Cómo se corresponden las operaciones POSIX con S3?
De forma imperfecta. Abrir es en realidad una decisión del cliente de traer un objeto o preparar una ruta de escritura mediante una capa de traducción, la escritura parcial y la sobrescritura reemplazan el objeto entero, y renombrar es un patrón de emulación, normalmente copiar más borrar o una reescritura de metadatos en la capa de montaje.
¿Qué pregunta debería sustituir a «¿podemos montarlo?»
«¿Qué modo de fallo estamos comprando?» Si una carga solo necesita una carpeta, eso no significa que necesite un sistema de archivos, y responder primero a la pregunta del modo de fallo suele eliminar el montaje del diseño.
¿Cuánto ha crecido S3 desde su lanzamiento?
De alrededor de 1 petabyte en unos 400 nodos de almacenamiento en 15 racks con 15 Gbps de ancho de banda total en su lanzamiento el 14 de marzo de 2006, a más de 500 billones de objetos y más de 200 millones de peticiones por segundo a escala global en marzo de 2026, repartidos en 123 zonas de disponibilidad de 39 regiones de AWS.



