Ricos en datos y pobres en información: guía práctica
|
7
minuto de lectura

Puede estar en una reunión de revisión un lunes, con un dashboard impecable en pantalla, y aun así no saber si la cifra se movió porque la campaña funcionó, porque se rompió la tabla de origen o porque alguien cambió la definición la semana pasada. Los gráficos tienen un aspecto pulido. Pero la reunión termina con la misma pregunta incómoda: ¿en qué podemos confiar?
Esa brecha es lo que significa ser rico en datos y pobre en información, y aparece cuando los equipos recopilan multitud de filas, eventos y registros, pero aun así no logran convertirlos con la rapidez suficiente en información lista para decidir. El problema no es solo el volumen. Es el tiempo y la confianza que se necesitan para transformar señales en bruto en algo sobre lo que un responsable pueda actuar sin dudar del origen.
Índice
De dónde procede la expresión y por qué sigue siendo relevante
El coste real para el negocio de ser rico en datos y pobre en información
De las fábricas de reglas a la observabilidad basada en IA en la práctica
La trampa del dashboard y el problema DRIP
Un dashboard de ingresos puede parecer sano y aun así no superar la única prueba que importa: ¿puede el equipo explicar por qué cambió el pipeline comercial? Marketing dice que la campaña impulsó la demanda, ventas dice que cambió la combinación de leads, finanzas ve una cifra que no coincide con la previsión de la semana pasada y al analista le toca unir tablas del data warehouse, exportaciones de aplicaciones SaaS y ajustes manuales en hojas de cálculo. Esa es la trampa del dashboard: mucha visualización y poca decisión.
DRIP significa data rich, information poor, es decir, rico en datos y pobre en información. Describe la brecha cada vez mayor entre la cantidad de datos que recopila una empresa y la cantidad de información lista para decidir en la que puede confiar. Los datos en bruto son una fila de una tabla, un evento de un flujo o una línea de registro de un archivo. La información es esa misma señal una vez que tiene contexto, actualidad, un responsable y la explicación suficiente para respaldar una acción.
La distinción importa porque los equipos suelen tratar más datos como la respuesta a la falta de conocimiento. En la práctica, eso puede ampliar la brecha. Más tablas implican más joins, más herramientas implican más traspasos y más traspasos implican más ocasiones de que alguien plantee una pregunta que nadie puede responder con seguridad. Si quiere ver en la práctica cómo encajan los dashboards en este problema, la guía interna sobre dashboards de calidad de datos muestra por qué la visibilidad superficial a menudo se queda corta frente a un control real.
Regla práctica: si una métrica necesita una reunión para explicarse, todavía no es información.
El modelo mental adecuado es la latencia, no el volumen. Una empresa puede poseer una gran cantidad de datos y aun así tardar en decidir porque los datos llegan tarde, carecen de contexto o no se han contrastado con las reglas de negocio que los hacen fiables. Por eso DRIP tiene menos que ver con el almacenamiento y más con el camino que va de la señal a la acción.
De dónde procede la expresión y por qué sigue siendo relevante
La expresión “data rich and information poor” (rico en datos y pobre en información) existe desde hace décadas porque este modo de fallo vuelve una y otra vez con otro aspecto. Se popularizó con el libro de gestión empresarial de 1983 In Search of Excellence, donde resumía un problema de gestión sencillo: las organizaciones pueden acumular datos sin convertirlos en información utilizable. Comentarios posteriores sobre la misma idea la vincularon a una estimación de 2010 según la cual la economía estadounidense perdía 997 000 millones de dólares al año por la sobrecarga de información, tomando como base de esa estimación a 78,6 millones de trabajadores del conocimiento a tiempo completo, y por eso la expresión sigue calando hoy en los consejos de administración y en los equipos de analítica (panorámica histórica de la expresión y de la estimación de 2010).
Por qué la expresión sobrevive a cada ciclo de herramientas
La expresión sobrevivió al BI, al big data y ahora a la IA porque las herramientas cambiaron más rápido que el problema de fondo. Un data warehouse puede centralizar los datos, un dashboard puede resumirlos y un modelo puede puntuarlos, pero ninguno de esos pasos garantiza que el resultado sea oportuno, explicable o lo bastante fiable como para actuar. Por eso la expresión sigue teniendo cabida en cualquier debate serio sobre analítica en 2025, sobre todo cuando los equipos siguen añadiendo sistemas más rápido de lo que mejoran el proceso de decisión.
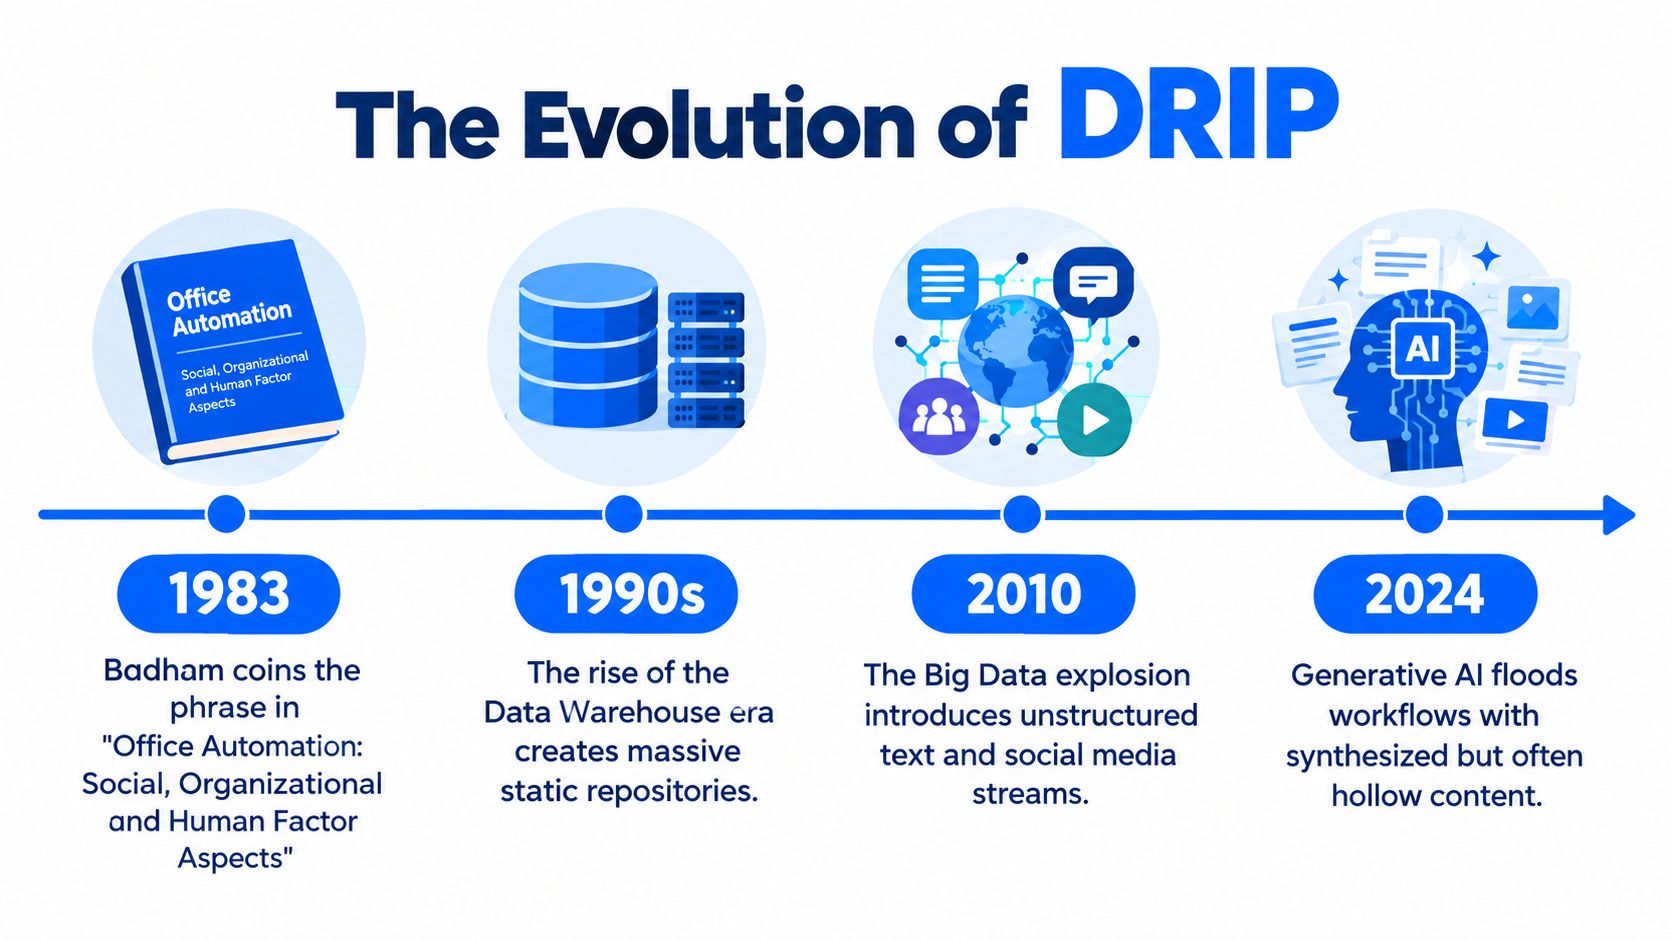
La expresión perdura porque el síntoma no deja de cambiar de forma, no porque el diagnóstico esté desfasado.
El giro moderno es la IA. Las herramientas generativas pueden producir más resúmenes, más previsiones y más texto, pero si los datos de base están desactualizados o no son fiables, el resultado sigue estando vacío. DRIP sigue siendo la abreviatura adecuada porque señala el fallo real: la información no llega en una forma que las personas puedan utilizar con seguridad.
Qué causa la brecha entre datos e información
La causa más habitual es la fragmentación. Una sola pregunta de negocio suele depender de datos repartidos entre data warehouses, aplicaciones SaaS, almacenes operativos y hojas de cálculo, lo que significa que la respuesta tiene que atravesar varios ámbitos de responsabilidad antes de que nadie pueda confiar en ella. En esa situación, el retraso no es solo técnico, sino también interpretativo, porque cada traspaso añade otra oportunidad de que las definiciones diverjan.
Cuatro causas estructurales que aparecen en equipos reales
La brecha suele deberse a una combinación de fragmentación, proliferación de herramientas, sobrecarga y latencia. Una forma útil de analizar el problema es comparar la causa estructural con el síntoma que genera.
Causa | Escala habitual en 2025 | Síntoma operativo |
|---|---|---|
Fragmentación de los datos | Muchos sistemas, cada uno con una parte de la respuesta | Los equipos discuten sobre qué tabla es la de referencia |
Proliferación de herramientas | Varias herramientas de analítica y observabilidad en paralelo | No hay una visión compartida de la calidad, la actualidad o el linaje |
Sobrecarga de información | Demasiados dashboards y métricas compitiendo por la atención | Las reuniones se llenan de cifras, pero no se toma ninguna decisión |
Latencia de procesamiento | Los datos llegan cuando la ventana de decisión ya ha pasado | Los responsables actúan con cifras desactualizadas o esperan a una actualización manual |
El problema de la sobrecarga no es abstracto. Los informes actuales sobre el entorno laboral indican que los trabajadores del conocimiento sufren interrupciones constantes y que muchos equipos dedican tiempo a buscar entre aplicaciones en lugar de actuar sobre el resultado (resumen sobre la sobrecarga en el trabajo). Dicho de otro modo, la empresa no solo tiene más datos, sino también más fricción entre la pregunta y la respuesta.
Una lectura relacionada útil es el análisis del blog de Artul.ai sobre por qué fallan los resúmenes de las conferencias de resultados, porque muestra el mismo patrón en otro contexto: la materia prima existe, pero el relato utilizable no aflora con claridad.
Por qué la latencia importa más que el volumen de datos
Los pipelines batch siguen predominando en muchos entornos, por lo que la decisión a menudo se toma antes de que lleguen los datos más recientes. Eso crea un desfase temporal. Un responsable ve un KPI, supone que refleja el presente y toma una decisión con datos que quizá ya estén desactualizados. El problema no es que a la empresa le falten señales. Es que la señal llega demasiado tarde a la decisión, despojada del contexto necesario para interpretarla.
Si quiere reducir esa brecha, la panorámica interna sobre fuentes de datos dispares es una perspectiva útil, porque permite ver con más claridad el coste de las entradas dispersas.
El coste real para el negocio de ser rico en datos y pobre en información
La mala calidad de los datos no solo molesta a los analistas. Genera una escalera de costes que se vuelve más empinada cada vez que los datos erróneos avanzan hacia los procesos posteriores. Una estimación del sector muy citada afirma que la mala calidad de los datos cuesta a las organizaciones una media de 12,9 millones de dólares al año, y el estudio de D&B citado por la misma fuente describe una escalada de 1 dólar, 10 dólares y 100 dólares, en la que la prevención cuesta alrededor de 1 dólar por registro, la identificación y resolución de un problema cuesta alrededor de 10 dólares por registro y la corrección de un error a posteriori cuesta alrededor de 100 dólares por registro (escalada de costes e impacto en la empresa).
El coste empieza siendo pequeño y luego se multiplica rápidamente
Esa escalada explica por qué la detección tardía hace tanto daño. Un valor erróneo detectado durante la validación es barato. El mismo valor erróneo utilizado en un dashboard es más caro. Una vez que llega a un motor de precios, a un informe de cumplimiento o a un flujo de trabajo de cara al cliente, la factura de la reparación se dispara, porque hay que rastrear el problema, explicar el impacto en el negocio y deshacer las decisiones posteriores.
Fase | Coste por registro | Desencadenante habitual | Ejemplo |
|---|---|---|---|
Prevención | 1 dólar | Validación antes de que los datos erróneos entren en el pipeline | Una regla bloquea un código no válido en la ingesta |
Identificación y corrección | 10 dólares | Los analistas encuentran y solucionan el problema después de que aparezca | Una carga fallida se atribuye a un archivo mal formado |
Corrección tras el impacto | 100 dólares | El error llega a un informe, un flujo de trabajo o un proceso regulatorio | Un valor erróneo altera una decisión de precios o de cumplimiento |
Una corrección barata es la que se detecta antes de que se propague.
El coste oculto es la pérdida de oportunidades. Si un equipo pasa días conciliando la verdad, pierde la ocasión de actuar mientras el mercado sigue moviéndose. Un minorista con un motor de precios vinculado a una tabla de costes de hace seis meses puede no detectar el error hasta que los márgenes se desvían o un competidor le obliga a reaccionar. Para entonces, el daño no es solo el precio erróneo. Es la confianza en las cifras que pierde el equipo directivo.
Por eso DRIP es un impuesto sobre la latencia de las decisiones. Se paga con reacciones más lentas, más trabajo de conciliación y más reuniones dedicadas a demostrar que los datos son reales en lugar de decidir qué hacer a continuación. El caso de negocio de la calidad de datos interno es relevante aquí, porque la economía solo mejora cuando los equipos reducen la propagación, no solo la limpieza.
Cómo diagnosticar su propia situación DRIP
No necesita una encuesta para saber si su equipo se encuentra en territorio DRIP. Necesita buscar los síntomas que aparecen en el trabajo diario. El más claro es la falta de actualidad, fácil de detectar cuando la actualización de un dashboard incumple su nivel de servicio sin que nadie lo note o cuando la marca de tiempo de un informe lleva semanas sin moverse. Si la cifra parece actual pero la carga que hay detrás no lo es, el dashboard es decorativo.
Cinco señales que suelen aparecer juntas
Falta de actualidad: la actualización llega tarde, la marca de tiempo no ha cambiado o la última ejecución no se completó a tiempo.
Cambios de distribución silenciosos: un KPI cambia de forma sin un motivo de negocio evidente.
Deriva de esquema: una tabla de origen añade, elimina o renombra campos y la lógica posterior sigue ejecutándose.
Fallos de entrega que se parchean a mano: alguien vuelve a cargar el archivo, edita la extracción o relanza el proceso sin corregir la causa raíz.
Movimientos de KPI sin explicación: las reuniones siguen girando en torno a la misma cifra porque nadie se fía de la subida o la bajada.
Las comprobaciones más rápidas son también las más útiles. Las comprobaciones de actualidad le indican si los datos llegaron cuando se esperaba. La puntuación estadística de anomalías le indica si el patrón cambió de una forma que deberían revisar las personas. La comparación de esquemas muestra los cambios estructurales antes de que rompan los consumidores posteriores. El triaje basado en el linaje le indica dónde empezó la rotura en lugar de dejar que los equipos lo adivinen. La referencia interna sobre métricas de data observability es un buen complemento si quiere vincular esas comprobaciones con señales operativas.
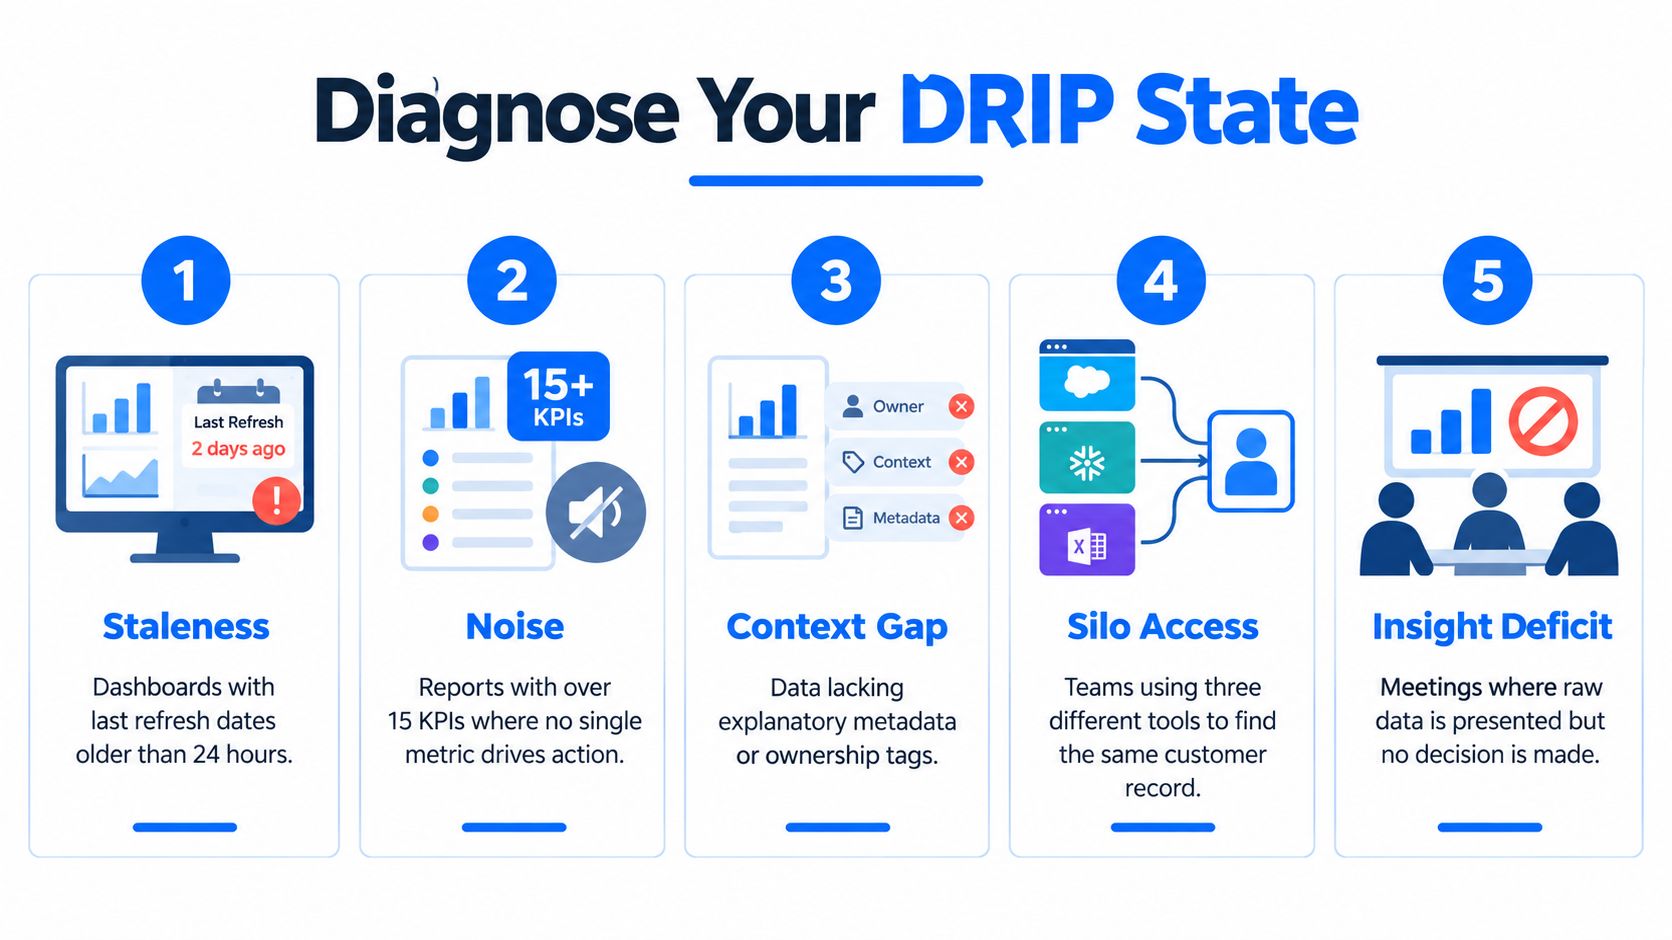
Un pequeño ejemplo del sector minorista que pone de manifiesto el patrón
Un equipo de analítica de un minorista observa una caída de ingresos, una fuente del data warehouse que llega tarde y un cambio de nombre de columna en la tabla de productos de origen. Ninguna de esas señales por sí sola demuestra que el pipeline esté roto. Juntas, apuntan a un único proceso ETL fallido que nadie señaló porque el informe seguía mostrándose y el error quedaba oculto tras un parche manual.
Si se cumplen más de dos de esas cinco señales, ya se encuentra en territorio DRIP. En ese punto, el problema no es si los datos existen. El problema es si la organización puede confiar en ellos lo bastante rápido como para actuar.
Cinco controles operativos que cierran la brecha
Un dashboard puede parecer sano mientras el pipeline subyacente ya se está desviando. Los controles son los que detectan esa deriva antes de que la gente empiece a discutir sobre qué cifra es la real. Cada uno cubre un modo de fallo distinto. La gobernanza aclara la responsabilidad y el linaje. La observabilidad saca a la luz comportamientos inesperados. La puntualidad mantiene visible la latencia. La validación bloquea los registros erróneos antes de que se propaguen. El seguimiento de esquemas detecta los cambios estructurales antes de que los sistemas posteriores interpreten mal los datos.
Control | Síntoma DRIP que resuelve | Implementación mínima viable | Modo de fallo si se omite |
|---|---|---|---|
Gobernanza | Confusión sobre la responsabilidad y el linaje | Asignar responsables, definir los elementos de datos críticos, mantener el linaje | Teatro burocrático sin responsabilidad operativa |
Observabilidad | Anomalías silenciosas y cargas que faltan | Comprobaciones continuas de anomalías y actualidad en las tablas críticas | Los equipos solo detectan los problemas cuando los dashboards ya fallan |
Puntualidad | Resultados desactualizados | Establecer SLA de actualidad para los pipelines clave y alertas cuando se incumplan las ventanas | Datos exactos que llegan demasiado tarde para ser útiles |
Validación | Registros erróneos que se propagan a los procesos posteriores | Comprobaciones de reglas de negocio en la ingesta y antes de la transformación | Los errores se extienden a los informes, al cumplimiento y a las entradas de la IA |
Seguimiento de esquemas | Deriva estructural | Comparar el esquema entrante con la estructura esperada en cada carga | Los procesos posteriores fallan silenciosamente o interpretan mal los datos |
Los controles funcionan en conjunto, no de forma escalonada
La gobernanza sin observabilidad se convierte en papeleo de procesos. La observabilidad sin validación detecta un síntoma, pero sigue dejando pasar los datos erróneos. La validación sin puntualidad produce datos limpios que llegan cuando la ventana de decisión ya se ha cerrado. El seguimiento de esquemas sin responsables genera una alerta, pero nadie es claramente responsable de la corrección.
Por eso los equipos necesitan un conjunto de controles, no una solución única. Un patrón práctico es digna, que ejecuta comprobaciones de calidad de datos y de observabilidad dentro del entorno del cliente en anomalías, puntualidad, validación, seguimiento de esquemas y monitorización del negocio.
El objetivo es acortar el intervalo entre un cambio en los datos y una decisión segura sobre qué hacer a continuación. Un pipeline lento, un cambio de esquema oculto o una carga fallida deberían aflorar como un problema de confianza, no como una sorpresa en la revisión semanal. Cuando estos controles funcionan en conjunto, el dashboard deja de actuar como una alarma y empieza a funcionar como una superficie de confianza para el negocio.
De las fábricas de reglas a la observabilidad basada en IA en la práctica
Un fabricante multinacional puede pasar los viernes escribiendo a mano comprobaciones de umbrales para las fuentes de sensores y descubrir el lunes que las reglas ya estaban desfasadas. Ese modelo no escala cuando el entorno contiene millones de señales, sobre todo cuando comentarios recientes sobre el sector manufacturero sostienen que se utiliza menos del 1 % de los datos diarios de las fábricas para tomar decisiones (DRIP en la industria manufacturera y el problema del contexto). Las fábricas de reglas manuales convierten a los ingenieros en personal de mantenimiento y, aun así, pasan por alto los momentos que importan.
Qué cambia cuando la observabilidad aprende la línea base
La observabilidad basada en IA sustituye los umbrales rígidos por líneas base aprendidas, de modo que un monitor puede señalar una nueva rotura cuando la cardinalidad, la actualidad o el comportamiento del esquema se salen de los patrones normales. Esto importa cuando el fallo es nuevo. Una regla escrita para el pipeline del mes pasado no detectará una nueva disposición de campos ni un patrón de retraso inesperado, pero un monitor adaptativo sí puede llamar la atención sobre ello, como se explica en esta guía sobre cómo detecta la IA anomalías de datos en los pipelines de datos.
Un contraste útil es el siguiente:
Capacidad | Fábrica de reglas | Observabilidad basada en IA |
|---|---|---|
Configuración de umbrales | Redactados a mano por ingenieros | Aprende el comportamiento normal a partir de los datos |
Detección de cambios | Solo detecta modos de fallo conocidos | Señala cambios nuevos en volumen, actualidad o esquema |
Carga de mantenimiento | Alta, porque las reglas quedan obsoletas rápidamente | Menor, porque las líneas base se actualizan con el conjunto de datos |
Calidad de las alertas | A menudo ruidosas o frágiles | Más centradas en desviaciones con mucha señal |
Uso por parte de los equipos | Centralizado en ingeniería | Lo bastante modular para que lo utilicen los equipos de dominio |
La contrapartida es real. La IA reduce la fatiga de alertas y detecta patrones desconocidos, pero sigue necesitando supervisión. Las líneas base pueden desviarse, los modelos pueden quedar obsoletos y un sistema inteligente sigue necesitando personas que revisen las excepciones, confirmen la causa raíz y trasladen el resultado a la gobernanza. Ese ciclo de retroalimentación importa más que la propia alerta.
Una mejor automatización no elimina la responsabilidad, sino que la adelanta.
Las configuraciones más sólidas combinan la detección basada en modelos con una puntuación de actualidad que tiene en cuenta el linaje y con monitores modulares que los equipos de dominio pueden componer sin abrir un ticket para cada nueva regla. Esto es práctico a escala, porque el coste de la comprobación manual ya ha superado el valor que aporta.
Sus primeros pasos para llegar a ser rico en información
Añadir otro dashboard suele agravar el problema DRIP si el nuevo gráfico no está respaldado por validación, linaje o un contrato de actualidad. Cada vista adicional puede convertirse en otro lugar donde discutir sobre la cifra en lugar de en otra forma de confiar en ella. El primer paso no es informar de más cosas, sino acortar el ciclo de retroalimentación.
Una secuencia práctica de 90 días
Designe a los responsables: asigne una persona responsable a cada conjunto de datos crítico y a cada KPI de negocio.
Redacte el contrato: defina qué significa “bueno” para las tablas clave, incluidas la actualidad y los valores aceptados.
Instrumente el pipeline de mayor riesgo: añada detección de anomalías y comprobaciones de actualidad a la fuente de ingresos o de operaciones que más importe.
Añada validación en el punto de entrada: compruebe los registros en CI o en la ingesta antes de que los valores erróneos se propaguen.
Haga un seguimiento de los cambios de esquema: genere alertas sobre campos nuevos, que faltan o renombrados antes de que fallen los consumidores.
Elija un KPI de extremo a extremo: sígalo desde el origen hasta el dashboard para que cada paso sea visible.
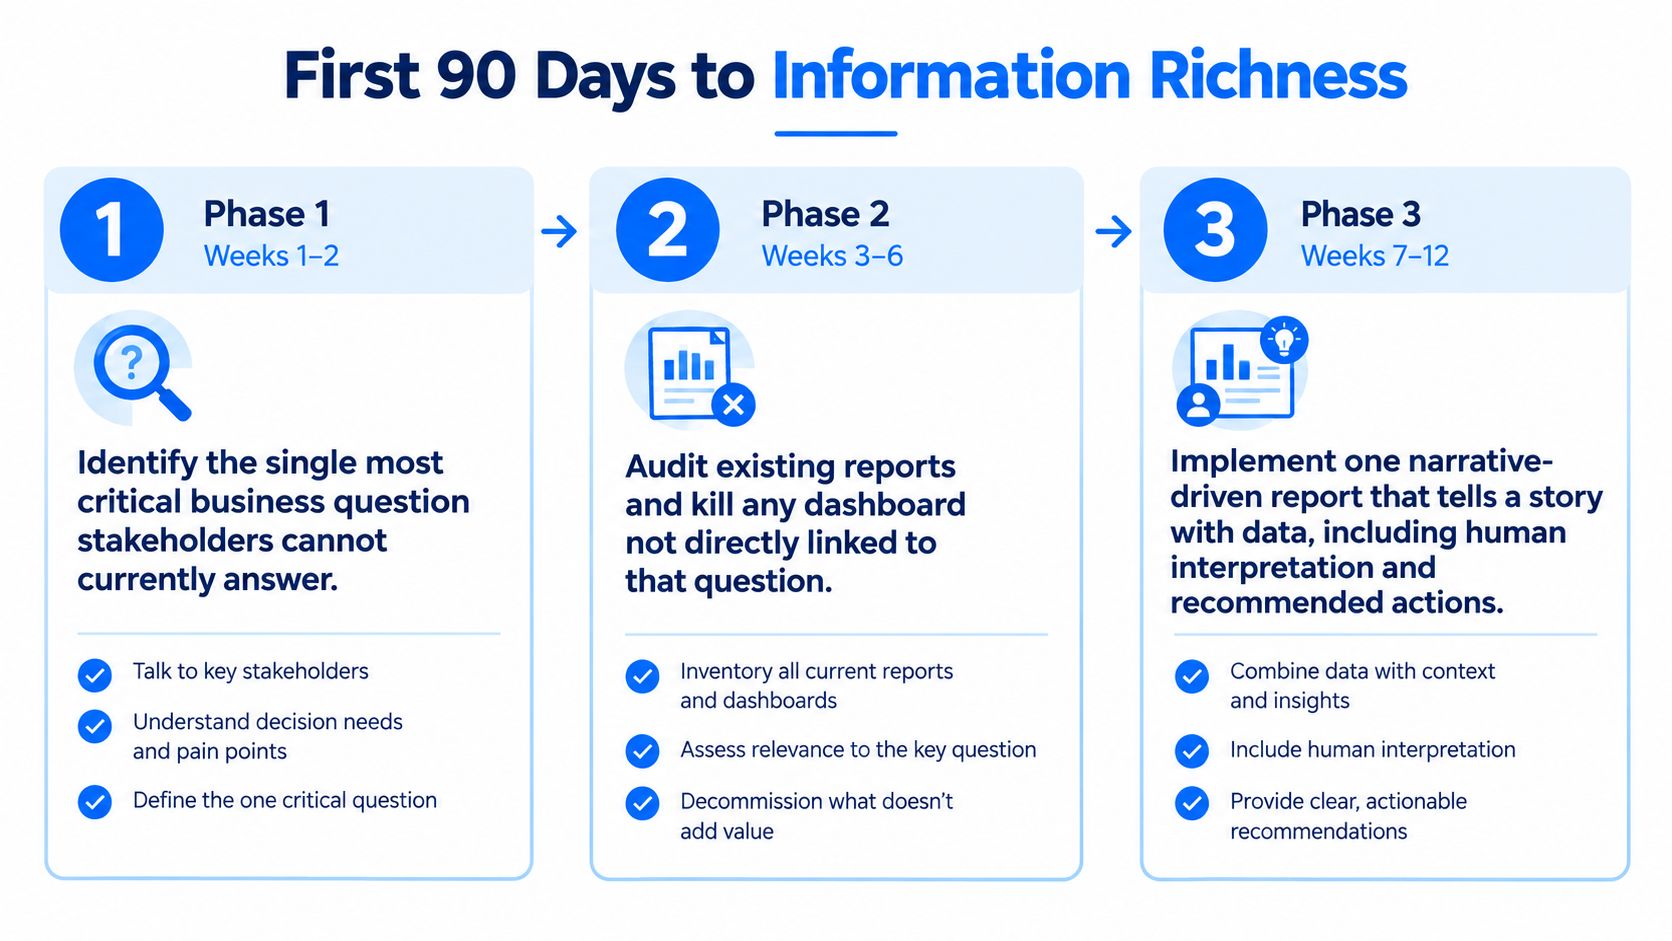
El punto de partida más sencillo es una decisión semanal que el equipo ya toma. Instrumente los datos que la sustentan para que la respuesta pueda defenderse sin prisas de última hora. Si el equipo puede explicar la cifra, confiar en ella y actuar en consecuencia en la misma reunión, está saliendo del problema DRIP y avanzando hacia la riqueza de información.
Si intenta convertir los datos en algo en lo que el negocio pueda confiar, digna le ofrece los controles para hacerlo: detección de anomalías, monitorización de la puntualidad, validación, seguimiento de esquemas y monitorización del negocio dentro de su propio entorno. Visite digna para ver cómo esos controles pueden ayudar a cerrar la brecha entre los datos en bruto y la siguiente decisión.
Para que las ventanas de actualidad y las cargas que faltan sean visibles antes de que un KPI desactualizado llegue a la revisión semanal, descubra cómo digna Timeliness aprende cuándo se espera que llegue cada conjunto de datos.
Preguntas frecuentes
¿Qué significa ser rico en datos y pobre en información?
Ser rico en datos y pobre en información, o DRIP (data rich, information poor), describe la brecha entre la cantidad de datos que recopila una empresa y la cantidad de información lista para decidir en la que puede confiar. Los datos en bruto son una fila, un evento o una línea de registro; la información es esa señal con contexto, actualidad, un responsable y la explicación suficiente para respaldar una acción.
¿De dónde procede la expresión “data rich, information poor”?
Se popularizó con el libro de gestión empresarial de 1983 In Search of Excellence. Comentarios posteriores la vincularon a una estimación de 2010 según la cual la sobrecarga de información costaba a la economía estadounidense 997 000 millones de dólares al año, sobre la base de 78,6 millones de trabajadores del conocimiento a tiempo completo, y por eso la expresión sigue resonando en los equipos de analítica.
¿Qué hace que las organizaciones sean ricas en datos y pobres en información?
Suelen combinarse cuatro causas estructurales: la fragmentación de los datos entre data warehouses, aplicaciones SaaS y hojas de cálculo; la proliferación de herramientas sin una visión compartida de la calidad o el linaje; la sobrecarga de información por exceso de dashboards; y la latencia de procesamiento, cuando los pipelines batch entregan los datos una vez que la ventana de decisión ya ha pasado.
¿Cuánto le cuesta a una empresa la mala calidad de los datos?
Una estimación muy citada sitúa la media en 12,9 millones de dólares al año. Además, el coste aumenta con el tiempo: alrededor de 1 dólar por registro para prevenir un error, 10 dólares para identificarlo y corregirlo, y 100 dólares para corregirlo después de que llegue a un informe, a un motor de precios o a un proceso de cumplimiento.
¿Cómo puedo saber si mi equipo es rico en datos y pobre en información?
Busque cinco señales: dashboards desactualizados, cambios de distribución silenciosos, deriva de esquema, fallos de entrega parcheados a mano y movimientos de KPI que nadie sabe explicar. La regla del artículo es que, si se cumplen más de dos, su equipo ya está en territorio DRIP y no puede confiar en sus datos con la rapidez suficiente.



