¿Qué es una plataforma de datos?
|
8
minuto de lectura

Una plataforma de datos es el conjunto integrado de herramientas e infraestructura que una organización utiliza para ingerir, almacenar, procesar, gobernar y servir datos para analítica e IA. El mercado global de plataformas de datos se estimó en 82.400 millones de USD en 2024 y se prevé que supere los 210.000 millones de USD para 2031, con una tasa de crecimiento anual compuesta del 14,5% durante ese período de pronóstico, según el resumen del mercado de plataformas de datos de 6Wresearch.
Es posible que su equipo de producto ya esté conviviendo con el problema. Una exportación de CRM llega como una hoja de cálculo, una réplica de Postgres contiene datos de la aplicación, las plataformas de publicidad entregan archivos CSV y un tablero de Looker se rompe repentinamente porque alguien cambió el nombre de un campo. Cada fuente funciona por su cuenta, pero nadie puede explicar fácilmente qué versión es la actual, quién puede usarla, si llegó a tiempo o por qué cambió una métrica.
El problema no suele ser los datos en sí. Es la ausencia de un sistema operativo conectado para los datos.
Tabla de contenidos
Una definición en lenguaje sencillo de una plataforma de datos
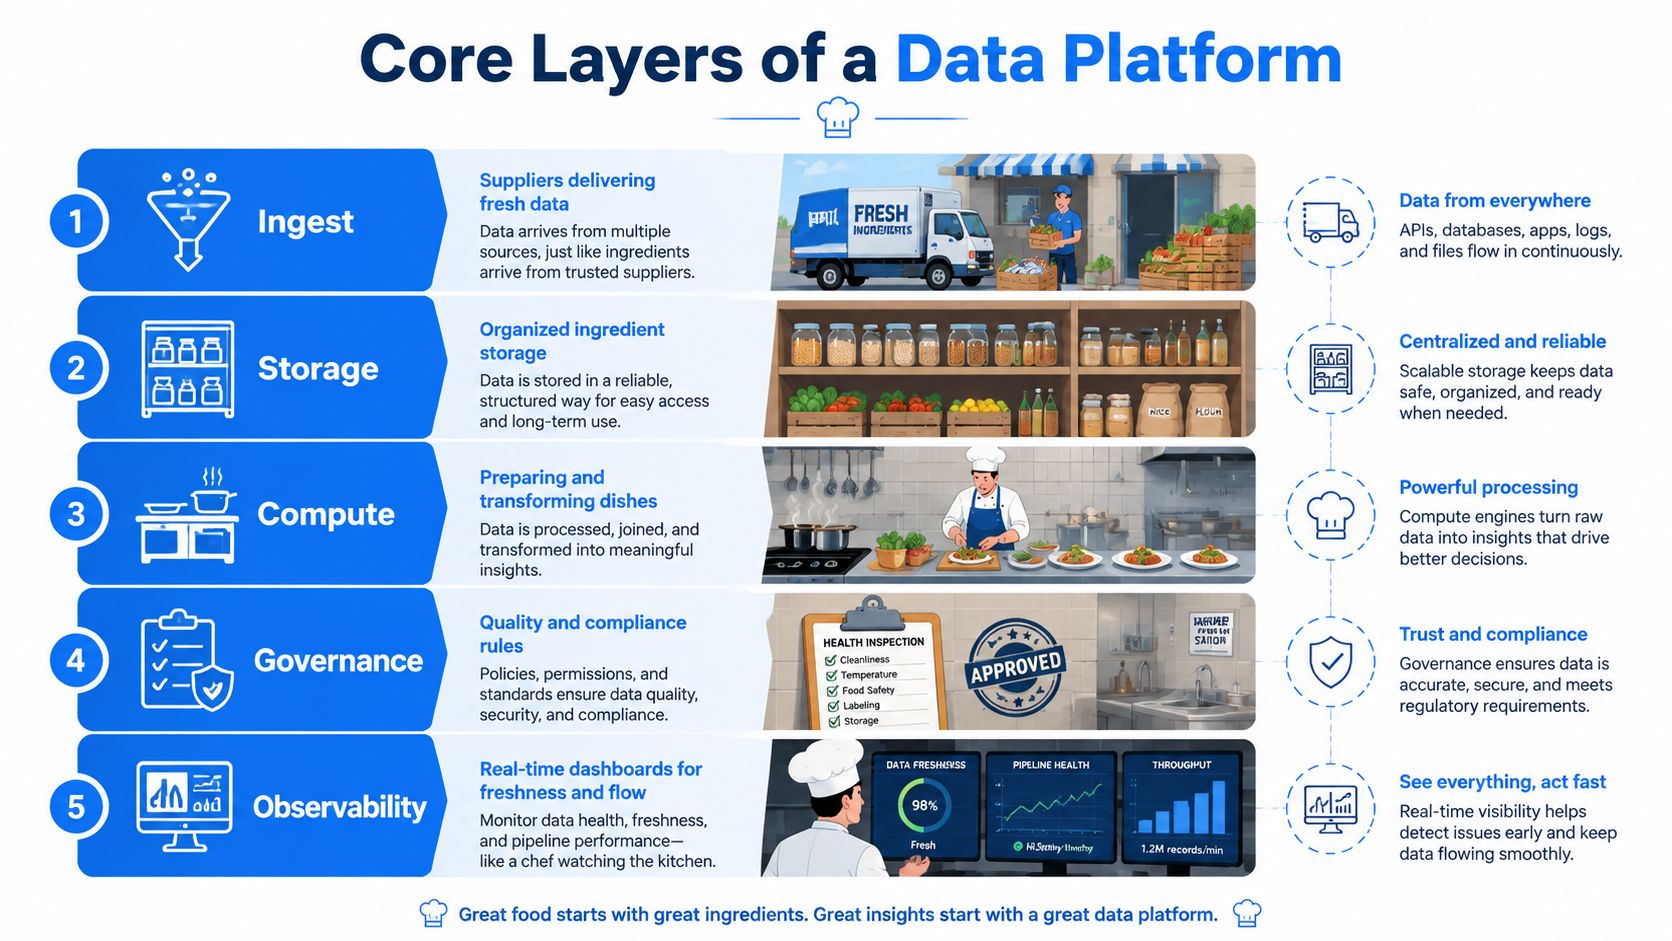
Las capas principales que proporciona toda plataforma de datos
La ingesta es el muelle de carga
El almacenamiento es la despensa y la cámara frigorífica
El procesamiento es la cocina
La gobernanza es el inspector y el libro de recetas
La Observability es el panel de control de la cocina
Cómo evolucionaron las plataformas de datos hasta convertirse en lo que son hoy
Comparación entre almacenes, lagos y lagos de datos (lakehouses)
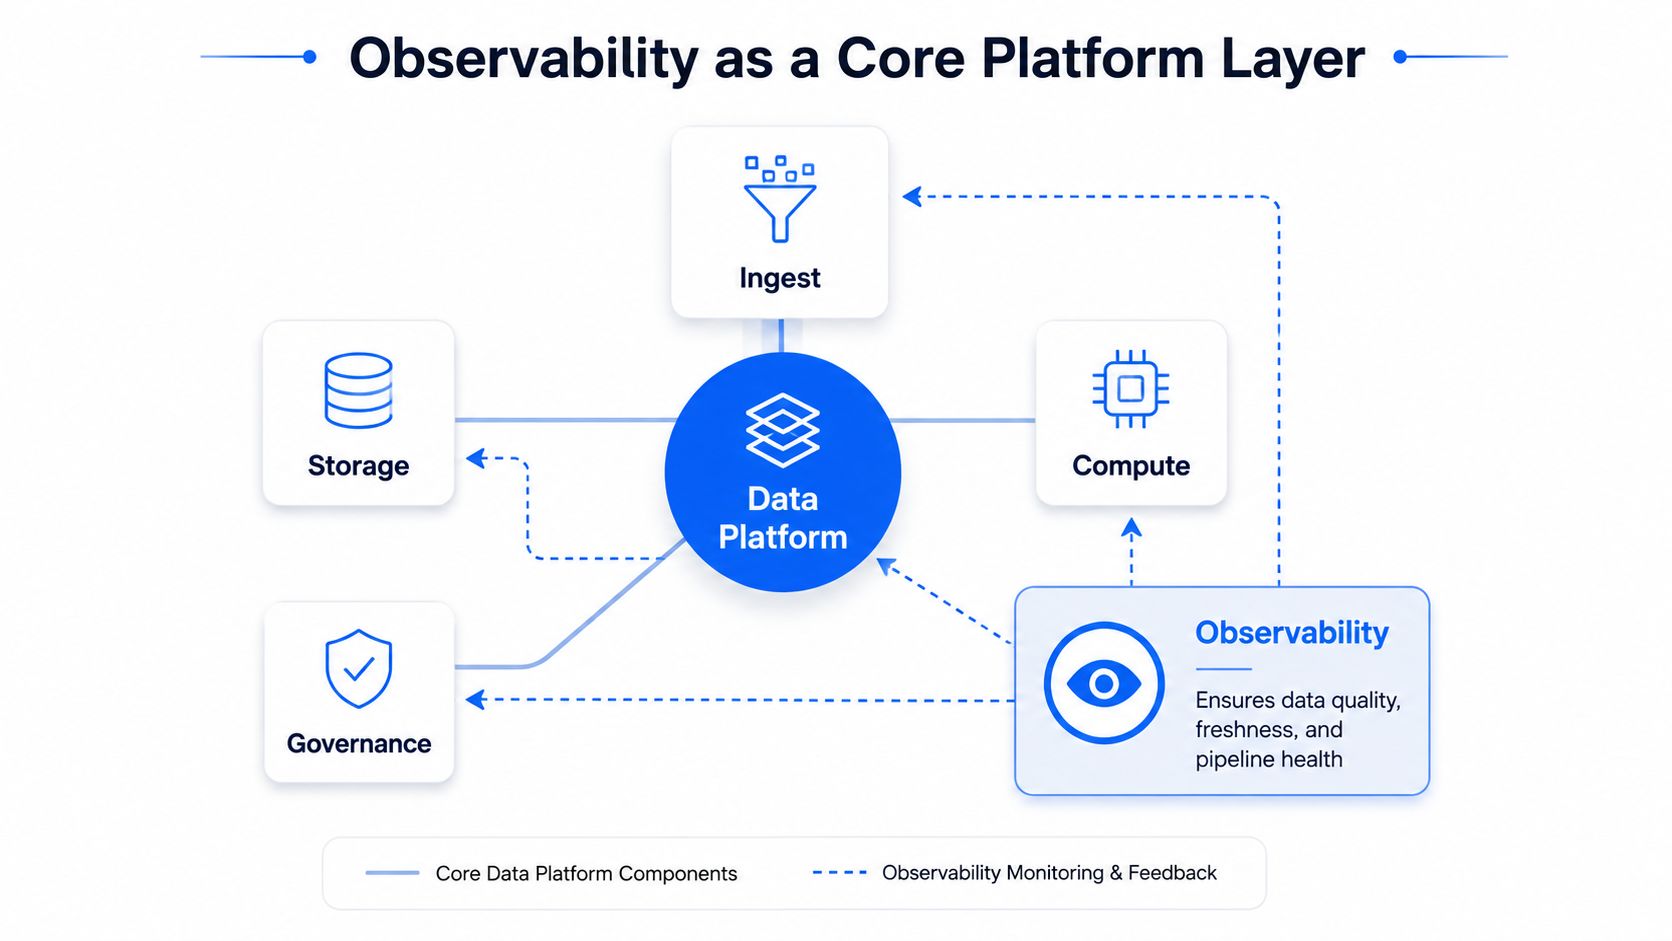
Por qué la Observability pertenece al interior de la plataforma
Los fallos que los equipos no ven a tiempo
La calidad y la Observability responden a preguntas diferentes
Plataformas de datos en la práctica a través de las industrias
Una lista de verificación práctica para evaluar su plataforma
Ingesta y almacenamiento
Procesamiento y modelado
Gobernanza y acceso
Observability y fiabilidad
Una definición en lenguaje sencillo de una plataforma de datos
Piense en una plataforma de datos como la cadena de suministro de datos compartida de la organización. Recibe información de los sistemas operativos, la almacena en formatos adecuados, la prepara para su uso, aplica reglas de acceso y significado, y expone resultados de confianza a analistas, aplicaciones y sistemas de IA.
Esa definición tiene una implicación importante: una plataforma de datos no es necesariamente un solo producto. Es una colección integrada de infraestructura, servicios, políticas e interfaces. Un almacén de datos (warehouse) puede proporcionar almacenamiento y procesamiento SQL, mientras que servicios independientes gestionan la ingesta, la transformación, el catalogado, el control de acceso y la supervisión. Esas piezas se convierten en una plataforma cuando funcionan juntas como un sistema confiable en lugar de como herramientas desconectadas.
A nivel práctico, hágase cinco preguntas:
¿Pueden llegar los datos de forma fiable? Esta es la capa de ingesta, que abarca archivos, APIs, eventos de aplicaciones y captura de datos modificados (CDC).
¿Dónde residen? El almacenamiento puede incluir tablas de almacenes de datos, almacenamiento de objetos, tablas de lakehouse o almacenes especializados en tiempo real.
¿Cómo se preparan? El procesamiento (compute) ejecuta consultas, transformaciones, agregaciones y cargas de trabajo de aprendizaje automático.
¿Qué significan los datos y quién puede utilizarlos? La gobernanza gestiona las definiciones, el linaje, el catalogado, los permisos y los registros de auditoría.
¿Cómo saben los equipos si el sistema está sano? La Observability realiza un seguimiento de la frescura, los cambios de esquema, las anomalías, el comportamiento de las tuberías de datos (pipelines) y el impacto río abajo (downstream).
Las directrices de arquitectura empresarial suelen describir este tipo de plataforma como un software que ayuda a los usuarios a almacenar, acceder, gestionar y gobernar los datos empresariales tanto en el plano de datos como en el plano de control de datos, tal como se describe en el análisis de mercado de plataformas de datos de IDC.
Por lo tanto, una plataforma de datos no es solo una base de datos, porque una base de datos puede almacenar datos sin gestionar su ciclo de vida completo. Tampoco es solo una herramienta de BI, porque los tableros consumen datos preparados en lugar de gestionar la ingesta y la gobernanza. Tampoco es automáticamente una suite de un único proveedor. La característica definitoria es la integración.
Para un marco empresarial más amplio, esta descripción general de las plataformas de datos empresariales es útil. La pregunta central sigue siendo sencilla: ¿puede su organización pasar del sistema de origen a una decisión de confianza sin tener que coser manualmente cada etapa?
Las capas principales que proporciona toda plataforma de datos
Un restaurante hace que la arquitectura sea más fácil de entender. Los proveedores entregan los ingredientes, el personal los almacena, los cocineros preparan los platos, los inspectores hacen cumplir las normas y los gerentes vigilan el funcionamiento para detectar indicios de problemas. Una plataforma de datos sigue el mismo patrón.
La ingesta es el muelle de carga
La ingesta introduce la materia prima en la plataforma. Las fuentes pueden incluir eventos de aplicaciones, APIs, archivos, réplicas de bases de datos o flujos de captura de datos modificados. Kafka puede transportar flujos de eventos, mientras que los conectores y las tareas programadas pueden cargar archivos y registros operativos.
El muelle de carga necesita algo más que una puerta. Necesita horarios de recepción, identificación del origen, gestión de fallos y un registro de lo que ha llegado. Sin esos controles, una plataforma puede aceptar datos pero dejar al equipo sin poder saber si una entrega se completó.
Las organizaciones que necesitan conectar sistemas externos suelen evaluar los servicios de API de datos junto con conectores nativos y herramientas de eventos. La elección correcta depende de la variedad de las fuentes, las necesidades de latencia y la cantidad de lógica de pipelines que el equipo interno desee gestionar por sí mismo.
El almacenamiento es la despensa y la cámara frigorífica
El almacenamiento preserva los ingredientes en formatos que se adaptan a diferentes trabajos. Amazon S3 puede albergar objetos estructurados y no estructurados, mientras que Snowflake puede organizar tablas analíticas curadas. Un lakehouse puede colocar formatos de tabla transaccionales sobre el almacenamiento de objetos para que los equipos puedan trabajar con conjuntos de datos grandes y diversos manteniendo una gestión de tablas más robusta.
Las decisiones de almacenamiento afectan al coste, la velocidad de acceso, la retención y la gobernanza. Es posible que los datos brutos deban permanecer cerca de su forma original para la exploración, mientras que los datos curados deben organizarse para un uso empresarial repetible.
El procesamiento es la cocina
El procesamiento convierte los datos almacenados en algo útil. Los motores de SQL responden preguntas, los marcos de transformación como dbt construyen conjuntos de datos modelados y los motores de procesamiento distribuido preparan los datos para cargas de trabajo complejas o aprendizaje automático.
La distinción importante es que el almacenamiento guarda los ingredientes, mientras que el procesamiento realiza el trabajo. Separarlos puede permitir a los equipos escalar el procesamiento y el almacenamiento de forma independiente, pero también crea límites operativos que necesitan una propiedad clara.
La gobernanza es el inspector y el libro de recetas
La gobernanza define quién puede acceder a los datos, qué significa una métrica, de dónde procede un conjunto de datos y qué controles se le aplican. Unity Catalog, el control de acceso basado en roles, el control de acceso basado en atributos, el registro de auditoría, los catálogos y las herramientas de linaje pueden respaldar estas responsabilidades.
La gobernanza también protege la consistencia. Si un equipo define "cliente activo" de forma diferente a otro, ambos tableros pueden ser técnicamente correctos pero producir decisiones contradictorias.
La Observability es el panel de control de la cocina
La Observability muestra si las entregas llegaron, si el almacenamiento está disponible, si las transformaciones se completaron correctamente y si los resultados siguen siendo de confianza. Herramientas como Monte Carlo pueden supervisar el comportamiento de los datos, mientras que las métricas y alertas nativas de la plataforma proporcionan contexto operativo.
Las directrices de arquitectura orientadas a IBM tratan la Observability como una capa fundamental de la plataforma de datos porque los equipos necesitan visibilidad sobre la confianza, la Timeliness y el comportamiento de las tuberías de datos, y no meramente sobre el éxito de una tarea. Un pipeline puede finalizar con éxito y, aun así, publicar datos obsoletos, incompletos o con cambios estructurales.
En esta guía de arquitectura de sistemas de datos se presenta una perspectiva arquitectónica muy útil. La lección es sencilla: mover datos es solo una parte del trabajo. Una plataforma que funcione también debe explicar, proteger e inspeccionar continuamente lo que mueve.
Cómo evolucionaron las plataformas de datos hasta convertirse en lo que son hoy
Las plataformas de datos evolucionaron a través de compensaciones recurrentes en lugar de una secuencia limpia de tecnologías que se reemplazaban unas a otras. Los equipos han equilibrado repetidamente la disciplina de esquemas, la flexibilidad, la velocidad analítica, el coste de infraestructura y la gobernanza.
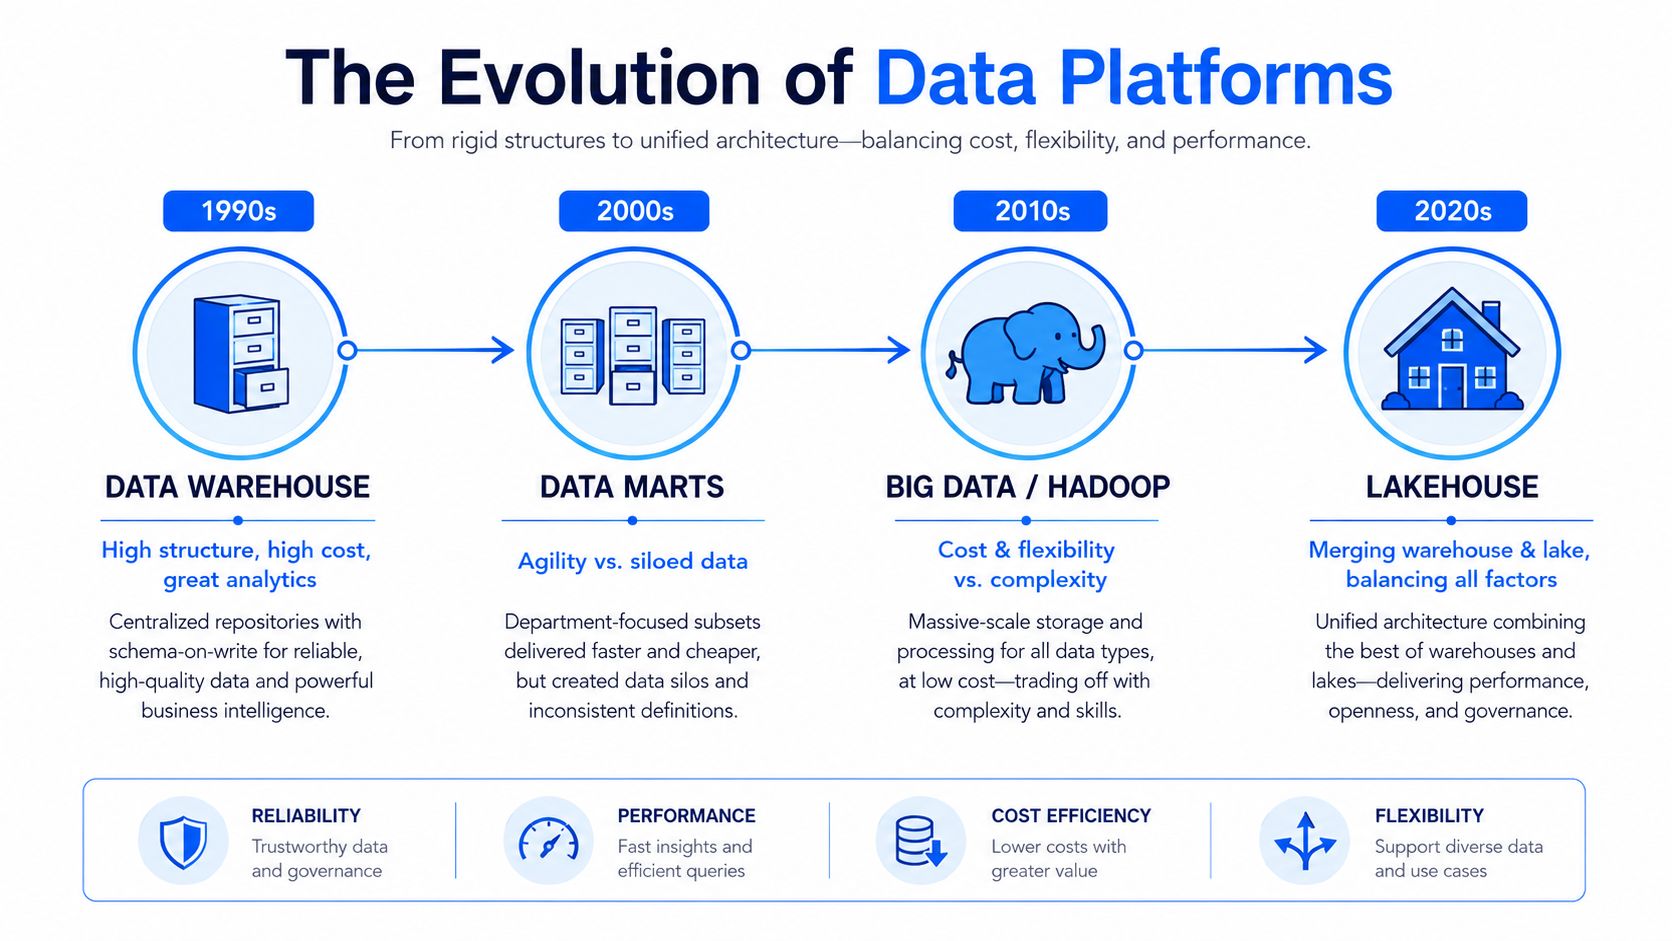
El almacén de datos (data warehouse) estableció un modelo centralizado para la generación de informes. Las organizaciones consolidaron la información de múltiples sistemas en esquemas estructurados, ofreciendo a los analistas una visión unificada del negocio. Este enfoque permitía un análisis SQL fiable, pero los esquemas rígidos y los costosos servidores locales (on-premises) hacían que los cambios fueran difíciles y lentos.
Los almacenes de datos departamentales (data marts) introdujeron una mayor flexibilidad local. Los departamentos individuales podían dar forma a los datos para sus propias necesidades de informes, pero esa misma flexibilidad podía crear lógica duplicada y definiciones en conflicto. Un data mart de finanzas y uno de marketing podían calcular una medida empresarial de forma diferente, incluso cuando ambos partían de fuentes similares.
El lago de datos (data lake) respondió a la necesidad de un almacenamiento más económico y amplio. El almacenamiento de objetos y Hadoop hicieron viable la retención de archivos estructurados y no estructurados, registros (logs), eventos y otros formatos sin tener que modelarlo todo antes de su llegada. La contrapartida fue la complejidad. Sin propiedad, catalogación, controles de calidad y reglas de ciclo de vida, un lago podía convertirse en una colección de archivos en los que nadie confiaba.
El lakehouse surgió como una respuesta pragmática. Los formatos de tabla como Delta Lake, Apache Iceberg y Apache Hudi añaden gestión de esquemas y comportamiento transaccional sobre el almacenamiento abierto, ayudando a que un único entorno soporte tanto cargas de trabajo analíticas como de aprendizaje automático.
La arquitectura sigue convergiendo. Los almacenes gestionados admiten cada vez más datos semiestructurados y formatos de archivo abiertos, mientras que los lagos modernos adoptan transacciones, gobernanza y gestión de tablas propias de los almacenes. Esta historia se resume en un repaso al desarrollo histórico de las plataformas de datos.
La conclusión útil no es que una arquitectura haya ganado a las demás. Es que cada plataforma hereda ciertas compensaciones. Un equipo que elija una arquitectura debería preguntarse qué limitaciones importan más: un SQL rápido y gobernado, una retención económica de datos brutos, un acceso flexible para el aprendizaje automático, formatos abiertos o la simplicidad operativa.
Comparación entre almacenes, lagos y lagos de datos (lakehouses)
Un almacén, un lago y un lakehouse pueden dar soporte a la analítica, pero organizan el trabajo de manera diferente. La mejor opción depende de sus formatos de datos, cargas de trabajo, expectativas de gobernanza y las habilidades con las que ya cuentan sus equipos.
Dimensión | Almacén de datos (Data Warehouse) | Lago de datos (Data Lake) | Lakehouse |
|---|---|---|---|
Formatos típicos | Tablas estructuradas y curadas, con un soporte creciente para datos semiestructurados | Archivos brutos, registros (logs), eventos, objetos estructurados y no estructurados | Tablas estructuradas y semiestructuradas sobre almacenamiento de objetos abierto |
Cargas de trabajo principales | BI, informes SQL, análisis de negocio gobernado | Retención de datos brutos, exploración, ciencia de datos, procesamiento diverso | BI, analítica, aprendizaje automático e ingeniería de datos compartida |
Enfoque de esquema | El esquema se define normalmente antes o durante la carga | El esquema se puede aplicar a posteriori, lo que aumenta la flexibilidad | Se añaden controles de esquema y de tablas sobre un almacenamiento flexible |
Modelo de gobernanza | Suele ser centralizado y maduro para conjuntos de datos curados | Puede variar ampliamente y requiere una catalogación y un diseño de políticas deliberados | Su objetivo es combinar el almacenamiento abierto con una gobernanza de tablas más sólida |
Perfil de coste | Optimizado para un rendimiento analítico gestionado, con costes condicionados por el uso de procesamiento y almacenamiento | A menudo atractivo para un almacenamiento amplio, requiriendo ingeniería adicional para su usabilidad | Equilibra la economía del almacenamiento compartido con las necesidades de procesamiento y gestión |
Equipos que dependen de él | Analistas, desarrolladores de BI, ingenieros de analítica, finanzas y operaciones | Ingenieros de datos, científicos de datos, investigadores y usuarios exploratorios | Equipos multifuncionales de plataforma, analítica, ingeniería e IA |
Un almacén suele ser la opción más clara cuando la mayoría de las cargas de trabajo implican tablas curadas y consultas SQL rápidas. Ofrece a los analistas un entorno controlado, pero los equipos pueden necesitar sistemas adicionales para archivos brutos, procesamiento especializado o experimentación de aprendizaje automático.
Un lago es útil cuando la organización necesita conservar datos variados antes de conocer cada uso futuro. Esa flexibilidad conlleva una responsabilidad. El catalogado, la propiedad, el seguimiento de esquemas y las políticas de acceso deben evitar que el entorno se convierta en un archivo sin gestionar.
Un lakehouse intenta combinar ambos modelos. Puede proporcionar almacenamiento abierto y un amplio acceso a los datos, al tiempo que añade una semántica de tablas más sólida, gestión de transacciones y gobernanza. Sin embargo, esto no elimina la complejidad. Los equipos siguen necesitando comprender las distribuciones de archivos, las opciones de procesamiento, el mantenimiento de tablas, los permisos y el aislamiento de las cargas de trabajo.
La distinción entre un lago y un data mart más enfocado se explora en esta comparación de lagos de datos y data marts. La decisión debe basarse en la realidad de la carga de trabajo y no en las modas. Una plataforma híbrida puede ser sensata cuando el departamento financiero necesita informes gobernados desde el almacén, el equipo de ciencia de datos necesita acceso a eventos brutos y operaciones requiere datos de baja latencia desde un almacén especializado.
Por qué la Observability pertenece al interior de la plataforma
La Observability debe estar junto a la ingesta, el almacenamiento, el procesamiento y la gobernanza porque cada capa puede introducir un fallo que parezca correcto desde el exterior. El estado verde de un pipeline no demuestra que los datos estén frescos, completos, sean estructuralmente compatibles o tengan sentido para sus consumidores.
La Data Observability es la supervisión continua de pipelines, tablas, tareas y patrones de consumo. Busca cambios en la frescura, desviaciones en el esquema (schema drift), anomalías de volumen, transformaciones fallidas y variaciones en el tiempo de ejecución, en lugar de confiar únicamente en si una tarea programada tuvo éxito o no. Las directrices empresariales sobre Data Observability describen este alcance operativo más amplio.
Los fallos que los equipos no ven a tiempo
La desviación del esquema es un fallo silencioso muy común. Un sistema de origen puede añadir una columna, eliminar un campo o cambiar un tipo de datos sin previo aviso. Un modelo río abajo puede fallar inmediatamente, o puede continuar produciendo resultados incompletos o engañosos. La investigación sobre monitorización de esquemas identifica estos cambios estructurales como señales que los sistemas de Observability deberían rastrear a lo largo del tiempo.
La frescura (freshness) genera otro riesgo. Un conjunto de datos puede tener una estructura válida y, aun así, ser inservible porque su última entrega llegó tarde. Los equipos comparan la llegada real con las programaciones esperadas o las expectativas de nivel de servicio para detectar retrasos antes de que los datos obsoletos lleguen a los tableros y a los informes operativos, una distinción detallada en las directrices de Timeliness de digna.
Los duplicados, los cambios de volumen inesperados y las distribuciones cambiantes pueden crear una clase diferente de incidente. Una tabla de ingresos puede cargarse correctamente a pesar de contener registros repetidos, y una característica de ML puede existir técnicamente mientras refleja una población desactualizada.
La calidad y la Observability responden a preguntas diferentes
Las comprobaciones de calidad validan reglas conocidas. Por ejemplo, una prueba a nivel de registro puede exigir que exista un identificador o que un valor se encuentre dentro de un rango aceptado. La Observability detecta comportamientos inesperados, rastrea el impacto a través del linaje y ayuda a diagnosticar cambios que las reglas predefinidas no previeron.
Regla práctica: Utilice la validación determinista para las reglas que ya comprende, y la Observability para los cambios que no sabía que debía esperar.
Ambos enfoques colaboran mutuamente. Una estrategia unificada de calidad de datos y Observability explica por qué las empresas combinan la validación con la detección de anomalías, el linaje y el seguimiento de esquemas.
Hacer que la Observability forme parte de la plataforma cambia la atribución de responsabilidades. Los ingenieros de datos reciben alertas con contexto del origen y de lo que hay río abajo, los ingenieros de analítica pueden ver si un modelo se ve afectado y los equipos de gobernanza obtienen evidencias sobre el comportamiento de los datos. En lugar de descubrir un problema a través de un tablero roto, los equipos pueden investigar el límite de la ingesta o del esquema donde comenzó el cambio. Las prácticas de Data Observability proporcionan un marco útil para evaluar esa capacidad.
Plataformas de datos en la práctica a través de las industrias
La arquitectura se vuelve más clara cuando las mismas capas resuelven diferentes problemas operativos.
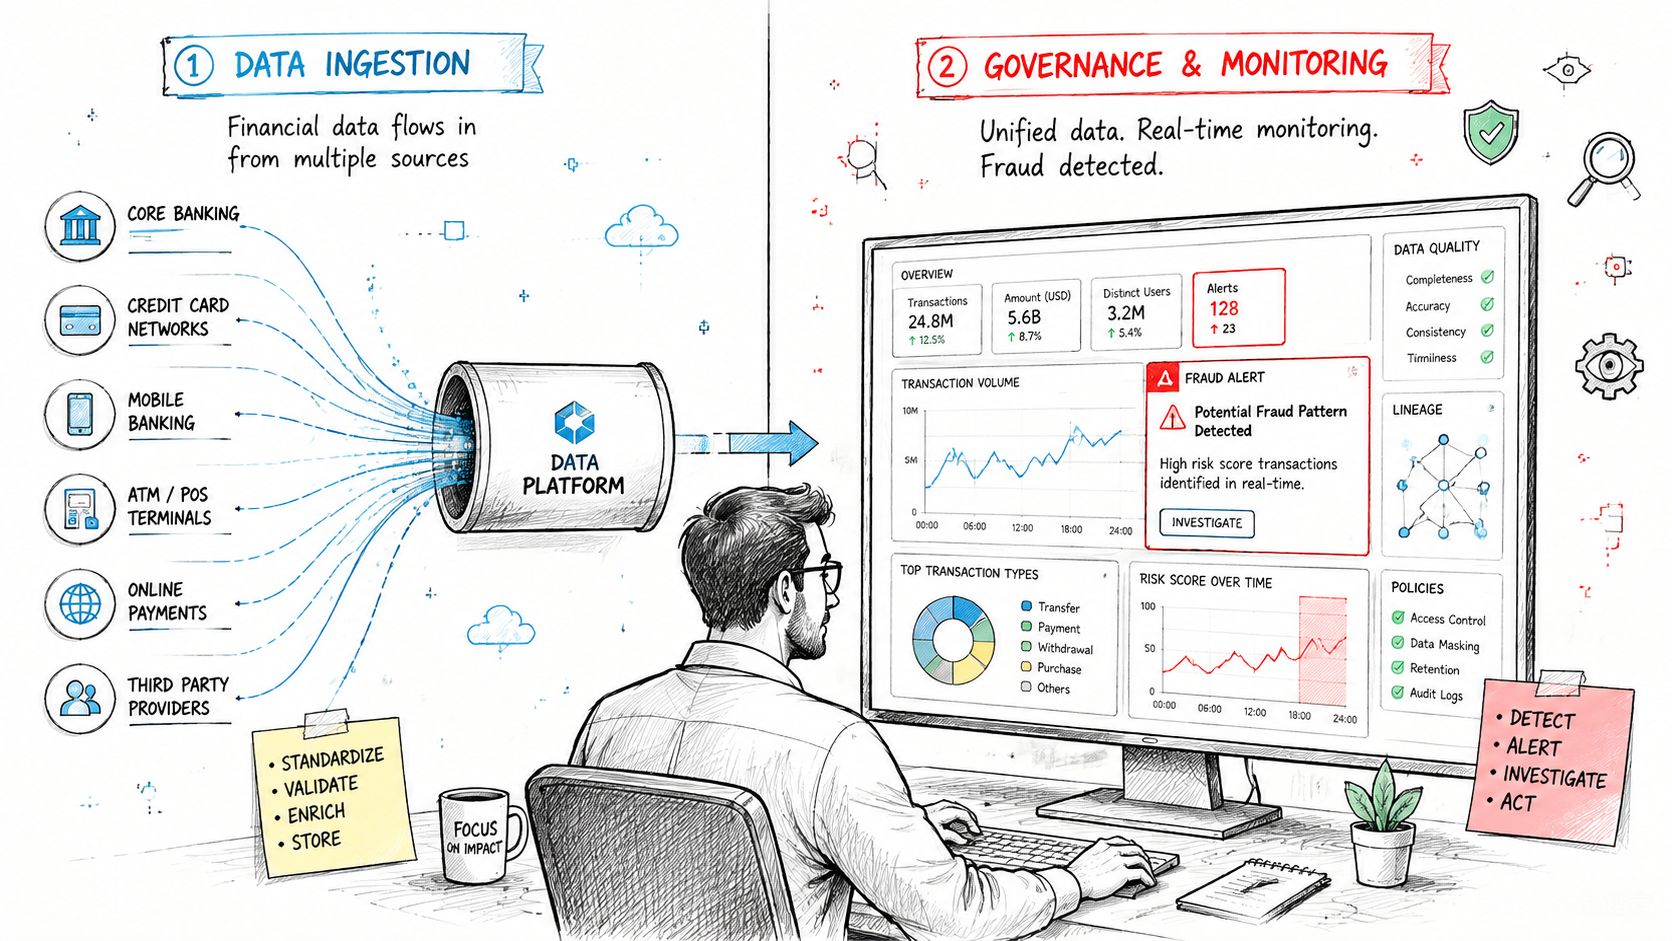
Un banco minorista puede ingerir eventos de transacciones, registros de clientes y señales de dispositivos en una plataforma que admita análisis de fraude casi en tiempo real. La capa de ingesta debe gestionar eventos de forma oportuna, el procesamiento debe comparar el comportamiento actual con los patrones relevantes, la gobernanza debe restringir los datos financieros sensibles y la Observability debe identificar entregas faltantes o cambios estructurales antes de que los flujos de trabajo de fraude consuman entradas defectuosas. La contrapartida es la complejidad operativa a cambio de una detección más rápida y un uso más controlado de la información sensible.
Una red de hospitales se enfrenta a una combinación diferente de limitaciones. Es posible que sea necesario reunir registros clínicos, datos de reclamaciones, sistemas operativos y datos de dispositivos, pero el acceso no puede ser uniforme. La gobernanza determina qué roles pueden ver qué conjuntos de datos, el linaje ayuda a los usuarios a comprender cómo se produjo un informe y la validación ayuda a aplicar reglas en registros críticos. La organización acepta una mayor carga de gestión de control porque la trazabilidad y el acceso restringido importan tanto como la comodidad analítica.
Los equipos de telecomunicaciones a menudo necesitan tanto la perspectiva del cliente como la de la red. Un lakehouse puede proporcionar una base común para los tableros de pérdida de clientes (churn) y los modelos de anomalías de red, mientras que diferentes patrones de procesamiento sirven a los usuarios de SQL y a los equipos de aprendizaje automático. La Observability ayuda a los ingenieros de la plataforma a distinguir un cambio genuino en el comportamiento del cliente de un pipeline roto o de una fuente de datos incompleta.
Las organizaciones del sector público pueden compartir datos entre agencias manteniendo los requisitos de residencia, acceso y auditoría. Una plataforma modular puede centralizar el catalogado y las definiciones de políticas, permitiendo al mismo tiempo que los diferentes departamentos mantengan la propiedad de sus conjuntos de datos. La compensación aceptada es que el acceso interinstitucional requiere controles más formales que un intercambio informal de archivos, pero el resultado es un análisis más reproducible y una responsabilidad más clara.
Estos ejemplos no apuntan a una única arquitectura universal. Muestran por qué el diseño de la plataforma debe comenzar con las consecuencias del fallo. Un flujo de telecomunicaciones retrasado, un campo clínico expuesto, una métrica bancaria sin explicar y un conjunto de datos del sector público incompleto requieren controles diferentes, incluso cuando las capas subyacentes parecen similares.
Una lista de verificación práctica para evaluar su plataforma
Utilice las siguientes preguntas para evaluar su pila tecnológica actual. Un "no" no significa automáticamente que la arquitectura sea incorrecta. Identifica un límite donde la integración, la propiedad o la visibilidad pueden ser débiles.
Ingesta y almacenamiento
Cobertura de fuentes: ¿Puede la plataforma aceptar entradas tanto por lotes (batch) como en tiempo real (streaming) sin tener que crear un modelo operativo a medida para cada fuente?
Ubicación de datos: ¿Sabe qué conjuntos de datos pertenecen a tablas curadas de almacenes de datos, al almacenamiento flexible de un lago o a tablas de un lakehouse?
Control del ciclo de vida: ¿Pueden los propietarios identificar las expectativas de retención, acceso y frescura para los conjuntos de datos importantes?
Procesamiento y modelado
Base compartida: ¿Pueden los análisis SQL, los flujos de trabajo de transformación y las cargas de trabajo de aprendizaje automático utilizar datos gobernados sin copias innecesarias?
Reproducibilidad: ¿Pueden los analistas rastrear una métrica desde su definición semántica a través de las transformaciones hasta llegar a los datos de origen?
Adecuación de la carga de trabajo: ¿Soporta la capa de procesamiento la latencia, la escala y los patrones de procesamiento que sus equipos necesitan?
Gobernanza y acceso
Claridad de permisos: ¿Puede la plataforma aplicar un acceso basado en roles o en atributos en lugar de confiar en acuerdos informales?
Linaje y catalogado: ¿Puede un usuario descubrir qué significa un conjunto de datos, quién es su propietario y qué productos río abajo dependen de él?
Auditabilidad: ¿Puede su equipo reconstruir quién accedió a datos sensibles y cómo se produjo una cifra reportada?
Observability y fiabilidad
Visibilidad de frescura: ¿Sabrá el equipo si una entrega se retrasa o falta antes de que el usuario de un tablero informe del problema?
Protección estructural: ¿Puede la plataforma detectar columnas añadidas, campos eliminados y cambios en los tipos de datos?
Señales de comportamiento: ¿Puede detectar anomalías en el volumen, los valores, las métricas de negocio, la ejecución de los pipelines y el consumo de la plataforma?
Una plataforma madura no necesita provenir de un solo proveedor. Sí necesita la integración suficiente para que un equipo pueda responder a "¿de dónde viene este número?" sin tener que llevar a cabo una investigación en seis herramientas diferentes. La lista de verificación de fiabilidad de datos para equipos de datos puede ayudar a convertir estas preguntas en una evaluación más formal.
digna ofrece una plataforma empresarial de calidad de datos y Observability que se ejecuta dentro del propio entorno del cliente, con comprobaciones en la base de datos para detectar anomalías, Timeliness, validación y cambios de esquema en almacenes, lagos y pipelines. Visite digna para ver cómo su enfoque de monitorización modular puede encajar en una plataforma de datos gobernada.
Preguntas frecuentes
¿Qué es una plataforma de datos?
El conjunto integrado de herramientas e infraestructura que una organización usa para ingerir, almacenar, procesar, gobernar y servir datos para analítica e IA. La implicación importante es que una plataforma de datos no es necesariamente un producto, y no es solo una base de datos.
¿Cuáles son las capas centrales?
Ingesta, almacenamiento, cómputo, gobernanza y observabilidad, que se corresponden con un restaurante: la ingesta es el muelle de carga, el almacenamiento la despensa y la cámara frigorífica, y el cómputo la cocina. Cada capa arrastra sus propias consecuencias de coste, velocidad de acceso, retención y gobernanza.
¿Qué cinco preguntas revelan si tiene una?
¿Pueden llegar los datos de forma fiable? ¿Dónde viven? ¿Cómo se preparan? ¿Qué significan y quién puede usarlos? ¿Cómo saben los equipos que el sistema está sano? Una pila que no responde a las dos últimas es una colección de herramientas, no una plataforma.
¿En qué se diferencia de una base de datos?
Una base de datos puede almacenar datos sin gestionar su ciclo de vida completo. Las guías de arquitectura empresarial describen una plataforma como software que ayuda a almacenar, acceder, gestionar y gobernar datos corporativos tanto en el plano de datos como en el plano de control, que es justo lo que una base de datos por sí sola no aporta.
¿Qué tamaño tiene el mercado de plataformas de datos?
Se estimó en 82.400 millones de USD en 2024 y se proyecta que supere los 210.000 millones en 2031, con un crecimiento anual compuesto del 14,5 % en ese periodo. El crecimiento refleja la consolidación de herramientas sueltas en plataformas gobernadas, no simplemente más almacenamiento.


