Qué es un formato de tabla abierto
|
10
minuto de lectura

Probablemente estés aquí porque tu lago ya parece una tabla en una herramienta, pero se comporta como un montón de archivos en otra.
Un panel financiero cambia a posteriori. Un relleno arregla una consulta y rompe otra. Las escrituras de Spark tienen éxito, Trino lee datos obsoletos y nadie puede responder a una pregunta básica: ¿qué versión de este conjunto de datos es la correcta? Ahí es cuando la gente deja de preguntar «¿qué formato de archivo usamos?» y empieza a preguntar qué es realmente un formato de tabla abierto.
La respuesta corta es sencilla. Un formato de tabla abierto es la capa de metadatos que hace que el almacenamiento de objetos se comporte como una tabla de base de datos. La respuesta larga importa más, porque el formato en sí es solo la mitad de la historia. La otra mitad es cómo lo opera tu equipo: compactación, control de esquema, catálogos y observabilidad.
Índice de contenidos
ACID, viaje en el tiempo y evolución del esquema, explicados
Un plan práctico de despliegue para equipos de ingeniería de datos
El momento en que un lago de datos deja de ser fiable
Un fallo habitual empieza así.
Finanzas revisa el informe de ingresos de ayer y ve que ya no coincide con el panel. Ninguna pipeline está en rojo. Ningún orquestador muestra una tarea fallida. Los archivos siguen en el almacenamiento de objetos. Pero en algún punto entre un append de streaming y un trabajo de mantenimiento, los lectores captaron una vista parcial de la tabla.
Por qué el almacenamiento en crudo falla de forma sutil
El almacenamiento de objetos es muy bueno guardando archivos. Por sí solo no es un sistema de tablas.
Si guardas archivos Parquet en una carpeta y llamas a esa carpeta revenue, todavía no has respondido a las preguntas que importan a los analistas:
Qué archivos pertenecen ahora mismo a la tabla
Qué escritura produjo la versión actual
Qué esquema debería usar un lector
Cómo era la tabla la semana pasada
Qué archivos puede ignorar una consulta sin riesgo
Sin esa capa de metadatos, cada motor tiene que inferir el estado a partir de listados de directorios y nombres de archivo. Funciona un tiempo. Luego alguien reescribe particiones, compacta archivos o cambia el tipo de una columna, y los lectores empiezan a ver verdades distintas desde la misma ruta de almacenamiento.
Los archivos en crudo pueden almacenar datos correctamente y aun así producir analítica poco fiable.
La capa que falta
Un formato de tabla abierto añade el registro que falta del estado de la tabla junto a los propios datos. En lugar de tratar el almacenamiento como «los archivos que haya bajo este prefijo», registra una vista gobernada de la tabla: archivos actuales, instantáneas históricas, esquema y metadatos de disposición.
Por eso los equipos que invierten en monitorización del data lake descubren a menudo el mismo patrón. El problema no suele ser solo una escritura defectuosa. Es que la plataforma carece de una forma fiable de describir el estado de la tabla entre lectores y escritores.
La diferencia parece pequeña hasta tu primera inconsistencia silenciosa. Después se vuelve fundamental.
Qué hace realmente un formato de tabla abierto
Una nueva pipeline deja archivos de reemplazo para revenue. El trabajo de Spark termina. Una analista actualiza un panel en Trino. Un trabajo de features de machine learning lee la misma tabla mediante otro motor. Las tres consultas atacan la misma ruta de almacenamiento, pero no siempre ven la misma respuesta.
Esa brecha es lo que un formato de tabla abierto está hecho para cerrar.
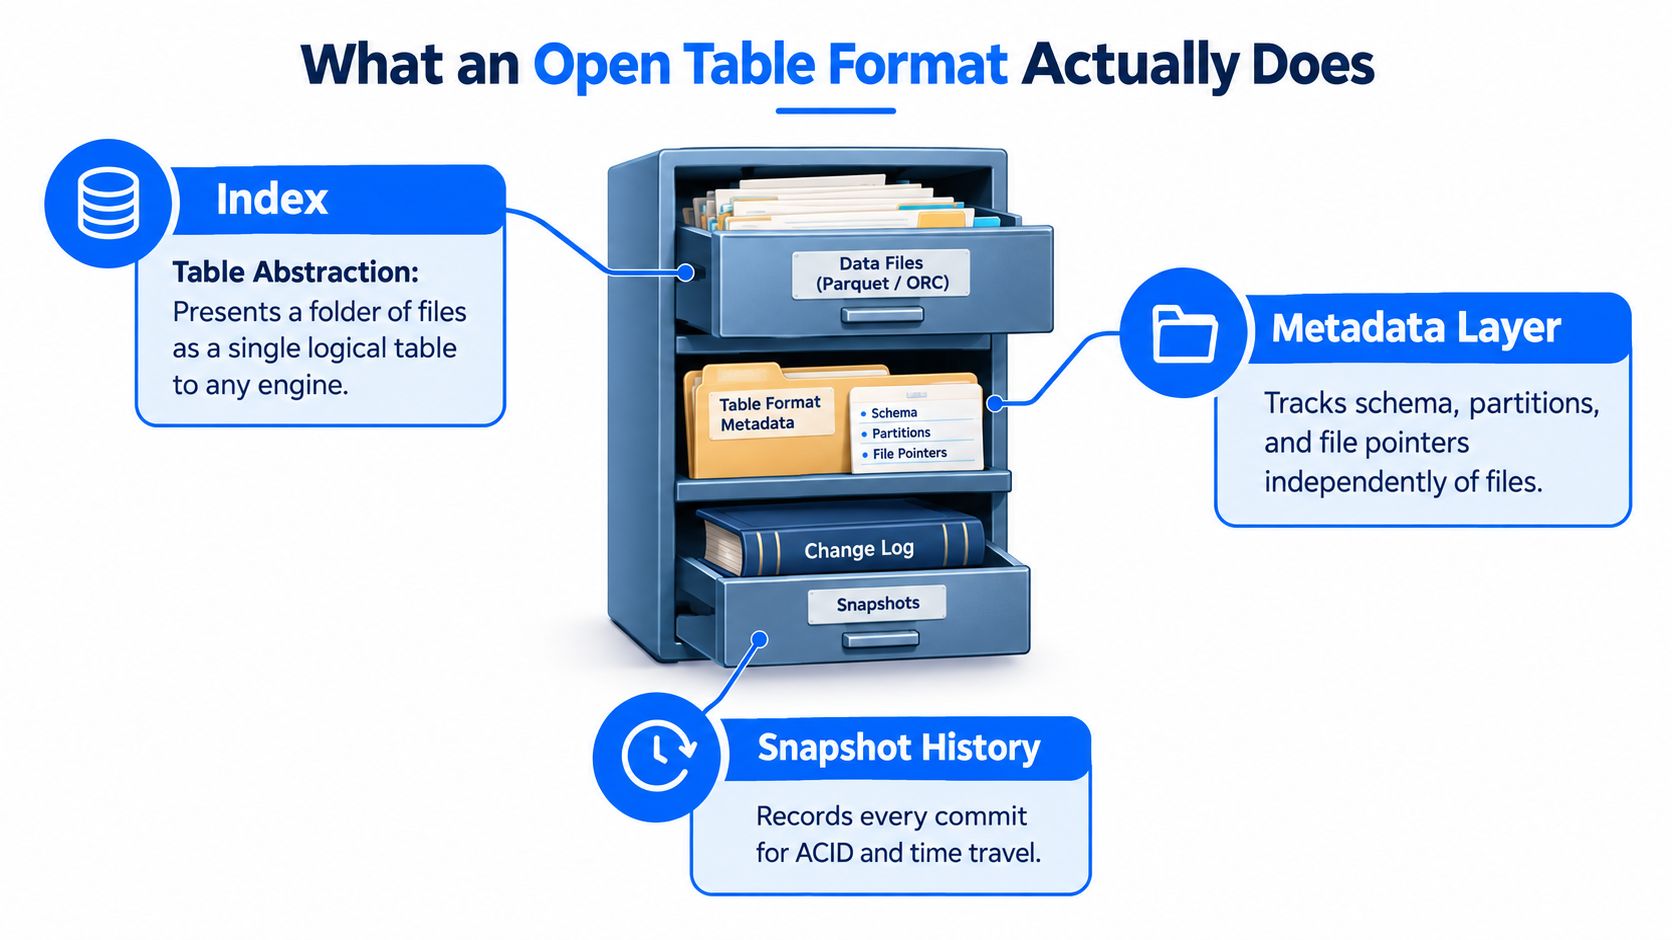
Se sitúa sobre los archivos y define el estado de la tabla
Los formatos de tabla abiertos se confunden a menudo con los formatos de archivo porque ambos aparecen en el mismo bucket. Resuelven problemas distintos.
Parquet, ORC y Avro definen cómo un archivo concreto almacena filas y columnas. Un formato de tabla abierto define cómo un conjunto de archivos se convierte en una tabla lógica que muchos motores pueden leer y escribir con seguridad. Databricks describe los formatos de tabla abiertos como una capa de metadatos sobre Parquet, ORC o Avro en almacenamiento de objetos que añade funciones de tabla como transacciones ACID, evolución del esquema y viaje en el tiempo, en su repaso de los formatos de tabla abiertos.
Si esa distinción sigue borrosa, ayuda esta guía sobre qué es Parquet y cómo almacena datos columnares. Parquet responde «¿cómo está codificado este archivo?». Un formato de tabla responde «¿qué archivos componen la tabla y en qué versión deben confiar los lectores?».
El formato actúa como plano de control de la tabla
Un modelo mental útil es un historial de Git para archivos de datos, con reglas más estrictas sobre concurrencia y esquema. El formato de tabla lleva registro del estado actual y del camino que lo produjo. Los motores de consulta no tienen que escanear carpetas y adivinar. Pueden leer los metadatos de la tabla y obtener una respuesta exacta.
En la práctica, esa capa de metadatos cumple cuatro funciones.
Declarar la pertenencia de archivos
El formato registra qué archivos pertenecen ahora a la tabla. Si la compactación reescribe diez archivos pequeños en uno mayor, los lectores siguen el puntero de metadatos al conjunto válido en lugar de mezclar datos viejos y nuevos.Publicar instantáneas de forma atómica
Una escritura se hace visible como una nueva instantánea confirmada. Los lectores ven la versión antigua o la nueva, no un estado intermedio donde la mitad de los archivos ha cambiado.Seguir el esquema como metadato de tabla
Nombres de columna, tipos, identificadores de campo y cambios permitidos viven en la definición de la tabla, no solo en lo que un escritor emitiera. Eso importa en cuanto distintos motores empiezan a renombrar columnas, ensanchar tipos o añadir campos anidados.Guardar metadatos de disposición y poda
Valores de partición, estadísticas de archivo y a veces metadatos de borrado ayudan a los motores a omitir archivos irrelevantes y planificar consultas con eficiencia.
La capa operativa es lo que los equipos suelen subestimar
La lista de funciones es la parte fácil. En el modelo operativo es donde los formatos de tabla abiertos se ganan el sueldo.
Una vez que un formato posee el estado de la tabla, tu equipo debe decidir quién se encarga de la compactación, quién aprueba los cambios de esquema y qué catálogo es la fuente de verdad. Son preguntas de producción, no de folleto. Si nadie se encarga de la compactación, los archivos pequeños se acumulan y el rendimiento de consulta se degrada. Si cualquier escritor puede cambiar el esquema, un despliegue malo puede romper a los lectores posteriores. Si Spark usa una vista de catálogo y Trino otra, vuelves a tener varias verdades con mejor marketing.
El formato te da los mecanismos. Tu equipo de plataforma sigue necesitando reglas.
Por qué el cambio importa en el trabajo diario
Sin formato de tabla, escribir datos suele significar «se subieron archivos». Con formato de tabla, escribir datos significa «se confirmó y publicó una nueva versión de la tabla».
Es un contrato más fuerte para cada sistema posterior. Trabajos por lotes, consultas de BI y lectores en streaming pueden coincidir sobre el estado de la tabla. Los motores pueden interoperar mediante metadatos compartidos en lugar de convenciones de ruta. Los ingenieros de datos pueden razonar sobre el mantenimiento, como la compactación o la evolución de particiones, sin tratar cada reescritura como una posible caída.
Un formato de tabla abierto es, entonces, la capa que convierte el almacenamiento de objetos en un sistema de tablas que la gente puede operar con confianza. El formato de archivo sigue importando. La victoria oculta es que los metadatos dan a tu equipo una forma controlada de mantener consistente el estado de la tabla a medida que se multiplican escrituras, esquemas y motores.
Cómo evolucionó el formato de Hive al lakehouse
La historia importa porque cada formato se creó para arreglar un dolor concreto, no para ganar una matriz de funciones.
Una cronología útil de la historia y evolución de los formatos de tabla abiertos sitúa Apache Hive en 2008, Apache Hudi en 2016, Apache Iceberg en 2017 y Delta Lake entre 2017 y 2019. Esa secuencia muestra la rapidez con que maduró la capa de tabla del lakehouse en cuanto los equipos toparon con los límites de los primeros patrones de data lake.

Hive resolvió el problema de una época
Hive dio a los primeros equipos de Hadoop una forma de tratar archivos en HDFS como tablas. Su modelo de particiones se apoyaba mucho en la estructura de directorios. Encajaba con los supuestos de la época.
Esos supuestos envejecieron mal en el almacenamiento de objetos en la nube. El particionado por directorios se volvió frágil. El comportamiento de listado y renombrado no se parecía a HDFS. Las tablas longevas se volvieron incómodas cuando cambiaban las estrategias de partición.
La siguiente ola corrigió fallos concretos
Cada formato más reciente respondió a una debilidad operativa distinta.
Apache Hudi surgió en 2016 para dar soporte a cargas que requerían upserts a nivel de registro y procesamiento incremental en entornos de data lake.
Apache Iceberg llegó en 2017 para abordar problemas de tablas analíticas grandes, escalado de metadatos y evolución de particiones.
Delta Lake tomó forma entre 2017 y 2019 como una vía basada en registro de transacciones para llevar un comportamiento ACID fiable al almacenamiento abierto.
Para entonces, el sector había pasado de «¿cómo metemos archivos en un lago?» a «¿cómo comparten varios motores tablas fiables sobre almacenamiento barato?».
El nombre lakehouse llegó tras el giro técnico
El giro arquitectónico llegó primero. La etiqueta lakehouse vino después.
Si quieres el contexto más amplio de la pila en torno a formatos, catálogos, motores y gobierno, esta guía sobre qué es un lakehouse y cómo mantener la calidad de los datos ofrece la vista de conjunto. El punto importante aquí es más estrecho: los formatos de tabla abiertos se convirtieron en la capa que hizo técnicamente creíbles las promesas del lakehouse.
Hacia 2025 y 2026, esa capa había madurado más. La misma cronología señala que la especificación v3 de tablas de Iceberg se ratificó en 2025, y que Iceberg 1.10 y 1.11 trajeron soporte estable para funciones como vectores de borrado, tipos variant, tipos geoespaciales y marcas de tiempo en nanosegundos en esa fase posterior de la evolución del formato.
Iceberg, Delta Lake y Hudi comparados
Una decisión de formato parece sencilla durante la evaluación. Luego arranca producción, un trabajo de streaming se retrasa, se acumulan archivos pequeños, dos motores discrepan sobre cambios de esquema, y aparece la pregunta: ¿quién se encarga del mantenimiento de la tabla y cuán predecible es ese trabajo?
Apache Iceberg, Delta Lake y Apache Hudi son formatos de tabla listos para producción. La comparación útil no es la paridad de funciones. Es cómo cada formato organiza los metadatos, coordina las escrituras y asigna la responsabilidad de tareas operativas como compactación, limpieza y compatibilidad entre motores.
La mayor diferencia es la arquitectura de metadatos
Los archivos de datos pueden estar todos en almacenamiento de objetos, pero cada formato guarda el «índice» de la tabla de forma distinta. El repaso de Dremio a la arquitectura de Iceberg, Delta Lake y Hudi es un buen punto de referencia:
Delta Lake registra los cambios de tabla en un registro de transacciones secuencial bajo
_delta_log.Iceberg sigue el estado de la tabla mediante metadatos de instantánea y archivos de manifiesto que describen qué archivos de datos pertenecen a cada versión.
Hudi mantiene una línea temporal de acciones, incluidos commits y operaciones de mantenimiento como compactación, clustering y limpieza.
Esa decisión de diseño afecta a más que al rendimiento de lectura. Cambia la rapidez con que crecen los metadatos, la seguridad con que varios motores pueden escribir, cómo se gestionan los cambios de partición y cuánto cuidado rutinario necesita la tabla por parte de tu equipo.
Iceberg, Delta Lake y Hudi de un vistazo
Dimensión | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Diseño de metadatos | Metadatos de instantánea con listas de manifiestos y manifiestos | Registro de transacciones secuencial en | Línea temporal de instantes inmutables que cubre escrituras y servicios de tabla |
Modelo de particionado | Particionado oculto y evolución de particiones, de modo que el esquema lógico de partición puede cambiar sin reescribir archivos antiguos | El comportamiento de partición se gestiona mediante el estado de tabla registrado y las convenciones del escritor | Diseñado en torno a disposiciones intensivas en ingesta, con servicios que reorganizan archivos con el tiempo |
Estilo de concurrencia | Modelo de aislamiento por instantáneas centrado en versiones de tabla e intercambio de metadatos | Protocolo de commit basado en registro con patrones de concurrencia optimista | Protocolo de commit basado en línea temporal, a menudo acompañado de servicios en segundo plano |
Mejor encaje | Tablas analíticas compartidas entre varios motores | Plataformas centradas en Spark, sobre todo donde las herramientas nativas de Delta son parte del día a día | Upserts frecuentes, captura de cambios y procesamiento incremental |
Principal concesión | Fuerte interoperabilidad, pero la disciplina de catálogo importa y las reglas de escritura entre motores deben ser explícitas | Los patrones operativos suelen ser más sencillos donde Spark y las herramientas conscientes de Delta marcan el estándar | La flexibilidad de escritura es fuerte, pero la compactación y el clustering necesitan planificación y responsables activos |
Postura de interoperabilidad | Amplio soporte entre motores y catálogos. La especificación de Apache Iceberg es una razón por la que muchos equipos lo consideran la opción de tabla compartida más neutral | Fuerte herencia de Spark, con compatibilidad creciente en el ecosistema más amplio | La interoperabilidad ha mejorado, pero los supuestos operativos siguen siendo más orientados a la ingesta que neutrales respecto al motor |
Una mejor lente de decisión: quién operará la tabla
Si un equipo compara solo casillas, los tres parecen cercanos. En la práctica generan trabajo de guardia distinto.
Iceberg encaja a menudo con organizaciones que quieren que varios motores lean una misma tabla gobernada mediante una capa de catálogo. El beneficio es la portabilidad. El coste es la disciplina. Cambios de esquema, orden de clasificación, tamaño de archivos, retención de instantáneas y consistencia del catálogo necesitan responsables claros, sobre todo cuando más de un motor puede escribir.
Delta Lake encaja a menudo con plataformas ya centradas en flujos de Spark y herramientas conscientes de Delta. La vía operativa puede ser directa porque el modelo transaccional y las herramientas están muy alineados. La contrapartida es que la estrategia de interoperabilidad importa más con el tiempo si la plataforma se expande más allá de sus supuestos originales.
Hudi encaja a menudo con sistemas intensivos en ingesta donde las actualizaciones a nivel de registro y el consumo incremental son parte del diseño central. Esa fortaleza viene con servicios de tabla más visibles. La compactación, el clustering y la limpieza no son detalles secundarios. Alguien tiene que programarlos, vigilarlos y decidir cuándo la latencia de escritura importa más que la disposición de lectura.
Aquí también el trabajo de fiabilidad deja de estar separado del de calidad. Un trabajo de compactación tardío, un cambio de esquema sin revisar o un motor escribiendo con la configuración de catálogo equivocada pueden crear incidencias que los analistas viven como «datos malos». Los equipos con plataformas centradas en Spark evalúan a menudo la elección de formato junto a las prácticas de gestión de calidad de datos en Databricks, porque la corrección de la tabla y las comprobaciones de calidad se cruzan en el mismo flujo de producción.
El formato equivocado rara vez falla durante una demo. Falla durante la tarea de mantenimiento que tu equipo supuso que se resolvería sola.
ACID, viaje en el tiempo y evolución del esquema, explicados
Un formato de tabla empieza a sentirse real la primera vez que algo va mal en producción. Una pipeline escribe la mitad de sus archivos, falla con el resto, y una analista refresca un panel justo en el peor momento. Sin control transaccional, el lago expone ese desorden directamente. Con un formato de tabla abierto, los lectores siguen viendo el último estado válido hasta que el nuevo está plenamente confirmado.
ACID significa que la tabla tiene un punto de commit claro
El beneficio práctico de ACID en un lakehouse es simple. Los lectores no ven trabajo a medias.
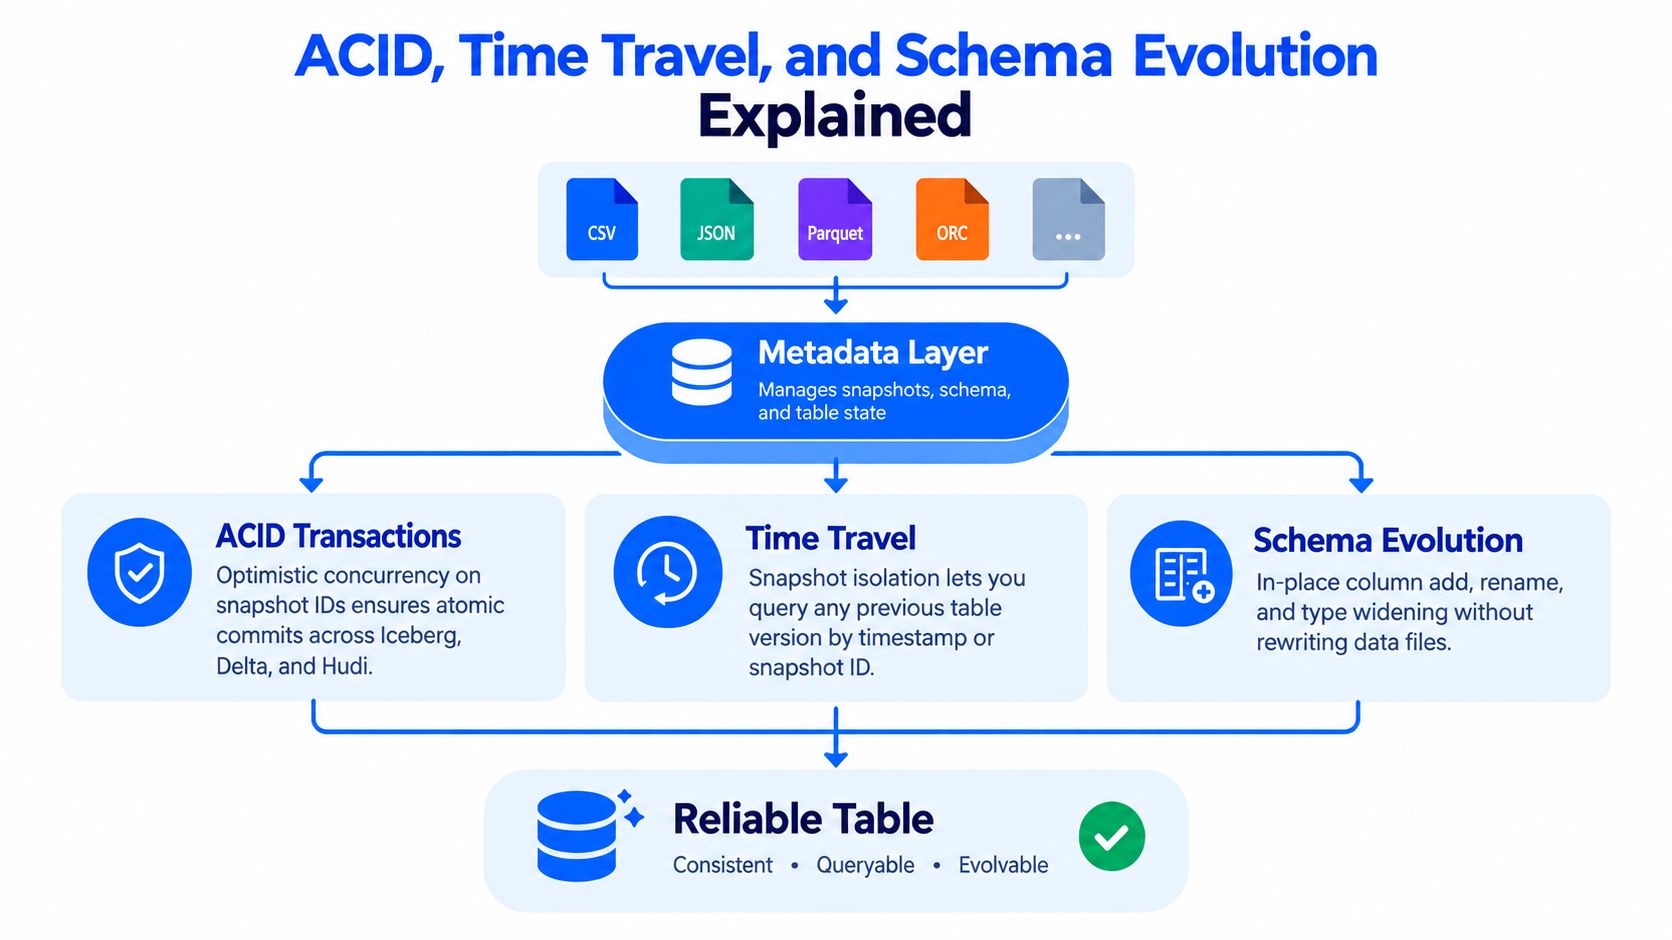
Por debajo, estos formatos publican los cambios mediante commits de metadatos. Los archivos de datos pueden existir ya en el almacenamiento de objetos, pero no forman parte de la tabla hasta que se acepta la nueva versión de metadatos. Eso te da el comportamiento que los equipos esperan de una base de datos, aunque el almacenamiento subyacente sigan siendo archivos en un lago.
En la práctica, eso significa:
un trabajo por lotes puede publicar una actualización completa como un único commit atómico
un trabajo de streaming puede seguir añadiendo mientras los lectores permanecen en una instantánea consistente
una escritura fallida puede dejar archivos huérfanos, pero no convertirse en la verdad de la tabla
los escritores concurrentes necesitan reglas de conflicto, lógica de reintento y coordinación de catálogo para no pisarse
Ese último punto se subestima fácilmente. ACID no es solo una función para lectores. Es también un mecanismo de control para varios escritores, y los detalles operativos difieren según formato, motor y configuración de catálogo.
El viaje en el tiempo es como los equipos depuran y reproducen estados de datos
El viaje en el tiempo significa que la tabla puede exponer versiones confirmadas anteriores, no solo la actual. Suena a comodidad hasta que un informe cambia tras un relleno, o un trabajo de borrado elimina más registros de los previstos.
Si has trabajado con datos históricos en Snowflake, el modelo mental es parecido. Consultas un estado previo de la tabla en lugar de restaurar archivos en crudo desde una copia.
La pregunta útil no es «¿el formato admite viaje en el tiempo?». La pregunta útil es «¿cuánto historial conservamos, quién controla la retención y qué pasa cuando se ejecuta la limpieza de almacenamiento?». Los equipos celebran a menudo las lecturas históricas en la evaluación y descubren después que una expiración agresiva de instantáneas eliminó justo la versión que necesitaban para una auditoría o una revisión de incidencia.
El viaje en el tiempo es solo tan fiable como la política de retención que lo respalda.
La evolución del esquema separa el cambio controlado de la rotura accidental
La evolución del esquema permite que una tabla cambie de forma con el tiempo sin forzar una reescritura completa de cada archivo antiguo. Eso suele incluir añadir columnas nullable, gestionar algunas promociones de tipo y, en ciertos formatos, admitir renombrados de columna mediante identidad de campo estable en lugar de la posición.
La función suena permisiva. El uso en producción debería ser lo contrario.
Un proceso seguro de cambio de esquema responde a unas preguntas concretas:
Quién puede aprobar un cambio de esquema en producción
Qué motores tienen permitido escribir ese nuevo esquema
Si los lectores posteriores pueden manejar el cambio
Cómo afectan los cambios de partición a los trabajos y supuestos existentes
Si el catálogo interpretará el nuevo esquema igual en todas las herramientas
Ahí es donde los equipos ganan flexibilidad o generan trabajo de limpieza de larga duración. Un renombrado de columna puede ser válido a nivel de formato y aun así romper extractos de BI, modelos de dbt o código de ingesta que referenciaban el nombre antiguo. Un ensanchamiento de tipo puede pasar la validación de escritura y aun así cambiar el comportamiento de los joins o el manejo de nulos aguas abajo.
La evolución del esquema es una capacidad del formato. El gobierno del esquema es una decisión operativa.
El mismo patrón se aplica también a ACID y al viaje en el tiempo. El formato aporta el mecanismo. La fiabilidad viene de la responsabilidad: quién aprueba cambios, quién ajusta la retención, quién limpia archivos y quién decide en qué motores se confía para escribir.
La verdadera pregunta tras la adopción
Un lakehouse suele parecer sano justo después de la primera escritura correcta. Las consultas funcionan. El viaje en el tiempo funciona. Todos repasan la lista de funciones y siguen adelante.
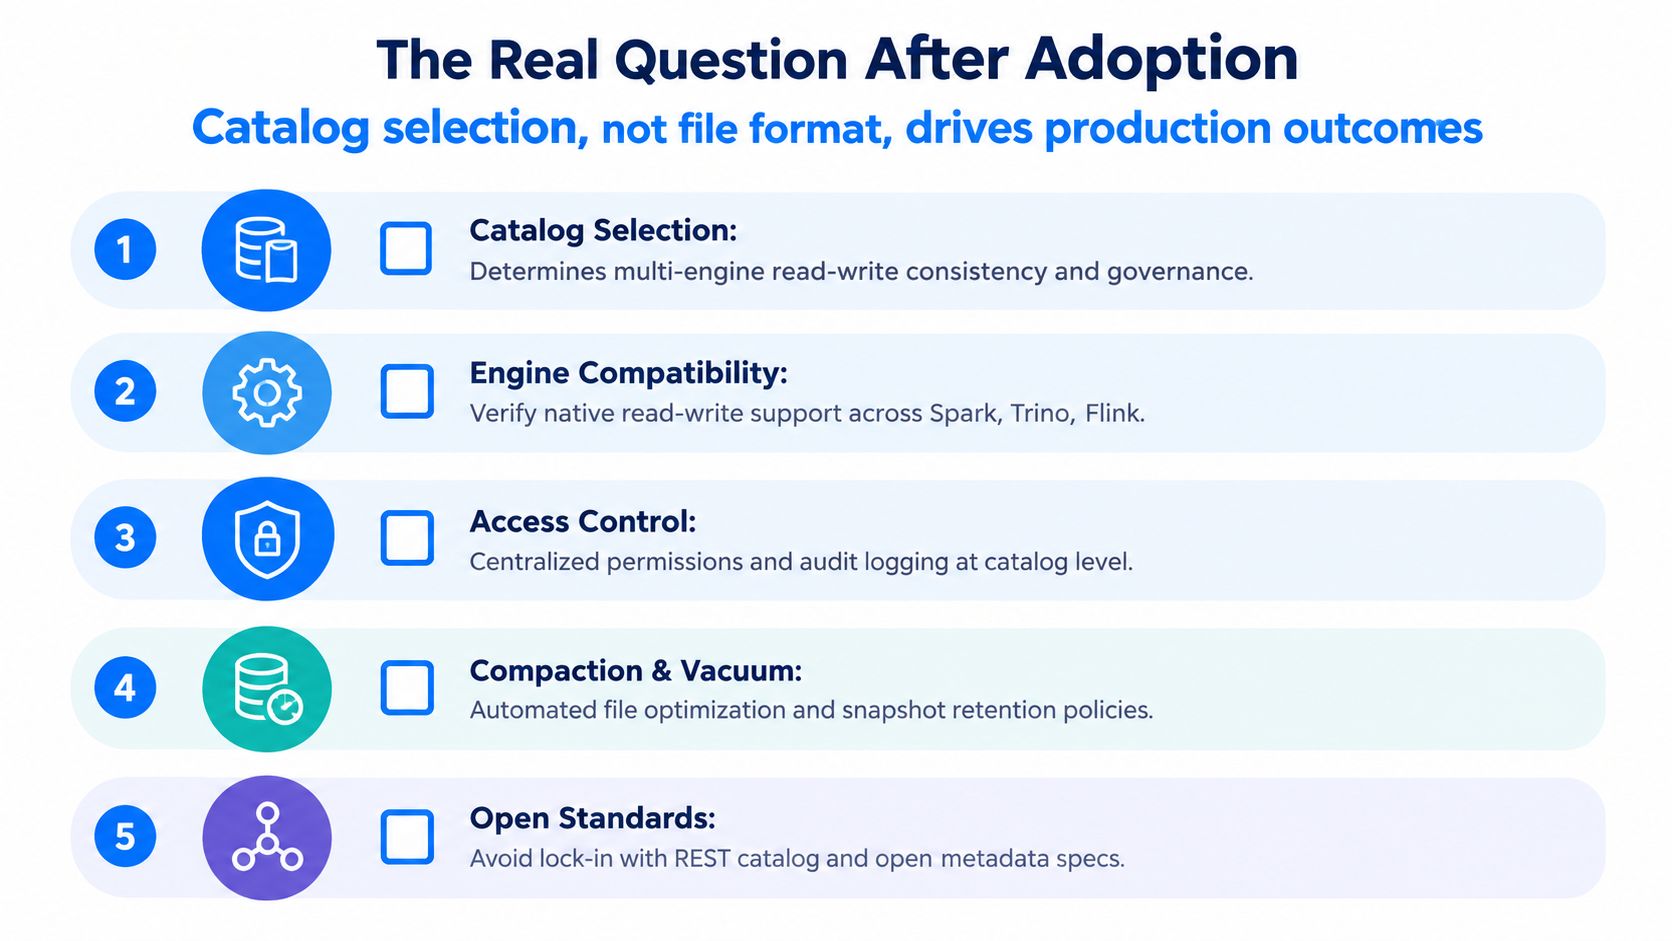
Entonces empiezan las preguntas operativas. Qué catálogo es la fuente de verdad. Qué motores pueden escribir. Quién ejecuta la compactación. Quién aprueba cambios de esquema técnicamente válidos pero arriesgados para los trabajos posteriores. Esas decisiones moldean la fiabilidad diaria más que la elección de formato de archivo por sí sola.
El catálogo fija las reglas de circulación
Un formato de tabla abierto define cómo encajan los metadatos y los archivos de datos. El catálogo decide cómo encuentran esa tabla los sistemas, coordinan cambios y aplican políticas. En la práctica, el catálogo funciona como el control aéreo del lakehouse. Los aviones pueden estar bien construidos, pero aun así necesitas un punto que coordine despegues, aterrizajes y cambios de ruta.
El repaso de Uplatz sobre convergencia y divergencia de formatos de tabla abiertos señala el papel creciente de proyectos de traducción e interoperabilidad como Apache XTable, la salida Iceberg nativa de Hudi y Delta Lake UniForm. También apunta una realidad de producción que se pierde en las comparativas de formato. Muchas empresas operan más de un formato, y la interoperabilidad sigue dependiendo mucho del soporte del motor, el comportamiento del catálogo y las restricciones específicas de cada nube.
Por eso la misma tabla Iceberg, Delta Lake o Hudi puede parecer predecible en un montaje y frágil en otro. Un catálogo REST, Glue, Hive Metastore, Nessie, Polaris o un plano de control gestionado por un proveedor diferirán en descubrimiento, permisos, modelos de ramificación, coordinación de escrituras y manejo de fallos.
La responsabilidad de la compactación se vuelve modelo operativo
La compactación suena a mantenimiento en segundo plano. En producción se parece más a una recolección de basura mezclada con ajuste de índices. Bien hecha, mantiene sensata la planificación de consultas y estable el rendimiento de lectura. Mal hecha, quema tiempo de clúster, pelea con las cargas de ingesta y genera limpieza tras reescrituras fallidas.
Alguien tiene que encargarse de:
La cadencia de compactación
Las decisiones de orden y clustering
La limpieza y retención de instantáneas
Los pasos de reversión cuando el mantenimiento empeora las cosas
La detección de archivos huérfanos
No son casillas del formato. Son trabajos recurrentes con modos de fallo, concesiones de coste y necesidad clara de responsables. Una reseña franca en Shirokoff sobre formatos de tabla abiertos lo dice directamente al señalar la sobrecarga de metadatos, el trabajo de mantenimiento, el coste de la curva de aprendizaje y un gobierno desigual entre herramientas.
La fiabilidad depende de quién controla el cambio
Los equipos de producción también aprenden que el gobierno rara vez vive solo en los archivos de la tabla. El enmascarado de columnas, los controles a nivel de fila, los registros de auditoría y el etiquetado de PII suelen depender de que el catálogo y los motores de consulta los apliquen de forma consistente.
Los equipos que mantienen fiables estas tablas vigilan la capa de metadatos como un plano de control de aplicación. Siguen la antigüedad de las instantáneas, los commits fallidos, el número de archivos, los archivos huérfanos, el retraso de mantenimiento y qué escritor cambió el estado de la tabla por última vez. Los equipos que solo vigilan la salud del almacenamiento de objetos suelen perderse las señales tempranas. El bucket parece bien mientras la tabla se vuelve más difícil de confiar.
Un plan práctico de despliegue para equipos de ingeniería de datos
Un despliegue limpio empieza pequeño, pero no debería empezar vago. Quieres un piloto que exponga pronto los bordes operativos.
La fase 1 elige el plano de control
Elige primero el catálogo. La disposición de archivos importa, pero el catálogo decide cómo descubren tablas los motores, coordinan escrituras y aplican políticas.
Evalúa opciones como catálogos orientados a REST, montajes al estilo Hive Metastore y catálogos nativos de nube con preguntas prácticas:
Qué motores deben leer y escribir de forma nativa
Dónde vivirán la propiedad de la tabla y los permisos
Cómo se revisarán los cambios de esquema
Qué ocurre si el catálogo no está disponible
Si te saltas este paso, a menudo lo reconstruirás después bajo presión.
La fase 2 fija la base de seguridad y gobierno
Antes de una adopción amplia, define el contrato operativo mínimo.
Eso suele incluir SSO, RBAC, cifrado en tránsito y en reposo, identidades de servicio controladas y una política para restricciones de fila o columna donde haga falta. También incluye expectativas de linaje, etiquetado de PII y vías de aprobación para cambios de esquema.
Una opción de herramienta útil en esta etapa es digna, que se ejecuta dentro del propio entorno del cliente y monitoriza el comportamiento de los datos, la Timeliness, la validación de registros, los cambios de esquema y las métricas de plataforma en lagos, almacenes y pipelines. Para los formatos de tabla abiertos eso importa porque los problemas de fiabilidad suelen aparecer primero como instantáneas obsoletas, deriva de esquema, escrituras retrasadas o anomalías en métricas de negocio, y no como fallos duros de pipeline.
La fase 3 pone a prueba la ruta de escritura
No valides la arquitectura con un único lote diario.
Usa un conjunto piloto con varios escritores diarios, al menos un flujo de mantenimiento y un motor de consulta distinto del motor escritor principal. Incluye en la prueba un trabajo de partición oculta u optimización de disposición para que tu equipo tenga que manejar cambios de instantánea, efectos de compactación y decisiones de reversión en condiciones realistas.
Un buen piloto debería generar algunas preguntas incómodas. ¿Quién aprueba los cambios de esquema? ¿A quién se avisa por commits fallidos? ¿Qué lectores están permitidos durante las ventanas de mantenimiento? Esos son justo los problemas que conviene sacar pronto.
La fase 4 instrumenta la capa de metadatos
La monitorización del almacenamiento por sí sola no te dirá bastante.
Sigue señales como:
Antigüedad de instantánea para la frescura del estado de tabla publicado.
Retraso de compactación para que la proliferación de archivos no degrade el rendimiento.
Patrones de fallo de escritores entre motores.
Eventos de deriva de esquema antes de que se rompan los paneles posteriores.
Crecimiento de archivos huérfanos tras reintentos u operaciones abortadas.
Si no puedes ver la salud de la ruta de metadatos de la tabla, estás operando sobre todo con esperanza.
Los formatos de tabla abiertos resuelven el problema de la capa de tabla, pero no eliminan la necesidad de operaciones disciplinadas. digna ayuda a los equipos a monitorizar cambios de esquema, Timeliness, anomalías y comportamiento de plataforma dentro de su propio entorno, lo que encaja con los modos de fallo que aparecen tras adoptar un lakehouse. Si tus tablas ya abarcan varios motores y trabajos de mantenimiento, merece la pena ver cómo digna puede ayudarte a vigilar la capa de fiabilidad basada en metadatos, y no solo los archivos de debajo.
Los equipos que despliegan en Databricks suelen añadir observabilidad para la plataforma Databricks en la misma fase, de modo que las garantías a nivel de tabla y las comprobaciones a nivel de valor lleguen juntas.
Preguntas frecuentes
¿Cómo evolucionaron los formatos de tabla desde Hive?
Hive definía una tabla como una disposición de directorios, así que las particiones eran carpetas y el listado de archivos era la fuente de verdad. Eso se rompió en el almacenamiento de objetos, donde los listados son lentos y de consistencia eventual. Los formatos modernos trasladaron la definición de la tabla a archivos de metadatos, eliminando por completo la dependencia de la estructura de directorios.
¿Qué significa ACID para una tabla de data lake?
Significa que una escritura se hace visible por completo o no se hace, y que los lectores concurrentes nunca quedan expuestos a un cambio en curso. En un lago esa garantía viene de intercambiar un puntero de metadatos de forma atómica, no de un registro de transacciones de base de datos, y por eso funciona sobre almacenamiento de objetos puro.
¿Se puede cambiar el esquema de una tabla sin reescribirla?
Sí. Añadir, eliminar, renombrar o reordenar columnas se registra en metadatos y se aplica al leer, así que los archivos de datos existentes quedan intactos. El matiz es que los lectores deben aplicar las mismas reglas: un motor con soporte parcial puede devolver nulos para una columna renombrada en lugar de lanzar un error.
¿Por qué un lago se comporta como una tabla en una herramienta y como un montón de archivos en otra?
Porque la garantía vive en la capa de metadatos, y solo la obtienen los motores que leen esa capa. Una herramienta apuntada directamente a los archivos Parquet subyacentes se salta por completo el historial de commits y ve lo que haya en el almacenamiento, incluidos archivos de una escritura que nunca se confirmó.
¿Cómo es un despliegue sensato?
Convierte primero una tabla bien conocida, mantén la original escribiendo en paralelo y traslada a los consumidores de forma gradual comparando salidas. Acuerda quién se encarga de la expiración de instantáneas y de la compactación antes del arranque, porque el mantenimiento sin responsable es la razón más común de que un piloto exitoso se degrade en el trimestre siguiente.


