¿Qué es Data Observability?
|
6
minuto de lectura
Un panel puede estar técnicamente disponible y seguir siendo operativamente inútil.
Esa es la situación en la que se encuentran muchos equipos ahora mismo. El pipeline se ejecutó. El almacén está activo. El BI se carga sin errores. Luego, alguien nota que los ingresos están estancados al mediodía, faltan los pedidos de ayer o una columna clave cambió de tipo de la noche a la mañana e inesperadamente rompió un modelo descendente. Nada parecía caído, pero el negocio ya estaba tomando decisiones con datos erróneos.
Esa brecha entre el tiempo de actividad del sistema y la confianza en los datos es donde la Data Observability importa. Si su empresa utiliza datos para asignar presupuestos, gestionar operaciones, respaldar el Compliance o alimentar sistemas de IA, la Observability deja de ser una capa de ingeniería deseable. Se convierte en parte de la continuidad del negocio.
Índice de contenidos
Por qué la confianza en los datos es más frágil que nunca
Los fallos silenciosos crean riesgos para la continuidad del negocio
La corrección reactiva no es escalable
Qué es exactamente la Data Observability
El monitoreo detecta fallos conocidos
La Observability ayuda a responder por qué
Los cinco pilares de la Data Observability
Frescura y Timeliness
Volumen
Esquema
Distribución
Linaje
Data Observability frente a calidad de datos: una distinción crítica
Por qué los equipos los confunden
Dónde encaja cada uno
Cómo funcionan las arquitecturas modernas de Data Observability
El modelo en forma de T en la práctica
Por qué la IA importa en lo operativo
Poner en práctica la teoría con una plataforma
Cómo se asignan las capacidades a los modos de fallo cotidianos
Qué suele fallar en el despliegue
Su lista de verificación de implementación de Data Observability
Una secuencia inicial práctica
Por qué la confianza en los datos es más frágil que nunca
Un patrón de fallo común se ve así. Finanzas abre el panel ejecutivo antes de una reunión de junta y ve números que no coinciden con el informe de cierre. Marketing dice que el gasto de la campaña parece normal. Ventas dice que el pipeline cayó. La ingeniería de datos revisa los registros de orquestación y ve tareas en verde. Nadie sabe si el problema es una carga tardía, una transformación rota, un cambio de esquema o un flujo duplicado.
Por eso los incidentes de datos erróneos son tan perturbadores. No son ruidosos como las interrupciones de infraestructura. Son silenciosos. Los informes aún se generan, los gráficos aún se actualizan y la gente sigue usándolos hasta que alguien descubre la inconsistencia por accidente.
Para los equipos que intentan tratar los datos como un activo, la confianza no es abstracta. Afecta a la planificación, el Compliance, las previsiones y los resultados de los modelos. Si está trabajando en ese marco empresarial más amplio, esta guía de expertos para el ROI de los activos de datos es útil porque conecta la fiabilidad técnica con el valor ejecutivo, que suele ser la conversación que falta.
Los fallos silenciosos crean riesgos para la continuidad del negocio
El problema no es solo la exactitud. Es el tiempo.
Un panel desactualizado una hora antes de una decisión de precios es un problema de continuidad. Un lote que falta en un flujo de trabajo de reclamaciones es un problema de continuidad. Un cambio no detectado en los datos de entrada del modelo es un problema de continuidad. En cada caso, el negocio sigue avanzando, pero lo hace con información comprometida.
Rara vez se culpa a los equipos de datos porque un pipeline falló de manera visible. Se les culpa cuando todo parecía normal y, aun así, los números eran incorrectos.
Esa presión explica por qué la categoría se está expandiendo tan rápidamente. Se prevé que el mercado global de Data Observability alcance los 7.010 millones de USD para 2033, expandiéndose desde los 2.300 millones de USD en 2023 a una tasa de crecimiento anual compuesto (CAGR) del 11,8%, según las proyecciones de mercado sobre el crecimiento de la Data Observability. La misma proyección vincula ese crecimiento con la necesidad de detectar anomalías, identificar las causas raíz y prevenir interrupciones antes de que afecten a los resultados comerciales.
La corrección reactiva no es escalable
Muchos equipos comienzan con comprobaciones manuales, aserciones SQL y unas pocas alertas de alto valor. Eso funciona por un tiempo.
Luego la plataforma se expande. Llegan más fuentes. La propiedad se distribuye. BI y ML consumen las mismas tablas ascendentes. Un problema en un panel ahora podría originarse cinco transformaciones antes, y para cuando alguien se da cuenta, varios productos descendentes ya están afectados.
En ese punto, la depuración reactiva se vuelve costosa porque cada incidente se convierte en un ejercicio de investigación. No solo está solucionando datos erróneos. Está reconstruyendo la cadena de eventos que los causó.
Qué es exactamente la Data Observability
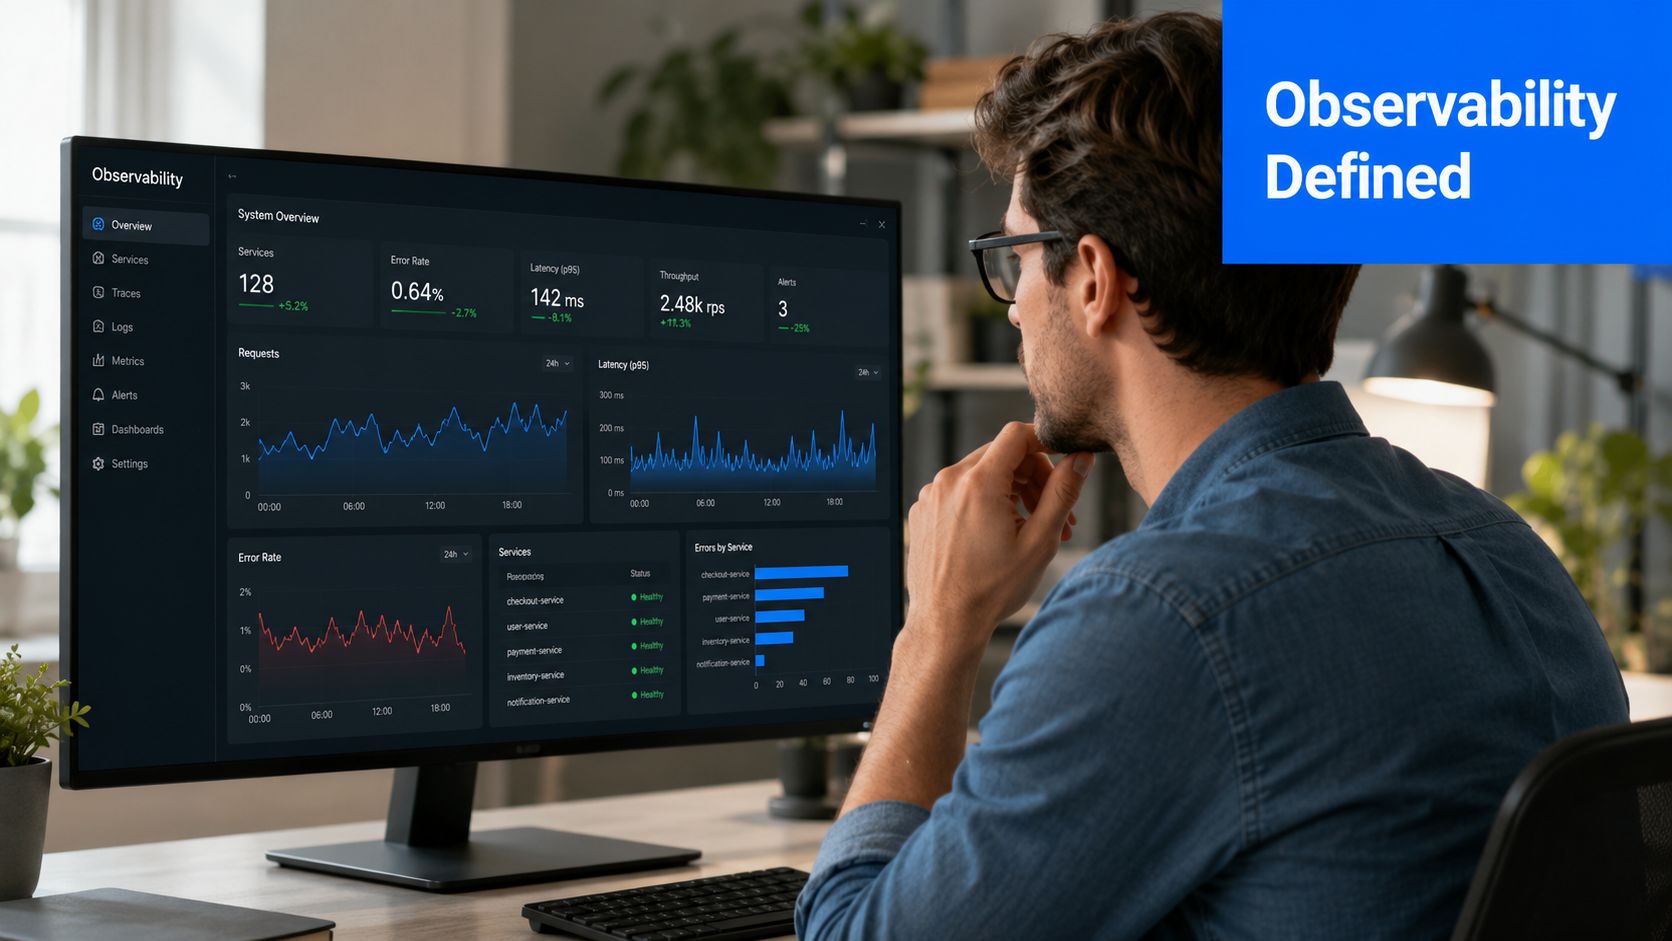
La Data Observability es la práctica de comprender la salud de los sistemas de datos mediante la inspección continua de las señales que producen los datos y los pipelines. En términos prácticos, le indica si los datos llegan a tiempo, con la forma esperada, con el comportamiento previsto y con suficiente contexto para rastrear los problemas hasta su origen.
Una analogía útil proviene de las operaciones de software. El monitoreo de rendimiento de aplicaciones (APM) les dice a los ingenieros que una aplicación es lenta, está fallando o se comporta de manera anormal. La Data Observability aplica esa misma mentalidad a las plataformas de datos. No se detiene en “la tarea se completó con éxito”. Pregunta si el resultado es confiable.
El monitoreo detecta fallos conocidos
El monitoreo tradicional es útil, pero es más limitado.
Funciona mejor cuando ya se conoce el modo de fallo. Si un pipeline falla, alerta. Si la latencia supera un umbral, alerta. Si una tabla no se actualizó a una hora fija, alerta. Esas comprobaciones son necesarias, pero asumen que el problema ha sido anticipado y codificado.
La Observability maneja los casos que sus comprobaciones estáticas no predijeron. Un pipeline puede completarse con éxito mientras produce la mitad de las filas esperadas. Una combinación (join) aún puede ejecutarse mientras causa un cambio de distribución en una métrica crítica. Una columna puede seguir presente pero cambiar de significado a través de la lógica ascendente.
La Observability ayuda a responder por qué
Ese es el cambio fundamental en la frase qué es la Data Observability. No es solo una capa de monitoreo con más alertas. Es una forma de pasar de la búsqueda reactiva de síntomas al diagnóstico a nivel de sistema.
Una práctica de Observability sólida suele hacer cuatro cosas a la vez:
Detecta anomalías ocultas: Señala comportamientos inesperados incluso cuando las tareas se realizan con éxito.
Proporciona contexto: Muestra qué cambió, cuándo cambió y qué depende de ello.
Acelera el triaje: Ayuda a dirigir los incidentes al propietario adecuado más rápidamente.
Respalda la prevención: Expone patrones que permiten a los equipos eliminar causas recurrentes, no solo limpiar los resultados.
Regla práctica: Si su configuración actual le dice que un pipeline se ejecutó pero no puede decirle si los datos resultantes son utilizables, tiene monitoreo. Aún no tiene Observability.
La diferencia importa porque a los usuarios de negocio no les importa si Airflow, dbt o el almacén completaron una tarea. Les importa si se puede confiar en el panel, informe o modelo en este mismo momento.
Los cinco pilares de la Data Observability
La Data Observability resulta más fácil de operacionalizar cuando se divide en señales. Las investigaciones del sector señalan que el tiempo promedio para detectar y resolver problemas de calidad de datos es de aproximadamente 4 a 9 horas sin prácticas de Observability efectivas, y que el monitoreo continuo de la frescura, el volumen, el esquema, la distribución y el linaje ayuda a los equipos a reducir el impacto de esos problemas, tal como se describe en esta descripción general de los cinco pilares de la Data Observability.
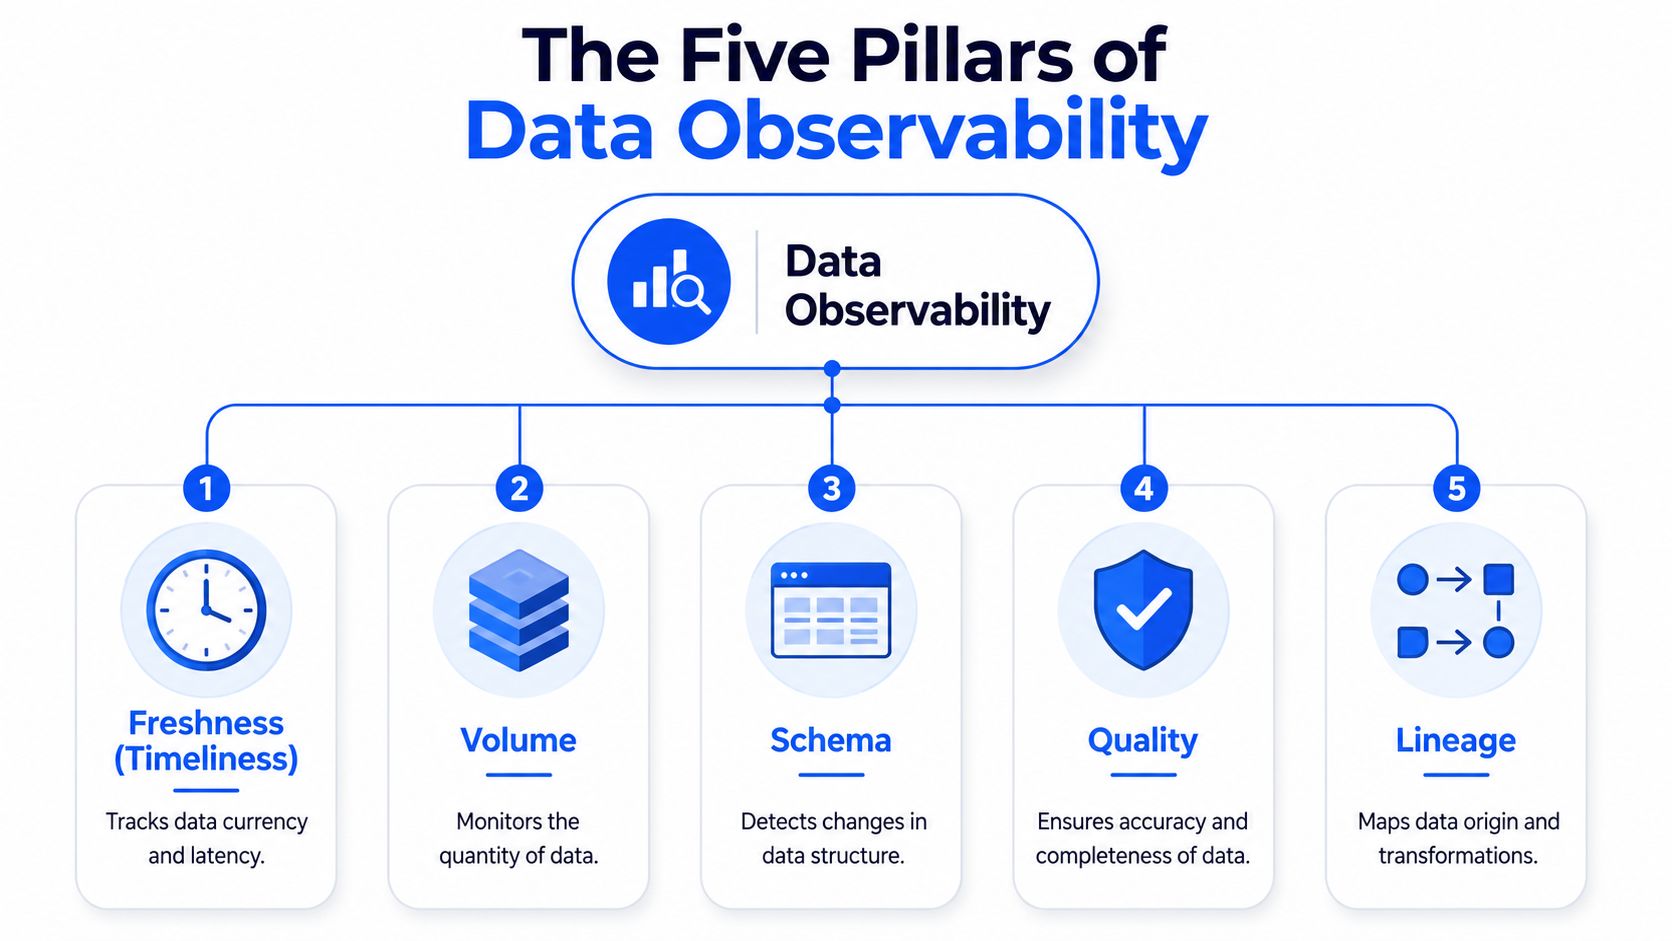
Frescura y Timeliness
La frescura plantea una pregunta operativa básica: ¿Llegaron los datos cuando el negocio los esperaba?
Eso suena simple, pero es una de las comprobaciones más importantes en producción. Un informe que es estructuralmente correcto pero llega con seis horas de retraso aún puede desencadenar malas decisiones.
Utilice el monitoreo de frescura para:
Flujos programados: Cargas diarias o por horas que deben llegar a tiempo.
Paneles operativos: Métricas vinculadas a la dotación de personal, inventario, revisión de fraudes o ventanas de negociación.
Entradas de IA sensibles al tiempo: Funciones que resultan engañosas cuando se retrasan.
Si su equipo desea un ejemplo concreto de esta categoría de señales, el monitoreo de Timeliness en la práctica muestra cómo el conocimiento de la programación y el seguimiento de la entrega esperada se integran en la Observability.
Un ejemplo práctico es una tabla de pedidos diarios que suele actualizarse antes de las horas de apertura comercial. Si no ha llegado, es posible que tanto finanzas como operaciones estén mirando números desactualizados sin darse cuenta.
Antes de profundizar, este breve video ofrece una buena descripción visual del concepto.
Volumen
El volumen rastrea si la cantidad de datos se encuentra dentro de un rango esperado.
Esto detecta fallos graves rápidamente. Si los recuentos de filas se desploman repentinamente, probablemente algo se rompió en una etapa anterior. Si los recuentos aumentan inesperadamente, es posible que se esté produciendo una duplicación o una repetición.
Un modelo mental útil es la recepción de un almacén. Si normalmente llegan diez camiones y solo aparecen dos, no se necesita un análisis de causa raíz perfecto para saber que las operaciones están en riesgo.
Esquema
La Observability del esquema vigila la estructura. Las columnas agregadas, eliminadas, renombradas o modificadas en su tipo pueden romper la lógica descendente incluso cuando las tareas de ingesta y transformación sigan informando de un éxito.
Por eso los incidentes de esquema son tan frustrantes. A menudo, el pipeline no está técnicamente "caído". Simplemente produce un resultado que los consumidores descendentes ya no pueden interpretar correctamente.
Los ejemplos comunes incluyen:
Cambios de tipo: De entero a cadena, o cambios de formato de marca de tiempo.
Eliminaciones de columnas: Un campo desaparece de una API de origen o de un modelo de transformación.
Cambios de nulabilidad: Un campo previamente obligatorio comienza a llegar parcialmente vacío.
Distribución
La distribución va más allá de los recuentos y la estructura. Examina el comportamiento de los valores.
Si la tasa de conversión, la tasa de nulos, la combinación de categorías o el tamaño promedio de la cesta cambian repentinamente fuera de los patrones normales, las comprobaciones de distribución lo detectan. La Observability comienza entonces a captar sutiles problemas comerciales que los umbrales fijos suelen pasar por alto.
Una combinación (join) rota es el ejemplo clásico. Los recuentos de filas pueden parecer correctos y el esquema puede no haber cambiado, pero los valores importantes aún pueden desviarse de formas que dañan los informes y los modelos.
Linaje
El linaje responde a la pregunta que todo director de incidentes se hace primero: ¿Dónde empezó esto y qué más afectó?
El linaje importa porque los fallos de datos se propagan. Una sola transformación ascendente puede afectar a múltiples mercados de datos (marts), paneles, salidas de ETL inverso y pipelines de características. Sin linaje, los equipos pasan demasiado tiempo adivinando dónde mirar y a quién notificar.
Si no puede rastrear una métrica hasta su origen y hacia adelante hasta sus consumidores, depurará los incidentes entrevistando a personas en lugar de inspeccionar los sistemas.
En conjunto, estos pilares forman una lista de verificación práctica. Si una plataforma o proceso cubre solo uno o dos de ellos, los equipos suelen acabar con una visibilidad fragmentada y una resolución más lenta.
Data Observability frente a calidad de datos: una distinción crítica
Los equipos suelen utilizar estos términos de manera indistinta, lo que genera confusión en la selección de herramientas y en los modelos operativos. Están relacionados, pero no son lo mismo.
Una analogía sencilla ayuda. Un médico que comprueba el pulso, el nivel de oxígeno y la temperatura está observando el estado del paciente. Un médico que solicita una prueba específica para una enfermedad conocida está validando con respecto a una regla definida. La Data Observability está más cerca de lo primero. La calidad de los datos está más cerca de lo segundo.
Por qué los equipos los confunden
La confusión se produce porque ambas disciplinas intentan producir datos confiables.
La calidad de los datos se centra en si estos cumplen con las expectativas comerciales definidas. ¿Es válido un correo electrónico? ¿Es único el ID de una cuenta? ¿Está presente un campo obligatorio? Esas son reglas explícitas, a menudo vinculadas al Compliance, a contratos o a estándares operativos.
La Data Observability se centra en si el sistema de datos se comporta normalmente y si están surgiendo anomalías. Observa patrones, movimientos, dependencias y cambios a lo largo del tiempo. Si desea un desglose más centrado en el producto, esta explicación de la Data Observability frente a la calidad de los datos es un complemento útil.
Dónde encaja cada uno
Aquí está la distinción práctica:
Dimensión | Calidad de los Datos | Data Observability |
|---|---|---|
Enfoque principal | Contenido de los datos y conformidad con las reglas | Salud de los datos, comportamiento y contexto del sistema |
Método típico | Reglas de validación y aserciones | Detección de anomalías, monitoreo y análisis de linaje |
Mejor para detectar | Problemas conocidos | Problemas desconocidos o emergentes |
Ejemplo de pregunta | ¿Es único el | ¿Por qué las tasas de nulos se dispararon repentinamente en |
Orientación temporal | Exactitud en un momento dado | Conciencia operativa continua |
Resultado principal | Cumplimiento de las reglas | Detección temprana y diagnóstico más rápido |
Una plataforma madura necesita ambos.
La calidad de los datos sin Observability se vuelve frágil porque los equipos solo pueden detectar aquello que predijeron. La Observability sin calidad deja lagunas donde las reglas comerciales explícitas son obligatorias. Los flujos de trabajo regulados, los requisitos de auditoría y los estándares de datos contractuales aún necesitan comprobaciones deterministas.
Una buena calidad de datos le dice si un registro pasa la validación. Una buena Observability le dice si el sistema que produjo el registro se está desviando hacia el fallo.
El modelo operativo más sólido trata la calidad y la Observability como capas complementarias, no como categorías que compiten entre sí.
Cómo funcionan las arquitecturas modernas de Data Observability
Un pipeline falla a las 2:00 a.m. La rotura del panel es solo el síntoma visible. Para cuando finanzas, operaciones o un modelo de cara al cliente muestran datos erróneos, el negocio ya ha absorbido el primer coste de la inactividad de los datos: decisiones paralizadas, pérdida de confianza e ingenieros dedicados al triaje manual.
La arquitectura determina si la Observability acorta ese incidente o lo extiende a lo largo del día.
Un diseño moderno monitorea toda la ruta de producción, incluidas las capas de ingesta, transformación, tablas de servicio, activos de BI y consumidores de ML. Los problemas rara vez comienzan en el panel final. Empiezan antes, en un cambio de esquema ascendente, una dependencia retrasada, una transformación rota o un patrón de desviación que nadie modeló explícitamente. Sin linaje a través de esas capas, la respuesta a los incidentes se convierte en un costoso juego de adivinanzas.
Es por eso que el modelo de ejecución importa tanto como la lista de características. Si una plataforma solo vigila las tablas descendentes, los equipos detectan los fallos después de que aparezca el impacto comercial. Si requiere extraer datos a un entorno de proveedor, la revisión de seguridad, la latencia y el coste adicional pueden ralentizar la adopción. Si la cobertura del monitor depende de comprobaciones creadas a mano para cada activo importante, el sistema se convierte en otra carga de mantenimiento en lugar de una capa operativa.
El modelo en forma de T en la práctica
Un patrón de arquitectura funciona bien en grandes patrimonios de datos: el modelo de monitoreo en forma de T.
La capa horizontal aplica un monitoreo ligero en todo el almacén. Eso normalmente incluye frescura, cambios de volumen, ejecuciones fallidas, brechas de linaje y otras señales amplias que indican que algo cambió. La capa vertical profundiza en los activos vinculados a los informes de ingresos, paneles ejecutivos, flujos de trabajo de Compliance y modelos de ML de producción. DataHub describe este enfoque en su explicación del monitoreo en forma de T.
Esta es una decisión de continuidad del negocio, no solo una preferencia de monitoreo. Una cobertura idéntica en todas partes suena disciplinada, pero a menudo genera ruido de alertas y desperdicia tiempo de ingeniería en activos de bajo impacto. Centrarse solo en un conjunto limitado de tablas críticas crea puntos ciegos ascendentes, dónde comienzan muchos incidentes. La forma en T equilibra ambos aspectos: una visión amplia de todo el patrimonio e inspección más profunda allí donde la inactividad cuesta más.
En la práctica, los equipos sólidos también extienden ese modelo con el contexto de uso y comportamiento. El monitoreo se vuelve más útil cuando los arquitectos pueden conectar las señales técnicas con los patrones de consumo, la propiedad y los procesos comerciales descendentes. Ese es el propósito de extender la Data Observability con analítica. Ayuda a los equipos a decidir qué anomalías son ruido operativo y cuáles amenazan un proceso de cierre de trimestre, un KPI ejecutivo o un flujo de trabajo del cliente.
Por qué la IA importa en lo operativo
Los umbrales estáticos fallan en los sistemas en vivo.
Los patrones de datos cambian con la estacionalidad, los lanzamientos, las actualizaciones de precios, las adquisiciones y el comportamiento cambiante de los usuarios. Una regla que funcionaba hace tres meses puede pasar por alto un incidente real hoy o activarse continuamente ante variaciones normales. Los equipos entonces pasan su tiempo ajustando los monitores en lugar de mejorar la fiabilidad del pipeline.
La Observability impulsada por IA aborda ese problema al aprender el comportamiento histórico y evaluar las anomalías en su contexto. Se adapta mejor a la detección de desviaciones, combinaciones (joins) inusuales, distribuciones cambiantes y alteraciones de tiempo que no se ajustan fácilmente a una regla fija. Eso reduce los falsos positivos y acorta el tiempo para encontrar la causa raíz, especialmente en entornos con cientos o miles de activos.
La arquitectura más sólida es híbrida. Utilice líneas base aprendidas para detectar modos de fallo desconocidos. Mantenga las comprobaciones deterministas para los SLA contractuales, los campos regulados y las reglas de negocio que necesitan una lógica explícita de aprobación o rechazo. Esa combinación lleva la Observability de una limpieza reactiva a un sistema de alerta temprana para los datos de los que el negocio depende cada día.
Poner en práctica la teoría con una plataforma
La teoría solo importa si cambia las operaciones cotidianas. En la práctica, los equipos necesitan una capa para la detección de anomalías, otra para la validación determinista y suficiente contexto histórico para decidir si una alerta es ruido o el inicio de un incidente.
Un obstáculo operativo importante es el mantenimiento de monitores frágiles. Un informe de Accenture de 2025 sobre la productividad de la ingeniería de datos indica que entre el 40 y el 60 % del tiempo del equipo de datos se destina al mantenimiento preventivo de reglas basadas en umbrales, un coste destacado en el debate de Databricks sobre la carga oculta del mantenimiento en la Data Observability. Esa es una de las razones por las que los equipos están avanzando hacia una detección impulsada por IA que puede reducir los falsos positivos y acortar el análisis de la causa raíz.
Cómo se asignan las capacidades a los modos de fallo cotidianos
Una plataforma práctica se asigna directamente a los patrones de incidentes que los equipos de datos ya conocen:
Cargas tardías o faltantes: El monitoreo de Timeliness detecta llegadas desactualizadas antes de que se vea afectado un panel de la junta o un flujo de trabajo impulsado por un SLA.
Desviación silenciosa de métricas: La detección de anomalías saca a la luz cambios inesperados en el comportamiento del volumen o de los valores sin esperar a que un humano se dé cuenta.
Cambios estructurales disruptivos: El seguimiento del esquema señala campos agregados, eliminados o modificados antes de que fallen las transformaciones descendentes.
Necesidades de políticas a nivel de registro: Las reglas de validación siguen siendo importantes allí donde la lógica empresarial, las auditorías o el Compliance requieren comprobaciones explícitas de aprobación o rechazo.
Revisión de patrones a lo largo del tiempo: El análisis histórico ayuda a los equipos a ver si una alerta es un pico aislado o parte de una debilidad operativa recurrente.
Un ejemplo es la extensión analítica de digna para Observability, que combina la detección de anomalías y el monitoreo de Timeliness con el análisis de tendencias históricas, el seguimiento de esquemas y la validación a nivel de registro en entornos controlados por el cliente. Esa combinación refleja una realidad práctica. La Observability y la calidad son más fáciles de operar cuando no están divididas en herramientas desconectadas.
Qué suele fallar en el despliegue
El error más común en el despliegue es intentar instrumentar cada tabla con la misma profundidad desde el primer día.
Eso genera demasiadas alertas, una propiedad poco clara y escepticismo por parte de los usuarios de negocio. Una secuencia mejor es más acotada. Comience con los activos vinculados a los ingresos, las finanzas, los informes de clientes, los procesos regulados o las entradas de modelos. Aplique frescura, volumen, esquema y linaje alrededor de esos primero. Luego expándase.
Otro error es tratar la Observability como un asunto puramente de ingeniería. Los responsables de operaciones, analítica, governance y ML necesitan visibilidad porque experimentan síntomas diferentes a causa del mismo defecto ascendente.
Su lista de verificación de implementación de Data Observability
Un despliegue suele empezar de la misma manera. Finanzas pregunta por qué cambió la métrica de la junta de ayer. Operaciones ve un informe de SLA roto. El equipo de datos empieza a rastrear tareas, comprobar ejecuciones de dbt y comparar recuentos de filas a mano. Para cuando la causa raíz está clara, el negocio ya ha estado operando con información errónea.
Por eso la implementación debe tratarse como un ejercicio de continuidad del negocio, no como un proyecto de monitoreo. Comience allí donde unos datos erróneos interrumpirían las decisiones, los informes, los ingresos, el Compliance o el rendimiento del modelo. Luego, expanda la cobertura de una manera que su equipo pueda operar.

Una secuencia inicial práctica
La cobertura debe seguir la ruta del impacto comercial. Si un KPI se rompe en un panel, el fallo a menudo se encuentra varios pasos atrás en la ingesta, la transformación o un cambio de esquema que nunca llegó a la capa de informes. Los equipos necesitan suficiente linaje y profundidad de monitoreo para rastrear esa ruta rápidamente, sin intentar instrumentar cada tabla el primer día.
Utilice esta lista de verificación como secuencia de inicio:
Definir los activos de datos críticos
Haga una lista de los paneles, informes, modelos y tablas operativas sin los cuales el negocio no puede funcionar de manera segura. Priorice por consecuencias, no por cantidad de tablas.Comenzar con la frescura y el volumen
Estas señales detectan muchos fallos operativos a tiempo y suelen ser las más rápidas de configurar. También crean una primera línea base clara para las alertas.Mapear una ruta de linaje de alto valor
Rastree una métrica importante desde el origen hasta el consumo descendente en BI o ML. Esto suele exponer brechas de propiedad, dependencias no documentadas y transformaciones frágiles más rápidamente que una cobertura amplia pero superficial.Agregar detección de cambios de esquema
La desviación estructural causa fallos silenciosos. Las columnas se renombran, los tipos cambian, los campos que admiten nulos dejan de hacerlo y la lógica descendente se rompe horas después.Incorporar comprobaciones de distribución para conjuntos de datos de alto impacto
Los datos nuevos aún pueden ser erróneos. Las comprobaciones de distribución ayudan a detectar fallos de combinación (joins), regresiones en la lógica empresarial, sesgos y desviaciones antes de que los usuarios los detecten en un informe o en el resultado de un modelo.Elegir una plataforma que limite el mantenimiento manual de reglas
Si cada monitor necesita un ajuste constante de los umbrales, la Observability se convierte en otra tarea pendiente. El establecimiento de líneas base y el triaje asistidos por IA ayudan a los equipos a pasar más tiempo solucionando problemas reales y menos tiempo vigilando las alertas.
¿Puede su modelo operativo indicar a finanzas, operaciones, producto y analítica si los productos de datos de los que dependen están sanos en este momento, y puede hacerlo antes de que un defecto se traduzca en un tiempo de inactividad comercial?
Si su equipo desea pasar de la depuración reactiva al control proactivo, digna ofrece capacidades de Data Observability y calidad de datos, tales como detección de anomalías, monitoreo de Timeliness, seguimiento de esquemas, validación y ejecución en base de datos para entornos controlados por el cliente.


