Marco de Calidad de Datos Empresariales: De las Métricas a la Confianza en la IA
|
8
minuto de lectura

Se puede tener un panel de control en verde y, aun así, estar entregando datos incorrectos. La canalización nocturna finaliza, el almacén de datos se carga, el informe de BI se actualiza y, a pesar de ello, alguien del lado del negocio sigue diciendo que los números no cuadran. Esa brecha es donde un marco de calidad de datos empresarial se gana su sustento, porque la calidad solo es útil cuando se gestiona continuamente, se asocia a una propiedad y se mide frente a lo que se supone que deben hacer los datos.
Tabla de contenidos
Lo que realmente resuelve un marco de calidad de datos empresarial
Hoja de ruta de implementación para almacenes y canalizaciones modernos
Lo que realmente resuelve un marco de calidad de datos empresarial
Un verdadero marco de calidad de datos empresarial resuelve la brecha de confianza entre los productores de datos y los consumidores de datos. No se trata de un esfuerzo de limpieza único, es un sistema gestionado de métricas, controles, propiedad y remediación que se sitúa a través de canalizaciones, almacenes de datos y casos de uso posteriores.
El modo de fallo nos resulta familiar. Un panel de ingresos es cuestionado en el ciclo de cierre. Los analistas pasan días conciliando los sistemas de origen. Un equipo de ML vuelve a entrenar modelos con datos que nadie puede certificar. Es por eso que la calidad ahora se sitúa más cerca de la Observability y la confiabilidad que de la limpieza administrativa. En la práctica, el marco transforma señales ruidosas como cargas retrasadas, cambios de esquema y transformaciones silenciosas en incidentes que alguien asume como propios.
Regla práctica: si nadie es responsable cuando se rompe una métrica de calidad, no tienes un marco, tienes un informe.
Los programas más sólidos separan el marco tanto de las reglas ad-hoc como de las características de los proveedores. El Data Governance define quién es el propietario del dominio, la arquitectura define dónde viven las comprobaciones y los controles computacionales definen qué se mide. Ese diseño por capas es lo que permite a los equipos pasar de notar los problemas tarde a detectarlos temprano y solucionarlos con evidencia.
Componentes principales que todo marco debe cubrir
Un marco utilizable comienza con lo básico y añade inteligencia sobre ello. El objetivo no es recopilar más comprobaciones, sino cubrir los modos de fallo que rompen los informes, las operaciones y los modelos.
Líneas de base, reglas y señales de deriva
El perfilado de datos establece la forma esperada de los datos. Las reglas de validación imponen restricciones conocidas en los límites de ingesta y transformación, aspectos como campos obligatorios, valores aceptados y comprobaciones referenciales. La detección de anomalías captura picos de volumen, cambios de distribución y deriva de cardinalidad que las reglas estáticas no predecirían.
El valor operativo proviene de cómo se complementan estas capas. El perfilado te dice cómo se ve lo "normal". La validación bloquea las infracciones obvias. La detección de anomalías captura los casos extraños que parecen válidos pero no se comportan con normalidad. Si deseas un punto de referencia útil para un diseño de governance más amplio, el marco de governance del programador del servidor es una lectura adyacente muy práctica porque trata el control como un modelo operativo, no como una lista de verificación.
Contratos, frescura y campos críticos
El seguimiento de esquemas protege la interfaz entre productores y consumidores. Detecta columnas añadidas, campos eliminados y cambios en los tipos de datos antes de que se rompa un panel de control o un modelo posterior. Los SLA de frescura y Timeliness hacen explícita la expectativa de entrega, de modo que los equipos puedan distinguir entre "cargado" y "utilizable". Las comprobaciones de completitud y unicidad protegen los campos que impulsan las uniones, la facturación y la ingeniería de características.
Componentes principales del marco y su propósito operativo | Qué detecta | Dónde se ejecuta | Señal principal |
|---|---|---|---|
Perfilado | Forma de la línea de base, patrones de nulos, valores atípicos | Almacén de datos o lago de datos | Distribución histórica |
Validación | Infracciones de reglas, valores no válidos | Ingesta y transformación | Aprobado o fallido |
Detección de anomalías | Sorpresas de volumen, deriva y cardinalidad | Observability en base de datos o externa | Desviación de la línea de base |
Seguimiento de esquemas | Cambios estructurales | Orquestador, almacén de datos o catálogo | Violación del Data Contract |
SLA de frescura | Entrega retrasada o ausente | Capa de canalización y programación | Retraso en la entrega |
Completitud y unicidad | Campos críticos faltantes, entidades duplicadas | Nivel de tabla y registro | Cobertura y deduplicación |
Un marco práctico también hace visible la calidad a nivel de dominio. Ahí es donde un modelo compartido como el de las dimensiones de la calidad de datos de digna ayuda a los equipos a asignar señales a propietarios responsables sin convertir cada comprobación en un debate independiente.
Roles de Governance y la capa humana
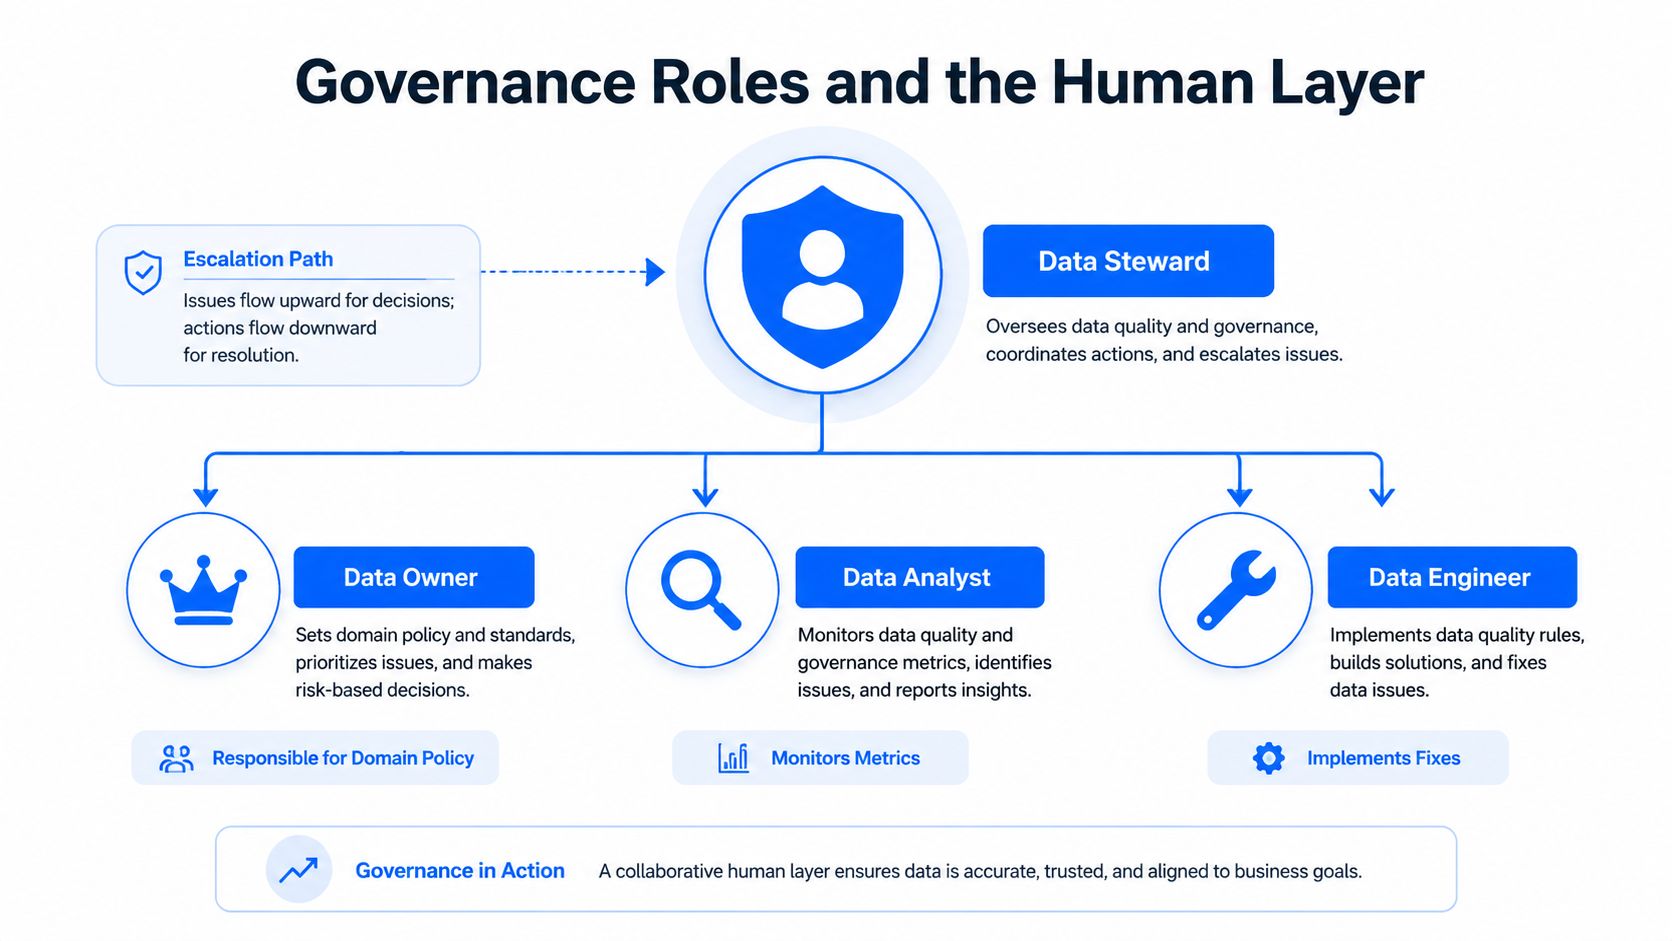
Las comprobaciones técnicas no resuelven los desacuerdos por sí solas. Un umbral roto, una definición de métrica en disputa o un archivo ascendente retrasado siguen necesitando un propietario humano, y el marco tiene que definir quién es antes de que se active la alerta.
Quién es el propietario de la respuesta
La pila de responsabilidad más clara es sencilla. Los propietarios de datos asumen la responsabilidad empresarial de la corrección. Los custodios de datos (stewards) clasifican las alertas y coordinan la remediación. Los custodios técnicos y los ingenieros de datos implementan los controles y reparan la canalización. Un consejo de datos u órgano de governance resuelve los conflictos entre dominios y aprueba las políticas.
Esa estructura importa más en industrias reguladas porque el rastro de la evidencia debe sobrevivir a una auditoría. En finanzas, atención médica y seguros, no basta con decir que un problema se solucionó. Los equipos necesitan mostrar qué falló, quién lo vio, qué acción se tomó y cuándo volvieron a estar en servicio los datos. En empresas de ritmo más rápido, la carga de documentación puede ser menor, pero el modelo de roles de igual manera debe existir.
Políticas que transforman las señales en acción
Las alertas de detección de anomalías, seguimiento de esquemas y SLA de frescura deben dirigirse a la creación de tickets con niveles de servicio explícitos. Los Data Contracts definen la forma y el comportamiento esperados de un conjunto de datos. Los SLA de calidad definen cuándo vence la respuesta. Los manuales de ejecución (runbooks) definen la ruta de solución. Sin esos artefactos, el monitoreo solo genera ruido.
Para una visión más detallada de cómo se asignan los roles a la práctica operativa, la guía de roles de data governance es un punto de referencia interno útil. Es especialmente relevante cuando un custodio tiene que decidir si un incidente es un problema del productor, de la transformación o de la expectativa del consumidor.
Cuando la alerta llega a un custodio, el tiempo empieza a correr para la respuesta, no para el descubrimiento.
Patrones de arquitectura para la calidad de datos a escala
Los equipos empresariales suelen terminar con uno de estos tres patrones. La elección correcta depende de dónde viven los datos, qué tan sensibles son y cuánta inteligencia estadística necesita la pila.
En base de datos, externo o híbrido
La calidad en la base de datos utiliza SQL ANSI, pruebas de dbt y funciones nativas del almacén de datos. Mantiene bajo el movimiento de datos y se ajusta estrechamente al control de acceso, por lo que a menudo es la opción más segura para entornos con información de identificación personal (PII) regulada. La contrapartida es que las tablas de hechos de gran tamaño pueden encarecer las comprobaciones repetitivas, y los enfoques basados únicamente en SQL no siempre gestionan adecuadamente los patrones de anomalías históricas.
Las plataformas de Observability externas perfilan y monitorean fuera del almacén de datos. Son mejores para la correlación entre diferentes fuentes, el aprendizaje de líneas de base y el análisis de tendencias a lo largo de extensos historiales. La contrapartida es una superficie de revisión de seguridad más amplia y la replicación de metadatos que algunos equipos de plataforma prefieren evitar.
Un patrón de diseño muy útil es el híbrido. Consiste en ejecutar comprobaciones ligeras en la base de datos y, a continuación, trasladar la detección de deriva impulsada por ML y el análisis histórico a una capa externa. Ahí es también donde la perspectiva del diseño del almacén de datos para líderes de ingeniería resulta útil, porque las decisiones de arquitectura y de calidad terminan influyendo mutuamente.
Aplicación en la capa de canalización
Los contratos declarativos, los registros de esquemas y los SLA de frescura pertenecen a la orquestación, no a una hoja de cálculo independiente de estándares. El objetivo es hacer que la calidad forme parte del despliegue y la entrega. Si un productor cambia un campo o un lote no cumple con su ventana de tiempo, la canalización debe reflejarlo de inmediato en lugar de esperar a una queja en un panel de control.
Arquitectura de calidad de datos en base de datos frente a externa | En base de datos (SQL/dbt/Nativo) | Plataforma de Observability externa | Patrón híbrido |
|---|---|---|---|
Movimiento de datos | Bajo | Mayor debido a la sincronización de metadatos | Bajo para comprobaciones, mayor para análisis |
Postura de seguridad | Fuerte dentro del almacén de datos | Requiere revisión adicional | Equilibrado por tipo de control |
Detección de anomalías | Limitada a menos que sea personalizada | Sólido soporte para líneas de base históricas | Ligero más deriva impulsada por ML |
Tiempo de obtención de valor | Rápido para comprobaciones estándar | Más rápido para una visibilidad amplia | Moderado, pero escalable |
Escala en tablas grandes | Puede ser costoso | Mejor para tendencias entre tablas | Dividido por caso de uso |
Mejor ajuste | Entornos regulados y sensibles a los costos | Entornos de múltiples equipos y rápida adopción | Entornos con madurez mixta |
Para una perspectiva arquitectónica más profunda, la página de arquitectura del sistema de datos de digna es de gran utilidad, ya que muestra cómo las verificaciones de calidad se integran en la capa de la plataforma en lugar de permanecer aisladas.
Hoja de ruta de implementación para almacenes y canalizaciones modernos
El despliegue funciona mejor cuando comienza a pequeña escala y se expande solo después de que los primeros controles demuestren su utilidad. Los equipos que intentan cubrir cada conjunto de datos desde el primer día suelen acabar con muchas reglas y muy poca adopción.

Comenzar con los conjuntos de datos que importan
Comience realizando un inventario de los conjuntos de datos críticos, los consumidores posteriores y los puntos de fallo conocidos. A continuación, establezca una línea de base del estado actual, incluidos los incidentes que ya están ocurriendo pero que solo se solucionan en hojas de cálculo o reuniones. Esto proporciona al programa un punto de partida medible en lugar de un objetivo teórico.
Incrustar verificaciones donde se mueven los datos
Instrumente el código de ingesta y transformación con pruebas de esquema, comprobaciones de nulos, comprobaciones de rango y aserciones de frescura. No los añada más tarde. Si la comprobación vive al lado del código que crea los datos, es mucho más probable que los ingenieros la traten como parte de la calidad del Release.
Automatizar el escalamiento y ampliar la cobertura
Una vez que los aspectos básicos sean estables, agregue detección de anomalías, cuarentena automática de filas defectuosas y flujos de trabajo de creación de tickets que se dirijan al custodio adecuado. Después de eso, amplíe la cobertura con generación de pruebas basada en metadatos y plantillas de SLA para que los conjuntos de datos secundarios no queden ignorados. La guía de implementación en la página de implementación de calidad de datos de digna es muy relevante aquí porque alinea el despliegue con la madurez operativa en lugar de con la novedad de las herramientas.
La señal de éxito más útil resulta aburrida. Menos reexpresiones, menos conciliaciones manuales, menos descubrimientos tardíos.
Preparar el marco para IA y ML
Los programas de calidad tradicionales basados en reglas se detienen demasiado pronto para la IA. Detectan nulos, duplicados y problemas de integridad referencial, pero a menudo pasan por alto las condiciones que dañan los resultados de los modelos.
Qué cambia una vez que los modelos consumen los datos
La calidad preparada para la IA añade linaje, perfilado de instantáneas de entrenamiento, comprobaciones de sesgo y equidad, y monitoreo de deriva de características. También añade controles de procedencia, hashes de versión y expectativas de reproducibilidad para que los equipos puedan rastrear una predicción hasta el conjunto de datos que la produjo. Para las canalizaciones de LLM, el linaje de prompts y embeddings también importa, porque la ruta de entrada del modelo se convierte en parte del historial de auditoría.
Ese cambio modifica el conjunto de KPIs. La frescura de las características, la calidad de las etiquetas, la velocidad del cambio de distribución y la proporción de predicciones vinculadas a conjuntos de datos certificados se vuelven más relevantes que las tasas brutas de aprobación de reglas. Si el entorno de producción consume características obsoletas, el modelo puede estar técnicamente "sano" y, aun así, estar equivocado.
Dónde se queda corta la DQ tradicional
Las reglas heredadas rara vez le indican si un conjunto de entrenamiento refleja a la población real. No detectarán el sesgo de muestreo solo porque cada fila sea válida. No revelarán la filtración de etiquetas solo porque el esquema parezca limpio. Por eso los programas preparados para IA necesitan un monitoreo que entienda el contexto del modelo, no solo la integridad de las tablas.
La guía de habilitación de IA empresarial es un complemento muy útil porque trata la preparación de datos como parte de un modelo operativo más amplio, no como un proyecto de ML independiente. Para el monitoreo a nivel de características, la detección de deriva de modelos de digna se integra de forma natural en la misma capa de control.
Controles de calidad de datos tradicionales frente a preparados para IA | DQ tradicional basada en reglas | DQ preparada para IA/ML | KPI a monitorear |
|---|---|---|---|
Validez | Comprobaciones de formato y rango | Comprobaciones de distribución de características | Tasa de aprobación de reglas |
Completitud | Detección de campos faltantes | Ausencia de datos por segmento | Cobertura de valores faltantes |
Unicidad | Detección de entidades duplicadas | Resolución de entidades en conjuntos de entrenamiento | Tasa de duplicados |
Linaje | Limitado o manual | Procedencia de características de extremo a extremo | Cobertura de linaje |
Frescura | Tiempos de entrega de canalización | Antigüedad de características frente a ventana de inferencia | Brecha de frescura de características |
Sesgo y equidad | Normalmente ausente | Segmentación por atributos protegidos | Varianza del sesgo |
Escenario de extremo a extremo donde el marco da sus frutos
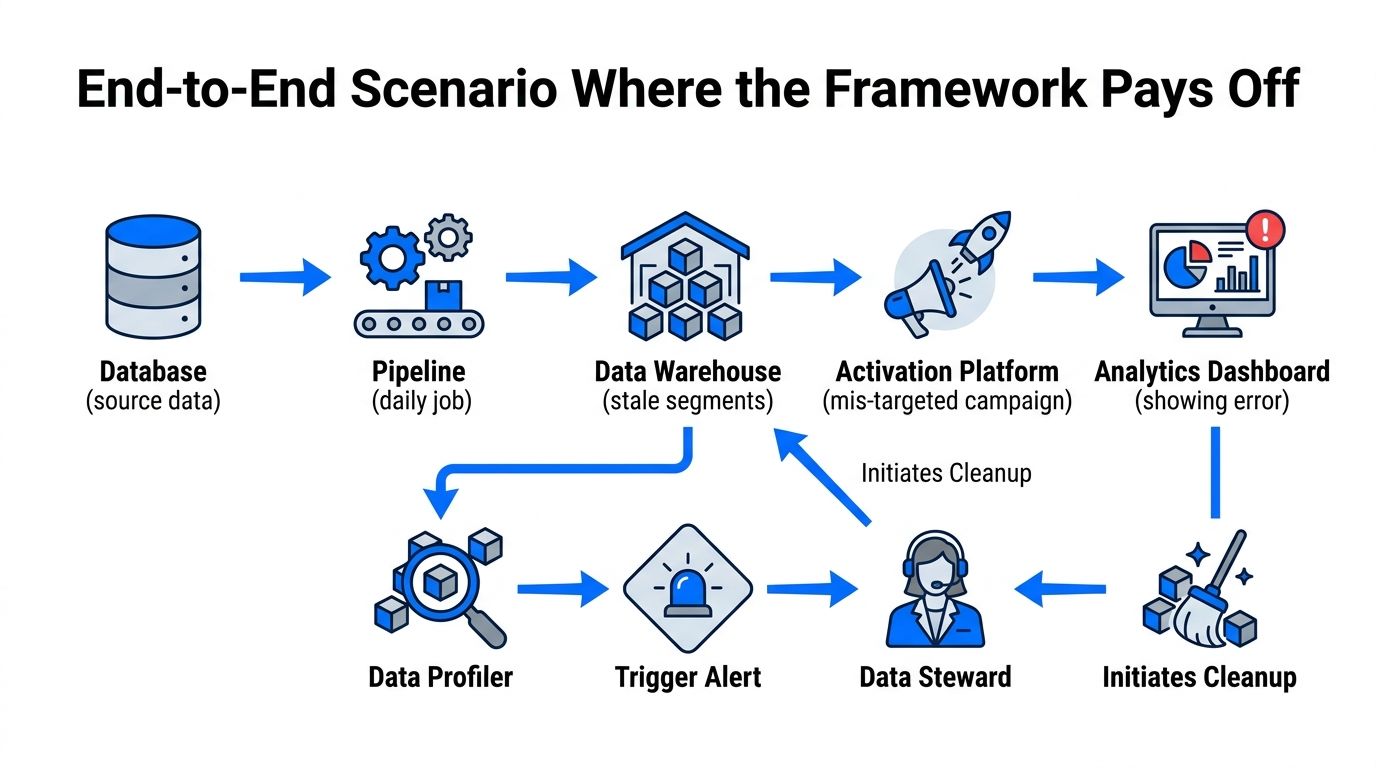
Una canalización de análisis de clientes se ejecuta cada noche y la tarea finaliza según lo programado. El equipo de activación asume que la actualización del segmento está al día, pero una tabla de origen ha dejado de actualizarse desde hace siete días. Los datos llegan a tiempo, pero aun así no están lo suficientemente actualizados para la lógica de la campaña.
Cómo se acumulan las señales
Un perfilador observa que el atributo del nivel de cliente se desvía de su patrón habitual. El seguimiento del esquema detecta un cambio de nombre de columna silencioso antes de que la unión posterior comience a fallar. La detección de anomalías alerta sobre una caída repentina en la tasa de nulos para un indicador crítico, lo que normalmente significa que la fuente ascendente ha cambiado su comportamiento. Los SLA de frescura confirman entonces el problema: la fuente está obsoleta aunque la canalización en sí se muestre en verde.
El custodio recibe la alerta, el propietario aprueba la remediación y el equipo de ingeniería reabre la carga histórica. Las características de ML posteriores se mantienen en cuarentena hasta que la versión de datos validada esté lista nuevamente. En una empresa regulada, el rastro de auditoría importa tanto como la solución, porque la frecuencia de reentrenamiento y la evidencia de control forman parte de la historia.
Autoevaluación del marco y KPIs
Un buen marco puede evaluarse en una revisión trimestral. Si las señales, los roles y las rutas de respuesta están claros, la madurez se hace visible sin necesidad de un largo debate.
Qué verificar
Señales: completitud, validez, unicidad, frescura, esquema, detección de anomalías.
Roles: patrocinador ejecutivo, propietarios de datos, custodios, cuidadores técnicos, consumidores.
KPIs: MTTR de incidentes, porcentaje de conjuntos de datos con SLA activos, tasa de falsos positivos en alertas, cobertura de linaje, puntuación de deriva de características de IA, acumulación de remediaciones pendientes.
KPI de autoevaluación del marco de calidad de datos empresarial | Fuente de medición | Objetivo de línea de base | Regla de decisión |
|---|---|---|---|
MTTR de incidentes | Registros de incidentes y tickets | Tendencia a la baja | Aceptable cuando está estable y mejorando |
Conjuntos de datos con SLA de DQ activos | Registro de governance | Amplia cobertura en datos críticos | Lista de vigilancia si la cobertura es parcial |
Tasa de falsos positivos en alertas | Historial de alertas | Suficientemente baja para mantener la confianza | Deficiente cuando los equipos silencian las alertas |
Cobertura de linaje | Herramienta de catálogo y linaje | De extremo a extremo para flujos críticos | Lista de vigilancia cuando el impacto no está claro |
Puntuación de deriva de características de IA | Capa de monitoreo del modelo | Dentro de la línea de base esperada | Deficiente cuando la deriva es persistente |
Acumulación de remediaciones pendientes | Flujo de trabajo del custodio | Pequeño y con envejecimiento lento | Deficiente cuando los tickets se acumulan |
Un programa maduro no solo produce tablas más limpias. Ofrece a los líderes una forma de ver si el marco está controlando el riesgo, mejorando la confianza y manteniendo utilizables las entradas de la IA.
digna respalda este tipo de modelo operativo con comprobaciones en la base de datos, monitoreo de frescura, seguimiento de esquemas, detección de anomalías y análisis histórico en el propio entorno del cliente. Si está creando un marco de calidad de datos empresarial que debe funcionar en almacenes de datos, canalizaciones y consumidores de IA, visite digna para ver cómo encajan estos controles en la práctica.


