Explicación de la herramienta de calidad de datos local para equipos de empresa
|
8
minuto de lectura

Un cuadro de mando puede estar en verde mientras los datos detrás de él ya son incorrectos. Una carga programada llega tarde, un sistema de origen añade una columna o la distribución de clientes cambia sin activar un fallo en la canalización. Los informes se siguen actualizando, las tareas siguen apareciendo como exitosas y el negocio solo descubre el problema cuando un analista cuestiona un resultado inesperado.
Ese patrón de fallo es común en grandes patrimonios de datos porque hoy en día los datos cruzan almacenes, lagos, bases de datos heredadas, redes privadas y servicios en la nube. Un control de calidad que solo vigile una plataforma puede pasar por alto el punto en el que un cambio entró en el patrimonio de datos. Una enterprise guide to why data issues continue creating conflicts aclara el problema general, pero la pregunta sobre el despliegue sigue siendo práctica: ¿dónde debe ejecutarse el monitoreo y cómo debe operar a través de los límites de confianza?
Por lo tanto, una herramienta de calidad de datos local (on-prem data quality tool) es más que una opción de alojamiento. Puede definir un modelo operativo en el que los controles se ejecutan cerca de los datos sensibles, los equipos conservan el control de la infraestructura y los ingenieros siguen obteniendo una visión unificada a través de sistemas distribuidos. La evaluación correcta comienza con la detección de fallos, luego avanza a través de la seguridad, la integración híbrida, la propiedad operativa y el coste total de propiedad.
Al final, podrá decidir si la ejecución local se adapta a su patrimonio de datos, qué capacidades merecen una prueba en un piloto, cómo comparar el modelo con SaaS y cómo construir un caso de ROI que incluya tanto el retrabajo evitado como las responsabilidades que su equipo heredará.
Índice de contenidos
Introducción Por qué la calidad de los datos falla silenciosamente dentro de la empresa
Qué es realmente una herramienta de calidad de datos local
Comience por dónde ocurre el cómputo
Separe el despliegue de la colaboración
Entienda el límite de la gobernanza
Comparación de herramientas de calidad de datos locales frente a SaaS
Asocie la decisión al patrimonio de datos
Capacidades esenciales que toda herramienta local debería incluir
Frescura y volumen
Distribución y detección de anomalías
Controles de esquema y estructurales
Validación de registros y lógica de negocio
Seguridad del despliegue y modelo operativo para patrimonios híbridos
Valide el límite del despliegue
Opere a través de los límites de confianza
Casos de uso de la industria ROI e impacto operativo
Mida el impacto operativo, no las métricas de vanidad
El tiempo para obtener valor necesita una prueba real
Cómo evaluar y elegir la herramienta de calidad de datos local adecuada
Introducción Por qué la calidad de los datos falla silenciosamente dentro de la empresa
Un ingeniero de plataforma de datos nota que la canalización nocturna se completó con éxito. La tarea del almacén de datos no tiene estado de error, la actualización del cuadro de mando ha finalizado y el servicio de BI está disponible. Más tarde, un responsable de gobernanza descubre que el último informe utiliza una carga incompleta, mientras que un ingeniero de analítica descubre que una columna de origen cambió de tipo y alteró el comportamiento posterior.
Ninguno de estos eventos tiene por qué producir un fallo técnico grave. Un archivo retrasado puede contener registros válidos. Una tabla puede seguir admitiendo consultas después de que cambie su distribución. Una modificación del esquema puede pasar por la ingesta mientras rompe las suposiciones en una transformación o modelo. El éxito operativo y la calidad de los datos son señales diferentes.
Esa distinción es de suma importancia en patrimonios de datos donde los sistemas sensibles permanecen en las instalaciones locales (on-premises) mientras que las cargas de trabajo de analítica e IA se ejecutan en entornos de nube pública o privada. Las industrias reguladas como el gobierno, los servicios financieros y la atención médica a menudo necesitan residencia de datos, controles de seguridad sólidos o compatibilidad con sistemas heredados. Una estimación del mercado sitúa los despliegues locales en el 37,5% del mercado global de calidad de datos en 2025, o unos 1.800 millones de dólares, con un crecimiento proyectado por debajo de la nube a una tasa de crecimiento anual compuesto (CAGR) del 13,8% hasta 2034 (MarketIntelo's data quality market estimate). La base instalada no está desapareciendo porque las plataformas en la nube se estén expandiendo.
Regla práctica: Trate la calidad de los datos como un problema de monitoreo a lo largo de todo el patrimonio de datos, no como una prueba adjunta a una sola canalización.
Un enfoque local se vuelve útil cuando la capa de monitoreo debe respetar la ubicación de los datos. En lugar de copiar registros sensibles a un servicio externo, la plataforma puede calcular métricas dentro de la infraestructura controlada por el cliente y publicar metadatos gobernados, incidentes y tendencias a las personas que los necesitan.
Esta guía construye la decisión de manera progresiva. Comienza con el modelo de ejecución, compara las ventajas y desventajas entre el modelo local y SaaS, identifica las capacidades que detectan diferentes modos de fallo y luego examina la seguridad híbrida, el impacto en la industria y el coste. La decisión final no es "¿qué producto tiene la lista de características más larga?". Se trata de si el modelo operativo puede detectar cambios importantes, preservar los límites de confianza, respaldar una remediación responsable y seguir siendo económicamente sensato para el equipo de su plataforma.
Qué es realmente una herramienta de calidad de datos local
Piense en un centro de distribución que maneja productos sensibles. El inspector de calidad puede examinar cada envío dentro del almacén, registrar las mediciones e informar si los productos cumplen con los requisitos. El inspector no necesita enviar cada artículo a una instalación de terceros solo para calcular una puntuación de calidad.
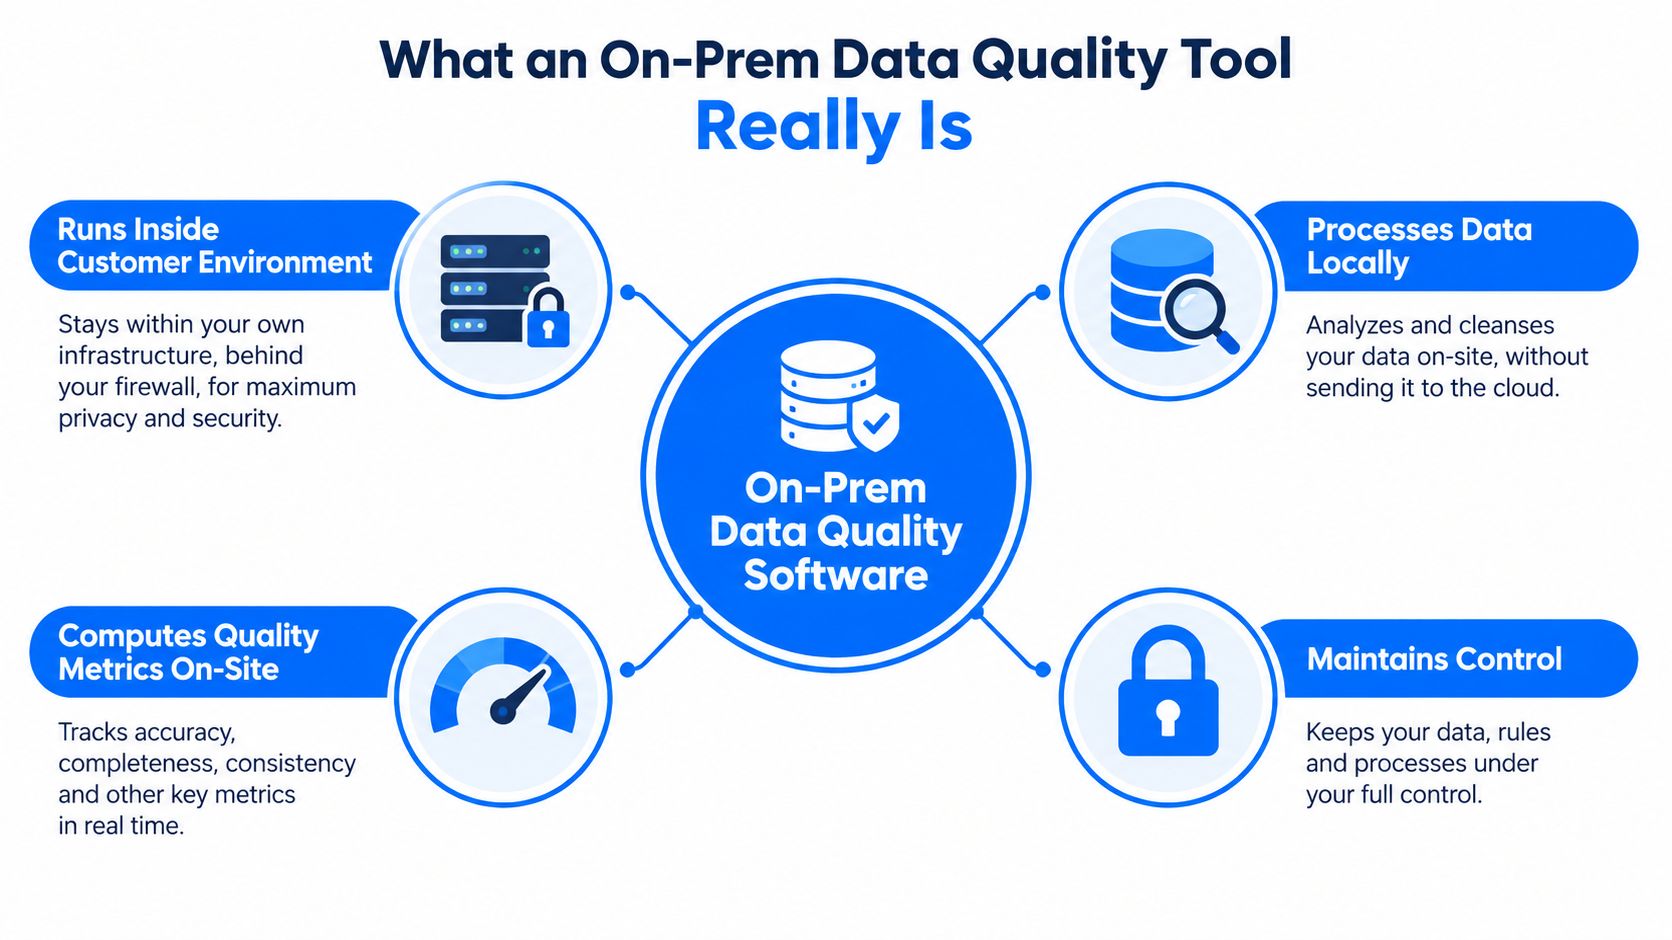
Una herramienta de calidad de datos local sigue el mismo principio. El software se ejecuta dentro del propio centro de datos del cliente, nube privada, VPC o infraestructura controlada. Se conecta a las bases de datos y plataformas donde ya residen los registros, calcula las métricas de calidad allí y envía los resultados autorizados a una interfaz compartida para ingenieros, analistas y partes interesadas.
Comience por dónde ocurre el cómputo
La distinción importante no es dónde se aloja la interfaz de usuario. Pregunte dónde lee los registros la plataforma y realiza el análisis. La ejecución en base de datos significa que la herramienta calcula los controles dentro del entorno de base de datos del cliente, lo que reduce el movimiento de datos y mantiene los registros sensibles en su lugar. También puede admitir un cálculo de métricas con menor latencia porque el análisis ocurre donde ya residen los datos, como se describe en la digna's in-database data quality guidance.
Ese diseño cambia la conversación sobre seguridad. Un equipo de seguridad puede revisar los permisos de la base de datos, las rutas de red, los controles de identidad y los registros de auditoría dentro de los procesos empresariales establecidos. La plataforma de calidad de datos se convierte en otra carga de trabajo gobernada en lugar de una nueva ruta para exportar datos de producción.
Separe el despliegue de la colaboración
Local no significa que los equipos aislados deban trabajar sin una visión común. Una plataforma útil sigue proporcionando cuadros de mando para el estado de los incidentes, el historial de métricas, los resultados de las reglas, los cambios de esquema y la propiedad. La capa de ejecución puede permanecer cerca de cada fuente de datos mientras que la capa de presentación ofrece a los diferentes usuarios una imagen operativa coherente.
Por ejemplo, un ingeniero puede investigar una consulta de validación fallida, un analista puede revisar un cambio en la distribución y un responsable de gobernanza puede necesitar pruebas de que se monitoreó una regla de negocio. Todos están observando diferentes consecuencias de la misma condición de datos subyacente.
Entienda el límite de la gobernanza
Las herramientas SaaS comúnmente centralizan el monitoreo en un entorno administrado por el proveedor. En cambio, una plataforma local otorga más control al cliente, incluyendo el despliegue, el acceso, las actualizaciones, la disponibilidad y la integración. Ese control puede satisfacer los requisitos de residencia, pero también genera trabajo operativo.
Por lo tanto, la pregunta correcta no es si lo local es automáticamente más seguro. Es si su organización puede operar la capa de monitoreo bajo sus propios estándares de seguridad y de plataforma mientras preserva una vista unificada a través de entornos en la nube y heredados.
Comparación de herramientas de calidad de datos locales frente a SaaS
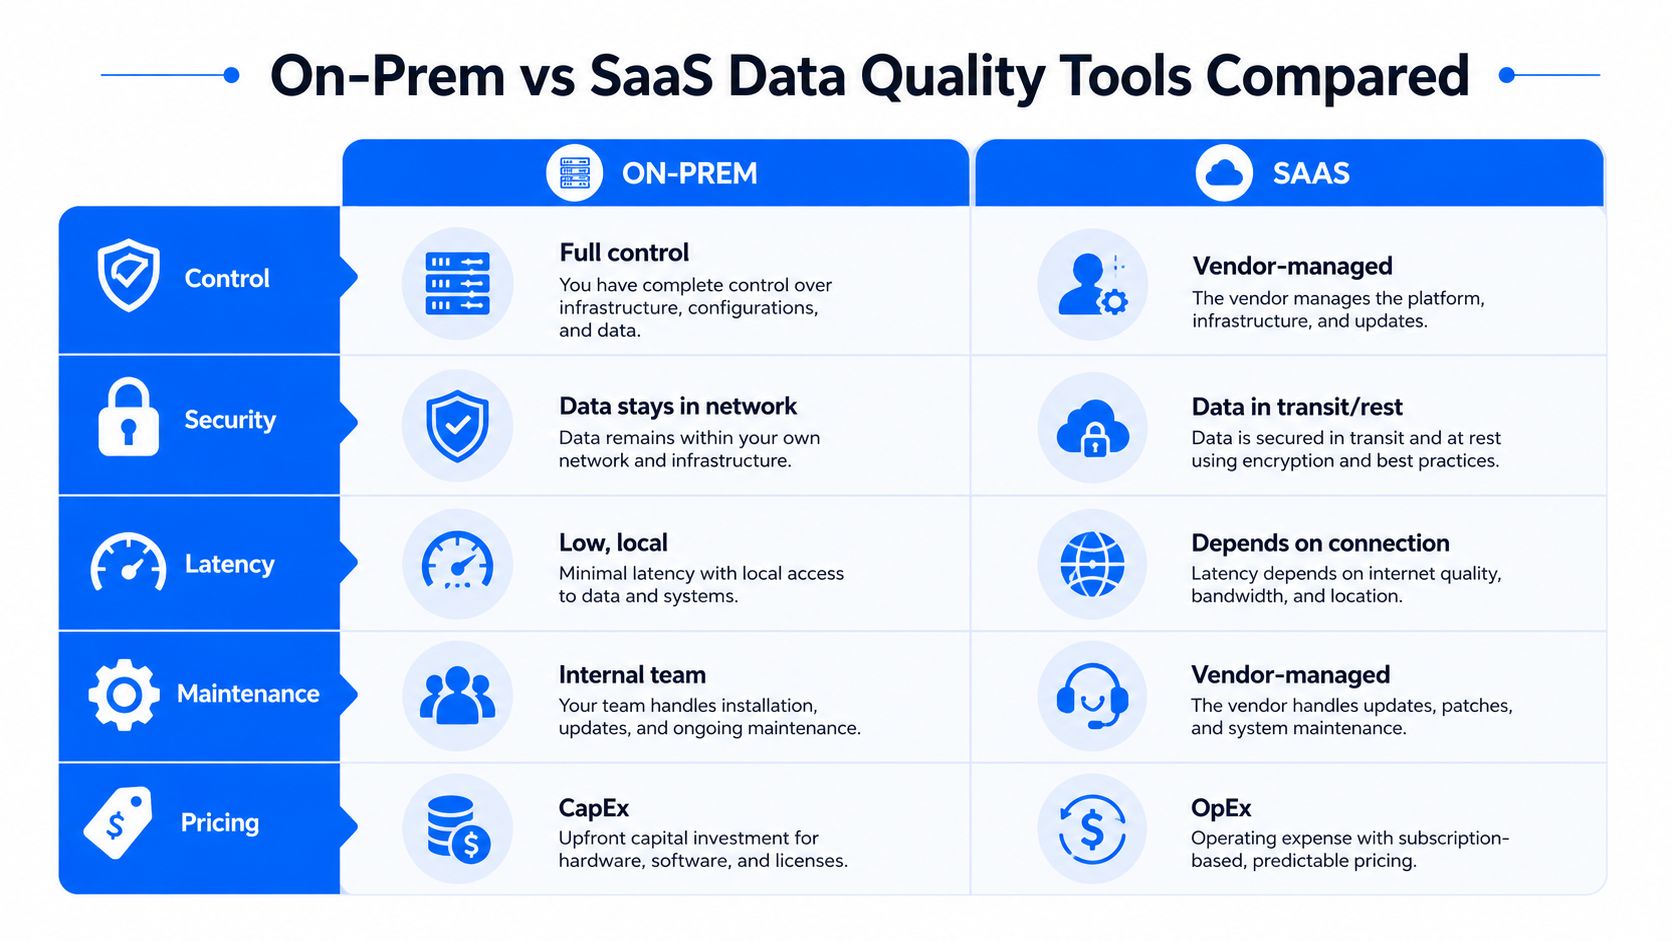
La comparación debe comenzar con las restricciones, no con la preferencia de marca. Una herramienta local generalmente le da al comprador más control sobre la ejecución, la ubicación de la red y el calendario de actualizaciones. SaaS generalmente reduce las responsabilidades de instalación e infraestructura, pero puede requerir que los datos, metadatos o resultados del monitoreo crucen un límite que los equipos regulados no pueden aceptar.
Criterios de evaluación | Herramienta local (On-Prem) | Herramienta SaaS |
|---|---|---|
Control | El cliente controla el despliegue y la infraestructura | El proveedor administra el servicio |
Seguridad | Los datos pueden permanecer dentro de la red del cliente | El tráfico de datos y de monitoreo utiliza rutas de servicio externas |
Latencia | La ejecución local puede reducir el movimiento y la dependencia de la conexión | El rendimiento depende en parte de la conectividad y de la arquitectura del servicio |
Mantenimiento | Los equipos internos gestionan las operaciones y actualizaciones | El proveedor gestiona gran parte de la operación de la plataforma |
Precios | Puede implicar costes de infraestructura y de operación interna | Los costes de suscripción se tratan comúnmente como gastos operativos |
La contrapartida es la responsabilidad operativa. Las soluciones locales brindan control directo a los equipos de infraestructura y seguridad, pero estos deben planificar la capacidad, la aplicación de parches, el respaldo, la alta disponibilidad, la Observability para la propia herramienta y la recuperación ante desastres. SaaS puede simplificar esas tareas, aunque el comprador aún necesita gobernar el acceso, las integraciones, los Data Contracts y la propiedad de los incidentes.
Asocie la decisión al patrimonio de datos
El modelo local suele ser la mejor opción cuando los registros deben permanecer dentro de la infraestructura controlada por el cliente, cuando los sistemas heredados son difíciles de exponer externamente o cuando los auditores requieren pruebas detalladas de acceso y procesamiento. También se adapta a patrimonios híbridos donde copiar datos a una plataforma SaaS crearía una complejidad adicional de residencia, privacidad o red.
SaaS puede ser más sencillo para equipos con una arquitectura predominantemente nativa de la nube, capacidad limitada de operaciones de plataforma y sin restricciones para enviar los datos de monitoreo requeridos a un servicio administrado por el proveedor. La simplicidad importa. Una herramienta que un equipo puede desplegar, configurar y mantener de manera constante es más valiosa que una plataforma teóricamente perfecta que nunca llega a producción.
La decisión se asemeja a otras elecciones de infraestructura. Los equipos que comparan cloud email versus onsite server se enfrentan a una pregunta similar sobre control, responsabilidad y conveniencia del servicio. El mismo principio se aplica aquí: elija el límite que coincida con el modelo de riesgo y la capacidad operativa de su organización.
Una descripción práctica del data quality software overview puede ayudar a los equipos a enmarcar la capa funcional, pero el despliegue aún requiere una evaluación carga de trabajo por carga de trabajo. Identifique qué conjuntos de datos son sensibles, dónde debe ocurrir el cómputo, qué metadatos pueden salir de cada entorno y quién dará soporte a la plataforma a las dos de la mañana.
Capacidades esenciales que toda herramienta local debería incluir
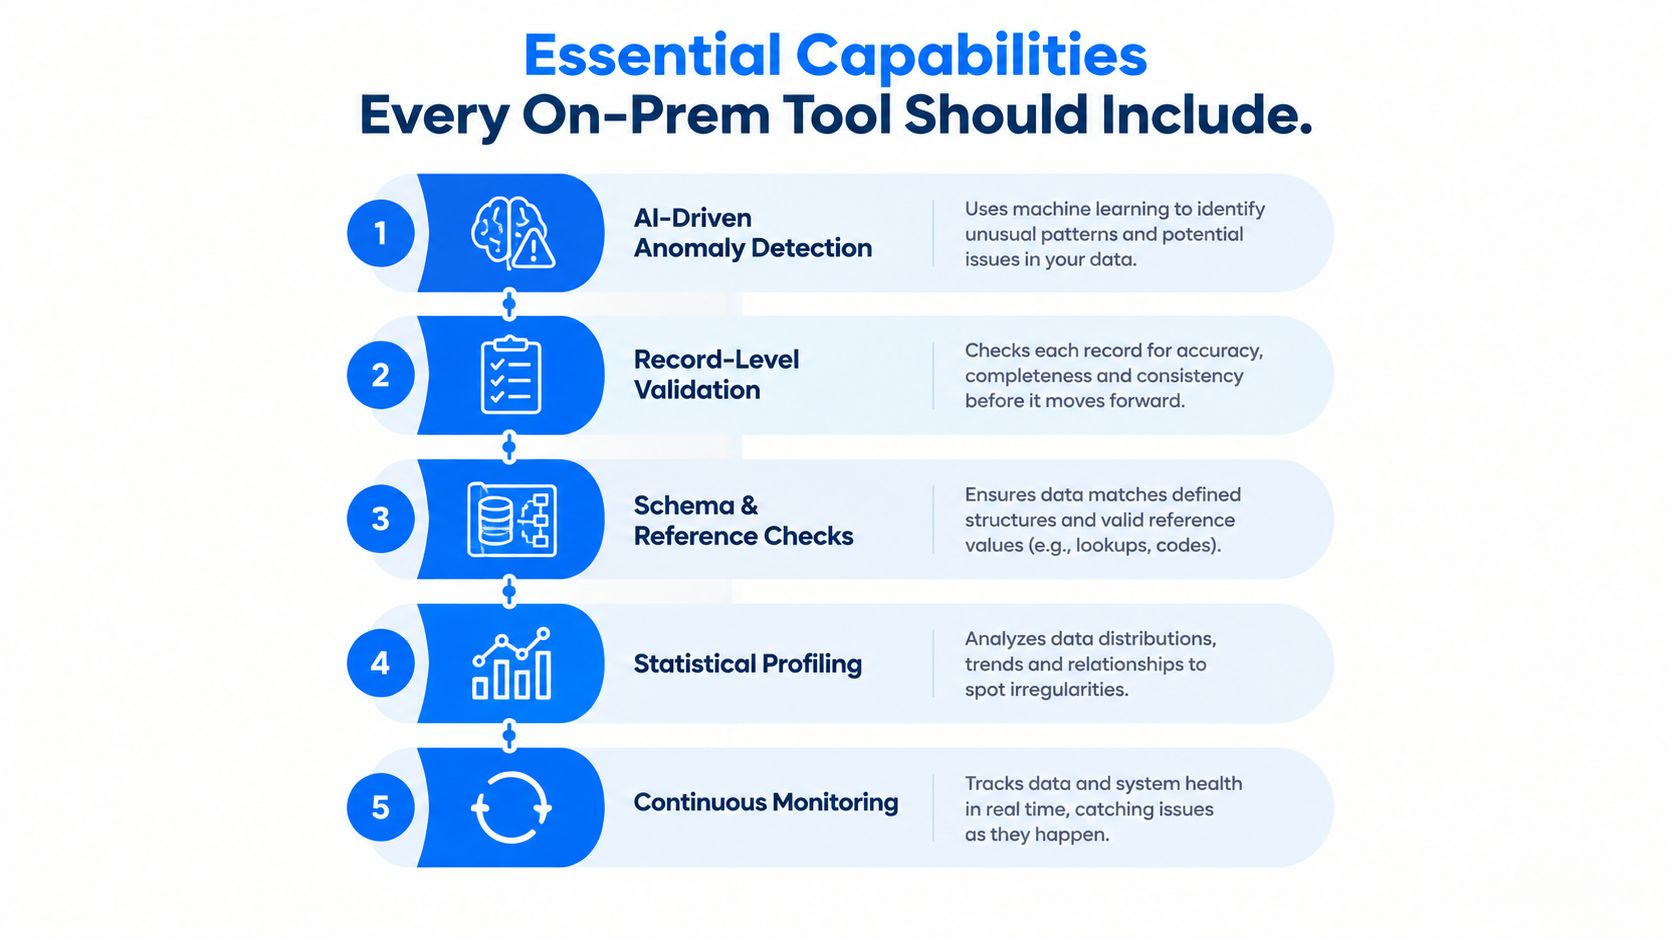
Una plataforma de calidad se gana su lugar al detectar diferentes tipos de fallos, no al producir una única puntuación general. La frescura, el volumen, la distribución, el esquema y la validación de reglas revelan, cada uno, un síntoma diferente. Un modelo de Observability práctico combina estas señales porque un retraso en la carga no necesariamente cambiará un esquema, y un evento de corrupción silenciosa puede no reducir el recuento de filas.
Frescura y volumen
El monitoreo de la Timeliness pregunta si los datos llegaron cuando los consumidores los esperaban. Debe tener en cuenta los patrones normales de entrega, los horarios, los datos que llegan tarde, las cargas faltantes, los reintentos y las cargas parciales. El cálculo de la entrega esperada es particularmente útil porque un umbral fijo puede clasificar erróneamente una fuente que tiene un comportamiento de llegada variable pero predecible.
El monitoreo del volumen detecta un tipo diferente de problema. Una canalización puede completarse cargando muchos menos o más registros de lo habitual. Un cambio repentino en el volumen puede indicar un cambio en el filtro de origen, una unión rota, una interrupción del sistema de origen o un evento comercial inesperado que requiere investigación.
Distribución y detección de anomalías
El monitoreo de la distribución analiza el interior del conjunto de datos. Puede identificar cambios en los patrones de valor, comportamientos nulos, equilibrio de categorías u otras características estadísticas que los recuentos de filas no revelarán. El aprendizaje de líneas base impulsado por IA puede reducir la dependencia de umbrales configurados manualmente. La plataforma aprende el comportamiento normal de un conjunto de datos y marca las desviaciones para su revisión.
El análisis histórico añade contexto. Una sola observación inusual puede ser inofensiva, mientras que un cambio gradual en las métricas históricas puede indicar el deterioro de los datos o un cambio en el proceso. Los equipos necesitan vistas de tendencias y volatilidad para distinguir un evento único de un problema de confiabilidad en desarrollo.
Controles de esquema y estructurales
El seguimiento de esquemas vigila el contrato entre productores y consumidores. Las columnas añadidas o eliminadas, los tipos de datos modificados y las estructuras alteradas pueden romper transformaciones, cuadros de mando o modelos, incluso cuando la ingesta informa de que se ha realizado con éxito.
Una implementación sólida registra el cambio, identifica los activos afectados donde el linaje está disponible y le da al equipo propietario suficiente contexto para decidir si el cambio es intencional. El monitoreo del esquema no debería limitarse a decir "algo cambió". Debería ayudar a los ingenieros a determinar qué cambió y qué podría depender de ello.
Record validation and business logic
Las señales estadísticas no reemplazan a las reglas deterministas. La validación a nivel de registro comprueba si los valores cumplen con las condiciones de negocio, las relaciones de referencia y los requisitos de auditoría. Los ejemplos incluyen verificar que un estado sea compatible con una fecha de ciclo de vida, que una transacción cumpla con una clasificación aprobada o que un campo requerido esté completo para un tipo de registro en particular.
Las cinco señales son complementarias. La frescura le dice cuándo llegaron los datos, el volumen le dice cuántos llegaron, la distribución le dice cómo cambió su comportamiento, el esquema le dice si su estructura se movió y la validación le dice si los registros cumplen con la intención comercial.
La ejecución en base de datos es importante en las cinco capacidades. Calcular las métricas donde ya residen los datos reduce el movimiento innecesario y permite que la herramienta opere cerca de conjuntos de datos grandes o sensibles. Aun así, la plataforma necesita consultas eficientes, una programación sensata, permisos y controles de recursos, porque la ejecución local no elimina la necesidad de una gestión responsable de la carga de trabajo.
Seguridad del despliegue y modelo operativo para patrimonios híbridos
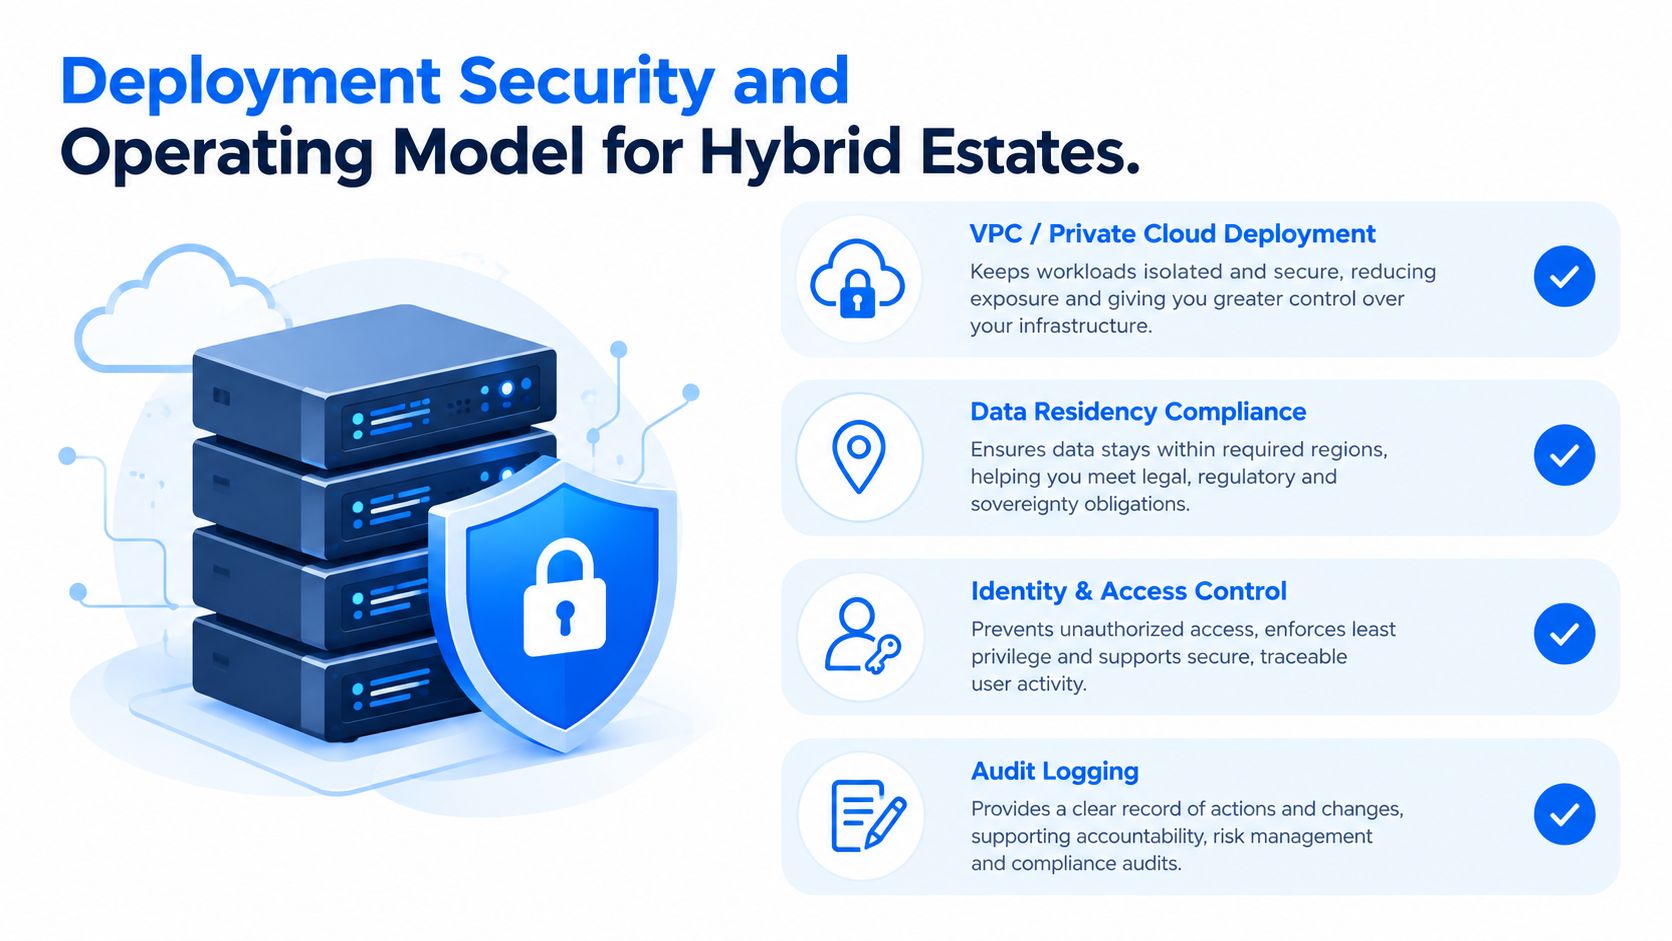
Los patrimonios híbridos exponen la debilidad de tratar lo local como una única opción de instalación. Un cliente puede mantener datos transaccionales en un centro de datos, ejecutar un almacén en una nube privada y utilizar servicios en la nube para análisis o desarrollo de modelos. La capa de monitoreo debe observar esos sistemas sin convertir cada límite de confianza en un problema de exportación de datos.
Valide el límite del despliegue
Comience con una revisión conjunta que involucre a los equipos de plataforma de datos, seguridad, infraestructura, privacidad y gobernanza. Las siguientes preguntas descubren brechas antes de que una compra se convierta en una excepción de arquitectura:
Ubicación de ejecución: ¿Dónde se ejecuta la herramienta y dónde se ejecutan las consultas?
Movimiento de datos: ¿Salen los registros sin procesar del entorno o la plataforma devuelve solo métricas y metadatos?
Identidad: ¿Puede la herramienta utilizar la identidad empresarial y los controles de acceso basados en roles?
Residencia: ¿Puede cada dominio de datos permanecer en su jurisdicción y límite de infraestructura requeridos? Revise los data residency requirements pertinentes antes de aprobar la conectividad.
Linaje: ¿Pueden los equipos rastrear un problema a través de activos en la nube y locales sin centralizar registros sensibles?
Acceso heredado: ¿Puede la plataforma conectarse a bases de datos y sistemas operativos más antiguos sin forzar una migración?
Evidencia de auditoría: ¿Se registran las ejecuciones de reglas, los eventos de acceso, los cambios de configuración y las decisiones sobre incidentes?
Operaciones: ¿Quién es el propietario de la aplicación de parches, las actualizaciones, los respaldos, la capacidad, los certificados y las pruebas de recuperación?
Opere a través de los límites de confianza
Un cuadro de mando unificado no requiere un único lago de datos para todo el monitoreo. Un modelo distribuido puede ejecutar controles localmente en cada entorno, retener los datos brutos en el origen y compartir resultados de calidad gobernados a través de canales aprobados. Ese enfoque brinda visibilidad a los equipos de gobernanza central al tiempo que permite a los propietarios de plataformas locales controlar el acceso y la ejecución.
El modelo operativo también debe definir la propiedad. Seguridad puede aprobar la conectividad, pero los propietarios de los datos deben decidir si una anomalía es esperada. Los equipos de plataforma mantienen el servicio, mientras que los equipos de dominio corrigen los defectos de origen o de transformación. Sin esos roles, una instalación local puede convertirse en otra isla de monitoreo.
Casos de uso de la industria ROI e impacto operativo
El caso económico para la calidad de datos local depende de lo que le cueste un fallo a su organización y de las responsabilidades que esta pueda absorber. El precio de la licencia es solo una línea. El cálculo más amplio incluye el retrabajo de los analistas, la investigación de ingeniería, el retraso en los informes, el consumo innecesario de la plataforma, la preparación de auditorías y el coste operativo de ejecutar el servicio de monitoreo.
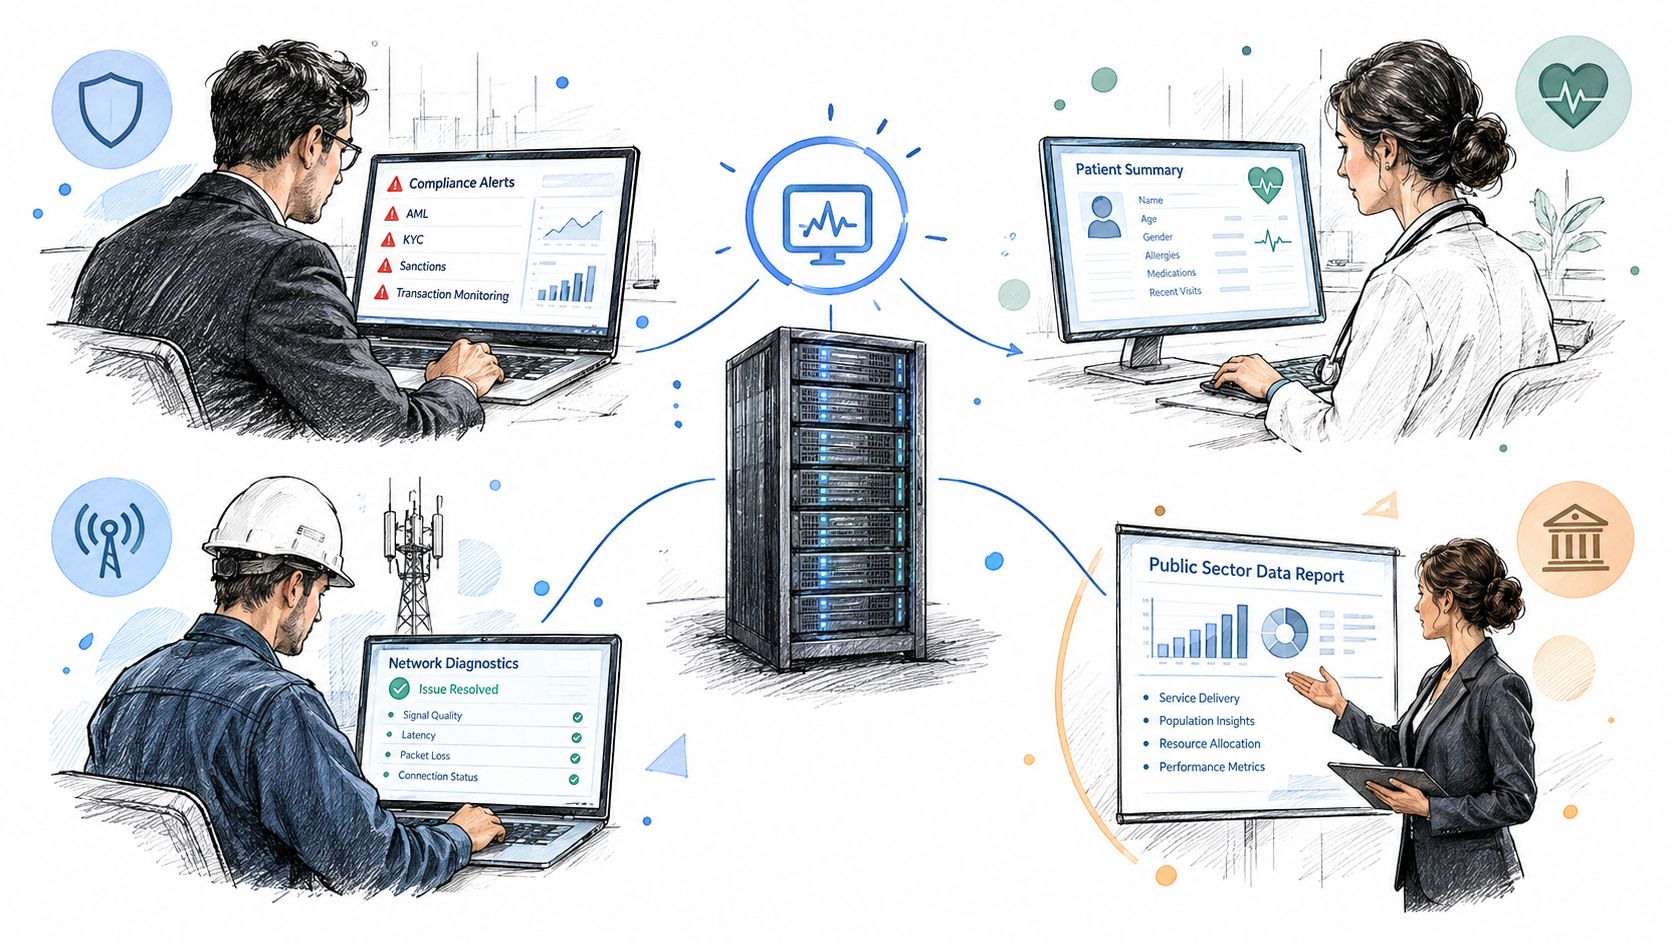
En finanzas, un equipo puede aplicar la validación a nivel de registro a transacciones críticas, monitorear los tiempos de entrega para datos de riesgo y rastrear los cambios de esquema antes de que se rompan los informes regulatorios. Los equipos de salud pueden priorizar la residencia, el acceso controlado y la evidencia de que las reglas de negocio se aplicaron a datos clínicos u operativos sensibles. Los equipos de telecomunicaciones a menudo necesitan un monitoreo de anomalías y volumen a través de fuentes operativas de alto rendimiento, mientras que los equipos del sector público pueden valorar la trazabilidad y los controles consistentes en sistemas más antiguos.
Mida el impacto operativo, no las métricas de vanidad
Un modelo de ROI útil pregunta qué cambia después de que la detección se vuelve continua:
Descubrimiento de incidentes más temprano: Los equipos identifican cargas tardías antes de que los cuadros de mando desactualizados lleguen a los tomadores de decisiones.
Menor tiempo de investigación: La distribución, el esquema y el contexto histórico reducen la búsqueda de la causa raíz.
Menor retrabajo: Los analistas dedican menos tiempo a conciliar informes que utilizaron entradas incompatibles o incompletas.
Mayor preparación para auditorías: Los resultados de las reglas y el historial operativo proporcionan evidencia para su revisión.
Consumo controlado: Los equipos de plataforma pueden detectar cargas de trabajo y comportamientos de datos inusuales antes de que generen costes o presiones de capacidad evitables.
Mayor confianza: Los usuarios de negocio pueden ver el estado del monitoreo en lugar de depender de garantías informales.
La contrapartida es clara. El modelo local puede reducir el movimiento de datos y respaldar el Compliance, pero el comprador asume la infraestructura, el despliegue y el mantenimiento. Las investigaciones de Observability informan que el 56,8% de los encuestados identificó el coste de la herramienta como un problema, mientras que el 29,3% citó facturas anuales impredecibles y el 27,3% señaló el CapEx y OpEx para la gestión de datos (ManageEngine's State of Observability 2025 report). Estos hallazgos refuerzan la necesidad de comparar la exposición a la suscripción con las obligaciones internas de mano de obra e infraestructura en lugar de mirar únicamente una licencia cotizada.
El tiempo para obtener valor necesita una prueba real
Una página de casos de estudio de Acceldata informa que su plataforma verificó más de mil millones de filas para 50 reglas críticas de calidad de datos en menos de 2 horas (Acceldata case studies). Ese es un punto de referencia informado por el proveedor, no una promesa para cada patrimonio de datos.
La experiencia de implementación publicada para digna es igualmente condicional: "Depende en gran medida del cliente; si todo está preparado, no lleva más de 2 horas. Este fue el caso de nuestra primera instalación de digna en IT-Services de la Seguridad Social de Austria". La lección práctica es probar el trabajo de preparación explícitamente. Las aprobaciones de conexión, las tablas representativas, las reglas, la propiedad y el enrutamiento de alertas determinan qué tan rápido un despliegue produce evidencia útil.
Cómo evaluar y elegir la herramienta de calidad de datos local adecuada
Utilice un piloto para probar el modelo operativo, no solo la interfaz. Seleccione conjuntos de datos representativos tanto de un entorno heredado como de una plataforma en la nube, luego verifique si la herramienta puede monitorearlos sin mover registros sensibles a un servicio externo.
Su evaluación debe responder a estas preguntas:
Ejecución: ¿Se calculan las métricas en el entorno o base de datos del cliente?
Cobertura: ¿Puede una sola plataforma combinar la detección de anomalías, la validación, la puntualidad, el esquema y el análisis histórico?
Líneas base: ¿La detección de anomalías aprende el comportamiento del conjunto de datos sin obligar a los ingenieros a mantener cada umbral?
Contexto: ¿Puede una alerta mostrar los activos afectados, el comportamiento histórico y la propiedad?
Integración: ¿Se conecta a las bases de datos, almacenes, programadores, sistemas de identidad y canales de notificación que ya están en uso?
Operaciones: ¿Puede su equipo aplicar parches, realizar respaldos, escalar y recuperarla bajo los estándares existentes?
Precios: ¿Es comprensible el modelo y evita cargos impredecibles por cada escaneo, alerta o llamada de API?
Adopción: ¿Pueden los ingenieros, analistas y usuarios de gobernanza trabajar desde la misma vista de estado e incidentes?
Comience con un módulo de alto valor y un conjunto de datos claramente definido. Mida si el piloto detecta modos de fallo conocidos de frescura, distribución, esquema y validación, luego calcule el esfuerzo interno requerido para operarlo. Un data quality business case bien estructurado debe incluir el retrabajo evitado, la respuesta a incidentes, la preparación de auditorías, la infraestructura, la mano de obra de la plataforma y el valor de mantener los datos dentro de los límites aprobados.
La conversación con el proveedor también debe incluir evidencia de despliegue, no solo una demostración de características. Solicite una revisión de la arquitectura, un recorrido de seguridad, una integración representativa y una prueba de tiempo hasta la primera alerta. Si hace referencia a la plataforma de ejemplo, mantenga el estilo de marca exacto: digna utiliza una "d" minúscula.
digna proporciona una plataforma empresarial de calidad de datos y Observability que se ejecuta dentro del entorno del cliente, con ejecución en base de datos para la detección de anomalías, validación, puntualidad y monitoreo de esquemas. Visite digna para explorar un modelo operativo local para patrimonios de datos híbridos y evaluar si se adapta a sus requisitos de seguridad, governance y confiabilidad.
Preguntas frecuentes
¿Qué hace que una herramienta de calidad de datos sea on-premise?
Dónde ocurre el cálculo, no dónde se aloja la interfaz. Lo que importa es si las consultas se ejecutan dentro de su red y si los registros en bruto salen del entorno o solo regresan métricas y metadatos. Esa única decisión de diseño reconfigura toda la conversación de seguridad.
¿Es on-premise automáticamente más seguro que SaaS?
No, y esa es la pregunta equivocada. El SaaS centraliza la monitorización en un entorno gestionado por el proveedor, mientras que on-premise mantiene la ejecución en infraestructura del cliente y traslada con ella la responsabilidad operativa. La comparación correcta parte de restricciones como residencia, acceso a sistemas heredados y evidencia de auditoría.
¿Qué capacidades debe demostrar un piloto on-premise?
Cinco señales complementarias. La frescura dice cuándo llegaron los datos, el volumen cuántos llegaron, la distribución cómo cambió su comportamiento, el esquema si se movió su estructura y la validación si los registros cumplen la intención de negocio. Una plataforma que solo produce una puntuación amplia no se ha ganado su sitio.
¿Qué debe cubrir la revisión del despliegue?
Ocho preguntas acordadas entre plataforma de datos, seguridad, infraestructura, privacidad y gobernanza: lugar de ejecución, movimiento de datos, identidad y acceso por roles, residencia por dominio, linaje entre fronteras, acceso a bases heredadas, evidencia de auditoría y quién asume parcheo, actualizaciones, copias y pruebas de recuperación.
¿Qué tamaño tiene el segmento on-premise?
Una estimación de mercado sitúa los despliegues on-premise en el 37,5 % del mercado global de calidad de datos en 2025, en torno a 1.800 millones de USD, con un CAGR del 13,8 % hasta 2034, por debajo del segmento cloud. El segmento persiste porque los sistemas sensibles siguen en local mientras la analítica migra a la nube.


