Gestión de calidad de datos empresarial: guía práctica
|
8
minuto de lectura

A las 8:47, un responsable de analítica abre el panel de KPIs de dirección y ve ingresos planos. La previsión de la semana pasada prometía crecimiento de dos dígitos. El director de ingresos ya pregunta en un hilo de mensajes quién responde de esa cifra, mientras el informe de referencia muestra una actualización nocturna sin error aparente.
Tres pipelines alimentan la tabla afectada. Ninguno registró un fallo claro. El equipo revisa el almacén, rastrea el flujo de eventos anterior, inspecciona los modelos dbt y por fin repasa la capa de BI. Dos días antes, un proveedor había renombrado un campo en su carga. El fallo de join resultante eliminó filas sin detener el pipeline.
Esta es la brecha operativa que la gestión de calidad de datos empresarial debe cerrar. Debería detectar deriva de esquema, huecos de frescura, anomalías de filas ausentes y cambios de negocio inesperados antes de que lleguen a una reunión de dirección. La disciplina no es una limpieza trimestral. Es un sistema de control continuo para los datos que alimentan reporte, analítica, cumplimiento e IA.
Tabla de contenidos
Cuando el panel de la mañana se rompe y nadie sabe por qué
Qué significa realmente la gestión de calidad de datos empresarial
Empiece por el comportamiento, no solo por las reglas
Haga explícitos los contratos
Trate la frescura como dimensión de calidad
Siga la estructura y conecte las señales
Capacidades centrales y las métricas que las hacen funcionar
Arquitectura y patrones de despliegue para la empresa
Mantenga el cálculo cerca de los datos
Ajuste los requisitos de aislamiento al despliegue
Compre capacidad por etapas operativas
Buenas prácticas y una hoja de ruta realista
La fase uno se centra en fallos visibles
La fase dos convierte supuestos en contratos
La fase tres integra la calidad en la entrega
Cómo una plataforma modular resuelve problemas operativos
Repensar la calidad de datos como disciplina operativa
Cuando el panel de la mañana se rompe y nadie sabe por qué
El panel no falló como muchos esperan. No hubo caída del almacén. Ningún trabajo de orquestación se puso en rojo. Ninguna alerta anunció que la carga del proveedor había cambiado. Desde la perspectiva de la plataforma, los datos seguían moviéndose, los modelos seguían ejecutándose y la herramienta de BI seguía sirviendo consultas.
Desde la perspectiva del negocio, el panel estaba equivocado.
La investigación siguió el camino habitual. El responsable de analítica comparó el panel con una consulta al almacén, comprobó si la tabla nocturna había llegado y revisó los registros del pipeline. Un ingeniero inspeccionó el flujo de eventos en busca de mensajes ausentes y después abrió el código de transformación para rastrear el join afectado. El fallo estaba después de la ingesta pero antes del panel, lo que dejó a cada equipo con evidencia parcial y sin una explicación compartida.
Regla operativa: una ejecución exitosa del pipeline no demuestra que los datos sean aptos para su uso.
El renombrado silencioso del campo fue solo una parte del incidente. Un rastreador de esquema podría haber identificado el cambio estructural al llegar la carga del proveedor. Un control de puntualidad podría haber señalado que la fuente llegó más tarde que su patrón habitual. Un detector de anomalías podría haber notado el patrón de filas ausentes en la tabla transformada. Una vista compartida de observabilidad podría haber conectado esas señales en vez de obligar a los ingenieros a buscar en cuatro sistemas.
La diferencia importa porque la mala calidad de datos crea un riesgo financiero, no una simple molestia de ingeniería. La estimación de Gartner, citada en resúmenes sectoriales de estadísticas de gestión de datos, sitúa el coste anual medio de la mala calidad en 12,9 millones de dólares por organización. La misma fuente señala que suele citarse investigación del MIT Sloan asociando la mala calidad con pérdidas de ingresos del 15 % al 25 %. Estas cifras encuadran la gestión de calidad como gasto operativo y disciplina de protección de ingresos.
Un programa que funcionara habría tratado la tabla de ingresos del panel como un activo de producción monitorizado. Habría definido volumen esperado, frescura, esquema y comportamiento del join, asignado propiedad y encaminado las desviaciones relevantes a quienes podían responder.
El objetivo no es evitar todo registro imperfecto. Es asegurar que un panel roto no sea la primera señal de monitorización.
Para orientación práctica sobre cómo convertir esas señales en vistas útiles, vea este enfoque para construir paneles de calidad de datos que realmente funcionan.
Qué significa realmente la gestión de calidad de datos empresarial
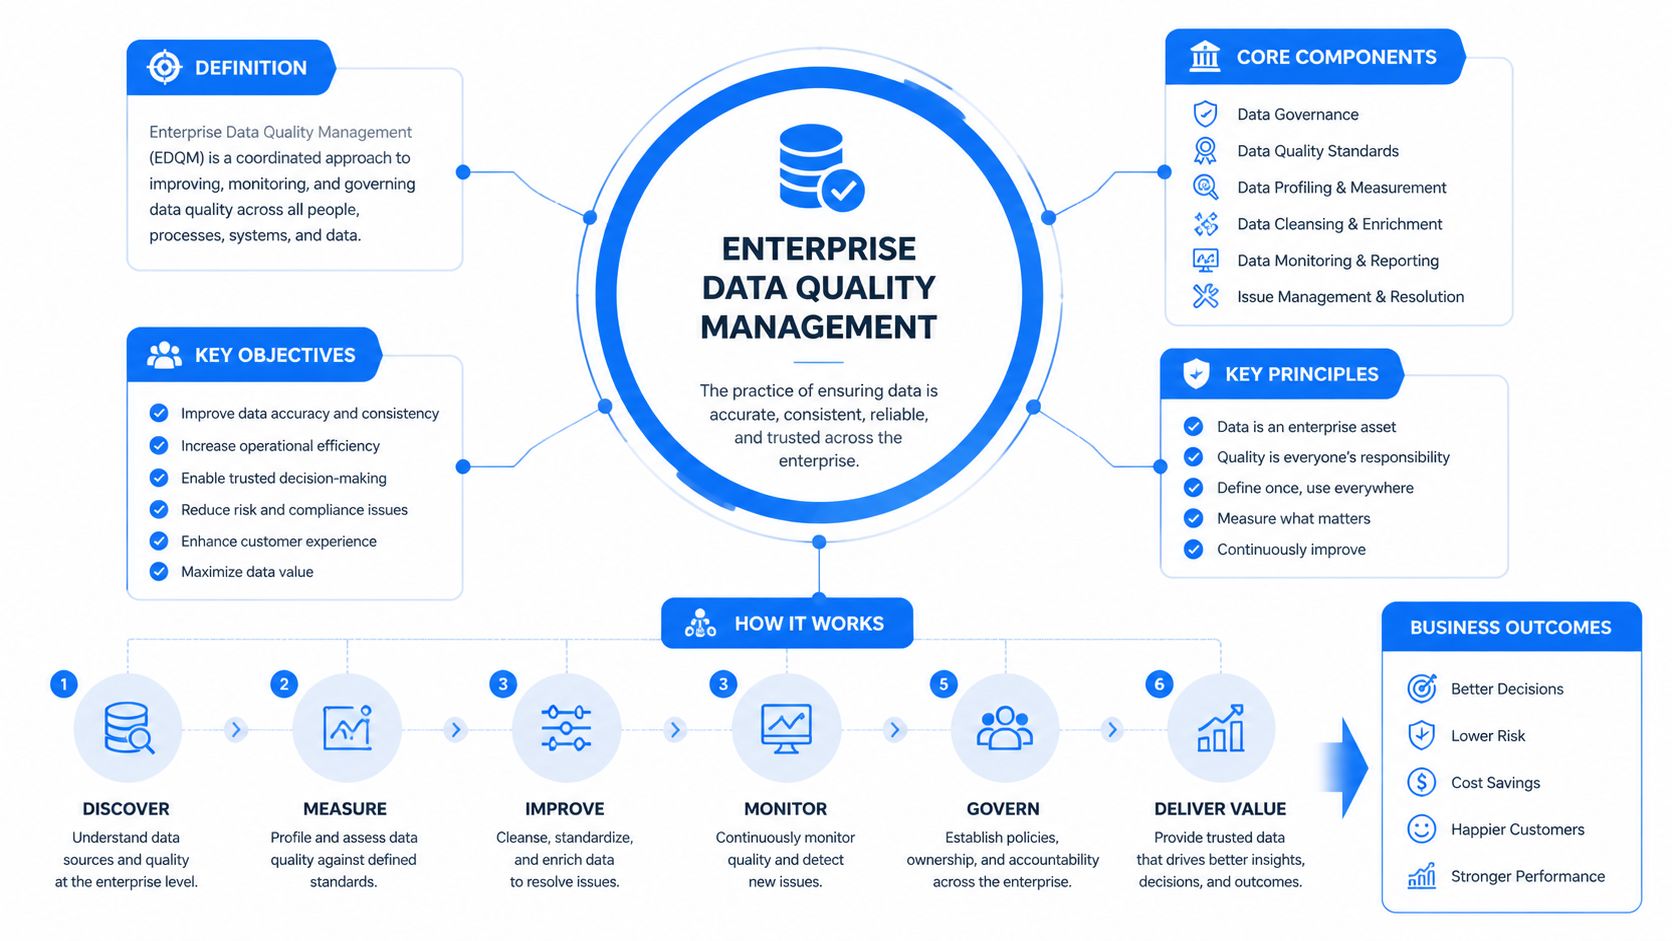
La gestión de calidad de datos empresarial es una disciplina operativa para mantener los datos aptos para su uso mientras atraviesan ingesta, transformación, almacenamiento y consumo. Trata la calidad como un bucle de control, no como un proyecto de limpieza: definir el comportamiento esperado, comprobar lo que llega, explicar desviaciones, asignar respuesta y registrar el resultado. El EDM Council describe este trabajo a lo largo de todo el ciclo de vida, y su informe global de referencia en gestión de datos respalda un enfoque orientado a la madurez basado en dimensiones y cuadros de mando repetibles.
Esa distinción importa durante los fallos operativos. Un panel obsoleto apunta a controles de frescura, la deriva de esquema exige comprobaciones estructurales, los retrasos de pipeline exigen monitorización de entregas, y un KPI inesperado puede exigir conciliación o análisis de anomalías. Cada capacidad debe responder a una pregunta recurrente y conducir a una acción práctica.
Empiece por el comportamiento, no solo por las reglas
La detección de anomalías encuentra cambios en el comportamiento antes de que un equipo sepa qué regla escribir. Un salto repentino de volumen, un patrón inusual de nulos o un cambio de distribución pueden exponer un fallo anterior incluso cuando la tabla sigue cumpliendo su esquema declarado.
Una regla determinista y una línea base aprendida sirven a propósitos distintos. Una regla puede rechazar un valor obligatorio ausente. Una línea base puede señalar un cambio brusco en la tasa histórica de nulos de ese campo. Los programas a escala usan ambas, porque las violaciones conocidas y los patrones desconocidos requieren señales diferentes.
Haga explícitos los contratos
Las reglas de validación imponen contratos técnicos y de negocio. Pueden comprobar formatos, valores permitidos, relaciones entre campos, integridad referencial y condiciones como si una fecha de transacción precede a la creación de la cuenta.
Una regla solo tiene valor operativo cuando su significado y su respuesta son claros. Cada comprobación fallida debería identificar qué cambió, qué consumidores pueden verse afectados y si el pipeline debe detenerse, poner registros en cuarentena o continuar con un incidente. Sin responsable ni umbral de respuesta, un conjunto creciente de reglas se convierte en ruido.
Trate la frescura como dimensión de calidad
La monitorización de Timeliness responde si los datos están disponibles y actualizados cuando un panel, un modelo o un proceso operativo los necesita. La calidad de datos suele incluir exactitud, completitud, coherencia, Timeliness, validez, unicidad, integridad, fiabilidad y accesibilidad, como expone esta guía de dimensiones de calidad de datos.
La guía de dimensiones de calidad de datos también aporta vocabulario útil para discutir esas dimensiones. Un panel puede contener valores exactos y aun así fallar si sus datos tienen varios días. Por eso los controles de Timeliness deben comparar los patrones de llegada esperados con la entrega real, en lugar de comprobar solo si un trabajo programado terminó en algún momento.
Siga la estructura y conecte las señales
El seguimiento de esquema detecta campos añadidos o eliminados, cambios de tipo, cambios de nulabilidad y rutas anidadas alteradas. La observabilidad conecta señales de esquema, frescura, volumen, calidad, linaje y plataforma para que un ingeniero investigue un solo evento operativo en lugar de buscar en sistemas separados.
Juntos, estos componentes forman un bucle de retroalimentación. El sistema establece el comportamiento esperado, detecta una desviación, aporta contexto, encamina el incidente y registra el resultado. Ese bucle protege la confianza en analítica e IA mejor que un catálogo estático de comprobaciones.
Capacidades centrales y las métricas que las hacen funcionar
Un cuadro de mando se vuelve útil cuando cada dimensión conduce a una decisión. Las nueve dimensiones habituales aportan vocabulario, pero los ingenieros necesitan señales medibles ligadas a tablas, flujos, modelos, responsables y vías de escalado.
La exactitud rara vez es un único porcentaje universal, porque el valor esperado puede venir de un sistema de referencia, un proceso de conciliación o un cálculo de negocio fiable. A nivel de fila, los equipos pueden vigilar marcas de atípicos, rangos de valores inesperados y discrepancias frente a registros autorizados. La métrica solo importa cuando alguien sabe si el resultado debe disparar investigación, cuarentena o aceptación.
La completitud necesita más que una comprobación genérica de nulos. Siga tasas de nulos en campos obligatorios, claves de negocio ausentes, huecos en secuencias de fechas o eventos y particiones faltantes. Una tabla puede tener una tasa global baja de nulos mientras a un segmento crítico le faltan los valores que alimentan un informe regulatorio.
La coherencia conecta sistemas que deberían coincidir. Concilie recuentos de clientes, cuentas, pedidos o transacciones entre las capas de origen y almacén. Compruebe la integridad referencial entre tablas de hechos y dimensiones, y señale definiciones incompatibles del mismo KPI. Las comparaciones entre sistemas suelen exponer problemas que la validación por fila no ve.
La Timeliness debería usar el retardo de frescura, las ventanas de entrega esperadas y el número de cargas tardías o ausentes. La guía de monitorización de Timeliness resulta útil al definir medidas de frescura para tablas y flujos de eventos. Una expectativa programada puede indicar cuándo debería llegar una carga, mientras que una expectativa aprendida puede detectar una deriva inusual en un patrón normal de entrega, enfoque descrito en las buenas prácticas de pipelines de datos de digna.
La validez cubre conformidad de esquema, valores permitidos, formatos y reglas de negocio. La unicidad comprueba identificadores duplicados, registros repetidos y coincidencias de entidad sin resolver. La integridad y la accesibilidad pueden añadirse donde relaciones, permisos y disponibilidad sean relevantes para el producto de datos.
Dimensión | Métricas clave | Señal operativa |
|---|---|---|
Exactitud | Marcas de atípicos, discrepancias de referencia, resultados de conciliación | Investigar valores inesperados o desacuerdos entre fuentes |
Completitud | Tasa de nulos, claves ausentes, huecos de secuencia | Poner en cuarentena registros incompletos o contactar al productor |
Coherencia | Varianza entre sistemas, fallos de integridad referencial | Rastrear definiciones en conflicto o relaciones rotas |
Timeliness | Retardo de frescura, cargas tardías, desviación de la entrega esperada | Escalar antes de que un informe o modelo use datos obsoletos |
Validez | Conformidad de esquema, valores no permitidos, violaciones de regla | Rechazar, aislar o remediar registros inválidos |
Unicidad | Recuento de duplicados, tasa de claves duplicadas, excepciones de resolución de entidad | Fusionar registros o corregir la lógica de identidad |
El cuadro de mando debería operar a nivel de conjunto y de campo siempre que sea posible. Una puntuación a nivel de tabla puede ocultar la columna exacta que provoca el fallo, mientras que una vista por campo ayuda al ingeniero a identificar rápidamente el contrato roto.
Los equipos que construyen estos controles pueden necesitar apoyo especializado de contratación, sobre todo cuando deben reclutar ingenieros de calidad de datos en LATAM. Las personas siguen formando parte del sistema de control. Cada métrica necesita responsable, umbral, vía de notificación y manual de respuesta.
Sin esos elementos, las mediciones rellenan un informe. Con ellos, el cuadro de mando dice al equipo qué hacer a continuación.
Arquitectura y patrones de despliegue para la empresa
La arquitectura determina si los controles de calidad pasan a formar parte de las operaciones de producción o siguen siendo un proyecto aislado de monitorización. El patrón adecuado depende de dónde residan los datos sensibles, cuánta infraestructura puede operar el equipo y con qué rapidez seguridad y compras aprueban un servicio nuevo.
Mantenga el cálculo cerca de los datos
La ejecución en base de datos o en el pipeline realiza perfilado, validación y cálculo de métricas dentro de sistemas como Snowflake, BigQuery, Databricks o una capa de orquestación. Esto reduce el movimiento innecesario de filas sensibles y permite que los controles se ejecuten junto a las cargas que protegen.
Este patrón encaja con equipos con límites estrictos de PII o que prefieren mantener los datos brutos dentro de los controles de gobierno existentes. También limita un problema común de implementación, en el que la monitorización exige una segunda copia de los datos de producción e introduce otra ruta de sincronización.
Ajuste los requisitos de aislamiento al despliegue
Bancos, organizaciones sanitarias y equipos gubernamentales pueden requerir despliegue en nube privada, aislado por VPC u on-premises. La decisión no es solo preferencia técnica. Puede depender de la residencia de datos, las revisiones internas de seguridad, la arquitectura de red y de si un proveedor puede operar sin acceder a registros de producción.
Un despliegue que satisface los requisitos de seguridad pero exige una amplia titularidad de infraestructura puede desbordar a un equipo de plataforma pequeño. A la inversa, una cómoda opción alojada puede encallar en la revisión de proveedores si choca con las reglas de tratamiento de la organización.
Compre capacidad por etapas operativas
La licencia modular permite empezar por un problema concreto, como detección de anomalías o Timeliness, y añadir después seguimiento de esquema, validación u observabilidad más amplia a medida que maduran la propiedad y las rutinas de respuesta. Así se evita pagar por controles que la organización todavía no puede operar con eficacia.
Patrón | Dónde se ejecuta | Mejor encaje | Compromiso principal |
|---|---|---|---|
En base de datos o en pipeline | Almacén, lakehouse u orquestador | Equipos que minimizan el movimiento de datos | Debe encajar en los patrones de cómputo y pipeline existentes |
Despliegue privado o aislado | Nube del cliente, VPC o centro de datos | Entornos regulados o sensibles a la seguridad | Requiere capacidad de infraestructura y aprobación |
Adopción modular | Primero capacidades seleccionadas, cobertura más amplia después | Equipos pequeños que demuestran valor de forma incremental | La cobertura puede quedar fragmentada sin un plan de crecimiento |
La arquitectura también es una cuestión de compras. Un motor técnicamente capaz no creará valor si la revisión legal bloquea el despliegue, la aprobación presupuestaria llega tarde o los ingenieros deben mantener una arquitectura que no encaja en su stack. Los equipos que evalúan la plataforma de datos empresarial circundante deberían incluir límites de seguridad, esfuerzo de integración, propiedad y coste operativo en la misma decisión.
Buenas prácticas y una hoja de ruta realista
Un despliegue debería empezar por los modos de fallo críticos para el negocio, no por intentar monitorizar todos los activos a la vez. El primer objetivo es dejar de enterarse de las roturas de datos por una escalada de dirección.
La fase uno se centra en fallos visibles
Empiece instrumentando las cinco tablas más críticas para ingresos. Configure alertas de volumen y frescura y encamínelas al flujo de Slack o PagerDuty que el equipo ya usa. El canal exacto importa menos que asegurar que los responsables de los datos vean la señal antes que los consumidores del panel.
Use la primera fase para establecer líneas base y propiedad. Registre el patrón normal de llegada, el comportamiento esperado de volumen, los campos críticos, los consumidores posteriores y el contacto de escalado de cada tabla. No añada reglas de negocio complejas hasta que el equipo pueda responder con fiabilidad a incidentes básicos de frescura y volumen.
La fase dos convierte supuestos en contratos
Después, trabaje con los equipos productores para definir reglas de validación sobre los campos y relaciones que importan. Un contrato de datos debería identificar el esquema, los valores aceptados, los campos obligatorios, la propiedad y qué ocurre cuando el productor cambia la estructura.
Las notificaciones de cambio de esquema deberían llegar antes de que la deriva alcance los modelos posteriores. La notificación debería incluir el campo cambiado, la diferencia de tipo o estructura, la primera aparición observada, el conjunto afectado y los consumidores conocidos. Ese contexto ayuda al productor a arreglar el origen en lugar de pedir a cada equipo posterior que redescubra la misma rotura.
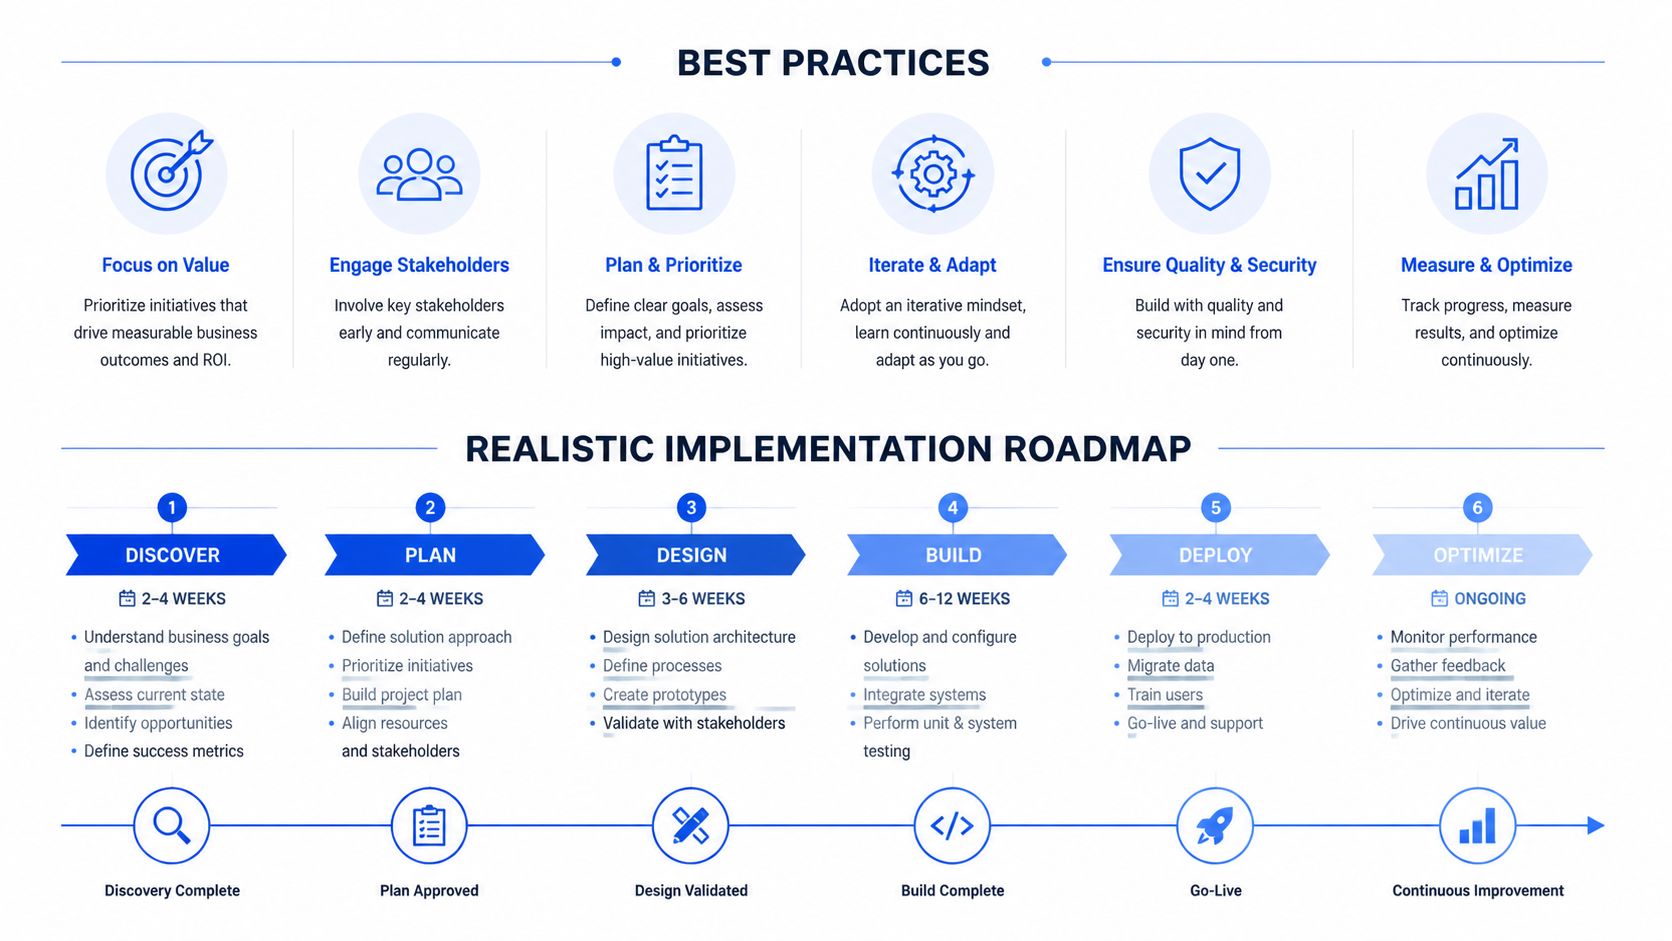
La fase tres integra la calidad en la entrega
Incruste las comprobaciones importantes en la CI del código de pipeline y de los cambios de esquema. Una pull request que cambie un modelo o un contrato debería mostrar qué controles de calidad se ven afectados y si los consumidores conocidos siguen siendo compatibles.
Estandarice los postmortems de incidentes en torno al mecanismo de fallo, la brecha de detección, la brecha de propiedad y el control preventivo. Vincule los KPIs de calidad a las revisiones de SLA para que los incidentes recurrentes influyan en la planificación y en las conversaciones de servicio, no solo en un backlog de ingeniería.
Un enfoque práctico de implementación de calidad de datos también debería incluir los hábitos que evitan que la cobertura se degrade:
Use nombres compartidos: aplique nomenclatura coherente a dimensiones, métricas, alertas, conjuntos y niveles de severidad.
Mantenga una única fuente de reglas: guarde contratos activos y definiciones de validación donde los equipos puedan encontrarlos y revisarlos.
Asigne responsables de conjunto: dé a cada activo crítico un responsable de negocio nombrado y un responder técnico.
Revise el comportamiento de las alertas: examine cuáles siguen disparándose, cuáles se ignoran y cuáles ya no representan un riesgo real.
Documente las excepciones: registre las desviaciones aceptadas para que las exenciones temporales no se vuelvan fallos permanentes invisibles.
El programa se vuelve sostenible cuando cada nueva comprobación tiene motivo, responsable y vía de respuesta. La cobertura debe crecer porque el equipo ha aprendido de los incidentes, no porque un panel parezca más completo.
Cómo una plataforma modular resuelve problemas operativos
Una plataforma modular es más fácil de evaluar cuando cada módulo se conecta a un modo de fallo. La pregunta no es si existe una funcionalidad. La pregunta es qué puede alguien detectar o prevenir con ella durante una semana real de operación.
La detección de anomalías ataca el problema del panel sorpresa. Un minorista puede vigilar los ingresos promocionales, los volúmenes de pedidos y la actividad de clientes frente a líneas base aprendidas. Un movimiento inusual puede motivar una investigación antes de una revisión de dirección, incluso cuando el pipeline reporta éxito.
El seguimiento de esquema ataca el problema del trabajo nocturno roto. Un equipo de logística que recibe telemetría de flota necesita saber cuándo una fuente añade un campo, elimina otro, cambia un tipo o altera una ruta anidada. Comparar conjuntos de campos y propiedades estructurales da a los ingenieros una señal temprana antes de que fallen las transformaciones posteriores. Las guías prácticas recomiendan registrar el origen, el conjunto, la versión de contrato, la primera aparición y los consumidores afectados, lo que hace más directa la remediación. Estos detalles se tratan en esta guía de monitorización de deriva de esquema.
Los controles de Timeliness atacan los incidentes de informes obsoletos. Un equipo financiero puede definir el comportamiento de entrega esperado para datos de riesgo o transacciones y distinguir una carga tardía de una variación esperada de calendario. El resultado es una señal de respuesta basada en la disponibilidad para el negocio, no en la mera finalización del trabajo.
Las reglas de validación atacan el riesgo de presentación regulatoria. Un banco puede comprobar campos de contraparte, valores permitidos, relaciones requeridas y condiciones de auditoría antes de que un flujo de envío consuma los datos. El control no sustituye al gobierno. Convierte los requisitos de gobierno en comportamiento repetible del pipeline.
La observabilidad ataca el problema de no saber lo que el equipo desconoce. Conecta frescura, esquema, volumen, validación, métricas de negocio y comportamiento de plataforma para que los ingenieros investiguen una desviación en contexto.
Una plataforma como digna combina detección de anomalías, monitorización de Timeliness, validación a nivel de registro, seguimiento de esquema, análisis histórico y ejecución en base de datos, con despliegue dentro de la nube, VPC o centro de datos del cliente. Su estructura modular permite empezar por una necesidad operativa concreta y ampliar solo cuando se pueda asignar propiedad y capacidad de respuesta.
Ese enfoque también protege las inversiones existentes. Los equipos no necesitan sustituir cada pipeline para añadir monitorización. Pueden colocar controles alrededor de los productos de datos más importantes, demostrar que los incidentes se detectan y resuelven más fácilmente y después extender la cobertura a finanzas, sanidad, telecomunicaciones o sector público.
Repensar la calidad de datos como disciplina operativa
Añadir más reglas de validación parece productivo porque el recuento de reglas es fácil de mostrar. No garantiza datos fiables. Una regla sin responsable, un umbral sin plan de respuesta y un panel sin escalado crean la apariencia de control mientras los mismos fallos continúan.
La medida operativa es otra. Pregunte si el equipo detecta incidentes antes, identifica causas raíz más rápido, protege los ciclos de reporte y reduce el trabajo repetido de conciliación. Los resultados de encuestas empresariales muestran por qué importa: en un informe sectorial de 2024, el 95 % de los responsables y profesionales de datos reportó un problema de calidad con impacto directo en el negocio, el 95 % dijo que la observabilidad por sí sola no bastaba para determinar la causa raíz y el 87 % dijo que los enfoques tradicionales basados en reglas no escalaban. Esas cifras aparecen en el informe ejecutivo State of Enterprise Data Quality de Anomalo.
Tres cambios operativos marcan la diferencia:
Asigne propiedad: cada conjunto crítico necesita un responsable de negocio nombrado y un responder técnico.
Ligue métricas a resultados: conecte señales de frescura, completitud y anomalías con informes, modelos, flujos regulatorios y KPIs de negocio.
Revise los modos de fallo: examine trimestralmente los incidentes recurrentes y elimine o revise los controles que los equipos ignoran por rutina.
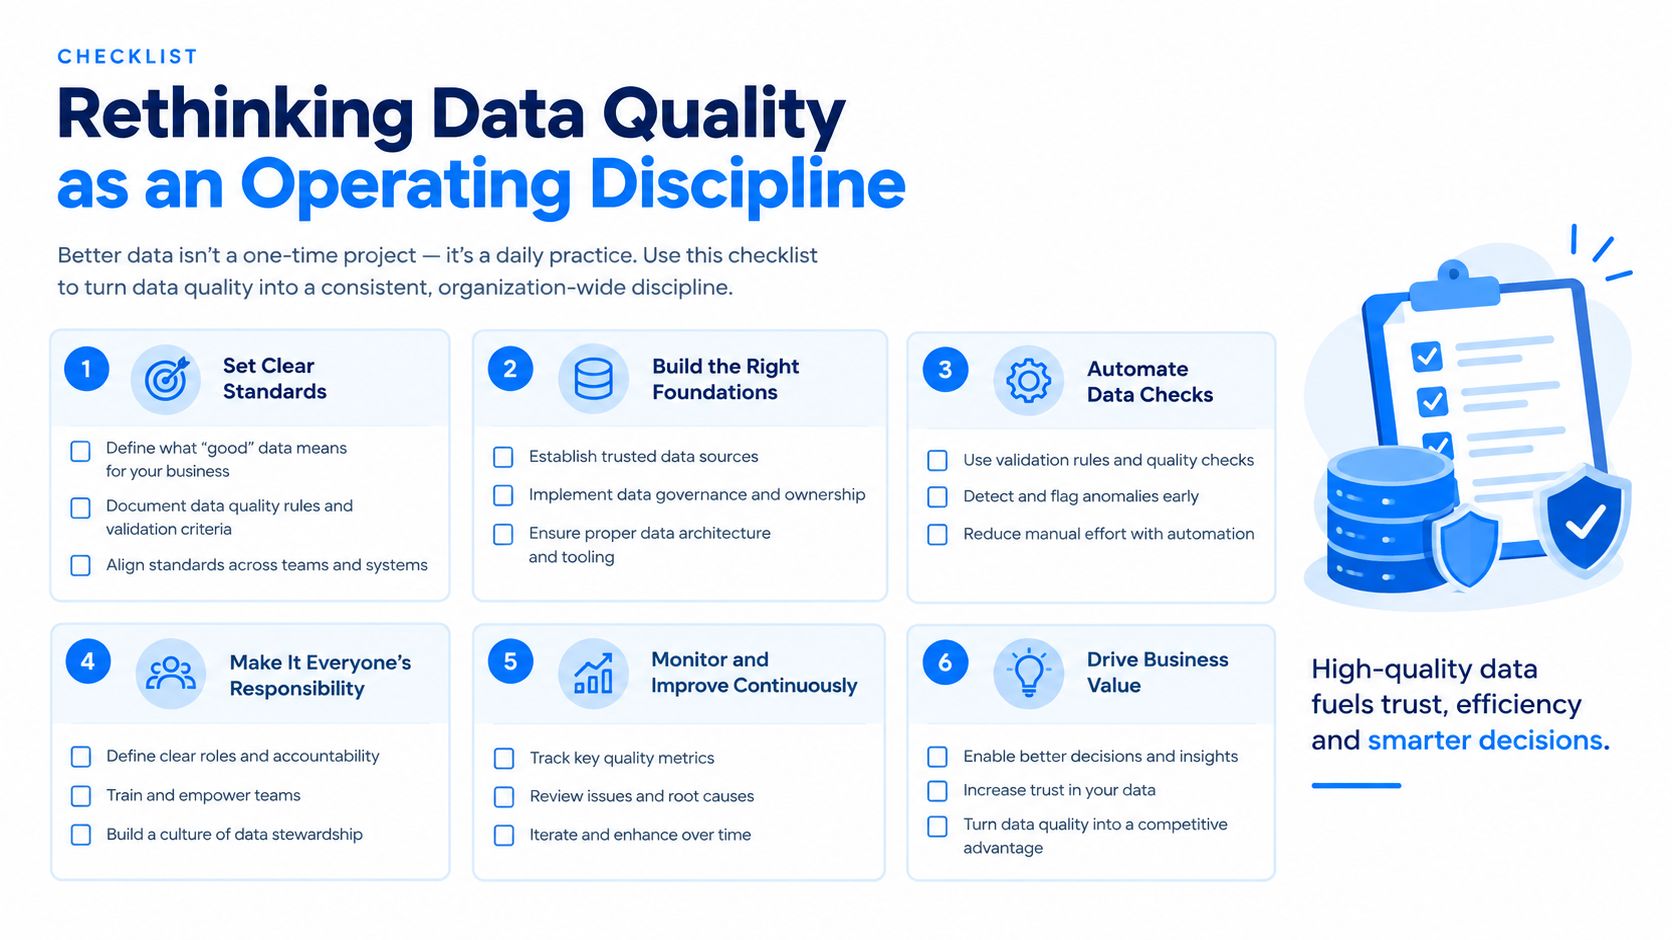
Use esta lista al inicio del próximo trimestre:
Identifique los conjuntos críticos que hay detrás de las decisiones más importantes.
Confirme el responsable, el responder, el umbral y la vía de escalado de cada uno.
Elimine reglas duplicadas o no accionables.
Añada monitorización para los fallos más comunes de frescura, esquema, volumen y completitud.
Revise cada alerta ignorada y decida si corregirla, suprimirla o escalarla.
Registre el paso de prevención de cada incidente recurrente.
La gestión de calidad de datos empresarial funciona cuando los controles pasan a formar parte de cómo los equipos operan sus productos de datos. Empiece por los fallos que interrumpen decisiones y construya después la cobertura técnica y la responsabilidad necesarias para que no vuelvan.
Si los paneles obsoletos, los cambios silenciosos de esquema o los movimientos inexplicados de KPIs consumen el tiempo de su equipo, visite digna para explorar una plataforma en su propio entorno para detección de anomalías, monitorización de Timeliness, validación y seguimiento de esquema. Empiece por los activos de datos que más importan, conecte las alertas con responsables y amplíe la cobertura a medida que madure su modelo operativo.
Para la capa de detección que capta los fallos para los que nadie escribió una regla, vea observabilidad de datos.
Preguntas frecuentes
¿Qué es la gestión de calidad de datos empresarial?
Es la práctica de mantener los datos fiables en todo el patrimonio y no proyecto a proyecto, combinando monitorización de comportamiento, contratos de datos explícitos, seguimiento de frescura y conciencia de esquema para que los problemas afloren antes de que se decida sobre ellos.
¿Por qué se rompen los paneles si ningún pipeline reportó un fallo?
Porque la mayor parte del daño es silenciosa. Un proveedor renombra un campo en su carga, un join descarta sin ruido las filas que dependían de él y todos los trabajos siguen reportando éxito. La orquestación confirma que el software se ejecutó; no dice nada sobre si las cifras resultantes siguen significando lo mismo que la semana pasada.
¿Qué métricas importan más en calidad de datos empresarial?
La cobertura de los conjuntos críticos, el tiempo de detección y de resolución, la tasa de recurrencia y la proporción de problemas hallados por la monitorización en lugar de reportados por un usuario de negocio. Esta última es la señal más clara de si detectan sus controles o sus interlocutores.
¿Dónde deben ejecutarse las comprobaciones de calidad?
Lo más cerca posible de los datos. Mantener el cálculo en el almacén evita mover registros sensibles fuera de su perímetro de seguridad y escala con el almacenamiento que ya paga, algo que importa cuando los requisitos de aislamiento descartan extraer datos a un servicio externo.
¿Cómo es un despliegue realista?
Tres fases. Empiece por los fallos visibles para que el valor sea evidente, convierta después los supuestos que hay detrás en contratos explícitos y, por último, integre la calidad en la entrega para que los controles influyan en las releases. Comprar toda la capacidad antes de la fase uno suele producir alertas que nadie posee.