Formato de tabla abierto: Iceberg, Delta y Hudi comparados
|
8
minuto de lectura

El consejo más repetido sobre el formato de tabla abierto es elegir uno que evite la dependencia de un proveedor. Ese consejo está incompleto. La portabilidad de los archivos importa, pero el cambio más profundo es que el significado de la tabla, el historial transaccional, la intención del esquema y los metadatos de planificación de consultas pasan a una capa compartida sobre los objetos del almacenamiento en la nube.
Ese desplazamiento convierte un directorio lleno de archivos Parquet u ORC en una tabla que varios motores pueden descubrir, leer, actualizar y evolucionar. También crea una responsabilidad nueva: hay que gobernar los metadatos. Iceberg, Delta Lake y Hudi pueden hacer que el almacenamiento se comporte más como una base de datos, pero no deciden si un snapshot tardío incumple un SLA, si una columna nueva rompe un modelo posterior o si un registro de apariencia válida contiene un patrón de negocio anómalo.
Esta guía empieza por el modelo conceptual, compara los tres formatos principales y luego sigue los metadatos hasta las operaciones de producción. La pregunta central es sencilla: ¿qué capa de control mantiene fiable una tabla abierta después de que el commit tenga éxito?
Tabla de contenidos
Por qué los formatos de tabla abiertos cambian el juego del lakehouse
Dónde los formatos de tabla abiertos dejan de resolver el problema
Por qué los formatos de tabla abiertos cambian el juego del lakehouse
Un formato de tabla abierto no es solo una forma compartida de leer Parquet sin depender de un proveedor. Coloca la semántica de tabla en metadatos que pueden residir junto a los datos en el almacenamiento de objetos. Esa semántica incluye commits atómicos, snapshots versionados, evolución de esquema, información de particiones y estadísticas a nivel de archivo.
Sin esa capa, el almacenamiento de objetos te da esencialmente archivos y carpetas. Un motor de consultas puede inferir una tabla a partir de un directorio, pero la estructura de directorios no responde de forma fiable a preguntas básicas: qué archivos pertenecen a la versión actual, qué escritura se completó, qué esquema estaba activo ayer o qué archivos pueden omitirse sin riesgo ante un filtro.
Los formatos de tabla abiertos responden a esas preguntas mediante metadatos compartidos. Apache Hudi surgió en Uber en 2016, Databricks introdujo Delta Lake entre 2017 y 2018 y lo liberó como código abierto en 2019, y Apache Iceberg nació en Netflix en 2018 y pasó a la Apache Software Foundation en 2019. Esos esfuerzos separados convergieron en el mismo problema: hacer que los data lakes se comportaran más como bases de datos sin sacar los datos del almacenamiento de objetos (panorama histórico de los formatos de tabla abiertos).
De directorios a tablas de primera clase
El resultado práctico es una tabla que admite lecturas por lotes, escrituras en streaming, actualizaciones y borrados sobre el mismo almacenamiento. Los motores no tienen que tratar cada archivo como su propia fuente de verdad. Pueden resolver un snapshot coherente, revisar los metadatos y planificar el trabajo contra el subconjunto de archivos relevante.
Eso cambia el diseño de varias maneras:
Las escrituras concurrentes se vuelven manejables: un commit puede tener éxito o fallar como un cambio de metadatos completo, sin exponer un estado parcial de la tabla.
Varios motores pueden cooperar: Spark, Trino, Flink, los almacenes de datos y otros lectores pueden usar el contrato de metadatos de la tabla en lugar de depender únicamente de rutas físicas.
Las pipelines dependen menos del motor: los equipos pueden separar la semántica de almacenamiento del motor de cómputo que ejecuta una transformación.
Las tablas se convierten en objetos de catálogo: la propiedad, la localización, el acceso y el linaje pueden organizarse alrededor de una tabla y no de una carpeta.
Una tabla Delta, por ejemplo, contiene archivos de datos y un registro de transacciones. Los checkpoints periódicos compactan ese registro para que los motores identifiquen el snapshot activo y las particiones relevantes sin enumerar cada objeto, incluso a gran escala (descripción técnica del diseño transaccional de Delta Lake).
Regla de arquitectura: un formato de tabla abierto te da una descripción duradera del estado de la tabla. No te da automáticamente un control duradero sobre lo que ese estado significa para el negocio.
Esa distinción importa para el diseño del lakehouse. Un modelo útil de calidad de datos en el lakehouse debe situarse por encima de los commits de almacenamiento y conectar el cambio estructural con la propiedad, la validación, la frescura y el impacto posterior.
Las primitivas esenciales explicadas sin jerga
Piensa en el almacenamiento de objetos como una gran sala de correo. Hay cajas en el suelo con archivos Parquet u ORC en bruto. Las cajas son duraderas, pero el suelo por sí solo no le dice al encargado qué cajas pertenecen al envío de hoy ni si una caja recién llegada sigue el formato de sobre acordado.
Un formato de tabla abierto añade los registros del encargado. Cada registro describe el estado actual de la tabla y ayuda a un motor de consultas a encontrar las cajas correctas sin abrirlas todas.
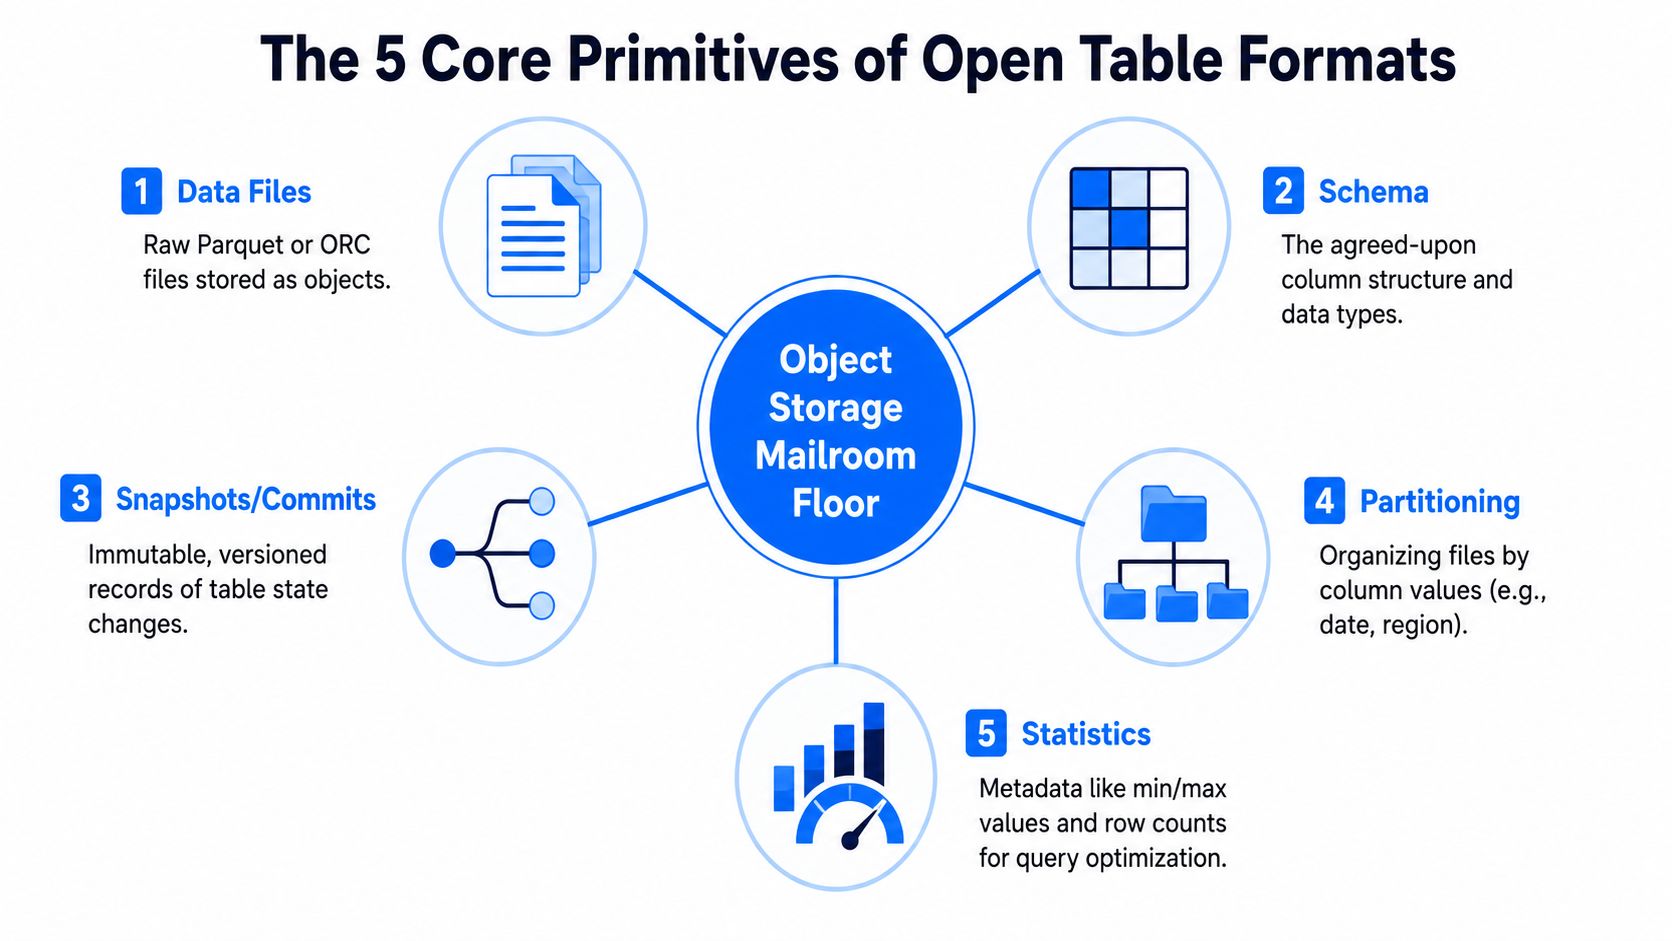
Los cinco registros que necesita el encargado
Los archivos de datos son las cajas en el suelo de la sala de correo. Contienen las filas reales, normalmente en formatos columnares como Parquet u ORC. El papel de Parquet en el almacenamiento analítico es distinto de la gestión de tablas. Parquet almacena los datos de forma eficiente, mientras que el formato de tabla abierto explica cómo esos archivos componen una tabla en evolución.
El esquema es el reglamento de la forma del sobre. Define nombres de columnas, tipos de datos y expectativas estructurales. La evolución de esquema permite que una tabla cambie con el tiempo sin reescribir de inmediato cada archivo histórico, pero el cambio permitido sigue necesitando gobernanza.
Los manifiestos son inventarios detallados. Una entrada de manifiesto puede indicar la ruta de un archivo de datos, sus valores de partición y las estadísticas de columna. En Iceberg, los archivos de metadatos definen la tabla, las listas de manifiestos definen los snapshots y los archivos de manifiesto enumeran los archivos de datos con estadísticas para el pruning (comparativa arquitectónica sobre Iceberg).
Los snapshots son fotografías de los registros. Un lector puede consultar la tabla tal como existía en un snapshot anterior y obtener una respuesta coherente incluso mientras llegan archivos nuevos. Iceberg usa archivos de metadatos inmutables e historial de snapshots, y cada commit produce una nueva versión de metadatos (especificación de Iceberg).
Las transacciones ACID son las reglas de commit del encargado. Una actualización de metadatos se hace visible como operación completa o no pasa a formar parte del estado actual de la tabla. Eso protege a los lectores de ver media escritura y da a los escritores una manera de coordinar cambios.
Por qué la partición y las estadísticas afectan al rendimiento
La partición es la organización de las estanterías. Si las filas se agrupan por un valor que aparece a menudo en los filtros, un motor puede saltarse estanterías enteras. Las estadísticas dan pistas más finas, como los valores mínimo y máximo de una columna dentro de un archivo, para que el planificador pueda evitar archivos cuyos rangos no coinciden con la consulta.
Por eso el rendimiento depende de la planificación sobre metadatos y no solo de la velocidad bruta de los archivos. Una tabla bien organizada permite al motor reducir la E/S antes de escanear los datos. Una tabla mal organizada puede seguir siendo técnicamente correcta y aun así forzar escaneos amplios.
La evolución de esquema merece la misma cautela. Añadir una columna puede ser compatible con los lectores existentes, pero eliminarla o cambiar un tipo puede afectar a paneles, modelos y contratos de datos. El formato registra el estado estructural. Tu plataforma sigue teniendo que decidir si un cambio propuesto es aceptable.
Cómo surgieron Iceberg, Delta Lake y Hudi
Iceberg, Delta Lake y Hudi crecieron en equipos distintos que se toparon con la misma carencia arquitectónica: los archivos en el almacenamiento de objetos no son tablas. Cada proyecto añadió metadatos y comportamiento de commit priorizando cargas de trabajo y entornos operativos diferentes. Su historia es, por tanto, una historia de gobernanza de metadatos, no de disposición de archivos.
Apache Hudi surgió en Uber en 2016, cuando los equipos necesitaban que el almacenamiento del lake soportara procesamiento incremental y datos mutables. Su diseño gira en torno a upserts, borrados, indexación a nivel de registro y una línea temporal de commits. Esas decisiones encajan con pipelines que aplican cambios repetidos procedentes de sistemas operativos.
Databricks introdujo Delta Lake entre 2017 y 2018 y lo liberó como código abierto en 2019. Delta guarda el historial transaccional en un registro junto a los archivos de datos. Entradas secuenciales en JSON o Parquet bajo _delta_log registran las operaciones y permiten a los motores reconstruir el estado de la tabla y consultar versiones anteriores. Esta comparativa arquitectónica de Iceberg, Delta Lake y Hudi ofrece una visión concisa de sus diseños.
Netflix desarrolló Iceberg en 2018 y lo donó a la Apache Software Foundation en 2019. Iceberg se centró en metadatos inmutables, aislamiento por snapshot, particionado oculto y acceso a tablas neutral respecto al motor. Su estructura de metadatos separa las definiciones de tabla, las referencias a snapshots y los manifiestos a nivel de archivo, y soporta la evolución de particiones y el pruning de consultas. Nuestra visión general del formato de tabla abierto Apache Iceberg aporta más contexto.
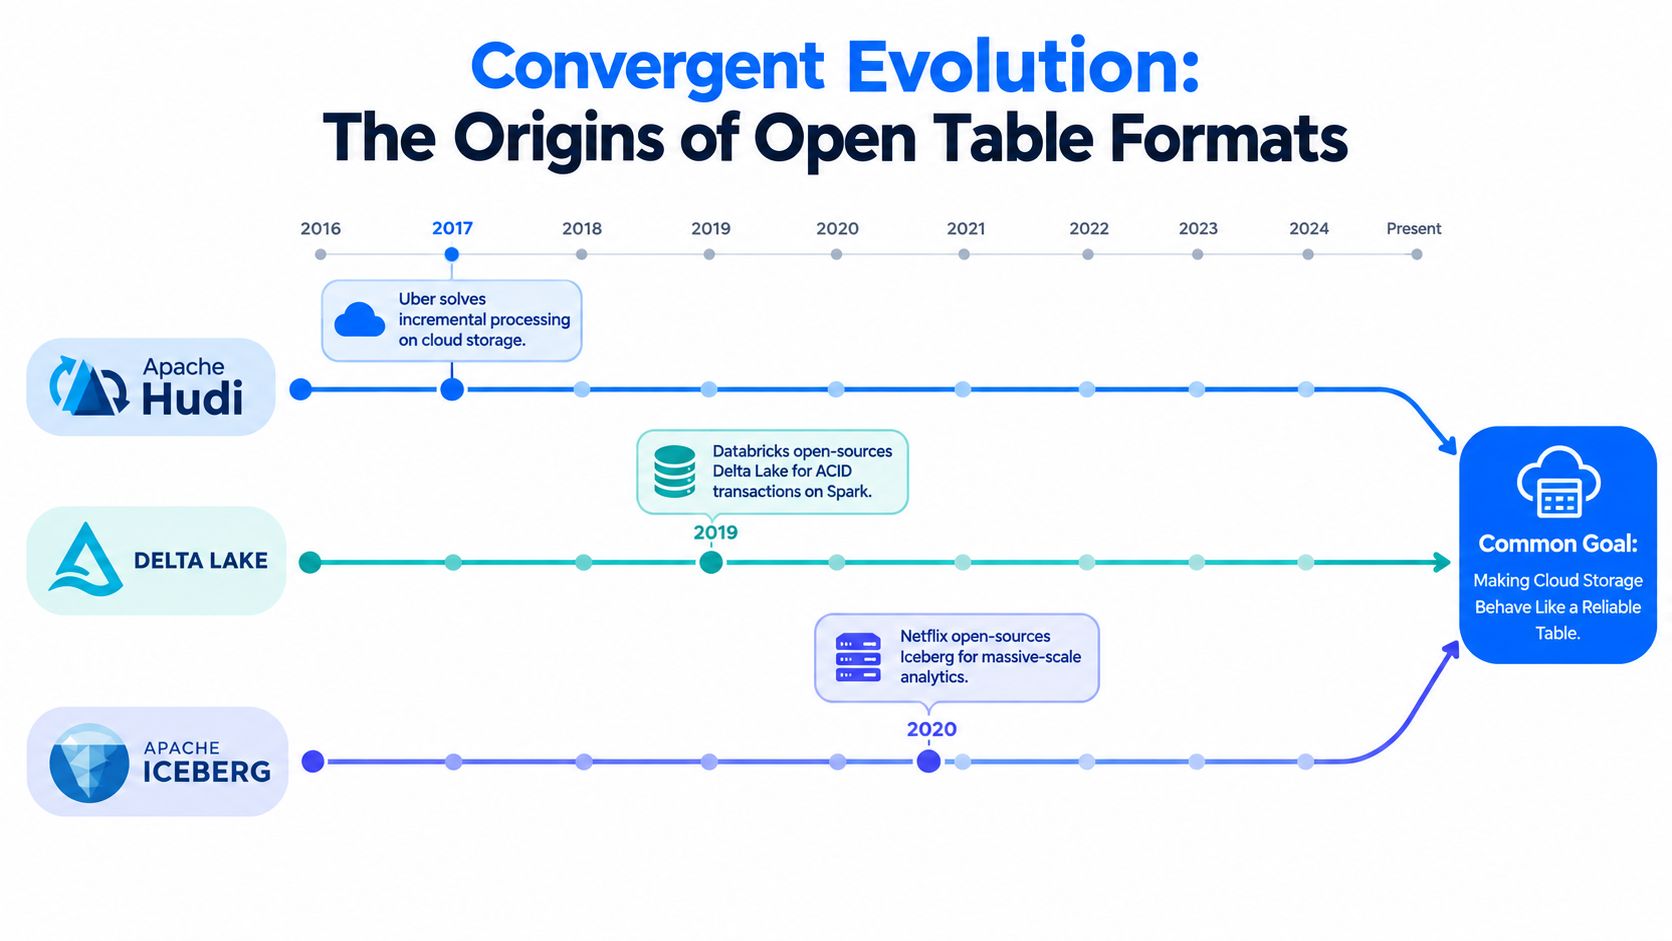
Estos formatos convergieron porque abordan el mismo fundamento con modelos de metadatos distintos. La decisión tiene que ver con cómo escriben datos las cargas de trabajo, qué motores deben interoperar, cómo coordinan el acceso los catálogos y qué equipo asume el mantenimiento de las tablas.
Esa historia también aclara la brecha operativa que queda. Las fortalezas de Hudi a nivel de registro, el enfoque de Delta basado en el registro de transacciones y el modelo de Iceberg basado en manifiestos aportan primitivas de tabla útiles. Ninguno define por sí solo el linaje corporativo, las definiciones de negocio, las políticas de acceso, la respuesta ante anomalías o la aprobación de cambios. Una capa de observabilidad dentro de la base de datos como digna puede conectar esos controles con los cambios de esquema, Timeliness y el comportamiento anómalo.
Comparación directa entre Iceberg, Delta Lake y Hudi
Las arquitectas de plataforma deberían comparar formatos por la forma de la carga de trabajo y la mezcla de motores, no por promesas de funcionalidades aisladas. Los tres pueden ofrecer comportamiento transaccional de tabla, gestión de esquema, historial de versiones y planificación de consultas guiada por metadatos. Sus diferencias se ven mejor en cómo representan el estado y optimizan las escrituras.
Dimensión | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Modelo de metadatos | Archivos de metadatos inmutables, listas de manifiestos, manifiestos e historial de snapshots | Registro de transacciones plano bajo | Commits basados en una línea temporal con metadatos y estructuras de índice para cambios de registro |
Estilo de particionado | Particionado oculto y transformaciones de partición, tratando la evolución de particiones como un cambio de metadatos | Columnas de partición más disposición y funciones de optimización propias del ecosistema | Columnas de partición, índices a nivel de registro y organización asistida por el motor para cargas mutables |
Evolución de esquema | Metadatos explícitos de esquema y partición, con una evolución que no ata las consultas a columnas físicas de partición | Metadatos de esquema y transacción gestionados mediante el protocolo Delta y los controles de plataforma que lo rodean | El esquema y la línea temporal de commits soportan cambios en pipelines de ingesta y con muchas actualizaciones |
Garantías de concurrencia | Commits basados en snapshots y aislamiento mediante versiones de metadatos inmutables | Commits mediante el registro de transacciones y coordinación optimista en torno al estado de la tabla | Commits en línea temporal, diseñados para inserciones, actualizaciones y borrados |
Encaje con el ecosistema | Opción sólida para entornos con motores heterogéneos y arquitecturas orientadas al catálogo | Encaje natural en plataformas centradas en Databricks y Spark, con interoperabilidad más amplia según el soporte del protocolo | Opción sólida para ingestas con muchos upserts, procesamiento incremental y cargas que se benefician de la indexación a nivel de registro |
Apache Iceberg
Iceberg suele resultar atractivo cuando muchos motores deben compartir tablas y las columnas físicas de partición no deberían filtrarse a la lógica de consulta. El particionado oculto deja que el formato gestione las transformaciones mientras las consultas se refieren a columnas lógicas. Su especificación también soporta la evolución de particiones como un cambio solo de metadatos que no reescribe de inmediato los archivos de datos existentes (documentación de Iceberg).
La contrapartida es el mantenimiento de metadatos. Los archivos de manifiesto y las estructuras de snapshot aportan información rica para la planificación, pero las tablas pequeñas o muy modificadas pueden acumular metadatos que exigen un mantenimiento deliberado. Iceberg encaja bien cuando la interoperabilidad, la evolución de particiones y la gobernanza orientada a snapshots pesan más que la simplicidad de un stack de un solo proveedor.
Delta Lake
El registro de transacciones de Delta resulta familiar para los equipos que ya operan Spark y Databricks. El registro captura las acciones sobre la tabla y los checkpoints hacen más eficiente la reconstrucción del estado a gran escala. Esa integración puede acortar el camino desde pipelines de Spark existentes hasta tablas de lakehouse transaccionales.
La limitación honesta es el acoplamiento. Delta funciona en el ecosistema más amplio, pero la experiencia más fluida suele depender de los protocolos, los runtimes, los catálogos y las prácticas de optimización de Databricks. Una plataforma que espera que motores independientes escriban y gobiernen las mismas tablas debería validar esos caminos en lugar de suponer compatibilidad a partir de la disposición de los archivos.
Apache Hudi
Hudi destaca en pipelines de captura de cambios y tablas mutables. Su enfoque de indexación a nivel de registro puede dirigir actualizaciones y borrados a los grupos de archivos adecuados, reduciendo la necesidad de búsquedas amplias para localizar los registros objetivo. Esa fortaleza trae consigo más conceptos operativos propios del formato, incluidos indexación, compactación y líneas temporales de commits.
Elige Hudi cuando el comportamiento de upsert sea central para la carga de trabajo y el equipo esté dispuesto a operar su modelo de escritura y mantenimiento. Elige Delta cuando Spark y Databricks sean el centro de gravedad. Elige Iceberg cuando la neutralidad de motor, la coordinación de catálogos y las estrategias de partición cambiantes sean los requisitos principales.
Prueba de decisión: enumera los motores que deben leer y escribir la misma tabla, y después las mutaciones, los controles de gobernanza y los comportamientos de rollback que esos motores necesitan. El formato que encaje en esa intersección importa más que una promesa genérica de portabilidad.
Dónde los formatos de tabla abiertos dejan de resolver el problema
Un formato de tabla abierto puede decirte que un commit tuvo éxito. No puede decirte si los registros confirmados cumplen una regla de negocio.
Ese límite es intencionado. La capa de formato gestiona la estructura y el estado de la tabla, no el significado de cada registro ni las expectativas de nivel de servicio en la entrega. No valida automáticamente que una transacción tenga un estado permitido, no avisa de un snapshot tardío, no detecta un cambio inesperado de distribución ni reconcilia un cambio de esquema con cada contrato posterior.
La brecha de gobernanza por encima de la tabla
La evolución de esquema muestra el problema con claridad. Un formato de tabla puede permitir un cambio aditivo sin romper las consultas existentes, pero un equipo de producción todavía debe preguntar quién lo aprobó, qué consumidores dependen de la columna afectada, si una ampliación de tipo altera el comportamiento del modelo y si existe una pista de auditoría.
Una explicación de Databricks de 2026 señala que los cambios de esquema ligeros pueden favorecer ediciones directas en producción sin pruebas suficientes, mientras los catálogos ganan importancia para los snapshots autorizados y el control de acceso (discusión de Databricks sobre formatos de tabla abiertos). Informes independientes de 2026 describen igualmente una brecha entre la estructura a nivel de tabla y el linaje, los glosarios, la clasificación y la gestión de políticas entre motores a escala de catálogo (análisis de arquitectura de datos moderna).
Los equipos suelen tapar esa brecha con herramientas desconectadas:
Flujos de catálogo: la localización de activos y la propiedad viven en un sistema.
Trabajos de validación: las comprobaciones de negocio se ejecutan en notebooks o tareas de orquestación.
Monitores de frescura: las alertas de llegada dependen de planificadores y metadatos de pipeline.
Respuesta a incidentes: analistas e ingenieras usan paneles separados para investigar el impacto.
Esa fragmentación dificulta seguir un incidente de metadatos. Aparece una columna nueva en un manifiesto de Iceberg, un modelo posterior sigue ejecutándose, un panel cambia y ninguna vista única conecta el evento estructural con el riesgo de negocio que se está creando.
La gobernanza puede subir de nivel, no desaparecer
Los formatos abiertos reducen la dependencia a nivel de almacenamiento, pero las organizaciones aún pueden crear dependencia por encima de los archivos, mediante catálogos, sistemas de control de acceso, convenciones de linaje y prácticas operativas. El reto se agudiza en finanzas, sanidad, telecomunicaciones y sector público, donde los equipos necesitan controles consistentes entre motores y evidencia para los cambios relevantes.
Por eso una capa de control debe observar más que el estado de los archivos. Debería conectar esquema, Timeliness, validez de los registros, anomalías, propiedad y dependencias posteriores, y dejar los datos donde la organización ya los gobierna.
Un enfoque de monitorización del data lake debería empezar en el límite de la tabla y después seguir los metadatos y el comportamiento de los datos hacia fuera, hasta las pipelines, los consumidores y los controles de negocio.
Cómo digna cierra la brecha operativa
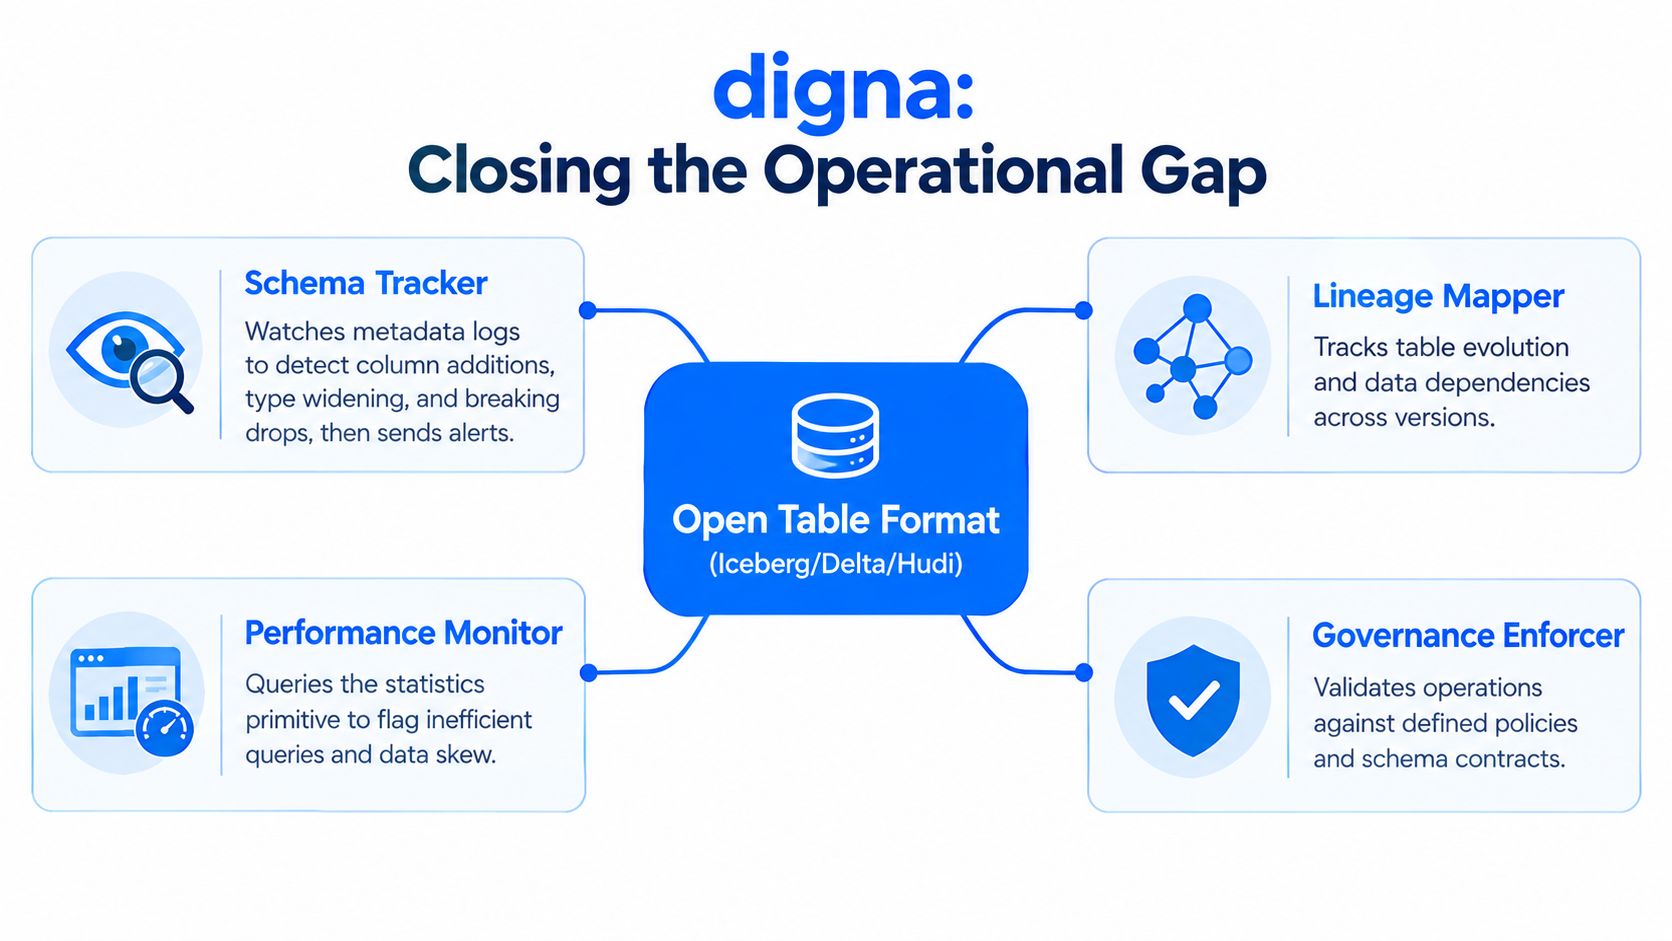
digna puede situarse sobre Iceberg, Delta Lake y Hudi como una capa de observabilidad dentro de la base de datos. El modelo mental útil no es otro formato de tabla. Es un conjunto de comprobaciones operativas que convierte los metadatos de tabla y el comportamiento de los snapshots en señales para ingenieras, responsables de datos y equipos de gobernanza.
Empezar por el cambio estructural
Schema Tracker observa los metadatos estructurales y detecta columnas añadidas, columnas eliminadas y cambios de tipo de dato. Para una tabla abierta, eso significa relacionar los cambios en los archivos de metadatos de Iceberg, las entradas del registro de transacciones de Delta o la información de commits de Hudi con las personas responsables y los consumidores que dependen de la tabla.
Un evento de esquema no debería convertirse automáticamente en un incidente. La pregunta que importa es si el cambio es compatible con los contratos de la tabla. Un atributo nuevo que admite nulos puede ser aceptable, mientras que un identificador eliminado o un cambio de tipo incompatible puede exigir aprobación y pruebas posteriores.
Añadir comportamiento de entrega y de registro
Timeliness compara la llegada real de los snapshots con los patrones de entrega esperados y las expectativas de nivel de servicio. Puede avisar de particiones tardías, cargas ausentes y entregas anticipadas, lo que ayuda a los equipos a distinguir un commit exitoso de una entrega exitosa del producto de datos.
Data Anomalies perfila los snapshots nuevos para revelar cambios inusuales de volumen, comportamiento de nulos y desplazamientos de distribución. Eso complementa las estadísticas a nivel de archivo. Los metadatos pueden ayudar a un motor de consultas a hacer pruning, pero la observabilidad pregunta si los datos recién confirmados parecen normales en su contexto de negocio.
Data Validation aplica reglas a nivel de registro y contratos de esquema. Esas comprobaciones pueden imponer condiciones como relaciones válidas, valores permitidos o requisitos de auditoría antes de que los consumidores traten un snapshot como listo.
Conectar los incidentes con la salud de la plataforma
Data Platform Observability reúne la salud de las pipelines, el linaje, la frescura, el uso y el comportamiento de la plataforma en una sola vista operativa. Cuando una tabla Iceberg anterior cambia de esquema, el equipo puede seguir ese evento hasta los paneles o modelos afectados en lugar de buscar por separado en registros de almacenamiento, historial de orquestación y alertas de BI.
El modelo de ejecución de digna dentro de la base de datos mantiene el cálculo de métricas y el análisis en las bases de datos de la clientela. El modelo de despliegue admite entornos de nube privada y on-premise, algo que puede importar cuando los datos regulados no pueden copiarse a un servicio externo de monitorización.
El límite arquitectónico sigue siendo claro. Iceberg, Delta o Hudi es dueño del estado de la tabla y de sus metadatos. digna monitoriza si ese estado es estructuralmente seguro, puntual, válido y conforme a lo esperado.
Un camino práctico hacia la adopción y la migración
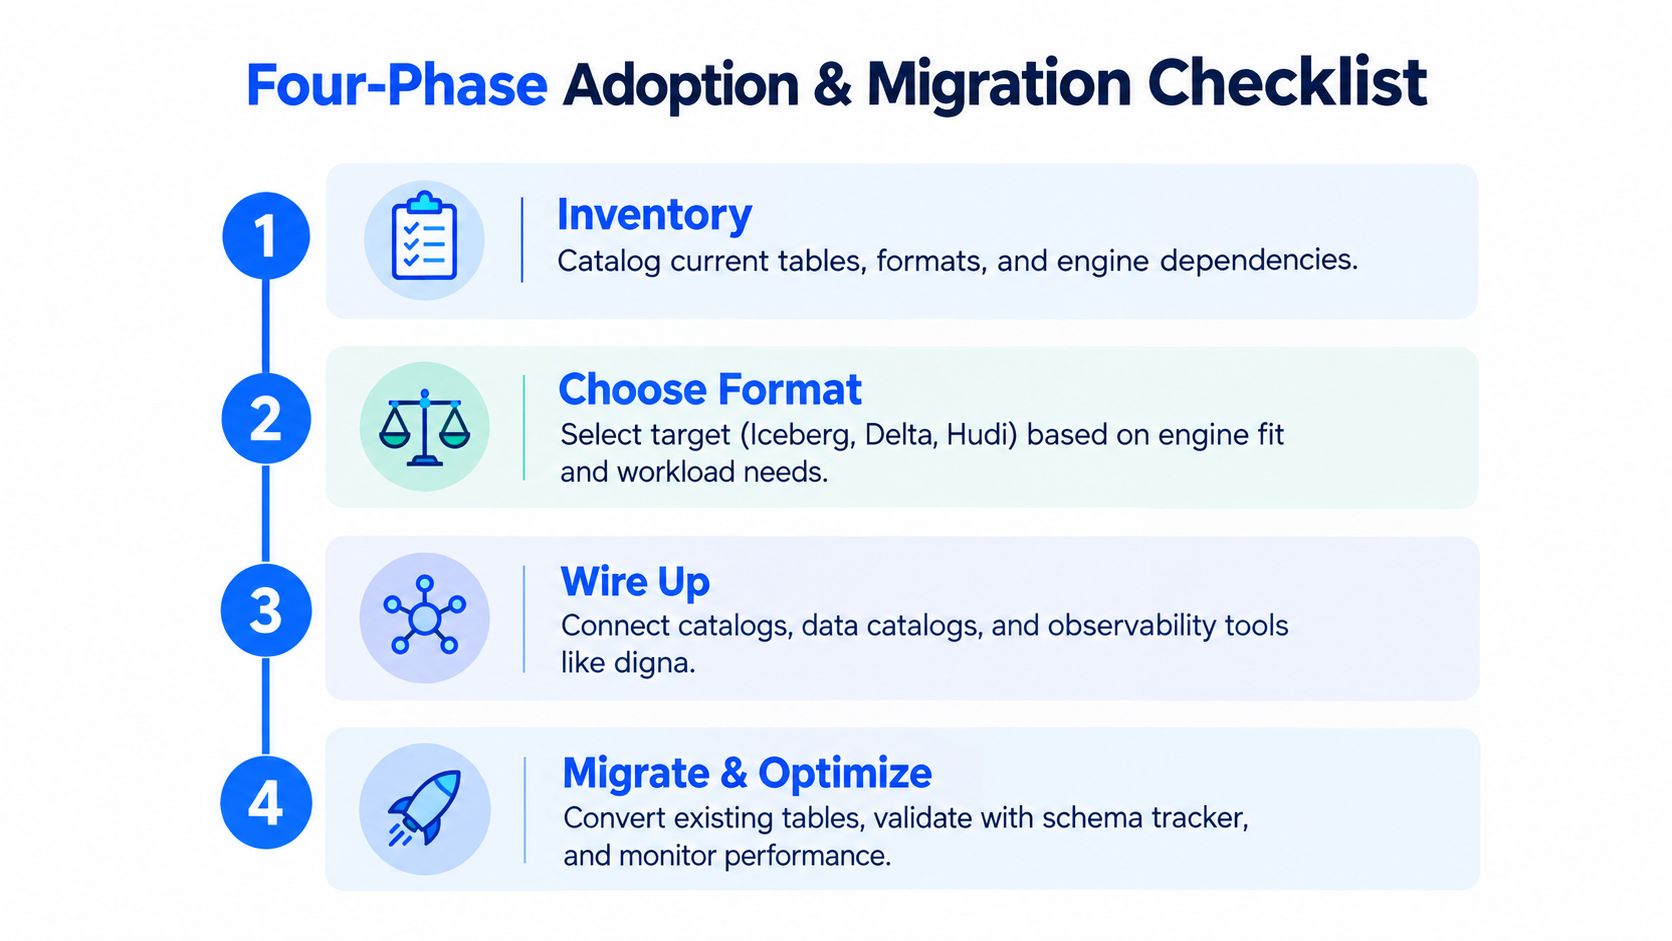
La migración funciona mejor como una secuencia controlada que como una conversión masiva. Trata cada tabla como un producto con un formato de almacenamiento, una identidad de catálogo, un conjunto de consumidores y unas expectativas operativas.
Fase uno: inventariar el patrimonio de datos
Enumera las tablas actuales, los formatos de archivo, los patrones de escritura, los esquemas de partición, las dependencias de motor y los consumidores posteriores. Identifica qué tablas solo reciben datos añadidos, cuáles necesitan actualizaciones o borrados y cuáles lee más de un motor.
Ese inventario revela los criterios reales de decisión. Una tabla que solo usa Spark tiene una ruta de migración distinta de otra que escribe Flink, consulta Trino y consume un almacén de datos.
Fase dos: elegir el destino
Elige Iceberg, Delta Lake o Hudi según el encaje de motor, los patrones de mutación, las necesidades de partición, el comportamiento del catálogo y la capacidad operativa del equipo. Los equipos financieros pueden priorizar la consistencia transaccional y la imposición de esquema. Las pipelines de retail pueden preferir el particionado oculto y los upserts desde CDC en streaming. Las plataformas de analítica SaaS pueden dar más peso a las lecturas entre varios motores.
El formato es solo una decisión. Define qué catálogo establece la identidad de la tabla, cómo la encuentran los motores, quién aprueba los cambios de esquema y cómo funciona el rollback.
Fase tres: conectar los controles antes del cambio
Conecta el catálogo, los flujos de validación, las pruebas de propiedad y la observabilidad antes de mover el tráfico de producción. Ejecuta lecturas en paralelo desde la tabla heredada y el destino Iceberg, Delta o Hudi. Compara el esquema y los resultados a nivel de fila con Data Validation, y luego fija umbrales de frescura y de comportamiento anómalo.
Un marco para planificar migraciones de datos debería incluir criterios de rollback, duración de las lecturas en sombra, aceptación por parte de los consumidores y retención de evidencia. No esperes al primer panel roto para descubrir que nadie es responsable de la tabla nueva.
Fase cuatro: migrar tabla por tabla
Convierte una tabla acotada, valida lecturas y escrituras, observa el crecimiento de los metadatos y el comportamiento de las consultas. Mantén disponible la ruta antigua hasta alcanzar la paridad y los umbrales operativos, y después mueve a los consumidores por etapas.
La elección de formato importa, pero la disciplina en los metadatos importa más. Una tabla Hudi bien gobernada puede superar a un despliegue de Iceberg mal mantenido para su carga de trabajo, igual que un patrimonio Delta operado con cuidado puede encajar mal en una organización que necesita motores y catálogos independientes.
Elige el formato que encaje con tu carga de trabajo, pero diseña la capa de gobernanza al mismo tiempo. Eso es lo que convierte el almacenamiento abierto en una tabla de lakehouse fiable.
digna monitoriza los cambios de esquema, la puntualidad de los snapshots, la validez de los registros y el comportamiento anómalo de los datos dentro de tu propio entorno, y da a los equipos una capa operativa sobre Iceberg, Delta Lake y Hudi. Visita digna para evaluar cómo sus capacidades modulares de observabilidad y validación pueden apoyar tu migración a tablas abiertas.
Donde termina el formato empiezan las comprobaciones de negocio: Business Monitoring vigila si las cifras que produce una tabla siguen comportándose como se espera.
Preguntas frecuentes
¿Evitar la dependencia de un proveedor es la razón principal para usar un formato de tabla abierto?
Esa razón está incompleta. La portabilidad de los archivos importa, pero el cambio mayor es que el significado de la tabla —historial transaccional, intención del esquema y metadatos de planificación de consultas— sale de un único motor y pasa a archivos que cualquiera puede leer. La dependencia es el síntoma; dónde vive la definición de la tabla es el cambio real.
¿Qué primitivas comparten Iceberg, Delta Lake y Hudi?
Los tres mantienen un registro de commits inmutable, un manifiesto que describe qué archivos pertenecen a qué versión, estadísticas por archivo para el pruning y un registro de esquema que evoluciona con independencia de los archivos de datos. Las diferencias están en cómo escribe y compacta cada uno esa estructura, no en el concepto subyacente.
¿En qué se diferencian los tres formatos en la práctica?
Iceberg tiene el soporte de motores más amplio y el diseño más neutral respecto al motor. Delta Lake se integra más a fondo en los entornos de Spark y Databricks. Hudi optimiza para upserts frecuentes y consumo incremental. La comparación honesta gira en torno al patrón de escritura para el que se construyó cada uno, no a cuál enumera más funciones.
¿Dónde dejan los formatos de tabla abiertos de resolver el problema?
En la frontera entre estructura y significado. El formato puede garantizar que cada motor lea las mismas filas confirmadas bajo el mismo esquema; no puede decirte que esas filas estén completas, que llegaran a tiempo o que contengan valores con sentido. Esa brecha es el lugar de la monitorización de calidad.
¿Cómo es un camino de adopción realista?
Elige una tabla con propiedad clara y un patrón de consulta conocido, conviértela mientras el original sigue funcionando y compara resultados durante un ciclo de negocio completo antes de mover a los consumidores. Asigna el mantenimiento —compactación, expiración de snapshots, actualizaciones de catálogo— antes de que termine el piloto, o no será tarea de nadie.



