Confiabilidad frente a validez de los datos: qué las diferencia
|
10
minuto de lectura

El consejo más popular sobre fiabilidad frente a validez de los datos es incompleto: haz que el pipeline sea coherente, añade comprobaciones de frescura y confía en el cuadro de mando cuando se mantenga en verde. Ese enfoque detecta entregas inestables, pero puede pasar por alto un fallo más peligroso. Un pipeline puede repetir indefinidamente la misma interpretación errónea, ofreciendo a los directivos un informe limpio y proporcionando a los modelos una señal de entrenamiento coherente que ya no representa al negocio.
La fiabilidad y la validez son capas de control independientes. La fiabilidad se pregunta si una medición es coherente y está disponible en condiciones repetibles. La validez se pregunta si mide la realidad, el constructo o la regla de negocio previstos. Una plataforma de datos fiable necesita ambas cosas, con módulos de Observability asignados al fallo que cada uno de ellos puede detectar.
Índice de contenidos
Por qué los pipelines estables pueden seguir produciendo decisiones erróneas
Cómo se asignan los módulos de Observability a cada propiedad
Por qué los pipelines estables pueden seguir produciendo decisiones erróneas
Pensemos en un cuadro de mando de ingresos mensuales que muestra totales idénticos en tres ejecuciones consecutivas. Se superan todas las comprobaciones de frescura. No se activa ninguna alerta de anomalía. El pipeline se completa según lo previsto, el recuento de filas se mantiene dentro del patrón esperado y el cuadro de mando presenta un aspecto operativo saludable.
El problema radica en la taxonomía. Una fusión silenciosa ha provocado que dos líneas de productos se agreguen bajo una misma categoría. El pipeline es estable, pero el significado empresarial ha cambiado. Nada en un monitor de entrega básico tiene por qué saber que la definición de la categoría ahora es errónea, sobre todo si los totales resultantes siguen siendo numéricamente plausibles.
Esa distinción es fundamental para la ciencia de la medición. La fiabilidad se refiere a la coherencia entre mediciones repetidas, mientras que la validez se refiere a si la medida capta lo que pretende medir (Statistics Solutions explica la distinción entre fiabilidad y validez). Por lo tanto, un pipeline estable puede ofrecer un error repetible. El cuadro de mando no miente porque el cálculo haya fallado. Induce a error porque el cálculo se sigue ejecutando con una interpretación no válida.
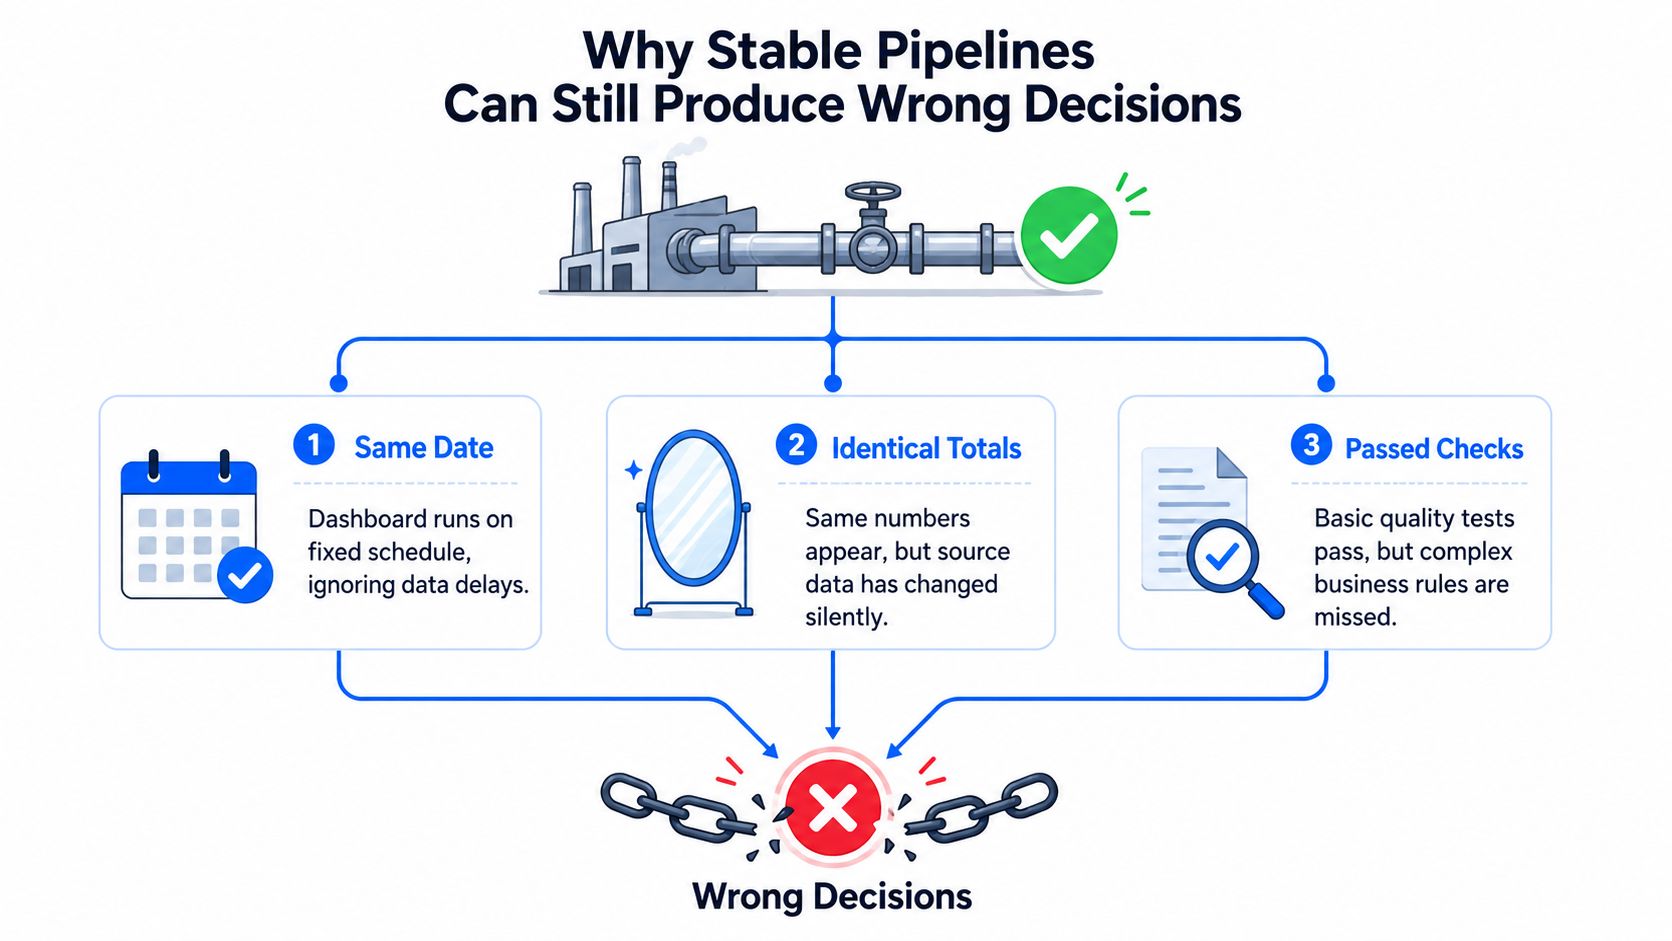
Dos modos de fallo diferentes
El error aleatorio crea variación. Una partición llega tarde, una fuente envía menos registros, se disparan los nulos o un observador clasifica el mismo registro de forma diferente de una ejecución a otra. Los controles de fiabilidad están diseñados para exponer esa inestabilidad mediante comprobaciones de repetibilidad, frescura, anomalía y coherencia.
El error sistemático crea un sesgo estable. Una unidad cambia de dólares a centavos, una tabla de tipos de cambio invierte una conversión o un denominador excluye a una población significativa. El resultado puede seguir siendo fluido y reproducible, pero no representar el constructo previsto. Se necesitan controles de validez, como las pruebas semánticas y la conciliación con una referencia autorizada, para ponerlo al descubierto.
Los equipos de operaciones pueden utilizar una guía práctica de control de calidad de los datos para organizar las comprobaciones en torno a la frescura, la exhaustividad, la coherencia y el cumplimiento de las normas. Pero supervisar el mecanismo de entrega no es lo mismo que demostrar que una métrica sigue significando lo que las partes interesadas creen que significa.
Una referencia interna útil es la explicación de digna sobre la fiabilidad de los datos, sobre todo cuando los equipos separan la entrega fiable de la corrección de la interpretación. La lección de producción es sencilla: el estado verde de un pipeline demuestra que el mecanismo se ha ejecutado. No demuestra que la métrica de decisión siga siendo válida.
Definición de confiabilidad y validez de los datos
La fiabilidad de los datos es la coherencia en condiciones repetibles. Si la misma fuente, método y condiciones producen resultados similares tras mediciones repetidas, la medición demuestra fiabilidad. En las plataformas de datos, esto significa que una tarea entrega los registros esperados, las transformaciones se comportan de forma coherente, los observadores coinciden en las clasificaciones y las métricas recurrentes no varían sin un cambio correspondiente en el proceso subyacente.
La fiabilidad está estrechamente ligada al error aleatorio. La estabilidad test-retest comprueba si los resultados persisten en ejecuciones sucesivas. La consistencia interna comprueba si los elementos relacionados se comportan de forma coherente. Los métodos de mitades partidas dividen un instrumento en partes para comparar la consistencia, mientras que los métodos interjueces examinan el acuerdo entre observadores. En el trabajo de repetibilidad en laboratorio, se suelen utilizar réplicas de observaciones, sirviendo unas 10 réplicas como referencia práctica en algunos entornos (debate metodológico sobre fiabilidad y validez).
La validez es la corrección del objetivo de medición. Un campo, una métrica o un conjunto de datos válidos representan la realidad o el constructo que pretenden representar. El valor puede tener un formato perfecto y producirse repetidamente, pero no ser válido si el campo tiene la unidad equivocada, la población equivocada, la etiqueta equivocada o la definición empresarial equivocada. La validez de los datos también incluye la conformidad con reglas, formatos y normas predefinidos (Definición de validez de datos de Acceldata).
Cuatro enfoques útiles de validez
Validez de contenido: ¿Incluye la métrica el conjunto completo de componentes empresariales que afirma cubrir? Una puntuación de salud del cliente que excluya las incidencias de soporte puede ser fiable, pero incompleta como medida de la salud del cliente.
Validez de constructo: ¿Capta la métrica el concepto previsto en lugar de un indicador conveniente? Una medida de "retención" basada únicamente en los inicios de sesión puede no representar el valor comercial retenido.
Validez de criterio: ¿Coincide el resultado con una norma conocida o con una referencia de confianza? Una conversión de divisas debe conciliarse con la fuente de tipos autorizada y su unidad definida.
Validez aparente: ¿Parece el campo medir lo que sugiere su nombre? Una columna llamada
active_customerpuede superar una revisión superficial mientras que su implementación cuenta las sesiones recientes en lugar de los contratos activos.
Un evento de desviación del esquema puede dañar la validez aparente cuando la estructura de un campo ya no coincide con su significado documentado. Un cambio de unidad puede dañar la validez de criterio cuando los valores ya no se alinean con la norma de referencia. Estos fallos pueden superar las comprobaciones de repetibilidad porque la misma lógica errónea se ejecuta de forma coherente.
El ejemplo clásico de medición deja clara la relación. Un termómetro que produce la misma lectura cada vez en agua hirviendo es fiable, pero si está calibrado para un contexto equivocado, la lectura no es válida. La fiabilidad es necesaria para obtener pruebas de validez significativas, pero la fiabilidad por sí sola no garantiza la validez. Para un tratamiento operativo más detallado, consulte la guía de digna sobre la validez de los datos.
Comparación frente a frente de ambos conceptos
Las definiciones sólo adquieren utilidad cuando modifican la forma en que un equipo diseña los controles. La fiabilidad y la validez deben evaluarse en función del error que corrigen, las pruebas que sustentan la conclusión, la alerta que aparece en producción y la capa en la que se origina el fallo.
Criterio | Confiabilidad de los datos | Validez de los datos |
|---|---|---|
Pregunta clave | ¿La medición sigue siendo coherente en condiciones repetidas? | ¿La medición representa la realidad o el constructo previstos? |
Principal error abordado | Error aleatorio y varianza inexplicada | Error sistemático, sesgo y mala interpretación semántica |
Pruebas de medición | Estabilidad test-retest, repetibilidad, reproducibilidad, consistencia interna, comprobaciones de mitades partidas y acuerdo interjueces | Comparación con un patrón de referencia, un criterio de referencia, una verdad conocida, una regla empresarial o una relación teórica esperada |
Señal del pipeline | Alerta de anomalía, falta de frescura, cambio de volumen, pico de nulos, fallo de entrega o resultado inconsistente del observador | Fallo en la prueba semántica, desajuste en la conciliación, conflicto de unidades, relación no válida o cambio de distribución con significado empresarial |
Capa de la pila | Transporte, ingesta, orquestación, almacenamiento y ejecución recurrente | Modelo semántico, lógica de transformación, definición de métricas, datos de referencia y capa empresarial |
Propietario típico | Equipo de plataforma de datos o de infraestructura | Ingeniería analítica, custodios de dominios y propietarios de productos de datos |
Qué significa el éxito | El sistema se comporta de forma predecible y entrega datos útiles en el plazo previsto | Los datos responden correctamente a la pregunta planteada |
Los métodos estadísticos no son intercambiables. La fiabilidad puede evaluarse mediante repetibilidad, reproducibilidad, estabilidad test-retest, consistencia interna o acuerdo interjueces. La validez se juzga más a menudo por la sensibilidad y la especificidad cuando existe un patrón de referencia, o por comparación con la verdad conocida y las relaciones esperadas (Statistics by Jim distingue precisión y coherencia de exactitud y corrección).
Compromisos de producción
Los controles también pueden interferir entre sí. Una transformación puede resultar más precisa semánticamente tras una normalización adicional, pero introducir más ramificaciones y hacer más difícil de reproducir la ejecución repetida. Una deduplicación agresiva puede hacer que el recuento de registros sea más estable, al tiempo que elimina eventos repetidos legítimos. Por lo tanto, una mejora de la fiabilidad puede reducir la validez si elimina casos extremos significativos.
Por eso los equipos deben tratar las dimensiones de calidad de los datos como categorías de pruebas independientes, no como etiquetas intercambiables. La Observability debe instrumentar el comportamiento del transporte y el significado empresarial de forma independiente. Una señal de salud del pipeline puede confirmar que los datos han llegado. No puede, por sí misma, confirmar que los datos que llegan sigan representando la entidad, unidad, denominador o proceso correctos.
Cómo se asignan los módulos de Observability a cada propiedad
Los módulos de Observability no son versiones redundantes del mismo radar. Cada uno ve una superficie de fallo diferente. La detección de anomalías y el control de la frescura suelen defender la fiabilidad porque identifican comportamientos inesperados en la entrega y patrones de datos repetidos. Los controles de Data Validation y esquema proporcionan pruebas más sólidas de validez cuando codifican lo que se supone que significan los datos y cómo se les permite cambiar.
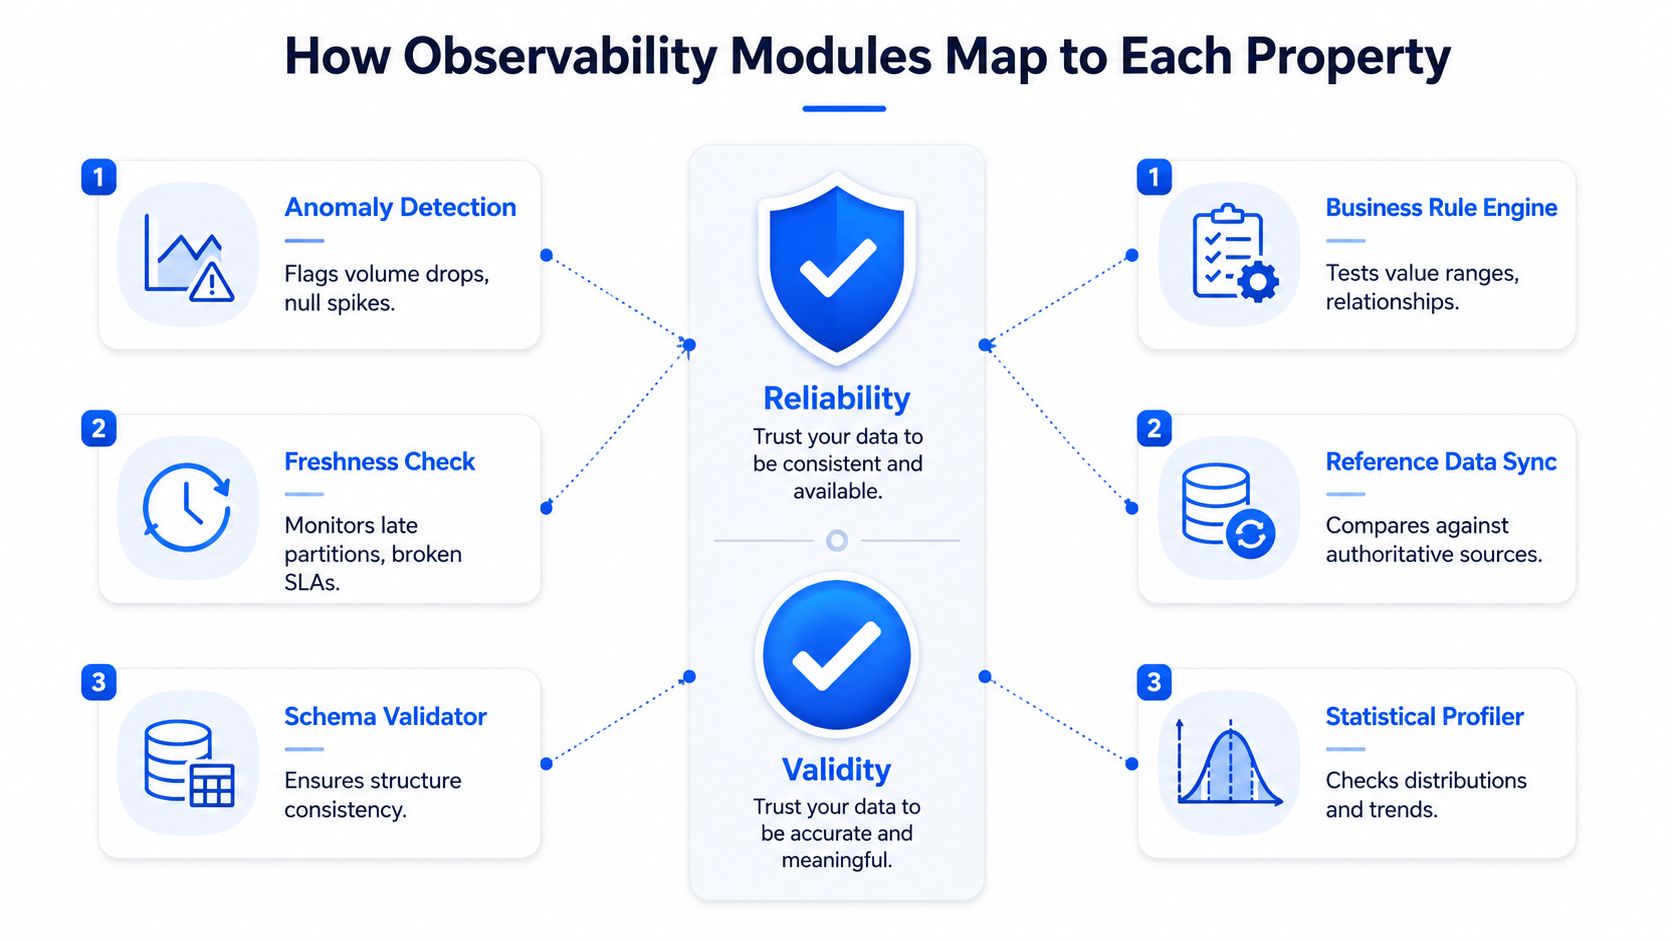
Detección de anomalías y frescura
La detección de anomalías puede advertir de una caída repentina del volumen, un pico de nulos inesperado o un cambio inusual en la distribución. Las comprobaciones de Timeliness supervisan las particiones retrasadas, las cargas que faltan y las expectativas de entrega incumplidas. Estos controles responden a una pregunta de fiabilidad: ¿llegaron los datos y se comportaron como lo hacen habitualmente?
Una interfaz de estado, como una interfaz de usuario de control de fiabilidad, puede hacer visibles estas condiciones operativas a los ingenieros y a las partes interesadas. Sin embargo, un estado de frescura limpio no detectará un valor que llega a tiempo con una unidad incorrecta. Un detector de anomalías puede pasar por alto una deriva semántica gradual cuando el nuevo comportamiento se convierte en la nueva línea de base.
Data Validation y esquema
Las comprobaciones de Data Validation codifican el significado empresarial. Pueden comprobar rangos de valores, relaciones referenciales, condiciones obligatorias, conciliaciones y reglas a nivel de registro. Estas comprobaciones son controles de validez cuando reflejan una definición aprobada del proceso.
La supervisión del esquema se sitúa entre ambas capas. Protege la fiabilidad al detectar cambios estructurales que pueden perjudicar a los consumidores, y respalda la validez al señalar un tipo de campo o un cambio de columna que pueda alterar la interpretación. La supervisión automatizada de esquemas puede identificar columnas añadidas o eliminadas y tipos de datos modificados antes de que fallen los sistemas posteriores (Monte Carlo describe el funcionamiento de la supervisión de cambios de esquemas).
Lo que permanece invisible
Las métricas de linaje y a nivel de columna exponen el contexto de fiabilidad y validez, pero no siempre generan la misma alerta. El linaje puede mostrar qué transformación ha cambiado un campo. No sabrá necesariamente si una unión ha introducido una población sesgada. El perfil de una columna puede mostrar el movimiento de la distribución. No determinará si el movimiento refleja un evento de negocio real o una definición de métrica no válida.
Un enfoque más amplio de Data Observability debería, por tanto, combinar cuatro campos superpuestos:
La supervisión de anomalías detecta comportamientos inesperados.
La supervisión de la frescura detecta fallos en los plazos de entrega.
La supervisión del esquema detecta cambios estructurales.
La supervisión de Data Validation comprueba la corrección semántica y empresarial.
Los espacios entre esos campos son aquellos en los que sobreviven las decisiones estables pero erróneas.
Escenarios del mundo real en los que uno falla sin el otro
Un equipo de finanzas puede conciliar los saldos de cierre cada noche y, aun así, publicar unos ingresos regionales erróneos. Supongamos que una nueva tabla de divisas invierte el sentido de la conversión. El pipeline se ejecuta según lo previsto, los saldos se concilian con la misma lógica defectuosa y la frescura se mantiene en verde. La señal de validez no se cuestiona porque ningún control compara los valores convertidos con la interpretación autorizada de los tipos.
La sanidad crea una división similar entre entrega y significado. Los recuentos de encuentros con pacientes llegan a tiempo, con un volumen estable y los campos esperados, pero un cambio de codificación reclasifica las visitas crónicas como agudas. Los controles de fiabilidad ven una transmisión de confianza. Una regla semántica de Data Validation vinculada a la norma de codificación o a la definición del KPI tendría más probabilidades de poner de manifiesto el cambio. Sin ella, la organización puede interpretar un cambio de clasificación como una variación en el rendimiento de los reingresos.
Los sistemas de telecomunicaciones demuestran cómo una agregación técnicamente exitosa puede, a pesar de todo, falsear la actividad. Los pipelines de registro de detalles de llamadas se ejecutan según lo previsto, pero un desfase horario en la tarea de agregación hace que las llamadas nocturnas se cuenten dos veces. Las comprobaciones de Timeliness, esquema y volumen básico pueden seguir siendo normales porque los registros están presentes y son estructuralmente correctos. Un control de validez de los límites de las ventanas temporales, la exclusividad de los eventos o la conciliación con un total de uso de confianza es el control que se dirige al defecto.
Los datos del sector público pueden superar las comprobaciones estructurales pero fallar en las de representación. Un extracto del censo coincide con el esquema, los tipos de columnas y el calendario de entrega esperados, pero una actualización del marco de muestreo subestima a los hogares rurales. Los registros son válidos en cuanto a formato y fiables en cuanto a llegada, pero la población representada por el extracto ya no coincide con la cobertura prevista. Una regla de exhaustividad limitada a campos no nulos no demostrará que el marco de muestreo subyacente siga siendo adecuado para su propósito.
Lo que oculta el cuadro de mando verde
Escenario | Señal de fiabilidad | Señal de validez | Consecuencia |
|---|---|---|---|
Finanzas | Entrega y conciliación estables | Desajuste en la interpretación de divisas | Ingresos regionales distorsionados |
Sanidad | Recuentos de encuentros puntuales | Cambio en el significado de la codificación | KPI de reingreso sesgado |
Telecomunicaciones | Procesamiento programado de CDR | Error de agregación de zona horaria | Llamadas nocturnas contabilizadas por duplicado |
Sector público | Coincidencia de esquema y calendario | El marco de cobertura subrepresenta a los hogares rurales | Estimación de población engañosa |
No se trata de ejemplos de pipelines rotos en el sentido estricto de la ingeniería. Son ejemplos de una ejecución correcta frente a una definición incorrecta. El cuadro de mando está en verde porque la plataforma mide la salud operativa, mientras que el negocio necesita pruebas sobre la exactitud de la representación.
Cómo elegir qué capa priorizar primero
Cuando la fiabilidad y la validez compiten por el presupuesto, los equipos no deben seguir automáticamente una secuencia de manual. Deben priorizar la capa en función del coste de los fallos, la detectabilidad y el perjuicio para las partes interesadas. Un conjunto de datos tardío que bloquea todos los informes posteriores exige una primera inversión diferente a la de un conjunto de datos que parece válido pero que alimenta la información regulada o las características del aprendizaje automático.
Empiece por la fiabilidad cuando el fallo en la entrega cree un perjuicio operativo inmediato. Esto incluye acuerdos de nivel de servicio incumplidos, particiones ausentes, reinicios manuales recurrentes y cuadros de mando a los que los usuarios no pueden acceder cuando lo necesitan. En esos entornos, los equipos de plataformas necesitan una orquestación fiable, expectativas de Timeliness, supervisión del volumen y una propiedad clara de las incidencias antes de que se puedan interpretar con confianza pruebas semánticas más profundas.
Empiece por la validez cuando el significado incorrecto pueda permanecer oculto. Los KPI críticos para los ingresos, los informes externos, las cargas de trabajo reguladas y los conjuntos de datos para el entrenamiento de modelos merecen controles semánticos tempranos porque los consumidores pueden no notar el defecto. Un número erróneo estable puede llegar más lejos que un trabajo visiblemente fallido.
Criterio | Favorecer primero la fiabilidad | Favorecer primero la validez |
|---|---|---|
Radio de impacto | Una carga fallida bloquea a muchos consumidores intermedios | Una definición errónea contamina informes, modelos o decisiones |
Exposición a auditorías | El tiempo de actividad operativo y las pruebas de entrega son la preocupación inmediata | La información regulatoria, financiera, clínica o pública depende de la corrección |
Tiempo para detectar | Los fallos se detectan rápidamente por la falta de datos o por la alteración de los calendarios | Los errores pueden seguir pareciendo plausibles y eludir la supervisión habitual |
Coste de los falsos positivos | Los equipos pueden tolerar las alertas operativas mientras estabilizan la entrega | Un exceso de alertas semánticas puede interrumpir los flujos de trabajo de confianza si no se tiene una propiedad clara |
Perjuicio para el usuario | Los analistas esperan a los datos o realizan una recuperación manual | Las partes interesadas actúan sobre un resultado que parece normal pero es erróneo |
Una regla de decisión práctica
Los equipos que realizan analítica por lotes para cuadros de mando internos suelen solucionar primero la fiabilidad porque las interrupciones en las entregas dominan el trabajo diario. Los equipos que envían características de modelos o publican métricas externas suelen solucionar primero la validez porque el principal riesgo es una representación errónea silenciosa.
No se trata de una clasificación por madurez. Es una decisión de asignación de riesgos. La primera capa de control debe dirigirse al fallo que las partes interesadas son menos capaces de detectar por sí mismas. Una vez que esa capa sea lo suficientemente estable como para producir señales interpretables, añada la otra capa en lugar de tratar la primera inversión como un sustituto de la misma.
Creación de un programa combinado de fiabilidad y validez
El modelo operativo más sólido consiste en tratar la fiabilidad y la validez como dos bucles de control dentro de una misma plataforma de datos, no como un único gran proyecto de calidad. Construya primero el bucle de fiabilidad allí donde la entrega sea inestable. Debe abarcar la salud del pipeline, las expectativas de Timeliness, el comportamiento del recuento de filas y los cambios estructurales. Las señales no válidas de un pipeline roto son difíciles de interpretar, por lo que los equipos necesitan una línea de base operativa de confianza.
A continuación, añada el bucle de validez. Defina reglas de negocio a nivel de registro, documente la semántica de las métricas, concilie los resultados críticos con los sistemas de fuentes de verdad y utilice auditorías de muestreo dirigidas allí donde las reglas automatizadas no puedan captar la totalidad del constructo. Los consejos sobre las reglas de Data Validation y la calidad continua de los datos resultan útiles para convertir los requisitos abstractos de corrección en controles repetibles.
Asignar la propiedad por tipo de fallo
El equipo de la plataforma debe ser el propietario de las señales de fiabilidad, tales como trabajos fallidos, entregas omitidas, comportamientos de volumen inesperados y eventos de esquema. La ingeniería analítica y los custodios de dominios deben ser los propietarios de la validez porque comprenden las definiciones de las métricas, los estándares de codificación, los datos de referencia y las consecuencias comerciales de la deriva semántica.
La canalización de incidencias debe reflejar esa división. Una infracción de la fiabilidad puede avisar al ingeniero de guardia cuando una carga se retrasa o se rompe un contrato intermedio. Una infracción de la validez debe dirigirse al propietario del producto de datos y al custodio del dominio cuando falla una regla de negocio, una conciliación se sale de su interpretación aceptada o cambia la definición de una métrica.
Capa de control | Qué cubre | Equipo propietario | Señal principal | Métrica de éxito |
|---|---|---|---|---|
Fiabilidad | Entrega, frescura, repetibilidad, volumen y estabilidad estructural | Equipo de la plataforma de datos | Alertas de pipeline, SLA, anomalías y esquemas | MTTR de incidencias y cumplimiento de SLA |
Validez | Significado empresarial, reglas, unidades, relaciones y alineación de referencias | Ingeniería analítica y custodios de dominios | Alertas de Data Validation, conciliación y semánticas | Tasa mensual de defectos de validez por conjunto de datos crítico |
Contexto compartido | Linaje, propiedad, documentación y pruebas de incidencias | Equipos de plataforma y de governance | Registros de trazabilidad y auditoría | Diagnóstico más rápido y rendición de cuentas más clara |
Una plataforma como digna puede ejecutar la detección de anomalías, la supervisión de la puntualidad, la Data Validation a nivel de registro y el seguimiento del esquema dentro del propio entorno del cliente, con comprobaciones ejecutadas en la base de datos para que los datos permanezcan en su sitio. Ese modelo se adapta a las organizaciones que necesitan supervisión operativa y controles semánticos en almacenes, lagos y pipelines sin tratar la privacidad, la auditabilidad y la salud de las entregas como productos independientes.
El programa debe demostrar su valor mediante pruebas operativas, no por el volumen del cuadro de mando. Realice un seguimiento del tiempo medio de resolución de incidencias, el cumplimiento de los niveles de servicio y la tasa mensual de defectos de validez de cada conjunto de datos crítico. Revise estas medidas tanto con los ingenieros como con los propietarios de los dominios, ya que un pipeline puede tener una salud operativa excelente mientras que una métrica empresarial deja de ser adecuada para su propósito.
digna ayuda a los equipos a supervisar el comportamiento de los datos, la puntualidad, los cambios de esquema, las anomalías y las reglas de negocio a nivel de registro dentro de su propio entorno. Visite digna para evaluar cómo encajarían los controles independientes de fiabilidad y validez en sus conjuntos de datos críticos.
Preguntas frecuentes
¿Qué diferencia hay entre fiabilidad y validez de datos?
La fiabilidad es consistencia bajo condiciones repetibles; la validez es corrección del objetivo de medición. Son capas de control distintas, y por eso una canalización puede ser perfectamente estable y aun así producir decisiones erróneas, mostrando totales idénticos en tres ejecuciones seguidas equivocadas del mismo modo.
¿Qué error aborda cada una?
La fiabilidad se vincula al error aleatorio, que genera variación entre ejecuciones. La validez aborda el error sistemático, que genera un sesgo estable. Esa es la razón por la que una cifra constante parece de fiar: la consistencia esconde el sesgo en vez de revelarlo.
¿Cuáles son las cuatro lentes de validez?
La validez de contenido pregunta si la métrica cubre todos los componentes de negocio que dice cubrir. La de constructo, si capta el concepto pretendido y no un sustituto cómodo. La de criterio, si coincide con una referencia de confianza. La aparente, si el campo mide lo que su nombre sugiere.
¿Cómo afecta la deriva de esquema a la validez?
Daña la validez aparente, porque la estructura de un campo deja de coincidir con su significado documentado. La columna sigue existiendo y poblándose, así que las comprobaciones de fiabilidad siguen en verde mientras el nombre del campo ha dejado de describir lo que ahora contiene.
¿Cómo se comprueba la fiabilidad en la práctica?
Repitiendo la medición en condiciones que no deberían alterar el resultado. En trabajos de repetibilidad de laboratorio unos 10 replicados sirven como referencia práctica, y el equivalente en datos es comparar ejecuciones repetidas del mismo cálculo antes de confundir estabilidad con corrección.


