Esquemas en Data Warehouse: Una guía completa de 2026
|
7
minuto de lectura

Conoces la sensación. Un panel se ve bien por la mañana, luego comienza una revisión ejecutiva y un gráfico de repente queda en blanco porque alguien cambió el nombre de una columna aguas arriba. El almacén de datos no "falló" en abstracto, se rompió un downstream Data Contract y nadie detectó el impacto con suficiente antelación.
Esa es la razón principal por la que los esquemas en los sistemas de almacén de datos son importantes. No son solo diseños de tablas, son la estructura que le dice a cada consumidor cómo leer el negocio de manera segura, ya sea que ese consumidor sea una herramienta de BI, una capa semántica o una canalización de ML. La definición más amplia de Oracle de un esquema como una colección de objetos de base de datos, que incluye tablas, vistas, índices y sinónimos, ayuda a separar el concepto general de base de datos del patrón de almacén dimensional que consultan los analistas (Oracle schema definition).
Tabla de contenidos
Lo que realmente significa un esquema en un almacén de datos
Comparación de esquemas en estrella, copo de nieve y galaxia
Prácticas de Observability que protegen la integridad del esquema
Lo que realmente significa un esquema en un almacén de datos
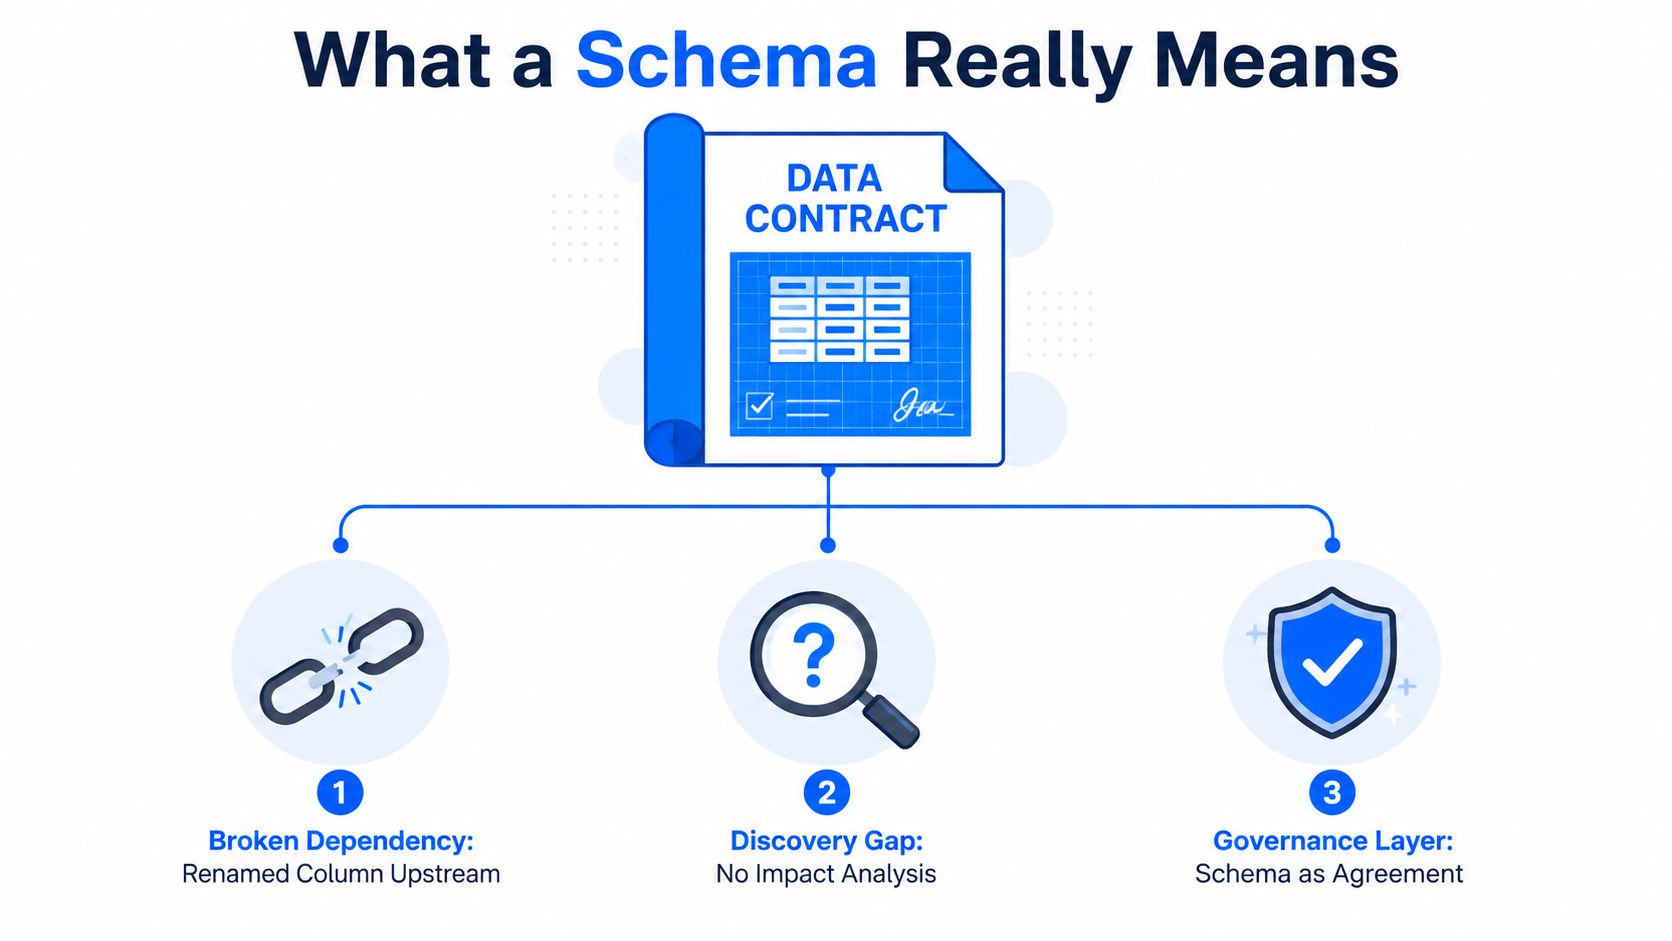
Un esquema de almacén es la forma de codificar el significado, no solo la forma de colocar las tablas. En la práctica, es la disposición lógica de tablas, claves, relaciones y restricciones que permite a un almacén responder a las preguntas de negocio de manera consistente, incluso cuando los sistemas de origen originales están desordenados. Por eso existen los esquemas de almacén dimensionales: convierten los datos operativos en un modelo semántico que admite la lectura analítica y mantiene el significado de negocio adjunto a cada fila.
El diseño de la tabla no es toda la historia
El esquema de un sistema transaccional y el esquema de un almacén resuelven problemas diferentes. El sistema de origen se preocupa por escrituras rápidas, una integridad estricta y actualizaciones diarias. El almacén se preocupa por las lecturas históricas, las uniones repetibles y los informes estables en muchas dimensiones. El esquema de un almacén se comporta como un contrato de interfaz, porque los analistas y las herramientas de BI dependen de que el significado de cada tabla y clave se mantenga lo suficientemente estable como para realizar consultas con confianza.
Esa distinción importa cuando se cambia el nombre de una columna o cambia una clave. Si el almacén trata el esquema como un contrato, los equipos pueden evaluar el impacto antes de lanzar un cambio. Si lo tratan como un diseño de tabla flexible, el BI aguas abajo se rompe primero y la governance se da cuenta más tarde. La misma idea se aplica a las características de ML y a las fuentes de ETL inverso, porque cualquier consumidor que lea del almacén depende de que la estructura siga siendo reconocible de una versión a otra.
Regla práctica: el esquema de un almacén debe indicar a los consumidores el significado de una fila antes de que escriban código SQL.
Por qué la definición de base de datos más amplia sigue siendo importante
La definición de Oracle es útil porque recuerda a los equipos que un esquema es una colección propia de objetos de base de datos, no solo un diagrama. En un almacén, ese conjunto de objetos más amplio puede incluir vistas, restricciones, índices y sinónimos junto con tablas dimensionales, lo que significa que el pensamiento del esquema debe incluir patrones de acceso y governance, no solo el estilo de modelado (Oracle schema definition).
Esa perspectiva más amplia es también lo que hace útil al seguimiento de esquemas. Si una tabla, vista o clave cambia de forma sin registrarse, los consumidores aguas abajo pueden perder la dependencia en la que confiaban, incluso cuando la consulta todavía se compila. Un esquema de Data Contract actúa como una capa de governance que hace visibles esas dependencias antes de que se rompan, y la infografía aquí muestra esa relación claramente An infographic showing that a data contract schema acts as a governance layer preventing broken data dependencies.
La forma más clara de pensarlo es la siguiente. Un esquema es el acuerdo del almacén sobre el significado, la estructura y el cambio. Cuando ese acuerdo se rastrea cuidadosamente, los analistas obtienen números consistentes, los paneles de BI siguen siendo legibles y los cambios de ingeniería pueden avanzar sin sorprender a las personas que dependen del almacén.
El Star Schema y la mentalidad de modelado dimensional
Un equipo de almacén de datos suele sentir la diferencia tan pronto como un modelo llega a los usuarios de BI. Las consultas se vuelven más simples, las uniones se vuelven predecibles y la conversación pasa de "¿dónde se almacena este campo?" a "¿qué evento de negocio describe esta fila?". El esquema en estrella es la expresión más clara del modelado dimensional porque mantiene visible esa respuesta. Una tabla de hechos central contiene el evento de negocio y las tablas de dimensiones circundantes proporcionan el contexto. La guía de MotherDuck describe el patrón claramente: cada fila de hechos representa un evento de negocio, mientras que las dimensiones responden a las preguntas de quién, qué, dónde, cuándo y por qué (MotherDuck star schema guide).
Comience desde el evento de negocio
El enfoque dimensional de Ralph Kimball sigue dando forma al diseño moderno de almacenes porque comienza con la pregunta que los ingenieros deben resolver primero: ¿qué significa una fila? La secuencia comienza con el proceso de negocio, luego el grano, luego las dimensiones y finalmente los hechos en ese grano. Ese orden evita que el equipo discuta sobre los nombres de las columnas antes de que el modelo tenga una unidad de análisis estable.
Un piso de almacén con un núcleo y varios radios es un modelo mental útil aquí. El núcleo es la tabla de hechos, los radios son las dimensiones y cada unión sigue un camino familiar. Los equipos de BI suelen encontrar esto más fácil de trabajar que una estructura normalizada porque el patrón de relación permanece visible y las medidas permanecen ancladas al evento que describen.
Medidas, hechos y contexto de cambio lento
Un hecho es el evento de negocio y, por lo general, lleva una o más medidas numéricas. La cantidad de ventas es aditiva, el saldo de la cuenta es semiaditivo porque depende del período que se inspeccione, y el precio unitario no es aditivo porque sumarlo generalmente no tiene sentido. El modelado dimensional clásico también tiene en cuenta las dimensiones de cambio lento, que es la forma en que un almacén preserva el historial cuando los atributos descriptivos como la ciudad del cliente o el gerente de la tienda cambian con el tiempo (Conceptual Design of Data Warehouses from ER Schemes)).
Un esquema en estrella funciona como un contrato de interfaz para la analítica. Define qué evento se está exponiendo, qué descriptores están disponibles y cómo deben manejarse los cambios para que los consumidores aguas abajo no tengan que adivinar. Por eso es importante tanto para el seguimiento de esquemas como para el modelado. Si un atributo de dimensión o clave cambia de forma sin registrarse, los informes de BI y las canalizaciones de características de ML pueden perder la dependencia sobre la que fueron construidos, incluso cuando el SQL todavía se compila.
Un esquema en estrella no es "tablas anchas por conveniencia". Es un modelo deliberado para un significado analítico estable.
El patrón sigue siendo popular porque se adapta a la agregación y el consumo. digna's star schema overview muestra la misma idea central en un diseño simple, y el formato de estrella mantiene las uniones fáciles de seguir para las consultas de BI sin pedir a los analistas que entiendan primero cada detalle operativo.
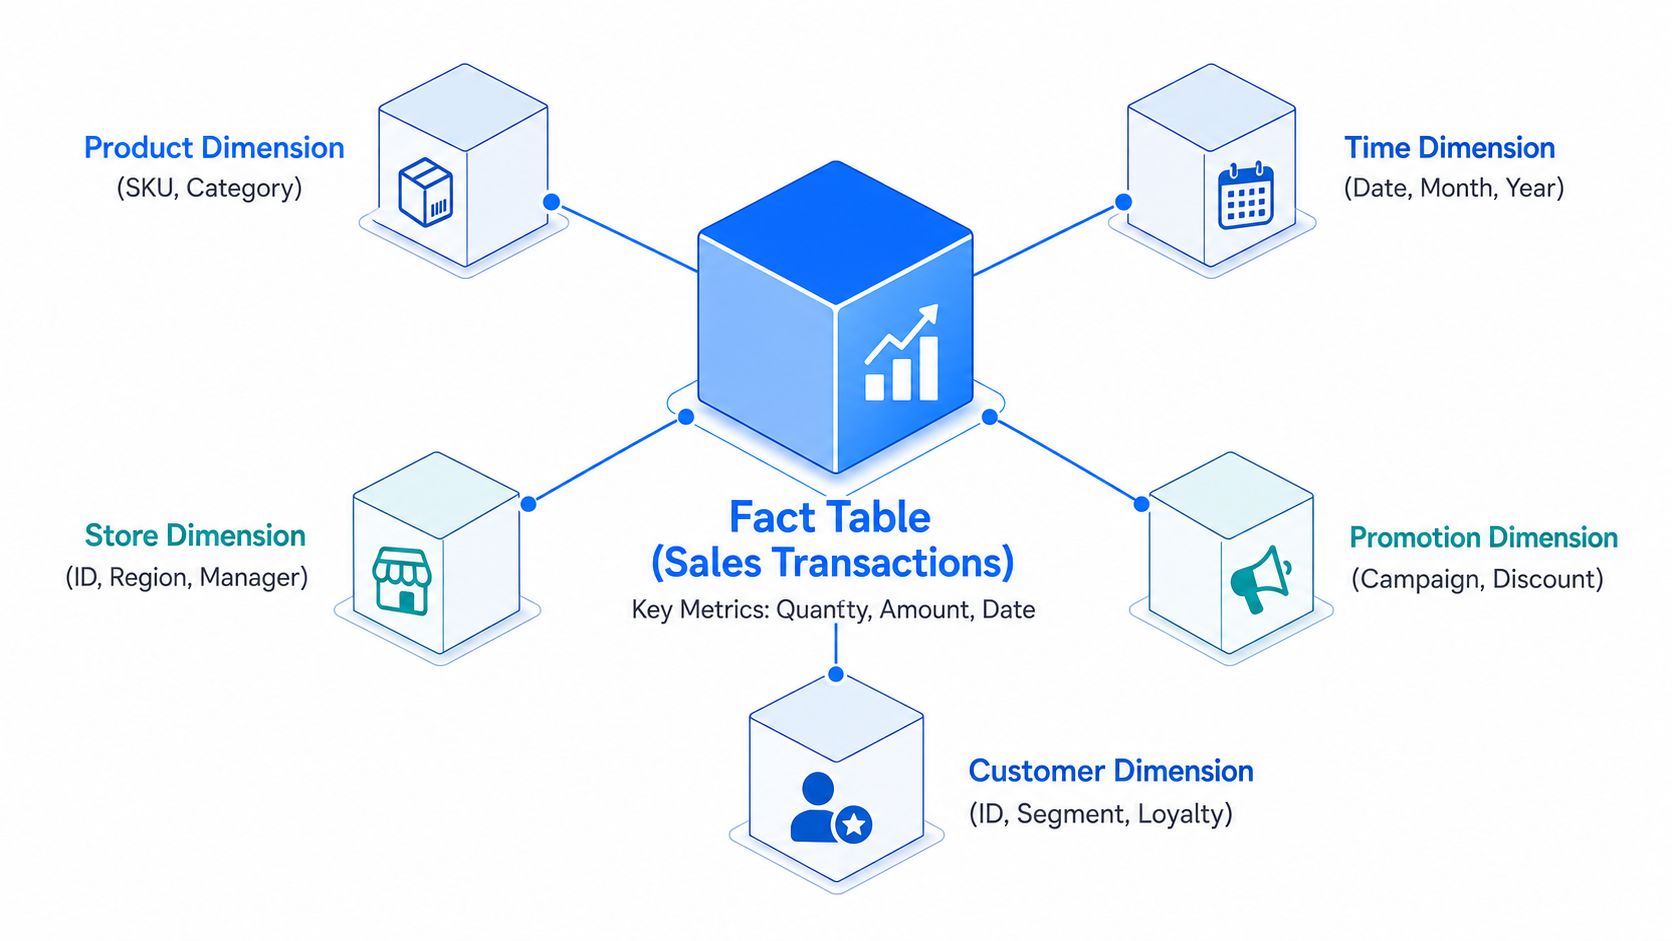
Comparación de esquemas en estrella, copo de nieve y galaxia
Un equipo de almacén de datos suele elegir entre estrella, copo de nieve y galaxia (también llamado constelación de hechos) cuando decide cuánta estructura exponer a los usuarios aguas abajo. La pregunta útil no es qué nombre suena más limpio. Es qué estructura se comporta como un contrato de interfaz estable para la carga de trabajo que tiene, con la menor sorpresa para los consumidores de BI y ML a medida que el modelo cambia con el tiempo (Exasol warehouse schema overview).
Use la carga de trabajo como diagnóstico
Comience con la forma del trabajo, no con el nombre. Un almacén con un dominio de negocio claro y muchos usuarios de paneles generalmente se adapta a un esquema en estrella porque la tabla de hechos central y sus dimensiones directamente vinculadas mantienen simple la ruta de consulta. Un almacén que comparte los mismos atributos descriptivos en varias tablas relacionadas puede adaptarse mejor a un esquema en copo de nieve, ya que la normalización adicional reduce el almacenamiento de atributos repetidos. Un almacén que necesita varias tablas de hechos para compartir dimensiones entre procesos de negocio apunta hacia el patrón de galaxia, donde la reutilización entre áreas temáticas importa más que mantener cada consulta lo más corta posible (Exasol warehouse schema overview).
Un diagnóstico rápido ayuda. Cuente las tablas de hechos y luego pregunte con qué frecuencia deben combinarse. Un dominio con repetidos análisis detallados generalmente apunta a estrella. Varios dominios con dimensiones compartidas apuntan hacia galaxia. Si el mantenimiento de dimensiones es el principal problema, el copo de nieve puede ayudar al separar los atributos cambiantes en tablas relacionadas, pero solo si las uniones añadidas no crean más fricción de la que eliminan.
Familia de Esquemas | Estructura | Compromiso Principal | Mejor Ajuste |
|---|---|---|---|
Estrella | Una tabla de hechos central con dimensiones vinculadas directamente | Simplicidad sobre normalización | BI e informes de un solo dominio |
Copo de nieve | Las dimensiones se dividen en subtablas relacionadas | Eficiencia de almacenamiento sobre simplicidad de consulta | Dimensiones que necesitan más mantenimiento estructural |
Galaxia | Múltiples tablas de hechos comparten dimensiones | Reutilización sobre simplicidad de modelado inicial | Almacenes empresariales que abarcan varios procesos de negocio |
Lo que le ofrece cada diseño
Un esquema en estrella mantiene el contrato fácil de leer. Los analistas pueden rastrear una métrica de regreso a la tabla de hechos y luego a las dimensiones sin tener que pasar por muchas uniones, razón por la cual sigue siendo común en los almacenes orientados a BI. Un esquema en copo de nieve mantiene más separada la jerarquía de dimensiones, por lo que el modelo puede reflejar más de cerca la estructura de origen y hacer que algunas tareas de mantenimiento sean más limpias. El costo es la complejidad de la consulta, ya que cada tabla adicional agrega otro punto de unión que el consumidor debe comprender.
Los esquemas en galaxia resuelven un problema diferente. Ayudan cuando una empresa desea que las mismas definiciones de dimensiones admitan más de un proceso analítico, como ventas, inventario y logística. En ese escenario, el modelo se trata menos de conveniencia y más de mantener las métricas alineadas entre equipos y herramientas. Para una comparación compacta de las formas de estrella y copo de nieve, use digna's star and snowflake schema guide.
La elección suele ser un compromiso entre la simplicidad de la consulta, el significado compartido y el mantenimiento. Si los analistas necesitan SQL repetible con una lógica de unión mínima, la estrella suele ser el ajuste más limpio. Si las dimensiones compartidas cambian a menudo y el equipo del almacén desea mantener la estructura más cercana al origen, el copo de nieve puede reducir la duplicación. Si varias tablas de hechos deben mantener la coherencia en todas las áreas de negocio, la galaxia proporciona esa base compartida sin obligar a cada equipo a crear su propia versión del mismo modelo de dimensión.
Schema-on-Write y Schema-on-Read en almacenes modernos
El esquema de un almacén no es solo un diseño de tabla. Es el contrato que le dice a cada consumidor aguas abajo qué forma tendrán los datos, y ese contrato puede aplicarse antes de que los datos aterricen o interpretarse más tarde en el momento de la consulta. Schema-on-write aplica las reglas por adelantado, mientras que schema-on-read permite que la estructura se aplique cuando se consulta la información. Databricks describe los sistemas de tipo almacén como el lugar para analíticas estructuradas y gobernadas, mientras que los sistemas de tipo lago aplican el esquema en el momento de la lectura y los diseños de lakehouse intentan unir ambos enfoques (Databricks data warehouse types).
Dónde ocurre la aplicación
Los sistemas Schema-on-write definen la forma de la tabla antes de que comience la ingesta. Se verifican los tipos de datos, los registros que no se ajustan se rechazan temprano y los analistas consultan información que ya ha sido moldeada para un uso conocido. Eso se adapta a los equipos que se preocupan más por la coherencia, la auditabilidad y los informes repetibles que por preservar exactamente cada carga útil sin procesar tal como llegó.
Schema-on-read sigue un camino diferente. Los datos sin procesar se almacenan primero y el motor de consultas interpreta la estructura solo cuando alguien la solicita. Eso lo hace útil para la exploración, el trabajo en entornos de prueba (sandboxes) y algunos flujos de trabajo de ML, especialmente cuando el equipo aún está aprendiendo qué contienen los datos.
El compromiso es sencillo. Schema-on-write ofrece predictibilidad. Schema-on-read ofrece flexibilidad. La mayoría de las plataformas empresariales utilizan ambos, con una capa de almacén curada para informes gobernados y una capa sin procesar o de sandbox para la experimentación y la ingeniería de características.
Por qué la mayoría de los equipos terminan con ambos
El patrón lakehouse existe porque ningún extremo cubre todas las necesidades. Databricks describe las arquitecturas de lakehouse modernas como la combinación de una gobernanza de tipo almacén con la flexibilidad de tipo lago, lo que se adapta a los equipos que necesitan un historial sin procesar y datamarts confiables en la misma plataforma más amplia.
El BI gobernado pertenece al lado donde se aplica el contrato. La exploración pertenece al lado flexible.
Esa división mantiene el almacén analítico confiable al tiempo que brinda a los científicos de datos acceso a las entradas sin procesar. También evita que la capa semántica absorba cada tabla experimental que aterriza en la plataforma. Si una carga de trabajo respalda los informes ejecutivos, schema-on-write suele ser la opción predeterminada más segura. Si se trata de encontrar patrones o crear características a partir de eventos sin procesar, schema-on-read suele ser la mejor opción.
La elección del esquema también afecta a la observability. Un contrato solo es útil si los equipos pueden ver cuándo cambia, comparar la forma antigua con la nueva y advertir a los consumidores aguas abajo antes de que se rompan los paneles o los modelos. Ahí es donde el seguimiento de esquemas y las comprobaciones relacionadas importan, porque convierten el diseño de esquemas en algo que las operaciones pueden monitorear en lugar de algo que los desarrolladores solo descubren después de una consulta fallida.
Para los equipos que buscan strategies for IT project change más amplias, la lección es la misma. El esquema tiene que cambiar de manera controlada, con visibilidad para las personas y los sistemas que dependen de él.
Evolución del esquema y gestión segura del cambio
El esquema de almacén más fuerte no es el que parecía más simple el primer día. Es el que puede cambiar de manera predecible sin romper a las personas y los sistemas que dependen de él. Eso significa pensar en el esquema como un contrato de interfaz, no solo como una estructura de almacenamiento. El contrato es consumido por paneles, capas semánticas y canalizaciones automatizadas, y esos consumidores pueden fallar sin previo aviso cuando cambia la forma.
Cambios disruptivos y no disruptivos
Algunos cambios son fáciles de absorber. Agregar una columna que admita valores nulos, agregar una nueva tabla o extender una vista a menudo puede ocurrir sin alterar a los consumidores existentes. Otros cambios son peligrosos. Cambiar el nombre de una columna, eliminar un campo o restringir un tipo de datos puede romper una consulta que funcionaba ayer y que hoy todavía se compila.
Es por eso que la gestión segura del cambio comienza con la compatibilidad, no con la conveniencia. Si un informe aguas abajo espera un campo llamado customer_id, cambiarle el nombre a client_id sin una capa de compatibilidad convierte un cambio de metadatos en un incidente de producción. La mecánica del cambio importa menos que el impacto en los consumidores.
Patrones que reducen el radio de impacto
Los equipos suelen mantener bajo el riesgo de cambio con un pequeño conjunto de patrones. El uso de alias de columnas puede preservar los nombres antiguos mientras se introducen otros nuevos. Las capas de compatibilidad basadas en vistas pueden presentar una interfaz estable mientras evoluciona la tabla subyacente. Las escrituras duales y los sufijos de tablas versionadas pueden dar tiempo a los consumidores para migrar sin forzar una transición brusca. Cada patrón gana tiempo, y el tiempo es lo que evita que el almacén se vuelva frágil.
Para los equipos que trabajan con una disciplina de cambio más amplia, las strategies for IT project change pueden ser un marco de trabajo útil, porque la evolución del almacén a menudo falla por la misma razón por la que fallan los cambios de plataforma en general: una propiedad poco clara y una comunicación débil.
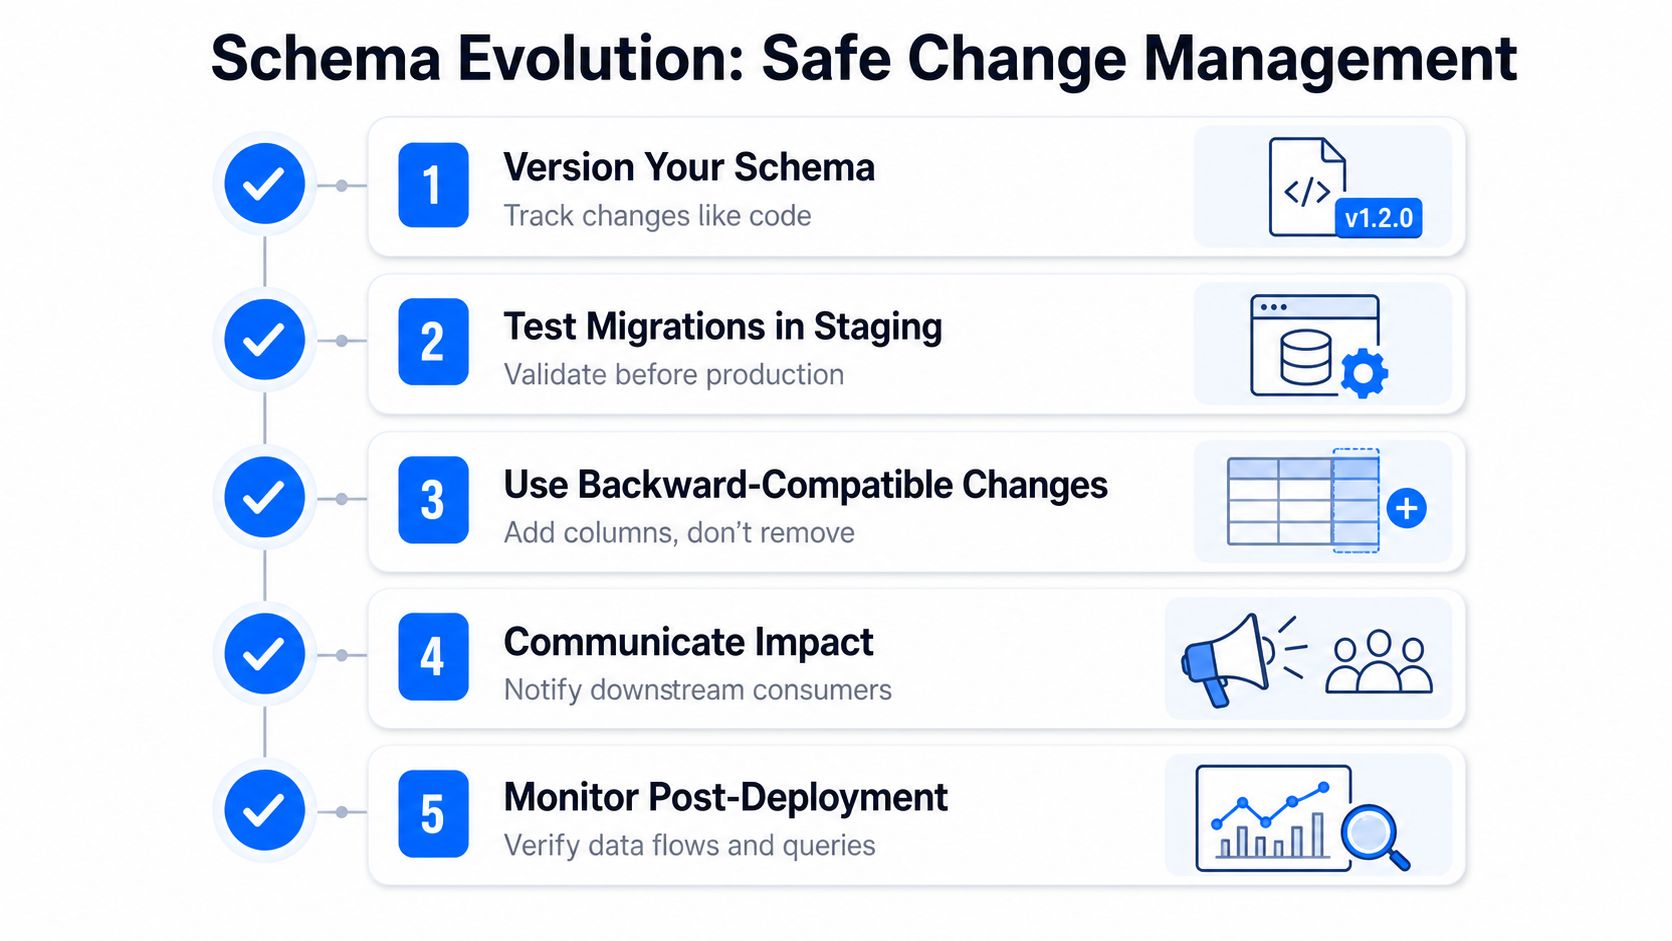
Una lista de verificación práctica para la migración
Versione el esquema: Realice un seguimiento de los cambios como si fuera código, para que pueda explicar qué cambió y cuándo.
Realice pruebas de migración primero: Valide la nueva forma antes de que la vean los consumidores de producción.
Prefiera cambios compatibles con versiones anteriores: Agregue antes de eliminar.
Comunique el impacto: Informe a los propietarios de BI, ingeniería de analíticas y ML sobre lo que se romperá.
Monitoree después del despliegue: Confirme que las consultas, cargas y paneles sigan comportándose como se espera.
Ese es el cambio mental que necesitan los equipos modernos. El diseño de esquemas es un trabajo de ciclo de vida, no un trabajo de diagramas. Si el modelo no puede evolucionar de manera segura, su elegancia inicial no lo salvará más adelante.
Prácticas de Observability que protegen la integridad del esquema
Un informe financiero que devuelve ceros dos días después de un despliegue es un clásico fallo silencioso. Los trabajos de carga se completaron con éxito, nadie recibió alertas en la ingesta y el único síntoma visible apareció mucho más tarde, cuando un usuario de negocio confió en el número. Ese tipo de desviación es exactamente la razón por la que la integridad del esquema debe monitorearse, no asumirse.
Esté atento al modo de fallo, no solo a la canalización
Un cambio de esquema puede parecer inofensivo desde el punto de vista del sistema de origen. Una cadena se convierte en un entero, una columna se mueve o un campo desaparece de un entorno y aparece en otro. El almacén de datos sigue cargándose, pero el significado ya no coincide con lo que esperan los consumidores aguas abajo.
Ahí es donde el seguimiento de esquemas se gana su lugar. El Schema Tracker de digna monitorea continuamente la estructura de las tablas y detecta cambios como columnas agregadas o eliminadas y modificaciones de tipos de datos. Es útil porque detecta la desviación estructural antes de que los usuarios de BI la descubran en un ciclo de revisión. digna también admite la comparación de esquemas entre entornos, lo que ayuda a los equipos a comparar los entornos de Desarrollo, Pruebas y Producción antes de que un Release se ponga en marcha.
Asigne cada práctica de observability a un riesgo diferente
La detección continua de esquemas maneja la desviación estructural. El monitoreo de Timeliness detecta cargas faltantes o retrasadas. La validación a nivel de registro verifica las reglas de negocio, de modo que un registro técnicamente válido que viola la lógica esperada sigue siendo marcado. La detección de anomalías impulsada por IA agrega otra capa al observar el comportamiento de los datos, no solo los metadatos, lo que ayuda a los equipos a notar cuando una métrica se mueve de una manera inesperada, incluso si el esquema no cambió.
Estas prácticas funcionan juntas. El seguimiento de esquemas le indica que la estructura cambió. La Timeliness le indica que los datos no llegaron cuando se esperaba. La validación le indica que el registro es incorrecto según las reglas de negocio. La detección de anomalías le indica que el comportamiento parece inusual incluso cuando la fila técnicamente existe.
El almacén de datos no garantiza la confianza por sí mismo. La confianza proviene de vigilar el almacén de datos como si fuera una dependencia de producción.
Si desea un punto de referencia concreto para esta mentalidad, las digna's observability best practices muestran cómo el seguimiento de esquemas, la validación, la Timeliness y el monitoreo de anomalías encajan en un solo modelo operativo.
Don't stop at the alert
El punto no es recopilar más alertas. Es reducir el tiempo entre la desviación y el descubrimiento. Es por eso que la observability tiene que estar vinculada a la propiedad, el escalado y una ruta de reversión conocida. Para los equipos en entornos regulados, esto es especialmente importante. Si está pensando en el manejo seguro de datos operativos en otro contexto, la WhisperAI guide on secure transcription es un buen ejemplo de cómo los flujos de trabajo estrechamente gobernados dependen de controles de datos confiables.
Lista de verificación y recomendaciones para empresas
Los equipos de TI empresariales deben tratar el trabajo con esquemas como una disciplina de governance, no como una preferencia de modelado. Comience con un proceso de negocio claro, declare el grano, elija las dimensiones y defina los hechos en ese grano. Luego decida cómo preservará la compatibilidad, cómo monitoreará la desviación y quién será el propietario de cada cambio de esquema cuando el almacén de datos evolucione.
Una lista de verificación empresarial de trabajo
Fase de diseño: Comience con un esquema en estrella a menos que la carga de trabajo exija claramente la normalización o dimensiones compartidas.
Disciplina de modelado: Declare el grano temprano y documente la estrategia de dimensión de cambio lento para cada atributo descriptivo que pueda cambiar.
Implementación: Utilice contratos de datos, migraciones idempotentes y control de versiones para los cambios de esquema.
Control operativo: Realice un seguimiento de los esquemas, valide los registros, monitoree la Timeliness y detecte anomalías en la misma vista operativa.
Governance: Mantenga el historial de cambios, el análisis de impacto y el mapeo de Compliance adjuntos a las tablas críticas.
Para industrias reguladas, el esquema en sí se convierte en evidencia. Los equipos de servicios financieros, atención médica, telecomunicaciones y del sector público necesitan saber qué cambió, cuándo cambió y qué sistemas aguas abajo lo vieron. Eso significa que el almacén de datos no es solo un activo para la elaboración de informes, es parte de la pista de auditoría.
Qué estandarizar primero
El primer estándar debe ser la compatibilidad. El segundo debe ser la visibilidad. Un esquema que cambia sin una ruta de revisión eventualmente romperá la confianza, incluso si el rendimiento de las consultas parece correcto. Un esquema que es observable, versionado y documentado puede evolucionar sin convertir cada Release en una apuesta.
Comience de forma sencilla, luego planifique el cambio como si el almacén de datos fuera a consumirse durante años, porque así será.
digna proporciona capacidades empresariales de calidad de datos y de observability de datos que rastrean los cambios de esquema, validan registros, monitorean la Timeliness y detectan anomalías dentro del entorno del cliente. Si está construyendo un almacén donde el BI, el ML y la governance dependen de contratos estables, visite digna para ver cómo este enfoque se adapta a su infraestructura tecnológica.



