10 ejemplos de políticas de gobernanza de datos
|
12
minuto de lectura

Un documento de política puede existir mientras sus datos siguen, en la práctica, sin gobierno. Datos de encuestas del sector indican que solo el 23 % de las organizaciones usa marcos formales de gobernanza o calidad de datos, que el 55 % no mantiene de forma continua un inventario de datos sensibles, que el 70 % carece de una estrategia unificada que conecte la visibilidad de datos e identidad y que solo el 39 % puede clasificar todos sus datos. Estos hallazgos muestran por qué una lista de títulos de políticas no basta. Una política útil traduce un principio en un control observable, asigna una persona que lo opere, registra evidencia y define qué ocurre cuando el control falla. Resultados de encuesta sobre la adopción de gobernanza de datos
Los diez ejemplos de políticas de gobernanza de datos que siguen están escritos como plantillas operativas, no como definiciones estáticas. Cada uno conecta un objetivo de control con su responsable, su disparador, su evidencia, su vía de escalado y un resultado medible. Los ejemplos se aplican a servicios financieros, sanidad, telecomunicaciones y administración pública, pero la misma lógica sirve para conjuntos de datos críticos, reporting regulado, pipelines analíticos y sistemas de IA.
Una política debe reflejar además el contexto legal de la organización. El Reglamento europeo de gobernanza de datos fue adoptado por el Parlamento Europeo el 6 de abril de 2022, entró en vigor el 23 de junio de 2022 y resultó aplicable el 24 de septiembre de 2023 tras un periodo transitorio de 15 meses, creando un marco jurídico para la reutilización de datos, los intermediarios y el altruismo de datos en los mercados de la UE. Calendario e implicaciones del Reglamento europeo de gobernanza de datos Esa progresión ilustra la presión práctica sobre las empresas para pasar del diseño de políticas a controles exigibles, sobre todo cuando los datos cruzan jurisdicciones.
Índice de contenidos
2. Política de detección de anomalías y aprendizaje de línea base
4. Política de detección de cambios de esquema y gobernanza estructural
5. Política de propiedad de datos y responsabilidad de stewardship
6. Política de monitorización de métricas de negocio y fiabilidad de KPI
10. Política de mejora continua y métricas de gobernanza de datos
1. Política de estándares de calidad de datos y validación
Una política de calidad de datos define la condición mínima que debe cumplir un registro antes de que los sistemas aguas abajo lo traten como utilizable. Su objetivo de control es la adecuación al propósito, no una perfección abstracta. Un registro de transacción puede necesitar un importe válido, una parte identificable y los campos regulatorios exigidos. Un registro clínico puede requerir mediciones e identificadores internamente coherentes. Una cuenta de telecomunicaciones puede necesitar atributos de facturación y cliente coherentes antes de ejecutar el reporting de ingresos.
El propietario de los datos aprueba el significado de negocio de cada regla. Un data steward mantiene el registro de reglas, mientras los ingenieros de datos implementan las comprobaciones en el pipeline o la base de datos correspondiente. El disparador es una carga programada, un evento de ingesta o un traspaso dentro del proceso de negocio. La evidencia debe incluir la definición de la regla, su justificación de negocio, la marca temporal de ejecución, los registros afectados, los resultados de aprobado y fallo, el estado de remediación y el historial de aprobación.
Regla práctica: Una regla de validación solo es gobernable cuando alguien puede explicar por qué existe, qué comprueba y quién actúa cuando falla.
La validación determinista es distinta de la monitorización del comportamiento. Una regla como «el importe de la transacción debe existir y ser numérico» produce un resultado repetible. Un monitor de anomalías, en cambio, evalúa si el comportamiento se ha apartado de un patrón esperado. Ambos pertenecen a un programa de calidad, pero responden preguntas distintas.
Cómo implementarla
Empiece por los conjuntos de datos que soportan el mayor riesgo de negocio, regulatorio u operativo. Pida a ingenieros de datos, analistas y responsables de negocio que definan las reglas juntos y documente la justificación para que quienes las mantengan después entiendan el control previsto.
Responsable: Un propietario de datos de negocio aprueba umbrales y excepciones.
Disparador: Cada carga relevante o evento de procesamiento a nivel de registro.
Evidencia: Versiones de reglas, registros de ejecución, registros fallidos, notas de remediación y aprobación.
Escalado: El steward investiga primero y luego dirige los casos no resueltos al propietario y a los consumidores afectados.
Resultado: Los conjuntos críticos tienen cobertura de validación visible y una respuesta documentada ante los fallos.
Los equipos pueden usar los estándares de calidad de datos de digna y su módulo de validación a nivel de registro para exigir comprobaciones de negocio deterministas sin depender de la revisión manual. Las reglas deben revisarse trimestral o semestralmente, en especial tras cambios en productos, obligaciones de reporting o sistemas de origen. Para más contexto, consulte la guía de estándares de calidad de datos de AutoProv.
2. Política de detección de anomalías y aprendizaje de línea base
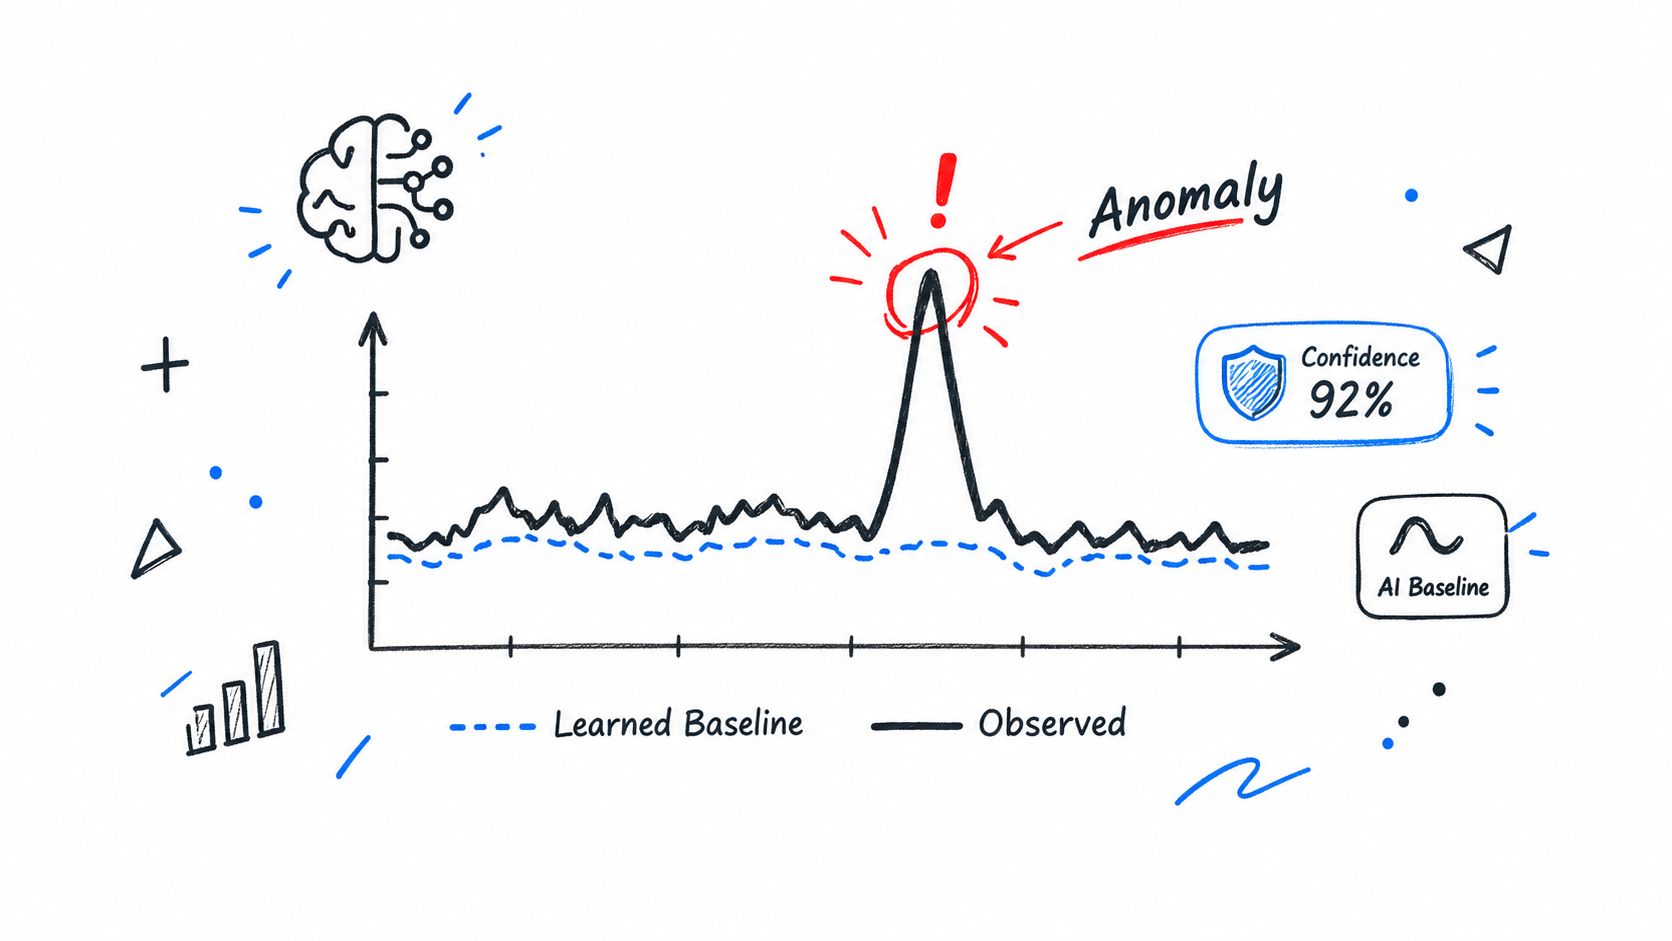
Un conjunto de datos puede satisfacer todas las reglas estáticas de validación y aun así volverse poco fiable cuando su comportamiento cambia. Una política de detección de anomalías controla ese hueco definiendo qué patrones vigilar, cómo se aprende el comportamiento normal, quién investiga las desviaciones y qué evidencia respalda la decisión final.
El responsable de la monitorización selecciona el conjunto de datos, el contexto de negocio y las dimensiones vigiladas. Un científico de datos o ingeniero de plataforma configura el aprendizaje de la línea base. El data steward registra las anomalías confirmadas, sus causas y su disposición. Los disparadores pueden incluir cambios de volumen, distribución, frecuencia u otro comportamiento definido.
El control debe separar una señal estadística de un incidente confirmado. Los equipos de servicios financieros pueden investigar volúmenes de negociación inusuales o patrones relacionados con fraude. Los equipos sanitarios podrían examinar cambios inesperados en ingresos hospitalarios o en distribuciones de mediciones clínicas. Los organismos públicos podrían revisar distribuciones anómalas de prestaciones o actividad de presentación. Estos casos requieren contexto antes de que una alerta se convierta en incidente operativo.
La monitorización del comportamiento identifica la desviación. La revisión humana determina si esa desviación es un defecto, un evento de negocio legítimo o un riesgo emergente.
Controles para la monitorización del comportamiento
Deje que el modelo aprenda el comportamiento histórico antes de que las alertas pasen a ser operativas. El diseño de implementación especifica un periodo de aprendizaje de 2 a 4 semanas, para que los ciclos ordinarios y los patrones recurrentes moldeen la línea base. Esa duración pertenece al diseño de implementación de esta política, no a un benchmark general del sector.
Responsable: El responsable de la monitorización asigna la tarea de triaje y el SLA de respuesta.
Disparador: Una desviación definida en volumen, distribución, frecuencia u otra dimensión vigilada.
Evidencia: Conserve el periodo de línea base, la ventana de comparación, el detalle de la alerta, la severidad, las notas de investigación, la causa raíz, la disposición y la remediación.
Bucle de aprendizaje: Registre anomalías confirmadas y falsos positivos para poder ajustar el modelo y los umbrales.
Escalado: Dirija las anomalías de alto impacto o no resueltas al propietario de los datos y al proceso de respuesta a incidentes.
Resultado: Los analistas distinguen la variación esperada de los defectos de datos, lo que mejora la confianza en el reporting y en las entradas de IA.
Los equipos pueden usar la detección de anomalías de digna para flujos de trabajo en Python como apoyo al aprendizaje de línea base y la monitorización continua. Su capacidad analítica también ayuda a examinar patrones históricos de anomalías en lugar de tratar cada alerta como un evento aislado.
La implementación debe avanzar en orden: seleccionar conjuntos de alto riesgo, definir el comportamiento vigilado, establecer el periodo de aprendizaje, probar la severidad de las alertas, asignar la responsabilidad de triaje y después revisar los casos confirmados. La política debe revisarse cuando cambien los procesos de negocio o el comportamiento de los datos.
3. Política de Timeliness y monitorización de entregas
Un conjunto de datos puntual es una dependencia operativa, no solo un atributo de calidad. Un feed puede contener valores exactos y aun así perder la ventana de decisión del cierre diario, la generación de facturas, las operaciones clínicas del mismo día o el reporting regulatorio. La política debe convertir «suficientemente fresco» en una expectativa de entrega acordada, un disparador observable y una respuesta definida.
Empiece por la necesidad del consumidor. Finanzas, operaciones, reporting y responsables clínicos pueden usar la misma tabla en momentos distintos del día, así que el productor de datos posee la ejecución de la entrega mientras el consumidor define la ventana requerida. El equipo de plataforma investiga los fallos de orquestación, infraestructura y dependencias.
Registre el consumidor, el caso de uso, la ventana de entrega aceptada y la consecuencia del retraso. Un disparador válido puede ser una llegada perdida, una carga temprana que rompe supuestos aguas abajo o una entrega fuera de la ventana de servicio acordada. El paquete de evidencia debe conservar horas de llegada esperada y real, el historial de entregas, el estado del pipeline, la información de dependencias, los registros de incidentes y la decisión sobre si se incumplió el SLA.
Haga observables las expectativas de entrega
Los calendarios aprendidos por IA pueden identificar el comportamiento normal de entrega sin obligar a los ingenieros a mantener frágiles ventanas horarias manuales. La guía de digna sobre definiciones y métricas de Timeliness explica cómo vigilar llegadas ausentes, tardías y tempranas y calcular la hora de entrega esperada.
Implemente el control en este orden:
Defina el plazo del consumidor y la consecuencia del retraso.
Establezca el comportamiento de entrega esperado a partir del historial observado.
Configure una alerta cuando pase la llegada prevista sin los datos esperados o cuando cambie el comportamiento de entrega.
Asigne al productor como primer punto de escalado.
Dirija las amenazas al plazo al responsable de la plataforma y al consumidor de negocio.
Conserve hora esperada, hora real, duración del retraso, estado de dependencias y respuesta del responsable.
El resultado es claridad diagnóstica. Los equipos pueden separar un origen tardío de un pipeline fallido o de un problema de infraestructura aguas abajo, en lugar de tratar cada entrega perdida como el mismo incidente.
Revise las tendencias de Timeliness cada mes. Un retraso recurrente puede señalar un problema de proceso, mientras que un feed fiable puede haber dejado de satisfacer las necesidades de un consumidor recién incorporado. Esos hallazgos deben actualizar la ventana de entrega, la propiedad o la regla de escalado.
4. Política de detección de cambios de esquema y gobernanza estructural
Un cambio de esquema puede invalidar salidas de confianza antes de que una comprobación a nivel de valor detecte nada. Eliminar una columna, cambiar un tipo de dato o alterar una restricción puede romper un informe, un modelo o una transformación ya en la ingesta. Por eso esta política gobierna la visibilidad e impacto del cambio estructural, con comparación determinista frente a una línea base de esquema aprobada.
El control empieza con un esquema registrado y un propietario del esquema nombrado. La detección automática compara cada versión desplegada con esa línea base y registra altas, bajas, cambios de tipo y cambios de restricciones. El disparador es cualquier desviación estructural no aprobada. Un revisor de cambios evalúa a los consumidores afectados, mientras los ingenieros de plataforma gestionan despliegue, notificación y rollback.
La evidencia debe hacer auditable la decisión:
Esquema antes y después y marca temporal de detección.
Solicitud de cambio, justificación y nivel de riesgo.
Evaluación de impacto y linaje afectado.
Aprobación, resultado del despliegue y decisión de rollback.
Una entidad financiera podría detectar un campo eliminado que se usa en cálculos regulatorios. Una organización sanitaria podría interceptar un cambio de tipo en una medición clínica antes de que llegue al soporte a la decisión. Un organismo público puede necesitar alinear sistemas de auditoría cuando cambia la estructura de un conjunto de datos público. En todos los casos, el resultado medible es una detección más temprana y menos fallos silenciosos en reporting, analítica o pipelines de IA.
Convierta la detección en una revisión proporcionada
Los consumidores conocidos aguas abajo deben recibir aviso antes del impacto en producción. Ese requisito depende del linaje actual, así que la política debe comprobar si el mapa de impacto está completo antes de aprobar. Un comité de revisión puede aprobar, rechazar o posponer un cambio, mientras los niveles de riesgo evitan que la evolución de bajo impacto cree un cuello de botella manual.
Responsable: Propietario del conjunto de datos o del dominio.
Disparador: Desviación estructural respecto al esquema registrado.
Evidencia: Diff de esquema, justificación, aprobaciones, mapa de impacto y registro del despliegue.
Escalado: Envíe los cambios no aprobados o de alto impacto al comité de revisión y al proceso de incidentes.
Resultado: Los consumidores reciben un aviso accionable antes de que la deriva estructural se convierta en un fallo silencioso.
La explicación de digna sobre la deriva de esquema y el cambio estructural describe la monitorización estructural continua para este control. Su Schema Tracker establece una línea base de altas, bajas y cambios de tipo de dato, y ayuda a los equipos a bloquear o revisar cambios antes de que lleguen a los consumidores.

5. Política de propiedad de datos y responsabilidad de stewardship
La propiedad es un control operativo, no una etiqueta en un catálogo. La política asigna la responsabilidad sobre calidad, puntualidad, expectativas de acceso, definiciones y resolución de incidencias en los conjuntos críticos. También debe mostrar quién puede decidir, quién ejecuta el trabajo y qué evidencia demuestra que la responsabilidad está activa.
El propietario de los datos acepta el riesgo de negocio y aprueba definiciones, expectativas de calidad y excepciones. El data steward convierte esas decisiones en metadatos, reglas, monitorización y gestión de incidencias. Los productores siguen siendo responsables de crear y entregar los datos. Los ingenieros de plataforma mantienen los controles técnicos, mientras los consumidores reportan defectos que afectan a la analítica, el reporting o el uso de IA.
Un nuevo conjunto crítico, un cambio material de propiedad o un problema de gobernanza sin resolver disparan la revisión. El propietario confirma alcance y riesgo, el steward registra las reglas operativas y los equipos afectados reciben una vía de escalado. Las disputas entre dominios van al decisor designado en lugar de quedarse en una cola sin asignar.
Haga auditable la responsabilidad
Un registro de propiedad debe conectar cada conjunto crítico con su propietario, steward, productor, consumidores, sensibilidad, derechos de decisión y vía de escalado. Manténgalo donde investigadores de incidentes, ingeniería, analítica y negocio puedan consultar el mismo asiento.
Evidencia de control: Definiciones aprobadas, expectativas de calidad, reglas de acceso, decisiones sobre excepciones y cambios de propiedad.
Evidencia operativa: Acciones del steward, incidencias asignadas, notas de remediación, actas de revisión y asientos vigentes del registro.
Evidencia de escalado: Compromisos de respuesta incumplidos, conflictos sin resolver, aceptación de riesgo y decisiones directivas.
Medida de resultado: Cada conjunto importante tiene una persona responsable capaz de explicar su significado, su uso aceptable y la respuesta cuando los controles fallan.
Esta definición de data steward distingue la responsabilidad de negocio de la coordinación operativa. Las reuniones de stewardship, semanales o quincenales cuando proceda, pueden repasar incidentes, acciones vencidas y patrones de calidad recurrentes. La reunión solo sirve si los participantes trabajan con evidencia compartida y registran decisiones, responsables y fechas. Ese registro conecta la actividad de gobernanza con un reporting, una analítica y unos resultados de IA más fiables.
6. Política de monitorización de métricas de negocio y fiabilidad de KPI
La fiabilidad de un KPI es un control operativo, no una función del panel. Protege la planificación, el reporting y la comunicación con accionistas al detectar cuándo una métrica de negocio se mueve de forma inesperada y comprobar si la causa es la actividad del negocio o un fallo de datos.
El propietario de la métrica, normalmente un responsable de negocio, aprueba la definición, la interpretación y el uso aceptable de cada KPI. Analytics engineering mantiene el cálculo y las dependencias. Un data steward coordina la investigación cuando cambian los datos de origen o las reglas de negocio. El disparador puede ser un movimiento inusual en ingresos, actividad de clientes, volúmenes, riesgo de cartera, rotación, resultados de tratamiento o desempeño operativo.
Cada ficha de KPI debe incluir su definición aprobada, los datos de origen, la lógica de cálculo, el responsable, el contexto de revisión y los factores estacionales u operativos conocidos. Los equipos de servicios financieros pueden vigilar ingresos netos, coste de adquisición y riesgo de cartera. Los equipos sanitarios pueden seguir ingresos hospitalarios, resultados y eficiencia operativa. Los equipos de telecomunicaciones pueden observar rotación, ingreso medio por usuario y disponibilidad de red.
Una alerta de KPI exige evidencia antes del escalado. Un cambio grande puede venir de una carga tardía, una modificación de esquema, un filtro cambiado, una actualización de definición o un evento de negocio real. Conecte la monitorización con los controles de calidad, Timeliness, anomalías y esquema descritos en otras partes del programa de gobernanza.
Empiece por las 3 a 5 métricas de negocio más críticas, tal como especifica el enfoque de implementación. Amplíe la cobertura solo cuando los responsables puedan investigar y responder con consistencia. La secuencia operativa es:
Comprobación de definición: Confirme que la definición aprobada y el cálculo siguen sin cambios.
Comprobación de datos: Revise frescura, volumen, completitud y evidencia estructural.
Comprobación de negocio: Registre un evento o condición operativa que explique el movimiento.
Comprobación de escalado: Determine si el KPI afecta a un informe formal, una decisión de negocio o una comunicación externa.
El responsable registra la alerta, la evidencia revisada, la conclusión, la acción y la fecha de vencimiento. Las incidencias no resueltas pasan al steward, al decisor de negocio o a la autoridad de reporting según el impacto. El resultado medible es un KPI que analistas, directivos y sistemas de IA pueden reproducir, explicar y creer.
La solución de Business Monitoring de digna puede examinar cambios inusuales en ingresos, volúmenes, actividad de clientes y métricas operativas. Las revisiones mensuales con la dirección de negocio comprueban si las alertas siguen representando un riesgo relevante y si los umbrales necesitan ajuste.
7. Política de linaje de datos y análisis de impacto
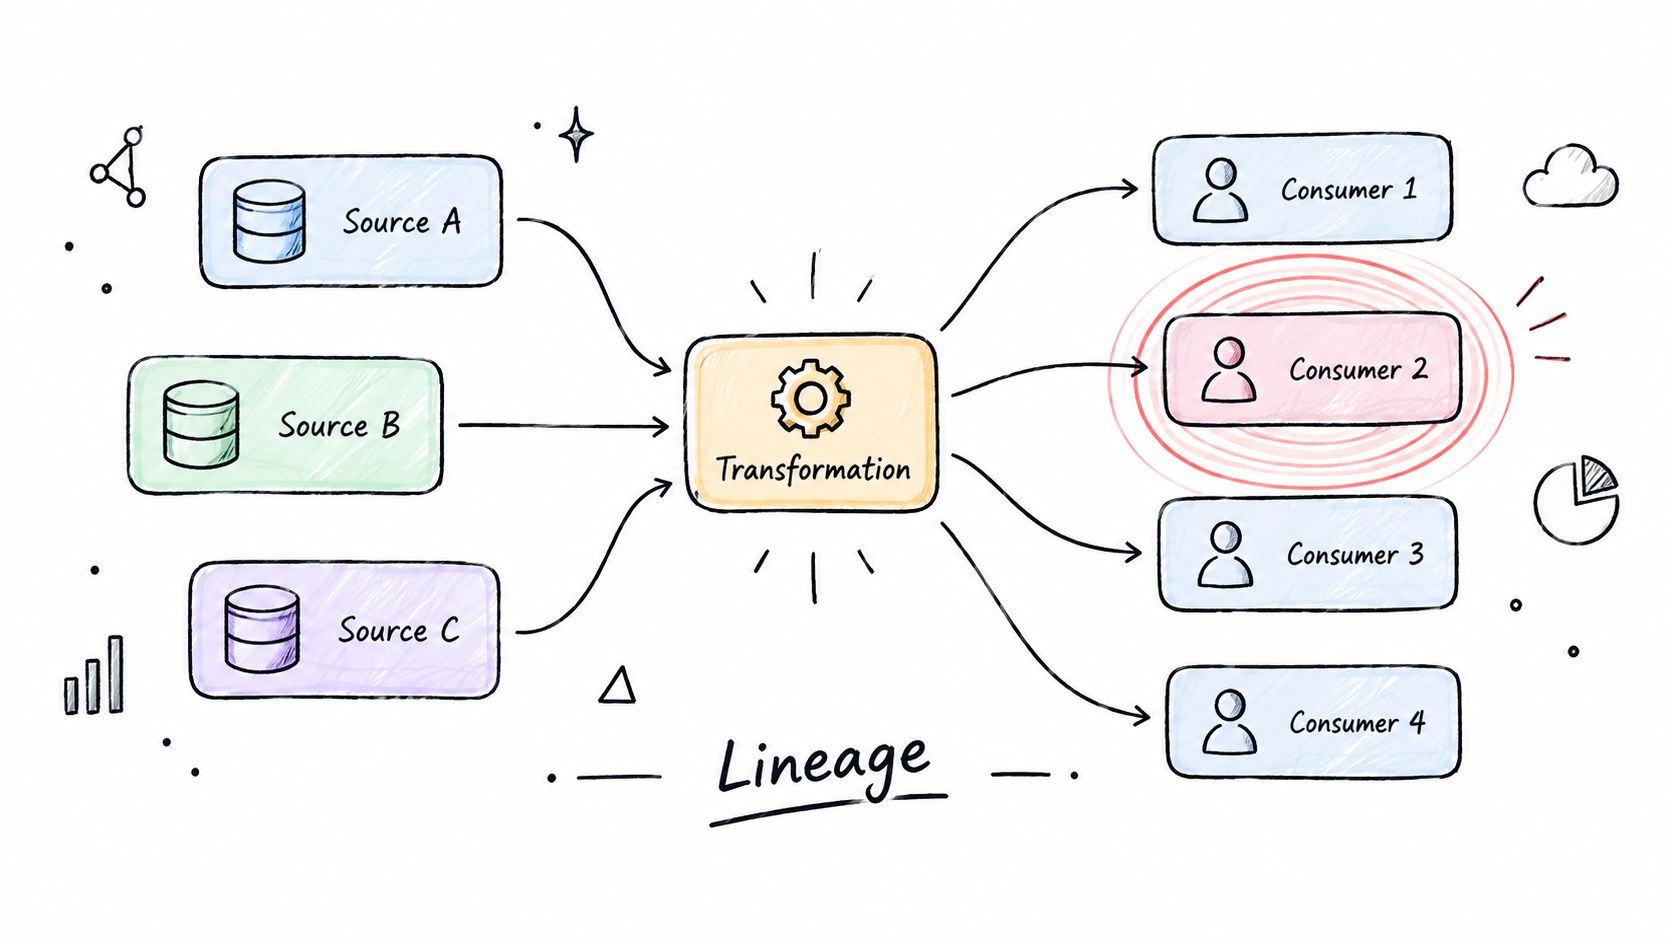
El linaje convierte una dependencia de datos en un control operativo. Conecta una cifra reportada o una entrada de modelo con su origen, transformaciones, destinos y consumidores. El objetivo de la política es establecer el alcance afectado antes de que un defecto, un cambio estructural o un hallazgo de auditoría dispare la remediación.
El propietario de los datos clasifica los activos críticos y aprueba su uso de negocio. Los ingenieros de datos capturan las dependencias de pipeline y transformación, mientras los stewards verifican que las relaciones técnicas reflejan el significado de negocio. Un nuevo flujo crítico, un cambio material de pipeline, un incidente de calidad, el despliegue de un modelo o una solicitud de auditoría inician el control.
La evidencia debe incluir activos de origen y destino, lógica de transformación, relaciones de dependencia, un mapa de linaje versionado, la fecha de revisión y los consumidores afectados. La secuencia operativa es:
Registrar el flujo y su responsable.
Capturar dependencias técnicas y versiones de transformación.
Confirmar definiciones de negocio y consumidores críticos.
Evaluar el impacto cuando cambia un origen, una regla o un destino.
Escalar relaciones ausentes o ambiguas al propietario de los datos y al arquitecto de plataforma.
Un banco puede usar este registro para identificar los modelos de riesgo afectados por un feed roto. Una organización sanitaria puede mapear flujos de datos clínicos para auditoría y cumplimiento, y un organismo público puede mostrar cómo los datos de origen llegan a los sistemas de reporting. Para los sistemas de IA, el linaje aporta evidencia de qué entradas consumió un modelo y cómo cambiaron esas entradas.
El linaje es un control estructural, no un diagrama estático.
Los diagramas manuales se degradan a medida que los sistemas evolucionan. La captura automática desde herramientas de pipeline da una base operativa más sólida, pero un steward debe seguir revisando si las dependencias están completas y si los consumidores de alto impacto están representados. El resultado medible es un análisis de impacto más rápido y basado en evidencia, con la remediación priorizada por informes, modelos y decisiones afectados en vez de por búsquedas manuales.
digna incluye un catálogo de datos que puede apoyar la documentación de linaje y el entendimiento compartido. Un rastro de auditoría visual también puede mostrar qué ocurrió y cuándo, un requisito de evidencia relevante para el software de rastro de auditoría para el cumplimiento de flotas en el Reino Unido.
8. Política de acceso a datos y gobernanza de seguridad
La gobernanza del acceso es un control operativo, no una lista de permisos. Especifica quién puede ver o modificar cada dominio de datos, qué propósito de negocio justifica ese acceso, cómo se conceden o retiran los permisos y qué evidencia respalda la decisión. El objetivo de control es el uso autorizado de datos sensibles y críticos. Unas reglas restrictivas pueden retrasar análisis legítimos, mientras que una revisión débil aumenta la exposición y dificulta establecer responsabilidades.
El propietario de los datos define las reglas de acceso del dominio y aprueba las excepciones. Los equipos de gestión de identidades y accesos aprovisionan permisos, los equipos de seguridad mantienen autenticación y registro, y los stewards comprueban si el acceso sigue correspondiendo a las responsabilidades actuales. Una solicitud, un cambio de rol, un traslado, una baja, una elevación de privilegios o una recertificación programada disparan el flujo.
Un registro defendible conecta la solicitud con quien la aprueba, el mapeo de roles, el estado del permiso, las marcas temporales de concesión y revocación, los eventos de acceso, la justificación de la excepción y el resultado de la revisión. Los conflictos sin resolver van a seguridad y al propietario responsable, suspendiendo o restringiendo el acceso cuando la política lo exige.
La limitación de finalidad también moldea el control. Las orientaciones del RGPD de la UE establecen que los datos personales deben recogerse con fines determinados, explícitos y legítimos y no reutilizarse de manera incompatible. Orientaciones de la Comisión Europea sobre los principios del RGPD Un usuario puede por tanto recibir acceso para una tarea operativa definida sin permiso para reutilizar esos mismos datos en análisis, reporting o desarrollo de IA no relacionados.
Incorpore el rastro de revisión a la implementación
Use acceso basado en roles ligado a responsabilidades del puesto y no a la pertenencia informal a un equipo. Conecte la política con los sistemas de identidad cuando sea posible y realice revisiones trimestrales de acceso para que los propietarios retiren permisos que ya no tienen un propósito documentado.
Responsable: Propietario de datos de negocio.
Disparador: Solicitud, cambio de rol, baja, cambio de privilegios o revisión trimestral.
Evidencia: Flujo de aprobación, estado del permiso, evento de acceso, revocación y excepción.
Escalado: Equipo de seguridad y propietario responsable para conflictos sin resolver.
Resultado: El acceso sigue siendo autorizado, explicable, revisable y reversible.
La ejecución en base de datos de digna y sus opciones de despliegue en nube privada u on-premises pueden sostener los controles mientras los datos permanecen en el entorno del cliente. La tecnología registra y aplica decisiones, pero la organización debe determinar quién necesita acceso, por qué lo necesita y cuándo debe terminar.
9. Política de respuesta a incidentes de datos y escalado
Los incidentes de datos requieren un control operativo, no solo un ticket. La política debe cubrir fallos de calidad, entregas tardías o ausentes, cambios de esquema, KPI poco fiables y preocupaciones de acceso. Su objetivo es detectar el problema, limitar su efecto sobre analítica, reporting o flujos de IA, documentar decisiones y evitar la repetición.
El responsable del incidente dirige la respuesta. El propietario del conjunto evalúa el impacto de negocio y aprueba una remediación aceptable. Los ingenieros de plataforma examinan las causas técnicas, los stewards mantienen el registro y los consumidores afectados reciben actualizaciones. Los disparadores incluyen validación fallida, alertas de anomalía, entrega perdida, cambio estructural no autorizado o una métrica de negocio sin explicación.
La severidad determina la vía de respuesta. Un incidente que afecta al reporting regulatorio, a operaciones de trading o a la seguridad del paciente justifica un escalado más rápido y una comunicación más clara con los grupos de interés que un problema interno de bajo impacto.
Haga auditable la resolución
El registro debe conservar la alerta, la notificación, la investigación, la causa raíz, la acción correctiva, la aprobación de restablecimiento y la revisión posterior. Esa evidencia distingue un fallo de origen corregido de una solución temporal.
Detección: Capture la señal, la marca temporal, el conjunto afectado y el alcance inicial.
Notificación: Contacte al propietario, al steward, a los consumidores y al personal de guardia.
Investigación: Establezca impacto, causa, dependencias y contención.
Resolución: Corrija, revierta, ponga en cuarentena o comunique la limitación del dato.
Prevención: Asigne el trabajo de seguimiento y verifique que el control cambió.
El escalado debe dispararlo el impacto de negocio, no el volumen de alertas por sí solo.
El responsable cierra el incidente solo cuando la evidencia respalda el uso restablecido o una limitación explícita. Una base de conocimiento consultable debe conservar causas raíz, decisiones y excepciones. Las revisiones mensuales posteriores a incidentes pueden identificar debilidades recurrentes de proceso o plataforma que los tickets individuales ocultan.
El sistema de alertas y el panel centrado en el usuario de digna pueden dar a ingenieros, analistas y responsables una visión compartida de incidentes y tendencias. La secuencia de implementación es definir criterios de severidad, conectar señales de detección, asignar roles de respuesta, exigir evidencia al cierre y después revisar causas recurrentes. El resultado medible es un historial de respuesta que sostiene un reporting fiable y un uso de IA más seguro aguas abajo.

10. Política de mejora continua y métricas de gobernanza de datos
La gobernanza necesita sus propias métricas operativas. Una política de mejora continua define cómo la organización mide la cobertura de controles, revisa el desempeño, prioriza carencias y cambia la política cuando se mueven las condiciones de negocio o regulatorias. Evita que la gobernanza se convierta en una revisión documental desconectada del comportamiento real de los datos.
El consejo de gobernanza fija el marco de medición. Los propietarios de dominio interpretan resultados, los stewards coordinan la remediación y los equipos de plataforma aportan la evidencia de ejecución. El disparador es una revisión de gobernanza programada, un incidente material, un nuevo flujo regulado o un cambio significativo en el patrimonio de datos.
Medidas útiles son:
Cobertura de clasificación: La proporción de activos de datos con clasificación asignada.
Cobertura de propiedad: La proporción de conjuntos críticos con propietarios nombrados.
Cobertura de linaje: La proporción de elementos de datos críticos con linaje documentado.
Capacidad de respuesta en accesos: La proporción de solicitudes de acceso aprobadas dentro del SLA acordado.
Finalización de recertificaciones: La proporción de revisiones trimestrales de acceso completadas a tiempo.
Estas medidas proceden de una guía de implementación que recomienda seguir la cobertura operativa en lugar de confiar solo en documentos de política. La misma guía indica que el tiempo medio de aprobación de accesos cayó a 1,3 días desde 5,2 días antes de la política, con comprobaciones de calidad programadas alcanzando el 97 % de ejecución y el cumplimiento de retención llegando al 88 %. Métricas de implementación para controles de políticas de gobernanza de datos
Use benchmarks sin externalizar el criterio
El trabajo de UNSC y Global Data Governance Mapping creó un marco de 26 indicadores en seis atributos de gobernanza para comparar la implementación entre organizaciones y jurisdicciones. Marco del Global Data Governance Mapping Un benchmark puede exponer carencias de propiedad, metadatos, acceso, linaje o gestión de incidencias, pero no puede decidir qué riesgo importa más a un negocio concreto.
Seleccione 5 a 7 métricas clave conectadas con el valor de negocio, revíselas trimestralmente y publique el trabajo de mejora con transparencia. El módulo Data Analytics de digna puede apoyar el análisis histórico de métricas de observabilidad, mientras que los materiales sobre herramientas para un despliegue de IA seguro y auditable aportan una perspectiva pertinente sobre requisitos de evidencia en entornos intensivos en IA.
Comparación de 10 políticas de gobernanza de datos
Política | 🔄 Complejidad de implementación | ⚡ Requisitos de recursos | 📊 Resultados esperados | Casos de uso ideales | ⭐ Ventajas clave |
|---|---|---|---|---|---|
Política de estándares de calidad de datos y validación | Alta, definición de reglas y gobernanza extensas | Media–Alta, ingenieros de datos, expertos de negocio, herramientas de validación | Adecuación de datos consistente, rastros de auditoría, menos errores aguas abajo | Sectores regulados, pipelines de ML, reporting corporativo | Evita datos malos, impone consistencia, sostiene el cumplimiento |
Política de detección de anomalías y aprendizaje de línea base | Media, configuración de modelos y pipelines de monitorización | Media, datos históricos, recursos de ML y observabilidad | Detección temprana de desplazamientos, alertas adaptativas, monitorización escalable | Detección de fraude, series temporales de alto volumen, métricas operativas | Detecta problemas nuevos, reduce el ajuste manual, escala con facilidad |
Política de Timeliness y monitorización de entregas | Media, definición de SLA y aprendizaje de calendarios | Media, instrumentación de pipelines, observabilidad | Mejor puntualidad, cumplimiento de SLA, menos retrasos aguas abajo | Facturación, plazos regulatorios, pipelines sensibles al tiempo | Alertas proactivas de retraso, evidencia de SLA, visión de la fiabilidad del pipeline |
Política de detección de cambios de esquema y gobernanza estructural | Media–Alta, seguimiento estructural continuo y análisis de impacto | Media, mapeo de linaje, mapeo de consumidores aguas abajo | Detección rápida de cambios rompedores, menos fallos aguas abajo | Esquemas en evolución, plataformas multiequipo, validación de contratos | Evita fallos silenciosos, permite rollbacks coordinados, rastros de auditoría |
Política de propiedad de datos y responsabilidad de stewardship | Media, definición de roles y procesos organizativos | Media, stewards designados, cadencia de gobernanza, paneles | Responsabilidad clara, investigaciones más rápidas, propiedad sostenida | Grandes organizaciones, entornos regulados, equipos de datos distribuidos | Mejora la velocidad de resolución, clarifica responsabilidades, preserva conocimiento |
Política de monitorización de métricas de negocio y fiabilidad de KPI | Media, definiciones de métricas e integración con BI | Media, responsables de negocio, analistas, herramientas de BI | KPI fiables, alertas tempranas de impacto, confianza en las decisiones | Reporting directivo, métricas de producto y finanzas, KPI para inversores | Evita malas decisiones, liga métricas a causas raíz, sostiene la estrategia |
Política de linaje de datos y análisis de impacto | Alta, captura y mantenimiento de linaje de extremo a extremo | Alta, herramientas de catálogo, automatización, esfuerzo de integración | Evaluación rápida del radio de impacto, investigaciones más cortas, evidencia de gobernanza | Pipelines complejos, auditorías, dependencias entre sistemas | Permite análisis de impacto rápido, reduce el tiempo de triaje, sostiene el cumplimiento |
Política de acceso a datos y gobernanza de seguridad | Media, integración de RBAC e IAM | Media, IAM, registro, procesos de revisión de accesos | Acceso controlado, registros listos para auditoría, menor riesgo interno | Datos sensibles o regulados (PII, PHI, financieros) | Protege datos sensibles, asegura auditabilidad, impone mínimo privilegio |
Política de respuesta a incidentes de datos y escalado | Media, playbooks de incidentes, SLA y guardias | Media–Alta, equipos de guardia, herramientas de incidentes, procesos de postmortem | Menor MTTD/MTTR, remediación documentada, aprendizaje continuo | Servicios de datos críticos, pipelines de reporting regulatorio | Respuesta estructurada, resolución más rápida, aprendizaje organizativo |
Política de mejora continua y métricas de gobernanza de datos | Media, selección de métricas y procesos de madurez | Media, analítica, revisiones con grupos de interés, métricas históricas | Progreso de gobernanza medido, hoja de ruta de mejora priorizada | Organizaciones que maduran su gobernanza, necesidad de justificar ROI | Aporta evidencia de impacto, impulsa optimización continua, alinea a los implicados |
Convierta el texto de la política en controles operativos
Los programas de gobernanza más sólidos no empiezan escribiendo todas las políticas posibles. Empiezan con un conjunto pequeño de datos de alto riesgo y hacen visible la responsabilidad. Ese enfoque también aborda un problema central de implementación: la gobernanza formal sigue incompleta en muchas organizaciones, así que una documentación amplia puede crear apariencia de madurez sin entregar cobertura de control.
Empiece seleccionando los conjuntos que sostienen reporting regulado, decisiones financieras materiales, operaciones clínicas, facturación a clientes o flujos de IA y analítica. Asigne un propietario de negocio y un steward operativo antes de definir controles detallados. El propietario debe decidir qué significa «apto para el uso», qué consumidores importan y qué nivel de riesgo acepta la organización. El steward debe mantener reglas, evidencia, registros de incidencias y actividad de escalado.
Después defina la evidencia de calidad y entrega. Una política de calidad debe producir resultados de validación, detalle de registros fallidos e historial de remediación. Una política de Timeliness debe mostrar el comportamiento de entrega esperado y real, no solo si un pipeline terminó. Estos controles trabajan juntos porque un pipeline exitoso puede seguir entregando datos incompletos o tardíos, mientras que una carga puntual puede contener registros inválidos.
Añada a continuación los controles de acceso y estructurales. La gobernanza del acceso debe conectar propósito, rol, aprobación, aprovisionamiento, revocación y evidencia de revisión. El principio de minimización de datos del RGPD exige que los datos personales sean adecuados, pertinentes y limitados a lo necesario para la finalidad del tratamiento. Orientación de la ICO británica sobre minimización de datos Ese principio da a las decisiones de acceso y recogida un límite práctico. Las políticas de retención también necesitan una base defendible. NIST SP 800-63B señala que los proveedores de servicios en la nube deben cumplir los requisitos aplicables de conservación de registros y, cuando la conservación no sea obligatoria, usar un proceso de gestión de riesgos que considere los riesgos de privacidad y seguridad e informe al suscriptor de la política de retención. Orientación de NIST SP 800-63B sobre conservación de registros
La gobernanza gana credibilidad cuando cada requisito importante produce evidencia que una persona nombrada puede interpretar y sobre la que puede actuar.
Conecte los incidentes con vías de escalado en lugar de enviar alertas a una cola sin dueño. Defina severidad, responsabilidades de guardia, destinatarios de la comunicación, opciones de contención, expectativas de causa raíz y revisión posterior. El propietario debe poder aprobar una respuesta de negocio, mientras ingenieros y stewards aportan la evidencia técnica y operativa que la sostiene.
Por último, revise tendencias con regularidad. Mida cobertura de clasificación y propiedad, linaje de elementos críticos, desempeño del SLA de accesos, finalización de recertificaciones, ejecución de calidad, puntualidad, patrones de anomalías y recurrencia de incidentes. El enfoque de benchmark desarrollado por el Global Data Governance Mapping demuestra por qué los indicadores estructurados son más útiles para comparar que los relatos de madurez. Los equipos de gobernanza pueden adaptar esa lógica sin tratar un marco externo como sustituto de sus propias decisiones de riesgo.
ISO/IEC 38505-1 plantea la gobernanza de datos como una responsabilidad del órgano de gobierno de evaluar, dirigir y supervisar el tratamiento y uso de los datos. También reconoce la responsabilidad por brechas de privacidad, legislación de conservación de registros e incumplimiento de normas obligatorias. Responsabilidades de gobernanza de datos en ISO/IEC 38505-1 Esa perspectiva cambia el papel de la tecnología de gobernanza. Las herramientas pueden ejecutar comprobaciones, conservar evidencia y hacer visibles los incidentes, pero la dirección sigue siendo responsable de decisiones, interpretación, excepciones y rendición de cuentas.
digna puede sostener este modelo operativo mediante validación en base de datos, detección de anomalías guiada por IA, monitorización de Timeliness, seguimiento de esquema, visibilidad compartida de incidentes, un catálogo de datos y análisis histórico. Sus opciones de despliegue en nube privada y on-premises permiten que la plataforma se ejecute dentro del entorno del cliente, mientras la organización conserva la responsabilidad del diseño de políticas y la propiedad de los controles.
Adopte las políticas en secuencia, mida si operan de verdad y revíselas cuando el negocio cambie. Una plantilla es un punto de partida. Un programa de gobernanza que funciona es la combinación de derechos de decisión, controles ejecutables, evidencia, respuesta humana y revisión recurrente.
digna combina validación a nivel de registro, detección de anomalías, monitorización de Timeliness, seguimiento de esquema, monitorización de negocio y analítica histórica en una plataforma que se ejecuta dentro del entorno del cliente. Visite digna para ver cómo sus módulos ayudan a convertir las políticas de gobernanza de datos en controles observables para analítica e IA.
La política 4 describe el control; la detección que hay detrás es una capacidad de producto. Schema Tracker compara cada esquema desplegado con una línea base aprobada y registra altas, bajas, renombrados y cambios de tipo según ocurren.
Preguntas frecuentes
¿Qué hace que una política de gobernanza de datos sea operativa y no decorativa?
Cada política nombra un objetivo de control, un responsable, un disparador, un paquete de evidencia, una vía de escalado y un resultado medible. Los datos de encuesta citados en el artículo indican que solo el 23 % de las organizaciones usa marcos formales de gobernanza, de modo que la documentación por sí sola crea con frecuencia apariencia de madurez sin cobertura de control.
¿Qué políticas debe escribir primero un equipo?
Empiece con un conjunto pequeño de datos de alto riesgo: reporting regulado, decisiones financieras materiales, operaciones clínicas, facturación a clientes y flujos de IA o analítica. Asigne un propietario de negocio y un steward operativo antes de definir controles detallados, porque una documentación amplia escrita primero adelanta a los controles que debía hacer cumplir.
¿En qué se diferencia una política de Timeliness de una de calidad?
Una política de calidad decide si un registro es apto para el propósito. Una política de entrega convierte «suficientemente fresco» en una ventana acordada, un disparador observable y una respuesta definida, con el productor a cargo de la ejecución y el consumidor definiendo la ventana. Un pipeline puede terminar bien y aun así perder el cierre diario.
¿Qué evidencia debe conservar una política de cambios de esquema?
El esquema antes y después con su marca temporal de detección, la solicitud de cambio y su justificación, un nivel de riesgo, una evaluación de impacto que cubra el linaje afectado, y la aprobación, el resultado del despliegue y la decisión de rollback. La detección compara cada versión desplegada con una línea base registrada bajo un propietario de esquema nombrado.
¿Quién posee una política de gobernanza en el día a día?
Tres roles se la reparten. El propietario de los datos aprueba el significado de negocio de cada regla y acepta el riesgo residual, el steward mantiene el registro de reglas, la evidencia y la actividad de escalado, y los ingenieros implementan las comprobaciones en el pipeline o la base de datos. Registrar primero ese reparto es lo que mantiene auditable la política.



