Detección de anomalías en bases de datos: una guía práctica
|
9
minuto de lectura

La primera señal rara vez es una falla dramática. Un panel de ingresos se mantiene en verde, los recuentos de filas parecen normales y nadie llama al equipo del almacén, pero un cambio silencioso aguas arriba ya ha desviado parte de los datos hacia una ruta de respaldo o ha cambiado la forma de una fuente. Para cuando el departamento de finanzas nota que el pronóstico es incorrecto, las filas erróneas ya se han introducido en los modelos, informes y diapositivas ejecutivas.
Por eso, la detección de anomalías en bases de datos funciona mejor cuando se trata al propio almacén como la superficie monitoreada. La pregunta útil no es solo si un gráfico parece extraño, sino si la Timeliness, la forma y la distribución de los datos aún coinciden con la línea base de la que dependen sus consumidores. En la práctica, eso significa extracción de características nativa de SQL, comparación de la línea base cerca de la fuente y alertas que entiendan el contexto en lugar de gritar ante cada pico esperado.
Tabla de Contenidos
Extracción de características de detección con SQL en la base de datos
Elegir entre líneas base estadísticas y aprendizaje impulsado por IA
Construcción de líneas base de similitud de segmentos para cargas de trabajo repetitivas
Detección de deriva de esquema y retrasos en la entrega como una sola señal
Diseño de alertas sensibles al contexto en las que la gente realmente confíe
Integración de la detección de anomalías en bases de datos en su pila de Observability
Cuando la deriva silenciosa de datos rompe sus informes
Un equipo de finanzas puede confiar en el mismo panel de ingresos diario durante semanas y, aun así, estar equivocado. Un solo cambio de nombre de esquema aguas arriba, una bifurcación en una transformación o un cambio de tipo en una tabla de origen pueden desviar filas hacia una ruta predeterminada, por lo que el panel se sigue representando y los números aún se ven ordenados. El problema es que el denominador ahora es parcial y la organización está realizando pronósticos sobre una porción filtrada de la realidad.
Las comprobaciones de paneles y las aserciones de estilo dbt se quedan cortas. Los recuentos de filas pueden mantenerse dentro de un rango normal mientras los ID de clientes activos caen, una canalización puede llegar tarde sin romperse por completo, o una columna previamente poblada puede comenzar a aparecer como NULL en el lugar equivocado. Ninguno de esos patrones activa siempre una regla simple, pero todos ellos pueden distorsionar las decisiones.
Un enfoque nativo del almacén detecta el problema en la fuente. En lugar de esperar a que los consumidores intermedios noten que algo se siente mal, la detección de anomalías en bases de datos compara el estado actual de los datos con la forma en que normalmente se comporta esa tabla, métrica o canalización. Eso incluye la estructura, la frescura y la distribución de valores, no solo si el trabajo se realizó correctamente.
Regla práctica: si los datos cambiaron de una manera que un panel no puede explicar por sí solo, su capa de detección debería residir donde se producen los datos, no tres herramientas aguas abajo.
La lección histórica es clara. Las evaluaciones comparativas iniciales ya mostraron que la calidad de la detección de anomalías depende en gran medida de los datos, y una evaluación comparativa posterior a una escala mucho mayor demostró lo mismo con una cobertura mucho más amplia, probando 30 algoritmos en 57 conjuntos de datos de referencia y 98.436 experimentos para estudiar el nivel de supervisión, el tipo de anomalía y las condiciones de ruido (ADBench benchmark). La razón por la que esto importa en los almacenes es simple: las cargas de trabajo difieren, los esquemas derivan y las líneas base que funcionan en un conjunto de datos pueden fallar en entornos similares a los de producción.
Extracción de características de detección con SQL en la base de datos
La forma más rápida de hacer útil la detección de anomalías es mantener la ingeniería de características dentro del almacén. Si primero exporta las tablas sin procesar a un almacén de características independiente, agrega latencia, duplicación y otro lugar para que la frescura se pierda antes de que el detector siquiera se ejecute. SQL ya sabe cómo calcular las señales que necesita, así que utilícelo.
Comience con ventanas móviles y deltas
Para la mayoría de las comprobaciones de almacén, comienzo con agregados móviles sobre ventanas de 7 días y 28 días. Las funciones de ventana como AVG, STDDEV y COUNT le brindan una línea base local sin salir de la base de datos, y LAG más diferencias simples muestran el cambio de un período a otro directamente en la consulta. Esa combinación detecta el deterioro gradual, los saltos repentinos y los cambios que solo se muestran cuando se compara el día de hoy con el mismo punto del ciclo anterior.
Los percentiles también importan. Una media puede mantenerse plana mientras la mediana se mueve, especialmente en datos comerciales sesgados, por lo que PERCENTILE_CONT ayuda a detectar la deriva que omiten las comprobaciones basadas en promedios. Los métodos estadísticos clásicos como la desviación estándar, la desviación absoluta de la mediana, el rango intercuartílico, la puntuación z y la puntuación z modificada siguen siendo útiles porque son transparentes y económicos de calcular en una tabla activa (classical statistical methods).
Si una métrica es lo suficientemente importante como para enviar una alerta, es lo suficientemente importante como para calcularse junto a los datos, no después de una exportación por lotes.
Un patrón práctico se ve así, en una tabla de hechos con un grano compuesto:
Partición por día y métrica, de modo que cada señal tenga su propio historial.
Calcule líneas base móviles para la media, la dispersión y el recuento.
Agregue deltas rezagados para el cambio de un día a otro y de una semana a otra.
Persista el resultado en una tabla de características que los trabajos posteriores puedan leer sin volver a calcular todo.
Patrón SQL | Función Utilizada | Señal Revelada |
|---|---|---|
Línea base móvil | AVG, STDDEV, COUNT | Tendencia local, volatilidad y volumen faltante |
Delta de período | LAG, resta | Cambios bruscos y regresión repentina |
Deriva de la mediana | PERCENTILE_CONT | Cambio de distribución oculto por los promedios |
Aquí también es donde la ejecución en la base de datos rinde operativamente. Evita copiar terabytes a otro sistema y mantiene la lógica de detección cerca de la señal de frescura. Para obtener una comparación arquitectónica de este patrón, consulte la nota interna sobre in-database data quality execution and safer external pipelines.
Elegir entre líneas base estadísticas y aprendizaje impulsado por IA
Las líneas base estadísticas siguen siendo el punto de partida adecuado para muchas tablas de producción. Una media móvil más la desviación estándar, la desviación absoluta de la mediana, el rango intercuartílico y las puntuaciones z son fáciles de explicar, fáciles de auditar y fáciles de ejecutar en SQL. Funcionan especialmente bien cuando una métrica es estable, la estacionalidad es débil y la empresa desea un umbral claro en lugar de una caja negra.
La debilidad aparece tan pronto como la serie se vuelve caótica. Los ciclos semanales, los efectos de los días festivos y las interacciones multivariadas hacen que los umbrales fijos sean frágiles, y el ajuste manual se convierte en una tarea de mantenimiento. Por eso existen las líneas base aprendidas. Pueden absorber más contexto, manejar mejor la estacionalidad y modelar relaciones entre columnas o tablas que una sola regla univariada no vería.
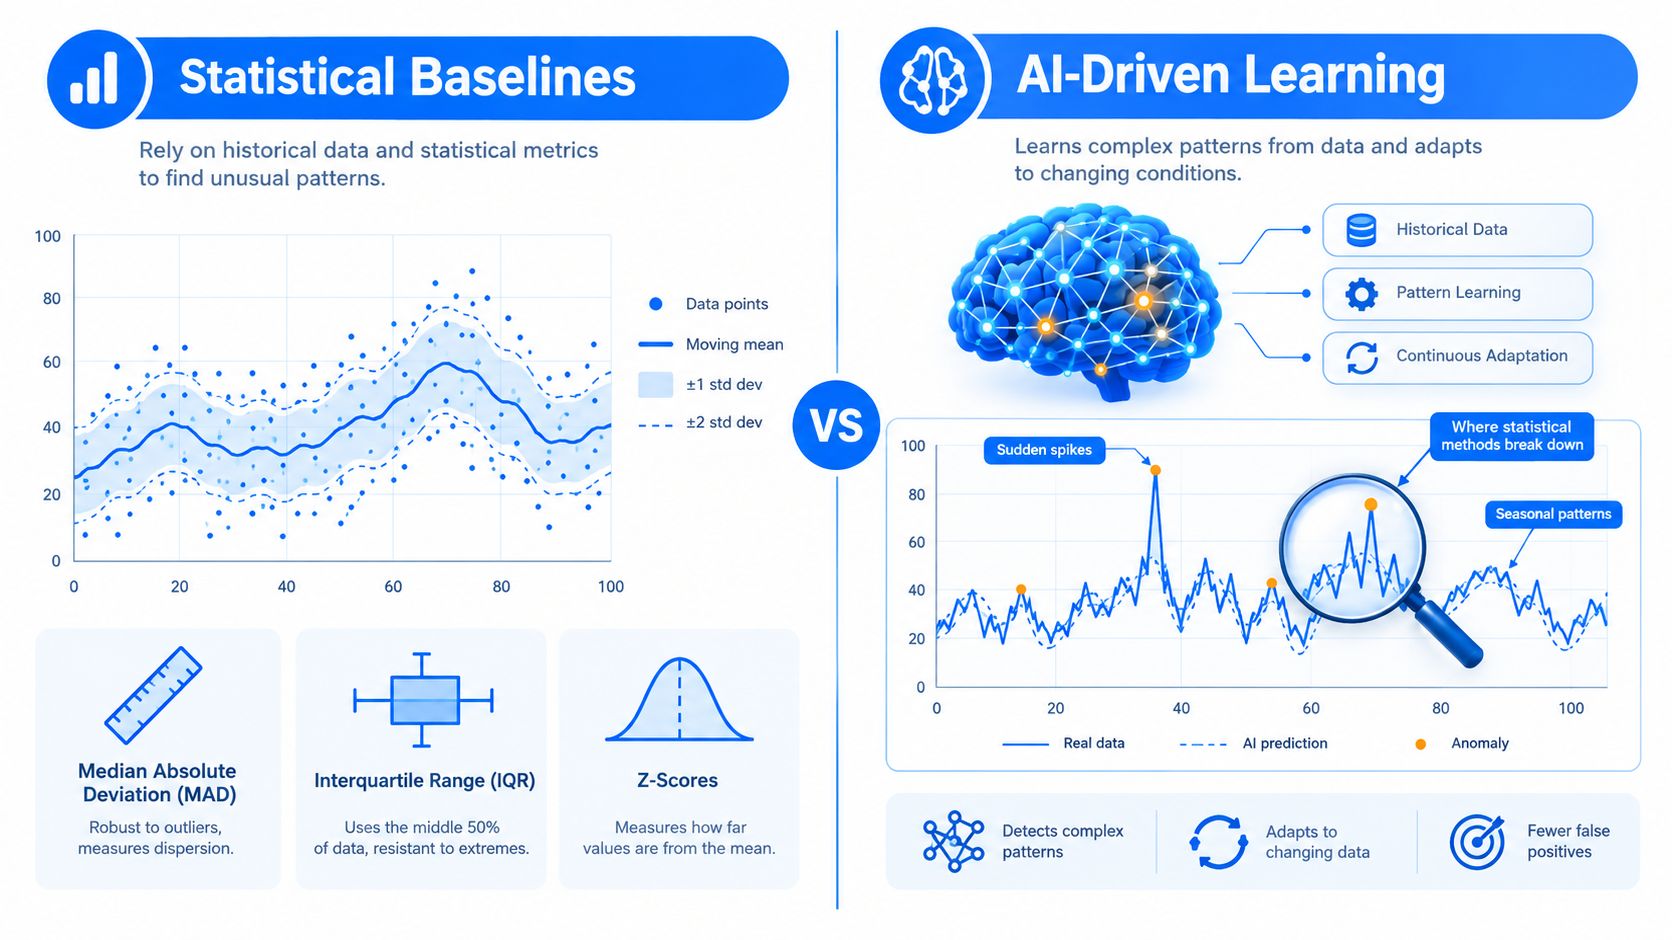
El compromiso es operativo, no solo matemático. Los modelos aprendidos introducen una canalización de entrenamiento, control de versiones y deriva en el propio modelo. También dificultan la explicabilidad cuando alguien pregunta por qué se activó una alerta a nivel de fila o métrica, lo cual es un problema real en entornos regulados donde los equipos necesitan pruebas defendibles, no solo una puntuación.
Un marco de referencia útil es este. Los métodos estadísticos a menudo detectan aproximadamente entre el 60% y 70% de las anomalías univariadas con casi cero falsos positivos en métricas estables, mientras que las líneas base aprendidas pueden acercarse al 85% de sensibilidad pero requieren más ajuste. Esos son puntos de referencia internos, no promesas universales, pero coinciden con lo que la mayoría de los profesionales ven cuando pasan de umbrales ajustados manualmente a la detección basada en modelos.
Si desea un punto de partida práctico, use líneas base estadísticas para los umbrales por métrica y modelos aprendidos en capas para series de alto valor y alta varianza. Ese enfoque se alinea con la división más amplia de la industria entre reglas explicables y modelos adaptativos, y también es la razón por la que recursos como AI anomaly detection in social ops son lecturas útiles incluso si su caso de uso es un almacén en lugar de una cola de eventos de clientes. Para un marco estadístico más profundo, el material interno sobre statistical pattern recognition es un buen complemento.
Construcción de líneas base de similitud de segmentos para cargas de trabajo repetitivas
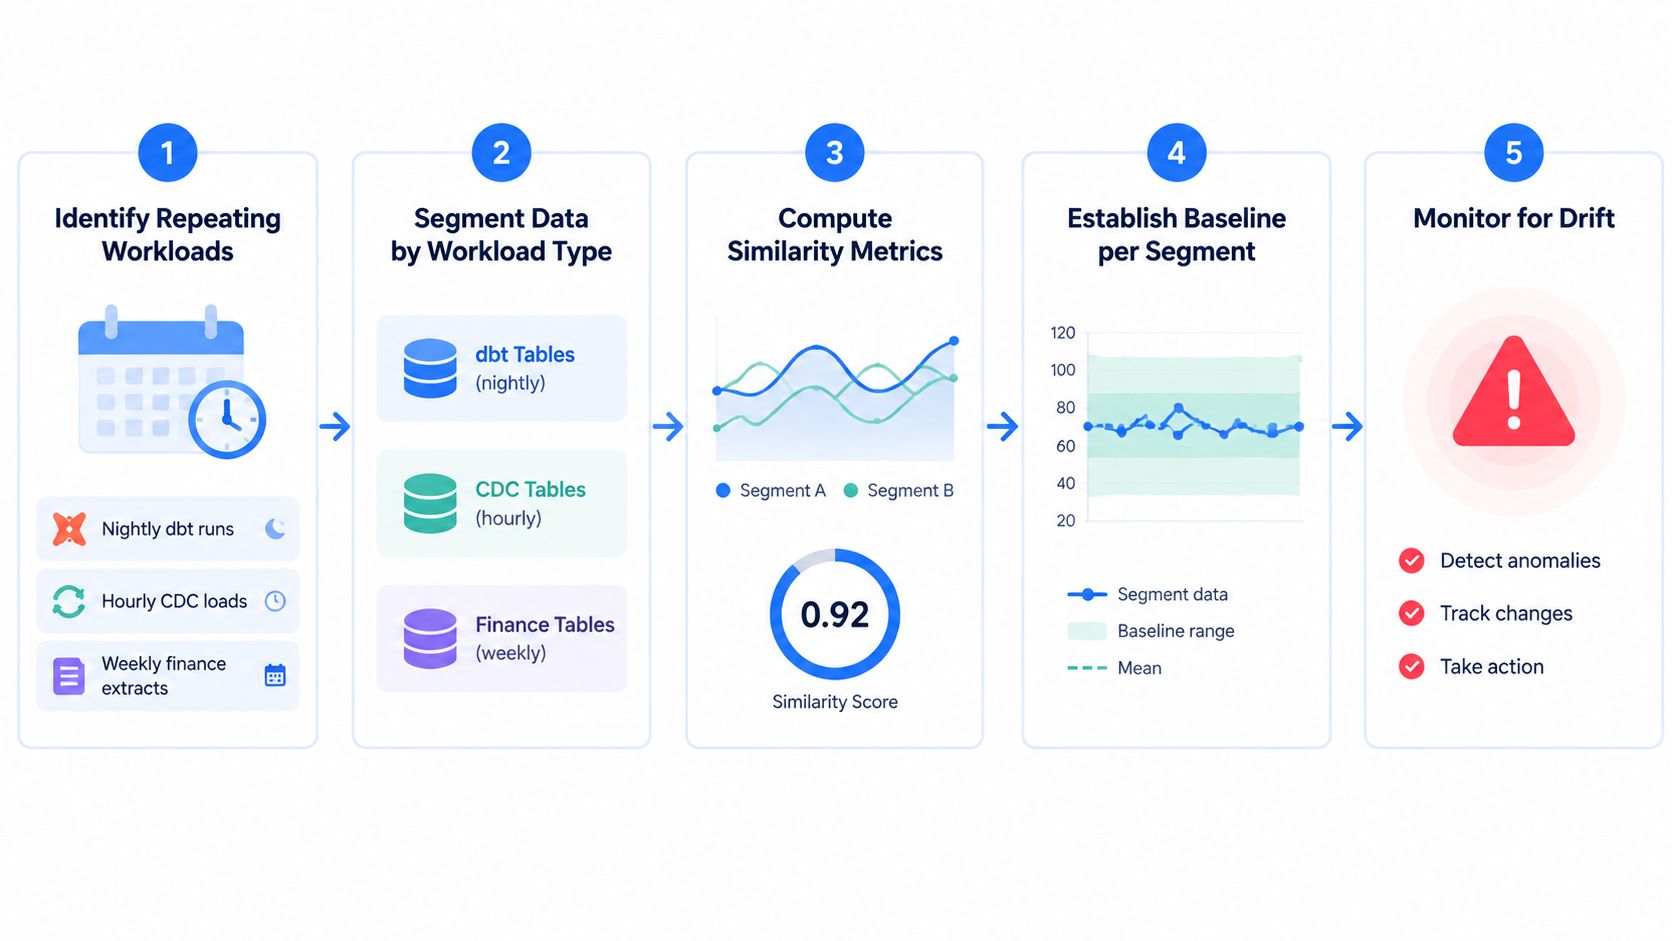
Las cargas de trabajo repetidas necesitan una línea base diferente a la de las métricas siempre activas. Las ejecuciones nocturnas de dbt, las cargas CDC por hora y las extracciones financieras semanales tienen una cadencia, por lo que la comparación correcta no suele ser "hoy frente a una media genérica", sino "hoy frente al segmento histórico más similar". Así es como se separa la deriva real de un relleno de lunes o un pico del Black Friday.
Huella digital de cada ejecución en SQL
Comience por registrar la huella digital de cada ejecución completada en el almacén. Normalmente incluyo recuentos de filas, un hash de las distribuciones de columnas clave, proporciones de nulos y algunos resúmenes numéricos de PERCENTILE_CONT o un equivalente del almacén. Esos valores le brindan una representación compacta de la carga de trabajo sin arrastrar toda la tabla a través del detector.
Almacene esas huellas digitales en una tabla baseline_segments indexada por job_id, day_of_week y hour_of_week. Luego, compare la ventana actual con los K segmentos anteriores más similares utilizando una métrica de similitud en el vector de huellas digitales. Si la similitud cae por debajo de un umbral de revisión, como 0.85, la ejecución merece una revisión humana antes de que contamine a los consumidores intermedios.
La lógica es sencilla, pero el beneficio es sutil. No se está preguntando si la carga de trabajo es "normal" en abstracto. Se está preguntando si se está comportando como su propio grupo de pares históricos, lo cual se adapta mucho mejor a los almacenes donde la estacionalidad es parte del funcionamiento normal.
Una línea base que ignora la cadencia siempre generará alertas excesivas ante un comportamiento periódico saludable.
La parte difícil son las líneas base que quedan obsoletas. Cuando una carga de trabajo evoluciona legítimamente, la biblioteca de huellas digitales debe invalidarse y reconstruirse, o comparará el nuevo comportamiento con un historial obsoleto para siempre. Eso es un problema de governance tanto como un problema de modelado, y pertenece a la misma canalización de observabilidad que el propio trabajo.
Para obtener una referencia práctica sobre la segmentación del comportamiento de datos repetibles, la guía interna sobre data profiling techniques es relevante aquí.
Detección de deriva de esquema y retrasos en la entrega como una sola señal
La mayoría de las pilas de monitoreo dividen el cambio estructural de la frescura. Esa separación es conveniente, pero oculta fallas. Un cambio de esquema puede llegar a tiempo y aun así romper la conversión de tipos aguas abajo, mientras que un archivo retrasado puede parecer inofensivo hasta que genera un informe desactualizado en cascada y el incumplimiento de un SLA.
Trate la estructura y la frescura de manera conjunta
Para la deriva de esquema, compare el esquema entrante de hoy con un esquema de línea base y clasifique las diferencias. Los conjuntos concretos son columnas faltantes (Β\I), nuevas columnas (I\B) y discrepancias de tipo en campos compartidos (schema drift detection pattern). Si aparecen columnas faltantes o discrepancias de tipo, se enfrenta a un cambio que rompe la compatibilidad. Si solo aparecen columnas nuevas, el cambio es aditivo.
La Timeliness debe situarse junto a esa comprobación, no debajo de ella. Un monitor de frescura puede clasificar cada entrega como anticipada, retrasada, faltante o parcial, y un cronograma puede ser explícito, como todos los días laborables antes de las 7:30 AM (data timeliness monitoring). Cuando el tiempo de llegada real se desvía demasiado de lo esperado, el estado de la entrega pasa a formar parte de la alerta, no de un panel independiente que nadie abre.
Tipo de Señal | Qué Detecta | Fuente Principal SQL | Latencia Típica de Alerta |
|---|---|---|---|
Deriva de esquema | Columnas añadidas, eliminadas o con cambio de tipo | Diferencias de INFORMATION_SCHEMA | Inmediata en la ingesta |
Retraso en la entrega | Cargas retrasadas, faltantes, anticipadas o parciales | Marcas de tiempo de llegada y tablas de frescura | Al incumplir el cronograma |
Falla combinada | Cambio estructural más regresión de frescura | Comprobaciones unidas de esquema y frescura | Casi en tiempo real |
Un ejemplo del mundo real hace que el valor sea obvio. Si un proveedor amplía una columna de cadena a VARCHAR(500) y una conversión numérica posterior comienza a fallar en una parte de las filas, la comprobación del esquema debería activarse antes de que se entregue el informe. Una comprobación solo de volumen probablemente esperaría hasta el día siguiente, lo cual es demasiado tarde para un triaje operativo.
Este es el tipo de caso en el que una plataforma como digna puede utilizarse como una opción entre otras, porque combina Timeliness, seguimiento de esquemas y comprobaciones en la base de datos en un único modelo operativo. El explicativo interno sobre schema drift and structural changes that break data pipelines se adapta bien a este patrón.
Diseño de alertas sensibles al contexto en las que la gente realmente confíe
Más alertas no significan una mejor detección. Por lo general, significan fatiga por alertas, y una vez que un equipo se ve abrumado por notificaciones ruidosas, la alerta útil se ignora junto con la basura. Un equipo que ve 40 notificaciones de Slack al día comenzará a silenciar canales, y así es como las interrupciones reales se ocultan a plena vista.
La solución es el sistema de alertas sensible al contexto. Suprima las ventanas de implementación conocidas con una tabla deploy_event, reduzca la gravedad cuando una desviación coincida con un cambio programado por lotes y requiera una segunda señal de corroboración antes de alertar al personal de guardia. Esa corroboración puede ser otra métrica, un cambio de esquema o una regresión de frescura, según la carga de trabajo.
La carga útil en sí debería explicar la alerta. Incluya el segmento de línea base utilizado, la puntuación z o el valor de similitud y las características que más contribuyen para que el ingeniero pueda realizar el triaje rápidamente. Si la persona de guardia tiene que reconstruir el contexto a partir de tres paneles diferentes, la alerta no está lista para producción.
Regla práctica: si un ingeniero no puede entender la alerta en menos de un minuto, la alerta es demasiado imprecisa.
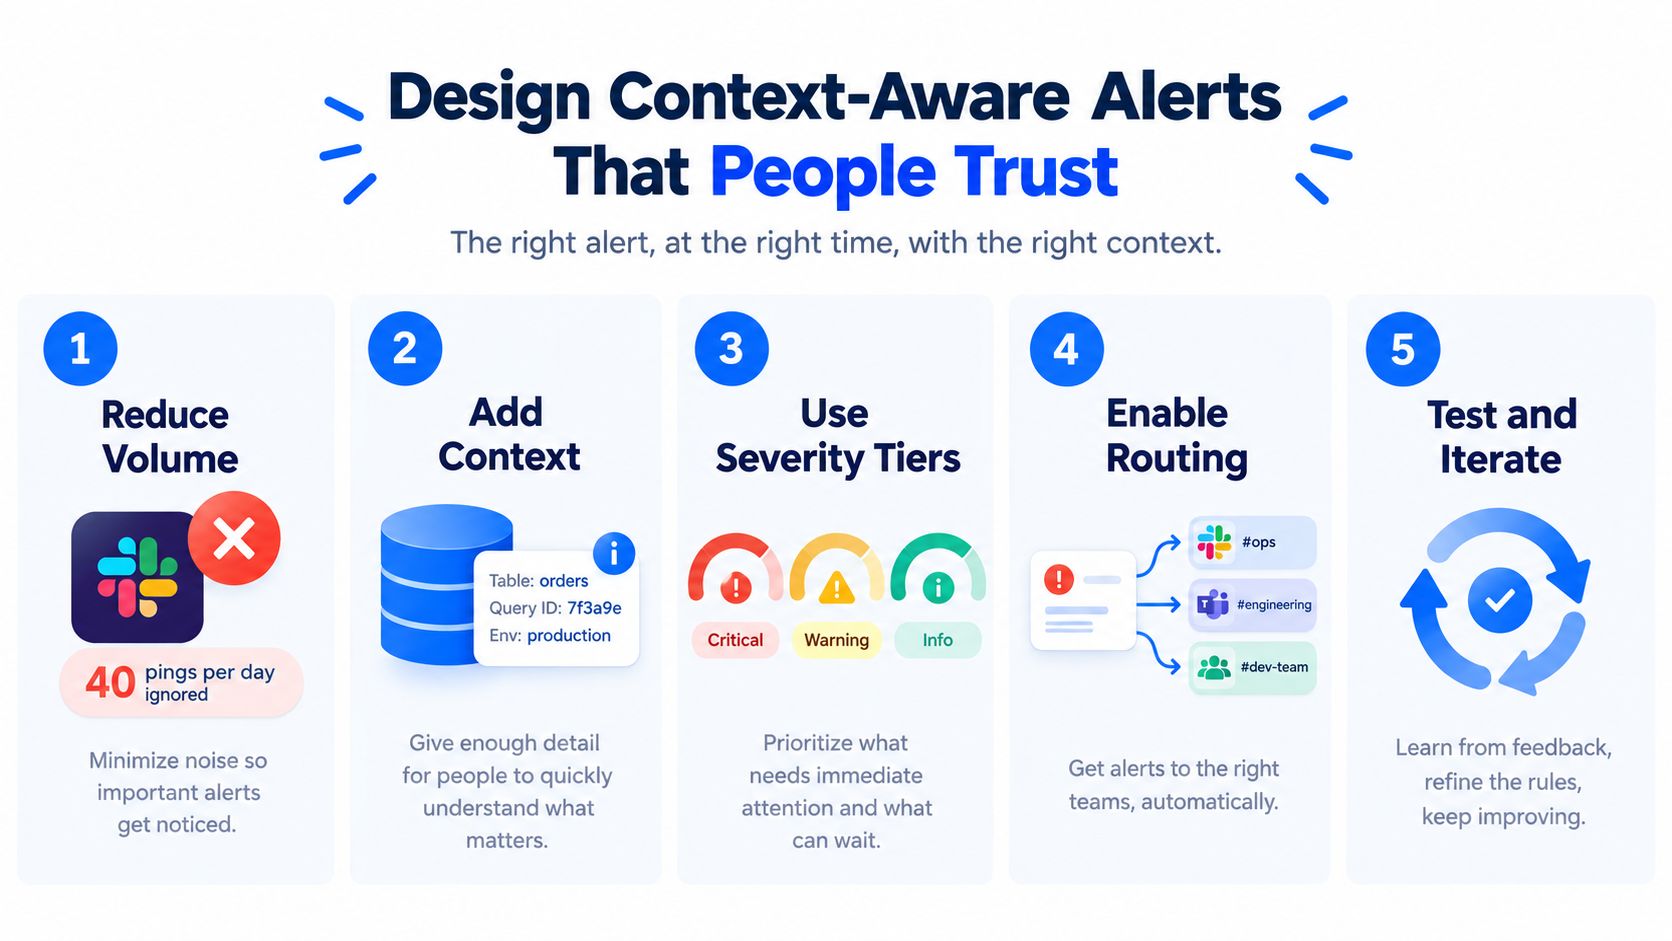
El objetivo operativo debería ser menos de 5 alertas críticas de alta señal por semana por tabla crítica, midiendo la confianza por la tasa de alertas ignoradas en lugar del recuento total de alertas. Ese enfoque cambia la conversación de "¿Cuántas alertas activamos?" a "¿Por cuáles alertas valió la pena despertar a alguien?". Para obtener más información sobre cómo los equipos operativos enrutan e interpretan estas señales, el artículo de Sift AI piece on anomaly detection in social ops es un buen punto de comparación, aunque el dominio sea diferente.
Integración de la detección de anomalías en bases de datos en su pila de Observability
Las señales de anomalías no deberían vivir en un panel aislado. Trátelas como telemetría, etiquételas con table, schema y run_id, y envíelas a la misma ruta de observabilidad que las métricas de aplicaciones e infraestructura. De esa manera, una carga fallida, una implementación y un pico en los errores de infraestructura se encuentran en la misma línea de tiempo de incidentes en lugar de en tres herramientas diferentes.
Conecte el almacén al flujo de incidentes
Los programadores nativos del almacén suelen ser el lugar más limpio para ejecutar las consultas de características. Las tareas de Snowflake, las consultas programadas de BigQuery, las pruebas de dbt y los sensores de Airflow se adaptan al patrón, siempre que la cadencia coincida con las expectativas de frescura de los datos. El evento de anomalía puede fluir a través de OpenTelemetry o un exportador nativo hacia PagerDuty, Slack o cualquier puerta de enlace de alertas canónica en la que ya confíe el equipo de guardia.
El compromiso es obvio. Los extractores basados en consultas REST (pull) son simples, pero lentos. Los emisores basados en eventos al completarse la escritura detectan los problemas más rápido, pero crean un acoplamiento entre el productor y la ruta de monitoreo, lo que significa que se necesita más disciplina de ingeniería en torno a los reintentos, la deduplicación y la propiedad.
Un orden de implementación práctico ayuda a mantener la sensatez:
Primero, calcule las características en SQL y persístalas.
Segundo, etiquete cada evento con el activo de datos y los metadatos de ejecución.
Tercero, conecte las alertas en un único flujo de incidentes canónico.
Cuarto, correlacione las anomalías con las implementaciones, los flags de características y los trabajos ETL aguas arriba.
Por último, ajuste el enrutamiento para que solo las alertas de mayor señal lleguen a los humanos.

La descripción general interna de Data Observability es relevante aquí porque enmarca la detección de anomalías como una parte de un sistema operativo más grande, no como un generador de alertas independiente. Ese es el modelo mental correcto para los almacenes de producción, y es el que evita que la gente cree otro panel ruidoso del que nadie se hace cargo.
Si está implementando la detección de anomalías en bases de datos en producción, comience con las comprobaciones que residen más cerca de los datos, luego agregue capas de contexto, explicabilidad y enrutamiento. digna admite la detección de anomalías en la base de datos, el monitoreo de Timeliness, el seguimiento de esquemas y los flujos de trabajo de Observability dentro del propio entorno del cliente, por lo que se adapta a los equipos que desean la lógica de detección donde ya residen los datos. Visite digna para ver cómo se adapta ese enfoque a su almacén, sus canalizaciones y su pila de alertas.
Preguntas frecuentes
¿Qué es la detección de anomalías en bases de datos?
Tratar el propio almacén como la superficie monitorizada en lugar de revisar paneles tres herramientas más abajo. Si los datos cambiaron de un modo que un panel no puede explicar por sí solo, la capa de detección debería vivir donde se producen los datos.
¿Qué características SQL conviene extraer primero?
Agregados móviles en ventanas de 7 y 28 días, calculados por día y por métrica para que cada señal conserve su propia historia. Añada deltas desfasados para el cambio día a día y semana a semana, use percentiles para los desplazamientos de distribución que las medias ocultan y persista el resultado en una tabla de características.
¿Qué función SQL detecta qué fallo?
Tres emparejamientos cubren casi todo. AVG, STDDEV y COUNT dan una línea base móvil que revela tendencia local, volatilidad y volumen ausente. LAG con resta da deltas de periodo que revelan saltos. PERCENTILE_CONT da deriva de la mediana y capta desplazamientos de distribución que las medias esconden.
¿Cuándo deben ceder las líneas base estadísticas ante modelos aprendidos?
Las líneas base estadísticas siguen siendo el punto de partida correcto para muchas tablas en producción, y su debilidad aparece en cuanto la serie se vuelve ruidosa, con estacionalidad, ciclos de versión o efectos de segmento. Los benchmarks confirman que la calidad de detección depende mucho de los datos.
¿Hay evidencia de que la elección de algoritmo importe?
Sí, y importa menos que los datos. El benchmark ADBench probó 30 algoritmos sobre 57 conjuntos de referencia en 98.436 experimentos, estudiando nivel de supervisión, tipo de anomalía y condiciones de ruido, y confirmó que la calidad depende mucho de los datos en lugar de resolverse con un único ganador.



