Detección de anomalías con machine learning: guía práctica
|
10
minuto de lectura

Su dashboard de ingresos parece correcto a las 9:00. A las 11:30, el departamento financiero cuestiona la previsión semanal, los responsables de ventas ponen en duda las cifras del pipeline comercial y nadie puede señalar una caída del sistema. El problema no es un job del data warehouse que ha fallado. Es un cambio silencioso upstream. Una tabla de origen empezó a duplicar registros, una marca de tiempo llegó tarde o la distribución de valores de una columna se desvió lo justo para contaminar la lógica downstream sin disparar ninguna alerta codificada a mano.
Ese es el tipo de fallo para el que está diseñada la detección de anomalías con machine learning. No los incidentes ruidosos. Los silenciosos. Los que superan la validación básica, llegan a tablas de confianza y erosionan poco a poco la confianza en cada informe y modelo que depende de ellos.
Muchos equipos no tienen dificultades por falta de alertas. Las tienen porque la monitorización tradicional basada en umbrales no puede seguir el ritmo de los datos de alta dimensionalidad, la estacionalidad cambiante, los pipelines en evolución y las restricciones empresariales en materia de privacidad y despliegue. La detección de anomalías moderna funciona cuando aprende el comportamiento normal de forma continua, se ejecuta cerca de los datos y se integra en flujos de trabajo de observabilidad que los equipos de operaciones pueden mantener.
Índice
Cuando los errores de datos silenciosos causan problemas ruidosos
Consideraciones sobre el despliegue y la monitorización en la empresa
Cuando los errores de datos silenciosos causan problemas ruidosos
Un patrón de fallo habitual empieza con un usuario de negocio que confía en datos que técnicamente están presentes, pero cuyo comportamiento es incorrecto. Las previsiones de ventas se disparan. La pérdida de clientes parece mejorar de un día para otro. Un feature store de ML recoge valores sesgados y modifica los resultados del modelo. Nadie ve ningún fallo, porque nada ha fallado.
Las comprobaciones basadas en reglas suelen detectar los fallos evidentes. Picos de nulos. Archivos ausentes. Recuentos de filas que caen a cero. Tienen dificultades cuando el problema es más sutil, como una fuente que envía registros duplicados, una distribución que se desplaza dentro de un rango aceptado o campos correlacionados que se desvían juntos de una manera que ninguna regla estática había previsto.
Esa brecha es importante en las operaciones reales. Los métodos de detección de anomalías basados en machine learning superan a los enfoques estadísticos tradicionales entre un 8 % y un 12 % en accuracy, y algunas implementaciones alcanzan hasta un 15 % más de precisión en la detección de anomalías complejas y multivariantes, especialmente en entornos de alta dimensionalidad como la monitorización de transacciones financieras y la predicción de fallos de equipos industriales, según este resumen de investigación sobre detección de anomalías.
Por qué falla la monitorización tradicional
La monitorización tradicional da por hecho que los equipos pueden definir los fallos de antemano. En la práctica, no pueden.
La lógica de negocio cambia: las nuevas campañas, los cambios de precios, las reorganizaciones territoriales y los lanzamientos de productos alteran el comportamiento de los datos más rápido de lo que se actualizan las reglas de alerta.
Los pipelines se superponen en capas: un solo KPI puede depender de jobs de ingesta, modelos de dbt, sincronizaciones de reverse ETL y API de terceros.
Las anomalías se esconden en las relaciones: cada columna puede parecer normal por sí sola, mientras que el patrón combinado es claramente incorrecto.
Regla práctica: si su equipo se entera de los problemas de datos por un consumidor del dashboard y no por la monitorización, su lógica de detección es demasiado frágil.
Los equipos que intentan modernizar estos flujos de trabajo suelen empezar por corregir primero la capa de ingesta y transformación. Por eso recursos como las soluciones de procesamiento de datos de Osher Digital aportan un contexto útil. Un procesamiento fiable reduce los fallos evitables, pero no sustituye a la detección de anomalías. Sigue necesitando un sistema capaz de detectar lo desconocido una vez que los datos empiezan a fluir.
Qué cambia el machine learning
La detección de anomalías con machine learning cambia el trabajo de escribir reglas por el de aprender baselines. En lugar de pedir a un ingeniero que defina de antemano cada estado incorrecto, el sistema modela el comportamiento esperado y señala las desviaciones significativas.
Ese cambio es operativo, no académico. Protege las previsiones, los informes financieros, los flujos de cumplimiento normativo, la monitorización del fraude y las entradas de los modelos frente al tipo de drift silencioso que provoca las discusiones más costosas en los equipos de datos empresariales.
Comprender la anatomía de una anomalía
Una anomalía son datos que se desvían del comportamiento esperado. Lo útil no es la definición. Es saber qué tipo de desviación se está observando, porque los métodos de detección fallan cuando los equipos tratan todas las anomalías como el mismo problema.
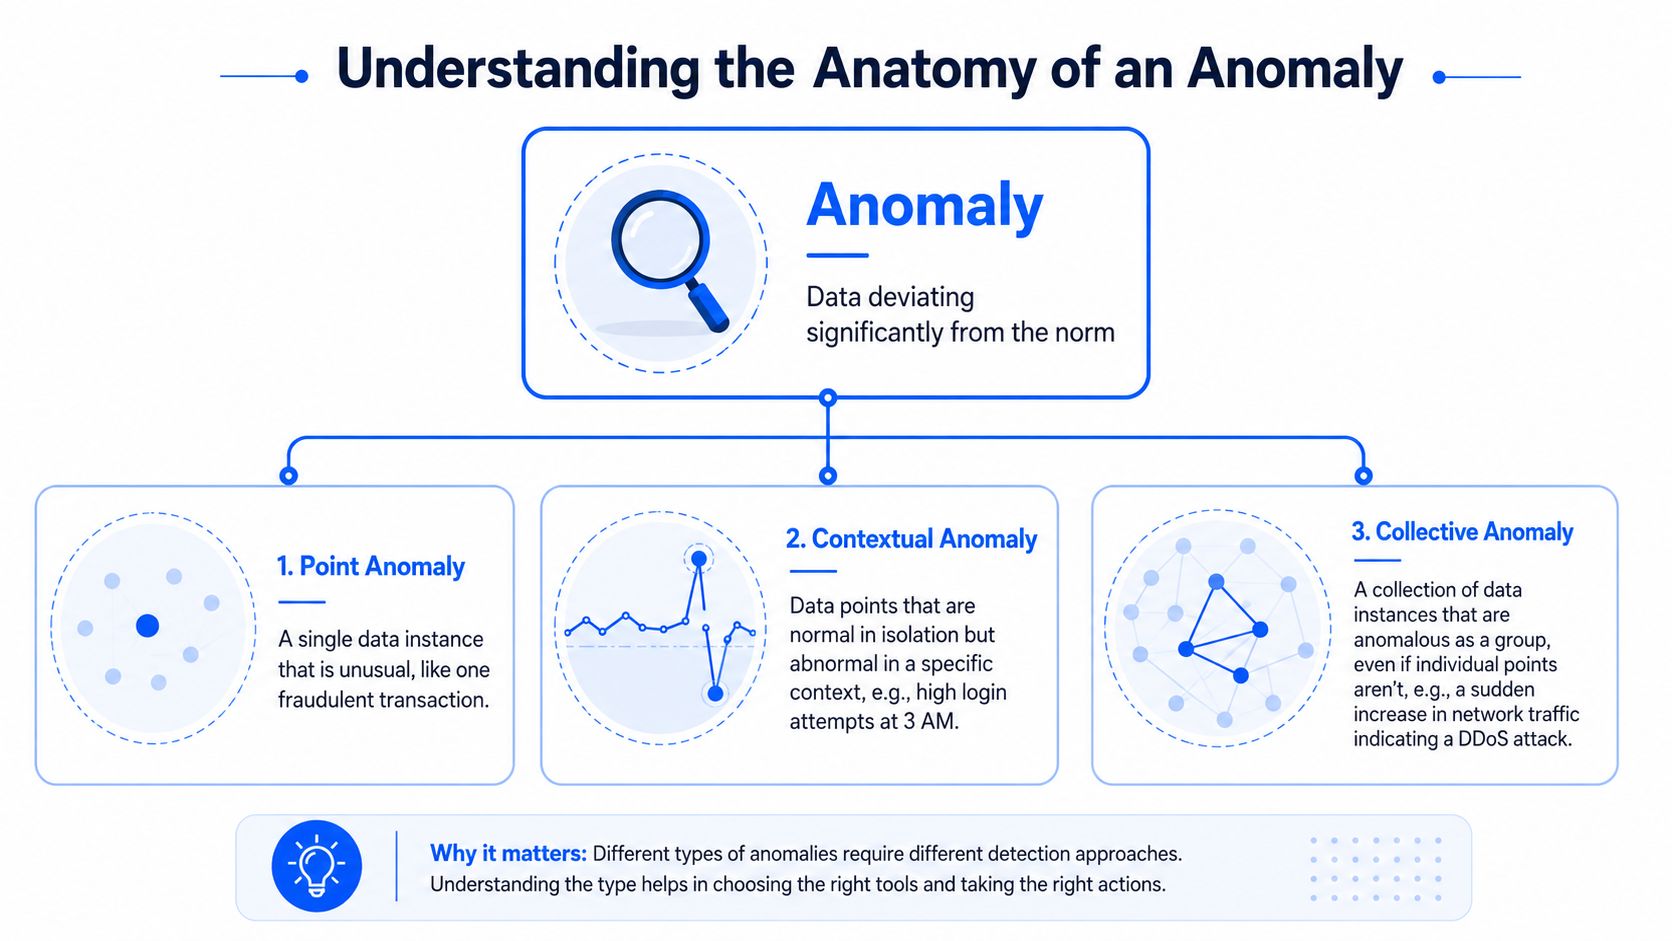
Anomalías puntuales
Una anomalía puntual es la más fácil de imaginar. Un evento, un valor, una fila parece incorrecto. Piense en una única transacción con tarjeta que se aleja mucho del patrón normal de un cliente, o en una carga del data warehouse con un recuento de registros imposible.
Son los casos para los que normalmente se diseña primero, porque se traducen de forma directa en alertas. Un valor es demasiado alto, demasiado bajo, demasiado temprano, demasiado tardío o está demasiado alejado de la norma.
Anomalías contextuales
Una anomalía contextual parece correcta hasta que se tienen en cuenta el momento, la estacionalidad o las condiciones del entorno. Un volumen alto de inicios de sesión a mediodía puede ser normal. El mismo volumen a las 3 de la madrugada en un sistema interno sensible puede ser una señal grave.
Las plataformas de datos lo ven con frecuencia. Un archivo que llega tarde puede ser normal con un calendario de festivos, pero alarmante en un día de negociación. Un pico de tráfico puede ser esperable durante el lanzamiento de una campaña, pero sospechoso en un fin de semana tranquilo.
Anomalías colectivas
Una anomalía colectiva es donde la monitorización empresarial suele fallar. Los registros individuales parecen inofensivos, pero el grupo forma un patrón que no debería existir. Un ataque coordinado de bots, un schema drift sutil en varios campos o una secuencia de eventos que cambian a la vez pueden entrar en esta categoría.
Los umbrales simples no captan el contexto. Los equipos necesitan métodos que detecten relaciones entre columnas, ventanas temporales y entidades.
Una fila errónea es fácil de detectar. Lo que daña la confianza en producción es un patrón erróneo repartido por un conjunto de datos de apariencia sana.
Por qué los umbrales estáticos fallan aquí
Los umbrales estáticos resultan atractivos porque son fáciles de explicar. También son costosos de mantener. Cada nueva fuente, patrón de estacionalidad y excepción de negocio añade más reglas. Con el tiempo, el sistema genera tanto ruido que la gente lo ignora.
Las plataformas modernas lo sustituyen por el aprendizaje adaptativo de baselines. Tal como se describe en la visión general de digna sobre técnicas de detección de anomalías con IA, los sistemas de detección de anomalías con machine learning perfilan de forma continua el volumen de registros, los valores ausentes y las distribuciones de valores para definir dinámicamente los límites esperados, lo que ayuda a detectar en tiempo real errores silenciosos como registros ausentes o duplicados.
Ese modelo operativo cambia el trabajo diario de los equipos de datos:
Menos mantenimiento de reglas: los ingenieros no tienen que ajustar a mano los umbrales de cada tabla y métrica.
Mejor cobertura: el sistema puede vigilar cambios de comportamiento que no son lo bastante evidentes como para codificarlos manualmente.
Investigación más transparente: los equipos pueden comparar el comportamiento actual con las baselines aprendidas en lugar de debatir si un umbral se configuró correctamente.
Qué significa esto en la práctica de la observabilidad
En observabilidad, la detección de anomalías no está aislada del resto del stack. Se sitúa junto a la monitorización de la puntualidad, el seguimiento de esquemas y la validación. Una detecta un patrón de métricas inesperado. Otra confirma un retraso. Otra revela una nueva columna o un cambio de tipo de datos. Juntas, explican por qué se rompió la confianza.
Ese es el valor práctico. No solo se detectan valores atípicos. Se protegen las decisiones de negocio frente a datos que, en apariencia, siguen estando disponibles, actualizados y consultables.
Los cuatro enfoques clave de machine learning
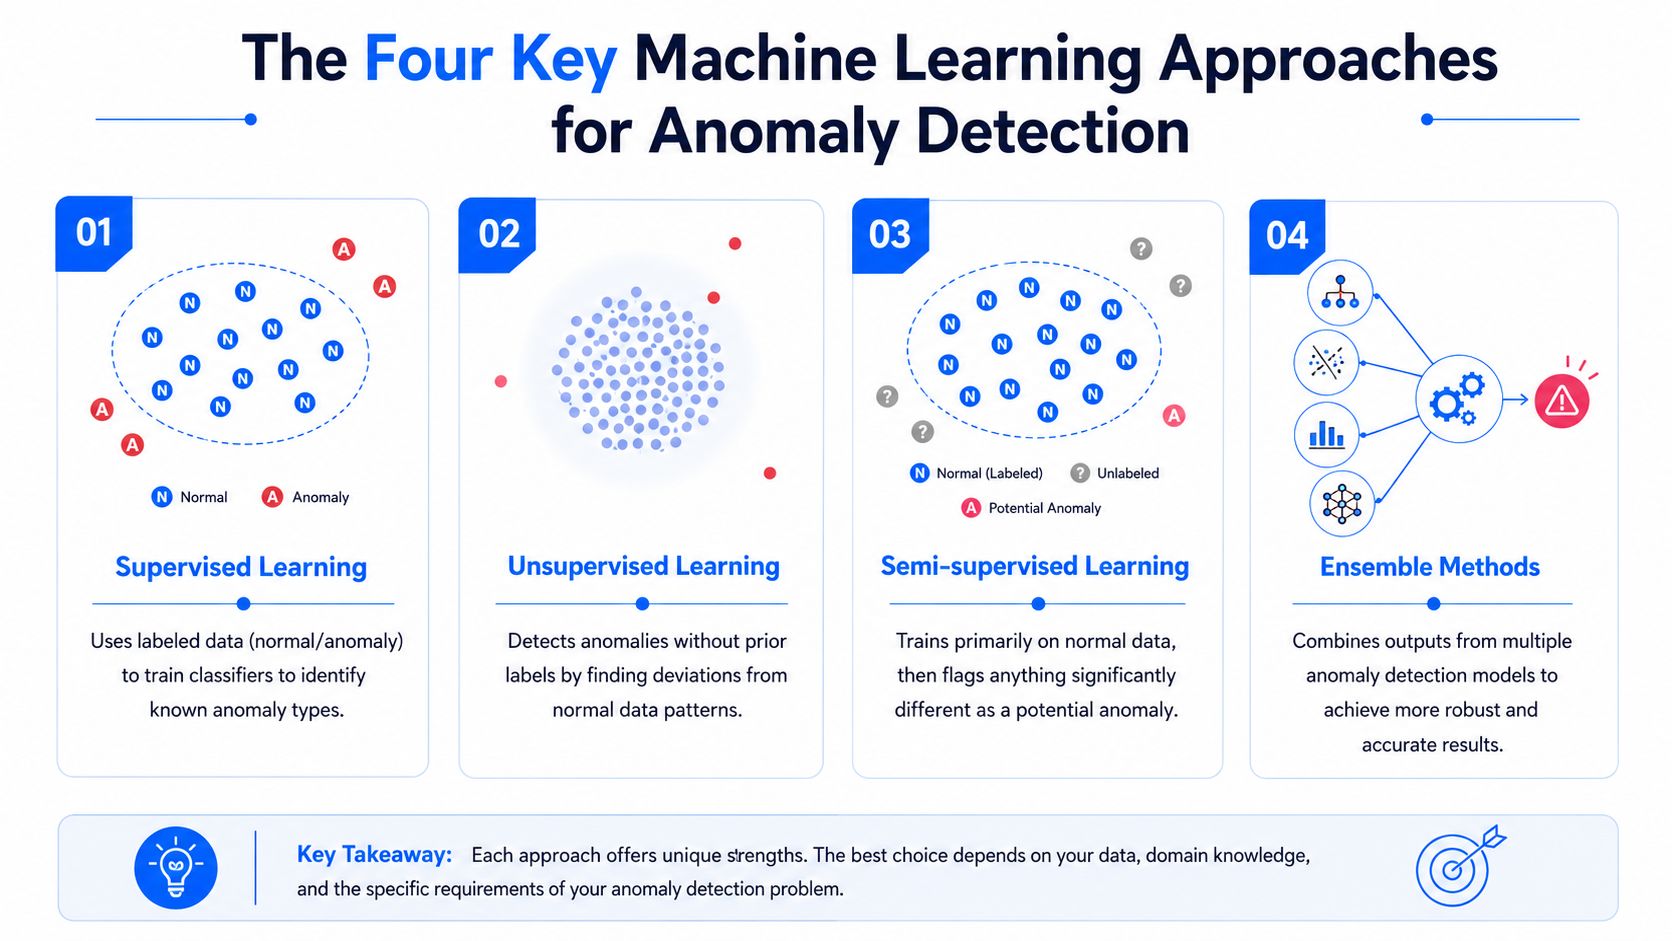
El enfoque adecuado depende menos de la popularidad del algoritmo y más de lo que tiene su equipo de datos. Las etiquetas, unas baselines históricas estables, la estructura secuencial, el presupuesto de cómputo, las necesidades de latencia y la capacidad de revisión importan más que la novedad.
Aprendizaje supervisado
La detección supervisada funciona cuando ya se sabe cómo es un caso incorrecto y se dispone de etiquetas que lo demuestran. Los sistemas antifraude, los pipelines de revisión de siniestros y algunos flujos de seguridad pueden justificarla, porque acumulan incidentes revisados con el tiempo.
La ventaja es la precisión en modos de fallo conocidos. Si sus anomalías etiquetadas son representativas, un clasificador puede aprender esos patrones directamente.
La desventaja es operativa. Las etiquetas son escasas, caras y a menudo están desactualizadas. Además, los problemas de datos empresariales cambian de forma. La clase de anomalía del trimestre pasado puede no cubrir el error de integración de este trimestre.
Utilice enfoques supervisados cuando:
Existan anomalías revisadas: su equipo dispone de etiquetas de alta calidad procedentes de analistas, investigadores de fraude u operaciones de seguridad.
Los tipos de fallo se repitan: trabaja con clases de anomalías recurrentes y bien conocidas.
Las vías de actuación estén definidas: el negocio ya sabe qué hacer cuando el sistema señala un problema.
Aprendizaje no supervisado
Los métodos no supervisados son la opción por defecto en muchas plataformas de datos, porque a menudo no se dispone de etiquetas. El sistema busca desviaciones en los propios datos en lugar de ejemplos de eventos incorrectos conocidos.
Suele ser la vía más práctica para la observabilidad empresarial. Se puede desplegar en muchas tablas y métricas sin tener que crear antes una operación de etiquetado. Aquí encajan métodos como el clustering, los modelos basados en aislamiento y la puntuación basada en distancias.
Un diseño sólido del mundo real procede de la documentación de detección de anomalías de Netdata, que describe un clustering k-means no supervisado con k=2 sobre ventanas móviles, con varios modelos por métrica, y que informa de una reducción del 99 % de los falsos positivos al exigir consenso unánime antes de señalar una anomalía. Es un buen recordatorio de que las decisiones de arquitectura pueden importar tanto como el algoritmo base.
La primera pregunta en producción no es “¿qué modelo es el más inteligente?”. Es “¿qué enfoque puede sobrevivir a datos sin etiquetar, entradas con ruido y la realidad de las guardias?”.
Aprendizaje semisupervisado
La detección semisupervisada parte de una suposición práctica: puede que no conozca todas las anomalías, pero normalmente conoce un conjunto de datos normales de confianza. El modelo aprende esa baseline y trata las desviaciones significativas como sospechosas.
Esto es especialmente útil en pipelines empresariales, donde los periodos sanos son más fáciles de identificar que los problemáticos. Se puede entrenar con ventanas históricas aceptadas y, después, puntuar los datos nuevos frente a esa representación aprendida.
Los métodos semisupervisados suelen funcionar bien cuando:
Situación | Por qué ayuda el enfoque semisupervisado |
|---|---|
Sistemas estables con drift ocasional | El modelo aprende un rango operativo normal claro |
Flujos de trabajo sensibles | Los equipos prefieren una detección conservadora anclada en datos de confianza |
Baja frecuencia de anomalías | No hay suficientes ejemplos positivos para el aprendizaje supervisado |
Deep learning
El deep learning cobra relevancia cuando la estructura es tan compleja que los modelos más simples no la captan. Las señales de series temporales, la telemetría multivariante y el comportamiento de alta dimensionalidad suelen entrar en esta categoría.
Para entornos industriales y de series temporales de pipelines, esta revisión de métodos de detección de anomalías señala que los predictores LSTM combinados con Variational Mode Decomposition pueden extraer componentes periódicos antes de detectar anomalías en series temporales residuales. Dicho de forma sencilla, el modelo separa primero el comportamiento normal repetitivo de lo que sobra y, después, comprueba si ese resto parece sospechoso.
El deep learning es útil cuando:
las secuencias importan más que los registros aislados
la periodicidad y el drift coexisten
la señal abarca muchas variables correlacionadas
También implica un mayor cómputo, más ajuste y una mayor carga de monitorización. Si un método más simple detecta el problema con una calidad de señal aceptable, suele ser la mejor opción para producción.
Ensembles en la práctica
Muchos sistemas empresariales acaban utilizando métodos de ensemble, aunque los equipos no los describan así. Combinan varios detectores o etapas de puntuación para reducir el ruido y mejorar la fiabilidad.
Un ensemble práctico podría incluir un filtro estadístico de referencia, una puntuación de anomalías aprendida y una regla de validación. Otro podría combinar un autoencoder con umbrales basados en aislamiento. En producción, los ensembles suelen imponerse porque respetan la complicada realidad de que un solo detector rara vez gestiona bien todas las tablas, cadencias y modos de fallo.
Cómo elegir el algoritmo adecuado para cada caso
No existe un algoritmo de detección de anomalías que sea el mejor en todos los casos. Solo existe el algoritmo que se ajusta a la estructura de sus datos, la forma de las anomalías, el requisito de latencia y el proceso de revisión. Los equipos se meten en problemas cuando estandarizan un método porque funcionó una vez.
La distinción más importante es si necesita detectar anomalías globales o anomalías locales. Suena académico hasta que se despliega a escala. Entonces se convierte en la diferencia entre detectar el drift real y pasarlo por alto durante meses.
La diferencia entre local y global importa
Algunas anomalías se sitúan muy lejos del conjunto de datos completo. Son valores atípicos globales. Otras solo resultan extrañas dentro de un vecindario o clúster local. Son valores atípicos locales.
Esa distinción cambia la elección del modelo. Según una investigación del Journal of Machine Learning Research, la elección del algoritmo debe depender de si las anomalías son locales o globales. Cuando los datos contienen varios clústeres de densidad, k-nearest neighbors supera a isolation forest, mientras que isolation forest es más adecuado para anomalías puramente globales.
Esto es directamente relevante para los datos empresariales. El comportamiento de los clientes suele agruparse por región, producto o canal. Las métricas de los equipos se agrupan por modo de funcionamiento. La actividad de los usuarios se agrupa por rol. Un punto puede parecer normal a nivel global y, aun así, ser muy anómalo dentro de su propio segmento.
Guía rápida de algoritmos de detección de anomalías
Algoritmo | Tipo | Ideal para | Consideración clave |
|---|---|---|---|
Isolation Forest | Detección de valores atípicos globales | Anomalías claras y aisladas en datos tabulares | Puede pasar por alto anomalías locales dentro de clústeres densos |
k-Nearest Neighbors | Basado en densidad local y distancia | Conjuntos de datos agrupados en los que importa el comportamiento del vecindario | Sensible al escalado y a la definición de distancia |
Local Outlier Factor | Basado en densidad local | Detección de registros con una densidad local mucho menor que la de los puntos cercanos | Más difícil de explicar a revisores no técnicos |
Z-score | Baseline estadística univariante | Comprobaciones rápidas de métricas individuales con distribuciones relativamente estables | Débil en relaciones multivariantes |
ECOD | Baseline de valores atípicos tabulares | Baseline ligera para flujos de trabajo de calidad de datos | Mejor como referencia comparativa que como respuesta universal |
LSTM | Modelo secuencial | Series temporales con dependencias temporales y patrones recurrentes | Mayor coste operativo y carga de ajuste |
Autoencoder | Basado en reconstrucción | Aprendizaje de patrones normales de alta dimensionalidad | Los umbrales y la gestión del drift requieren cuidado |
Qué funciona en los casos empresariales habituales
Para la monitorización de la calidad de datos tabulares, las baselines simples siguen teniendo su lugar. Isolation Forest y ECOD son puntos de partida prácticos para columnas, métricas a nivel de fila y comprobaciones del estado de los conjuntos de datos.
Para los datos de clientes o productos agrupados en clústeres, los métodos de vecindario suelen merecer pruebas tempranas. Si su conjunto de datos tiene varios regímenes operativos, los enfoques de densidad local pueden sacar a la luz anomalías que los métodos globales suavizan.
Para las series temporales, elija en función de cuánta memoria requiere el patrón. Las comprobaciones de desviaciones a corto plazo pueden funcionar con métodos estadísticos más simples. Las dependencias más largas, la periodicidad y el comportamiento residual pueden justificar modelos recurrentes o basados en reconstrucción. Si su equipo está evaluando diseños específicos para secuencias, esta guía sobre la detección de anomalías en series temporales es una referencia operativa útil.
No elija un algoritmo porque sea popular. Elíjalo porque su modo de fallo es aceptable para sus datos.
Las contrapartidas que los equipos subestiman
El algoritmo no es todo el sistema. El éxito en producción depende de varios detalles menos vistosos:
Escalado y preprocesamiento: los modelos basados en distancias fallan cuando las features no están normalizadas.
Interpretabilidad: los equipos de seguridad y los data stewards suelen necesitar un motivo, no solo una puntuación.
Cadencia de reentrenamiento: un buen detector se degrada si el comportamiento de referencia cambia y nadie lo actualiza.
Flujo de revisión: un modelo algo más débil con un triaje más limpio suele superar a un modelo más potente que inunda Slack.
Por eso la selección del algoritmo debe hacerse junto con el diseño operativo, no antes.
Cómo medir el éxito y evitar falsas alarmas
Lunes por la mañana: el detector salta con 600 registros. Doce requieren actuación. El resto son llegadas tardías normales, cambios de catálogo planificados y eventos de negocio puntuales. Si el equipo tiene que revisar ese montón cada día, el modelo está fallando aunque su puntuación offline pareciera buena.

Por qué la accuracy induce a error
La accuracy oculta la estructura de costes de la detección de anomalías. En conjuntos de datos desequilibrados, un modelo puede clasificar casi todo como normal y, aun así, parecer sólido sobre el papel. Eso no ayuda al analista de fraude, al data steward ni al ingeniero de plataforma que necesitan que el sistema detecte fallos poco frecuentes sin generar ruido constante.
Para este tipo de desequilibrio de clases, la precision, el recall y el F1 son las métricas de partida habituales. Las directrices de machine learning de Google sobre métricas de clasificación para conjuntos de datos desequilibrados son una referencia práctica si su equipo necesita una base común para la evaluación.
Las métricas que importan en producción
Cada métrica responde a una pregunta operativa distinta.
Precision: de las alertas enviadas a una persona o a un sistema downstream, ¿cuántas merecían una actuación?
Recall: de todas las anomalías, ¿cuántas detectó el detector?
F1 score: ¿cuál es el equilibrio entre precision y recall cuando necesita una sola cifra para comparar modelos?
Esas cifras deben corresponderse con el coste para el negocio. En los pagos, un recall bajo significa fraude no detectado. En las operaciones de datos, una precision baja significa que las colas de alertas se llenan, los equipos de guardia dejan de confiar en el detector y los incidentes reales esperan más tiempo a ser revisados.
La configuración del umbral importa tanto como la elección del modelo. Los equipos a menudo pasan semanas comparando algoritmos y luego aplican un umbral por defecto que nunca se ajustó a su capacidad de revisión ni a la gravedad de los incidentes.
Evalúe el proceso de alertas, no solo el modelo
Los conjuntos de prueba offline son útiles, pero pasan por alto una realidad empresarial habitual. Muchas anomalías solo son anómalas en su contexto.
Un cambio de esquema puede corresponder a una versión válida. Un pico de pedidos puede deberse a una promoción planificada. Un lote con retraso puede ajustarse a un SLA de un proveedor que cambió el trimestre pasado. El detector puede señalar el patrón correctamente y, aun así, generar una mala alerta si el sistema carece de contexto de negocio.
Un proceso de evaluación mejor incluye:
Muestras de alertas revisadas por las personas responsables de la decisión downstream.
Puntuación por segmentos, para que un promedio no oculte fallos en una región, un nivel de clientes o un sistema de origen de alto riesgo.
Pruebas de umbrales frente a la capacidad de revisión, para confirmar que el volumen diario de alertas es gestionable.
Captura de feedback, para que los falsos positivos y los verdaderos positivos confirmados mejoren los ajustes futuros.
Para los equipos que construyen esa capa de revisión, esta guía sobre métodos de identificación de valores atípicos resulta útil para comparar comprobaciones estadísticas simples con detectores basados en ML durante la validación.
Un recall alto con una precision baja provoca fatiga en los operadores. Una precision alta con un recall bajo crea puntos ciegos. Un detector útil se ajusta al modelo de respuesta del negocio.
Utilice baselines que resistan una auditoría
Empiece con una baseline que el equipo pueda explicar a auditoría, seguridad y operaciones. Puede ser una regla de percentiles, un umbral estacional o un modelo no supervisado sencillo con una lógica de umbrales clara. Si un detector más complejo solo mejora un benchmark offline pero dificulta el triaje, todavía no tiene cabida en la ruta de alertas de producción.
Esto importa aún más en entornos empresariales en los que los modelos se ejecutan dentro del data warehouse o del lakehouse para evitar copiar datos sensibles a sistemas independientes. La ejecución dentro de la base de datos puede simplificar los controles de privacidad y reducir el movimiento de registros regulados, pero también obliga a los equipos a elegir métricas, umbrales y flujos de revisión que funcionen con las herramientas de observabilidad existentes. El éxito no consiste solo en detectar anomalías. Consiste en detectar las anomalías correctas, con un volumen de revisión que la organización pueda sostener.
Consideraciones sobre el despliegue y la monitorización en la empresa
La mayoría de lo que se escribe sobre la detección de anomalías con machine learning se detiene en la selección del modelo. Los equipos empresariales suelen fallar más tarde, durante el despliegue. Descubren que el modelo requiere demasiado movimiento de datos, incumple las expectativas de privacidad, añade carga operativa o genera umbrales que dejan de ser relevantes.
No son problemas marginales. Son el verdadero trabajo de implementación.
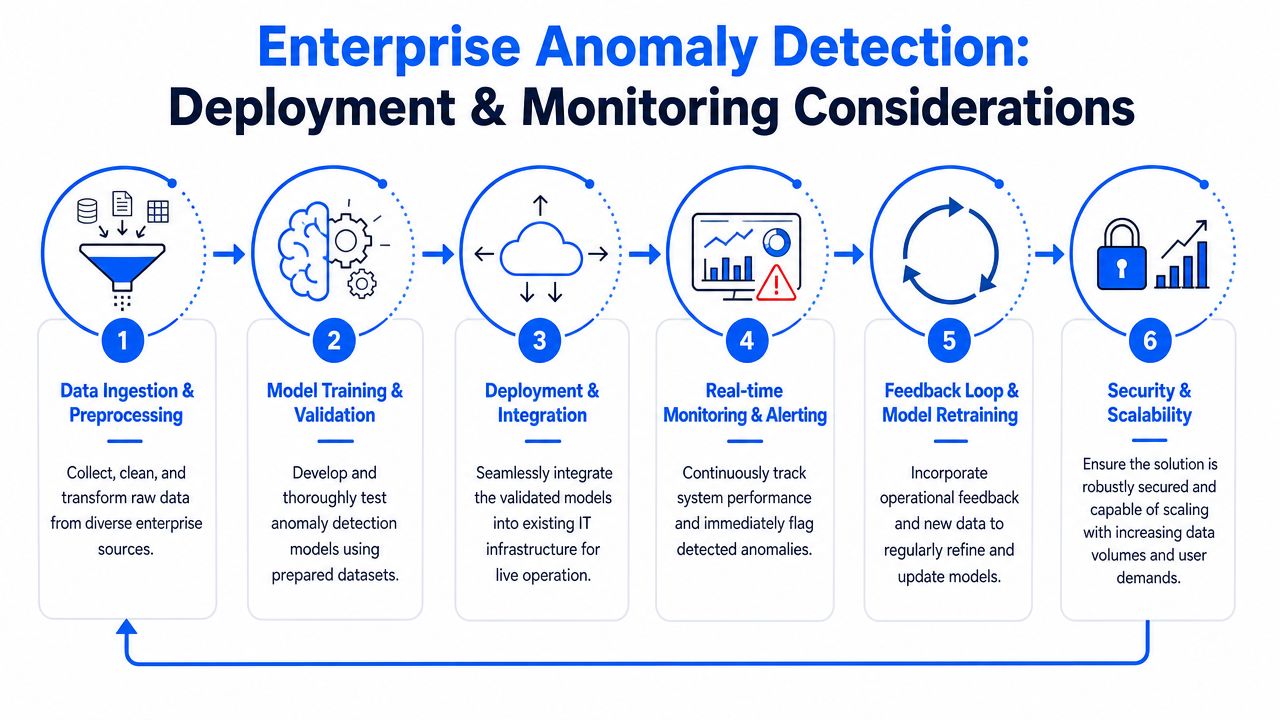
Tiempo real frente a procesamiento por lotes
No todas las anomalías necesitan una puntuación inmediata. Algunos procesos de negocio pueden tolerar la detección por lotes, en la que el sistema revisa ventanas horarias o diarias. Otros no. La revisión del fraude, la telemetría operativa, los feeds de datos sujetos a SLA y los dashboards ejecutivos suelen necesitar ciclos de feedback mucho más cortos.
La contrapartida es sencilla:
Modo de despliegue | Funciona bien cuando | Contrapartida |
|---|---|---|
Puntuación en tiempo real | El retraso es costoso o sensible al riesgo | Mayor complejidad de infraestructura y operativa |
Detección por lotes | Las tendencias importan más que la respuesta inmediata | Los problemas pueden descubrirse después de que afecten a los sistemas downstream |
Los equipos suelen sobrestimar su necesidad de tiempo real y subestimar el coste de mantenerlo. Si la acción de negocio sigue produciéndose a la mañana siguiente, la puntuación nocturna puede ser suficiente.
La ejecución dentro de la base de datos cambia la ecuación económica
En los entornos empresariales, dónde se ejecuta el modelo puede importar tanto como lo que hace. Llevar los datos de producción a un stack de monitorización externo genera latencia adicional, revisiones de gobernanza, costes y exposición. También duplica la lógica entre sistemas.
Ejecutar el análisis dentro de la base de datos o del data warehouse del cliente resuelve a la vez varios problemas prácticos:
La privacidad se refuerza: los registros sensibles permanecen en el entorno controlado.
El rendimiento mejora: menos movimiento de datos significa menos cuellos de botella.
Las operaciones se simplifican: los equipos evitan exportar grandes conjuntos de métricas solo para puntuarlos en otro lugar.
La gobernanza es más sencilla: los equipos de seguridad y cumplimiento normativo suelen preferir arquitecturas con menos copias de los datos.
Este es uno de los puntos en los que la arquitectura del producto importa. Por ejemplo, digna se basa en el cálculo de métricas y el aprendizaje de baselines dentro de la base de datos, y se ejecuta en entornos de nube privada u on-premises, lo que lo hace relevante para los equipos que necesitan detección de anomalías, monitorización de la puntualidad, seguimiento de esquemas y validación sin que el proveedor acceda a los conjuntos de datos de producción.
Los umbrales dinámicos no son opcionales
Los umbrales estáticos fallan cuando las distribuciones cambian. Ese problema se agrava a escala empresarial, porque cada conjunto de datos evoluciona de forma distinta. Las nuevas geografías, los nuevos canales, los nuevos calendarios de negocio y los cambios en los patrones de uso invalidan los límites ajustados a mano.
Trabajos recientes resumidos en esta investigación sobre umbrales dinámicos para anomalías destacan una respuesta práctica: los sistemas basados en autoencoders combinados con isolation forest pueden utilizar umbrales sensibles a los valores atípicos para adaptar los umbrales dinámicamente en función del comportamiento normal aprendido. Esto es importante porque el ajuste manual de umbrales no escala en grandes entornos de observabilidad.
Monitorizar el propio detector
Un detector de anomalías es otro sistema de producción. Necesita su propia monitorización.
Vigile el drift de las entradas: si los esquemas o las distribuciones upstream cambian, las puntuaciones de anomalías pueden perder su sentido.
Haga seguimiento del volumen de alertas: los aumentos repentinos pueden indicar incidentes reales o una degradación del detector.
Mida los resultados de las revisiones: si los analistas descartan repetidamente las alertas de un detector, reentrénelo o sustitúyalo.
Versione con cuidado la lógica del modelo: los cambios en la ingeniería de features o en las ventanas pueden alterar el comportamiento de las alertas tanto como los cambios de algoritmo.
Un detector que no se monitoriza se convierte en otro fallo silencioso a punto de producirse.
La observabilidad va más allá de las anomalías
Las configuraciones empresariales más útiles no tratan la detección de anomalías como una funcionalidad independiente. La vinculan a la puntualidad, la validación y la monitorización de esquemas. Una anomalía de volumen gana contexto cuando el mismo sistema muestra también una carga retrasada de una fuente o un cambio de tipo de una columna. El análisis de la causa raíz se acelera porque los operadores no tienen que saltar entre herramientas desconectadas.
Esa visión más amplia es lo que hace que la detección de anomalías sea accionable y no simplemente interesante.
Buenas prácticas y errores habituales que conviene evitar
Los equipos obtienen mejores resultados cuando tratan la detección de anomalías con machine learning como una disciplina operativa y no como un experimento de modelado. Los despliegues más sólidos suelen ser aburridos en el buen sentido. Objetivo claro, entradas limpias, responsabilidades definidas y feedback medido.
Buenas prácticas que funcionan en producción
Empiece por una consecuencia de negocio: vincule la detección a un fallo real, como previsiones erróneas, informes con retraso, revisión del fraude o entradas de modelos corruptas.
Perfile los datos antes de elegir el modelo: utilice el escalado de features, el tratamiento de valores ausentes y la ingeniería de features pertinente cuando sea necesario. Tal como se resume en esta visión general de los métodos de detección de anomalías y el preprocesamiento, la normalización, la imputación, la ingeniería de features y el ajuste de hiperparámetros son partes fundamentales de los flujos de trabajo eficaces de detección de anomalías.
Utilice primero baselines sencillas: un método estadístico básico o basado en árboles puede revelar si la señal existe antes de invertir en arquitecturas más pesadas.
Defina quién es responsable de revisar las alertas: alguien tiene que confirmar si una anomalía señalada es real y si la vía de respuesta funcionó.
Reentrene de forma deliberada: las baselines envejecen. Establezca un calendario explícito de reentrenamiento y revisión de umbrales vinculado a los cambios en los datos, no a las buenas intenciones.
Errores que generan ruido y desconfianza
Algunos errores aparecen una y otra vez.
Un mismo algoritmo para todo: los eventos de clientes, las transacciones financieras, los streams de sensores y las métricas de calidad a nivel de tabla rara vez se comportan de la misma manera.
Ignorar el contexto: un pico sin información sobre el momento de negocio, el calendario o el segmento suele generar falsas alarmas.
Omitir el preprocesamiento: los métodos basados en distancias y en densidad se degradan rápidamente con entradas sin escalar o sucias.
Tratar las alertas como verdad definitiva: una puntuación de anomalía es una ayuda para la toma de decisiones, no una prueba de la gravedad del incidente.
Olvidar a los usuarios downstream: si los analistas, los operadores o los data stewards no pueden entender el resultado, el sistema no influirá en las decisiones.
Una checklist práctica
Antes de llevar un detector a producción, confirme que estas preguntas tienen respuestas claras:
Comprobación | Por qué importa |
|---|---|
¿Qué acción de negocio sigue a una alerta? | La detección sin respuesta genera ruido |
¿Qué tipo de anomalía queremos detectar? | Los casos puntuales, contextuales y colectivos necesitan una lógica distinta |
¿Necesitamos sensibilidad local o global? | Esto cambia de forma sustancial la selección del algoritmo |
¿Cómo evaluaremos la calidad? | La precision, el recall y el F1 son más útiles que la accuracy |
¿Dónde se ejecutará la puntuación? | La arquitectura de despliegue afecta a la privacidad, el coste y la latencia |
¿Quién revisa y etiqueta los casos límite? | El feedback mantiene la utilidad del sistema a lo largo del tiempo |
La detección de anomalías con machine learning se gana la confianza cuando detecta los problemas pronto, ofrece explicaciones suficientes para actuar y se adapta a la realidad de las operaciones de datos empresariales. Eso suele implicar menos obsesión por la novedad de los modelos y más disciplina en torno a la arquitectura, los ciclos de revisión y la integración con la observabilidad.
Si su equipo necesita una detección de anomalías que se ajuste a las restricciones empresariales, digna es una opción que merece la pena evaluar. Se centra en las anomalías de datos, la validación, la puntualidad y el seguimiento de esquemas con ejecución dentro de la base de datos en entornos controlados por el cliente, algo útil cuando la privacidad, la simplicidad operativa y la integración con la observabilidad importan tanto como el propio modelo de detección.
Para obtener baselines aprendidas sobre volúmenes de tablas, valores ausentes y distribuciones de valores sin umbrales ajustados a mano, descubra cómo digna Data Anomalies ejecuta la detección de anomalías dentro de su base de datos.
Preguntas frecuentes
¿Qué es la detección de anomalías con machine learning?
Sustituye las reglas escritas a mano por baselines aprendidas: el sistema modela el comportamiento esperado y señala las desviaciones significativas, de modo que detecta errores silenciosos como registros duplicados, marcas de tiempo tardías o distribuciones que se desvían. El artículo cita investigaciones que muestran que los métodos de ML superan a los enfoques estadísticos tradicionales entre un 8 % y un 12 % en accuracy, especialmente con datos multivariantes y de alta dimensionalidad.
¿Qué son las anomalías puntuales, contextuales y colectivas?
Las anomalías puntuales son valores individuales que parecen incorrectos, como una carga del data warehouse con un recuento de registros imposible. Las anomalías contextuales dependen del momento o de las condiciones, como un gran volumen de inicios de sesión a las 3 de la madrugada. Las anomalías colectivas son grupos de registros de apariencia inofensiva que forman un patrón erróneo, como un ataque coordinado de bots o un schema drift en varios campos.
¿Debo utilizar detección de anomalías supervisada o no supervisada?
La no supervisada suele ser la opción práctica por defecto, porque las anomalías etiquetadas son escasas y caras. Los métodos supervisados encajan cuando existen incidentes revisados y los tipos de fallo se repiten, como en la revisión del fraude o de siniestros. La configuración k-means no supervisada de Netdata con k=2 logró una reducción del 99 % de los falsos positivos al exigir consenso entre varios modelos.
¿Es mejor isolation forest o k-nearest neighbors para la detección de anomalías?
Depende de si las anomalías son globales o locales. Una investigación del Journal of Machine Learning Research concluyó que k-nearest neighbors supera a isolation forest cuando los datos contienen varios clústeres de densidad, mientras que isolation forest es adecuado para valores atípicos puramente globales. Los datos de clientes agrupados por región o canal suelen requerir el enfoque local, basado en vecindarios.
¿Cómo se mide el rendimiento de un detector de anomalías?
Olvide la accuracy, que parece sólida con datos desequilibrados incluso cuando un modelo clasifica casi todo como normal. Utilice precision, recall y F1, y después pruebe los umbrales frente a la capacidad de revisión real: un detector que salta con 600 registros cuando solo doce requieren actuación está fallando, por buena que pareciera su puntuación offline.



