Calidad de datos ETL: una guía práctica para canalizaciones confiables
|
6
minuto de lectura

Su pipeline se puso en verde a las 2:14 AM. Al llegar el desayuno, el equipo de finanzas está contemplando líneas de ingresos que no tienen sentido, los analistas se preguntan si el almacén de datos está roto y su herramienta de orquestación sigue insistiendo en que todo se ejecutó correctamente. Ese desfase entre la salud del trabajo (job health) y la salud de los datos (data health) es donde la calidad de datos en ETL suele fallar en la práctica.
La parte difícil no es ejecutar validaciones. Es diseñar controles que detecten cuándo los datos cambiaron de comportamiento, no solo cuándo falló una tarea. Los pipelines de ETL pueden terminar a tiempo, alcanzar el conteo de filas esperado y, aun así, transferir datos corruptos, obsoletos o estructuralmente incompatibles a los sistemas downstream; por eso la calidad debe medirse en los datos mismos y no en la bandera de éxito asociada al trabajo.
Tabla de Contenidos
Cuando los Pipelines en Verde Producen Datos Rotos
Por qué el estado de ejecución no es suficiente
Qué suele romperse primero
Las Cinco Dimensiones de Calidad que Todo Pipeline de ETL Debe Monitorear
Por qué los cinco pilares deben funcionar juntos
Qué detecta realmente cada dimensión
Validación Basada en Reglas Frente a Detección de Anomalías Impulsada por IA
Dónde gana cada enfoque
Cómo combinarlos en capas sin crear caos de alertas
Mecánicas de Validación a Nivel de Registro que Detectan Defectos
Use umbrales, no solo conteos
Validaciones que dan resultados en la práctica
Monitoreo de Timeliness y Ventanas de Entrega Esperadas
Desviación del Esquema (Schema Drift) y Cómo Detectarla Antes de que Rompa los Sistemas Downstream
Detecte la desviación en el límite
Cómo responder sin convertir cada cambio en una interrupción del servicio
Construcción de una Capa Práctica de Calidad ETL en la Práctica
Cómo suele madurar la infraestructura de calidad
Quién es responsable de cada parte en la infraestructura
Conceptos Erróneos Comunes y una Lista de Verificación Práctica de Calidad
Una lista de verificación que puede aplicar esta semana
Cuando los Pipelines en Verde Producen Datos Rotos
Una ejecución en verde puede parecer correcta hasta que alguien abre el panel de control y ve números que no coinciden con la realidad. La capa ETL puede completarse con éxito mientras un sistema de origen cambia un campo decimal, un archivo llega medio vacío o una coerción de tipos convierte valores válidos en algo que todavía se carga pero que ya no significa lo que solía significar. Para cuando finanzas, operaciones o BI detectan el problema, el incidente del pipeline ya es noticia vieja y la limpieza se ha trasladado a los sistemas downstream.
La investigación histórica sobre ETL es contundente respecto al origen de estos fallos. Un estudio sobre implementaciones de ETL reveló que los trabajos de ETL que fallan a mitad de camino, los sistemas bloqueados durante la ejecución y el hecho de que los usuarios no encuentren los datos en el destino porque las claves primarias se transformaron incorrectamente se encontraban entre los problemas más comunes, y esos mismos procesos causaron problemas de precisión, Timeliness, credibilidad y consistencia de representación (ETL data-quality failure study). La lección es sencilla: el pipeline mismo puede introducir el defecto, incluso si el sistema de origen parecía correcto.
Por qué el estado de ejecución no es suficiente
Las herramientas de orquestación informan principalmente si una tarea se ejecutó, no si los datos se comportaron correctamente. Un trabajo puede completarse a tiempo y aun así enviar cargas parciales, omitir una partición o forzar la conversión de valores durante la transformación. Por eso los controles deben estar en la capa de datos, no solo en la capa de flujo de trabajo.
Regla práctica: trate cada ejecución exitosa de ETL como no verificada hasta que los datos superen las comprobaciones de frescura, esquema y nivel de registro.
El coste de hacer esto mal no es abstracto. Gartner estima que la mala calidad de los datos cuesta a las organizaciones una media de 12,9 millones de dólares al año, y los resúmenes del sector señalan que los datos incorrectos pueden provocar una pérdida de ingresos del 15% al 25% en algunas empresas, razón por la cual los controles de calidad tempranos en el ETL son tan importantes (costs of poor data quality). Eppler y Helfert también describieron 23 tipos de costes distintos vinculados a datos de baja calidad, incluidos el mantenimiento, el exceso de mano de obra, la reintroducción de datos, la pérdida de ingresos, la pérdida de clientes y el reprocesamiento. También identificaron 10 categorías de costes de aseguramiento de la calidad de datos, como la inspección, la prevención de defectos, la reparación, la formación y la mejora de procesos. En pocas palabras, la factura llega tanto si invierte en calidad como si no.
Qué suele romperse primero
Los fallos que más duelen son los silenciosos. Un archivo llega tarde pero aun así se carga. Un sistema de origen añade una columna y su analizador la ignora. Un campo numérico se convierte en texto y el almacén de datos lo acepta tras la conversión de tipos. Ninguno de esos problemas detiene necesariamente el trabajo, pero contaminan los datos.
La respuesta correcta es un monitoreo por capas, no la esperanza. Necesita señales de comportamiento que le indiquen cuándo el pipeline está produciendo datos que ya no coinciden con la forma, el tiempo o la distribución que espera. Eso significa mirar más allá de la ejecución y analizar las propiedades de los propios registros.
Las Cinco Dimensiones de Calidad que Todo Pipeline de ETL Debe Monitorear
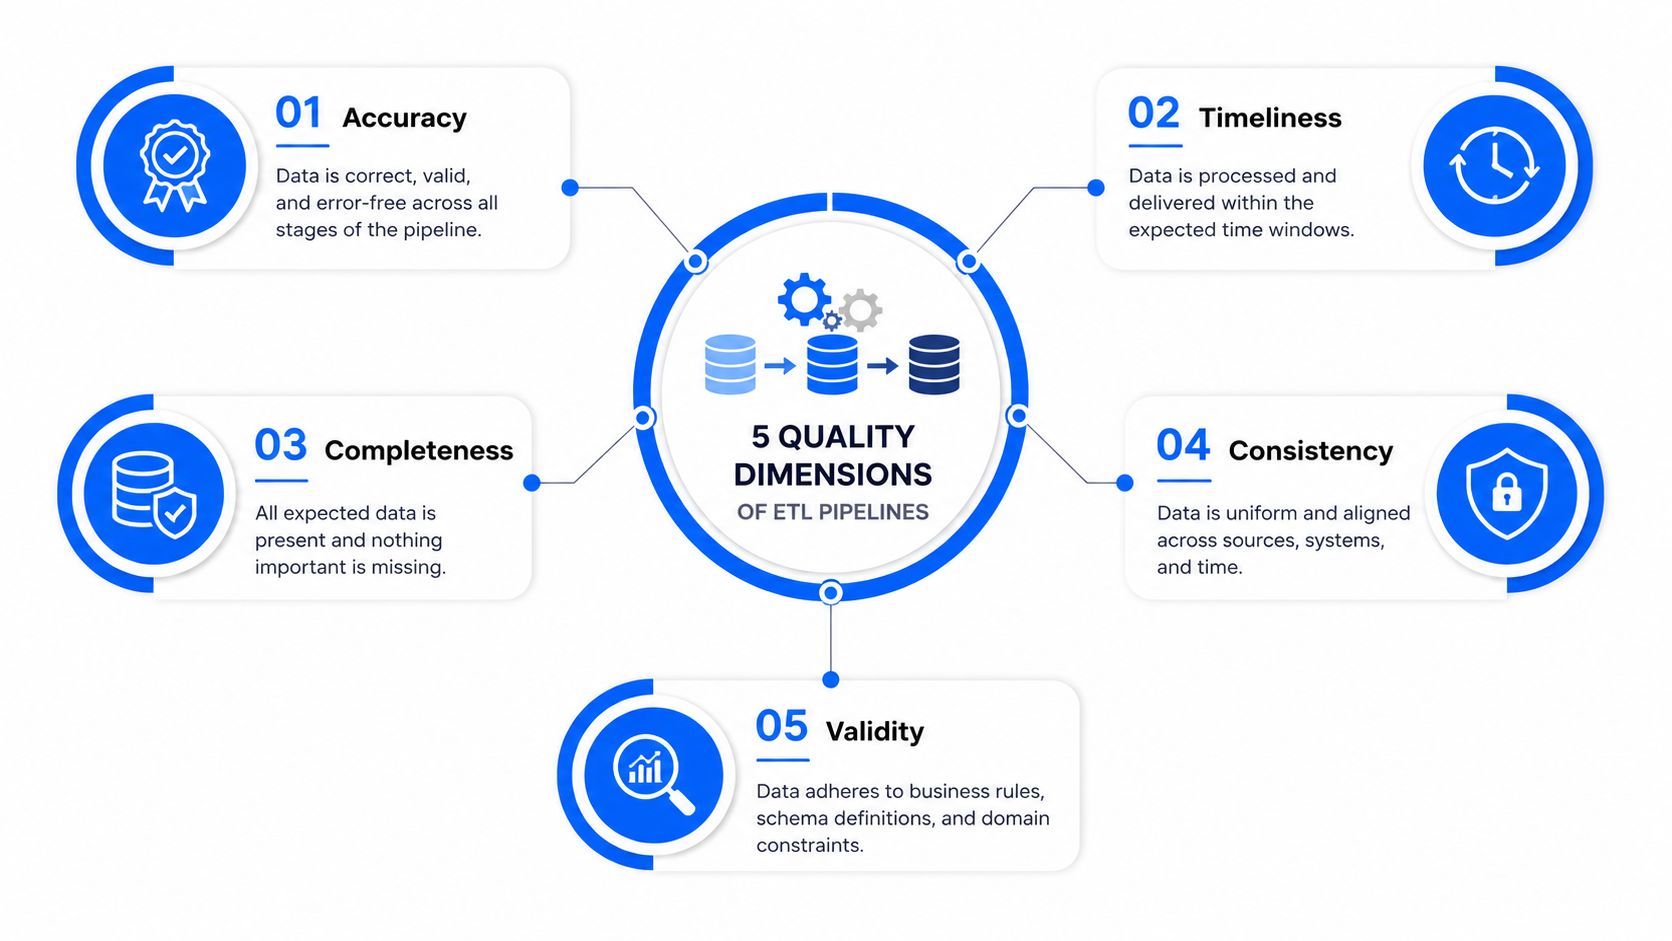
La calidad de ETL funciona mejor cuando se deja de tratar como una puntuación única. La investigación moderna en Observability enmarca el problema en torno a la frescura, el esquema, el volumen, la distribución y el linaje, y ese desglose se alinea perfectamente con las dimensiones académicas más tradicionales de precisión, completitud, consistencia, Timeliness, validez y unicidad (modern observability pillars, academic overview of ETL quality dimensions). Cada una de ellas detecta un modo de fallo diferente, y ninguna sustituye a las demás.
La frescura le indica si está llegando el registro válido más reciente. El esquema detecta la desviación estructural, incluyendo nuevas columnas, campos eliminados y cambios de tipo. El volumen señala caídas o picos repentinos que sugieren un truncamiento o duplicación de datos. La distribución revela cambios más sutiles, como variaciones en la tasa de nulos o rangos de valores desviados. El linaje vincula un problema con el origen y con el paso de transformación que lo introdujo.
Por qué los cinco pilares necesitan funcionar juntos
Si solo vigila el esquema, no detectará datos obsoletos pero estructuralmente válidos. Si solo vigila el volumen, una carga incorrecta puede pasar desapercibida porque el recuento de filas parece normal. Si solo vigila la frescura, puede enviar un archivo estructuralmente incorrecto justo a tiempo. Por eso se trata de señales de comportamiento y no de casillas de verificación intercambiables.
Un buen recurso para los equipos que están desarrollando esta disciplina es training data quality standards, especialmente si se intenta alinear a analistas, ingenieros y responsables de governance bajo las mismas expectativas. El objetivo no es añadir más trabas, sino hacer visible el modo de fallo adecuado antes de que el almacén de datos sea el único lugar donde se detecte.
También mantengo una referencia interna sencilla para los equipos que desean un desglose más formal de los pilares en digna's dimensions of data quality. Ese tipo de vocabulario compartido es importante cuando diferentes equipos utilizan las mismas palabras para referirse a cosas distintas.
Qué detecta realmente cada dimensión
La Frescura detecta entregas ausentes o retrasadas antes de que los paneles de control queden desactualizados.
El Esquema detecta cambios estructurales no anunciados que rompen los sistemas de consumo o corrompen los mapeos.
El Volumen detecta truncamientos, duplicaciones y cargas parciales.
La Distribución detecta desviaciones en las tasas de nulos, rangos de valores y cardinalidad que las reglas fila por fila suelen pasar por alto.
El Linaje le ayuda a rastrear el fallo hasta un sistema de origen, un trabajo o un paso de transformación.
Un almacén de datos solo parece saludable cuando se comprueba la capa correcta.
Las implementaciones de Observability más sólidas no dependen de una sola dimensión para hacer todo el trabajo. Utilizan cada dimensión como una perspectiva diferente sobre el mismo pipeline, de modo que el problema pueda detectarse donde se originó y no después de que haya afectado a los informes de los sistemas downstream.
Rule-Based Validation Versus AI-Driven Anomaly Detection
La validación basada en reglas sigue siendo esencial, pero solo cubre lo que ya se sabe que se puede esperar. Si un campo de ingresos nunca debe ser negativo, si un código de país debe pertenecer a un conjunto definido o si debe existir una clave externa antes de cargar una fila de hechos, una regla debe obligar a cumplirlo. Eso es control estricto, y el control estricto es positivo.
El problema es que las reglas no ven el comportamiento que cambia sin violar una restricción estricta. Un origen puede empezar a enviar registros tarde, un campo puede volverse más ruidoso, una unión puede perder claves coincidentes o una distribución puede desviarse lo suficiente como para dañar la analítica mientras sigue superando cada comprobación estática. Ahí es donde la detección de anomalías se gana su lugar. Para obtener una visión más amplia de ese patrón, vale la pena leer la ETL anomaly detection guide junto con digna's anomaly detection approach.
El equilibrio práctico es sencillo. Las reglas son precisas y fáciles de explicar. La detección de anomalías cubre un territorio más amplio, pero necesita un punto de referencia y puede generar ruido si no se gestionan cuidadosamente la propiedad de las alertas y la sintonización del sistema. En mi experiencia, los equipos se meten en problemas cuando tratan la detección de anomalías como un sustituto de las comprobaciones deterministas. No lo es.
Dónde gana cada enfoque
Dimensión | Validación Basada en Reglas | Detección de Anomalías Impulsada por IA |
|---|---|---|
Coste de configuración | Menor para restricciones conocidas | Mayor porque requiere un comportamiento de referencia histórico |
Cobertura | Estrecha, pero exacta | Más amplia, detecta desviaciones y patrones inusuales |
Carga de mantenimiento | Crece a medida que se acumulan las reglas | Crece cuando no se gestionan las referencias, los responsables y los ajustes |
Tiempo de respuesta para obtener insights | Inmediato para fallos definidos | Rápido una vez que se aprenden los patrones, pero no siempre es instantáneo el primer día |
Puntos ciegos | Imprevistos desconocidos y desviaciones de comportamiento | Invariantes de negocio estrictas y requisitos de políticas explícitos |
Cómo combinarlos en capas sin crear caos de alertas
Comience con reglas para invariantes que nunca desearía relajar. Luego añada una capa de detección de anomalías encima para las métricas que tienden a desviarse, como el volumen, las tasas de nulos y las correlaciones de campos. Si un registro falla en cualquiera de las capas, diríjalo a una cuarentena o a una cola de revisión en lugar de permitir que continúe hacia los sistemas downstream.
Este enfoque también hace que sus controles sean explicables. Los ingenieros pueden depurar una restricción fallida. Los analistas pueden entender por qué cambió una línea de base. Los equipos de governance obtienen un registro de lo que se bloqueó y por qué. Cuando se hace bien, el sistema se siente menos como un muro de comprobaciones frágiles y más como un conjunto calibrado de barreras de seguridad.
Mecánicas de Validación a Nivel de Registro que Detectan Defectos
Las comprobaciones a nivel de registro funcionan solo cuando se asocian al impacto de negocio, no solo a un estado de aprobado o fallido. La ausencia de un campo con opción a nulo en un conjunto de datos de bajo riesgo no es lo mismo que la falta de una clave en una tabla de hechos de ingresos. El control tiene que reflejar esa diferencia, o de lo contrario se vuelve demasiado estricto para sobrevivir o demasiado laxo para ser útil.
El trabajo de ETL clínico demuestra lo rápido que puede disminuir la calidad cuando las definiciones son imprecisas. En un estudio hospitalario, las tasas de error de extracción manual y de exportación automatizada variaban en función de si se excluían los campos ambiguos, lo que apunta a una lección sencilla: la automatización no garantiza la calidad, y la claridad en las definiciones de los datos modifica materialmente las tasas de defectos.
Use umbrales, no solo conteos
Una tasa de fallo del 0,1% en una carga de 50 millones de filas representa un problema operativo diferente que esa misma tasa en un lote de 1.000 filas. El primero puede ocultar decenas de miles de filas defectuosas. El segundo puede ser una muestra pequeña pero crítica donde incluso un solo defecto importa.
Por eso son importantes los niveles de gravedad. Advertir, poner en cuarentena y detener le dan al pipeline margen para reaccionar sin volverse frágil y permisivo al mismo tiempo.
La mecánica de validación debe seguir siendo concreta. Un artículo de validación de ETL de 2021 recomienda el recuento correcto de columnas, tipos de datos y restricciones de columna, además de la presencia y el orden de las columnas para archivos planos, junto con restricciones de clave primaria, clave externa e índice único (validation mechanics article). Esto sigue siendo la columna vertebral de una validación a nivel de registro confiable.
Validaciones que dan resultados en la práctica
Detección de nulos: Analice el perfil de las columnas y establezca rangos de densidad aceptables, especialmente para los campos comerciales obligatorios.
Cumplimiento de claves: Rechace las claves primarias duplicadas y las claves externas huérfanas antes de que contaminen las uniones downstream.
Validación de dominio: Utilice valores controlados para campos como los códigos de país ISO y otros enums finitos.
Umbrales de negocio: Exprese los rangos de tolerancia de ingresos, los límites de tasa de devolución o los umbrales de cancelación como porcentajes de las filas entrantes.
Hechos de llegada tardía: Valide con ventanas de fechas de vigencia para que los eventos se ubiquen en el intervalo de tiempo correcto.
Prefiero poner en cuarentena las filas ambiguas antes de permitir que alteren el conjunto de datos de confianza. La cuarentena brinda a los productores de datos la oportunidad de corregir el origen o el mapeo sin convertir el almacén de datos en un colector de basura.
Regla operativa: si el equipo no puede explicar por qué es seguro ignorar una fila fallida, entonces no es seguro ignorarla.
Un punto práctico. No escriba reglas para cada caso extremo. Comience con los campos que impulsan las finanzas, el Compliance, los flujos de trabajo de los clientes y el entrenamiento de modelos. Ahí es donde los defectos de calidad se vuelven costosos más rápidamente.
Tipo de Validación | Qué Detecta | Guía de Umbrales | Acción Recomendada |
|---|---|---|---|
Comprobaciones de nulos | Ausencia de valores requeridos | Definido por la criticidad del campo y el tamaño del conjunto de datos | Advertir para campos de bajo riesgo, cuarentena para campos críticos |
Restricciones de clave | Duplicados y relaciones rotas | Tolerancia cero para claves de identidad | Detener o poner en cuarentena |
Reglas de dominio | Códigos inválidos y valores fuera de conjunto | Utilizar listas finitas de valores permitidos | Rechazar o dirigir a remediación |
Comprobaciones de rango | Valores atípicos e imposibles | Definir límites específicos del negocio | Advertir en límites suaves, cuarentena en límites estrictos |
Fechas de vigencia | Eventos tardíos o con fecha incorrecta | Validar contra las ventanas esperadas | Cuarentena y reprocesamiento si es necesario |
Para los equipos que desean un conjunto de controles más amplio, digna's data validation rules and continuous quality guide es un complemento útil para estas comprobaciones a nivel de registro.
Monitoreo de Timeliness y Ventanas de Entrega Esperadas
Un pipeline puede estar en verde y aun así entregar datos obsoletos. Eso es lo que rompe los paneles de control de la mañana, no una alerta de trabajo fallido. El Timeliness debe tratarse como un SLA, con una ventana de entrega esperada vinculada a cuándo la empresa utiliza el conjunto de datos.
El control es simple en concepto y riguroso en la práctica. Compare la llegada esperada con la llegada real, luego clasifique la ejecución como temprana, tardía, ausente o parcial. Una fuente de ventas que debe llegar antes de una revisión de ingresos a las 8:00 AM tiene una ventana estrecha, mientras que una fuente de informes de la tarde puede tolerar una más amplia. Utilice el límite de negocio, no el cronograma de la herramienta de orquestación, como punto de referencia.
La forma más limpia de definir esa ventana es aprender de los patrones de ejecución anteriores, la cadencia de commits del origen y el tiempo de consumo. Si el equipo revisa los paneles al inicio del día, un desfase de diez minutos puede ser importante. Si los datos solo se utilizan después del almuerzo, ese mismo retraso puede ser irrelevante. digna's timeliness metrics guide ofrece un marco útil para establecer esas ventanas y medirlas de forma consistente.
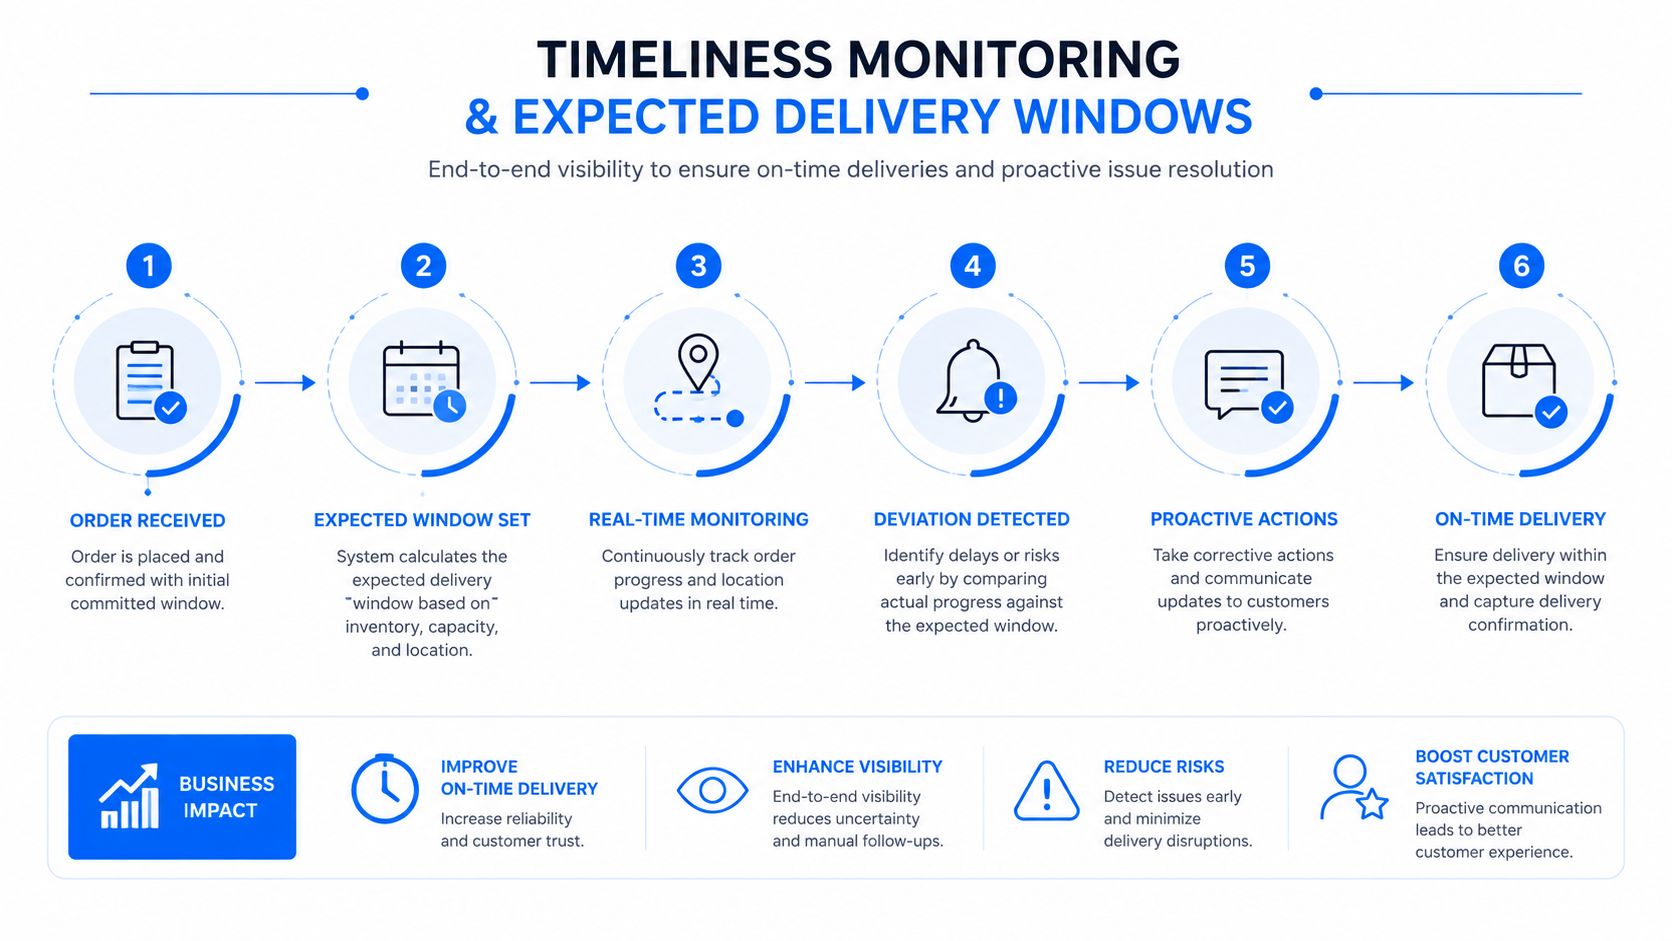
Monitoree más que solo la marca de tiempo final. Las comprobaciones de latidos (heartbeat) muestran si el origen sigue produciendo datos. Las marcas de agua (watermarks) muestran cuánto ha progresado el pipeline. Los marcadores de completitud incremental indican si llegaron todas las particiones, que es donde a menudo se esconden las cargas parciales.
La política de alertas debe reflejar el tipo de fallo, no solo la existencia de un retraso.
Llegadas tempranas: Generalmente inofensivas, pero útiles cuando apuntan a un cambio de cronograma en los sistemas upstream.
Llegadas tardías: Alerta una vez que el retraso supera la ventana de negocio del conjunto de datos.
Cargas ausentes: Escalar rápidamente si los datos no están disponibles antes de un plazo límite de consumo conocido.
Cargas parciales: Tratar como de alto riesgo cuando los grupos de archivos o particiones esperados están incompletos.
La distinción útil es entre un desfase rutinario y un retraso que arruinará una reunión de directorio o el flujo de trabajo de un cliente. Esa decisión corresponde a la política de monitoreo, no a la cabeza de alguien a las 7:50 AM. El control de Timeliness funciona cuando le da tiempo al equipo para actuar y cuando detecta la obsolescencia silenciosa antes de que alguien confíe en los números.
Desviación del Esquema (Schema Drift) y Cómo Detectarla Antes de que Rompa los Sistemas Downstream
La desviación del esquema (schema drift) es silenciosa porque el pipeline suele seguir ejecutándose mientras los sistemas de consumo se rompen a su alrededor. Los sistemas de origen cambian de forma sin previo aviso, y la carga sigue pareciendo exitosa hasta que un panel, un modelo o un trabajo downstream comienza a fallar debido a campos ausentes o reestructurados. Por eso la desviación del esquema pertenece a la misma capa de control que la validación y el monitoreo de Timeliness, y no a una cola de limpieza posterior a los hechos. La definición práctica de desviación es el cambio gradual o no anunciado de la estructura de un origen a lo largo del tiempo en relación con el esquema del pipeline, por lo que requiere un monitoreo activo en lugar de una aprobación única (schema-drift definition).
La forma más útil de pensar en la desviación es por su tipo. La desviación aditiva aporta nuevas columnas. La desviación sustractiva elimina campos que los sistemas de consumo esperan. La desviación mutativa cambia el tipo, la precisión o la admisibilidad de nulos. Se trata de diferentes modos de fallo, por lo que requieren diferentes respuestas. Un cambio que es seguro para la ingesta puede aun así romper una capa semántica downstream o un conjunto de características de un modelo.
Schema drift explained expone claramente el problema operativo. Si la estructura cambia y nadie lo nota hasta el consumo, el coste aparece más tarde en forma de uniones incorrectas, conversiones fallidas o pérdida silenciosa de datos.
Detecte la desviación en el límite
Las comprobaciones de contrato deben ejecutarse a medida que los datos cruzan el límite de ingesta. Los registros de esquemas versionados ayudan cuando los sistemas upstream evolucionan de forma deliberada. Los trabajos de comparación (diff) que contrastan instantáneas de DDL detectan cambios que pasan desapercibidos en las revisiones de código. Las comprobaciones de inferencia pueden alertar sobre columnas inesperadas incluso si el productor nunca las anunció.
Las mecánicas importan. La validación contra la estructura declarada debe cubrir la presencia de columnas, el tipo, las restricciones y el orden para archivos planos, además de las comprobaciones de clave primaria, clave externa y unicidad donde apliquen esas reglas. Esas comprobaciones no son glamorosas, pero evitan muchos problemas antes de que se extiendan a las tablas e informes downstream.
Cómo responder sin convertir cada cambio en una interrupción del servicio
Tipo de Desviación | Ejemplo de Cambio | Método de Detección | Respuesta Recomendada |
|---|---|---|---|
Aditiva | Nuevo campo añadido a una carga útil | Diferencia de esquema, inferencia, comprobación de contrato | Permitir la adición con opción a nulo, luego actualizar los modelos downstream |
Sustractiva | Columna existente eliminada | Validación en el límite, diferencia de instantáneas | Bloquear o dirigir a una capa de compatibilidad |
Mutativa | Cambios de tipo o precisión | Validación de tipo, comparación de registros | Poner en cuarentena, mapear con cuidado y versionar el contrato |
Las políticas de fallo estricto parecen seguras hasta que crean más incidentes de los que evitan. He visto a equipos rechazar cambios aditivos inofensivos y luego pasar el siguiente sprint desbloqueando manualmente a los consumidores. La evolución compatible hacia atrás suele funcionar mejor. Las adiciones con opción a nulo, las transiciones de doble escritura y las cargas downstream reproducibles son más seguras que pretender que los esquemas nunca cambian.
Diseñe pensando en la desviación y los controles seguirán siendo útiles por más tiempo. Asuma que el esquema es fijo, y la próxima versión upstream le demostrará lo contrario.
Construcción de una Capa Práctica de Calidad ETL en la Práctica
Una ejecución de ETL en verde aún puede entregar datos incorrectos. Eso suele ocurrir porque un solo control está haciendo demasiado, mientras que el fallo real se encuentra a una capa de distancia. Una infraestructura de calidad útil separa esas tareas. Las comprobaciones a nivel de fila se ejecutan en línea durante la extracción o transformación. La detección de anomalías a nivel de agregación se ejecuta en los límites de carga. Las comprobaciones de frescura y linaje se ejecutan después de la confirmación (commit), una vez que se puede verificar que el conjunto de datos llegó y rastrear cómo se movió.
Esa división es importante en la práctica. Las reglas estáticas son buenas para detectar patrones incorrectos conocidos. El monitoreo de comportamiento detecta desviaciones, retrasos y cambios sutiles que las reglas fijas pasan por alto.
Cómo suele madurar la infraestructura de calidad
La primera versión debe ser ligera. Comience con sondeos no bloqueantes en cada transición de etapa, de modo que el equipo pueda ver qué cambió antes de decidir si detiene la carga. A medida que la señal mejore, promueva las comprobaciones que detectan defectos reales para convertirlas en compuertas de orquestación. Mantenga el resto como alertas o rutas de cuarentena.
Un modo de fallo común es tratar cada problema como un asunto de redacción de reglas. Los equipos terminan con una lógica frágil que bloquea cambios inofensivos y aun así pasa por alto desviaciones significativas. El patrón más sólido es el control por capas, donde el perfilado de distribución, las alertas de ventanas de llegada y los contratos de esquema basados en el linaje cubren cada uno una fracción de riesgo diferente. Las herramientas exactas varían. El principio de diseño no.
Un caso de la industria deja claro este equilibrio. Una implementación descrita en el material de ITSV reemplazó miles de reglas de validación estáticas con perfilado, alertas de Timeliness y contratos de esquema, lo que redujo el ruido de las alertas y reveló desviaciones que afectaban a los ingresos de manera más temprana. Ese resultado tiene menos que ver con la infraestructura específica y más con el ajuste. Las compuertas estrictas deben manejar los fallos que rompen a los consumidores. Todo lo demás debe informar a los operadores sin convertir la variación rutinaria en una interrupción.
Quién es responsable de cada parte en la infraestructura
Ingenieros de datos: Responsables de los límites del pipeline, los contratos de esquema y el enrutamiento de fallos.
Ingenieros de analítica: Responsables de las expectativas orientadas al modelo, las comprobaciones de distribución y la validación semántica.
Equipos de governance: Responsables de los estándares, la política de gravedad y las rutas de escalamiento.
Propietarios de negocio: Responsables del significado de la alerta, especialmente cuando una fila es técnicamente válida pero comercialmente incorrecta.
Construya la infraestructura de control de la misma manera que construye el pipeline, con propiedad, pruebas y rutas de reversión (rollback).
digna se adapta a este modelo porque se ejecuta en el propio entorno del cliente y combina detección de anomalías, monitoreo de Timeliness, Data Validation a nivel de registro, seguimiento de esquemas y métricas de plataforma. El punto no es la marca del proveedor. El punto es que las comprobaciones permanezcan cerca de los datos y el modelo operativo se mantenga dentro del entorno donde se ejecuta el pipeline.
Trate la infraestructura de calidad como una superficie de producto, no como un proyecto de una sola vez. Analice el perfil de cada conjunto de datos, asigne cada modo de fallo a un único responsable, dirija las alertas al equipo que pueda actuar y retire los controles una vez que otra capa cubra el mismo vacío de manera más limpia. La calidad se mantiene cuando la infraestructura se gestiona con disciplina, no cuando el recuento de reglas sigue aumentando.
Conceptos Erróneos Comunes y una Lista de Verificación Práctica de Calidad
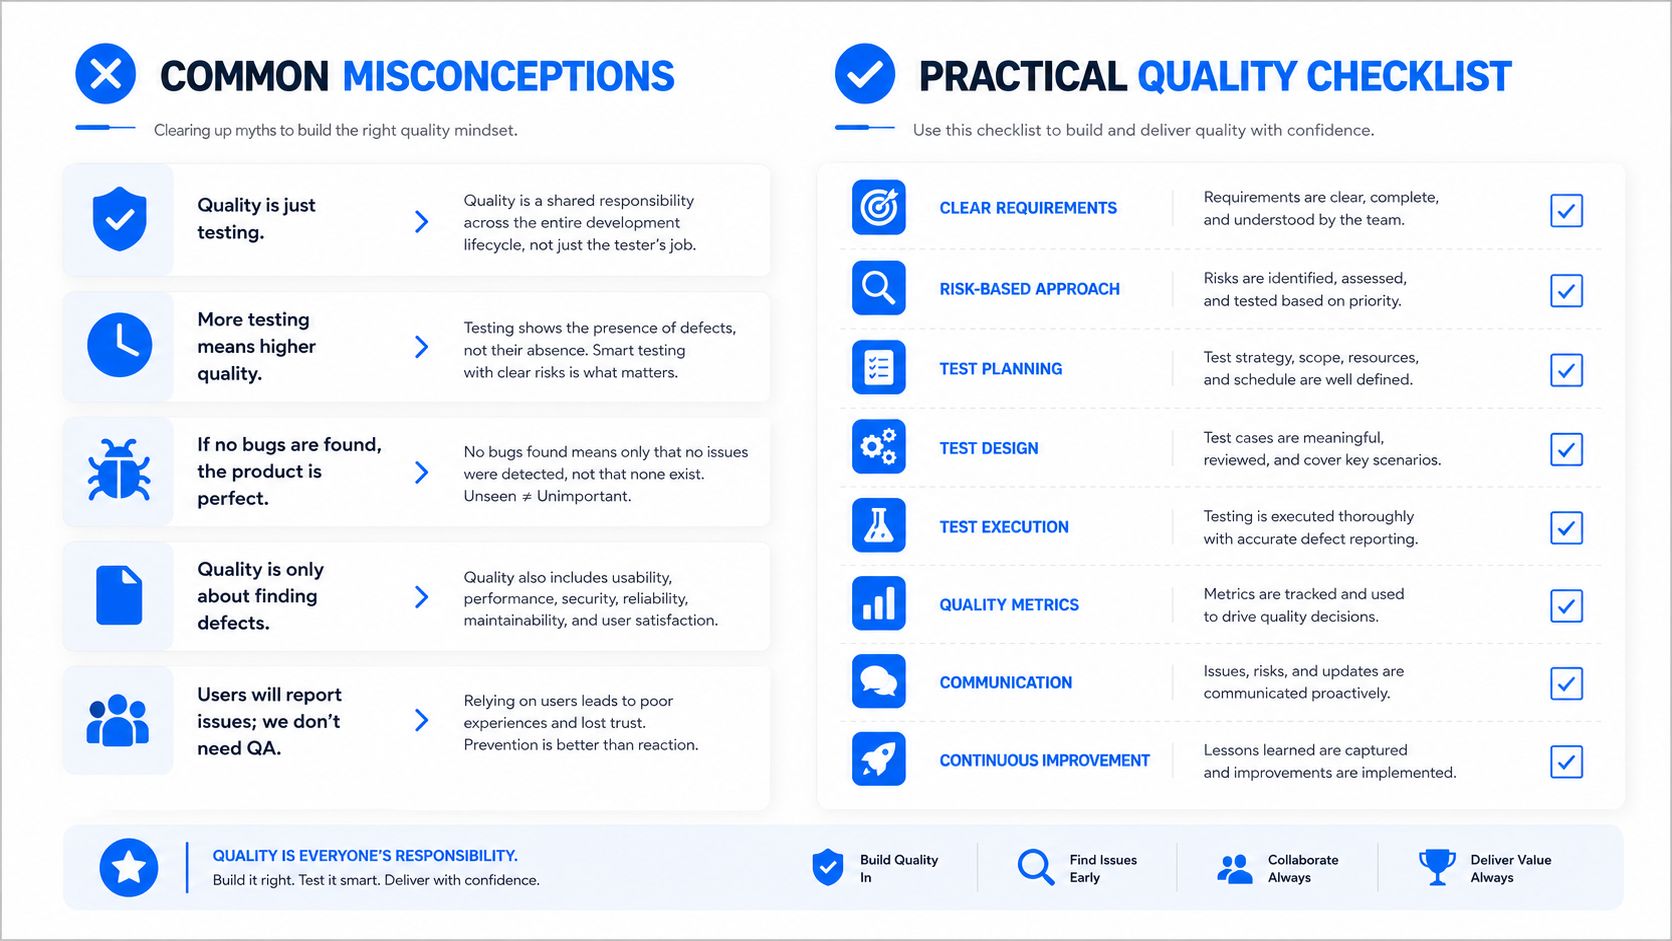
El primer concepto erróneo es que más reglas significan automáticamente mejor calidad. En realidad, acumular comprobaciones estáticas suele generar fatiga de alertas, pipelines frágiles y un largo historial de reglas en las que nadie confía. El segundo es que un pipeline en verde significa datos confiables. No es así, porque el trabajo puede tener éxito mientras el contenido está obsoleto, desviado o estructuralmente incorrecto. El tercero es que la desviación del esquema es un problema de migración de una sola vez. No lo es, es continuo.
Esos errores desaparecen una vez que se separa la función de cada control. Las reglas miden lo esperado. Las anomalías detectan lo inesperado. La detección de desviaciones vigila la estructura a medida que cambia con el tiempo. Si el equipo mezcla esas funciones, el resultado es un monitoreo ruidoso y una respuesta lenta ante incidentes.
Una lista de verificación que puede aplicar esta semana
Primero analice el perfil del origen: Conozca las formas de los campos, los patrones de nulos y las distribuciones antes de escribir reglas.
Reemplace los umbrales estáticos por líneas de base móviles: Utilice el comportamiento observado cuando el conjunto de datos sea naturalmente variable.
Alerte sobre la ausencia, no solo sobre la presencia: La falta de datos suele ser la primera señal de una carga rota.
Versione cada esquema: Trate el cambio estructural como un evento gestionado, no como una sorpresa.
Asigne un responsable humano a cada alerta: Las alertas sin propiedad se convierten en ruido de fondo.
Los programas más duraderos no persiguen reglas perfectas. Construyen Observability, establecen responsabilidades claras y permiten que el modelo de control evolucione a medida que evoluciona el pipeline. Esa es la diferencia entre un sistema que parece limpio y uno que se mantiene confiable cuando cambia el comportamiento del origen.
Si está reforzando la calidad de los datos de ETL en almacenes de datos, lagos de datos y pipelines de streaming, comience con controles que vigilen el comportamiento de los datos, no solo el estado de las tareas. digna ayuda a los equipos a monitorear anomalías, desviación de esquemas, Timeliness y validación dentro de su propio entorno, de modo que las comprobaciones permanezcan cerca de los datos y la propiedad esté clara. Visite digna para ver cómo este enfoque se adapta a su infraestructura.
Preguntas frecuentes
¿Por qué una canalización ETL en verde produce datos rotos?
Porque las herramientas de orquestación informan sobre todo de si una tarea se ejecutó, no de si los datos se comportaron bien. La regla práctica es tratar toda ejecución ETL correcta como no verificada hasta que los datos pasen comprobaciones de frescura, esquema y nivel de registro.
¿Qué dimensiones debe monitorizar toda canalización ETL?
Cinco, porque una puntuación única esconde el fallo. La frescura dice si está llegando el último registro válido, y las demás cubren volumen, esquema, distribución y validez a nivel de registro. Cada una capta una clase distinta de fallo, y tratarlas por separado es lo que hace útil la señal.
¿Qué fallos de ETL duelen más?
Los silenciosos. Una canalización que se cae se anuncia sola y se arregla; una ejecución que termina mientras pierde una partición, fuerza un tipo o admite registros inválidos viaja hasta el panel antes de que alguien pregunte nada.
¿Cuánto cuesta una mala calidad de datos en ETL?
Gartner estima la mala calidad de datos en una media de 12,9 millones de USD por organización y año, y los resúmenes sectoriales señalan que los datos deficientes pueden provocar entre un 15 % y un 25 % de pérdida de ingresos en algunas empresas. Los controles tempranos importan porque el coste crece con cada salto posterior.
¿La respuesta es más pruebas?
La respuesta es monitorización por capas, no la esperanza ni una batería de pruebas más larga. Las comprobaciones deterministas captan violaciones de reglas conocidas, las estadísticas captan comportamientos que las reglas no describen y el seguimiento de esquemas capta el cambio estructural, y ninguna capa cubre a las otras dos.



