Apache Iceberg: la guía del profesional
|
8
minuto de lectura

Has adoptado Apache Iceberg, registrado unas cuantas tablas y apuntado Spark al almacenamiento de objetos. El primer incidente en producción suele llegar antes de que la arquitectura parezca terminada: una consulta posterior lee un esquema inesperado, un cambio de partición se comporta de otra manera en Trino, o nadie sabe qué snapshots pueden eliminarse sin riesgo. Los archivos Parquet rara vez son la parte difícil. La propiedad, la coordinación de catálogos, el mantenimiento de metadatos y la evidencia de que una tabla es fiable son la carga de trabajo real.
El valor de Apache Iceberg viene de separar el estado de la tabla de la disposición física de los archivos. Esa separación sostiene una analítica fiable entre motores, pero también implica que los equipos necesitan prácticas de operación que van más allá de la especificación del formato. Esta guía trata el formato de tabla abierto Apache Iceberg como una disciplina de plataforma, con fronteras claras entre almacenamiento, catálogos, motores, mantenimiento y observabilidad.
Tabla de contenidos
Por qué Iceberg es una disciplina operativa y no solo un formato de archivo
Snapshots, manifiestos, particionado oculto y viaje en el tiempo
Buenas prácticas de particionado, ordenación y tamaño de archivos
Operar tablas Iceberg pensando en esquema, calidad y Timeliness
Por qué Iceberg es una disciplina operativa y no solo un formato de archivo
Un equipo puede adoptar Iceberg rápido y aun así carecer de respuestas a las preguntas que importan en producción. ¿Quién es responsable de la expiración de snapshots? ¿Qué equipo aprueba un cambio de esquema? ¿Cómo detectas que un productor añade un campo con un significado incompatible? ¿Qué pasa cuando Spark y Trino interpretan de forma distinta una transformación de partición porque su configuración de catálogo o conector ha divergido?
Iceberg nació en Netflix en 2017 para abordar los límites de escalabilidad y coherencia de las tablas de Apache Hive. Netflix lo donó a la Apache Software Foundation en noviembre de 2018, y en mayo de 2020 se convirtió en proyecto de primer nivel de Apache, según el historial de versiones del proyecto. Esos hitos explican el enfoque de ingeniería del formato, pero no eliminan las responsabilidades operativas que aparecen tras la adopción.
La capa física de datos es comparativamente sencilla. Los motores escriben archivos, normalmente Parquet, en el almacenamiento de objetos. El trabajo difícil empieza alrededor de esos archivos:
Gobernanza del catálogo: decide quién puede crear, alterar, eliminar o promover tablas, y cómo se resuelven los identificadores entre entornos.
Higiene de metadatos: controla la retención de snapshots, elimina archivos huérfanos y vigila el crecimiento de los manifiestos.
Coordinación de motores: prueba cómo Spark, Flink, Trino y otros lectores manejan el mismo esquema, especificaciones de partición, borrados y reglas de aislamiento.
Evidencia: conecta la calidad de datos, la frescura, el linaje y el historial de despliegues con un estado de tabla concreto.
Regla práctica: trata cada tabla Iceberg como un producto gestionado, con una persona responsable, una política de operación y un ciclo de vida observable.
Ahí es donde encaja la observabilidad de datos. La observabilidad no sustituye al catálogo ni al motor de consultas. Aporta la evidencia necesaria para responder si una tabla está sana ahora, si un cambio provocó una regresión y si quien está de guardia puede fiarse del snapshot actual.
El rendimiento y la corrección se deciden en esa capa operativa. Iceberg da a los equipos primitivas sólidas, pero una plataforma que no programa mantenimiento, no coordina el acceso y no monitoriza el comportamiento seguirá produciendo datos poco fiables.
Los componentes esenciales de una tabla Iceberg
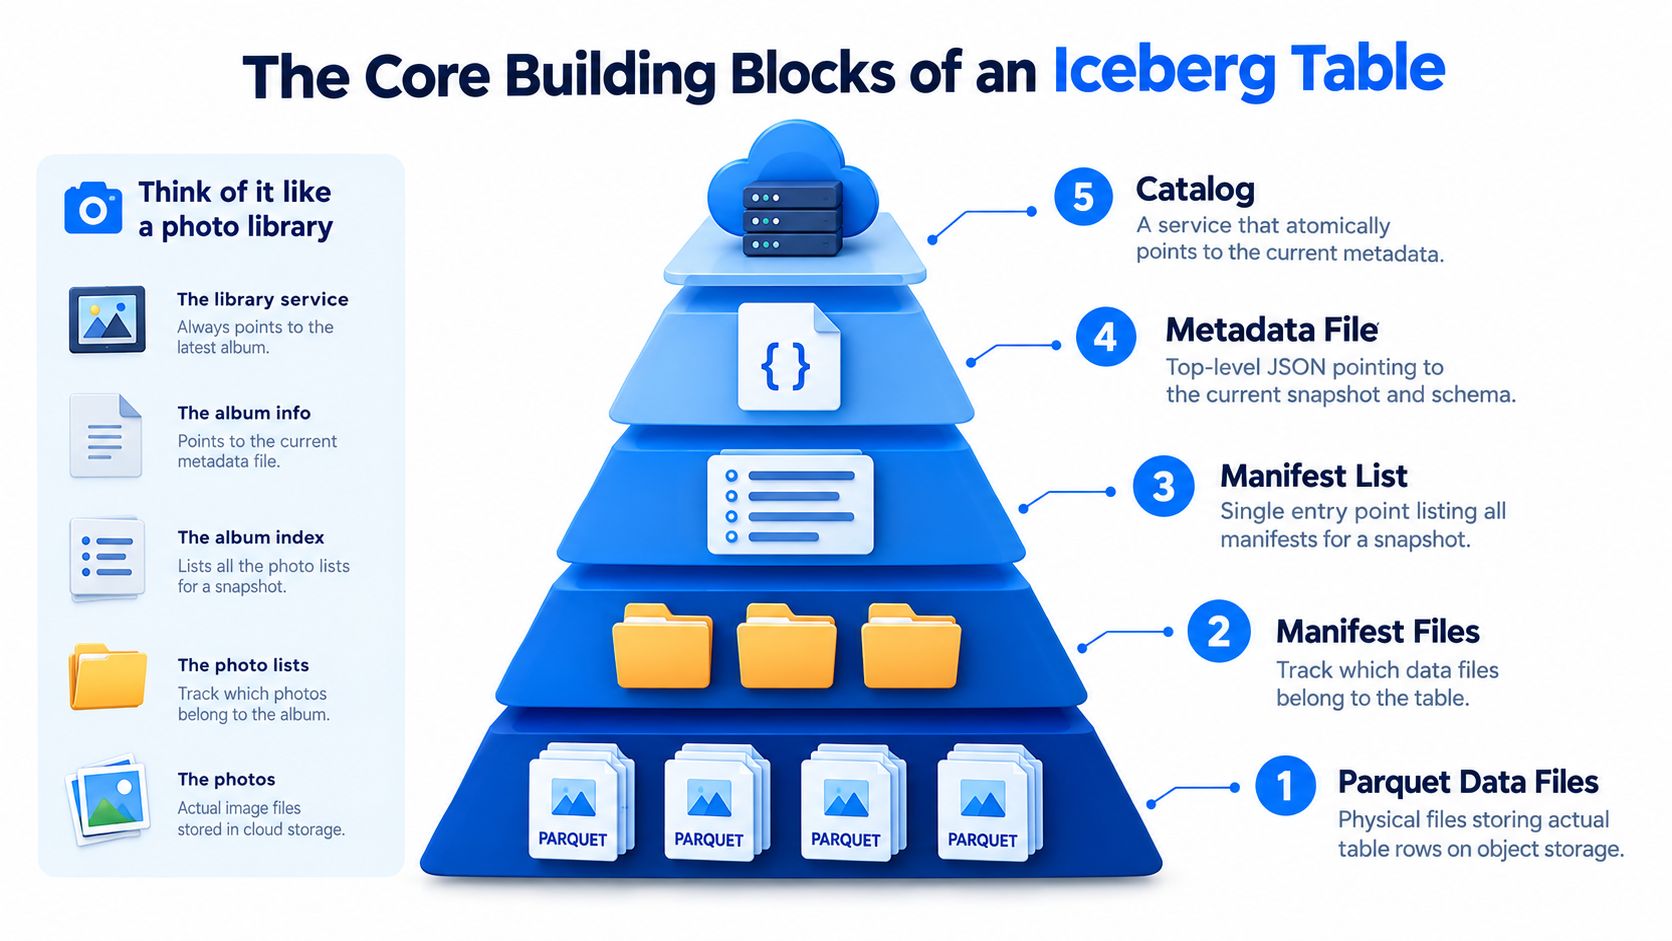
Un buen modelo mental empieza con una fototeca. Las fotografías son las filas, las carpetas describen grupos de fotografías, el índice del álbum te dice dónde mirar, y el catálogo de la biblioteca te dice qué colección es la vigente.
Abajo del todo, los archivos de datos Parquet guardan las filas reales en el almacenamiento de objetos. Parquet es un formato de archivo columnar, e Iceberg gestiona las referencias a esos archivos en lugar de obligar a los lectores a descubrirlos escaneando nombres de directorios. Para una explicación centrada en la capa de archivos, consulta qué es Parquet y cómo funciona.
Los archivos de manifiesto actúan como carpetas curadas con punteros a archivos de datos, junto con información que ayuda a los motores a decidir qué archivos son relevantes. Una lista de manifiestos es el índice de un snapshot concreto. Identifica los manifiestos que componen ese estado de tabla, de modo que el planificador puede empezar por un punto de entrada estructurado en lugar de buscar por todo el almacén de objetos.
Las capas de metadatos y catálogo
El archivo de metadatos de la tabla es la ficha del catálogo de la biblioteca. Iceberg guarda el estado de la tabla en metadatos JSON, incluidos esquemas, especificaciones de partición, historial de snapshots y linaje entre versiones. Los snapshots están incrustados en los metadatos de la tabla en lugar de serializarse como un sistema de estado aparte, lo que permite a los lectores reconstruir una tabla en un momento concreto a partir del registro de snapshots y la información de linaje, como describe la especificación de tablas de Iceberg.
El catálogo guarda el puntero atómico al archivo de metadatos actual. Un escritor crea nuevos datos y metadatos y luego actualiza ese puntero mediante el mecanismo de commit del catálogo. Los lectores resuelven el identificador de la tabla a través del catálogo, obtienen la ubicación de los metadatos actuales y planifican contra los manifiestos a los que apunta el snapshot elegido.
El modelo reutilizable es sencillo:
Los archivos de datos guardan filas.
Los archivos de manifiesto siguen las entradas de archivos de datos.
Las listas de manifiestos identifican los manifiestos de un snapshot.
Los metadatos registran esquemas, especificaciones de partición, snapshots y linaje.
El catálogo apunta de forma atómica a los metadatos actuales.
Esa indirección es la base de los commits atómicos y de las lecturas independientes del motor. También explica por qué borrar archivos a mano o cambiar rutas del almacén de objetos fuera de los procedimientos de Iceberg puede romper la integridad de la tabla.
Snapshots, manifiestos, particionado oculto y viaje en el tiempo
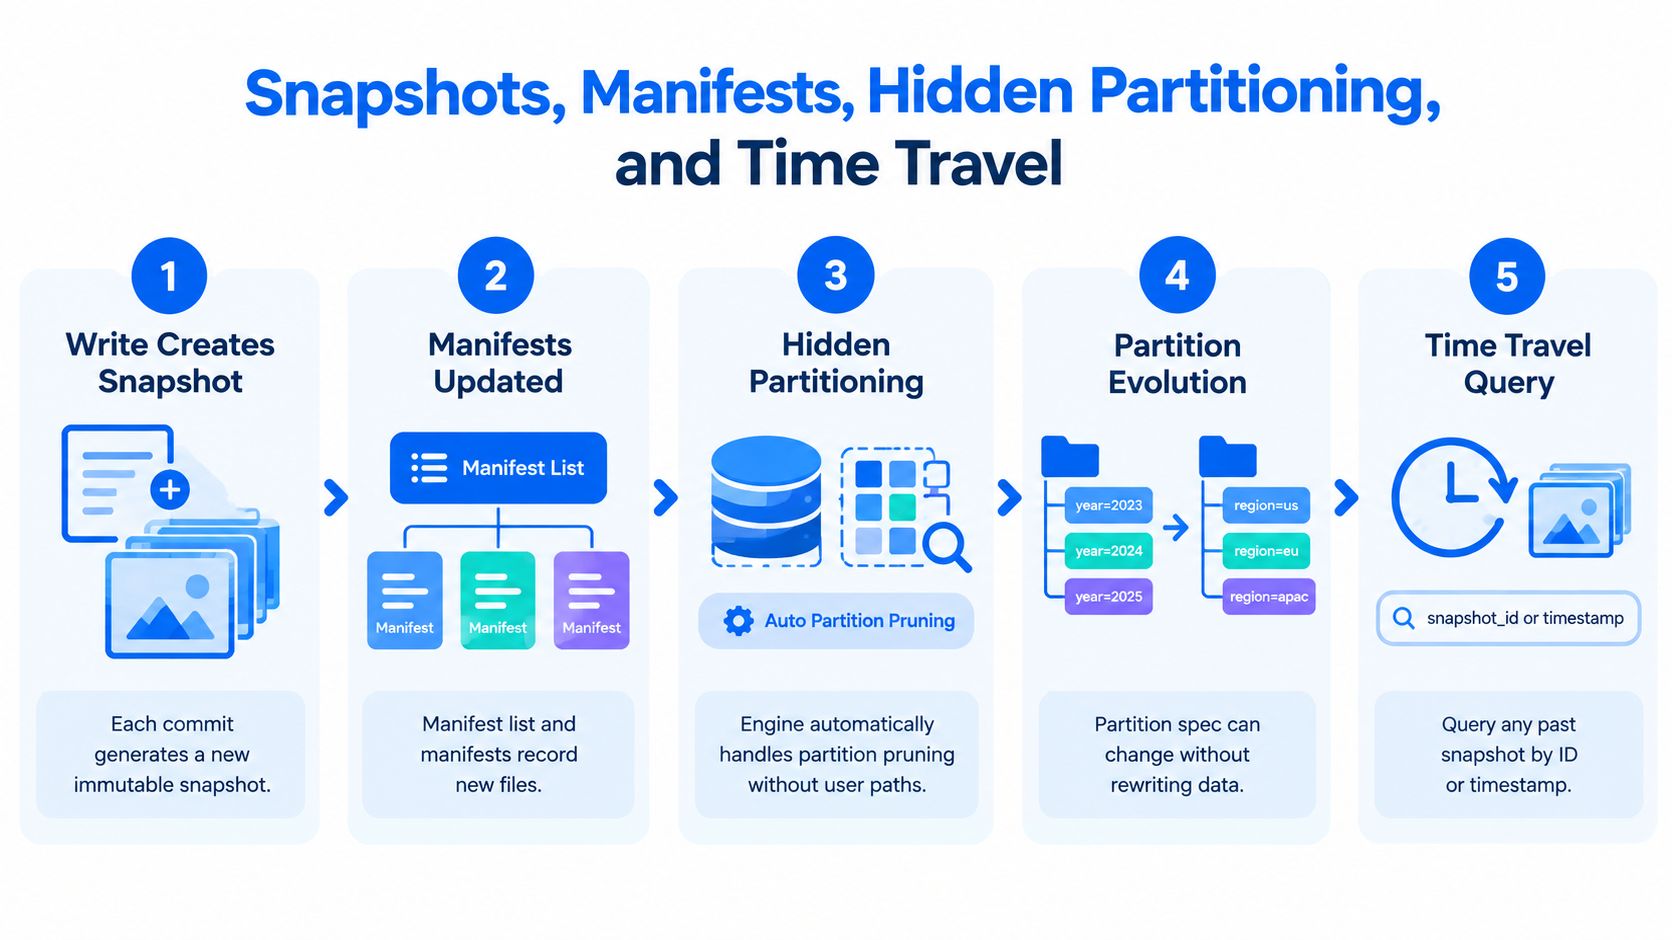
Una escritura en Iceberg cambia el estado de la tabla confirmando un nuevo snapshot. El snapshot registra un punto nuevo en la historia de la tabla y referencia la lista de manifiestos que describe los archivos visibles en ese punto. Como Iceberg guarda el historial de snapshots y el linaje entre versiones en los metadatos, un lector puede reconstruir no solo el último estado, sino también estados confirmados anteriores.
La secuencia importa:
Un escritor crea o prepara nuevos archivos de datos.
El commit crea un nuevo snapshot.
La lista de manifiestos identifica los manifiestos de ese snapshot.
Los lectores usan metadatos de manifiesto y estadísticas de archivo para reducir trabajo.
Una consulta histórica puede seleccionar un snapshot anterior en lugar del actual.
El particionado oculto quita la lógica de rutas a las consultas
Iceberg registra las transformaciones de partición en los metadatos. Una transformación como la extracción de fecha, el bucketing o el truncado puede guiar el descarte sin exigir a los usuarios escribir filtros contra columnas físicas de partición o rutas del almacén de objetos. El motor interpreta la información de particiones de la tabla durante la planificación, lo que mantiene el SQL centrado en columnas de negocio.
Eso no significa que el particionado se convierta en ajuste automático de rendimiento. El motor sigue necesitando estadísticas utilizables, una disposición de archivos sensata y una especificación de partición que encaje con la carga de consultas. El particionado oculto elimina toda una clase de errores de ruta visibles para el usuario, pero no rescata un diseño inadecuado.
Evolución sin reescribir la historia
La evolución de particiones afecta solo a los metadatos. Un equipo puede cambiar una especificación de partición, mantener los datos antiguos en su disposición física original y escribir los datos nuevos bajo la nueva especificación, como documenta la evolución de particiones de Iceberg. La tabla sigue cada versión de partición por separado.
Esa flexibilidad resulta potente cuando cambian los patrones de acceso. También crea una obligación de planificación, porque los motores de consulta deben interpretar varias especificaciones de partición en una misma tabla. El beneficio es evitar un gran trabajo de reescritura; el coste, unos metadatos y una planificación más complejos.
El viaje en el tiempo se vuelve entonces una herramienta práctica de diagnóstico. Consulta un snapshot antiguo, compara sus resultados con el estado actual, investiga el cambio y vuelve al último snapshot. El modelo de snapshots confirmados de Iceberg ofrece aislamiento por snapshot, así que los lectores ven un estado confirmado coherente mientras los escritores crean snapshots nuevos de forma atómica. Para flujos de trabajo con datos históricos, el mismo patrón resulta útil más allá de Iceberg, como muestra esta guía de análisis de datos históricos.
Apache Iceberg frente a Delta Lake y Apache Hudi
Elegir un formato de tabla por número de funciones es un mal método de producción. La comparación útil trata del comportamiento de los metadatos, la cobertura de motores y la semántica de lecturas históricas, seguidas por la carga de trabajo y las restricciones de gobernanza que tu plataforma pueda sostener.
Dimensión | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Modelo de metadatos | Metadatos basados en snapshots, con listas de manifiestos y manifiestos que describen los archivos de la tabla y sostienen la planificación | Una cadena de JSON en | Una línea temporal de commits diseñada en torno a cambios a nivel de registro y operaciones orientadas al streaming |
Patrón de motor más fuerte | Uso amplio con varios motores: Spark, Flink, Trino, Presto, Impala, Dremio y Snowflake | Más fuerte en entornos centrados en Spark | Más fuerte para upserts en streaming y procesamiento incremental |
Modelo de viaje en el tiempo | Las lecturas apuntan a snapshots confirmados, con retención controlada por operaciones de tabla | Las lecturas dependen del historial retenido del registro de transacciones y de los checkpoints | Las lecturas dependen de la línea temporal de commits configurada y de la ventana de retención |
Principal contrapartida en producción | La coordinación entre catálogos y motores exige una gobernanza deliberada | La portabilidad puede complicarse fuera de su ecosistema más fuerte | Las opciones merge-on-read y copy-on-write añaden complejidad operativa |
El modelo de metadatos de Iceberg separa el estado de la tabla de los archivos de datos. Los motores pueden usar listas de manifiestos y estadísticas a nivel de archivo para reducir el trabajo de planificación sin obligar a cada lector a interpretar una convención de directorios. La cadena de registro de Delta es eficaz para anotar cambios, pero una inspección histórica amplia puede convertirse en un problema de gestión de registros. La línea temporal de Hudi encaja de forma natural con actualizaciones en streaming, sobre todo donde dominan el consumo incremental y el comportamiento de upsert.
La cobertura de motores cambia cómo se comporta la misma tabla en la práctica. Spark y Flink pueden escribir tablas Iceberg y participar en protocolos de commit, produciendo nuevos snapshots de forma atómica. Trino y Presto se usan habitualmente como planificadores orientados a lectura que obtienen metadatos de manifiesto, aplican empuje de filtros y usan transformaciones de partición durante la planificación. Impala accede a Iceberg mediante su abstracción de catálogo y puede beneficiarse del descarte por metadatos. Dremio y Snowflake añaden más vías de consumo, pero cada combinación de conector y catálogo sigue necesitando pruebas de compatibilidad.
El catálogo es el punto de coordinación
Los catálogos REST, Hive, Glue, Nessie y Polaris resuelven los identificadores de tabla hasta el puntero de metadatos actual. Ese puntero es la decisión del plano de control que le dice a un motor qué estado de tabla leer o actualizar. La compatibilidad de almacenamiento por sí sola no garantiza una gobernanza coherente.
Los escritores concurrentes necesitan gestión de conflictos. Un escritor puede descubrir que el puntero del catálogo cambió después de iniciar su commit, lo que fuerza un reintento o una respuesta de conflicto. Distintos motores muestran esos fallos de forma distinta, así que los equipos de plataforma deberían probar reintentos, manejo de errores y responsabilidad operativa en vez de suponer que todos los conectores se comportan igual.
Una lista práctica de selección tiene este aspecto:
Elige Iceberg cuando varios motores, catálogos abiertos y una gobernanza de tablas portable importen más que una integración estrecha con la plataforma.
Elige Delta Lake cuando Spark y su plataforma circundante sean la vía dominante de escritura, gobernanza y servicio.
Elige Hudi cuando los upserts en streaming, las lecturas incrementales y la ingesta a nivel de registro sean los requisitos centrales.
Prueba primero el catálogo cuando las mismas tablas deban gobernarse entre motores.
Valida las lecturas históricas con procedimientos reales de retención y rollback, no solo con una consulta de demostración exitosa.
Las operaciones de calidad de datos también deben encajar con el entorno de ejecución elegido. Para equipos que usan Databricks, la gestión de calidad de datos en Databricks es una vía operativa relevante que conviene evaluar junto al comportamiento del catálogo y del motor.
Un ejemplo práctico: crear y consultar una tabla Iceberg
Un pequeño flujo en PySpark hace concreto el modelo de metadatos. La implementación exacta del catálogo varía, así que el ejemplo usa un catálogo Iceberg con nombre y una ubicación de almacén que sustituirías por los ajustes de tu entorno.
La definición de la tabla guarda la transformación de partición en los metadatos. Los usuarios pueden filtrar por event_time; no necesitan referenciar una columna de partición generada ni un directorio del almacén de objetos.
El append crea un nuevo snapshot confirmado. Para inspeccionar el historial, consulta las tablas de metadatos, selecciona el identificador de snapshot deseado y usa ese identificador para una lectura histórica.
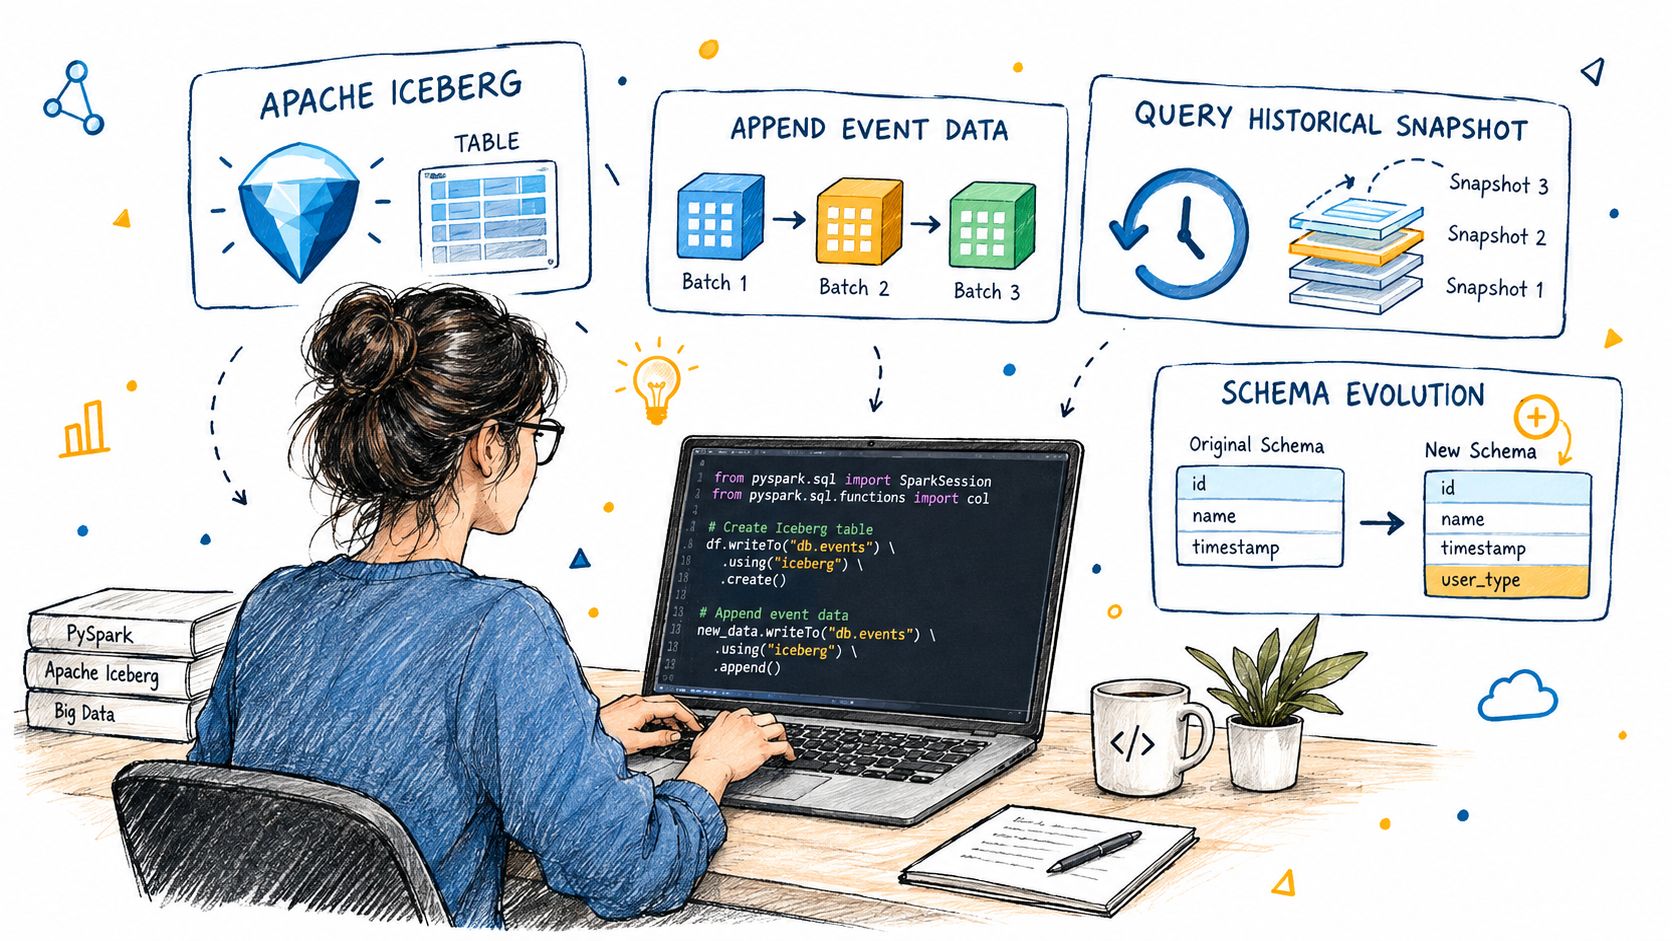
La evolución de esquema afecta solo a metadatos en los cambios admitidos. Añade una columna y luego anexa registros que la rellenen:
Los lectores que apuntan al snapshot anterior siguen usando la proyección de esquema anterior. Entre bastidores, el catálogo apunta a unos metadatos de tabla actualizados, los metadatos referencian un snapshot nuevo, la lista de manifiestos identifica los manifiestos relevantes, y los manifiestos apuntan a los archivos de datos. Esa disposición del sistema de archivos debería ser visible y explicable para el equipo que opera la tabla.
Buenas prácticas de particionado, ordenación y tamaño de archivos
Iceberg no vuelve rápida una consulta lenta de forma automática. El rendimiento de consulta suele depender de la relación entre tamaño de archivo, orden de clasificación, transformaciones de partición y la mezcla real de filtros. El formato te da mecanismos para hacer evolucionar la disposición, pero los ingenieros aún deben probarla y mantenerla.
Empieza por el tamaño de archivo. Un rango inicial habitual es de 128 a 512 MB, pero el objetivo correcto depende de los patrones de lectura, los ajustes del formato de archivo, la compresión y el comportamiento del motor. Los archivos pequeños aumentan el coste de planificación y hacen ineficientes los escaneos. Los archivos muy grandes pueden reducir el paralelismo o encarecer las lecturas selectivas.
La ordenación es la segunda palanca. Ordena por tiempo de evento cuando dominen los escaneos por ventanas temporales. Usa una columna de filtro de alta cardinalidad cuando produzca una agrupación significativa, y plantéate una organización al estilo Z-order solo donde el motor y las herramientas de mantenimiento la soporten de forma consistente. Una clave de ordenación que luce bien en un documento de diseño puede ser errónea para la mezcla real de consultas.
El particionado oculto es una herramienta de refinamiento, no un sustituto del análisis de carga. La evolución de particiones te permite ajustar la especificación sin reescribir de inmediato los archivos históricos, pero cada especificación adicional aumenta el número de disposiciones que los planificadores deben interpretar.
Palanca | Punto de partida | Cuándo ajustar | Error común |
|---|---|---|---|
Tamaño de archivo | Empieza en torno a 128-512 MB y valida con escaneos representativos | Ajusta según lecturas selectivas, concurrencia y paralelismo del motor | Dejar que se acumulen muchos archivos diminutos |
Orden de clasificación | Empieza por los filtros temporales habituales o columnas selectivas estables | Cámbialo cuando el historial de consultas muestre que dominan otros predicados | Elegir una clave por intuición en vez de por las consultas observadas |
Transformación de partición | Usa una transformación gruesa y relevante para el negocio | Hazla evolucionar cuando los patrones de acceso cambien de forma apreciable | Crear demasiadas particiones |
Mantenimiento | Programa la compactación y la limpieza de metadatos | Aumenta la frecuencia según crecen la ingesta y el número de tablas | Tratar la limpieza como una tarea de emergencia |
Evita el exceso de particionado que genera archivos por debajo de 64 MB. Prefiere granularidad diaria o mensual antes que horaria cuando el volumen resultante sea bajo. Son heurísticas de operación, no garantías, así que valídalas con cargas representativas antes de estandarizarlas.
La compactación no es opcional a escala. Los procedimientos de reescritura de Spark, el mantenimiento basado en Flink o herramientas externas pueden combinar archivos y mejorar la disposición, pero deben coordinarse con la retención de snapshots y la limpieza de archivos huérfanos. La evolución de particiones reduce la presión de reescritura, pero no elimina la necesidad de vigilar el crecimiento de los metadatos.
Operar tablas Iceberg pensando en esquema, calidad y Timeliness
Cuando los equipos operan muchas tablas Iceberg, la mayoría de los incidentes empiezan como fallos de detección. Un productor cambia un campo sin avisar a los consumidores, eventos tardíos aterrizan después de la ventana de partición esperada, una pipeline crea snapshots sin entregar datos útiles, o el mantenimiento deja una tabla técnicamente legible pero operativamente cara.
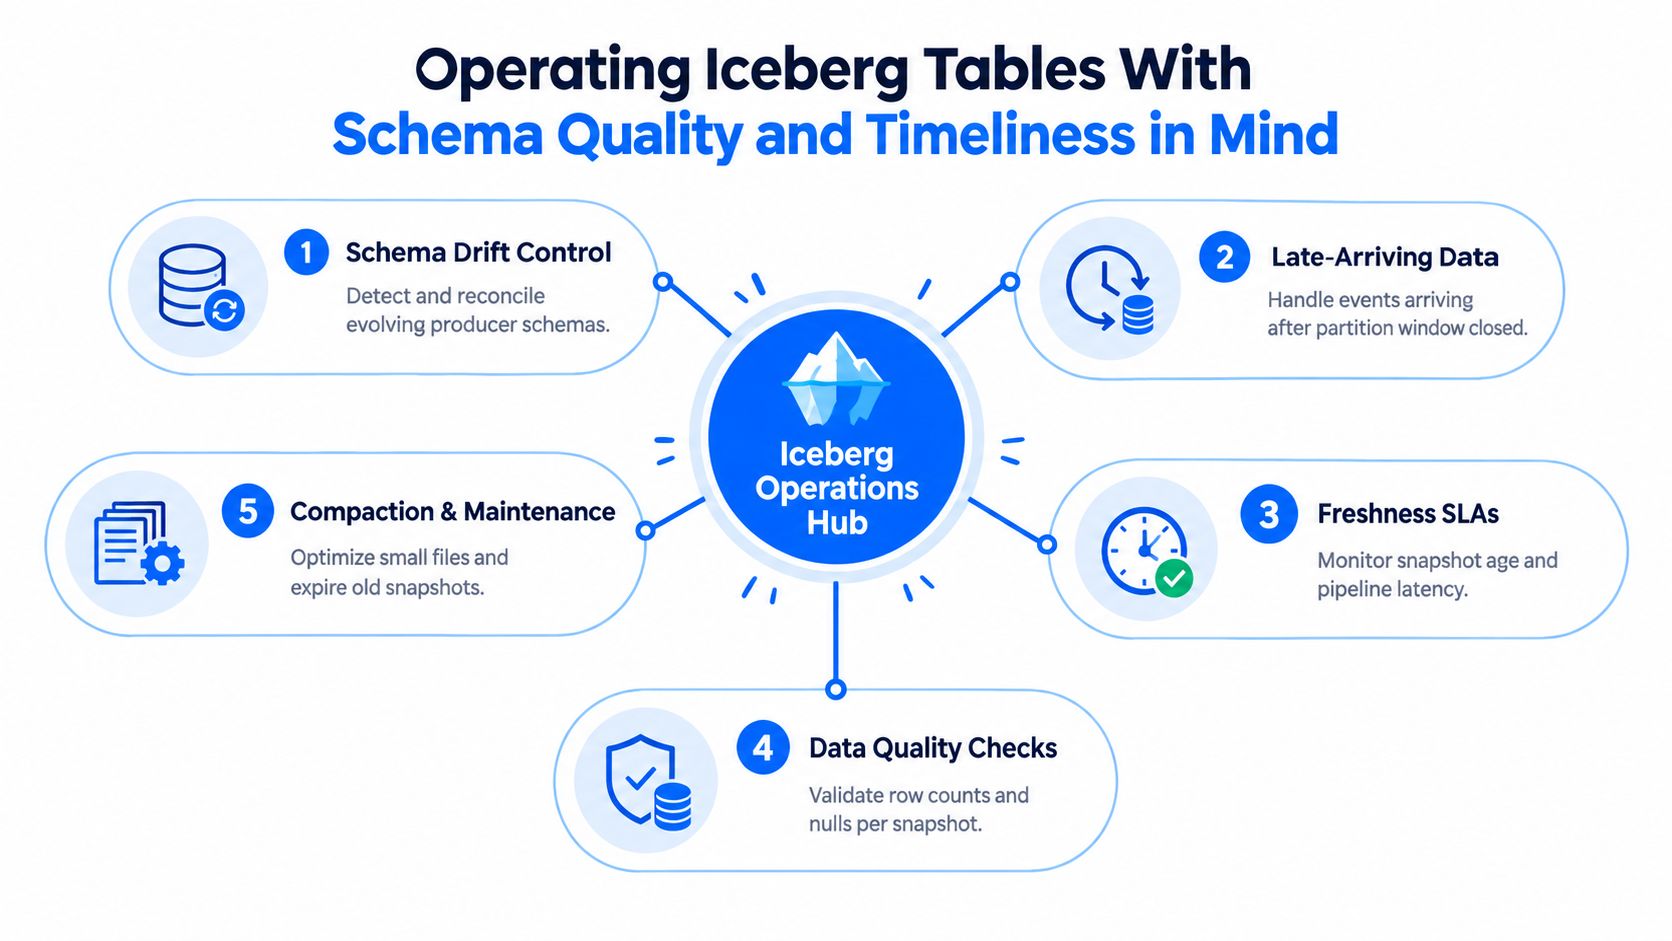
Trata cada riesgo como una señal que necesita responsable y respuesta:
Deriva de esquema: detecta campos añadidos, eliminados, renombrados o con cambio de tipo antes de que los trabajos posteriores los interpreten mal.
Datos tardíos: compara el tiempo de evento con el de llegada para que una partición temporal cerrada no oculte problemas de entrega.
Frescura: sigue la antigüedad del último snapshot útil, no solo si un escritor se ejecutó.
Calidad: vincula los resultados de validación a un snapshot concreto para que un incidente pueda reproducirse.
Salud de metadatos: vigila el número de snapshots, el crecimiento de manifiestos, los archivos huérfanos y la distribución de tamaños de archivo.
Haz explicable el snapshot actual
Una vista operativa fiable conecta el estado de la tabla con el comportamiento de la pipeline. Una comprobación de recuento de filas sin identidad de snapshot no puede decirle a una ingeniera qué versión falló. Una alerta de frescura basada solo en el reloj puede clasificar mal una tabla que recibió un lote vacío o mal formado. Una alerta de esquema sin propiedad aguas abajo genera ruido en lugar de acción.
digna puede situarse junto al catálogo y a la capa de cómputo con ese fin. Su Schema Tracker vigila los cambios estructurales, Data Validation aplica comprobaciones de negocio a nivel de registro, Timeliness sigue las llegadas esperadas y los retrasos, y las vistas de observabilidad ayudan a los equipos a examinar tendencias y comportamiento de la plataforma. Su modelo de ejecución dentro de la base de datos mantiene el cálculo de métricas en el entorno del cliente en lugar de mover datos de producción a un servicio externo.
La pregunta operativa a las dos de la madrugada no es si Iceberg confirmó correctamente. Es si la tabla es fiable ahora mismo, qué snapshot está afectado y qué cambió desde el último estado sano. Esa respuesta exige señales de calidad, puntualidad, esquema y metadatos en un mismo contexto de incidente.
Migrar desde Hive, Delta o Hudi sin incendiar el lake
Las rutas de migración difieren mucho según el formato de origen. Las tablas externas de Hive suelen ser las más accesibles porque los archivos existentes pueden ya servir, pero las discrepancias de identificadores, las suposiciones de SerDe y el registro en el catálogo aún pueden romper a los lectores posteriores. Una conversión de metadatos o una vía CTAS puede funcionar para una tabla y fallar para otra cuando difieren las suposiciones de disposición física.
Delta exige un examen más cuidadoso. Las utilidades de conversión o reescritura deben tener en cuenta los vectores de borrado, los ajustes del change data feed y las columnas de identidad, que no se trasladan limpiamente al modelo destino. Un registro de tabla exitoso no demuestra que el comportamiento histórico, los borrados o los consumidores incrementales vayan a comportarse igual.
Hudi suele ser la migración más difícil cuando el origen depende del comportamiento merge-on-read, copy-on-write o de la semántica de la línea temporal. Los snapshots de Iceberg no ofrecen un reemplazo uno a uno para cada operación de la línea temporal de Hudi, así que los equipos pueden necesitar una reescritura completa y una frontera de cambio definida con cuidado.
Una secuencia de cambio más segura
La elección del catálogo va primero. Decide si el patrimonio destino usará REST, Glue, Nessie o Hive Metastore, y luego prueba permisos, identificadores, manejo de credenciales y comportamiento de rollback. Las herramientas de BI suelen cachear nombres totalmente cualificados, así que cambiar rutas de catálogo o de espacio de nombres puede romper informes aunque los datos sean correctos.
La migración de particiones merece su propia prueba. El particionado oculto cambia cómo expresan los usuarios los filtros y cómo interpretan los motores las transformaciones, mientras las disposiciones antigua y nueva pueden coexistir durante la transición. La doble escritura puede preservar opciones de rollback, pero también crea un trabajo de reconciliación que hay que vigilar.
Usa esta secuencia:
Inventario: registra esquemas, particiones, consumidores, escrituras, reglas de retención y requisitos de lectura histórica.
Piloto: convierte tablas no críticas y prueba cada motor importante.
Doble lectura: compara resultados, recuentos, esquemas, frescura y comportamiento de acceso.
Cambio: mueve a los consumidores de forma deliberada, conserva una vía de rollback y mantén disponible la ruta antigua hasta completar la validación.
Para una planificación más amplia, usa las buenas prácticas de migración de almacén de datos a data lake como lista de comprobación y adáptalas después a las restricciones de catálogo y motor de tu patrimonio.
digna aporta calidad de datos y observabilidad dentro del entorno para operaciones próximas a Iceberg, incluidos seguimiento de esquema, validación de registros, monitorización de puntualidad, detección de anomalías y métricas de plataforma. Visita digna para evaluar cómo esas señales pueden ayudar a tu equipo a operar grandes patrimonios de tablas con evidencia más clara y una respuesta a incidentes más rápida.
El historial de snapshots te dice qué cambió, pero no si el cambio fue erróneo: para eso, combina los metadatos de Iceberg con la observabilidad de la plataforma de datos.
Preguntas frecuentes
¿De dónde viene Apache Iceberg?
Nació en Netflix en 2017 para abordar los límites de escalabilidad y coherencia de las tablas de Apache Hive. Netflix lo donó a la Apache Software Foundation en noviembre de 2018, y en mayo de 2020 se convirtió en proyecto de primer nivel de Apache.
¿Por qué Iceberg es una disciplina operativa y no un formato de archivo?
Porque un equipo puede adoptarlo rápido y aun así carecer de respuestas a las preguntas que importan en producción. La capa física de datos es comparativamente sencilla; el rendimiento y la corrección se deciden en la capa operativa que hay encima.
¿Qué exige realmente operar Iceberg?
Cuatro cosas: gobernanza del catálogo que decida quién puede crear, alterar, eliminar o promover tablas y cómo se resuelven los identificadores; higiene de metadatos que controle la retención de snapshots, la eliminación de archivos huérfanos y el crecimiento de manifiestos; coordinación de motores que pruebe cómo Spark, Flink y Trino manejan las mismas especificaciones; y evidencia que conecte calidad, frescura y linaje con un estado de tabla.
¿Cuál es la idea central de diseño de Iceberg?
Separar el estado de la tabla de la disposición física de los archivos. De esa separación viene su valor, y es también la razón por la que las preguntas operativas suben un nivel en lugar de desaparecer.
¿Cómo debería tratarse una tabla Iceberg?
Como un producto gestionado con una persona responsable, una política de operación y un ciclo de vida observable. Una tabla sin esas tres cosas tiene especificación, pero nadie responde por cómo se comporta con el tiempo.



