Verlässliche Daten sind valide Daten: Ein praktischer Leitfaden
|
7
min. Lesezeit
Es ist Montagmorgen. Das Executive Dashboard ist grün, die Einnahmen sehen stabil aus und die Pipeline über Nacht wurde fehlerfrei abgeschlossen. Bis Dienstagnachmittag stellt ein Produktmanager fest, dass die Konversionsraten seit drei Tagen falsch sind, weil eine vorgelagerte Schemaänderung den Umgang mit Nullwerten verändert hat. Operativ ist nichts fehlgeschlagen. Der Workflow lief nach Plan und lieferte die Daten pünktlich. Die Daten selbst waren jedoch nicht mehr gültig.
Diese Unterscheidung verursacht einige der kostspieligsten Vorfälle auf modernen Datenplattformen. Zuverlässige Daten sind gültige Daten, aber eine Pipeline, die konsistent läuft, erzeugt nicht automatisch vertrauenswürdige Datensätze. Die Zuverlässigkeit in der Produktion hängt davon herab, ob die Daten korrekt, aktuell, strukturell kompatibel und für die von ihnen unterstützte Entscheidung geeignet bleiben.
Inhaltsverzeichnis
Wenn zuverlässige Daten die Gültigkeitsprüfung nicht bestehen
Wie Timeliness und Schema-Stabilität das Bild vervollständigen
Praktische Kontrollen zur Erreichung von Gültigkeit und Zuverlässigkeit
Warum statische Data Validation für moderne Datenplattformen nicht ausreicht
Wenn zuverlässige Daten die Gültigkeitsprüfung nicht bestehen
Der erste Alarm ist meist kein Alarm. Es ist eine Frage in Slack.
„Warum ist die Konversion bei einem Kanal eingebrochen?“
Das Dashboard zeigt immer noch eine erfolgreiche Aktualisierung an. Die Job-Orchestrierung meldet keine Fehler. Die Zeilenanzahl sieht plausibel aus und das Warehouse hat jeden Datensatz akzeptiert. Ein schneller Vergleich zeigt, dass ein vorgelagerter Dienst die Darstellung fehlender Werte geändert hat. Die Transformation wurde zwar weiterhin ausgeführt, aber ihre Join- und Aggregationslogik behandelte diese Werte anders. Eine Metrik, die stabil aussah, wurde auf Basis einer veränderten Bedeutung berechnet.
Dies ist die gefährliche Lücke zwischen Pipeline-Zuverlässigkeit und Datengültigkeit. Eine zuverlässige Pipeline kann jede geplante Aufgabe abschließen, während sie Datensätze liefert, die gegen die geschäftliche Bedeutung verstoßen. Ein gültiger Datensatz kann operativ auch unzuverlässig werden, wenn er zu spät oder unvollständig ankommt oder ohne Vorwarnung seine Form ändert.
Eine grüne Pipeline kann trotzdem falsch sein
Einfaches Monitoring beantwortet oft operative Fragen:
Ist der Job gestartet?
Wurde er beendet?
Hat das Warehouse die Abfrage akzeptiert?
Hat die erwartete Aufgabe ein Ergebnis geliefert?
Wurde das Dashboard aktualisiert?
Diese Prüfungen sind wichtig, aber sie beantworten nicht, ob eine Kunden-ID immer noch dem richtigen Kunden zugeordnet ist, ob ein Zeitstempel zum beabsichtigten Berichtszeitraum gehört oder ob ein Statuscode innerhalb des genehmigten Geschäftsvokabulars bleibt.
Gültigkeit ist die Kontrolle, die eine erfolgreiche Verarbeitung mit einem sinnvollen Ergebnis verbindet. IBM beschreibt Gültigkeit als eine eigenständige Dimension der Datenqualität, die Format, Typ, Bereich und Einschränkungen von Geschäftsregeln umfasst, und weist in seiner Erklärung der Datenqualitätsdimensionen darauf hin, dass plausible Daten dennoch ungültig sein können, wenn sie strukturellen oder semantischen Erwartungen widersprechen.
Eine fehlerhafte E-Mail, ein negatives Alter, ein unerwarteter Code oder ein Null-Join-Key können die Erfassung passieren, weil die Speicherschicht dies zulässt. Nachgelagerte Modelle und Berichte übernehmen dann den Fehler. Je weiter der Datensatz reist, desto schwieriger wird es, die ursprüngliche Ursache zu ermitteln.
Praktische Regel: Ein erfolgreicher Durchlauf beweist, dass die Software ihre Arbeit abgeschlossen hat. Er beweist nicht, dass das Ergebnis Vertrauen verdient.
Das geschäftliche Risiko ist beträchtlich. In einem Artikel der MIT Sloan Management Review aus dem Jahr 2017 wurde eine Studie zitiert, wonach schlechte Daten die meisten Unternehmen durch fehlerhafte Entscheidungen, Berichte und Finanzergebnisse 15 % bis 25 % ihres Umsatzes kosten (MIT Sloan Management Review Referenz). Diese Schätzung verdeutlicht, warum Gültigkeit in die Unternehmenskontrollen gehört und nicht nur auf technische Checklisten.
Gültigkeit und Zuverlässigkeit von Daten verstehen
Eine Pipeline kann um 2 Uhr morgens erfolgreich abgeschlossen werden und zum Frühstück dennoch unbrauchbare Daten liefern. Ein Feld kann analysiert werden, ein Job kann grün werden und ein Dashboard kann aktualisiert werden, während die Datensätze gegen die Regeln verstoßen, die ihnen Bedeutung verleihen. Gültigkeit und Zuverlässigkeit beschreiben unterschiedliche Kontrollen, um diesen Fehler abzufangen.
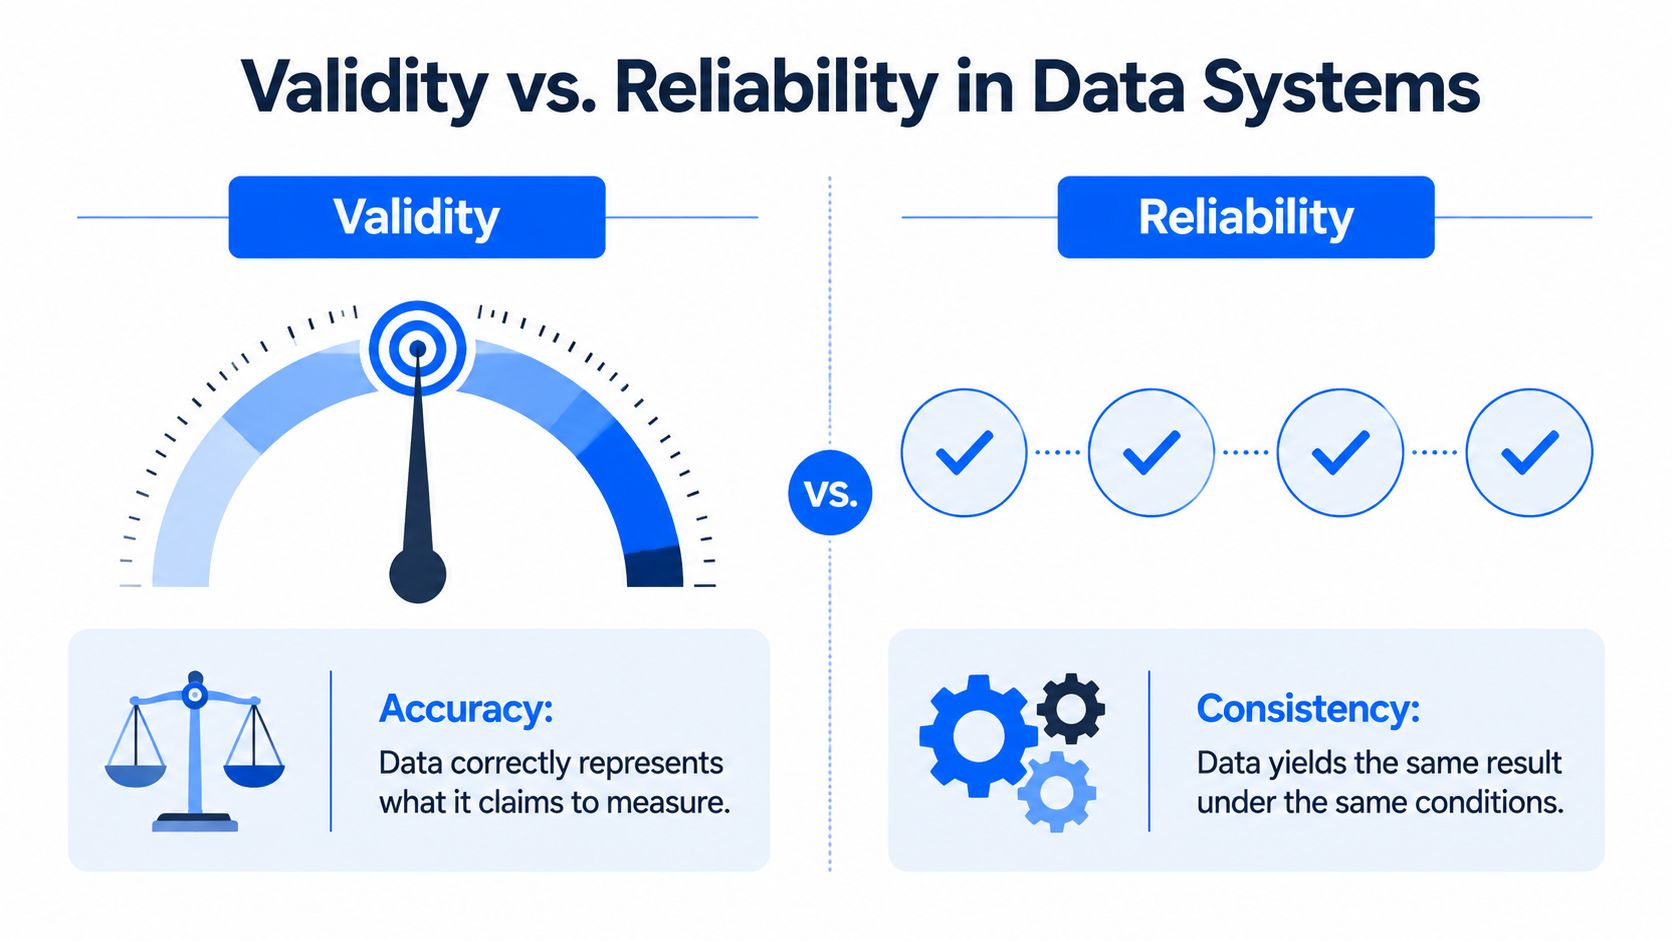
Gültigkeit fragt, ob ein Datensatz das darstellt, was er vorgebbar darstellt, und den Regeln für akzeptable Daten entspricht. Zuverlässigkeit fragt, ob die Ergebnisse im Laufe der Zeit und unter sich ändernden Messbedingungen konsistent bleiben. Die statistischen Standards der Vereinten Nationen behandeln die beiden als verwandte, aber getrennte Eigenschaften.
Eine Waage, die konstant 5 Pfund zu viel anzeigt, ist zuverlässig, weil sie reproduzierbare Ergebnisse liefert, aber sie ist nicht gültig, weil ihre Messwerte das tatsächliche Gewicht verfehlen. Eine Waage, die willkürlich schwankt, ist weder zuverlässig noch gültig.
Was Gültigkeit in der Produktion bedeutet
In einer Datenplattform umfasst die Gültigkeit mehr als nur die Frage, ob ein Wert plausibel aussieht. Ingenieure prüfen üblicherweise:
Typkonformität: Numerische Felder enthalten Zahlen, Datumsangaben werden korrekt analysiert und IDs behalten ihre erforderliche Darstellung.
Bereichskonformität: Werte bleiben innerhalb sinnvoller unterer und oberer Grenzen.
Formatkonformität: E-Mails, Codes, Telefonnummern und Zeitstempel entsprechen den akzeptierten Mustern.
Referenzielle Integrität: Fremdschlüssel verweisen auf Datensätze in der richtigen Dimensions- oder Referenztabelle.
Einhaltung von Geschäftsregeln: Zusammenhängende Felder stimmen untereinander und mit dem von ihnen beschriebenen Prozess überein.
Ein Kundenalter von 37 Jahren kann genau und gültig sein. Ein negatives Alter ist ungültig, selbst wenn die Datenbank es akzeptiert. Ein Zeitstempel kann dem erforderlichen Format entsprechen, während er dennoch das falsche Ereignis darstellt, weil ein vorgelagertes System eine unerwartete Zeitzone angewendet hat.
Die Unterscheidung zwischen Genauigkeit und Gültigkeit ist in der Produktion von Bedeutung. Genauigkeit betrifft die Frage, ob ein Wert die Realität widerspiegelt. Gültigkeit betrifft die Frage, ob er dem Data Contract und dem Messdesign entspricht. Ein Wert kann vernünftig erscheinen und dennoch eine Regel verletzen, die die nachgelagerte Interpretation schützt. Der Leitfaden zur Datengültigkeit erklärt, wie Teams diese Unterscheidung in der Praxis bewerten können.
Warum Zuverlässigkeit mehr als Konsistenz erfordert
Zuverlässigkeit umfasst eine verlässliche Verfügbarkeit, eine vollständige Bereitstellung und das Eintreffen innerhalb des Zeitrahmens, den eine Entscheidung erfordert. Eine Pipeline, die jede Nacht dieselbe fehlerhafte Transformation wiederholt, ist zwar konsistent, aber ihr Output ist kein zuverlässiger Beleg. Gültige Datensätze, die erst nach einem Planungstreffen eintreffen, können ebenfalls unbrauchbar sein.
Die Worldwide Governance Indicators der Weltbank stellen standardisierte Daten aus mehreren Quellen für mehr als 200 Volkswirtschaften von 1996 bis 2024 zusammen, wobei 35 länderübergreifende Quellen wie Haushaltsbefragungen, Unternehmensbefragungen und Expertenbewertungen herangezogen werden. Vergleiche zwischen Märkten erfordern Daten, die strukturell gültig bleiben und konsistent produziert werden.
Observability verbindet diese Eigenschaften auf operativer Ebene. Aktualitätsprüfungen, Warnungen bei Schemaänderungen, Volumenüberwachung und Trends bei Regelfehlern zeigen, ob gültige Datensätze weiterhin in einem zuverlässigen Muster eintreffen. „Die Pipeline ist zuverlässig“ sollte das Lieferverhalten beschreiben. „Die Daten sind gültig“ sollte die Konformität und Bedeutung beschreiben. Das Vertrauen in die Produktion erfordert beides.
Häufige Fehlermodi, die das Vertrauen in Daten zerstören
Eine Pipeline kann die Erfassungsprüfungen bestehen und den Datensatz später dennoch beschädigen. Die Fehler treten meist auf, wenn Datensätze auf Transformationen, Joins, Geschäftsregeln oder sich ändernde vorgelagerte Strukturen treffen. Produktionskontrollen müssen diese Interaktionen testen und nicht nur isolierte Felder.
Schleichende Schemaänderung (Silent Schema Drift)
Ein vorgelagerter Dienst fügt ein Feld hinzu, entfernt es, benennt es um oder ändert den Typ. Der Consumer läuft möglicherweise weiter, weil die Abfrage immer noch analysiert wird oder eine flexible Payload die Änderung akzeptiert. Eine Transformation kann dann das falsche Feld zuordnen, einen neuen Status verwerfen oder das Null-Verhalten ändern, ohne einen operativen Fehler auszulösen. Die Anleitung zum Schema Drift von digna beschreibt, wie strukturelle Änderungen Consumer unbemerkt beeinträchtigen können.
Null-Vererbung
Ein erforderlicher Join-Key wird in einem kleinen Teil der eingehenden Datensätze zu Null. Schema- und Typprüfungen auf Quellebene werden weiterhin bestanden, aber der Join schließt diese Datensätze aus. Faktentabellen verlieren zugehörige Zeilen und Aggregate weisen Lücken auf, ohne dass ein offensichtlicher Erfassungsfehler vorliegt. Verteilungsprüfungen und das Monitoring von Join-Übereinstimmungen können diese Lücke aufdecken.
Zeitzonen-Fehlanpassungen
Ein Zeitstempel kann syntaktisch gültig bleiben, während sich seine Zeitzoneninterpretation ändert. Stündliche, tägliche oder monatliche Aggregationen ordnen Ereignisse dann dem falschen Zeitraum zu. Ein Format-Validator genehmigt den Wert, obwohl sich seine analytische Bedeutung verschoben hat. Das Monitoring sollte Zeitzonenannahmen und das Grenzverhalten vergleichen, insbesondere bei Berichtsstichtagen.
Doppelte Zustellung
At-Least-Once-Streaming kann ein Ereignis mehr als einmal liefern. Die Validierung auf Zeilenebene genehmigt jede Kopie, da jeder Datensatz für sich genommen gültig ist. Ohne Idempotenz oder Deduplizierung werden Umsatz-, Aktivitäts- und Transaktionsaggregate künstlich aufgebläht. Ereignis-IDs und Warnungen vor Duplikaten bieten eine Kontrolle auf Ebene des Geschäftsereignisses.
Veraltete Dimensionen
Ein Faktendatensatz kann einen gültig aussehenden Schlüssel enthalten, der in der aktuellen Dimensionstabelle fehlt. Standardmäßige Schemavalidierung zeigt nicht an, dass die Referenzdaten veraltet sind. Nach dem Join sehen Analysten möglicherweise unbekannte Kategorien, fehlende Attribute oder fehlerhafte Segmentierungen. Prüfungen der referenziellen Integrität und der Aktualität von Dimensionen fangen verschiedene Teile des Problems ab.
Fehlermodus | Was die einfache Validierung abfängt | Was in der Produktion fehlschlägt |
|---|---|---|
Silent Schema Drift | Analysierbarkeit und erwartete Feldtypen | Transformationen, Joins oder Mappings nutzen veränderte Struktur |
Null-Vererbung | Spaltentyp und grundlegendes Format | Joins verwerfen Datensätze und nachgelagerte Summen werden unvollständig |
Zeitzonen-Fehlanpassung | Zeitstempel-Syntax | Zeitreihenfenster ordnen Ereignisse dem falschen Zeitraum zu |
Doppelte Zustellung | Gültigkeit der einzelnen Zeile | Aggregate zählen dasselbe Geschäftsereignis wiederholt |
Veraltete Dimensionen | Faktentabellen-Struktur | Referenz-Joins verlieren Attribute oder erzeugen ungelöste Schlüssel |
Die operative Lehre ist direkt: Die Gültigkeit von Datensätzen ist notwendig, aber nicht ausreichend. Tests müssen auch Beziehungen, Verteilungen, Lieferverhalten und strukturelle Änderungen überwachen. Observability verbindet diese Prüfungen mit den Ergebnissen, indem sie zeigt, ob ein gültiger Datensatz weiterhin in der erwarteten Form, im erwarteten Volumen und zur erwarteten Zeit eintrifft. Ohne diese Sichtweise validieren Teams einzelne Teile, während sie den Systemfehler übersehen.
Wie Timeliness und Schema-Stabilität das Bild vervollständigen
Ein Datensatz kann bei der Erstellung jede Validierungsregel bestehen und dennoch für die von ihm unterstützte Entscheidung falsch sein. Wenn der gestrige Inventar-Snapshot nach dem heutigen Zuteilungslauf eintrifft, können Typen, Bereiche und Geschäftsregeln alle gültig sein. Der Datensatz ist dennoch unbrauchbar, da er den aktuellen Betriebszustand nicht mehr darstellt.
Freshness ist daher eine zeitliche Gültigkeitsbeschränkung. Das Monitoring sollte überprüfen, ob die erwarteten Daten eingetroffen sind, ob kein Batch fehlt und ob die neuesten Datensätze innerhalb des vereinbarten Betriebsfensters bleiben. Dieser Leitfaden zu Data Timeliness, Metriken und Monitoring erklärt, wie man dieses Fenster messbar macht. Ein praktischer Leitfaden zum Freshness-Monitoring bietet denselben operativen Fokus: „Die Daten sollten aktuell sein“ muss eine Bedingung werden, die bestanden werden, fehlschlagen und Maßnahmen auslösen kann.
Drei Achsen für die Produktionsreife
Bewerten Sie jeden kritischen Datensatz anhand von drei miteinander verbundenen Achsen:
Korrektheit: Werte entsprechen den Anforderungen an Typ, Format, Bereich, Beziehung und Geschäftsregeln.
Freshness (Aktualität): Daten treffen innerhalb des vereinbarten Lieferfensters ein und spiegeln den relevanten Zustand des Unternehmens wider.
Strukturelle Stabilität: Felder, Typen, Tabellen und Beziehungen bleiben mit den konsumierenden Systemen kompatibel.
Ein Datensatz kann eine Achse erfüllen, während er auf einer anderen versagt. Ein Kundenexport kann korrekte Datensätze enthalten, aber erst nach Beginn einer Kampagne eintreffen. Ein Streaming-Feed kann kontinuierlich eintreffen, während er Ereignisse dupliziert. Eine Tabelle kann ihr Schema beibehalten, selbst nachdem eine Quelle die Bedeutung eines Statuscodes geändert hat.
Schema-Stabilität ist ein aktiver Vertrag
Schemaänderungen erfordern eine Auswirkungsanalyse, keine automatische Ablehnung. Eine neue Nullable-Spalte kann für Consumer, die unbekannte Felder ignorieren, sicher sein. Eine gelöschte Spalte, ein umbenanntes Feld oder eine Typänderung kann eine Transformation unterbrechen oder deren Ausgabe unbemerkt verändern.
Observability verbindet Freshness, Schema Drift, Volumenverschiebungen und Pipeline-Fehler, anstatt sie als isolierte Warnungen zu behandeln. Ataccamas Diskussion über Datenqualität und Data Observability beschreibt Freshness als Aktualität, Schema Drift als strukturelle Änderung und Volumenanomalien als unerwartete Änderungen der Datensatzgröße.
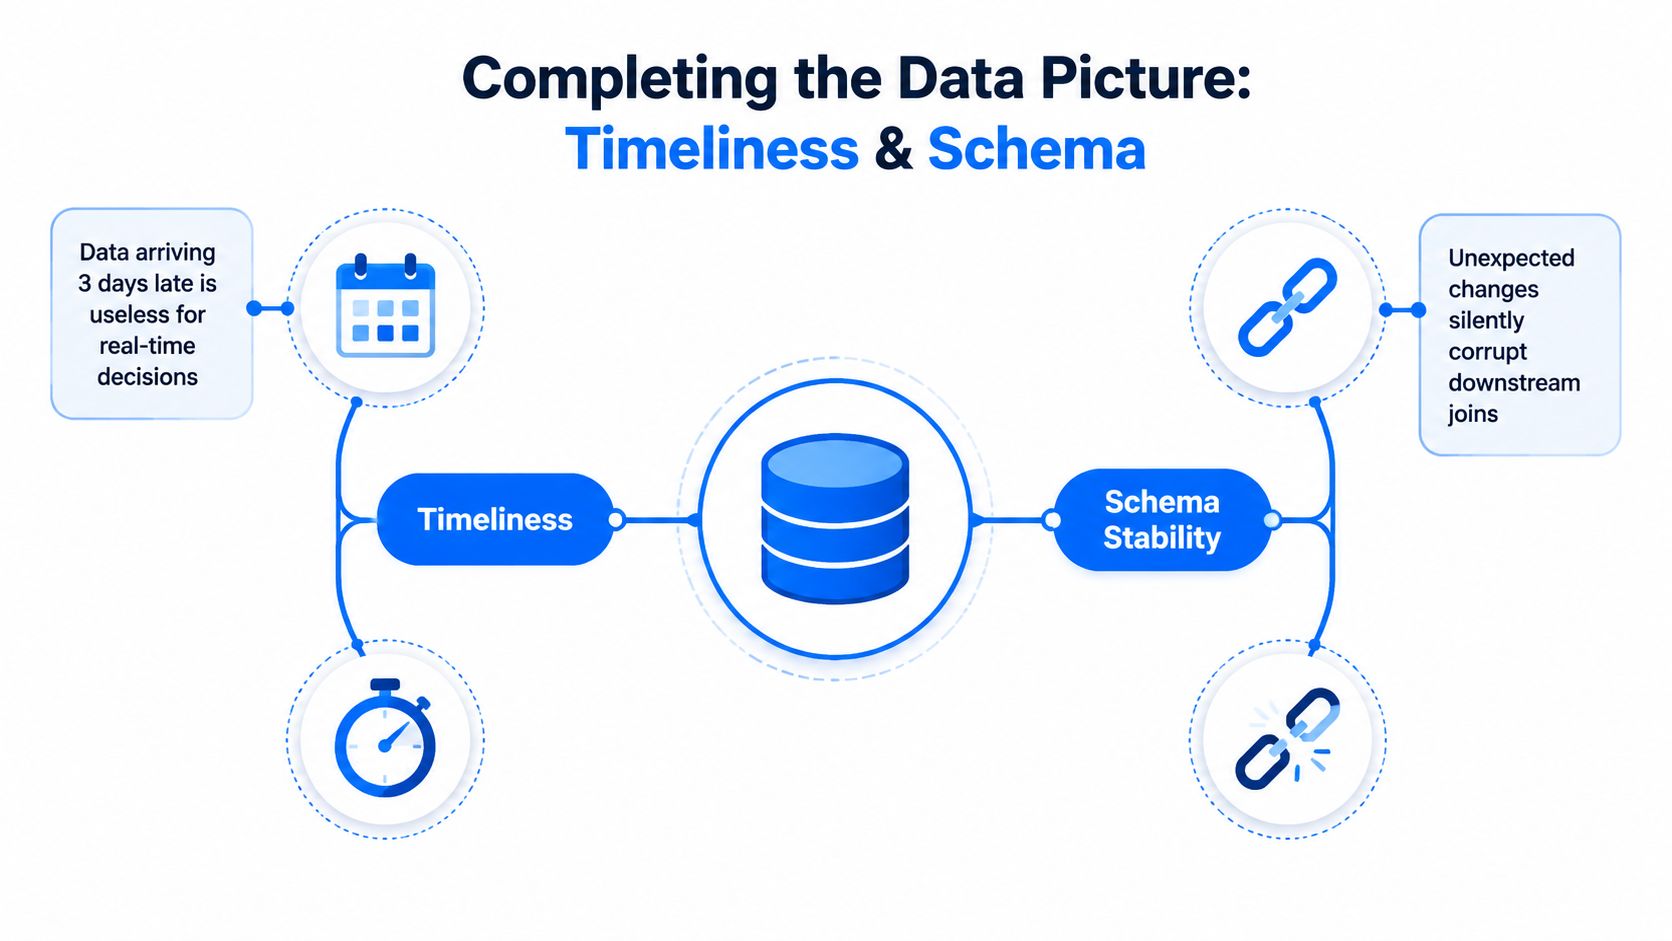
Das Zusammenspiel ist wichtiger als jede einzelne Kennzahl. Korrektheit ohne Freshness liefert die historische Wahrheit zum falschen Entscheidungszeitpunkt. Freshness ohne strukturelle Stabilität liefert aktuelle Daten, die von Consumern möglicherweise falsch interpretiert werden. Strukturelle Stabilität ohne Korrektheit bewahrt eine zuverlässige Form für fehlerhafte Werte.
Zuverlässige Daten sind nur dann gültige Daten, wenn Korrektheit, Freshness und strukturelle Stabilität zusammenwirken.
Praktische Kontrollen zur Erreichung von Gültigkeit und Zuverlässigkeit
Kontrollen funktionieren am besten, wenn sie nah an dem Fehler angesiedelt sind, den sie abfangen sollen. Ein einzelner Test am Ende der Pipeline kommt für einen verletzten Quellvertrag zu spät, während Dutzende von undifferenzierten Warnungen zu Müdigkeit führen und Teams dazu verleiten, das Monitoringsystem zu ignorieren.
Beginnen Sie mit geschichteten Prüfungen
Wenden Sie an der Quell- oder Staging-Grenze Zusicherungen auf Spaltenebene für erforderliche Felder, akzeptierte Typen, Null-Verhalten, Bereiche und genehmigte Referenzwerte an. Fügen Sie Verteilungsprüfungen hinzu, bei denen ein gültiger Datensatz dennoch einen ungültigen Datensatz erzeugen kann, wie etwa eine plötzliche Konzentration in einer Kategorie oder ein unerwarteter Einbruch bei ausgefüllten Werten.
Testen Sie auf der Integrationsebene die Beziehungen. Prüfungen der referenziellen Integrität sollten bestätigen, dass Schlüssel aufgelöst werden. Eindeutigkeitsprüfungen sollten doppelte Geschäftsereignisse identifizieren. Spaltenübergreifende Regeln sollten Kombinationen wie Status und Abschlussdatum überprüfen, anstatt jedes Feld isoliert zu testen.
Überwachen Sie auf der Consumption-Ebene die Metriken, die von den Stakeholdern genutzt werden. Ein Dashboard kann technisch verfügbar bleiben, während sich seine Kernmetrik für Umsatz, Kunden oder Risiken abnormal verhält. Prüfungen auf Geschäftsebene bieten einen letzten Schutz gegen Fehler, die von tiefer liegenden Zusicherungen nicht erfasst werden.
Fügen Sie operative Observability hinzu
Freshness-Monitore sollten erwartete Ankunftsmuster, verzögerte Batches, fehlende Ladungen und vorzeitige Lieferungen überwachen. Schema-Diff-Detektoren sollten hinzugefügte, entfernte, umbenannte oder neu typisierte Felder melden, bevor eine bahnbrechende Änderung die abhängigen Modelle erreicht. Datadogs Dokumentation zum Data-Observability-Monitor beschreibt die Erkennung auf Datenbank-, Schema-, Tabellen- und Spaltenebene.
Die Erkennung von Volumenanomalien schließt eine weitere wichtige Lücke. Sie kann stillschweigende Kürzungen, unerwartete Spitzen bei Duplikaten und unvollständige Extraktionen aufdecken, selbst wenn jede gelieferte Zeile die Validierung besteht.
Kontrolle | Fängt ab | Pipeline-Phase | Alarm-Priorität |
|---|---|---|---|
Null- und Bereichszusicherungen | Fehlende erforderliche Werte und ungültige Grenzen | Quelle oder Staging | Hoch, wenn kritische Felder fehlschlagen |
Referenzielle Prüfungen | Nicht aufgelöste Dimensions- und Referenzschlüssel | Integration | Hoch für betroffene Joins |
Freshness-Monitoring | Verspätete, fehlende oder unerwartet frühe Ladungen | Quelle und Staging | Kritisch für entscheidungsrelevante Datensätze |
Schema-Diff-Erkennung | Hinzugefügte, entfernte, umbenannte oder neu typisierte Felder | Quellvertrag | Kritisch bei schwerwiegenden Änderungen |
Erkennung von Volumenanomalien | Kürzungen, Duplikate-Spitzen und Teilladungen | Staging und Consumption | Hoch, wenn Aggregate betroffen sind |
Monitoring von Business-Metriken | Unerwartetes KPI-Verhalten | Consumption | Priorität richtet sich nach geschäftlicher Auswirkung |
Schwellenwerte sollten normales Verhalten widerspiegeln, nicht willkürliche Perfektion. Eine Warnung, die bei jeder Wochenendschwankung ausgelöst wird, bringt den Betreibern bei, Alarme zu ignorieren. Ein nützliches Health-Dashboard kombiniert technische Signale mit Zuständigkeiten, betroffenen Assets, der letzten erfolgreichen Lieferung und der gefährdeten Geschäftsentscheidung. Teams können auch kontinuierliche Data Validation-Regeln und -Prüfungen nutzen, um Kontrollen auf Datensatzebene mit fortlaufendem Qualitätsmonitoring zu verbinden.
Warum statische Data Validation für moderne Datenplattformen nicht ausreicht
Statische Validierungsregeln sind nützliche Hürden, werden jedoch brüchig, wenn Teams sie als vollständige Zuverlässigkeitsstrategie betrachten. Eine einmal geschriebene Regel bestätigt möglicherweise, dass ein Feld nicht Null ist, übersieht dabei jedoch einen neuen Enum-Wert, eine geänderte Semantik, ein doppeltes Ereignismuster oder eine Quelle, die keine aktuellen Daten mehr liefert.
Moderne Plattformen verarbeiten Streaming-Ereignisse, semistrukturierte Payloads und Antworten von Drittanbietern, die sich außerhalb des Release-Zyklus des Warehouse-Teams entwickeln. Diese Betriebsumgebung erfordert kontinuierliche Observability und nicht nur punktuelle Validierungen.
Die geschäftlichen Folgen können schwerwiegend sein. Bei einem berichteten Vorfall im Einzelhandel übersah eine statische Null-Prüfung einen neuen Enum-Wert und leitete 4 Millionen USD an Attributionen falsch weiter. Ein weiteres Beispiel aus dem Fintech-Bereich betraf eine fest codierte Bereichszusicherung, die einen Währungscode-Wechsel nicht erkannte, was die Risikobewertungen künstlich in die Höhe trieb. Diese Beispiele verdeutlichen die zentrale Schwäche statischer Regeln: Sie können bekannte Bedingungen überprüfen, übersehen jedoch ungewohntes, aber folgenschweres Verhalten.
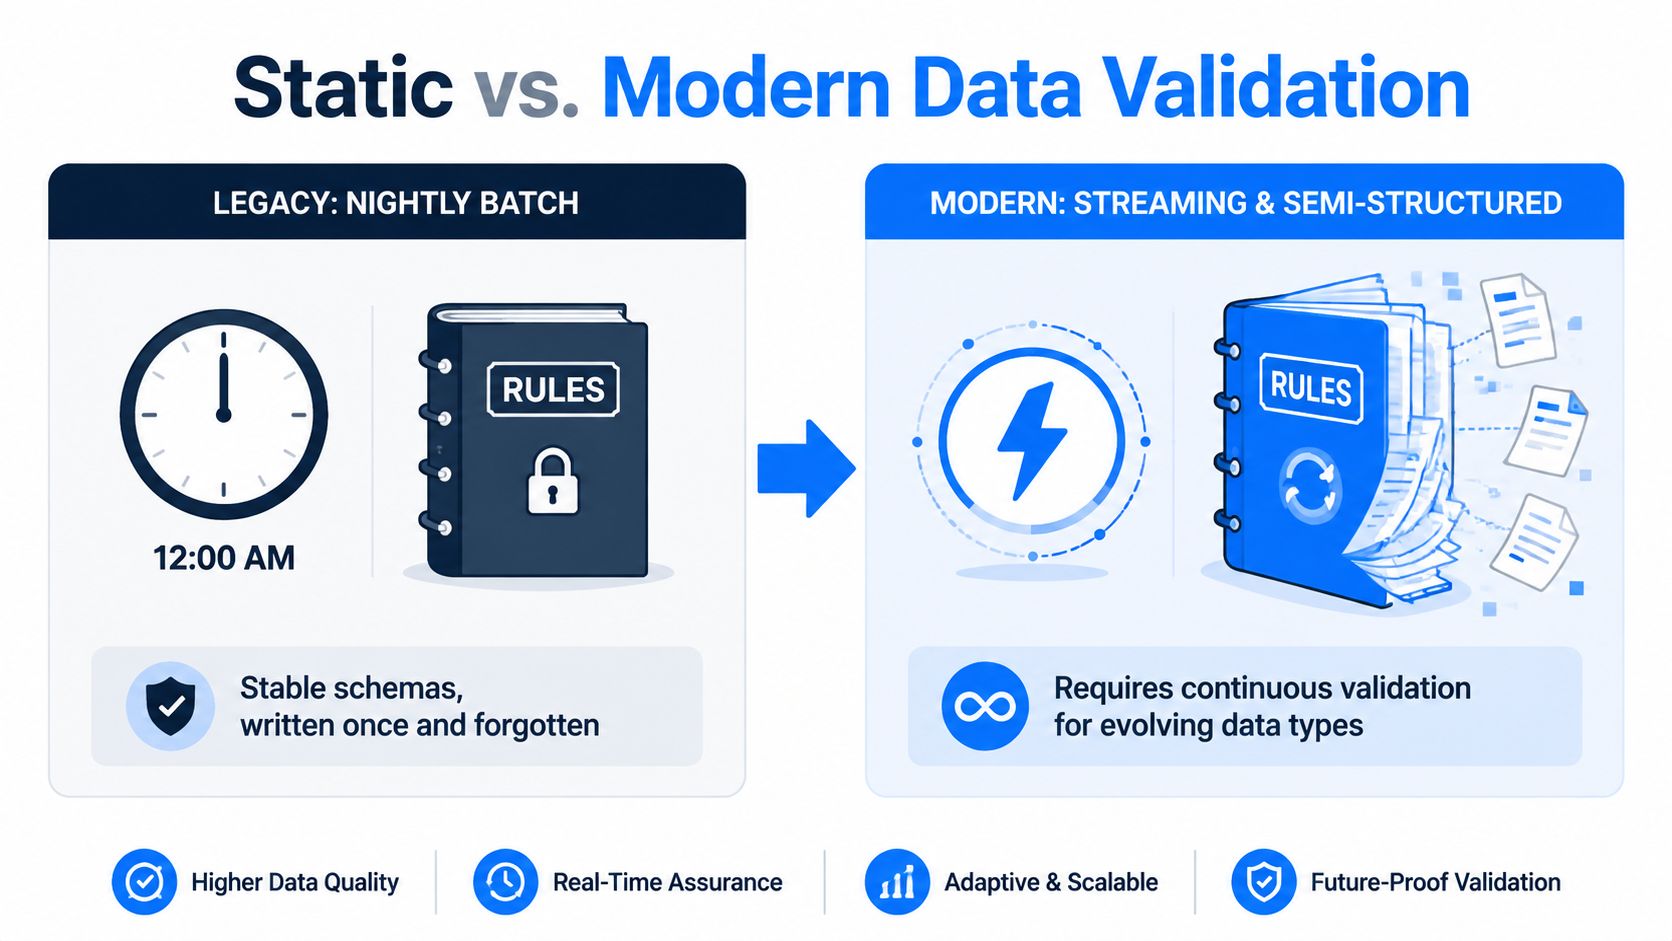
Kontinuierliche Observability überwacht, wie sich Daten im Laufe der Zeit verhalten. Sie kombiniert explizite Verträge mit Anomalieerkennung, Freshness-Tracking, Volumenanalyse und dem Monitoring von Schemaänderungen. Dieses Modell ersetzt deterministische Regeln nicht. Es bettet sie in eine Feedbackschleife ein, die erkennen kann, wenn sich die Umgebung verändert hat.
Der praktische Wandel führt weg von „Hat dieser Wert den Test bestanden?“ hin zu „Verhält sich dieser Datensatz immer noch so, wie es für seinen Zweck erwartet wird?“. Diese Frage deckt Fehler auf, die eine statische Validierung im Vorfeld nicht beschreiben kann.
Aufbau einer skalierbaren Datenzuverlässigkeitsstrategie
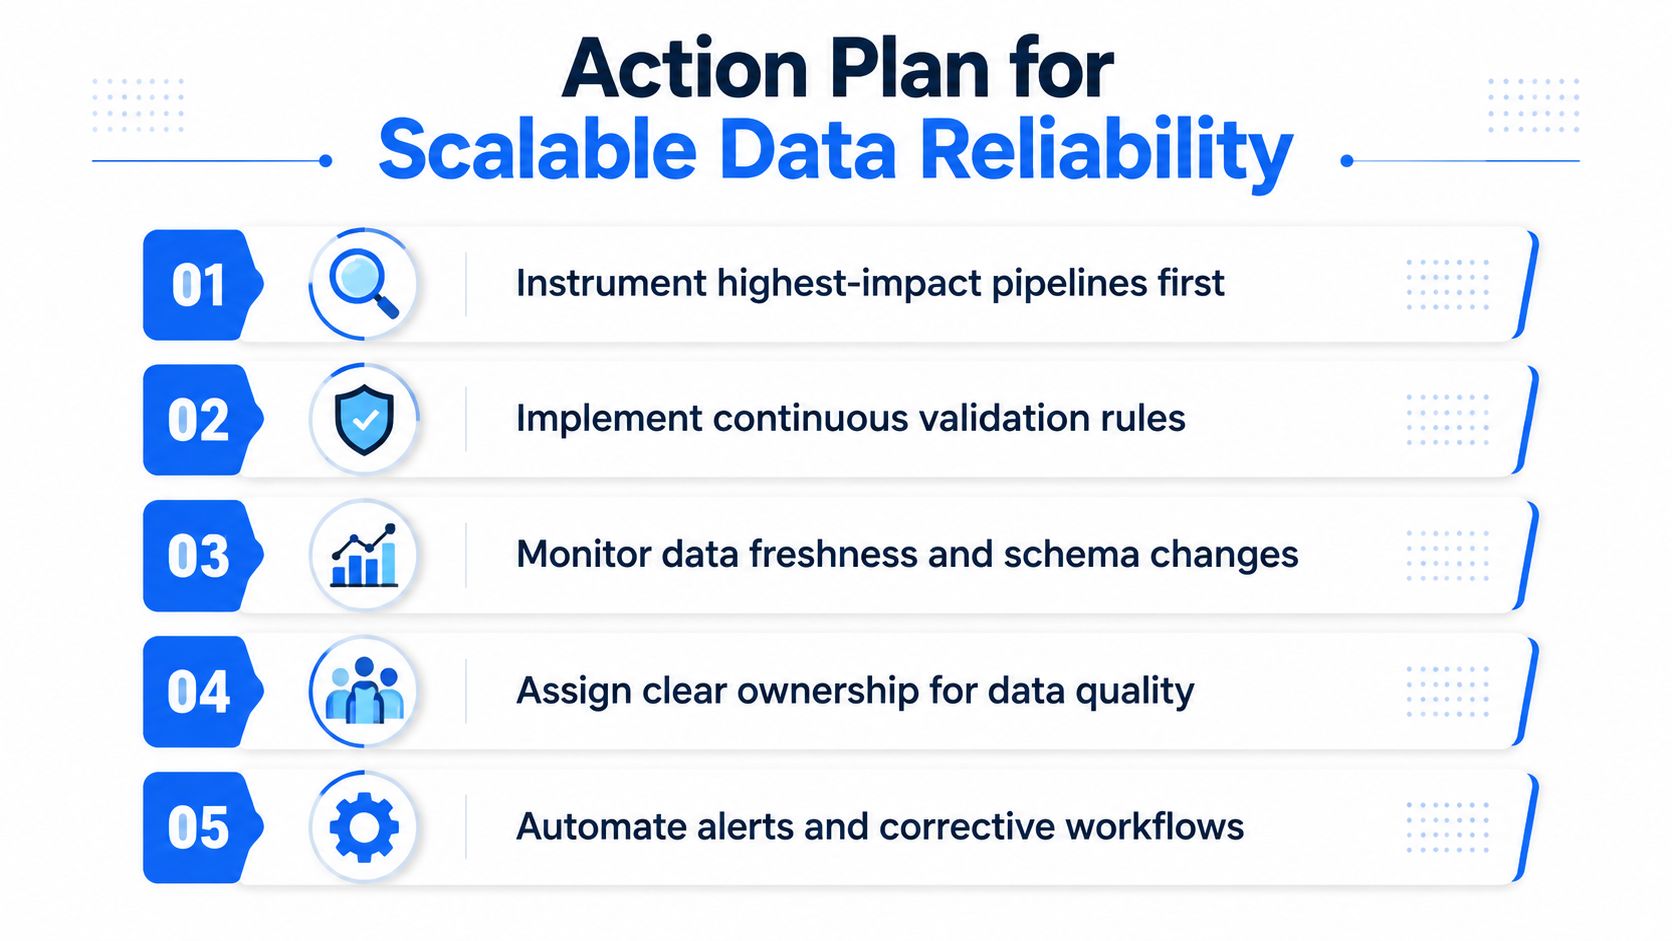
Teams müssen nicht jede Tabelle instrumentieren, bevor sie das Vertrauen verbessern. Beginnen Sie mit den Pipelines, die regulatorische Berichte, Management-Kennzahlen, den Kundenbetrieb, finanzielle Entscheidungen oder KI-Funktionen speisen.
Nutzen Sie diese Reihenfolge:
Auswirkungen priorisieren: Ordnen Sie kritische Datensätze den Entscheidungen und Modellen zu, die von ihnen abhängen.
Lieferverträge definieren: Legen Sie Erwartungen an Freshness, Vollständigkeit und Schema-Kompatibilität fest.
Kontrollen schichten: Kombinieren Sie deterministische Validierung mit Anomalie-, Volumen- und Strukturmonitoring.
Zuständigkeiten zuweisen: Geben Sie Ingenieuren, Analysten und geschäftlichen Stakeholdern klare Eskalationspfade an die Hand.
Den Kreis schließen: Nutzen Sie Vorfälle, um Schwellenwerte, Verträge und Behebungs-Workflows zu verfeinern.
Für Teams, die Management-Kommunikation neben operativen Daten analysieren, können linguistische Erkenntnisse aus Earnings Calls zusätzlichen Kontext darüber liefern, wie Geschäftssprache und Leistungssignale interpretiert werden. Diese Art der Kontextanalyse hängt weiterhin von Quelldaten ab, die gültig, zeitnah und strukturell stabil bleiben.
Der operative Standard wird durch dignas Perspektive auf Datenzuverlässigkeit gut zusammengefasst: Observability sollte die technische Gesundheit mit der Vertrauenswürdigkeit der konsumierten Daten verbinden. Skalierbare Zuverlässigkeit bedeutet nicht, statische Regeln anzuhäufen. Es geht darum, Feedbackschleifen aufzubauen, die Teams helfen, Veränderungen zu erkennen, Auswirkungen zu verstehen und zu reagieren, bevor ungültige Daten die Entscheidungsfindung erreichen.
digna hilft Datenteams, die Gültigkeit von Datensätzen, Freshness, Schemaänderungen, Anomalien und Business-Metriken innerhalb ihrer eigenen Datenumgebung zu überwachen. Besuchen Sie digna, um zu sehen, wie kontinuierliche Observability dazu beitragen kann, fehlerhafte Pipelines und ungültige Daten abzufangen, bevor sie Dashboards, Analysen und KI-Workflows erreichen.
Häufig gestellte Fragen
Können Daten verlässlich und trotzdem nicht valide sein?
Ja, und diese Lücke verursacht einige der teuersten Vorfälle in modernen Datenplattformen. Pipeline-Verlässlichkeit heißt, der Job lief und lieferte planmäßig eine Ausgabe; Validität heißt, die Werte bedeuten noch das, was das Geschäft annimmt.
Was beantwortet einfaches Monitoring tatsächlich?
Operative Fragen: Startete der Job, endete er, akzeptierte das Warehouse die Abfrage, erzeugte der erwartete Task eine Ausgabe, aktualisierte das Dashboard. Das zählt, doch nichts davon sagt, ob ein Kundenidentifikator noch auf die richtige Kundin zeigt.
Wie sieht ein Validitätsfehler von außen aus?
Wie eine Frage und nicht wie ein Alert. Jemand fragt, warum die Conversion für einen Kanal einbrach, während das Dashboard weiterhin eine erfolgreiche Aktualisierung zeigt, und an diesem Punkt veröffentlicht eine verlässlich wirkende Pipeline längst ungültige Daten.
Welche Validitätsprüfungen erfassen, was Monitoring übersieht?
Die an Bedeutung gebundenen: ob ein Kundenidentifikator noch auf die richtige Kundin zeigt, ob ein Zeitstempel in den gemeinten Berichtszeitraum gehört und ob ein Statuscode im freigegebenen fachlichen Vokabular bleibt.
Wie greifen Timeliness und Validität ineinander?
Sie decken verschiedene Hälften des Vertrauens ab. Timeliness bestätigt, dass die Daten da sind, wenn die Entscheidung sie braucht; Validität bestätigt, dass die vorhandenen Daten beschreiben, was sie behaupten. Ein Datensatz braucht beides, bevor ihn jemand vertrauenswürdig nennen sollte.



