Wie man die Datengenauigkeit misst: 8 praktische Methoden
|
9
min. Lesezeit

Die Genauigkeit wird gemessen, indem Daten mit einer vertrauenswürdigen Erwartung oder einer bekannten Wahrheit verglichen werden und dieser Vergleich anschließend durch Validierung, Abstimmung, Stichprobenverfahren, Anomalieerkennung und historische Analysen untermauert wird. Für kritische Datensätze definiert ein praktischer Benchmark die Genauigkeit als korrekte Datensätze ÷ Gesamtdatensätze × 100, mit einem empfohlenen Zielwert von mindestens 98 % für kritische Daten, obwohl der richtige Schwellenwert vom Geschäftsrisiko und dem jeweiligen Anwendungsfall abhängt (Praktisches Framework von Acceldata).
Der gängige Rat lautet, einige Null-Prüfungen durchzuführen, zu bestätigen, dass Daten das richtige Format verwenden, und den Datensatz als genau zu bezeichnen, wenn die Pipeline grün wird. Dieser Ansatz misst jedoch die Vollständigkeit und Gültigkeit, nicht unbedingt die Wahrheit. Eine Kundenadresse kann vollständig und korrekt formatiert sein, aber dennoch falsch. Ein Transaktionsbetrag kann die technische Validierung bestehen und dennoch von dem tatsächlich berechneten Betrag abweichen. Ein Datum wie 31. Dezember 2099 kann syntaktisch gültig, aber als Geburtsdatum eines Kunden ungenau sein.
Datengenauigkeit ist der Grad, in dem Daten das reale Objekt, Ereignis oder den Wert, den sie beschreiben, korrekt wiedergeben. Das erforderliche Niveau hängt von der beabsichtigten Verwendung ab. Eine kleine Diskrepanz kann bei explorativen Analysen tolerierbar sein, ist jedoch bei der Finanzberichterstattung, in Patientenakten, bei regulatorischen Daten oder bei einer automatisierten Entscheidung inakzeptabel.
Eine fundierte Bewertung trennt zwischen Bias (systematischer Fehler), Präzision, Unsicherheit, Gültigkeit, Angemessenheit, Timeliness und strukturellen Änderungen. Die Messwissenschaft beschreibt Genauigkeit durch die Nähe zu einem wahren oder Referenzwert, während Bias die systematische Abweichung und Präzision die Streuung wiederholter Messungen widerspiegelt (Leitfaden des National Physical Laboratory). Die unten aufgeführten Methoden betrachten Genauigkeit als kumulierte Belege dafür, dass Daten die Realität widerspiegeln, und nicht als einen einzigen, universellen Wert.
Inhaltsverzeichnis
7. Vollständigkeit und Timeliness als Genauigkeitsindikatoren
8. Integrierte Multi-Methoden-Strategie zur Genauigkeitsüberwachung
1. Vergleich mit vertrauenswürdigen Datenquellen
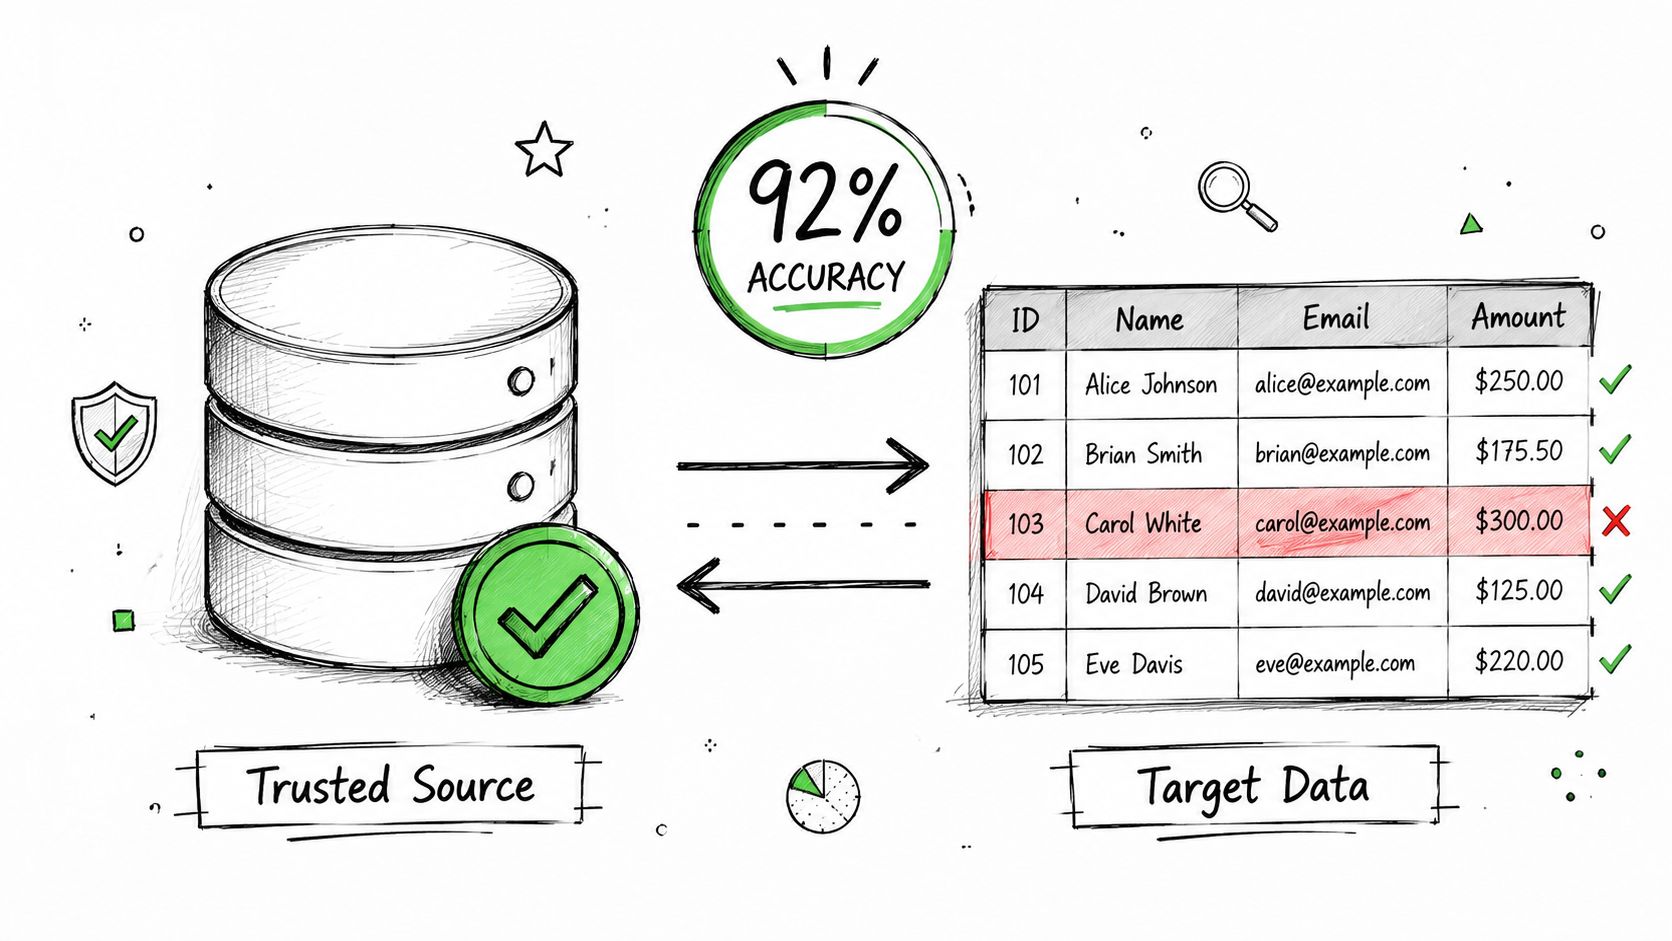
Der direkte Vergleich liefert den stärksten ersten Beleg, wenn eine Quelle über eine definierte Autorität und Kontrollen verfügt. Ein Data-Warehouse-Datensatz kann mit einer Master-Kundendatenbank abgeglichen werden, ein Analytics-Preis mit einem freigegebenen Preissystem und ein Berichtbetrag mit einem verifizierten Transaktionsprotokoll. Die Frage ist konkret: Stimmt der erfasste Wert mit der Referenz überein, die zur Darstellung des erwarteten Objekts, Ereignisses oder Werts verwendet wird?
Ein grundlegendes Maß ist:
Genauigkeitsrate = korrekt übereinstimmende Datensätze ÷ bewertete Datensätze × 100
Diese Rate hat erst dann eine Aussagekraft, wenn das Team definiert hat, was eine „Übereinstimmung“ ist. Exakte Gleichheit kann für eine Transaktions-ID oder einen genehmigten Produktpreis angemessen sein. Eine Adresse erfordert möglicherweise eine Normalisierung, während ein Statusfeld eventuell eine Stichtagsregelung benötigt, da Systeme zu unterschiedlichen Zeiten aktualisiert werden. Das Ergebnis misst daher die Übereinstimmung unter einer definierten Vergleichsmethode, nicht die Genauigkeit in jedem denkbaren Sinne.
Definieren Sie die Referenz vor der Berechnung
Dokumentieren Sie die vertrauenswürdige Quelle, den Eigentümer, die Aktualisierungshäufigkeit, die relevanten Felder, den Matching-Schlüssel und das akzeptable Zeitfenster. Ein Ladevorgang im Warehouse, der kurzzeitig hinter einem Master-System zurückbleibt, spiegelt möglicherweise eine normale Verarbeitungslatenz wider und keinen fehlerhaften Wert. Eine Referenz kann auch veraltete oder fehlerhafte Datensätze enthalten, sodass ihre Autorität durch Kontrollen gestützt und nicht einfach vorausgesetzt werden sollte.
Praktische Regel: Ein Vergleich beweist die Übereinstimmung mit der ausgewählten Referenz. Er beweist nicht, dass die Referenz selbst das zugrunde liegende Objekt, Ereignis oder den Wert korrekt darstellt, es sei denn, diese Quelle verfügt über eigene Qualitätskontrollen.
Anwendungsbereiche sind unter anderem:
Kundenidentität: Vergleichen Sie Warehouse-Adressen mit dem Master-CRM-Datensatz und erfassen Sie, ob der Abgleich exakt, normalisiert oder stichtagsbezogen erfolgt.
Finanzberichterstattung: Vergleichen Sie Transaktionsbeträge in einer Berichtsdatenbank mit dem Quell-Banksystem.
Product Governance: Überprüfen Sie Analytics-Preise gegen die genehmigte Preissreferenz.
Kundenlebenszyklus: Gleichen Sie Statusfelder mit autoritativen Geschäftsunterlagen ab.
Teams können digna Data Reconciliation nutzen, um wiederkehrende Quelle-Ziel-Vergleiche zu automatisieren, fehlgeschlagene Abgleiche zu untersuchen und nachzuverfolgen, ob Diskrepanzen isoliert oder dauerhaft auftreten. Legen Sie Akzeptanzschwellenwerte basierend auf den geschäftlichen Auswirkungen fest. Eine perfekte Übereinstimmung ist nicht immer erforderlich, während eine minimale Abweichung bei einem Feld mit hoher Priorität inakzeptabel sein kann.
2. Validierung von Geschäftsregeln
Geschäftsregeln übersetzen eine Genauigkeitserwartung in einen deterministischen Test. Eine Rechnungssumme sollte den Einzelposten zuzüglich Steuern entsprechen. Ein Kundenrabatt sollte innerhalb des Limits für die jeweilige Kundenstufe liegen. Die Kosten eines Produkts sollten den genehmigten Verkaufspreis nicht überschreiten. Jede Regel liefert einen prüfbaren Beleg dafür, dass eine definierte Beziehung eingehalten wird.
Die Methode ist besonders nützlich, weil ihr Umfang explizit ist. Eine fehlgeschlagene Prüfung identifiziert die verletzte Erwartung und isoliert häufig den betroffenen Datensatz, das Feld oder die Transformation. Die Regelvalidierung eignet sich für kritische Felder, Compliance-Kontrollen, berechnete Kennzahlen und Beziehungen, die ohne subjektives Urteil bewertet werden können.
Eine erfolgreiche Regel beweist die Konformität mit der in dieser Regel codierten Logik. Sie beweist nicht, dass der zugrunde liegende Wert die Realität widerspiegelt. Eine intern konsistente Rechnung kann dennoch einen falschen berechneten Betrag aufweisen, und ein nicht-negativer Lagerbestand kann sich dennoch von der physischen Zählung unterscheiden. Wie der Rat zur Erkennung von Tachobetrug zeigt, garantiert das Bestehen von Formatprüfungen nicht, dass ein Wert den tatsächlichen Zustand der Welt widerspiegelt.
Entwickeln Sie Regeln gemeinsam mit Personen, die den dargestellten Prozess verstehen. Dokumentieren Sie für jede Regel die geschützten Felder, die geschäftliche Begründung, die Reaktion bei Fehlern und die Bedingungen, unter denen eine Ausnahme legitim ist. Testen Sie die Regeln anhand historischer Daten, um ein erwartetes Verhalten festzulegen, und überprüfen Sie sie, wenn sich Produkte, Richtlinien, Status oder Transformationen ändern.
digna Data Validation unterstützt Prüfungen auf Datensatzebene unter Verwendung von Werten, Bereichen, Schwellenwerten, Referenzdaten und Geschäftsbedingungen. Teams können diese Prüfungen nutzen, um explizite Erwartungen im großen Stil durchzusetzen und gleichzeitig Fehlerdetails für Untersuchungen aufzubewahren.
Ein praktisches Kontrollset sollte folgenden Punkten Priorität einräumen:
Kritische Kennzahlen: Beginnen Sie mit Umsätzen, Salden, regulierten Feldern und operativen Kennzahlen.
Business Ownership: Lassen Sie die Regeln und dokumentierten Ausnahmen von den zuständigen Fachbereichen genehmigen.
Nachvollziehbare Ergebnisse: Speichern Sie fehlerhafte Datensätze, die genauen Fehlerursachen, Regelversionen und den Untersuchungsstatus.
Mehrschichtige Abdeckung: Kombinieren Sie deterministische Validierung mit Vergleichen aus vertrauenswürdigen Quellen und Anomaliesignalen.
Die Regelabdeckung sollte als Teil der Pipeline überwacht und nicht als einmal abgeschlossene Konfiguration betrachtet werden. Eine Regel kann weiterhin erfolgreich ausgeführt werden, während sie inhaltlich unvollständig wird, weil sich der Geschäftsprozess geändert hat. Diese Einschränkung ist der Grund, warum die Validierung nur eine Art von Beleg innerhalb einer umfassenderen Strategie zur Genauigkeitsüberwachung darstellt.
3. Systemübergreifender Abgleich
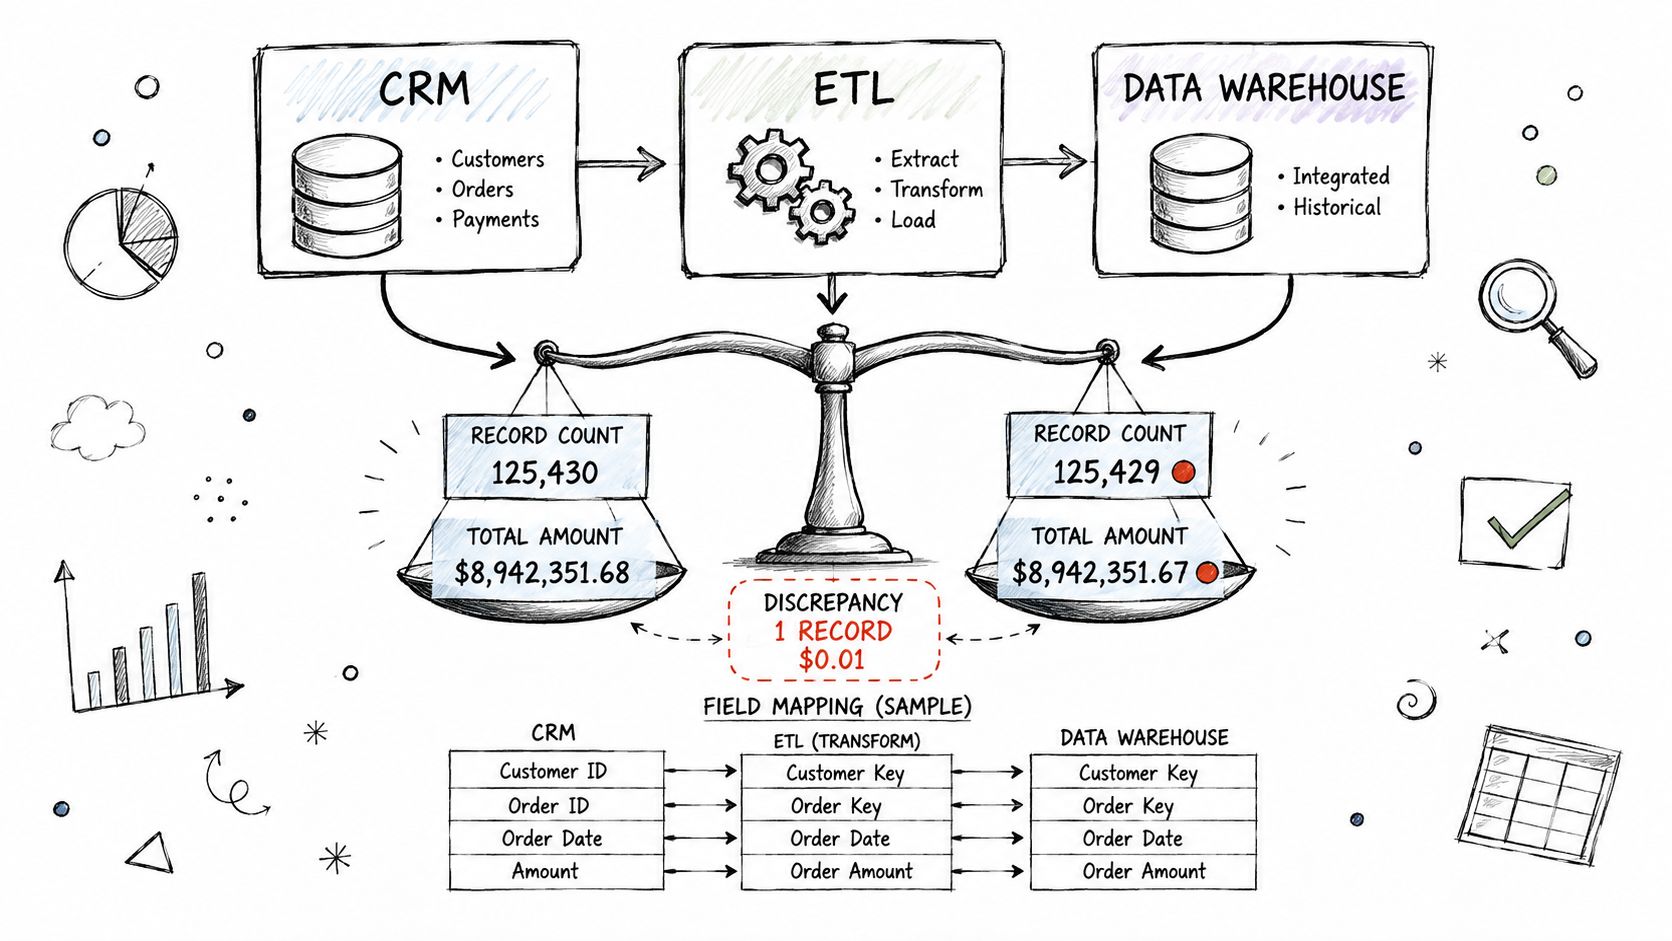
Der systemübergreifende Abgleich prüft, ob eine Transformation die nachgelagert benötigten Informationen bewahrt hat. Er vergleicht Datensätze zwischen einem Quell- und einem Zielsystem, anstatt nur zu prüfen, ob einzelne Felder gültige Formate aufweisen. Der Vergleich kann Zählungen, Aggregate, Geschäftskennzahlen und statistische Profile umfassen.
Eine Finanzpipeline verdeutlicht, warum dies wichtig ist. Die Quelle enthält möglicherweise Transaktionsdaten, während ein Data Warehouse transformierte Berichtsdaten speichert. Beide Systeme können gültige Daten und Beträge ungleich Null enthalten, dennoch kann sich die Summe im Warehouse unterscheiden, weil Datensätze gefiltert, dupliziert, abgeschnitten oder fehlerhaft transformiert wurden.
Der Abgleich sollte auf mehreren Ebenen stattfinden. Prüfungen auf Datensatzebene identifizieren fehlende oder unerwartete Entitäten. Aggregatprüfungen vergleichen Transaktionssummen, Umsätze, Salden oder andere genehmigte Kennzahlen. Profilprüfungen untersuchen Verteilungen und Häufigkeiten von Werten, die eine einfache Gesamtsumme verbergen könnte.
Legen Sie ein Abgleichfenster fest, das bekannte Latenzen und Verarbeitungsverzögerungen berücksichtigt. Definieren Sie Toleranzen, Alarmbedingungen, Zuständigkeiten und Schritte zur Fehlerbehebung, bevor Diskrepanzen auftreten. Eine Abweichung außerhalb der Toleranz sollte ein Untersuchungsprotokoll mit ausreichend Kontext für die Diagnose erzeugen.
Nützliche Kontrollen umfassen:
Zählungen: Vergleichen Sie die Anzahl der Datensätze in Quelle und Ziel nach Anwendung dokumentierter Filter.
Aggregate: Vergleichen Sie Summen, Mittelwerte und andere genehmigte Geschäftskennzahlen.
Abdeckung: Bestätigen Sie, dass erwartete Rechnungs- oder Kundendatensätze die nachgelagerten Systeme erreichen.
Trendverhalten: Verfolgen Sie wiederkehrende Abweichungen, um isolierte Vorfälle von systematischen Transformationsfehlern zu trennen.
Nutzen Sie digna Data Reconciliation, um regelmäßige Vergleiche zwischen Quell- und Zieldatensätzen zu unterstützen. Das Ergebnis ist ein Beleg für Konsistenz, kein Beweis dafür, dass jeder Wert korrekt ist. Eine Quelle kann veraltet oder fehlerhaft sein, und übereinstimmende Summen können sich gegenseitig aufhebende Fehler verbergen. Dokumentieren Sie, welches System die vertrauenswürdige Erwartung liefert und wann jedes System aktuell sein sollte. Kombinieren Sie dann die Abgleichsergebnisse mit Validierungen, Anomaliesignalen und menschlicher Überprüfung.
4. Statistische, historische Analyse und Anomalieerkennung
Ein Wert kann jede vordefinierte Regel erfüllen und sich dennoch völlig anders verhalten als der Prozess, den er darstellt. Die statistische und historische Analyse liefert Kontext, indem sie Verteilungen, Trends, Volatilität, Timing und wiederkehrende Abweichungen untersucht. Die Anomalieerkennung erweitert diesen Ansatz, indem sie unerwartete Änderungen identifiziert, die Teams möglicherweise nicht als feste Regeln hinterlegt haben.
Angenommen, der durchschnittliche Transaktionswert steigt über Nacht um 300 %. Das beweist nicht, dass die Daten falsch sind. Die Änderung könnte auf einer legitimen Preisentscheidung, einem Großeinkauf eines Kunden oder einem geschäftlichen Ereignis beruhen. Es erzeugt jedoch ein Signal mit hoher Priorität, da das beobachtete Verhalten stark vom etablierten Muster abweicht.
Untersuchen Sie Abweichungen, anstatt sie automatisch zu deklarieren
Nützliche Signale sind plötzliche Veränderungen bei der Altersverteilung von Kunden, ungewöhnliche Preisschwankungen bei Produkten, unerwartete Änderungen der Transaktionszahlen und Umsatzmuster, die vom historischen Verhalten abweichen. Teams sollten Zählungen, Aggregate, Verteilungen und das Timing gemeinsam überwachen, da eine isolierte Kennzahl das Ausmaß eines Problems verschleiern kann.
dignas statistische Methoden zur Datenanalyse können die Analyse von Trends, Volatilität und historischem Verhalten unterstützen. KI-gestütztes Lernen von Baselines kann dabei helfen, Abweichungen zu erkennen, ohne dass jeder Schwellenwert manuell konfiguriert werden muss. Die Baseline benötigt jedoch weiterhin operativen Kontext.
Eine Anomalie ist ein Beleg dafür, dass sich das Verhalten geändert hat. Sie ist an sich kein Beweis dafür, dass der geänderte Wert ungenau ist.
Beginnen Sie mit einer Anlaufphase, die dem System genügend historisches Verhalten liefert, um normale Abweichungen zu modellieren. Passen Sie die Sensitivität bei bekannten Kampagnen, Migrationen, saisonalen Ereignissen oder System-Upgrades an. Dokumentieren Sie die Erklärung, wenn eine Anomalie legitim ist. Diese Entscheidung verbessert die zukünftige Triage und verhindert, dass Teams jede ungewöhnliche Beobachtung als Datenfehler behandeln.
Statistische Analysen helfen auch dabei, Genauigkeit von Unsicherheit zu unterscheiden. Die Ernährungs- und Landwirtschaftsorganisation (FAO) erklärt, dass die analytische Genauigkeit nicht direkt quantifiziert werden kann und zufällige sowie systematische Fehler umfasst, während Standardfehler und Konfidenzintervalle die Unsicherheit um Messungen herum kommunizieren (FAO-Datenqualitätsmethodik). Ein stabiles Muster kann dennoch systematisch verzerrt sein.
5. Referenzdatenabgleich
Der Referenzdatenabgleich prüft, ob ein Feld mit einer genehmigten externen Liste, einer Stammtabelle oder einem kontrollierten Vokabular übereinstimmt. Er liefert einen Beleg für die Gültigkeit, insbesondere bei kategorischen und dimensionalen Feldern, beweist aber für sich genommen noch keine Genauigkeit. Ein Wert kann dem erwarteten Format entsprechen und dennoch für den geschäftlichen Kontext unpassend sein.
Beispielsweise kann ein Länderfeld einen korrekt formatierten Ländercode mit zwei Buchstaben enthalten, der jedoch nicht akzeptiert wird. Eine Produktkategorie kann ausgefüllt und eindeutig sein, verweist jedoch auf einen veralteten Zweig der Produkthierarchie. Ein Abteilungscode kann in einem Datensatz vorhanden sein, obwohl die Abteilung bereits aus den Stammdaten der Organisation gelöscht wurde.
Bewahren Sie den anwendbaren Referenzstatus
Referenzdaten ändern sich. Währungslisten, Steuersätze, Produkthierarchien, Organisationsstrukturen und Statustabellen können Werte hinzufügen, entfernen oder umbenennen. Speichern Sie die für jede Validierung verwendete Referenzversion und das Gültigkeitsdatum. Andernfalls werden historische Datensätze möglicherweise mit einem späteren geschäftlichen Zustand abgeglichen, was zu Fehlalarmen führt oder legitime Abweichungen maskiert.
Wenden Sie die Prüfung auf Felder an wie:
Ländercodes: Vergleichen Sie Kundenwerte mit dem ISO-3166-Ländercodestandard.
Produkt-Taxonomie: Gleichen Sie Kategoriecodes mit der genehmigten Hierarchie ab.
Währungen: Validieren Sie Transaktionswährungscodes gegen eine offizielle Währungsliste.
Organisationsstruktur: Vergleichen Sie die Abteilungscodes von Mitarbeitern mit den aktuellen Stammdaten.
Statuswerte: Überprüfen Sie Transaktionsstatuswerte gegen die definierte Statustabelle.
Das Ergebnis beweist, dass ein Wert mit einer akzeptierten Referenz übereinstimmt. Es beweist nicht, dass die Referenz für das Transaktionsdatum angemessen ist oder dass der Quell-Datensatz die Realität widerspiegelt. Fügen Sie Gültigkeitsdaten, dokumentierte Ausnahmen und Audit-Trails hinzu, wenn Referenzdaten für die regulierte Berichterstattung herangezogen werden.
Der Referenzvergleich stärkt auch die Validierung von Geschäftsregeln. Eine Regel kann erfordern, dass eine Abteilung existiert, während die Referenzprüfung feststellt, ob ihr Code genehmigt ist. Wenn sich die Referenz ändert, aktualisieren Sie die Kontrolle und dokumentieren Sie die Änderung. Dadurch bleibt die Validierungsebene an das Geschäft angepasst, anstatt ein veraltetes Lookup als Beleg für Genauigkeit zu behandeln.
6. Stichproben und manuelle Überprüfung
Automatisierte Prüfungen sind effizient, aber eine manuelle Überprüfung deckt Fehlertypen auf, die Regeln und Vergleiche übersehen können. Teams wählen repräsentative Datensätze aus und verifizieren sie anhand von Rechnungen, Quellsystemen, Kundenbestätigungen, Recherchen oder anderen Nachweisen des realen Zustands.
Eine Stichprobe kann Kundendatensätze umfassen, deren Adressen mit offiziellen Geschäftsunterlagen abgeglichen werden, Transaktionsdatensätze, die mit Originalrechnungen verglichen werden, oder verdächtige Produktpreise, die anhand genehmigter Dokumente überprüft werden. Das Ergebnis ist nicht nur eine Erfolgsquote. Es zeigt auch, ob Fehler auf veraltete Daten, Transformationslogik, manuelle Eingaben, Fehler im Quellsystem oder eine unklare Definition der Wahrheit zurückzuführen sind.
Konzipieren Sie die Stichprobe gezielt
Eine Zufallsauswahl kann allgemeine Zustände schätzen, während eine Stratifizierung sicherstellt, dass risikoreiche oder wertvolle Datensätze besondere Aufmerksamkeit erhalten. Dokumentieren Sie die Grundgesamtheit, die Auswahlmethode, die Verifizierungsbelege, den Prüfer, das Datum, die Entscheidungskriterien und die Fehlerklassifizierung. Statistische Stichprobenverfahren können helfen, eine angemessene Stichprobengröße zu bestimmen, aber die Methode sollte dem Risiko und der beabsichtigten Verwendung entsprechen.
Eine manuelle Überprüfung sollte die automatisierte Kontrolle validieren, nicht sie bloß wiederholen.
Nutzen Sie Stichproben, um die Annahmen hinter automatisierten Genauigkeitsraten zu hinterfragen. Wenn ein Quellvergleich eine hohe Übereinstimmung meldet, können manuelle Prüfungen testen, ob die angebliche Quelle aktuell und autoritativ ist. Wenn die Anomalieerkennung ungewöhnliche Datensätze meldet, kann eine gezielte Überprüfung feststellen, ob diese Datensätze legitime geschäftliche Ereignisse widerspiegeln.
Die menschliche Überprüfung liefert zudem qualitative Belege. Prüfer stellen möglicherweise fest, dass „korrekt“ von Gültigkeitsdaten, Kundenzustimmungen, geografischen Konventionen oder geschäftlichen Ausnahmen abhängt, die im Datenmodell nicht abgebildet waren. Diese Erkenntnisse sollten in Regeln, Referenzdaten, Abgleichslogiken und Überwachungsschwellenwerte einfließen.
Stichproben sind arbeitsintensiv, planen Sie sie daher für kritische Datensätze und bekannte Risikobereiche ein. Verfolgen Sie wiederkehrende Fehlermuster, anstatt jeden überprüften Datensatz als Einzelfall zu behandeln. Mit der Zeit lernt die Organisation, welche automatisierten Prüfungen ausgebaut werden müssen und welche Signale zu viele berechtigte Ausnahmen erzeugen.
7. Vollständigkeit und Timeliness als Genauigkeitsindikatoren
Genauigkeit ist der Beleg dafür, dass bereitgestellte Daten die Realität abbilden. Vollständigkeit und Timeliness beweisen zwar nicht, dass einzelne Werte wahr sind, aber sie prüfen, ob der Datensatz die relevante Grundgesamtheit im geforderten Moment darstellt. Fehlende Datensätze, ausgelassene kritische Felder oder verzögerte Ladevorgänge können ansonsten korrekte Werte für ihren Verwendungszweck unbrauchbar machen.
Ein täglicher Transaktionsdatensatz enthält möglicherweise fehlerfreie Daten, kommt jedoch erst nach der Berichtsfrist an. Der Bericht beschreibt dann nur die empfangenen Datensätze, nicht den geschäftlichen Zustand, der bei der Entscheidungsfindung vorliegen musste. Ein Stammdaten-Ladevorgang, der neu angelegte Kunden ausschließt, erzeugt ein fehlerfreies, aber unvollständiges Bild und kann nachgelagerte Analysen in die Irre führen.
Verfolgen Sie Abdeckung und Bereitstellung als separate operative Signale:
Eingangsverhalten: Vergleichen Sie die Bereitstellungszeiten mit dem etablierten Zeitplan, um verspätete, fehlende oder unerwartet frühe Ladevorgänge zu identifizieren.
Abdeckung: Vergleichen Sie die gelieferten Datensätze mit der erwarteten Grundgesamtheit oder der Anzahl in einer vertrauenswürdigen Quelle.
Kritische Felder: Messen Sie die Belegungsrate für Felder, die in Joins, Berechnungen, Berechtigungsentscheidungen oder regulatorischen Ausgaben verwendet werden.
Veränderungspunkte: Untersuchen Sie abrupte Verschiebungen in der Abdeckung nach einer Änderung der Quelle, des Schemas oder der Pipeline.
Definieren Sie akzeptable Lücken, bevor die Überwachung beginnt. Eine verspätete inkrementelle Ladung kann während geplanter Wartungsarbeiten zu erwarten sein, während eine unerklärte Verzögerung auf einen Fehler in der Quelle oder der Pipeline hindeuten kann. Abdeckungsprüfungen benötigen zudem einen klaren Nenner. Eine reine Datensatzanzahl kann nicht zeigen, ob sich die fehlende Grundgesamtheit in einem Segment mit hoher Auswirkung konzentriert.
dignas Fähigkeit für Timeliness überwacht Eingangsmuster und erwartete Bereitstellungszeiten. Der Schema Tracker erkennt strukturelle Änderungen, einschließlich hinzugefügter oder entfernter Spalten sowie geänderter Datentypen. Diese Signale stellen keine Wahrheit auf Wertebene fest. Sie können jedoch identifizieren, wann ein zuvor zuverlässiger Genauigkeitsprozess möglicherweise nicht mehr sicher ist, und stoßen damit Quellvergleiche, Regelvalidierungen oder gezielte Überprüfungen an.
Leitfäden zur Datenqualität stellen Genauigkeit gleichberechtigt neben Vollständigkeit, Konsistenz, Zuverlässigkeit und Timeliness (Leitfaden zur Datenqualität der kanadischen Regierung). Die gemeinsame Betrachtung dieser Dimensionen liefert Teams stärkere Belege für die Eignung der Daten: Werte sollten korrekt sein, die Abdeckung sollte der beabsichtigten Grundgesamtheit entsprechen und Informationen sollten rechtzeitig eintreffen, um ihre Nutzung zu unterstützen.
8. Integrierte Multi-Methoden-Strategie zur Genauigkeitsüberwachung
Das stärkste Betriebsmodell kombiniert die verschiedenen Methoden, anstatt die gesamte Last auf eine einzige Kennzahl zu legen. Der Vergleich mit vertrauenswürdigen Quellen prüft die Übereinstimmung mit einem erwarteten Zustand. Die Geschäftsvalidierung prüft die explizite Logik. Der Abgleich prüft die Bewegung über Systeme hinweg. Anomalieerkennung und historische Analysen prüfen das Verhalten. Stichproben testen, ob automatisierte Annahmen der Überprüfung mit realen Belegen standhalten.
Eine Pipeline für die Finanzberichterstattung zeigt, wie die Schichten zusammenwirken. Das Quellsystem enthält Transaktionsdaten, und das Warehouse unterstützt die Berichterstattung. Die erforderlichen Felder sind befüllt und die Pipeline läuft erfolgreich durch, aber die Gesamtsumme im Warehouse weicht von der vertrauenswürdigen Quelle ab.
Die Untersuchung kann wie folgt ablaufen:
Abgleich von Quell- und Zielkennzahlen, um die Diskrepanz und ihr Ausmaß zu identifizieren.
Validierung von Geschäftsregeln für Transaktionsbeträge, Daten, Identifikatoren und berechnete Felder.
Überprüfung von Anomalien, um festzustellen, ob sich die betroffenen Werte oder Zählungen unerwartet geändert haben.
Nutzung historischer Analysen, um festzustellen, wann die Abweichung begann und ob sie wiederholt auftritt.
Stichprobenartige Prüfung ausgewählter Datensätze gegen Quellbelege, um den Fehler zu klassifizieren.
Prüfung auf Timeliness und Schemaänderungen für verspätete Ladevorgänge, strukturelle Änderungen oder verändertes Pipeline-Verhalten.
Methoden den Risiken zuordnen
Gesundheitsdaten erfordern möglicherweise eine Überwachung der Vollständigkeit, eine Referenzvalidierung, eine Anomalieerkennung und regelmäßige manuelle Überprüfungen. Die Telekommunikationsabrechnung erfordert eventuell Umsatzabgleiche, Gebührenregeln, Nutzungsmusteranalysen und die Überwachung struktureller Änderungen. Daten des öffentlichen Sektors erfordern möglicherweise nachvollziehbare Referenzversionen, wiederholbare Validierungen und prüfbereite Untersuchungsprotokolle.
Nutzen Sie die geschäftlichen Auswirkungen, um zu entscheiden, wo Sie beginnen. Ordnen Sie jedes kritische Datenelement seiner vertrauenswürdigen Erwartung, seinen Regeln, Abgleichsprüfungen, Verhaltenssignalen, seinem Stichprobenplan und seinem Eskalationspfad zu. Die Korrelation von Erkenntnissen über verschiedene Methoden hinweg hilft Teams zu unterscheiden, ob es sich um einen lokalen fehlerhaften Datensatz oder um einen Ausfall der gesamten Pipeline handelt.
Eine Plattform wie digna kann Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness und Schema Tracker in einem gemeinsamen Überwachungsworkflow zusammenführen. Die Plattform läuft in der Umgebung des Kunden und führt Analysen direkt in der Datenbank aus. Dadurch verbleiben die Daten an ihrem Ort, während Ingenieure, Analysten und Governance-Teams Vorfälle und Trends überprüfen.
8-Methoden-Vergleich: Messung der Datengenauigkeit
Methode | Komplexität der Implementierung 🔄 | Ressourcenbedarf & Wartung ⚡ | Erwartete Ergebnisse 📊⭐ | Ideale Anwendungsfälle 💡 | Wichtigste Vorteile ⭐ |
|---|---|---|---|---|---|
Vergleich mit vertrauenswürdigen Datenquellen | Mittel, Mapping und Match-Logik; Pflege der vertrauenswürdigen Quelle | Moderat, Rechenleistung für große Datensätze; laufende Quellpflege | Hoch, messbare Genauigkeitsraten; eindeutige Belege für Abweichungen | Strukturierte Daten mit autoritativen Stammdaten (CRM, Preise, Finanzen) | Objektive, skalierbare Identifizierung von Abweichungen auf Feldebene |
Validierung von Geschäftsregeln | Niedrig–Mittel, Formalisierung und Versionierung von Regeln | Niedrig–Mittel, Regelerstellung und Pflege durch Stakeholder | Eindeutige Pass/Fail-Audits; starke Belege für die Compliance | Regulierte Prozesse und deterministische Prüfungen (Rechnungen, Rabatte) | Prüfbar, effizient beim Auffinden systematischer Regelverstöße |
Systemübergreifender Abgleich | Mittel–Hoch, Mapping, Zeitfenster, Pipeline-Wissen | Mittel, Integrationen, geplante Vergleiche, Rechenleistung | Erkennt Datenverlust/-beschädigung; validiert End-to-End-Integrität | Multi-System-ETL-Pipelines, Finanz- und Berichtssysteme | Deckt Transformations-/Übertragungsfehler auf mit Belegen zur Behebung |
Statistische, historische Analyse & Anomalieerkennung | Mittel, Baseline-Lernen und Modell-Tuning | Niedrig–Mittel, historische Daten, Analyse-Expertise | Zeigt Ausreißer, Trends und Signale schleichender Verschlechterung | Trendüberwachung, Frühwarnung bei neuartigen Problemen, neue Datensätze | Adaptive Erkennung von Problemen, die Regeln/Referenzprüfungen verpassen |
Referenzdatenabgleich | Niedrig, lookupbasierte Prüfungen; Verwaltung von Referenzversionen | Niedrig–Mittel, Referenzdatenverwaltung und -aktualisierungen | Sichert kategorische/dimensionale Konsistenz und Vergleichbarkeit | Standard-Codes/Stammdaten (ISO-Codes, Steuersätze, Produkthierarchien) | Setzt Standards durch; verhindert Aggregations-/Klassifizierungsfehler |
Stichproben und manuelle Überprüfung | Geringe Komplexität, aber hoher operativer Aufwand 🔄 | Hoch, arbeitsintensiv, geschultes Personal, begrenzte Skalierung ⚡ | Qualitative, hochgradig vertrauenswürdige Belege für Stichproben 📊 | Audits, Validierung automatisierter Prüfungen, regulatorische Nachweise | Findet Fehlertypen, die automatisierte Methoden übersehen; Ursachenkontext |
Vollständigkeit & Timeliness als Genauigkeitsindikatoren | Niedrig–Mittel, Definition von Zeitplänen und Baselines 🔄 | Niedrig, Überwachungstools; Schwellenwerte; optionales KI-Scheduling ⚡ | Frühwarnung bei fehlenden/verspäteten Daten; verbessert das Datenvertrauen 📊 | Pipelines mit SLAs, operatives Berichtswesen, zeitkritische Daten | Proaktive Erkennung von Lieferproblemen in der Pipeline |
Integrierte Multi-Methoden-Strategie zur Genauigkeitsüberwachung | Hoch, Koordination mehrerer Techniken und Feinabstimmung 🔄 | Hoch, mehrere Module, Integration, laufende Wartung ⚡ | Umfassende Abdeckung, schnellere Reaktion auf Vorfälle, prüfbereit 📊⭐ | Kritische Bereiche (Finanzen, Gesundheitswesen, Telekommunikation, öffentlicher Sektor) | Mehrere Beleglinien; erfasst unterschiedlichste Genauigkeitsszenarien |
Machen Sie Genauigkeitsprüfungen zu fortlaufenden Belegen
Kein einzelner Genauigkeitswert beweist, dass Daten in jedem Kontext die Realität widerspiegeln. Ein prozentualer Anteil übereinstimmender Datensätze kann eine fehlerhafte Referenzquelle verbergen. Ein Validierungswert kann zeigen, dass Datensätze Geschäftsregeln einhalten, während er einen Transformationsfehler übersieht. Ein Abgleich kann eine Diskrepanz aufdecken, ohne zu erklären, ob die Quelle, das Ziel oder das Zeitfenster dafür verantwortlich ist.
Die praktische Antwort besteht darin, eine Beweiskette aufzubauen. Definieren Sie zunächst den beabsichtigten Verwendungszweck und das Fehlerniveau, das das Unternehmen akzeptieren kann. Legen Sie die vertrauenswürdige Erwartung fest, sei es ein Master-System, genehmigte Referenzdaten, ein verifiziertes Transaktionsprotokoll oder eine dokumentierte Beobachtung aus der realen Welt. Definieren Sie dann, was eine Übereinstimmung ausmacht, und dokumentieren Sie das Timing, die Version, die Zuständigkeit und die Ausnahmen hinter dieser Entscheidung.
Codieren Sie die wichtigsten Erwartungen als deterministische Regeln. Regeln sollten kritische Kennzahlen, Compliance-Verpflichtungen, Beziehungen und Berechnungen schützen. Testen Sie diese anhand historischer Daten, bewahren Sie fehlerhafte Datensätze und genaue Fehlerursachen auf und überarbeiten Sie sie, wenn sich Produkte, Richtlinien, Schemata und Geschäftsprozesse ändern.
Gleichen Sie Quell- und Zielkennzahlen an den Stellen ab, an denen sich Daten bewegen. Vergleichen Sie Zählungen, Aggregate, Abdeckung und Profile, während Sie bekannte Verarbeitungslatenzen berücksichtigen. Eine Diskrepanz ist nicht automatisch ein Beweis dafür, dass das Ziel ungenau ist, aber sie ist ein Beleg dafür, dass die Pipeline einer Untersuchung bedarf.
Nutzen Sie Anomalieerkennung und historische Analysen, um Kontext zu liefern, den explizite Prüfungen nicht bieten können. Eine plötzliche Verschiebung kann einen Fehler im Quellsystem, eine fehlerhafte Transformation, ein Schema-Drift oder ein legitimes geschäftliches Ereignis offenbaren. Analysten sollten die Erklärung dokumentieren und nicht nur den Alarm schließen. Diese Historie verbessert zukünftige Triagen und hilft Teams, Baselines anzupassen, ohne aussagekräftige Änderungen zu unterdrücken.
Die manuelle Überprüfung bleibt wichtig für risikoreiche Daten und um zu testen, ob automatisierte Kontrollen das Richtige messen. Stichproben können systematische Verzerrungen, unklare Referenzdefinitionen und Fehlerkategorien aufdecken, die von keiner bestehenden Regel erfasst werden. Behandeln Sie die Ergebnisse als Input für das Überwachungsdesign.
Timeliness, Vollständigkeit und Schemaänderungen fungieren als Frühwarnungen. Ein verspäteter oder unvollständiger Datensatz ist für die darin enthaltenen Daten möglicherweise genau, aber für die darauf basierende Entscheidung unzuverlässig. Eine strukturelle Änderung kann die nachgelagerte Logik ungültig machen, ohne einen offensichtlichen Fehler auf Feldebene zu erzeugen. Die Überwachung dieser Indikatoren parallel zu Genauigkeitsprüfungen bietet Teams eine realistischere Sicht auf die Eignung der Daten.
digna unterstützt diesen evidenzbasierten Workflow durch Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness und Schema Tracker. Teams können mit Datensätzen hoher Auswirkung beginnen, geschäftsbasierte Schwellenwerte festlegen, Untersuchungen dokumentieren und die Abdeckung erweitern, wenn sich Anforderungen und beobachtete Risiken weiterentwickeln.
Unabhängige Nutzerbefragungen zeigen zudem, warum technische Messungen mit der Wahrnehmung der Stakeholder gepaart werden sollten. In einer Nutzerbefragung von 2023 bewerteten 72 % der Nutzer die statistische Datengenauigkeit als gut oder sehr gut, mit einer durchschnittlichen Bewertung von 4,03, während eine andere Umfrage nur 29,39 % Zufriedenheit mit der Datenqualität ergab (Ergebnisse der Nutzerzufriedenheitsumfrage 2023). Der Kontrast verdeutlicht, dass ein technisch akzeptabler Datensatz und ein vertrauenswürdiger Datensatz nicht immer dasselbe sind.
Messen Sie die Übereinstimmung mit der Realität, testen Sie die dahinterstehende Logik, untersuchen Sie Verhaltensänderungen und bewahren Sie die Belege hinter jeder Entscheidung. Auf diese Weise bewegen sich Datenteams weg von einer bloß grünen Pipeline-Anzeige hin zu Daten, die sie verantwortungsvoll nutzen können.
digna bietet dateninterne Qualität und Observability in Ihrer Umgebung durch Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness und Schema Tracker. Besuchen Sie digna, um zu sehen, wie Ihr Team Datengenauigkeitsprüfungen in fortlaufende Belege über Warehouses, Lakes und Pipelines hinweg verwandeln kann.


