Was ist ein offenes Tabellenformat?
|
9
min. Lesezeit

Es ist Dienstagmorgen. Ein Spark-Job hat eine Parquet-Datei aufgegriffen, während ein anderer Prozess noch daran schrieb. Ein nachgelagertes dbt-Modell liest einen unvollständigen Batch, verbindet ihn bei einem Retry erneut und verdoppelt einen Teil der Umsatzsumme. Das Team findet das Problem nicht in den Pipeline-Logs. Die Finanzabteilung findet es in einem Bericht.
Das ist die Art von Fehler, die einen rohen Data Lake weniger wie eine Datenbank und mehr wie einen geteilten Ordner mit hervorragendem Durchsatz wirken lässt. Die Dateien mögen langlebig, günstig und offen sein, doch der Lake braucht weiterhin einen verlässlichen Weg zu bestimmen, welche Dateien zu einer Tabelle gehören, welche Version Reader sehen sollen und wie Writer Änderungen sicher veröffentlichen. Genau das ist die Rolle eines offenen Tabellenformats.
Inhaltsverzeichnis
Das Problem, das ein offenes Tabellenformat löst
Ein roher Data Lake speichert Dateien meist im Objektspeicher, oft in Formaten wie Parquet, ORC oder Avro. Das Speichersystem weiß, dass die Dateien existieren, doch es weiß nicht automatisch, dass eine bestimmte Sammlung von Dateien eine logische Tabelle darstellt, dass ein neuer Batch vollständig ist oder dass ein Reader entweder den alten oder den neuen Zustand sehen soll, niemals eine Mischung aus beidem.
Verzeichniskonventionen versuchen, diese Lücke zu füllen. Teams legen Ordner für Datumswerte, Regionen, Mandanten oder Ingestion-Läufe an und bitten dann Verarbeitungs-Engines, die Tabellenstruktur aus Pfaden und Dateiinhalten zu erschließen. Dieser Ansatz funktioniert, bis mehrere Writer, Retries, Updates, Deletes, Schemaänderungen und nebenläufige Reader gleichzeitig auftreten.
Praktische Regel: Ein Ordner voller Dateien ist Speicher. Eine Tabelle braucht einen Vertrag über Identität, Zustand und Änderung.
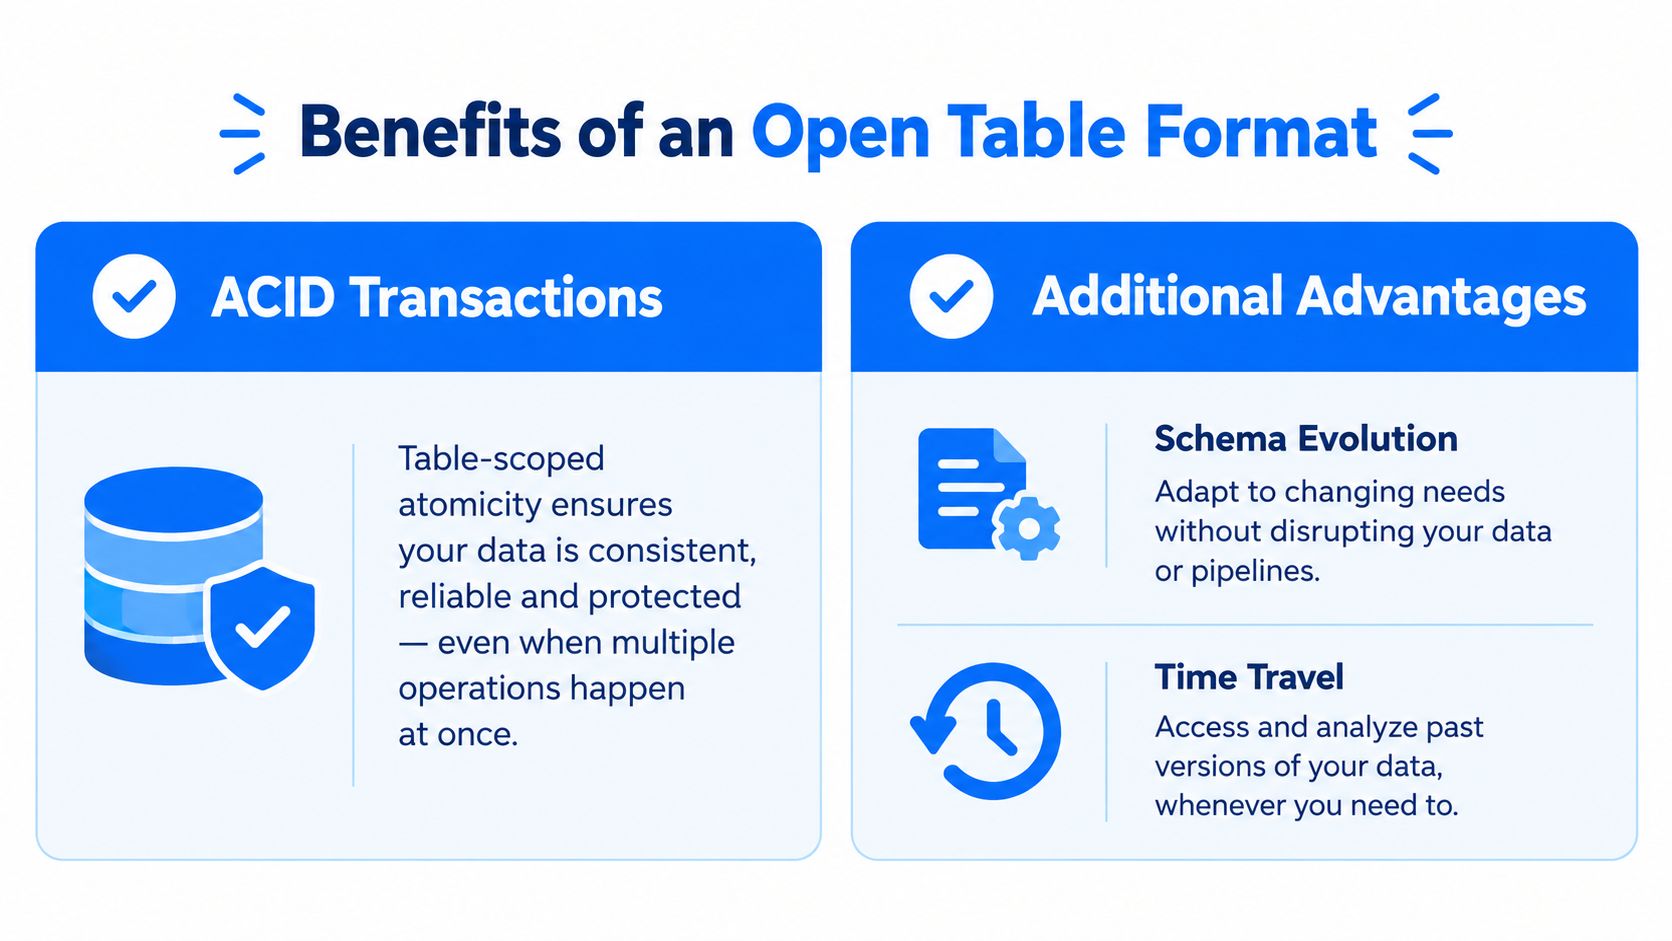
Ein offenes Tabellenformat ist eine Spezifikations- und Metadatenschicht, die über den rohen Datendateien und unterhalb der Query- oder Verarbeitungs-Engines liegt. Sie beschreibt diese Dateien als versionierte, transaktionale Tabelle, einschließlich Schema, Partitionierungsregeln, aktiver Dateien und committeter Snapshots. Die Daten bleiben in offenem Speicher, während die Tabellenmetadaten die Koordination liefern, die rohen Verzeichnissen fehlt. Databricks' Überblick zu offenen Tabellenformaten beschreibt diese Schicht als den Mechanismus, der Dateien im Objektspeicher um Fähigkeiten wie ACID-Transaktionen, Schemaevolution, Time Travel und zeilenweise Updates oder Deletes ergänzt.
Das Format trennt außerdem die logische Tabelle von den privaten Speicherannahmen einer einzelnen Engine. Kompatible Clients können Spark, Trino, Flink, Snowflake, BigQuery und DuckDB mit derselben zugrunde liegenden Tabelle arbeiten lassen, wobei der genaue Funktionsumfang von Engine, Connector, Katalog und Version des Tabellenformats abhängt. Diese Engine-Neutralität ist der entscheidende Teil. Ein Plattformteam kann Spark für Transformation, Trino für interaktives SQL, Flink für Streaming und eine weitere Engine für BI nutzen, ohne für jeden Workload eine eigene physische Kopie anzulegen.
Deshalb gehört ein offenes Tabellenformat in eine umfassendere Architektur einer Datenplattform. Es ersetzt die Plattform nicht. Es liefert einen verlässlichen Tabellenzustand, den der Rest der Plattform entdecken, abfragen, überwachen und steuern kann.
Historisch entstanden offene Tabellenformate aus den Grenzen der Hive-artigen, verzeichnisbasierten Tabellenverwaltung. Apache Hudi begann 2016 bei Uber, Apache Iceberg entstand um 2017 bei Netflix, und Delta Lake wurde 2017 von Databricks eingeführt und 2019 quelloffen veröffentlicht. Diese Meilensteine markierten den Weg zu Metadatenverwaltung auf Dateiebene, ACID-Verhalten, Schemaevolution und sichereren Updates auf Cloud-Objektspeicher. Eine Geschichte der offenen Tabellenformate rückt diese Projekte ins Zentrum der Lakehouse-Entwicklung.
Wie ein offenes Tabellenformat im Inneren arbeitet
Ein offenes Tabellenformat wird verständlicher, wenn Sie die Tabelle in Schichten zerlegen. Stellen Sie sich einen Gefrierschrank voller Eiswürfel vor.
Die Datendateien sind die Eiswürfel. Sie enthalten die eigentlichen Datensätze, meist in einem spaltenorientierten Format wie Parquet. Eine Tabelle kann viele Dateien enthalten, und diese Dateien können über den Objektspeicher verteilt sein.
Partitionierung ist die Eiswürfelschale. Sie gruppiert Dateien nach einem Layout, das die Abfrageplanung unterstützen kann, etwa nach einem Datum oder einer anderen Transformation einer Spalte. Der wichtige Unterschied ist, dass ein modernes Tabellenformat dieses Layout als Tabellenmetadaten verwalten kann, statt jede Nutzerin zu zwingen, die physische Verzeichnisstruktur zu verstehen.
Manifestdateien sind Inventarlisten. Jedes Manifest hält fest, welche Datendateien zu einem bestimmten Teil der Tabelle gehören, und enthält Informationen, die einer Engine helfen zu entscheiden, welche Dateien sie überspringen kann. Eine Abfrage über einen engen Datumsbereich muss nicht jeden Würfel im Gefrierschrank prüfen, wenn das Inventar die passende Schale benennt.
Die Metadatenschicht ist der Ordner. Sie verfolgt Tabellenschema, Partitionsspezifikation, aktuellen Snapshot und die Verweise auf Manifestlisten. Ein Snapshot ist eine konsistente Sicht auf den gesamten Ordner, nicht bloß ein Zeitstempel an einem beliebigen Verzeichnis.
Das Modell von Apache Iceberg veranschaulicht diesen geschichteten Ansatz. Es organisiert Tabellen über unveränderliche Snapshots und Manifestdateien. Jeder Commit erzeugt eine neue zeitpunktbezogene Sicht und bewahrt frühere Versionen für Time Travel und Rollback, wobei Metadaten-JSON, Manifestlisten und Manifestdateien die üblicherweise beschriebene Hierarchie bilden. Dieser Spickzettel zu Iceberg-Metadaten umreißt diese Bestandteile.
Einen neuen Tabellenzustand veröffentlichen
Ein Writer überschreibt den aktuell veröffentlichten Snapshot normalerweise nicht an Ort und Stelle. Er legt neue oder ersetzende Dateien bereit, erzeugt aktualisierte Metadaten und Manifeste und committet dann einen neuen Tabellenzustand über den Katalog oder das Tabellenprotokoll. Der abschließende Veröffentlichungsschritt ändert den aktuellen Metadatenverweis der Tabelle atomar.
Reader, die vor dem Commit starten, nutzen weiter den früheren Snapshot. Reader, die danach starten, nutzen den neuen. Diese Trennung verhindert, dass eine Abfrage die Hälfte eines Batches sieht, weil Dateien zu unterschiedlichen Zeitpunkten im Objektspeicher auftauchten.
Ein Katalog koordiniert Tabellenidentität und Auffindbarkeit. Er kann eine REST-Schnittstelle, einen Hive-artigen Dienst oder eine andere Katalogimplementierung nutzen. Der Katalog beantwortet Fragen wie, wo die Tabellenmetadaten liegen und welche Metadatenversion aktuell ist. Er ist der Kontrollpunkt, der verhindert, dass jede Engine ihre eigene Deutung der Tabelle erfindet.
Manifestlisten tragen das Pruning zur Planungszeit, während Metadaten Schema und Partitionsspezifikation speichern. Hidden Partitioning geht einen Schritt weiter und erlaubt Nutzerinnen, logische Spalten abzufragen, ohne Filter gegen physische Ordnernamen zu schreiben. Das bedeutet, eine Tabelle kann ihre Partitionsstrategie weiterentwickeln, ohne jede Analystin zu zwingen, SQL rund um Speicherpfade umzuschreiben.
Ein Schreiblayout wählen
Copy-on-Write und Merge-on-Read stehen für unterschiedliche Kompromisse.
Bei Copy-on-Write schreibt ein Update die betroffenen Datendateien neu. Lesevorgänge bleiben einfacher, weil der neueste Tabellenzustand bereits in spaltenorientierten Dateien materialisiert ist, doch häufige Updates können mehr Schreibarbeit erzeugen.
Bei Merge-on-Read können neue Änderungen separat abgelegt und beim Lesen oder bei späterer Kompaktierung mit den Basisdateien verschmolzen werden. Schreibvorgänge bleiben für update-lastige oder Streaming-Workloads reaktionsfähiger, doch Reader und Wartungsprozesse tragen mehr Verantwortung.
Wenn Sie sich mit den zugrunde liegenden Dateien noch vertraut machen, liefert diese Erläuterung zu Parquet den tieferliegenden Kontext. Parquet speichert Datensätze. Das offene Tabellenformat erklärt, wie diese Datensätze an einer gesteuerten, versionierten Tabelle teilnehmen.
Was ein offenes Tabellenformat Ihnen tatsächlich bringt
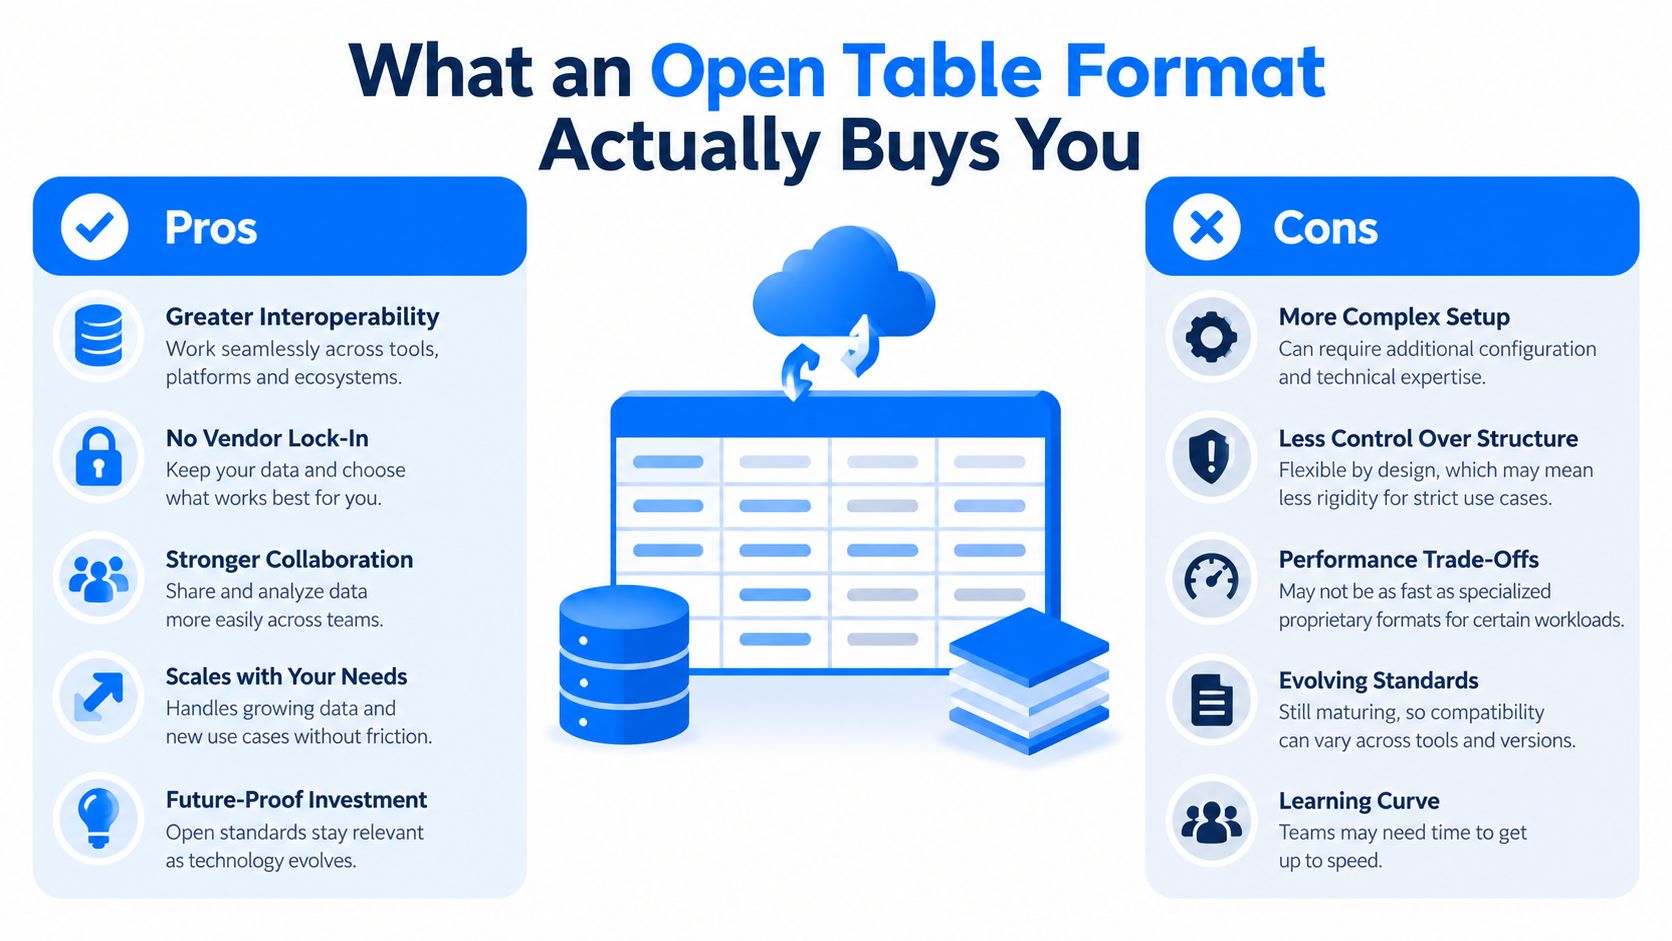
Die Vorteile lassen sich leichter als Matrix bewerten. Jede Fähigkeit löst ein bestimmtes Fehlermuster, doch keine garantiert, dass die fachliche Bedeutung der Daten korrekt ist.
Fähigkeit | Was sie ermöglicht | Wo sie aufhört |
|---|---|---|
ACID-Transaktionen | Reader sehen einen committeten Tabellenzustand, während Writer Änderungen atomar auf Tabellenebene veröffentlichen. | Sie machen eine Transaktion über mehrere Tabellen hinweg nicht atomar. |
Time Travel | Teams können einen früheren Snapshot abfragen oder wiederherstellen, wenn der aktuelle Zustand fragwürdig ist. | Aufbewahrung, Bereinigung und Katalogunterstützung bestimmen, wie lange diese Snapshots verfügbar bleiben. |
Schemaevolution | Teams können Spalten hinzufügen, umbenennen, umsortieren oder entfernen, gemäß den Kompatibilitätsregeln von Format und Engine. | Sie entscheidet nicht, ob eine fachliche Änderung für nachgelagerte Modelle sicher ist. |
Metadatengetriebene Leistung | Engines können Partitionen überspringen und Dateien auslassen, gestützt auf Metadaten, Statistiken und Layoutinformationen. | Schlechte Partitionierung, kleine Dateien und ungeeignete Sortierreihenfolge können weiterhin teure Abfragen erzeugen. |
ACID-Transaktionen sind das Fundament. Ohne sie verlassen sich Teams oft auf ein Muster aus Umbenennen und Hoffen. Ein Job schreibt in ein temporäres Verzeichnis und hofft, dass ein abschließendes Umbenennen Reader davor bewahrt, ein unvollständiges Ergebnis zu sehen. Dieser Ansatz wird brüchig, sobald Retries, mehrere Writer, das Verhalten des Objektspeichers und unabhängige Query-Engines zusammentreffen.
Time Travel verändert die Reaktion auf Vorfälle. Bringt eine Pipeline falsche Werte ein, kann eine Analystin die aktuelle Tabelle mit einem früheren Snapshot vergleichen, eine Abfrage gegen den vorherigen Zustand wiederholen oder eine als gut bekannte Version wiederherstellen, sofern die zugehörigen Metadaten und Dateien nicht durch Aufbewahrungsverfahren entfernt wurden. Die Historie der Tabelle wird zu einem operativen Artefakt statt zu einer unsichtbaren Folge von Dateimutationen.
Schemaevolution adressiert ein anderes Problem. Quellsysteme ändern sich. Ein Produzent ergänzt ein Feld, benennt eine Spalte um oder ändert die Feldreihenfolge. Ein Tabellenformat kann verträgliche strukturelle Änderungen festhalten, ohne dass jede historische Datei sofort neu geschrieben werden muss. Das senkt die Migrationsreibung, doch das Team braucht weiterhin einen Vertrag darüber, wie nachgelagerte Konsumenten die Änderung deuten.
Leistungsgewinne entstehen, indem Arbeit von der Scanzeit in die Planungszeit verlagert wird. Die Engine kann Partitionsmetadaten, Spaltenstatistiken auf Dateiebene und die Sortierreihenfolge nutzen, um das Lesen irrelevanter Dateien zu vermeiden. Das Ergebnis hängt davon ab, wie die Tabelle geschrieben und gepflegt wird. Metadaten können die Suche verengen, doch sie können ein Layout nicht retten, das übermäßige Dateiwechsel oder schlechte Datenlokalität erzeugt.
Die Grenze zählt:
Eine Tabelle kann transaktional korrekt und fachlich falsch sein.
Ein atomarer Commit kann einen vollständigen Batch bewahren, der falsche Umsätze, doppelte Kundinnen oder einen ungültigen Statuscode enthält. Offene Tabellenformate liefern strukturelle Konsistenz und historischen Zustand. Datenvalidierung, Lineage, Eigentum und Business-Monitoring brauchen weiterhin einen eigenen Entwurf.
Iceberg, Delta Lake und Hudi im Vergleich
Apache Iceberg, Delta Lake und Apache Hudi sind die drei dominierenden Optionen unter den offenen Tabellenformaten. Sie teilen das grobe Ziel, verlässliches Tabellenverhalten in den Objektspeicher zu bringen, doch ihre Metadatenmodelle und Workload-Prioritäten unterscheiden sich.
Funktion | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Metadatenmodell | Unveränderliche Snapshots verweisen auf Manifestlisten und Manifestdateien, die die Datendateien der Tabelle aufzählen. | Ein sequenzielles Transaktionslog in | Eine Zeitachse und ein Metadatensystem tragen Tabellen-Commits, Indizierung auf Satzebene und inkrementelle Verarbeitung. |
Schreibmodi | Nutzt für Updates üblicherweise Dateiersetzung, mit Tabellenversionsfunktionen gemäß den Fähigkeiten des Formats. | Nutzt üblicherweise über das Transaktionslog koordinierte Dateiersetzung und optimistische Nebenläufigkeitsmuster. | Unterstützt Copy On Write und Merge On Read. |
Transaktionsgarantien | ACID-Verhalten ist um committete Tabellen-Snapshots herum organisiert. | Atomare Commits, Snapshot-Isolation und reproduzierbare Historie stammen aus dem Transaktionslog. | Transaktionale Commits tragen Upserts und Deletes, wobei das Verhalten vom gewählten Schreibmodus geprägt wird. |
Partitionierungsstrategie | Hidden Partitioning und Partitionsevolution helfen, logische Abfragen vom physischen Layout zu trennen. | Partitionierte Tabellenlayouts werden über das Delta-Transaktionsprotokoll und Engine-Integrationen koordiniert. | Partitionierung arbeitet mit Indizierung auf Satzebene und Tabellendiensten, die für veränderliche Daten entworfen sind. |
Passende Workloads | Analytik über mehrere Engines, Batch-Tabellen und Umgebungen, in denen Metadatenportabilität zählt. | Workloads mit enger Integration in Delta-eigene Werkzeuge und Spark-zentrierten Lakehouse-Betrieb. | Inkrementelle Verarbeitung, CDC, Upserts, Deletes und streaming-orientierte Pipelines. |
Icebergs Stärke ist seine Snapshot- und Manifest-Architektur. Eine Engine kann gegen Metadaten planen, ohne jede Datei im Objektspeicher aufzulisten, und Hidden Partitioning erlaubt Tabellenadministratorinnen, die physische Organisation zu ändern, ohne SQL-Nutzerinnen jedes Layoutdetail offenzulegen.
Delta Lake nutzt ein Transaktionslog im Verzeichnis _delta_log/. Operationen erscheinen als fortlaufend nummerierte JSON- oder Parquet-Dateien, und dieses Log trägt atomare Commits, Snapshot-Isolation und reproduzierbare Tabellenhistorie. Dieser Vergleich von Delta Lake, Iceberg und Hudi erklärt die Rolle des Logs in Deltas Entwurf.
Hudi ist um Indizierung auf Satzebene herum gebaut und unterstützt Copy On Write und Merge On Read, eine Kombination, die zu Pipelines mit häufigen Upserts und Deletes passt. Die Orientierungshilfe von AWS zu offenen Tabellenformaten beschreibt diese Schreibmodi und Hudis Fokus auf inkrementelle Verarbeitung und Streaming-CDC.
Für einen Batch-ETL-Workload können alle drei tragfähig sein. Für BI lautet die praktische Frage, welche Query-Engines die Tabelle mit den Funktionen lesen können, die Ihre Abfragen brauchen, darunter Pruning, Snapshot-Lesevorgänge und Schemaverhalten. Für CDC-Streaming können Schreibverstärkung, Indizierung, Merge-Semantik und Kompaktierung mehr zählen als eine einfache Funktionsliste.
Die Ökosystemunterstützung ändert sich fortlaufend über Spark, Trino, Flink, Snowflake, BigQuery und weitere Engines. Das macht Kompatibilitätstests wertvoller als die Annahme, ein Logo auf einer Supportseite garantiere überall identisches Verhalten. Teams sollten Schreibvorgänge, nebenläufige Commits, Schemaänderungen, Deletes, Time Travel und Fehlerwiederherstellung mit ihren tatsächlichen Engines und Katalogen prüfen. Auch ein Ansatz zur Datenqualität in Databricks muss neben der Formatwahl bewertet werden, denn das Schreibprotokoll einer Tabelle ersetzt keine Prüfungen der enthaltenen Daten.
Die praktische Wahl lautet nicht „welches Format gewinnt?“. Sie lautet: welche Schreibsemantik, welches Katalogmodell, welcher Wartungsprozess und welche Engine-Integrationen zu der Pipeline passen, die Sie betreiben.
Wie offene Tabellenformate in moderne Datenplattformen passen
Ein Lakehouse hat meist vier funktionale Schichten. Objektspeicher hält die Dateien. Das offene Tabellenformat verwaltet Tabellenmetadaten und committeten Zustand. Verarbeitungs- und Query-Engines lesen oder schreiben über kompatible Clients. Governance- und Observability-Systeme prüfen, was geschah und ob die entstandenen Daten brauchbar sind.
Ein typischer Ablauf beginnt, wenn Datensätze in S3 oder ADLS landen. Ein Writer erzeugt oder aktualisiert eine Tabelle, veröffentlicht Metadaten und registriert die Tabelle in einem Katalog. Spark kann die Daten transformieren, Flink kann einen Stream verarbeiten, Trino kann interaktive Abfragen bedienen, und Snowflake, BigQuery oder Athena können zusätzliche Konsumwege bieten, wenn ihre Integrationen das Protokoll und die Funktionen der Tabelle unterstützen.
Diese Trennung macht einen logischen Datensatz für mehrere Workloads verfügbar. Analytik kann die Tabelle abfragen, eine Machine-Learning-Pipeline kann Features ableiten, und ein Streaming-Konsument kann frische Änderungen verarbeiten, ohne dass jedes Team eine eigene Kopie pflegen muss. Der Kompromiss ist, dass jeder Client sich über Tabellensemantik, Katalogzugriff, unterstützte Funktionen und Autorisierungsverhalten einig sein muss.
Deshalb versteht man das Format besser als Teil der Steuerungsebene des Lakehouse und nicht bloß als Wahl eines Dateiformats. Die Steuerungsebene legt Signale offen, die an einem gewöhnlichen Vorfallstag zählen:
Commit-Muster: Erkennen Sie stehengebliebene Writer, ungewöhnliche Commit-Frequenz oder wiederholte Fehlschläge.
Frische der Metadaten: Finden Sie Tabellen, deren Katalogzustand oder Metadatenaktualisierungen hinter der erwarteten Lieferung zurückbleiben.
Partitionsdrift: Finden Sie Änderungen der physischen Organisation, die das Abfrageverhalten verändern.
Schemaereignisse: Verfolgen Sie hinzugefügte, entfernte oder geänderte Spalten, bevor nachgelagerte Konsumenten scheitern.
Snapshot-Verhalten: Setzen Sie Datenqualitätsvorfälle mit genau dem committeten Tabellenzustand in Beziehung, den Reader konsumiert haben.
Eine Plattform wie digna kann neben dieser Schicht sitzen und Frische der Metadaten, Schemaänderungsereignisse, Timeliness, Validierungsergebnisse, Anomalien und Plattformsignale innerhalb der Kundenumgebung überwachen. Dieser Ansatz nutzt Tabellenhistorie als operative Signalquelle und hält die Verantwortung für Datenqualität vom Tabellenprotokoll getrennt.
Die Unterscheidung ist nützlich. Das Format sagt Ihnen, welcher Tabellenzustand committet wurde. Observability sagt Ihnen, ob dieser Zustand rechtzeitig eintraf, erwarteten Mustern folgt, Geschäftsregeln erfüllt und für die nachgelagerte Nutzung sicher bleibt. Mehr Kontext zu dieser Beziehung findet sich in wie Sie Datenqualität in einem Lakehouse aufrechterhalten.
Grenzen und Kompromisse, die die meisten Artikel auslassen
Ein offenes Tabellenformat löst die Atomaritätslücke für eine Tabelle. Es macht aus einem Objektspeicher-Lake keine vollständig koordinierte relationale Datenbank.
Die erste Grenze ist der Transaktionsbereich. ACID-Garantien bleiben im allgemeinen Modell auf die Tabelle beschränkt. Aktualisiert eine Pipeline eine Vertriebstabelle und eine Bestandstabelle, kann jede Tabelle sicher committen, während der gesamte Geschäftsvorgang zwischen ihnen dennoch inkonsistent wird. Eine tabellenübergreifende Transaktion braucht einen Koordinator oder eine dafür entworfene Plattformfunktion.
Die zweite Grenze ist die fachliche Qualität. Eine Tabelle kann jede erwartete Datei, ein gültiges Schema und einen sauberen Snapshot enthalten und dennoch falsche Werte führen. Ein offenes Tabellenformat weiß nicht, dass eine Rückerstattung größer ist als ihre Bestellung, dass eine Kundennummer eine Geschäftsregel verletzt oder dass Umsätze plötzlich die falsche Währung abbilden.
Die Betriebsarbeit verschwindet nicht
Tabellenwartung braucht weiterhin technische Aufmerksamkeit.
Kompaktierung: Merge-on-Read-Layouts und update-lastige Workloads können Kompaktierung erfordern, damit Reader nicht wiederholt viele Änderungsdateien abgleichen müssen.
Dateigrößen: Zu viele kleine Dateien erhöhen den Aufwand für Planung und Scans, selbst wenn Metadaten Pruning erlauben.
Partitionsabstimmung: Ein Partitionsschema, das zu den gestrigen Zugriffsmustern passte, kann nach Änderungen an Workload oder Datenverteilung schlechte Leistung erzeugen.
Aufbewahrung: Time Travel hängt davon ab, dass Metadaten und Datendateien älterer Snapshots erhalten bleiben. Bereinigungsrichtlinien müssen Wiederherstellungsbedarf und Speicherverwaltung ausbalancieren.
Nebenläufigkeit: Mehrere Writer können in Konflikt geraten. Die Pipeline muss Retries, fehlgeschlagene Commits und Idempotenz behandeln, statt anzunehmen, dass jeder Schreibvorgang gelingt.
Auch Governance lebt jenseits des bloßen Tabellenformats. Kataloge wie Unity Catalog, Glue, Polaris und Nessie können Auffindbarkeit, Berechtigungen, Lineage-Integrationen und Koordination verwalten, doch jeder bringt Verantwortung für Konfiguration, Verfügbarkeit, Kompatibilität und Upgrades mit. Unterschiede zwischen Anbietern bei Katalogspezifikationen, REST-Schnittstellen und Hidden Partitioning können die Portabilität erschweren, selbst wenn zwei Systeme Unterstützung für dasselbe zugrunde liegende Format beanspruchen.
Operative Grenze: Das Format schützt den Tabellenzustand. Ihre Plattform verantwortet weiterhin Qualität, Lineage, Zugriffsrichtlinien, Vorfallsbearbeitung und Workload-Entwurf.
Diese Einschränkungen sind kein Grund, offene Tabellenformate abzulehnen. Sie sind die Grenzen, die vor der Produktion dokumentiert gehören. Ein Entwurf, der Katalogbetrieb, Wartungsjobs, Qualitätsprüfungen, Monitoring und Rollback-Verfahren einschließt, verhält sich ganz anders als einer, der das Format als direkten Ersatz für ein Warehouse behandelt.
Ein offenes Tabellenformat auswählen und einführen
Wählen Sie das Format am Workload, nicht an einem Anbieterslogan. Beginnen Sie mit den Engines, die die Tabelle lesen und schreiben müssen, und testen Sie dann die Schreibmuster, die Katalogintegration, das Fehlerverhalten, den Wartungspfad und die Qualitätssignale, die in der Produktion zählen.
Kriterium | Was zu bewerten ist | Warum es zählt |
|---|---|---|
Engine-Kompatibilität | Testen Sie Spark, Trino, Flink, BI-Werkzeuge und alle Cloud-Warehouse-Integrationen, die Sie tatsächlich nutzen. | Eine nominelle Integration unterstützt womöglich nicht jede Tabellenfunktion oder Schreiboperation. |
Schreib-Nebenläufigkeit | Simulieren Sie nebenläufige Appends, Updates, Deletes, Retries und fehlgeschlagene Commits. | Der Umgang mit Konflikten entscheidet, ob Pipelines sauber wiederanlaufen oder manuelles Eingreifen brauchen. |
CDC- und Mutationsbedarf | Vergleichen Sie Upserts, Deletes, inkrementelle Lesevorgänge sowie das Verhalten von Copy On Write und Merge On Read. | Streaming- und veränderliche Workloads stellen unterschiedliche Anforderungen an Speicher und Lesevorgänge. |
Katalogintegration | Bewerten Sie REST- oder Hive-artigen Zugriff, Auffindbarkeit, Berechtigungen, Lineage und Katalogverfügbarkeit. | Die Steuerungsebene bestimmt, wie Engines den Tabellenzustand identifizieren und koordinieren. |
Wartungswerkzeuge | Testen Sie Kompaktierung, Dateibereinigung, Partitionsevolution, Statistiken und Snapshot-Aufbewahrung. | Ein Format, das leicht zu beschreiben, aber schwer zu warten ist, wird zur Betriebslast. |
Observability und Qualität | Verbinden Sie Commit-Ereignisse, Schemaänderungen, Timeliness, Validierung und Geschäftskennzahlen mit Vorfallsabläufen. | Strukturelle Konsistenz allein belegt nicht, dass Daten für den Einsatz taugen. |
Eine praktische Migration kann in einen 90-Tage-Plan passen, ohne so zu tun, als sei ein Formatwechsel ein einzelnes Deployment.
Pilot
Wählen Sie repräsentative Tabellen, darunter eine append-lastige Tabelle, eine Tabelle mit Schemaänderungen und einen Workload mit Updates oder Deletes. Messen Sie Abfrageverhalten, Commit-Konflikte, Metadatenwachstum, Wiederherstellungsschritte und den Aufwand, Datensätze zu validieren.
Validierung mit doppeltem Schreiben
Schreiben Sie dieselben logischen Eingaben über den alten und den neuen Tabellenpfad. Vergleichen Sie Zeilenanzahlen, Schlüssel, Null-Verhalten, Aggregate, Schemaereignisse, Lieferzeitpunkte und Snapshot-Inhalte. Halten Sie den Vergleich auf fachliche Abnahmekriterien ausgerichtet und nicht nur darauf, ob beide Systeme Dateien erzeugt haben.
Umstellung
Ziehen Sie einen nachgelagerten Workload nach dem anderen um. Legen Sie Verantwortung für Katalog, Wartungsjobs, fehlgeschlagene Commits, Rollback-Entscheidungen und Alarme fest. Halten Sie den alten Pfad verfügbar, bis der neue unter normalen Betriebsbedingungen stabile Lese-, Schreib-, Wiederherstellungs- und Monitoringvorgänge gezeigt hat.
Außerbetriebnahme
Entfernen Sie überflüssige Writer und Speicherpfade erst, nachdem Anforderungen an Aufbewahrung, Audit, Lineage und Rollback dokumentiert sind. Archivieren Sie die Nachweise, die nötig sind, um zu erklären, wann die Umstellung erfolgte und welcher Tabellen-Snapshot maßgeblich wurde.
Verbreitete Einführungsfehler sind vorhersehbar: den Katalogbetrieb unterschätzen, Tests zur Partitionsevolution überspringen, das Format als Warehouse-Ersatz behandeln, Konflikte nebenläufiger Writer ignorieren und die Rollback-Planung vernachlässigen. Der stärkste Auswahlprozess bezieht Observability vom Piloten an ein, damit Teams nicht nur sehen, ob ein Commit gelang, sondern auch, ob die entstandenen Daten pünktlich eintrafen und für ihre Konsumenten korrekt blieben.
Für umfassendere Architekturentscheidungen kann eine Orientierung zur Enterprise-Datenplattform helfen, Tabellenformate neben Governance, Qualität und operativer Verantwortung einzuordnen.
digna hilft Unternehmen, Datenqualität, Timeliness, Schemaänderungen, Anomalien und Plattformverhalten innerhalb der eigenen Infrastruktur zu überwachen, was es zu einem praktischen Begleiter der Metadaten- und Snapshot-Steuerungsebene eines offenen Tabellenformats macht. Besuchen Sie digna, um zu bewerten, wie diese Signale einen sichereren Lakehouse-Betrieb stützen können.
Ein atomarer Commit garantiert, dass ein Reader nie einen halben Batch sieht; er garantiert nicht, dass der Batch richtig war, und das bleibt eine Frage des Data Quality Management.
Häufig gestellte Fragen
Was ist ein offenes Tabellenformat?
Eine Spezifikations- und Metadatenschicht, die über den rohen Datendateien und unterhalb der Query- oder Verarbeitungs-Engines liegt. Sie liefert, was ein Ordner nicht kann: einen Vertrag über Identität, Zustand und Änderung.
Warum ist ein Ordner voller Dateien keine Tabelle?
Weil ein Ordner Speicher ist. Ein roher Data Lake legt Dateien im Objektspeicher ab, in Formaten wie Parquet, ORC oder Avro, und Verzeichniskonventionen versuchen die Lücke zu füllen, was einen Lake weniger wie eine Datenbank und mehr wie einen geteilten Ordner mit hervorragendem Durchsatz wirken lässt.
Wann entstanden diese Formate?
Sie entstanden aus den Grenzen der Hive-artigen, verzeichnisbasierten Tabellenverwaltung. Apache Hudi begann 2016 bei Uber, Apache Iceberg entstand um 2017 bei Netflix, und Delta Lake wurde 2017 von Databricks eingeführt und 2019 quelloffen veröffentlicht.
Was trennt das Format?
Die logische Tabelle von den privaten Speicherannahmen einer einzelnen Engine. Diese Trennung erlaubt mehreren Engines, dieselbe Tabelle zu lesen, ohne dass jede ihre eigene Deutung davon aufzwingt, welche Dateien zählen.
Welche Kompromisse lassen die meisten Artikel aus?
Die operativen. Ein Format einzuführen bringt Metadaten zum Verwalten, Aufbewahrungsentscheidungen und Engine-Verhalten zum Abgleichen mit sich, die Kosten sind also nicht null, selbst wenn die Spezifikation offen ist und die Migration mechanisch aussieht.



