Verlässlichkeit messen: Daten, Pipelines & ML
|
7
min. Lesezeit

Wahrscheinlich erleben Sie das gerade. Ein Dashboard, das gestern noch stimmig aussah, ist plötzlich falsch. Eine Modell-Eingabetabelle hat eine stille Schemaänderung mitgenommen. Ein Finanzbericht ist veraltet, doch die Pipeline meldet „success“. Alle stellen dieselbe Frage: Können wir den Daten trauen?
Das ist das Grundproblem hinter der Frage, wie man Verlässlichkeit misst. In Enterprise-Warehouses ist Verlässlichkeit keine Laborübung. Sie ist eine operative Disziplin. Wer nur gezogene Stichproben außerhalb des Warehouse validiert, übersieht die Fehler, die in laufenden Pipelines, auf Produktionstabellen und über wechselnde Schemata hinweg passieren. Moderne Teams brauchen einen Weg, Verlässlichkeit dort zu messen, wo die Daten bereits liegen.
Inhaltsverzeichnis
Warum Ihre Dashboards und ML-Modelle immer wieder brechen
Montagmorgen-Fehler wirken zunächst selten dramatisch. Ein Vertriebs-Dashboard zeigt negativen Umsatz. Ein Churn-Modell stuft plötzlich alle als geringes Risiko ein, weil eine Quelltabelle nicht mehr aktualisiert wird. Ein Support-Dashboard verliert die Hälfte seiner Kategorien, weil sich weiter vorn ein Join-Schlüssel geändert hat. Das Warehouse läuft weiter, doch das Vertrauen ist weg.
Deshalb muss Verlässlichkeit in geschäftlichen Begriffen gemessen werden, nicht nur mit technischen Prüfungen. Die sauberste operative Kennzahl ist Data Downtime, berechnet als Anzahl der Vorfälle × (durchschnittliche Erkennungszeit + durchschnittliche Behebungszeit), und viele Teams nutzen als Maßstab, dass Spitzenunternehmen weniger als 1 % pro Jahr anstreben, während durchschnittliche Organisationen oft 5–10 % ihrer Datenbestände als unbrauchbar erleben, laut Monte Carlos Erläuterung zu Data Downtime.
Verlässlichkeitsfehler beginnen meist weiter vorn
Die meisten schwerwiegenden Vorfälle beginnen nicht bei einem Dashboard. Sie beginnen mit einer dieser Bedingungen:
Eine Pipeline lief mit fehlerhaften Ausgaben durch. Die Orchestrierung meldete den Job grün, doch in einem kritischen Feld schossen die Nullwerte hoch.
Ein Schema änderte sich unangekündigt. Ein Spaltentyp wechselte, ein Feld verschwand, oder ein Quellteam benannte ein Attribut um.
Eine Quelle lieferte verspätet. Berichte aktualisierten planmäßig, aber mit den unvollständigen Daten von gestern.
Ein Modell konsumierte veraltete Features. Der Feature Store wirkte verfügbar, doch eine Partition traf nie ein.
Auch Sicherheit kann Teil desselben Fehlerpfads sein. Wenn KI-Agenten oder Automatisierungsschichten ohne starke Kontrollen auf Unternehmensdaten zugreifen, beginnen Verlässlichkeit und Governance sich zu überschneiden. Teams, die diese operative Grenze durchdenken, finden den Sicherheitsleitfaden für KI-Agenten im Unternehmen nützlich, weil er einordnet, wo Zugriffsrisiko zu nachgelagerten Vertrauensproblemen wird.
Stakeholder interessiert Vertrauen, nicht Ihr Orchestrierungsgraph
Eine Bereichsleiterin fragt nicht, ob ein Airflow-Task erfolgreich wiederholt wurde. Sie fragt, ob die Zahl auf dem Bildschirm sicher verwendbar ist. Deshalb gewinnt Verlässlichkeitsarbeit an Zugkraft, wenn Sie Vorfälle mit Downtime, verfehlten SLAs und verlorenem Vertrauen in Analytics verbinden.
Praktische Regel: Wenn das Geschäft nicht sagen kann, ob Daten nutzbar sind, haben Sie bereits ein Verlässlichkeitsproblem.
Teams, die weniger Überraschungen im Produktivbetrieb wollen, sollten auch wiederkehrende Muster von Pipeline-Ausfällen studieren, besonders rund um späte Erkennung und verdeckte Brüche in produktiven Datenflüssen. Eine nützliche Referenz ist diese Analyse dazu, warum Datenpipelines im Produktivbetrieb scheitern und wie man Probleme früh erkennt.
Die vier Säulen der Datenverlässlichkeit
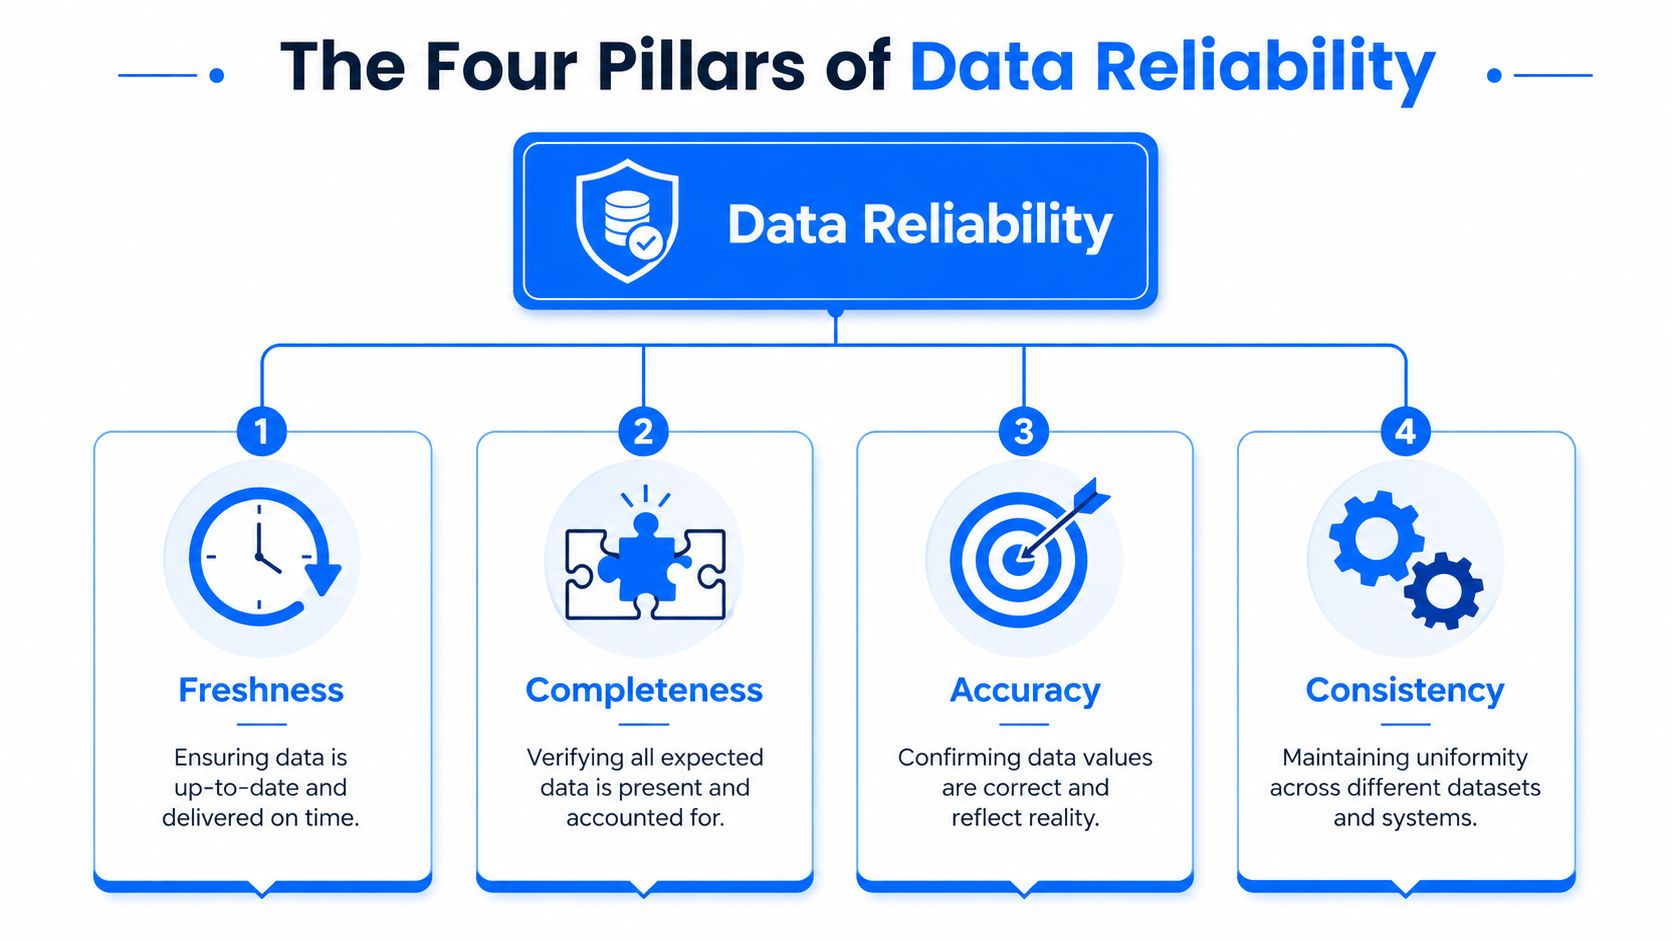
Wenn Sie ein Rahmenwerk wollen, das Ihr Team wirklich nutzen kann, teilen Sie Verlässlichkeit in vier Säulen. Nicht zehn. Keine riesige Checkliste, die niemand pflegt. Vier genügen, um Verantwortung zuzuweisen, Prüfungen zu definieren und Vorfälle zu besprechen, ohne den Prozess in Governance-Theater zu verwandeln.
Aktualität und Timeliness
Aktualität fragt, ob die Daten aktuell sind. Timeliness fragt, ob sie eintrafen, als das Geschäft sie brauchte. In einem Warehouse hängt beides zusammen, ist aber nicht identisch.
Ein täglicher Finanz-Mart kann relativ zu seinem letzten Ladevorgang frisch und für das Führungsmeeting trotzdem zu spät sein. Eine Streaming-Tabelle zur Betrugserkennung kann fortlaufend eintreffen und dennoch genug nachhängen, um nachgelagerte Entscheidungen zu brechen. Diese Säule gehört gleichzeitig zur Pipeline- und zur Konsumschicht.
Vollständigkeit
Bei Vollständigkeit geht es um Vorhandensein. Sind alle erwarteten Zeilen da? Sind kritische Spalten gefüllt? Sind alle Partitionen eingetroffen? Ist eine Region verschwunden, weil sich weiter vorn ein Filter änderte?
Viele Teams überwachen zu wenig. Sie zählen die Gesamtzahl der Zeilen und hören dort auf. Diese Praxis übersieht den häufigeren Enterprise-Fehlermodus, bei dem eine Teilmenge fehlt, während die Gesamtsumme noch plausibel aussieht.
Verlässlichkeit wird stärker, wenn Sie die erwartete Form prüfen und nicht nur den erfolgreichen Abschluss eines Jobs.
Genauigkeit und Korrektheit
Genauigkeit ist schwieriger, weil sie fachliche Bedeutung berührt. Ein Wert kann existieren, dem Typ entsprechen und trotzdem falsch sein. Währungszeichen gehen verloren. Statuscodes driften von den zulässigen Geschäftszuständen ab. Fremdschlüssel verweisen auf Datensätze, die es nicht mehr gibt.
Für Datenarchitektinnen verbindet diese Säule meist technische Validierung mit Geschäftsregeln. Manche Prüfungen sind universell, etwa referenzielle Integrität. Andere sind tabellenspezifisch und müssen von dem Team verantwortet werden, das den Prozess hinter den Daten versteht.
Konsistenz
Konsistenz hält integrierte Systeme nutzbar. Formate, Datentypen, Schlüssellogik, Namenskonventionen und Schemaerwartungen müssen über die Zeit halten. Diese Säule erfasst die Probleme, die nachgelagerte Joins, Dashboards und Feature-Pipelines schleichend vergiften.
Ein praktischer Weg, die vier Säulen zu nutzen, ist, jedem kritischen Asset ein primäres Fehlermuster zuzuordnen:
Führungs-Dashboards scheitern meist zuerst an Aktualität und Genauigkeit.
ML-Feature-Tabellen scheitern meist zuerst an Konsistenz und Schemastabilität.
Datensätze für den Finanzabschluss scheitern meist zuerst an Vollständigkeit und Korrektheit.
Gemeinsame Dimensionen scheitern meist zuerst an Konsistenz, weil viele nachgelagerte Systeme von ihnen abhängen.
Diese Einordnung beschleunigt Reviews. Sie hält Teams außerdem davon ab, überall dieselben Prüfungen anzuwenden, was einer der Hauptgründe dafür ist, dass Monitoring verrauscht und teuer wird.
Zentrale Verlässlichkeitskennzahlen und In-Database-Berechnung
Die Frage wie man Verlässlichkeit misst wird erst nützlich, wenn sie zu etwas Berechenbarem führt. In Warehouse-Umgebungen sind die besten Kennzahlen jene, die Sie direkt in SQL auf produktionsnahen Tabellen, Metadatentabellen und Systemprotokollen berechnen können. Wenn Sie erst exportieren müssen, haben Sie bereits Latenz und Risiko hinzugefügt.
Was klassische Verlässlichkeitskennzahlen uns noch lehren
Klassische Messwissenschaft zählt weiterhin. In der Fragebogengestaltung ist Cronbachs Alpha der Standard für Skalenreliabilität, und 0,8 oder mehr gilt als akzeptabel. Für stetige Variablen ist der Intraklassen-Korrelationskoeffizient (ICC) der gebräuchlichste Parameter, um Reliabilität über wiederholte Messungen zu schätzen, wie der Bibliotheksleitfaden der University of Southampton zu Reliabilität, Validität und Reproduzierbarkeit zusammenfasst.
Diese Methoden sind wertvoll, wenn Sie wiederholte menschliche oder instrumentelle Messungen bewerten. Für den laufenden Warehouse-Betrieb helfen sie weniger, denn Ihr Problem lautet meist nicht „Stimmen zwei Bewertende überein?“, sondern „Sind die Daten eingetroffen, entsprechen sie den Vorgaben und bleiben sie in einem sich verändernden Produktivsystem stabil?“
Ein nützliches Denkmodell lautet: Klassische Reliabilitätsstatistik validiert Messkonsistenz auf Stichproben. Warehouse-Verlässlichkeitskennzahlen validieren operative Konsistenz auf sich fortlaufend verändernden Assets. Wenn Sie ein praktisches Beispiel dafür brauchen, abstrakte Messung in operative Scorecards zu übersetzen, lohnt sich das Kennzahlen-Playbook von Halo AI, weil es zeigt, wie Teams Kennzahlen nutzbar statt bloß berichtbar machen.
Kennzahlen, die Sie im Warehouse berechnen können
Unten steht eine kompakte Betriebstabelle. Es geht nicht darum, diese Abfragen wörtlich zu kopieren. Es geht darum, Messungen zu bauen, die dort laufen, wo die Daten liegen.
Säule | Beispielkennzahl | Was sie misst | Beispielhaftes SQL-Konzept |
|---|---|---|---|
Aktualität | Zeit seit dem letzten erfolgreichen Ladevorgang | Verzögerung zwischen erwarteter und tatsächlicher Verfügbarkeit |
|
Vollständigkeit | Abweichung der Zeilenzahl | Fehlendes oder unerwartet aufgeblähtes Volumen | aktuelle Partitions-Zeilenzahl mit dem historischen Muster vergleichen |
Genauigkeit | Quote ungültiger Werte | Verstöße gegen Geschäftsregeln in kritischen Spalten |
|
Konsistenz | Häufigkeit von Schemaänderungen | Struktureller Drift, der die nachgelagerte Nutzung bricht | aktuelles Information Schema mit einem früheren Snapshot vergleichen |
Ein paar praktische Muster funktionieren gut.
Sie sind bewusst einfach. Sie bilden vier Fragen ab, die jeder Engineer versteht:
Ist es zu spät
Fehlt etwas
Sind die Werte gültig
Hat sich die Struktur geändert
Für Teams, die einen dauerhaften Kennzahlenkatalog aufbauen, ist dieser Leitfaden zu Datenqualitätskennzahlen hilfreich, weil er Eitelkeitsprüfungen von Messungen trennt, die den Betrieb tragen.
Starten Sie nicht mit Dutzenden Prüfungen. Starten Sie mit dem kleinsten Satz, der ein fehlerhaftes Dashboard, einen gebrochenen Join oder ein instabiles Modell-Input erklären kann.
Der Zielkonflikt liegt auf der Hand. In-Database-Berechnung erhält Kontext und reduziert Bewegung, aber Sie brauchen disziplinierten Abfrageentwurf, damit Observability-Jobs nicht mit produktiven Workloads konkurrieren. Deshalb beginnen erfahrene Teams meist mit kritischen Tabellen, partitionsbewussten Prüfungen und metadatengetriebenen Scans statt mit roher Validierung ganzer Tabellen.
Handhabbare SLOs und Baselines setzen
Rohe Kennzahlen verändern kein Verhalten. Teams verändern ihr Verhalten, wenn eine Kennzahl einen Schwellenwert überschreitet, den alle verstehen. Genau das leisten SLOs. Sie machen aus Beobachtung einen operativen Vertrag.
Ein schwaches Verlässlichkeitsprogramm sagt: „Wir überwachen Aktualität.“ Ein starkes sagt: „Der Faktenbestand zu Kundenbestellungen muss vorliegen, bevor die nachgelagerte Abstimmung beginnt, und ein Alert löst aus, wenn das erwartete Ankunftsfenster verfehlt wird.“ Der genaue Schwellenwert hängt vom geschäftlichen Nutzen ab, nicht von Engineering-Vorlieben.

Schwellenwerte müssen zum geschäftlichen Schaden passen
Unterschiedliche Assets verdienen unterschiedliche Ziele. Ein Vorstandsbericht, eine echtzeitnahe Betrugstabelle und ein Archiv für Modelltraining sollten nicht dieselbe Alert-Policy teilen.
Nutzen Sie diese Entscheidungsregeln beim Setzen von SLOs:
Entscheidungskritische Assets brauchen engere Schwellen für Aktualität und Korrektheit, weil Menschen unmittelbar danach handeln.
Gemeinsam genutzte vorgelagerte Tabellen brauchen stärkere Konsistenzkontrollen, weil ein struktureller Bruch sich auf viele Konsumenten ausbreiten kann.
Regulierte Datensätze brauchen explizite Validierungsregeln und nachvollziehbare Ausnahmen, weil Prüfbarkeit ebenso zählt wie Rechtzeitigkeit.
ML-Feature-Eingaben brauchen stabilitätsorientierte Baselines, damit Drift und Schemaänderungen erkannt werden, bevor die Modellqualität sinkt.
Bei dieser letzten Kategorie versagen statische Schwellenwerte besonders oft. Eine Regel zur Zeilenzahl erkennt katastrophalen Verlust, verrät aber nicht, ob sich ein gelerntes Verhaltensmuster so verschoben hat, dass ein Feature unzuverlässig wird.
Warum statische Regeln bei großem Umfang brechen
Statische Regeln wirken attraktiv, weil sie sich leicht erklären lassen. In großen Landschaften sind sie außerdem teuer in der Pflege. Wenn jede Tabelle handgeschriebene Schwellenwerte bekommt, verbringen Teams ihre Zeit mit dem Justieren von Alerts statt mit dem Verbessern der Verlässlichkeit.
Deshalb ist Baseline-Learning wichtig. In-Database-Kennzahlenberechnung und Baseline-Learning finden innerhalb der konfigurierten Tabellen der Kundin statt. digna liest zum Beispiel Teradatas DBC-Systemtabellen direkt per SQL-Abfragen, um operative Kennzahlen in Zeitreihendaten für KI-gestützte Anomalieerkennung zu überführen, wie in dignas Übersicht zur Teradata-Workload-Analyse beschrieben.
Dieser Ansatz verändert das Betriebsmodell. Statt eine Engineerin jeden Normalzustand im Voraus definieren zu lassen, kann das System wiederkehrende Muster direkt aus warehouse-internen Signalen lernen. In Umgebungen mit hohem Volumen ist das der Unterschied zwischen wartbarer Observability und Alert-Müdigkeit.
Ein Schwellenwert sollte die Kosten des Irrtums abbilden, nicht die Bequemlichkeit beim Schreiben der Regel.
Ein Zielkonflikt bleibt. Gelernte Baselines senken den manuellen Aufwand, brauchen aber eine Überprüfung, wenn sich das Geschäftsverhalten deutlich ändert. Quartalsabschluss, Produkteinführungen, Quellmigrationen und regionale Expansionen können allesamt echte Musterverschiebungen erzeugen. Teams, die das gut machen, kombinieren automatische Baselines mit expliziten Geschäftskalendern und Reviews durch die Verantwortlichen.
Ihren Data Stack für volle Sichtbarkeit instrumentieren
Die meisten Observability-Inhalte setzen voraus, dass Sie Daten herausbewegen, anderswo aggregieren und Verlässlichkeit von außen beurteilen. In kleinem Maßstab funktioniert das. In großen Warehouse-Landschaften wird es zur Belastung, besonders wenn Datenschutz, Latenz und Betriebslast zugleich zählen.
Das In-Database-Verlässlichkeitsparadox
Das Paradox ist einfach. Sie wollen Verlässlichkeit fortlaufend messen, doch der Export der Daten zur Messung kann Kosten, Verzögerung und Governance-Reibung erzeugen. Schlimmer noch: Er trennt das Messsystem von der Umgebung, in der die Brüche entstehen.
Für KI-basierte Erkennung ist die Lücke schärfer. Die ungelöste Herausforderung nennen manche Engineers das In-Database-Verlässlichkeitsparadox. Die meisten Leitfäden konzentrieren sich auf externe Stichproben, nicht aber darauf zu validieren, ob die gelernte Baseline eines Algorithmus konsistent bleibt, wenn die Berechnung nativ im Warehouse stattfindet. Diese Herausforderung wird direkt in dieser Erörterung des In-Database-Verlässlichkeitsparadoxons für Enterprise Data Engineers beschrieben.

Genau das übersehen viele Teams. Es genügt nicht, Daten zu überwachen. Sie brauchen auch die Gewissheit, dass Ihre Monitoring-Logik stabil bleibt, wenn das Quellvolumen hochschnellt, sich Schemata verschieben oder historische Muster sich ändern.
Was man in der Praxis instrumentiert
Für ein Warehouse-first-Verlässlichkeitsprogramm instrumentieren Sie drei Ebenen gleichzeitig.
Erstens: Überwachen Sie das Ankunftsverhalten. Sie müssen wissen, ob erwartete Datensätze eingetroffen sind, ob sie pünktlich waren und ob Verzögerungen vereinzelt oder systemisch auftreten.
Zweitens: Überwachen Sie die strukturelle Stabilität. Schema-Drift bricht Pipelines und Modelle häufiger, als Teams zugeben, besonders wenn vorgelagerte Anwendungsteams Änderungen ohne Analytics-Review ausliefern.
Drittens: Überwachen Sie die Validität auf Satzebene für geschäftskritische Entitäten. Aggregate können tiefe Fehler verbergen. Gebrochene Referenzen, doppelte Schlüssel und ungültige Statusübergänge zeigen sich meist erst, wenn Sie Zeilen prüfen, nicht Zusammenfassungen.
Ein praxistaugliches Dashboard für Plattformteams sollte enthalten:
Aktualitätsansichten, die verspätete Tabellen, verzögerte Partitionen und veraltete nachgelagerte Marts hervorheben
Schemaansichten, die hinzugefügte Spalten, entfernte Spalten und Datentypänderungen zeigen
Validierungsansichten, die Regelverstöße nach Tabelle, Verantwortung und Fachdomäne sichtbar machen
Historische Ansichten, die Engineers helfen, diesen Vorfall mit früheren Mustern zu vergleichen
Wenn Sie diese Fähigkeit formalisieren, ist eine gute konzeptionelle Referenz, was Data Observability in der Praxis bedeutet. Sie hilft, Observability als technisches Betriebsmodell zu verankern und nicht als weiteres Dashboard.
Externe Stichproben können einen Punkt belegen. In-Database-Instrumentierung kann die Plattform betreiben.
Der Zielkonflikt ist hier organisatorisch. Volle Sichtbarkeit erfordert Einigkeit zwischen Platform Engineering, Analytics Engineering, Governance und ML-Teams. Ohne geteilte Verantwortung instrumentiert jedes Team seine eigene Ecke, und niemand sieht die vollständige Fehlerkette.
Einen verlässlichkeitsgetriebenen Workflow aufbauen
Ein Verlässlichkeits-Alert ist nur dann wertvoll, wenn er die richtige Reaktion auslöst. Sonst haben Sie ein Benachrichtigungssystem gebaut und kein Verlässlichkeitsprogramm.
Der Workflow muss im besten Sinne langweilig sein. Wiederholbar. Zugewiesen. Nach einem schweren Vorfall leicht prüfbar. Wenn Teams das überspringen und auf heldenhaftes Debuggen setzen, lösen sie den akuten Ausfall und bewahren genau die Bedingungen, die den nächsten verursachen.
Was nach dem Alert passiert
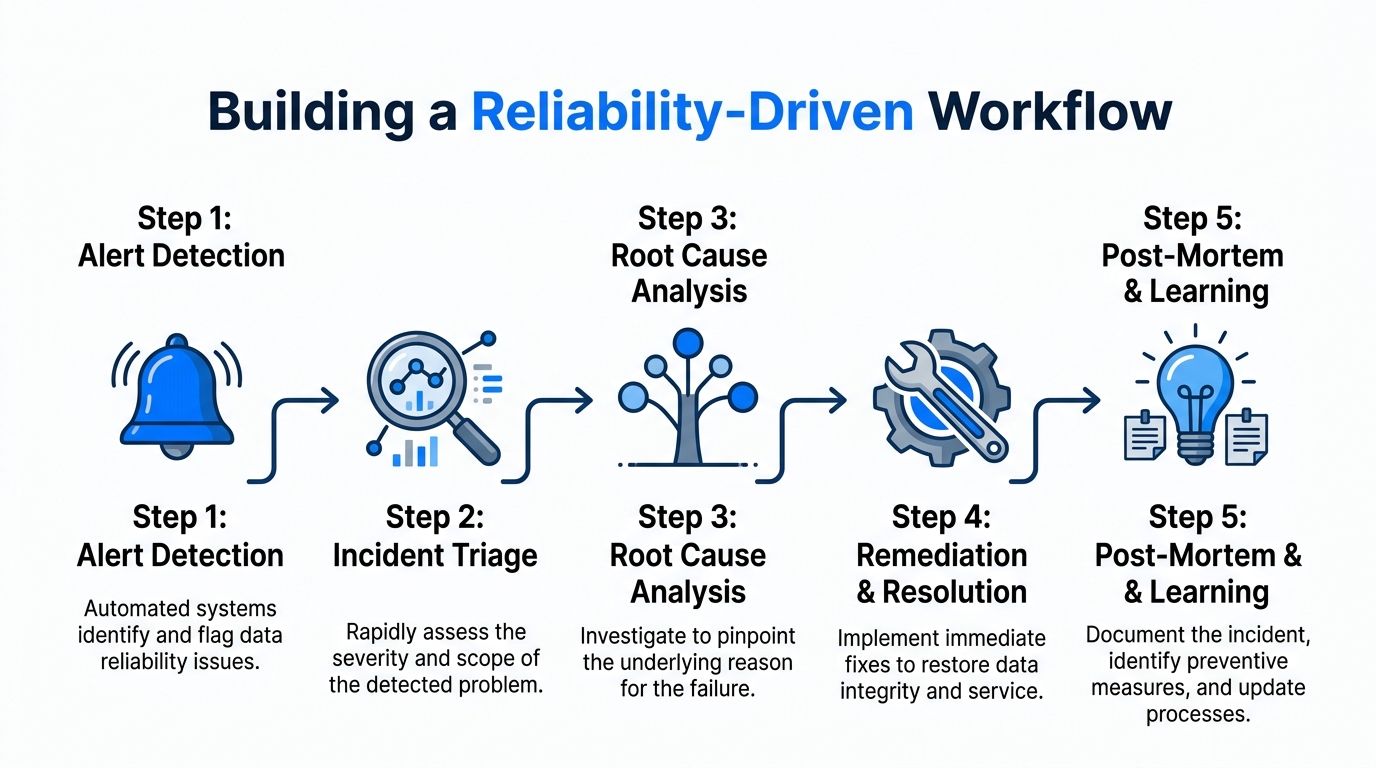
Ein starker Workflow folgt meist fünf Schritten, wobei nicht jeder Vorfall dieselbe Tiefe braucht.
Das Problem erkennen
Das Signal kann aus Aktualität, Schema, Validierung oder nachgelagerten fachlichen Prüfungen stammen. Wichtig ist, dass die Erkennung erfolgt, bevor Stakeholder das Problem selbst entdecken.Schnell triagieren
Entscheiden Sie, ob das Problem vereinzelt, geteilt oder führungsrelevant ist. Eine defekte Feature-Tabelle, die ein einziger Trainingsjob nutzt, ist etwas anderes als ein verspäteter Finanz-Mart, den das ganze Unternehmen konsumiert.Die Ursache zurückverfolgen
Prüfen Sie Pipeline-Logs, Warehouse-Metadaten, Liefermuster der Quelle und Schemahistorie. Fragen Sie, ob das Problem aus verspäteter Ankunft, struktureller Änderung, Logikregression oder schlechten Quelldaten stammt.Sicher beheben
Laden Sie nach, wenn Daten fehlen. Korrigieren Sie die Transformationslogik, wenn das Problem semantisch ist. Stellen Sie Schemakompatibilität nach vorn her, wo möglich. Vermeiden Sie stille Einzelkorrekturen, die keine Spur hinterlassen.Die Lehre festhalten
Ergänzen Sie eine neue Leitplanke, passen Sie Verantwortlichkeiten an oder verfeinern Sie eine Baseline. Wenn derselbe Vorfall ohne neue Kontrolle erneut auftreten kann, ist der Prozess nicht abgeschlossen.
Vorfälle nutzen, um die Plattform zu härten
Historische Observability zählt hier, weil Trends oft offenlegen, was ein einzelner Vorfall verbirgt. Wiederholte Verspätungen in einer Quelldomäne können auf schwache vorgelagerte Verträge hindeuten. Häufige Schemabrüche in gemeinsamen Dimensionen können auf Probleme der Release-Koordination hindeuten. Validierungsspitzen in einem Geschäftsprozess können zeigen, dass das Problem gar nicht im SQL liegt, sondern in operativer Dateneingabe oder Systemintegration.
Ein besonders nützliches operatives Muster ist die Überwachung des Ankunftsverhaltens gegen erwartete Zeitpläne und gelernte Muster. Das Timeliness-Monitoring der Plattform verfolgt die Datenankunft gegen gelernte Verhaltensmuster, berechnet erwartete Lieferzeiten und erkennt Verzögerungen, wodurch veraltete Berichte und defekte Dashboards durch verspätete oder fehlende Ladevorgänge direkt verhindert werden, wie in diesem Produktupdate zu Timeliness-Monitoring und Zeitreihenanalyse beschrieben.
Für Teams, die breitere automatisierte Reaktionsflüsse entwerfen, sind die Prinzipien in Architektur und Design von KI-Agenten nützlich, weil sie klares Denken über Orchestrierung, Übergaben und kontrollierte Eskalation erzwingen. Dieselbe Disziplin gilt für den Betrieb der Datenverlässlichkeit.
Das beste Ergebnis einer Nachbetrachtung ist kein Dokument. Es ist eine neue Kontrolle, die dieselbe Fehlerklasse verhindert.
Ein reifer Workflow versucht nicht, jeden Vorfall zu eliminieren. Er reduziert Überraschung, verkürzt die Diagnose und sorgt dafür, dass jeder Fehler der Plattform etwas Neues beibringt.
Wenn Sie Verlässlichkeit messen wollen, ohne Daten aus Ihrer Umgebung zu bewegen, ist digna für genau dieses Betriebsmodell gebaut. Es hilft Teams, Anomalien zu erkennen, Datensätze zu validieren, Timeliness zu überwachen und Schemaänderungen zu verfolgen, und zwar direkt in kundeneigenen Datenumgebungen, sodass die Verlässlichkeitsmessung nah an den Systemen bleibt, die brechen.
Häufig gestellte Fragen
Wie misst man Datenverlässlichkeit?
Mit Kennzahlen, die sich dort berechnen lassen, wo die Daten bereits liegen. Die Zeit seit dem letzten erfolgreichen Ladevorgang deckt Aktualität ab, die Abweichung der Zeilenzahl die Vollständigkeit, die Quote ungültiger Werte die Genauigkeit und die Häufigkeit von Schemaänderungen die Konsistenz. Daten erst zu exportieren erzeugt Latenz und Governance-Reibung, bevor überhaupt etwas gemessen wurde.
Was sind die vier Säulen der Datenverlässlichkeit?
Aktualität und Timeliness, Vollständigkeit, Genauigkeit und Korrektheit sowie Konsistenz. Vier genügen, um Verantwortung zuzuweisen und Vorfälle zu prüfen, ohne den Prozess in Governance-Theater zu verwandeln. Geben Sie jedem kritischen Asset ein primäres Fehlermuster: Führungs-Dashboards scheitern meist an Aktualität, ML-Feature-Tabellen an Konsistenz und Schemastabilität.
Was ist Data Downtime und wie berechnet man sie?
Die Zahl der Vorfälle multipliziert mit der Summe aus durchschnittlicher Erkennungs- und Behebungszeit. Sie beschreibt Verlässlichkeit in geschäftlichen statt in Orchestrierungsbegriffen. Spitzenunternehmen zielen auf unter 1 % pro Jahr, während durchschnittliche Organisationen oft 5 % bis 10 % ihrer Datenbestände als unbrauchbar erleben.
Warum brechen statische Schwellenwerte bei großem Umfang?
Sie sind leicht zu erklären und teuer zu pflegen. Schwellenwerte für jede Tabelle von Hand zu schreiben bedeutet, dass Teams ihre Zeit mit Alert-Tuning statt mit Verlässlichkeit verbringen. Eine Regel zur Zeilenzahl erkennt katastrophalen Verlust, verrät aber nicht, dass sich ein gelerntes Verhaltensmuster so verschoben hat, dass ein Feature unzuverlässig wird.
Was sollte ein Verlässlichkeitsprogramm zuerst instrumentieren?
Drei Ebenen gleichzeitig: Ankunftsverhalten, strukturelle Stabilität und Validität auf Satzebene für geschäftskritische Entitäten. Aggregate verbergen tiefe Fehler, denn gebrochene Referenzen, doppelte Schlüssel und ungültige Statusübergänge zeigen sich erst bei der Prüfung einzelner Zeilen. Beginnen Sie mit dem kleinsten Satz, der ein defektes Dashboard erklären kann.



