System of Record vs. Source of Truth: Ein praktischer Leitfaden
|
8
min. Lesezeit

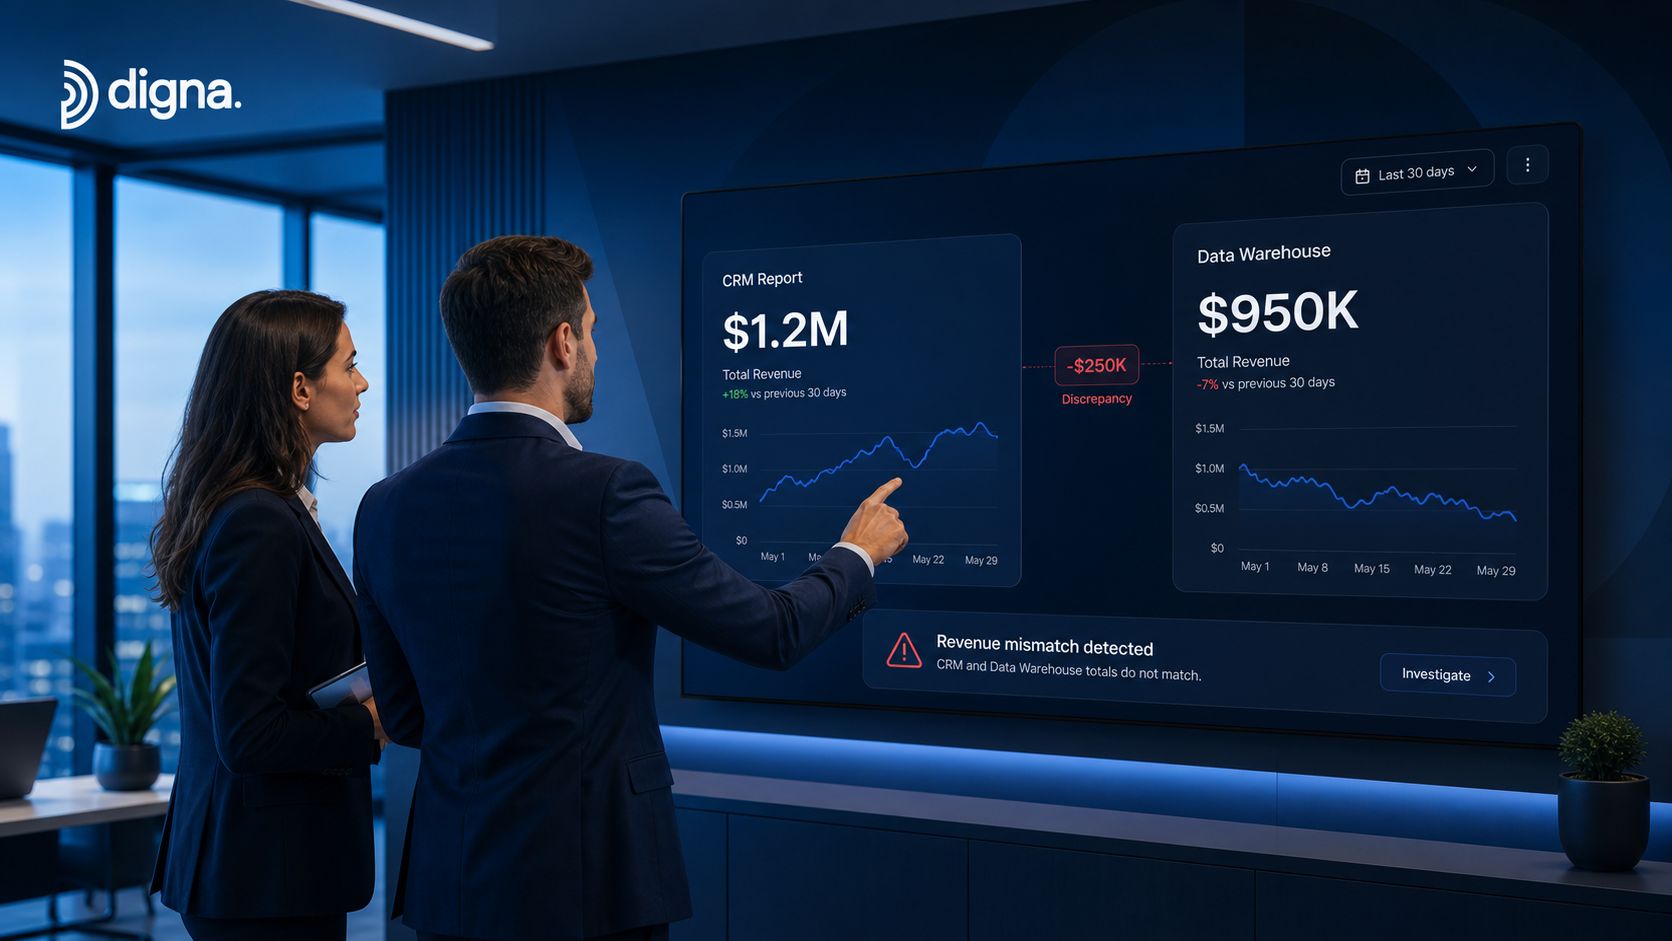
Sie kennen den Moment: Die Finanzabteilung hat eine Umsatzzahl im CRM, das Lager-Dashboard zeigt eine andere, und ein Abteilungsleiter fragt vor versammelter Mannschaft, welche davon stimmt. Die unangenehme Antwort ist, dass beide Systeme auf ihre Weise die Wahrheit sagen, aber nicht demselben Zweck dienen. Das ist der Kern von System of Record vs. Source of Truth – und wenn man diesen Unterschied missversteht, führt das bei Teams zu fehlerhaften Dashboards, unklaren Audits und langsamen Reaktionen auf Vorfälle.
Inhaltsverzeichnis
Warum die Unterscheidung in der modernen Datenarchitektur wichtig ist
Technische Unterschiede zwischen System of Record und Source of Truth
Entscheidungskriterien für die Auswahl oder Abstimmung von SOR und SOT
Checkliste für die Implementierung und empfohlene Architekturen
Warum die Unterscheidung in der modernen Datenarchitektur wichtig ist
Ein Finanzteam kann eine Stunde lang über eine Umsatzabweichung debattieren, die in Wirklichkeit ein Systemproblem ist. Ein Bericht liest Daten aus dem CRM, das als System of Record für kundenbezogene operative Daten dient, während ein anderer aus dem Data Warehouse liest, das als Source of Truth für das abteilungsübergreifende Reporting aufbereitet wurde. IBM beschreibt ein System of Record als die maßgebliche Quelle für einen Geschäftsbereich oder -prozess, während eine Source of Truth mehrere Systems of Record zu einer vollständigen, bereichsübergreifenden Ansicht harmonisiert. Dieser Unterschied ist wichtig, weil die Systeme für unterschiedliche Aufgaben gebaut sind, nicht weil eines „echter“ ist als das andere. Die Erklärung von IBM zu System of Record versus Source of Truth macht diese architektonische Trennung deutlich.
Die operative Ebene und die analytische Ebene
Am einfachsten lässt sich dies als operativ versus analytisch verstehen. Ein System of Record is ein operativer Datenspeicher, der maßgebliche Datensätze für eine einzelne Geschäftseinheit erfasst, validiert, aktualisiert und speichert und nicht direkt für Berichte oder Analysen verwendet wird. Aus diesem Grund kann eine HR-Plattform, ein ERP oder ein CRM das System of Record für seine eigenen Daten sein, während ein Warehouse oder eine verwaltete semantische Ebene zur Source of Truth für das Unternehmens-Reporting wird. Die Aufschlüsselung von Peter Ritchie zu operativen und analytischen Systemen ist nützlich, da sie zeigt, dass diese Unterscheidung kein semantisches Rauschen ist, sondern eine architektonische Grenze.
Der praktische Nutzen ist Vertrauen. Wenn ein Dashboard beantworten soll, was im gesamten Unternehmen passiert ist, sollte es die Daten nicht direkt aus isolierten operativen Speichern abrufen und darauf hoffen, dass sie von selbst zusammenpassen. Wenn ein Transaktionssystem die maßgebliche Kundenadresse bewahren soll, sollte es keine Aggregationslogik auf Unternehmensebene enthalten.
Praktische Regel: Nutzen Sie das System of Record für die Erfassung und Kontrolle und die Source of Truth für die gemeinsame Interpretation.
Diese Aufteilung wurde kritisch, als Unternehmen von einzelnen operativen Datenbanken zu Multi-System-Datenarchitekturen übergingen. Moderne Leitfäden behandeln SOR und SOT als komplementäre Konzepte, nicht als austauschbare Synonyme, da jedes ein anderes Fehlerszenario löst. Wenn man sie vermischt, ist das Ergebnis meist dasselbe: widersprüchliche Zahlen, verzögerte Entscheidungen und ein langes Meeting, das niemand wollte.
Technische Unterschiede zwischen System of Record und Source of Truth
Ein konkreter Unterschied zeigt sich im Verhalten im Live-Betrieb. Ein System of Record ist für einen einzelnen Bereich optimiert, wird häufig beschrieben und ist so ausgelegt, dass die Transaktionsintegrität bei der Erfassung gewahrt bleibt. Eine Source of Truth ist breiter gefächert, lesezentriert und darauf ausgelegt, maßgebliche Eingaben in einer verwalteten Ansicht abzustimmen, die Entscheidungsträger nutzen können. Der Vergleich von Nutrient zwischen SOR und SOT zieht diese Grenze klar, insbesondere bei dem Unterschied zwischen einem operativen Speicher in Fast-Echtzeit und einer periodisch aktualisierten analytischen Ansicht. Der Vergleich von Nutrient zwischen SOR und SOT verdeutlicht zudem den praktischen Punkt, dass das SOR einem einzelnen Bereich dient, während die SOT dem Unternehmen eine gemeinsame Sichtweise bietet.
Dimension | System of Record | Source of Truth |
|---|---|---|
Zweck | Maßgebliche Quelle für eine einzelne Geschäftseinheit oder einen Bereich | Einheitliche Ansicht für die Entscheidungsfindung über Bereiche hinweg |
Umfang | Eng gefasst, bereichsspezifisch | Breit gefächert, aus mehreren Quellen |
Aktualisierungsmuster | Echtzeit oder Fast-Echtzeit | Periodische Aggregation oder ETL |
Hauptnutzung | Erfassung und Verwaltung operativer Datensätze | Lesen, Berichten und Abstimmen von Entscheidungen |
Vertrauensmodell | Validierung am Point of Capture | Abgleich und Anreicherung über verschiedene Quellen hinweg |
Umfang, Eigentum und Aktualisierungsverhalten
Ein SOR ist der Ort, an dem Daten erstellt und verwaltet werden. Die Darstellung von Rework hilft hier, da sie das Regelwerk von der Speicherebene trennt: Die Source of Truth definiert, wie die Daten interpretiert werden sollen, und das System of Record ist der Ort, an dem die Daten gehalten werden. Aus diesem Grund gibt ein Vertriebsteam einen neuen Kunden ein, bucht die Finanzabteilung eine Rechnung oder aktualisiert die Personalabteilung eine Personalakte in einem SOR, während die Unternehmensleitung sich auf eine SOT verlässt, um eine konsistente Sicht über diese Datensätze hinweg zu erhalten. Die Erklärung von Rework zu Source of Truth und System of Record zeigt auch, warum ein Warehouse als SOT dienen kann, selbst wenn es nicht die ursprüngliche Quelle der Fakten ist.
Die Mechanismen des Vertrauens sind unterschiedlich. SORs sind stark bei der zeitpunktbezogenen Erfassung, aber sie lösen Duplikate nicht von selbst auf und füllen fehlende Felder nicht ohne zusätzliche Kontrollen aus. SOTs hängen von Anreicherung, Verifizierung und Abgleich ab, sodass ihre Zuverlässigkeit von der vorgeschalteten Datenqualität und einer kontinuierlichen Validierung abhängt. Aus diesem Grund ist Observability wichtig, bevor die Daten die Dashboards erreichen. Tools wie AutoProv Single-Source-Prüfungen sind in der Praxis nützlich, weil sie Lücken, Abweichungen und fehlende Quellenabdeckung aufdecken, bevor ein fehlerhafter Datensatz als maßgeblich eingestuft wird.
Ein SOR kann für eine einzelne Einheit korrekt sein und dennoch eine schlechte Grundlage für das Unternehmens-Reporting bilden. Eine SOT kann für eine geschäftliche Frage maßgeblich sein und dennoch im Hintergrund von mehreren Systems of Record abhängen.
Dieser Unterschied ist der Grund, warum das Aktualisierungsverhalten eine Rolle spielt. Ein Transaktionsspeicher enthält möglicherweise den aktuellsten Fakt für einen einzelnen Datensatz, während eine verwaltete analytische Ebene die am besten nutzbare bereichsübergreifende Antwort für Planung und Berichterstattung liefert. Wenn diese Aufgaben vermischt werden, muss jeder Konsument raten, welcher Ebene er vertrauen kann, was meist zu inkonsistenten Zahlen und verzögerten Korrekturen führt.
Wie die einzelnen Konzepte in der Produktion scheitern
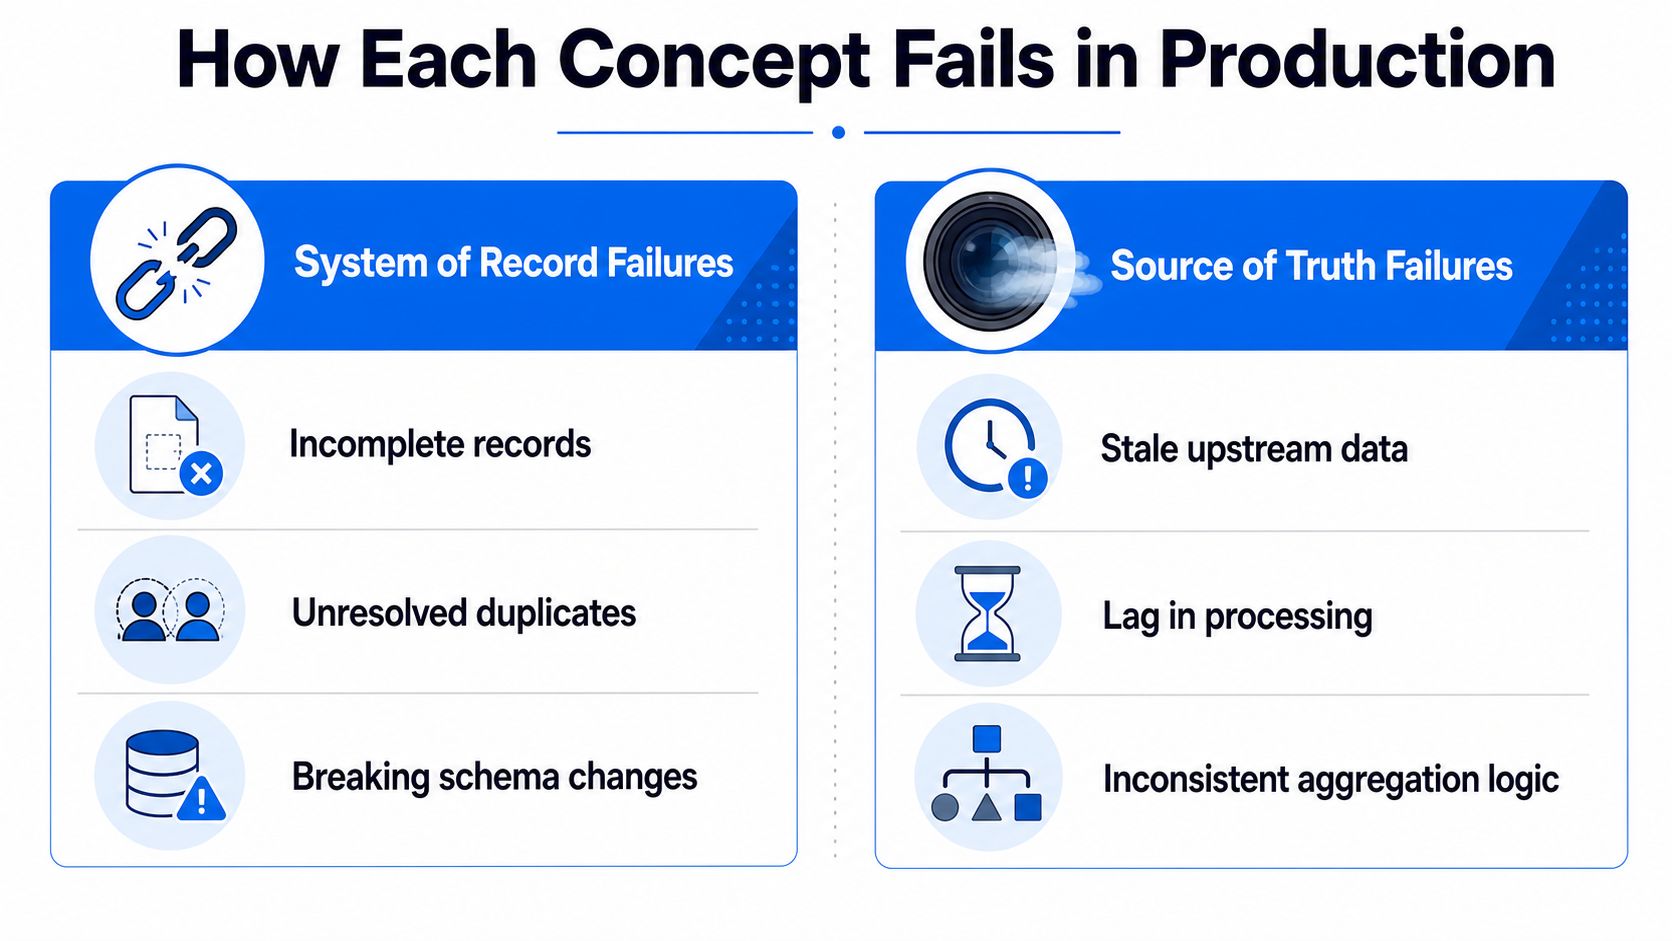
Die Fehlerszenarien sind unterschiedlich, daher sollte auch das Incident Playbook unterschiedlich sein. Ein System of Record scheitert, wenn der Datensatz selbst unvollständig ist, Duplikate ungelöst bleiben oder eine Schemaänderung die darauf angewiesenen Konsumenten beeinträchtigt. Eine Source of Truth scheitert, wenn die vorgeschaltete Datenqualität mangelhaft ist, ETL veraltete Daten liefert oder die Abgleichslogik einen Konflikt zwischen zwei Systemen übersieht, die beide glauben, im Recht zu sein. Dieser Unterschied ist in der Produktion wichtig, da der Fehlerort bestimmt, wo man zuerst sucht und wo man Kontrollen ansetzt. Die Observability muss das Problem abfangen, bevor es die Dashboards erreicht. Deshalb sind Tools wie AutoProv Single-Source-Prüfungen in der Praxis nützlich, wenn Teams Lücken, Abweichungen und fehlende Quellenabdeckung frühzeitig aufdecken müssen.
Wie ein Scheitern in der operativen Ebene aussieht
Operative Fehler zeigen sich meist zuerst als Dateneingabe- oder Integrationsprobleme. Ein doppelter Kundendatensatz kann zwei Identitäten in nachgelagerten Systemen erzeugen. Eine Schemaänderung kann eine Integration stören, die ein bestimmtes Feld oder einen stabilen Datentyp erwartet hat. Wenn die Erfassungskontrollen schwach sind, speichert das Quellsystem fehlerhafte Daten fehlerfrei ab – was schlimmer ist als ein Datenverlust, da die fehlerhaften Daten dadurch legitim und maßgeblich wirken.
Die operative Ebene scheitert im Moment des Schreibvorgangs. Das ist der Kompromiss. Sie ist dafür gebaut, Datensätze zu erfassen, zu validieren, zu aktualisieren und zu speichern. Ein Schwachpunkt in einem dieser Schritte macht das System of Record zu einem verlässlichen Ort für unzuverlässige Fakten. Peter Ritchies Definition von System of Record und Single Source of Truth ist hier nützlich, da sie den Fokus auf die operative Genauigkeit statt auf das Berichtsverhalten legt.
Wie ein Scheitern in der Aggregationsebene aussieht
SOT-Fehler sind oft unauffälliger, was es schwieriger macht, sie zu erkennen. Ein Data Warehouse kann weiterhin planmäßig geladen werden, während es inhaltlich falsch ist, weil eine vorgelagerte Quelle veraltet ist, eine Zusammenführungsregel nicht mehr aktuell ist oder eine Annahme zur Deduplizierung seit letzter Woche nicht mehr stimmt. Die Ebene sieht von außen immer noch gesund aus, aber die gelieferte Antwort kann sich von der Geschäftsrealität entfernen, die sie eigentlich zusammenfassen soll. Deshalb benötigen Teams Einblick in Eingangsmuster, strukturelle Änderungen und Geschäftsregelprüfungen, bevor das Problem ein Dashboard erreicht.
Für Teams, die einen konkreten Bezugspunkt für diese Art von Kontrolle benötigen, steht der Datenabgleich im Mittelpunkt des Problems. Es ist die Methode, die aufzeigt, wenn Datensätze nicht übereinstimmen, eine Quelle fehlt oder ein „vertrauenswürdiges“ Aggregat eine veraltete oder unvollständige Sichtweise weiterträgt. Eine Source of Truth hängt von diesen Prüfungen ab, denn Autorität ohne Verifizierung ist nur ein Etikett.
Die Frage nach der Ursache ist einfach, wird aber von Teams zu oft übersprungen. Entstand der fehlerhafte Datensatz im operativen Speicher oder wurde er erst nach der Aggregation und dem Abgleich irreführend? Wenn Sie das nicht klar beantworten, verschwenden Sie Zeit damit, der falschen Ebene und dem falschen Team die Schuld zu geben.
Entscheidungskriterien für die Auswahl oder Abstimmung von SOR und SOT
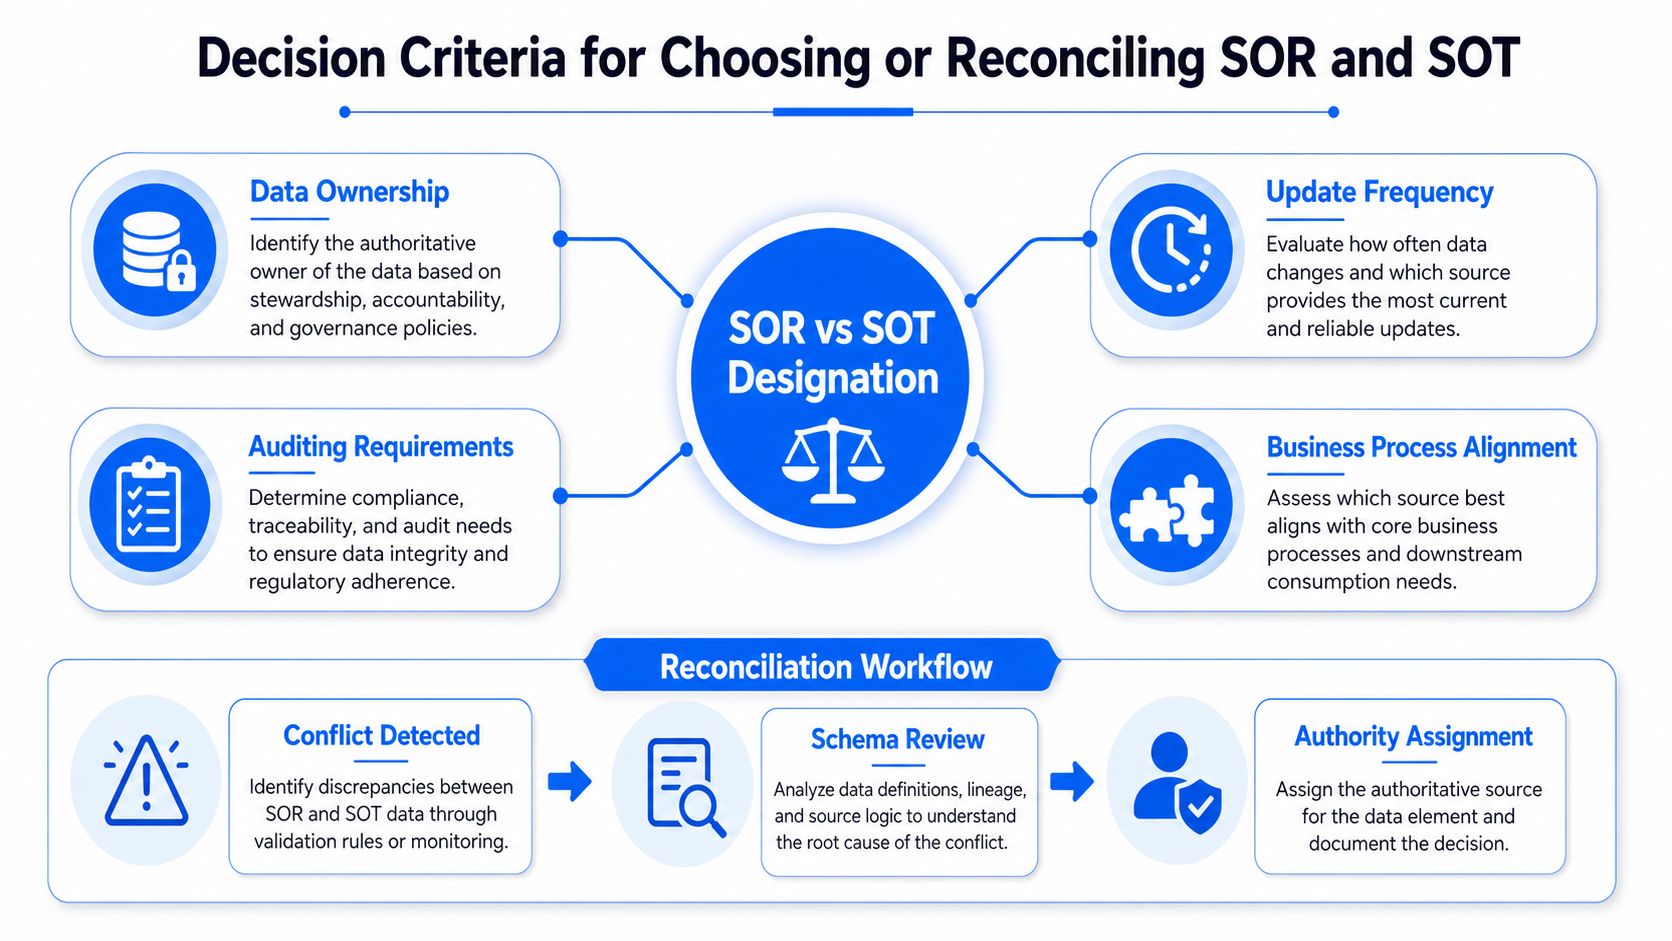
Beginnen Sie mit der Zuständigkeit. Wenn ein Team die Daten im Rahmen eines Live-Geschäftsprozesses erstellt und pflegt, ist dieses System in der Regel das System of Record für diesen Bereich. Wenn das Ziel darin besteht, eine harmonisierte Sicht über verschiedene Bereiche hinweg für Berichte, Planung oder Aufsicht bereitzustellen, ist diese Ebene meist die Source of Truth. Der Fehler liegt darin, ein einzelnes System für beide Aufgaben erzwingen zu wollen, da der Schreibpfad ein strenges Transaktionsverhalten erfordert, während der Lesepfad eine breite Integration und Historie verlangt.
Nutzen Sie die richtige Ebene für die richtige Frage
Ein verwaltetes Warehouse oder eine semantische Ebene ist oft die richtige SOT, wenn Finanzen, Vertrieb und Betrieb eine gemeinsame Sicht auf das Geschäft benötigen. Die operativen Systeme bleiben maßgeblich für ihre eigenen Datensätze, während das Warehouse zur vereinbarten Berichtsebene wird, da es mehrere maßgebliche Eingaben kombiniert. Dieses Muster funktioniert, weil es die architektonische Realität respektiert, dass die Berichtsebene auf den operativen Systemen aufsetzt, anstatt sie zu ersetzen.
Wenn mehrere Systeme die Autorität über dasselbe Feld beanspruchen, gleichen Sie dies ab, indem Sie fragen, welches System für die Erstellung, welches für die Validierung und welches für die nachgelagerte Interpretation zuständig ist. Die Antwort lautet selten „alle gleichermaßen“. Häufiger sollte ein System den Schreibpfad und ein anderes den gemeinsamen Lesepfad besitzen, ergänzt durch einen Abgleichsworkflow, der Konflikte meldet, bevor sie sich ausbreiten.
Operative Regel: Wenn das Feld eine Transaktion steuert, bevorzugen Sie das SOR. Wenn das Feld eine bereichsübergreifende Entscheidung steuert, bevorzugen Sie die SOT.
Hier treffen auch governance und Architektur aufeinander. Die Frage ist nicht, ob das Warehouse „weniger echt“ ist, sondern ob es der richtige Ort ist, um eine kontrollierte, prüfbare Interpretation mehrerer realer Systeme zu erstellen. Der vorherige Abschnitt über technische Unterschiede ist hier wichtig, da dasselbe Datenelement legitimerweise einen operativen und einen entscheidungsrelevanten Speicherort haben kann.
Wenn Teams ein konkretes Modell für den Abgleich benötigen, ist dieser Leitfaden zur Bedeutung des Datenabgleichs eine hilfreiche interne Referenz. Wichtig ist, die Zuständigkeit explizit zuzuweisen, damit ein Konflikt nicht bei jeder Änderung einer Zahl zu einer politischen Diskussion führt.
Wie Data Observability zuverlässige SOR und SOT unterstützt
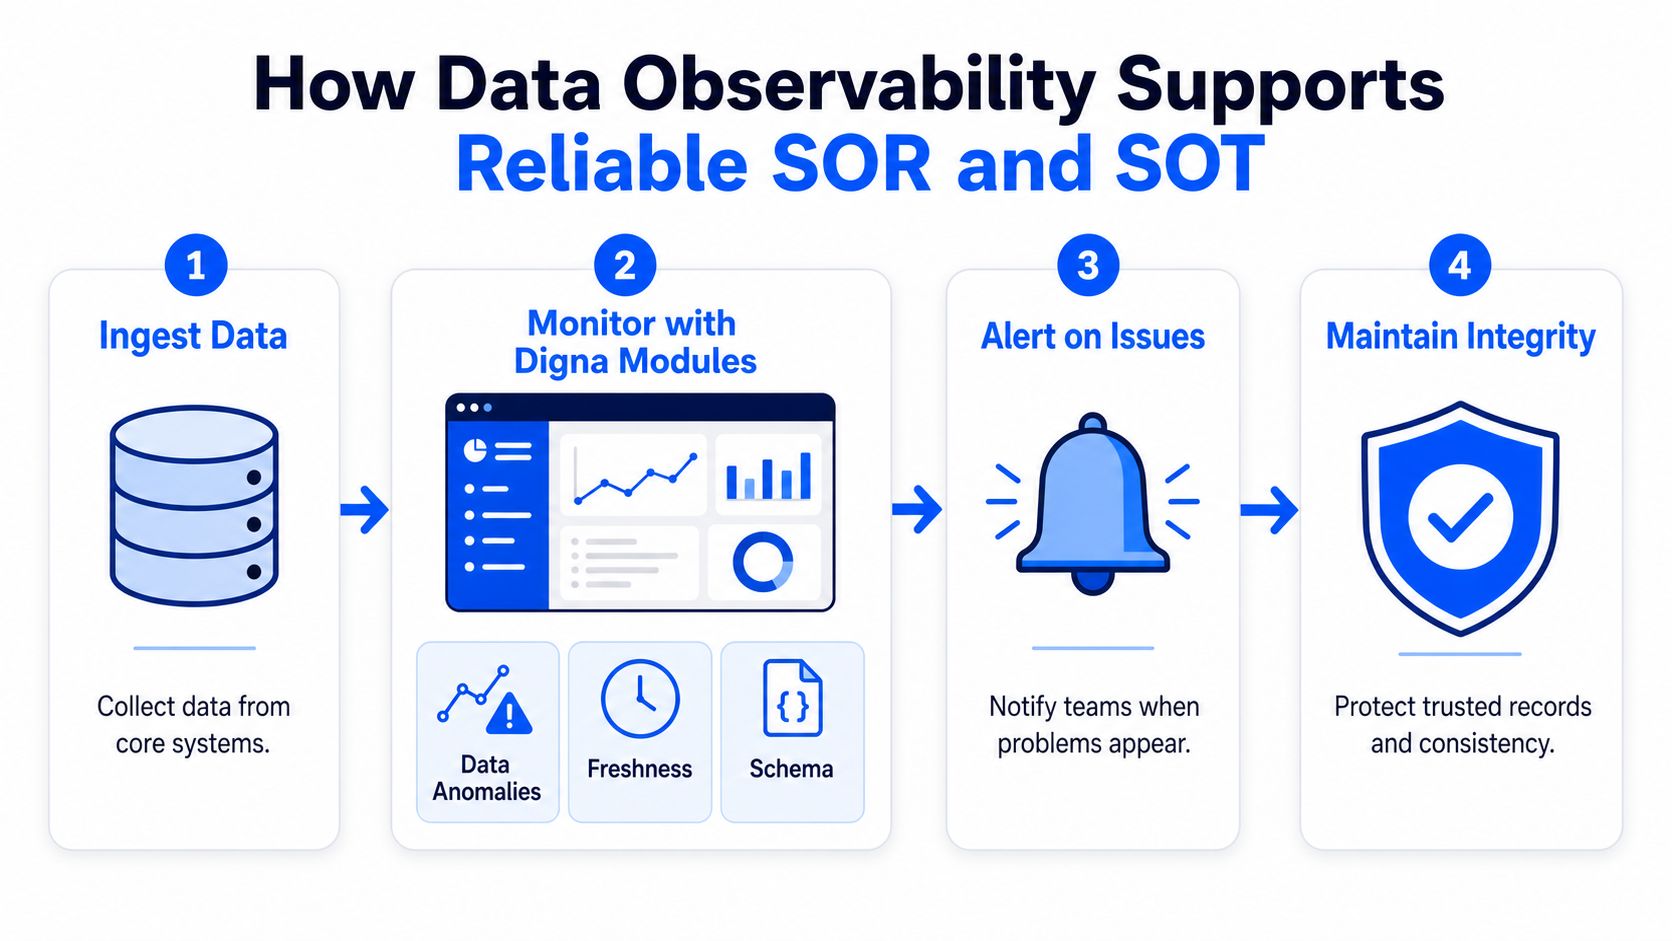
Data Observability schließt die Lücke zwischen „der Datensatz existiert“ und „der Datensatz ist vertrauenswürdig genug für die Nutzung“. In einer operativen Ebene bedeutet dies, Schema-Drift, fehlende Datensätze und fehlerhafte Validierungen abzufangen, bevor nachgelagerte Systeme den Schaden übernehmen. In einer vertrauenswürdigen analytischen Ebene bedeutet es, Verzögerungen beim Dateneingang, Anomalien und Regelverstöße zu erkennen, bevor Geschäftsanwender eine falsche Version der Realität sehen. digna ist eine Option in diesem Bereich, und seine Module passen genau zu den bereits besprochenen Fehlerszenarien: Data Anomalies für KI-gestütztes Lernen von Baselines, Timeliness für die Überwachung des Dateneingangs und die Erkennung von Verzögerungen, Data Validation für die Durchsetzung von Geschäftsregeln und Schema Tracker für die Erkennung struktureller Änderungen.
Was Observability überwachen sollte
Die Kontrollen sollten zur jeweiligen Ebene passen. Für ein SOR sind die Validierung auf Datensatzebene und das Schema-Tracking wichtig, da der Erfassungspunkt sauber bleiben muss. Für eine SOT sind Aktualität und Anomalieerkennung entscheidend, da die Frische und die Qualität des Abgleichs bestimmen, ob die gemeinsame Sichtweise noch verlässlich ist. Das Design von digna ist auch aus einer governance-Perspektive wichtig, da es vollständig innerhalb der Infrastruktur des Kunden mit In-Database-Ausführung läuft, sodass sensible Datensätze die Umgebung für die Überprüfung nicht verlassen müssen.
Die wichtigere Erkenntnis ist, dass Observability kein bloßes Dashboard-Zubehör ist. Sie ist die Steuerungsebene zwischen Systems of Record und Sources of Truth. Wenn eine Pipeline verspätet liefert, sich ein Schema ändert oder eine Geschäftsregel nicht mehr greift, sollte das Problem als Vorfall gemeldet werden, lange bevor Führungskräfte eine veraltete Kennzahl sehen.
Für einen tieferen Produktüberblick ist diese digna Data Observability Übersicht ein nützlicher Einstiegspunkt.
Teams, die nach einem praktischen Playbook für Datenintegrität suchen, können auch vom Leitfaden für Führungskräfte des Church Extension Fund lernen, insbesondere wenn sie governance-Begriffe in operative Kontrollen übersetzen müssen. Observability funktioniert am besten, wenn sie auf den tatsächlichen Datenlebenszyklus abgestimmt ist und nicht erst nachträglich hinzugefügt wird, wenn ein Bericht fehlerhaft ist.
Checkliste für die Implementierung und empfohlene Architekturen
Eine saubere Implementierung beginnt mit der Zuständigkeit, nicht mit den Tools. Identifizieren Sie zuerst jedes System, das eine kritische Entität erstellt oder aktualisiert, und markieren Sie dasjenige, das den maßgeblichen Schreibpfad besitzt, als SOR. Bestimmen Sie als Nächstes die Berichtsebene, die diese Eingaben zusammenführt, als SOT und dokumentieren Sie, welche Fragen diese Ebene beantworten darf. Wenn von beiden Ebenen erwartet wird, dass sie dieselbe Frage beantworten, deutet das auf einen Designfehler hin, nicht auf ein Feature.
Eine praktische Checkliste
Zuständigkeiten der Entitäten zuweisen: Bestimmen Sie das System, das den Datensatz erstellt und aktualisiert, als SOR für diesen Bereich.
Die Berichtsebene definieren: Wählen Sie das Warehouse oder die semantische Ebene, die als SOT für bereichsübergreifende Entscheidungen fungiert.
Validierungsregeln zuerst schreiben: Erfassen Sie Geschäftsregeln für Pflichtfelder, zulässige Werte und Konfliktbehandlung, bevor Sie Ladevorgänge automatisieren.
Aktualität explizit überwachen: Legen Sie Erwartungen fest, wann Quelldaten eintreffen müssen, und richten Sie Alarme ein, wenn dies nicht geschieht.
Schemaänderungen kontinuierlich verfolgen: Behandeln Sie strukturelle Abweichungen als Risiko für das Release, nicht als kosmetische Änderung.
Audit-Nachweise zusammenhalten: Bewahren Sie die Lineage und den Abgleichspfad auf, damit governance-Teams nachweisen können, wie die vertrauenswürdige Ansicht erstellt wurde.
Für eine breitere Plattformsicht bietet diese Übersicht über Unternehmensdatenplattformen nützlichen Kontext für Teams, die Architekturen mit mehreren Quellen und verwalteten Konsumenten entwerfen.
Architekturmuster, die sich bewähren
Für bereichsübergreifende Kundendaten lassen Sie CRM, Abrechnung und Support jeweils das SOR für ihren eigenen Bereich bleiben und führen Sie die Daten dann in einer verwalteten semantischen Ebene zusammen, die als SOT für Account-Teams und Führungskräfte dient. Für das Finanz-Reporting halten Sie das ERP oder Hauptbuch für die Transaktion maßgeblich und veröffentlichen Sie abgestimmte Berichtsansichten aus dem Warehouse. Für die operative Analytik nutzen Sie Change Data Capture oder geplante Datenübernahmen in eine analytische Ebene, damit der Betrieb schnell und die Analytik konsistent bleibt.
Das stärkste Muster ist nicht ein System, das vorgibt, alles zu sein. Es ist eine klare operative Quelle, eine verwaltete analytische Ansicht und eine Überwachungsebene, die beweist, dass beide immer noch übereinstimmen.
Diese Struktur funktioniert in Cloud-, On-Premises- und Hybrid-Umgebungen, da die Logik dieselbe bleibt, selbst wenn sich die technische Anbindung ändert. Die Systeme können sich unterscheiden, das Zuständigkeitsmodell sollte es nicht.
Praxisanwendungen in regulierten Branchen
Finanzdienstleister achten meist zuerst auf die Integrität an der Quelle und erst in zweiter Linie auf die Harmonisierung im Berichtswesen, da Risiko- und Regulierungsdaten nicht unbemerkt abweichen dürfen. Das Gesundheitswesen legt größten Wert auf die Zuverlässigkeit klinischer Datensätze und legt dann operative und Berichtsansichten darüber, damit Behandlungsteams und Compliance-Teams nicht mit inkompatiblen Daten arbeiten. Die Telekommunikation hat ein anderes Belastungsprofil: Große Mengen an Kunden- und operativen Daten können unter Last ohne Vorwarnung fehlerhaft werden, sodass Schema-Tracking und Aktualität entscheidend sind, um die vertrauenswürdige Ansicht aktuell zu halten.
Programme im öffentlichen Sektor haben es meist mit einer Mischung aus langlebigen Datensätzen, Audit-Erwartungen und vielen Berichtsempfängern zu tun, was die Trennung zwischen SOR und SOT besonders wertvoll macht. In der Praxis bedeutet dies, dass das operative System den maßgeblichen Datensatz behält, während die Berichtsebene auf Rückverfolgbarkeit, Konsistenz und Nachweisbarkeit ausgelegt ist. Der modulare Ansatz von digna lässt sich hier gut anwenden, da die Plattform Finanzrisikodaten, klinische Akten, datenintensive operative Feeds und staatliche Berichtspipelines überwachen kann, ohne überall dasselbe Kontrollmuster aufzuzwingen.
Was sich je nach Branche ändert
Die Gemeinsamkeit besteht darin, dass sich regulierte Umgebungen nicht darauf verlassen können, dass „das Dashboard gut aussah“. Sie benötigen den Nachweis, dass der vorgelagerte Datensatz gültig war, dass die Aggregationsebene die Daten rechtzeitig erhalten hat und dass Schemaänderungen die Bedeutung nicht unbemerkt verändert haben. Hier wird die Grenze zwischen System of Record und Source of Truth zu einer operativen Kontrolle, nicht nur zu einer Definition.
Wenn sich Ihr Unternehmen auf ein Audit vorbereitet oder die Kontrollen rund um das Management-Reporting verschärft, ist die Ressource Regina SOC 2 Audit-Hilfe für CFOs ein nützliches Beispiel dafür, wie Compliance-Arbeit von zuverlässigen Nachweisen abhängt und nicht nur von schönen Berichten. Dasselbe Prinzip gilt für all diese Branchen: Die vertrauenswürdige Ansicht muss nachweisbar sein und darf nicht bloß angenommen werden.
Wenn Sie herausfinden möchten, wo Ihre Systems of Record aufhören und Ihre Source of Truth beginnt, bietet digna Teams die Möglichkeit, die Nahtstellen zu überwachen, anstatt sie erst in einem fehlerhaften Dashboard zu entdecken. Es überwacht das Datenverhalten, validiert Geschäftsregeln, verfolgt die Aktualität und erkennt Schemaänderungen innerhalb Ihrer eigenen Umgebung – genau das, was diese Architekturen benötigen. Besuchen Sie digna, um zu sehen, wie sich das in Ihren eigenen operativen und Berichts-Stack integrieren lässt.
Für die Source-of-Truth-Seite, auf der ein Warehouse planmäßig weiterlädt und sich dabei unbemerkt von der geschäftlichen Realität entfernen kann, lernt digna Data Anomalies die normale Baseline jeder Tabelle und meldet unerwartete Abweichungen, bevor sie ein Dashboard erreichen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einem System of Record und einer Source of Truth?
Ein System of Record ist der maßgebliche operative Speicher für eine Geschäftsdomäne, etwa ein CRM, ERP oder HR-System, in dem Daten erstellt und verwaltet werden. Eine Source of Truth führt mehrere Systems of Record zu einer gesteuerten, domänenübergreifenden Sicht zusammen, typischerweise in einem Data Warehouse oder einer semantischen Schicht für das Reporting.
Kann ein Data Warehouse ein System of Record sein?
In der Regel nicht; der Artikel ordnet das Warehouse als Source of Truth ein. Es erzeugt die Fakten nicht selbst, sondern führt mehrere maßgebliche Quellen zur vereinbarten Reporting-Schicht zusammen. Operative Systeme wie CRM, Abrechnungsplattform oder ERP-Hauptbuch bleiben für ihre eigenen Datensätze und Transaktionen maßgeblich.
Wie unterscheiden sich die Fehlerbilder von System of Record und Source of Truth?
Ein System of Record versagt beim Schreiben: unvollständige Datensätze, nicht aufgelöste Kundendubletten oder eine Schemaänderung, die Integrationen bricht. Eine Source of Truth versagt leiser, wenn eine vorgelagerte Quelle veraltet, eine Merge-Regel überholt ist oder eine Deduplizierungsannahme nicht mehr gilt, während die Ladevorgänge weiterhin planmäßig laufen.
Welches System gilt, wenn zwei Systeme beim selben Feld voneinander abweichen?
Fragen Sie, welches System die Erstellung, welches die Validierung und welches die nachgelagerte Interpretation verantwortet. Die operative Regel des Artikels ist einfach: Steuert das Feld eine Transaktion, hat das System of Record Vorrang; steuert es eine bereichsübergreifende Entscheidung, hat die Source of Truth Vorrang, gestützt durch einen Abgleichsprozess, der Konflikte frühzeitig meldet.
Wie unterstützt Data Observability Systems of Record und Sources of Truth?
Die Kontrollen sollten zur Schicht passen. Beim System of Record halten Validierung auf Datensatzebene und Schema-Tracking den Erfassungspunkt sauber. Bei der Source of Truth bestätigen Timeliness und Anomalieerkennung, dass die gemeinsame Sicht aktuell und abgeglichen ist. Der Artikel ordnet dies digna Data Validation, Schema Tracker, Timeliness und Data Anomalies zu.



