Prüfung der referenziellen Integrität einrichten: Schritt für Schritt
|
6
min. Lesezeit

Ein Fremdschlüssel, der ins Leere zeigt, löst keinen Fehler aus. Die Zeile wird geladen, der nächste Inner Join verwirft sie, und ein Bericht zeigt null, wo eigentlich 82 stehen müssten. Eine Prüfung der referenziellen Integrität ist eine Datenvalidierungsregel, die bestätigt, dass jeder Wert in einer untergeordneten Spalte oder Spaltenkombination in der referenzierten übergeordneten Tabelle existiert, und die Zeilen meldet, bei denen das nicht der Fall ist.
Die meisten analytischen Plattformen führen diese Prüfung nicht für Sie aus. Snowflake behandelt Fremdschlüssel auf Standardtabellen als optional und nicht erzwungen, und BigQuery sagt klar, dass Sie selbst für ihre Einhaltung verantwortlich sind. Redshift und Databricks verhalten sich genauso. Die Prüfung muss also an anderer Stelle stattfinden.
Dieser Leitfaden zeigt, wie Sie die referenzielle Integrität in der Praxis prüfen: zuerst die Entscheidungen, die Sie vorab treffen sollten (Beziehungen, Spalten, NULL-Werte, Schwellenwerte, Zeitpunkt), dann die Einrichtung in digna: eine Handvoll Felder, kein SQL. Wenn Sie zuerst das Konzept verstehen möchten, beginnen Sie mit unserem Leitfaden zu referenzieller Integrität und verwaisten Datensätzen.
Das Wichtigste in Kürze
Prüfen Sie zuerst die Beziehungen, über die Ihre Berichte joinen: Faktentabellen zu Dimensionen und untergeordnete Datensätze zu übergeordneten, priorisiert danach, was bei einem Fehler kaputtgeht.
Verwenden Sie auf beiden Seiten exakt die Join-Spalten. Ein zusammengesetzter Schlüssel wird als Kombination geprüft, und beide Spaltenlisten müssen dieselbe Länge und Reihenfolge haben.
Ein Fremdschlüssel mit NULL lässt eine Prüfung der referenziellen Integrität nicht fehlschlagen. Ist die Referenz verpflichtend, ergänzen Sie eine separate Not-Null-Regel.
Verwenden Sie Nulltoleranz für Finanz- und klinische Daten und einen relativen Schwellenwert für große Tabellen mit einem bekannten Rest verspätet eintreffender Referenzen.
In digna ist die Prüfung eine Regel vom Typ Referential Integrity: Spalten wählen, festlegen, wo sie existieren müssen, zwei Schwellenwerte setzen, speichern. Sie läuft bei jeder Inspektion innerhalb Ihrer Datenbank.
Inhaltsverzeichnis
Was ist eine Prüfung der referenziellen Integrität?
Welche Beziehungen sollten Sie zuerst prüfen?
Wie wählen Sie die Spalten und zusammengesetzten Schlüssel aus?
Was sollte ein Fremdschlüssel mit NULL bedeuten?
Welchen Schwellenwert sollte eine Prüfung der referenziellen Integrität verwenden?
Wann sollte eine Prüfung der referenziellen Integrität laufen?
Wie richten Sie eine Prüfung der referenziellen Integrität in digna ein?
Wie sieht das entsprechende SQL aus?
Wie lesen Sie eine fehlgeschlagene Prüfung der referenziellen Integrität?
Wo sollten Sie anfangen?
Was ist eine Prüfung der referenziellen Integrität?
Eine Prüfung der referenziellen Integrität nimmt eine Spalte oder eine Spaltenkombination einer untergeordneten Tabelle und bestätigt, dass jeder befüllte Wert auch in der referenzierten übergeordneten Tabelle existiert. Zeilen, die einen übergeordneten Datensatz finden, bestehen die Prüfung. Zeilen ohne übergeordneten Datensatz sind verwaist und schlagen fehl. Das Ergebnis ist eine Anzahl bestandener und fehlgeschlagener Zeilen und, wenn Sie es wünschen, die fehlerhaften Zeilen selbst. Sie finden die Prüfung auch unter den Namen Fremdschlüsselprüfung oder Validierung der referenziellen Integrität.
Ein Fremdschlüssel-Constraint greift beim Schreiben und weist den Insert ab. Eine Prüfung greift nach dem Laden und zeigt Ihnen, welcher Anteil der geladenen Daten ins Leere zeigt. Wo deklarierte Schlüssel nur informativ sind, ist die Prüfung die einzige Kontrolle, die Sie tatsächlich haben.
Ansatz | Wann er greift | Was mit einem verwaisten Datensatz passiert | Funktioniert, wo Fremdschlüssel nicht erzwungen werden | Was Sie zurückbekommen |
|---|---|---|---|---|
Fremdschlüssel-Constraint | Beim Insert oder Update | Abgewiesen; der Ladevorgang schlägt fehl | Nein, die Deklaration ist nur ein Hinweis | Eine Fehlermeldung |
Ad-hoc-SQL-Abfrage | Wenn jemand daran denkt, sie auszuführen | Nichts, bis jemand nachsieht | Ja | Eine Ergebnismenge im SQL-Client einer Person |
Prüfung der referenziellen Integrität in digna | Bei jeder Inspektion, geplant oder auf Abruf | Geladen, gezählt und aufgelistet | Ja, auch über Datenbankverbindungen hinweg | Anzahl bestandener/fehlgeschlagener Zeilen, ein Status gemessen an Ihrem Schwellenwert, die fehlerhaften Zeilen |
Welche Beziehungen sollten Sie zuerst prüfen?
Prüfen Sie zuerst die Beziehungen, über die Ihre Berichte und nachgelagerten Jobs tatsächlich joinen: Faktentabellen zu ihren Dimensionen und untergeordnete Datensätze zu ihren übergeordneten. Eine fehlerhafte Verknüpfung an dieser Stelle verändert Zahlen, die Menschen lesen und unterschreiben. Eine Beziehung, die niemand abfragt, kann warten.
Eine kurze Bestandsaufnahme liefert Ihnen eine priorisierte Liste:
Listen Sie die Joins von Fakten zu Dimensionen auf. Buchungen zu Konten, Abrechnungsfälle zu Patienten, Verbindungsdatensätze zu Teilnehmern, Medikamentengaben zum Produktstamm.
Listen Sie die Joins von untergeordneten zu übergeordneten Datensätzen auf. Bestellpositionen zu Bestellungen, Diagnosen zu Behandlungsfällen, Sicherheiten zu Krediten.
Markieren Sie diejenigen, die Berichte, Abrechnung oder regulatorische Meldungen speisen. Ein Inner Join in diesen Abfragen verwirft verwaiste Datensätze spurlos.
Markieren Sie diejenigen, die von unterschiedlichen Jobs oder Systemen geladen werden. Ein untergeordneter Datensatz, der vor seinem übergeordneten eintrifft, ist verwaist.
Beginnen Sie mit den wichtigsten fünf bis zehn. Ergänzen Sie den Rest, sobald jemand für die Ergebnisse verantwortlich ist.
Wenn Sie das Ausmaß des Problems abschätzen möchten, bevor Sie etwas einrichten, liefern Ihnen die Abfragen aus dem Beitrag Verwaiste Datensätze mit SQL finden eine einmalige Zählung pro Beziehung.
Wie wählen Sie die Spalten und zusammengesetzten Schlüssel aus?
Verwenden Sie genau die Spalten, die der Join verwendet, auf beiden Seiten und in derselben Reihenfolge. Wird der übergeordnete Datensatz über zwei Spalten identifiziert, prüfen Sie sie gemeinsam als zusammengesetzten Schlüssel. Wenn Sie jede Spalte einzeln prüfen, rutschen Kombinationen durch, die es im übergeordneten Datensatz nirgends gibt.
Stationscodes sind ein gutes Beispiel. Hat jedes Krankenhaus eines Verbunds eine Station namens ICU-1, besteht eine Zeile mit Krankenhaus 2 und ICU-1 eine einspaltige Prüfung auf ward_code, solange Krankenhaus 1 diese Station hat. Nur das Paar (hospital_id, ward_code) erkennt den Fehler. digna prüft die Kombination, wenn Sie mehrere Spalten wählen, und weist Spaltenlisten unterschiedlicher Länge ab, statt eine schwächere Bedingung zu prüfen.
Zwei weitere Punkte sollten Sie vorab klären:
Verweisen Sie auf den Schlüssel des übergeordneten Datensatzes, nicht auf eine Bezeichnung. Prüfen Sie
product_codegegen denproduct_codedes Stamms, nicht gegen einen Produktnamen, den jemand bearbeiten könnte.Machen Sie beide Seiten vergleichbar. Ein Code, der auf einer Seite als Text mit führenden Nullen und auf der anderen als Zahl gespeichert ist, erzeugt verwaiste Datensätze, die gar keine sind. Normalisieren Sie ihn in einer View und prüfen Sie die View: In digna kann eine Datenquelle eine Tabelle, eine View oder eine eigene SQL-Anweisung sein.
Was sollte ein Fremdschlüssel mit NULL bedeuten?
Legen Sie vorab fest, ob ein Fremdschlüssel mit NULL zulässig ist. Eine Prüfung der referenziellen Integrität fragt, ob ein Wert im übergeordneten Datensatz existiert, und ein NULL hat keinen Wert, der nachgeschlagen werden könnte. Deshalb überspringt digna NULL-Werte bei dieser Prüfung. Ist die Referenz verpflichtend, ergänzen Sie eine separate Not-Null-Regel, damit ein fehlender Wert und ein ins Leere zeigender Wert als unterschiedliche Befunde erscheinen.
Manche Referenzen sind legitimerweise optional: ein zuweisender Arzt, ein Aktionscode, ein übergeordnetes Konto für einen Kunden auf oberster Ebene. Andere sind es nie: Jede Buchung hat ein Konto, jede verabreichte Dosis hat ein Produkt. Wenn Sie beides trennen, ist die Korrektur offensichtlich: Eine fehlende Referenz geht zurück an das erfassende System, eine ins Leere zeigende an die Stammdaten oder die Ladereihenfolge.
Was Sie erkennen möchten | digna-Regeltyp | Beispiel |
|---|---|---|
Wert vorhanden, aber nicht im übergeordneten Datensatz | Referential Integrity |
|
Wert fehlt, obwohl er verpflichtend ist | Rule |
|
Schlüssel kommt im übergeordneten Datensatz mehrfach vor | Uniqueness |
|
Auch die dritte Zeile ist wichtig: Ein doppelter Schlüssel im übergeordneten Datensatz erzeugt keine verwaisten Datensätze, verdoppelt aber jede Zeile, die darauf joint.
Welchen Schwellenwert sollte eine Prüfung der referenziellen Integrität verwenden?
Verwenden Sie Nulltoleranz für Finanz- und klinische Daten, bei denen ein verwaister Datensatz eine falsche Zahl in einem Abschluss oder eine fehlende Dosis in der Patientenakte bedeutet. Verwenden Sie einen relativen Schwellenwert für sehr große Tabellen, bei denen ein kleiner, bekannter Rest verspätet eintreffender Referenzen normal ist und nur ein Sprung über diesen Rest hinaus Aufmerksamkeit verdient.
digna gibt jeder Regel einen Threshold Mode (Schwellenwertmodus). Absolute vergleicht die Anzahl fehlgeschlagener Datensätze. Relative vergleicht die fehlgeschlagenen Datensätze geteilt durch die ausgewerteten Datensätze als Bruchteil, sodass 0.01 ein Prozent bedeutet. Jeder Modus hat zwei Stufen: Oberhalb des Info threshold lautet der Status Uncertain, oberhalb des Warn threshold Failed, andernfalls Passed. Beide stehen standardmäßig auf null, sodass eine neue Regel bereits bei einem einzigen fehlerhaften Datensatz fehlschlägt, bis Sie etwas anderes festlegen.
Situation | Threshold Mode | Info | Warn | Wirkung |
|---|---|---|---|---|
Buchungen zu Konten, Dosen zum Produktstamm | Absolute | 0 | 0 | Ein verwaister Datensatz lässt den Lauf fehlschlagen |
Dieselben Daten, ein einzelner Ausreißer soll vor dem Fehlschlag markiert werden | Absolute | 0 | 1 | Ein verwaister Datensatz ist Uncertain, zwei oder mehr sind Failed |
Ereignis- oder Verbindungsdatensätze mit bekannten, verspätet eintreffenden Dimensionen | Relative | 0.001 | 0.01 | Über 0,1 % Uncertain, über 1 % Failed |
Beginnen Sie streng und lockern Sie nur aus einem Grund, den Sie aufschreiben können.
Wann sollte eine Prüfung der referenziellen Integrität laufen?
Lassen Sie sie nach jedem Laden der untergeordneten Tabelle laufen und auch nach dem Laden der übergeordneten, denn verwaiste Datensätze entstehen immer dann, wenn beide in falscher Reihenfolge eintreffen. In digna läuft die Regel bei jeder Inspektion ihrer Datenquelle, geplant oder auf Abruf. Richten Sie die Inspektion daher am Ladevorgang aus, nicht am Berichtskalender.
Eine Prüfung zum Monatsende findet die verwaisten Datensätze eines ganzen Monats auf einmal, wenn der Bericht bereits fällig ist. Eine Prüfung nach jedem Ladevorgang findet die eines Tages, solange sich die Person, die geladen hat, noch erinnert, was sich geändert hat. Die Kosten sind ein Join pro Lauf, ausgeführt in der Quelldatenbank, ohne dass Daten herauskopiert werden. Schlägt die Prüfung fehl, benachrichtigen Sie das Team, das für die Daten verantwortlich ist.
Wie richten Sie eine Prüfung der referenziellen Integrität in digna ein?
In digna ist eine Prüfung der referenziellen Integrität eine Regel in digna Data Validation vom Typ Referential Integrity. Sie wählen die Spalten Ihrer Datenquelle, dann die Datenquelle und die Spalten, in denen sie existieren müssen, setzen zwei Schwellenwerte und speichern. Sie müssen kein SQL schreiben, und die Einrichtung dauert weniger als eine Minute.
Gehen Sie zu Configuration, wählen Sie die Datenquelle (hier
hospital_medication_administrations), öffnen Sie den Tab Data Validation und klicken Sie auf Add Rule. Der Dialog Add Data Validation Rule öffnet sich.Geben Sie einen Name und eine Description ein:
hc_product_in_master, „Jedes verabreichte Produkt existiert im Produktstamm der Apotheke“.Setzen Sie Type auf Referential Integrity. Die anderen Optionen sind Rule und Uniqueness.
Wählen Sie unter Attributes die Spalte dieser Datenquelle:
product_code.Wählen Sie unter must exist in die Data Source (
hospital_medications) und deren Attributes (product_code). Bei einem zusammengesetzten Schlüssel wählen Sie auf beiden Seiten mehrere Spalten in derselben Reihenfolge.Wählen Sie den Threshold Mode und setzen Sie Info threshold und Warn threshold. Das Beispiel verwendet Absolute, Info 0, Warn 1.
Speichern Sie. Die Regel läuft ab sofort bei jeder Inspektion der Datenquelle.

Die vollständige Regel: Typ, Attribute, die Datenquelle, in der sie existieren müssen, und zwei Schwellenwerte. Demodaten der Danubia Kliniken, eines fiktiven österreichischen Krankenhausverbunds.
Mit Info 0 und Warn 1 setzt bereits ein verwaister Datensatz den Status auf Uncertain, alles darüber auf Failed. Lassen Sie Warn auf 0, wenn schon ein einzelner verwaister Datensatz den Lauf fehlschlagen lassen soll. Der übergeordnete Datensatz muss auch nicht neben dem untergeordneten liegen: Seit Release 2026.01 kann die andere Seite eine Tabelle oder View in einem anderen Schema oder auf einer anderen Datenbankverbindung im selben Projekt sein; das behandelt der Beitrag zur referenziellen Integrität über Datenbanken hinweg. Das 2:26 Minuten lange Video Referenzielle Integrität in digna: in unter einer Minute eingerichtet zeigt dieselben Schritte.
Sobald Sie viele solcher Regeln haben, verwalten Sie sie als Code: Release 2026.06 hat ein Python SDK (pip install digna-sdk) sowie den Import und Export von Validierungsregeln zwischen Umgebungen eingeführt.
Wie sieht das entsprechende SQL aus?
Im Kern ist eine Prüfung der referenziellen Integrität ein Left Join von den untergeordneten Zeilen auf die eindeutigen Schlüssel des übergeordneten Datensatzes, der die Zeilen ohne Treffer zählt und NULL-Schlüssel ignoriert. digna erzeugt diese Abfrage und führt sie innerhalb Ihrer Datenbank aus. Von Hand für das obige Beispiel geschrieben, sieht die Logik so aus:
Dies veranschaulicht die Logik, es ist nicht die wörtliche Anweisung, die digna sendet. Bei einem zusammengesetzten Schlüssel erhält die Join-Bedingung eine Gleichheitsbedingung pro Spaltenpaar. Die Abfrage ist der einfache Teil. Die Arbeit liegt in allem drumherum: sie nach jedem Ladevorgang ausführen, mit einem Schwellenwert vergleichen, die Historie aufbewahren, die Zeilen an die richtigen Personen bringen. Die digna-Dokumentation beschreibt, wie jede Regelart zu SQL wird.
Wie lesen Sie eine fehlgeschlagene Prüfung der referenziellen Integrität?
Lesen Sie einen Fehlschlag in drei Schritten: Der Status sagt Ihnen, dass der Schwellenwert überschritten wurde, die Zahlen sagen Ihnen, wie groß die Lücke ist, und die fehlerhaften Datensätze sagen Ihnen, warum. Verwaiste Datensätze mit demselben Schlüssel deuten meist auf fehlende Stammdaten hin. Verwaiste Datensätze, die sich über viele Schlüssel verteilen, deuten meist auf einen fehlgeschlagenen Ladevorgang des übergeordneten Datensatzes oder auf ein abweichendes Schlüsselformat hin.
Zurück zum Beispiel der Danubia Kliniken. Am 2026-04-22 wurden auf den Stationen 82 Gaben eines neuen Produkts erfasst, bevor das Produkt im Produktstamm der Apotheke angelegt war. Die Regel hc_product_in_master schlug fehl: 4.244 von 4.326 Zeilen bestanden.
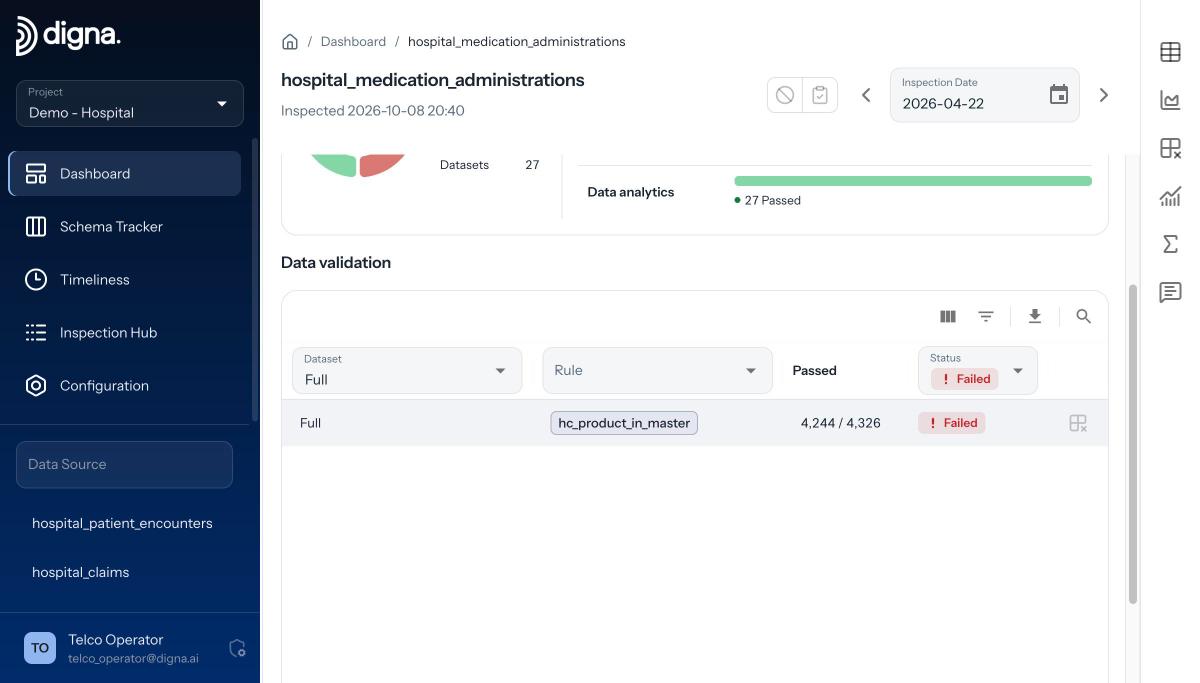
Das Ergebnis im Dashboard: 4.244 von 4.326 bestanden, Status Failed.
Um die Ursache zu sehen, öffnen Sie die Ansicht Invalid Records, filtern auf Failed, wählen die Prüfung, und digna listet jede fehlerhafte Zeile auf. Hier tragen alle 82 denselben product_code, 3858646 (Coavira 2.5 mg). Das sind nicht 82 Erfassungsfehler, sondern ein einziges Produkt, das im Stamm fehlt. Jeder Bericht, der Dosen mit Produkten verknüpfte, zeigte 0 Dosen davon, während das Pflegepersonal 82 verabreicht hatte.

Invalid Records: jede fehlerhafte Dosis mit Krankenhaus, Station, Produktcode und Medikamentenname.
Die häufigsten Muster:
Ein Schlüssel, viele Zeilen: Der übergeordnete Datensatz existiert noch nicht. Legen Sie ihn in den Stammdaten an und führen Sie die Inspektion erneut aus.
Viele Schlüssel, ein Ladevorgang: Der Ladevorgang des übergeordneten Datensatzes ist fehlgeschlagen oder lief verspätet. Korrigieren Sie die Ladereihenfolge.
Schlüssel, die fast richtig aussehen: Führende Nullen, Groß-/Kleinschreibung oder Leerzeichen unterscheiden sich zwischen Systemen. Normalisieren Sie in einer View.
Alte Schlüssel: Übergeordnete Datensätze wurden gelöscht oder archiviert, während untergeordnete noch auf sie verweisen.
Die fehlerhaften Zeilen lassen sich exportieren, sodass das verantwortliche Team die Datensätze erhält und nicht nur eine Zahl.
Wo sollten Sie anfangen?
Wählen Sie die eine Beziehung, deren verwaiste Datensätze am meisten schaden würden, wenn sie diesen Monat in einem Bericht landeten, und legen Sie nach dem nächsten Ladevorgang eine Prüfung darauf. Jede Prüfung besteht aus einer Handvoll Felder, läuft innerhalb Ihrer Datenbank, und Ihre Daten verlassen nie Ihre Infrastruktur. Wenn Sie sie auf Ihren eigenen Tabellen sehen möchten, buchen Sie eine Demo mit dem digna-Team.
Häufig gestellte Fragen
Wie prüfe ich die referenzielle Integrität mit SQL?
Verknüpfen Sie die untergeordnete Tabelle per Left Join mit den eindeutigen Schlüsselwerten der übergeordneten Tabelle und zählen Sie die Zeilen, bei denen die übergeordnete Seite NULL ist, wobei Sie Zeilen überspringen, deren eigener Fremdschlüssel NULL ist. Diese Zeilen sind verwaist. Selektieren Sie sie, statt sie zu zählen, um die zu korrigierenden Datensätze zu erhalten; Zeitplanung, Schwellenwerte und Historie bauen Sie selbst.
Schlägt eine Prüfung der referenziellen Integrität bei Fremdschlüsseln mit NULL fehl?
Nein. In digna überspringen Prüfungen der referenziellen Integrität NULL-Werte, weil es für NULL in der übergeordneten Tabelle nichts nachzuschlagen gibt. Ist die Referenz verpflichtend, ergänzen Sie eine separate Rule wie product_code IS NOT NULL, damit ein fehlender Wert und ein verwaister Wert als unterschiedliche Befunde erscheinen.
Kann eine Prüfung der referenziellen Integrität einen zusammengesetzten Schlüssel verwenden?
Ja. Wählen Sie mehrere Attribute in der Datenquelle und dieselbe Anzahl in der übergeordneten Datenquelle, in derselben Reihenfolge, und digna prüft die Kombination. Spaltenlisten unterschiedlicher Länge werden abgewiesen, denn der Vergleich eines zweispaltigen Schlüssels mit einer einzigen Spalte würde Zeilen durchlassen, die der vollständige Schlüssel erkennen würde.
Welchen Schwellenwert sollte eine Prüfung der referenziellen Integrität verwenden?
Für Finanz- und klinische Daten verwenden Sie den Modus Absolute mit Nulltoleranz, sodass ein einziger verwaister Datensatz den Lauf fehlschlagen lässt. Sehr große Tabellen mit einem bekannten Rest verspätet eintreffender Referenzen eignen sich stattdessen für einen Relative-Schwellenwert; in digna ist das ein Bruchteil, sodass 0.01 ein Prozent der ausgewerteten Zeilen bedeutet.
Wie lange dauert es, eine Prüfung der referenziellen Integrität in digna einzurichten?
Weniger als eine Minute. Öffnen Sie die Datenquelle unter Configuration, wechseln Sie zum Tab Data Validation, klicken Sie auf Add Rule, setzen Sie Type auf Referential Integrity, wählen Sie die Attribute und die Datenquelle, in der sie existieren müssen, setzen Sie zwei Schwellenwerte und speichern Sie. digna erzeugt das SQL und führt es innerhalb Ihrer Datenbank aus.



