Datenbankübergreifende referenzielle Integrität: So prüfen Sie sie
|
6
min. Lesezeit

Ihre Bestellungen liegen im Data Warehouse. Die Kunden, auf die sie verweisen, liegen im CRM, auf einem anderen Server, betreut von einem anderen Team. Datenbankübergreifende referenzielle Integrität bedeutet, dass jeder Schlüssel in einem System, etwa die Kundennummer einer Bestellung, einem existierenden Datensatz in der Stammdatentabelle eines anderen Systems entspricht. Ein Fremdschlüssel kann das nicht garantieren, denn ein deklarierter Fremdschlüssel wirkt in der Regel nur innerhalb einer Datenbank. Kommt also eine Bestellung mit einer Kundennummer an, die das CRM nie vergeben hat, schlägt nichts fehl. Die Zeile wird geladen, ein Join verwirft sie, und irgendwo ist ein Bericht unbemerkt falsch.
Das ist die schwierigste Variante der referenziellen Integrität. Innerhalb einer Datenbank können Sie den Constraint zumindest deklarieren; über eine Datenbank-, Server- oder Systemgrenze hinweg gibt es nichts zu deklarieren. Das allgemeine Konzept behandeln wir in unserem Grundlagenartikel Finden Ihre Daten noch ihre Eltern? Referenzielle Integrität verstehen. Dieser Beitrag behandelt referenzielle Integrität zwischen Systemen: wo sie bricht, was die üblichen Workarounds kosten, warum Schlüsselformate Fehlalarme erzeugen und wie Sie sie in digna prüfen, ohne Stammdaten irgendwohin zu kopieren.
Das Wichtigste in Kürze
Ein Fremdschlüssel über Datenbanken hinweg ist in der Regel nicht möglich: Ein deklarierter Constraint referenziert Tabellen in derselben Datenbank, systemübergreifende Referenzen sind also konstruktionsbedingt ungeschützt.
Die üblichen Workarounds (föderierte Abfragen, kopierte Referenztabellen, Lookups im ETL, Abgleichsexporte) bringen zusätzliche Datenbewegung, Pipelines oder manuelle Arbeit mit sich.
Unterschiede im Schlüsselformat wie führende Nullen, Groß-/Kleinschreibung, Auffüllung und Datentypen erzeugen falsche verwaiste Datensätze. Einigen Sie sich vor dem Vergleich auf eine kanonische Schlüsselform.
Seit Release 2026.01 prüft digna Data Validation die referenzielle Integrität über Tabellen, Views, Schemas und verschiedene Datenbankverbindungen im selben Projekt hinweg und validiert die Daten dort, wo sie liegen.
Die Einrichtung umfasst nur wenige Felder: Schlüsselspalten, die Datenquelle, in der sie existieren müssen, zwei Schwellenwerte. Kein SQL zu schreiben.
Inhaltsverzeichnis
Warum kann ein Fremdschlüssel keine Referenz über Datenbanken hinweg schützen?
Wo brechen Referenzen zwischen Systemen?
Kundenstamm im CRM, Transaktionen im Data Warehouse
Produktstamm im ERP, Bestellungen im Bestellsystem
Patientenstamm und klinische Fälle
Core Banking und das Reporting-Data-Warehouse
Wie validieren Teams Referenzen zwischen Systemen üblicherweise?
Warum erzeugen abweichende Schlüsselformate falsche verwaiste Datensätze?
Wie prüfen Sie datenbankübergreifende referenzielle Integrität in digna?
Welche systemübergreifenden Referenzen sollten Sie zuerst prüfen?
Nächster Schritt
Warum kann ein Fremdschlüssel keine Referenz über Datenbanken hinweg schützen?
Ein Fremdschlüssel kann keine datenbankübergreifende Referenz schützen, weil er ein Constraint ist, den die Engine auf ihren eigenen Tabellen durchsetzt: Bei jedem Insert, Update und Delete sucht sie die referenzierte Zeile in derselben Datenbank. Ein deklarierter Fremdschlüssel kann in der Regel nicht auf eine Tabelle in einer anderen Datenbank, auf einem anderen Server oder in einem anderen Produkt zeigen, es gibt also nichts, wogegen geprüft werden könnte.
Manche Engines erlauben Abfragen über Datenbanken hinweg, aber Abfragen ist nicht Erzwingen. Ein durchgesetzter Constraint über Systeme hinweg würde voraussetzen, dass das entfernte System bei jedem Schreibvorgang verfügbar und konsistent ist – und getrennte Systeme gibt es gerade deshalb, damit eines weiterläuft, während das andere ausfällt, migriert oder neu geladen wird.
Auf der Seite des Data Warehouse wird es noch schlimmer. Viele Analyseplattformen akzeptieren Fremdschlüsseldeklarationen, ohne sie durchzusetzen, selbst innerhalb einer Datenbank: Snowflake beschreibt sie auf Standardtabellen als optional und nicht durchgesetzt, und BigQuery gibt an, dass es sie nicht durchsetzt. Zudem ändern sich die Systeme unabhängig voneinander: Das CRM-Team führt doppelte Kunden zusammen, das ERP nimmt ein Produkt aus dem Sortiment. Jede Änderung ist in ihrem eigenen System gültig und kann trotzdem dazu führen, dass Datensätze anderswo auf Schlüssel zeigen, die es nicht mehr gibt.
Wo brechen Referenzen zwischen Systemen?
Referenzen zwischen Systemen brechen überall dort, wo ein System die Stammdaten besitzt und ein anderes die Aktivität erfasst: eine Transaktionstabelle, die auf einen Kunden, ein Produkt, einen Patienten oder ein Konto verweist, das anderswo gepflegt wird – von einem anderen Team, in einem eigenen Release-Zyklus und mit eigenen Regeln für das Zusammenführen und Stilllegen von Schlüsseln. Vier Situationen tauchen immer wieder auf.
Kundenstamm im CRM, Transaktionen im Data Warehouse
Der Vertriebsinnendienst pflegt die Kunden im CRM; Bestellungen werden jede Nacht ins Data Warehouse geladen. Werden zwei CRM-Datensätze zusammengeführt, verschwindet eine ID. Die Bestellungen im Data Warehouse tragen sie weiterhin, und beim Umsatz pro Kunde, Segment oder Region fallen unbemerkt Zeilen weg.
Produktstamm im ERP, Bestellungen im Bestellsystem
Ein neues Produkt geht in den Verkauf, bevor der Stammsatz im ERP freigegeben ist, oder ein ausgelaufenes Produkt wird entfernt, während offene Bestellungen noch darauf verweisen. Bestellpositionen ohne passendes Produkt verschwinden aus Margen- und Bestandsberichten.
Patientenstamm und klinische Fälle
Krankenhäuser führen die Patientenidentität in einem Patientenstamm, oft einem Master Patient Index, und erfassen Aufnahmen, Laboraufträge und Medikation in klinischen Systemen. Werden doppelte Patienten zusammengeführt, verlieren Fälle, die noch auf die stillgelegte ID verweisen, ihren Patienten – mit Folgen für Abrechnung und klinisches Reporting.
Core Banking und das Reporting-Data-Warehouse
Konten und Kunden liegen im Core-Banking-System. Das Management- und Meldewesen läuft auf einem separaten Data Warehouse, das aus mehreren Quellsystemen gespeist wird. Eine Buchung, die auf ein Konto verweist, das in der Kontodimension des Reportings fehlt, fällt entweder aus den Summen heraus oder landet in einem „Unbekannt“-Topf. Diesen Fall vertiefen wir im Beitrag über referenzielle Integrität in Bankdaten.
Wie validieren Teams Referenzen zwischen Systemen üblicherweise?
Teams validieren Referenzen zwischen Systemen üblicherweise auf eine von vier Arten: Sie fragen die entfernte Tabelle über einen Linked Server, einen Database Link oder eine föderierte Abfrage ab; sie kopieren die Referenztabelle ins Zielsystem; sie schlagen Schlüssel im ETL nach; oder sie exportieren die Schlüssel beider Seiten und gleichen sie regelmäßig ab. Alles funktioniert, und alles hat seinen Preis.
Die eigentliche Prüfung ist immer derselbe Anti-Join. Wären beide Tabellen von einer Engine aus erreichbar, sähe er so aus:
Die Workarounds unterscheiden sich darin, wie sie crm.customers von dem System aus erreichbar machen, in dem sales_orders liegt:
Ansatz | Funktionsweise | Was es kostet |
|---|---|---|
Linked Server, Database Links, föderierte Abfragen | Eine Engine fragt die entfernte Tabelle direkt ab und führt den Join aus | Beide Systeme müssen zur Abfragezeit verfügbar sein; große Joins über das Netzwerk sind langsam und belasten die Quelle; Zugangsdaten für das entfernte System werden in der Datenbank gespeichert; zwischen Netzwerkzonen oft blockiert |
Referenztabelle ins Data Warehouse kopieren | Eine Pipeline repliziert die Stammdatentabelle neben die Transaktionen | Eine zusätzliche Pipeline, die gebaut und betrieben werden muss; die Prüfung ist nur so aktuell wie die letzte Kopie; eine weitere Kopie von Stammdaten, oft personenbezogenen Daten, wirft Fragen zu Datenschutz und Datenresidenz auf |
Lookups im ETL | Der Ladejob schlägt jeden Schlüssel nach und weist nicht zugeordnete Zeilen zurück oder markiert sie | Deckt nur Daten ab, die durch diese Pipeline fließen; prüft nur einmal beim Laden, spätere Löschungen und Zusammenführungen im Stamm bleiben unbemerkt; Reject-Tabellen wachsen, ohne dass jemand sie liest |
Regelmäßige Abgleichsexporte | Schlüssellisten aus beiden Systemen werden in Dateien exportiert und verglichen | Manuell und selten; Ergebnisse kommen Wochen nach dem Fehler; Schlüsseldateien kursieren per E-Mail oder auf Netzlaufwerken |
Keiner dieser Ansätze ist falsch, aber sie haben ein gemeinsames Problem: Entweder werden Daten bewegt, oder jemand muss daran denken, etwas auszuführen. Was Sie eigentlich wollen, ist eine geplante Prüfung, die jede Seite dort liest, wo sie liegt, und dem zuständigen Team mitteilt, welche Datensätze verwaist sind.
Warum erzeugen abweichende Schlüsselformate falsche verwaiste Datensätze?
Abweichende Schlüsselformate erzeugen falsche verwaiste Datensätze, weil zwei Systeme denselben fachlichen Schlüssel in unterschiedlicher Form speichern können: im einen als Text, im anderen als Zahl, mit oder ohne führende Nullen, in anderer Groß-/Kleinschreibung oder mit nachgestellten Leerzeichen. Ein byteweiser Vergleich meldet dann einen fehlenden Eltern-Datensatz, der in Wahrheit existiert.
Das ist der häufigste Grund, warum eine erste systemübergreifende Prüfung Tausende von Fehlern meldet:
Abweichung | System A | System B |
|---|---|---|
Führende Nullen |
|
|
Groß-/Kleinschreibung |
|
|
Auffüllung und Leerzeichen |
|
|
Typumwandlungen |
|
|
Systempräfixe |
|
|
So beheben Sie das in drei Schritten:
Einigen Sie sich auf eine kanonische Form des Schlüssels, zum Beispiel einen getrimmten String in Großbuchstaben, aufgefüllt auf zehn Stellen.
Normalisieren Sie eine oder beide Seiten in einer View oder einem SQL-Statement auf diese Form, möglichst nah an der Quelle.
Prüfen Sie, ob der normalisierte Stammschlüssel noch eindeutig ist. Das Entfernen von Nullen oder das Angleichen der Schreibweise kann zwei verschiedene Schlüssel zu einem zusammenfallen lassen, und das würde echte verwaiste Datensätze verdecken.
Eine normalisierende Abfrage sieht so aus (die Funktionsnamen unterscheiden sich je nach Datenbank leicht):
Normalisieren Sie keine echten Unterschiede weg. Wenn ein Präfix angibt, welches Quellsystem den Schlüssel vergeben hat, ist ein zusammengesetzter Schlüssel aus Quellsystem und Nummer sicherer, als das Präfix zu entfernen.
Wie prüfen Sie datenbankübergreifende referenzielle Integrität in digna?
In digna ist eine datenbankübergreifende Prüfung der referenziellen Integrität eine Data-Validation-Regel vom Typ Referential Integrity, deren „must exist in“-Seite auf eine Datenquelle auf einer anderen Datenbankverbindung im selben Projekt zeigt. Seit Release 2026.01 validiert sie die Daten dort, wo sie liegen, ohne eine der beiden Tabellen in das jeweils andere System zu replizieren.
Zwei Änderungen im Release 2026.01 machen das möglich. Prüfungen der referenziellen Integrität laufen über Tabellen und Views, über Schemas und über verschiedene Datenbankverbindungen innerhalb eines Projekts hinweg. Und eine Datenquelle ist eine logische Schicht, hinter der eine Tabelle, eine View oder ein eigenes SQL-Statement steht. Damit haben Sie einen Ort, an dem Sie Schlüsselformate behandeln können: Eine Datenquelle mit eigenem SQL kann den Schlüssel vor dem Vergleich trimmen, umwandeln oder auffüllen, ganz ähnlich wie die Abfrage oben. Testen Sie diese Normalisierung an echten Daten, bevor Sie sich darauf verlassen. Datenbankverbindungen sind global, eine einmal eingerichtete CRM-Verbindung kann also von jedem Projekt wiederverwendet werden.
Die Regel selbst richten Sie in einem einzigen Dialog ein:
Gehen Sie zu Configuration, wählen Sie die Datenquelle mit den referenzierenden Zeilen, öffnen Sie den Tab Data Validation und klicken Sie auf Add Rule. Der Dialog Add Data Validation Rule öffnet sich.
Geben Sie unter Name einen Namen und unter Description eine Beschreibung ein, die aussagt, was gelten muss, zum Beispiel „Jede Bestellung verweist auf einen Kunden im CRM-Stamm“.
Setzen Sie Type auf Referential Integrity.
Wählen Sie unter Attributes die Schlüsselspalte oder -spalten dieser Datenquelle.
Wählen Sie unter must exist in die Ziel-Data Source, die auch auf einer anderen Verbindung liegen kann, und deren passende Attributes. Bei einem zusammengesetzten Schlüssel wählen Sie die Spalten auf beiden Seiten in derselben Reihenfolge.
Wählen Sie einen Threshold Mode (Schwellenwertmodus: Absolute oder Relative) und setzen Sie Info threshold und Warn threshold.
Speichern. Die Regel läuft bei jeder Inspektion der Datenquelle mit, ob geplant oder auf Abruf.

Die Regel für referenzielle Integrität in digna: product_code muss in der Datenquelle hospital_medications existieren.
Die Screenshots stammen aus unserem Demoprojekt, in dem beide Datenquellen auf derselben Verbindung liegen. Der Dialog ist derselbe, wenn die Ziel-Datenquelle auf einer anderen Verbindung liegt: Sie wählen sie unter „must exist in“ wie jede andere Datenquelle. Die Demo verwendet fiktive Daten der Danubia Kliniken, einer erfundenen österreichischen Krankenhausgruppe.
Die Regel hc_product_in_master besagt, dass jedes verabreichte Produkt im Produktstamm der Apotheke existieren muss. Am 2026-04-22 erfassten die Stationen 82 Verabreichungen von „Coavira 2.5 mg“ (Produktcode 3858646), bevor das Produkt in den Stamm aufgenommen worden war. Jeder Bericht, der Dosen mit Produkten verknüpfte, zeigte null Dosen des neuen Produkts, während das Pflegepersonal 82 verabreicht hatte.
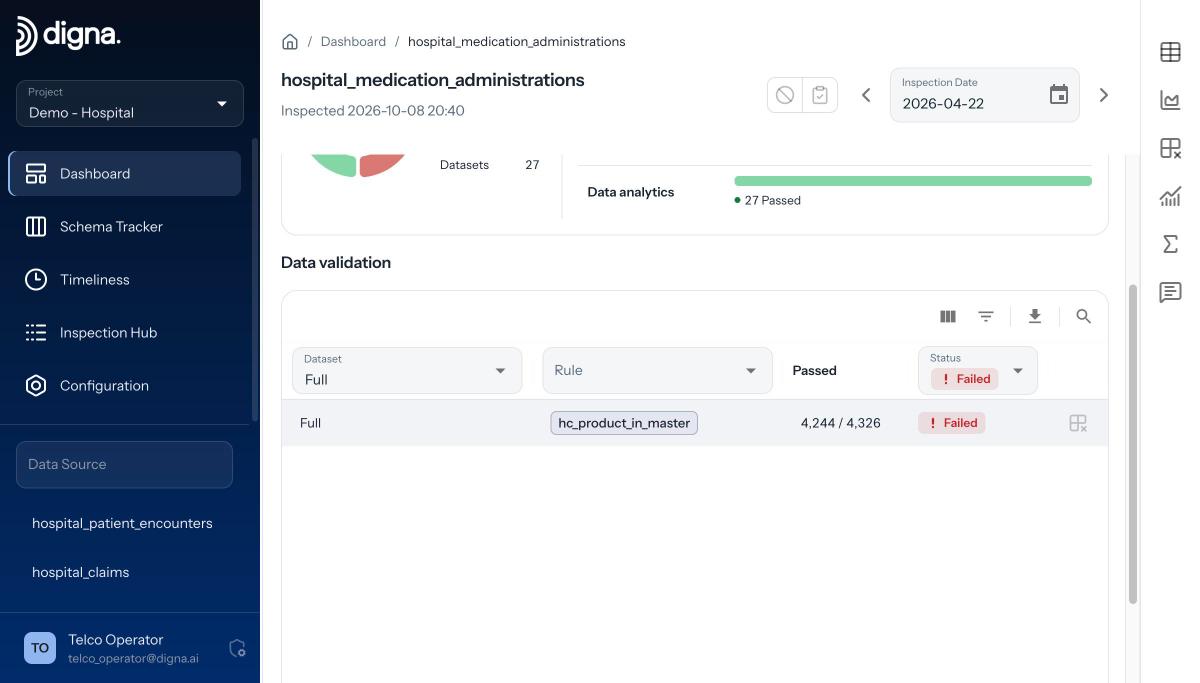
Das Ergebnis am 2026-04-22: 4.244 von 4.326 Zeilen bestanden, 82 fehlgeschlagen, Status Failed.
digna meldet pro Regel die Anzahl bestandener und fehlgeschlagener Datensätze und liefert die fehlgeschlagenen Datensätze selbst: dieselbe Abfrage mit negierter Bestehensbedingung. In der Ansicht Invalid Records filtern Sie nach Passed, Uncertain oder Failed, wählen die Prüfung und sehen die Zeilen, hier mit Krankenhaus, Station, Produktcode und Medikamentenname. Sie können sie exportieren und das Team benachrichtigen, dem die Daten gehören.
Für systemübergreifende Prüfungen sind einige Verhaltensweisen wichtig:
Schwellenwerte stehen standardmäßig auf null, eine neue Regel schlägt also schon bei einem einzigen verwaisten Datensatz fehl. Wenn bekannt ist, dass der Stamm den Transaktionen einige Stunden hinterherhinkt, erhöhen Sie den Info threshold, damit eine kleine Anzahl als Uncertain statt Failed erscheint, oder nutzen Sie den Modus Relative.
NULL-Schlüssel werden übersprungen. Eine fehlende Kundennummer lässt die Referenzprüfung nicht fehlschlagen. Ist der Schlüssel ein Pflichtfeld, ergänzen Sie eine separate Regel vom Typ Rule, etwa
customer_no IS NOT NULL.Die Spaltenlisten müssen gleich lang sein. Eine Abweichung wird zurückgewiesen, statt stillschweigend eine schwächere Bedingung zu prüfen.
Die Prüfungen laufen in den Quelldatenbanken. digna sendet SQL und erhält Zählwerte, auf Wunsch auch die fehlgeschlagenen Zeilen. Ihre Daten verlassen nie Ihre Infrastruktur.
Die vollständige Anleitung mit allen Feldern finden Sie unter So richten Sie eine Prüfung der referenziellen Integrität ein. Die Regeltypen, Schwellenwerte und Ergebnisansichten sind auf der Seite digna Data Validation und in der Dokumentation beschrieben.
Welche systemübergreifenden Referenzen sollten Sie zuerst prüfen?
Prüfen Sie zuerst die systemübergreifenden Referenzen, die Berichte speisen, auf deren Basis Menschen handeln, und die, deren Stammdaten regelmäßig zusammengeführt, umnummeriert oder stillgelegt werden – denn dort wird ein verwaister Datensatz direkt zu einer falschen Zahl. Beginnen Sie mit wenigen Regeln und erweitern Sie den Umfang, sobald die falschen verwaisten Datensätze durch Schlüsselformate ausgeräumt sind.
Eine praxistaugliche Reihenfolge für die systemübergreifende Validierung von Stammdaten:
Transaktionen gegen den Kunden-, Konto- oder Patientenstamm, denn dort finden ständig Zusammenführungen und Schließungen statt.
Bestellpositionen und Lagerbewegungen gegen den Produktstamm, denn neue Produkte werden oft verkauft, bevor der Stammsatz vollständig ist.
Referenzcodes (Land, Währung, Kostenstelle) gegen das System, dem die Codeliste gehört.
Kombinieren Sie jede Referenzregel mit einer Uniqueness-Regel auf dem Stammschlüssel: Eine Referenzprüfung gegen einen Stamm mit doppelten Schlüsseln kann bestehen, obwohl die Daten trotzdem falsch sind.
Nächster Schritt
Fremdschlüssel enden an der Datenbankgrenze, und ein Großteil der wichtigen Daten überschreitet sie. Um Referenzen zwischen Systemen zu validieren, brauchen Sie keine weitere Pipeline: Eine Referential-Integrity-Regel pro Beziehung, die dort läuft, wo die Daten liegen, zeigt nach jeder Inspektion, welche Datensätze ihren Eltern-Datensatz verloren haben. Wenn Sie das in Ihrer eigenen Systemlandschaft sehen möchten, buchen Sie eine Demo mit dem digna-Team.
Häufig gestellte Fragen
Kann man einen Fremdschlüssel über Datenbanken hinweg anlegen?
In der Regel nicht. Ein deklarierter Fremdschlüssel referenziert eine Tabelle in derselben Datenbank, weil die Engine ihn bei jedem Insert, Update und Delete prüft. Über Datenbanken, Server oder Produkte hinweg gibt es nichts zu deklarieren, deshalb müssen systemübergreifende Referenzen durch eine geplante Prüfung validiert werden, etwa einen Anti-Join oder eine Regel für referenzielle Integrität.
Wie prüft man referenzielle Integrität zwischen zwei verschiedenen Datenbanken?
Führen Sie einen Anti-Join aus, der die Schlüssel der referenzierenden Tabelle liefert, zu denen es in der Stammdatentabelle keine Entsprechung gibt. Teams machen beide Tabellen meist über föderierte Abfragen, kopierte Referenztabellen, Lookups im ETL oder Abgleichsexporte erreichbar. In digna kann eine Referential-Integrity-Regel auf eine Datenquelle auf einer anderen Verbindung zeigen, ohne Daten zu replizieren.
Warum meldet eine systemübergreifende Prüfung verwaiste Datensätze, die tatsächlich existieren?
Meist unterscheiden sich die Schlüsselformate. Ein System speichert '0004711' als Text, das andere 4711 als Integer, und Groß-/Kleinschreibung, nachgestellte Leerzeichen oder Systempräfixe erzeugen dieselben falschen verwaisten Datensätze. Einigen Sie sich auf eine kanonische Form, normalisieren Sie den Schlüssel in einer View oder einem SQL-Statement und stellen Sie sicher, dass der normalisierte Stammschlüssel weiterhin eindeutig ist.
Kopiert digna die Stammdatentabelle, um Schlüssel über Verbindungen hinweg zu vergleichen?
Nein. Seit Release 2026.01 prüft digna die referenzielle Integrität über Tabellen, Views, Schemas und Datenbankverbindungen in einem Projekt hinweg, ohne Daten zu replizieren. Die Prüfungen laufen in Ihren Datenbanken: digna sendet SQL und erhält Zählwerte, auf Wunsch auch die fehlgeschlagenen Zeilen. Ihre Daten verlassen nie Ihre Infrastruktur.
Lassen NULL-Fremdschlüssel eine Prüfung der referenziellen Integrität in digna fehlschlagen?
Nein. Referential-Integrity-Regeln überspringen NULL-Werte, eine Zeile mit leerer Kundennummer zählt also nicht als verwaist. Ist der Schlüssel ein Pflichtfeld, ergänzen Sie eine separate Regel vom Typ Rule mit einer Bedingung wie customer_no IS NOT NULL, damit fehlende und nicht zugeordnete Schlüssel als zwei getrennte Probleme gemeldet werden.



