Parquet-Dateiformate: Struktur, Tuning und Best Practices
|
12
min. Lesezeit

Ihr BI-Dashboard ist wieder langsam. Der nächtliche Job hat einen weiteren Haufen CSV-Dateien im Object Storage abgelegt, jemand hat ohne Vorwarnung ein paar Spalten ergänzt, und die eine Abfrage, die das Geschäft interessiert, kaut sich nun durch weit mehr Daten, als das Ergebnis rechtfertigt.
Das ist meist der Moment, in dem Parquet-Dateiformate aufhören, sich wie die Wahl einer Dateiendung anzufühlen, und anfangen, wie eine Architekturentscheidung zu wirken. Wenn Ihr Team Spark, DuckDB, Trino, BigQuery, dbt-Modelle oder Lakehouse-Pipelines betreibt, sitzt Parquet mitten in Ihrer Geschichte über Verlässlichkeit und Kosten. Das Knifflige ist, dass die meisten Erklärungen bei „Parquet ist spaltenorientiert“ aufhören, was zwar stimmt, aber unvollständig ist.
In der Praxis kommt es darauf an, wie Parquet Daten auf der Platte anordnet, welche Encodings helfen, welche Schemaänderungen sicher sind und was sich am Format selbst noch verändert. 2026 ist Parquet nicht eingefroren. Neue logische Typen und Encodings kommen weiterhin hinzu, und die Unterstützung landet ungleichmäßig in den Engines. Genau dort geraten Produktionsteams in die Falle.
Inhaltsverzeichnis
Warum es Parquet-Dateiformate für moderne Analytics gibt
CSV ist einfach zu erzeugen und im großen Maßstab mühsam auszuwerten. Braucht eine Dashboard-Abfrage nur price, region und event_date, muss ein CSV-Reader dennoch jedes Feld jeder Zeile parsen, um überhaupt zu diesen Spalten zu gelangen. Das Format weiß nicht, wo die Werte einer Spalte als zusammenhängender Block liegen, und es trägt nicht genug Metadaten, um irrelevante Abschnitte sauber zu überspringen.
Parquet behebt das, indem es Daten spaltenweise statt zeilenweise speichert. Zusätzlich hinterlegt es Metadaten, die Readern unnötige Arbeit ersparen. Moderne Darstellungen des Formats halten fest, dass diese Entwurfsentscheidungen Parquet-Dateien in Analytics-Workloads üblicherweise 5- bis 10-mal kleiner als CSV und 10- bis 100-mal schneller abfragbar machen; ein Benchmark-Beispiel zeigt eine Parquet-Zstd-Datei mit 164 MB gegenüber 1,09 GB für CSV bei einem Datensatz mit 11,2 Millionen Zeilen, und manche Count-Abfragen laufen rund 160-mal schneller, wenn allein die Metadaten sie beantworten können (Erläuterung des Parquet-Formats von MotherDuck).
Warum das spaltenorientierte Layout alles verändert
Wenn Werte derselben Spalte beieinanderliegen, können Engines drei nützliche Dinge tun:
Weniger Bytes lesen: Eine Abfrage, die drei Spalten braucht, muss die übrigen Spalten nicht über das Netz und durch den Parser schleifen.
Besser komprimieren: Ähnliche Werte gruppieren sich innerhalb einer Spalte, sodass Encodings wie Dictionary, Run-Length und Delta wirksam werden.
Ganze Abschnitte überspringen: Parquet speichert Min-, Max- und Null-Count-Metadaten im Footer, sodass Reader Row Groups vor dem Dekodieren ausschließen können.
Deshalb wurde Parquet zum Standardformat für analytische Speicherung und nicht für Transaktionsverarbeitung. Es ist auf Scans, Aggregationen, Filterung und Projektion optimiert.
Praxisregel: Wenn Menschen überwiegend Teilmengen von Spalten abfragen und große Datensätze scannen, arbeiten zeilenorientierte Textformate gegen den Workload.
Was Engineers weiterhin entscheiden müssen
Parquet nimmt Ihnen Entwurfsentscheidungen nicht ab. Es verschiebt sie.
Ein Produktionsteam muss weiterhin Fragen zu Row-Group-Größe, Codec-Standards, Page-Layout, Versionsunterstützung und Schemaevolution beantworten. Das sind keine Randfälle. Sie wirken unmittelbar auf Scankosten, Interoperabilität und darauf, ob nachgelagerte Reader eine Pipeline-Änderung überstehen.
Wenn Sie Lakehouse-Speicher entwerfen oder Extraktformate für Ihr Warehouse überdenken, hören Entscheidungen zur Datensystemarchitektur genau hier auf, abstrakt zu sein. Das Verhalten des Dateiformats prägt Abfragelatenz, Speichereffizienz und operative Fehlerbilder.
Die Entstehungsgeschichte und warum sie weiterhin zählt
Viel Produktionsschmerz rund um Parquet beginnt mit einer falschen Annahme: dass es nur eine neutrale Dateiendung sei, die jede Engine gleich behandelt. Das ist es nicht. Parquet entstand aus einem konkreten Analytics-Problem, und jene ursprünglichen Entwurfsentscheidungen erklären bis heute sowohl seine Stärken als auch seine Fehlerbilder.
Parquet begann 2013 als gemeinsame Anstrengung von Twitter und Cloudera. Das 1.0-Release wurde am 30. Juli 2013 angekündigt, nachdem das Projekt bereits über 90 gemergte Pull Requests gesehen hatte, was zeigt, wie schnell das Format in seinen ersten Monaten Gestalt annahm (Ankündigung von Parquet 1.0 durch das Twitter-Engineering).

Damals kämpften Teams der Hadoop-Ära mit breiten Datensätzen, langen Scanzeiten und Speicherkosten, die schneller wuchsen als die Budgets. Parquet wurde für dieses Umfeld gebaut. Werte spaltenweise speichern, ähnliche Werte zusammen komprimieren und Query-Engines genug Metadaten geben, um Arbeit zu sparen. Das klingt heute gewöhnlich, weil jedes Lakehouse-Team es erwartet. 2013 löste es einen sehr teuren Engpass.
Das Projekt wurde später am 27. April 2015 zum Top-Level-Projekt der Apache Software Foundation. Das zählt, weil Dateiformate mit der Reader-Unterstützung stehen und fallen. Sobald mehrere Engines, Warehouses und Tabellenformate auf Parquet setzten, wurde Kompatibilität ebenso wichtig wie das reine Kompressionsverhältnis.
Die frühen Wetten zeigen sich noch 2026
Zwei Entwurfsentscheidungen von Anfang an prägen bis heute reale Pipelines.
Erstens optimierte Parquet auf analytische Scans, nicht auf Punktabfragen. Eine Parquet-Datei arbeitet wie ein Lager, das nach Produktart statt nach Kundenauftrag geordnet ist. Wenn Sie jeden Wert einer Spalte über 500 Millionen Zeilen brauchen, ist dieses Layout effizient. Brauchen Sie eine bestimmte Zeile aus der Mitte, ist es schwerfällig. Teams geraten weiterhin in Schwierigkeiten, wenn sie Parquet für Event-Replays, operative APIs oder Workloads nutzen, die schnellen Einzelsatzzugriff benötigen.
Zweitens machte Parquet Dateien selbstbeschreibend. Schema und Row-Group-Metadaten liegen im Footer, sodass Reader die Struktur entdecken können, ohne von einem separaten Schema-Dienst abzuhängen. Diese Portabilität ist ein wichtiger Grund, warum sich Parquet über Spark, Hive, Trino, DuckDB, externe Snowflake-Tabellen und Lakehouse-Stacks verbreitet hat.
Sie schafft aber auch eine scharfe Kante. Ist der Footer beschädigt, kann die Datei unlesbar sein, selbst wenn die Data Pages unversehrt im Object Storage liegen. Das Format macht das explizit. Dateien enden mit der Magic Number PAR1, und die Länge der Metadaten steht als 4-Byte-Little-Endian-Ganzzahl im Footer, was Readern sagt, wo Schema- und Row-Group-Metadaten beginnen (Dokumentation zum Apache-Parquet-Dateiformat).
Dieses Detail klingt hardwarenah, zählt aber im Betrieb. Ein abgebrochener Upload, ein fehlgeschlagener Multipart-Write oder ein fehlerhafter Rewrite-Job kann aus einem kaputten Footer eine unlesbare Datei machen. In einem partitionierten Datensatz zeigt sich das oft als fehlender Tag, gebrochener Backfill oder als Abfrage, die nur für ein Kundensegment scheitert. Für Teams, die an Datenqualität und Verlässlichkeit im Lakehouse arbeiten, ist das einer der Gründe, warum Dateivalidierung in die Pipeline gehört und nicht ins Postmortem.
Die Entstehungsgeschichte erklärt auch, was Parquet standardmäßig weiterhin nicht löst. Der ursprüngliche Gewinn lag sichtbar bei wiederholten Werten, Dimensionen mit niedriger Kardinalität und scanlastiger Analytik. 2026 bekommen schwierigere Fälle mehr Aufmerksamkeit: Stringspalten mit hoher Kardinalität wie URLs oder Nutzer-IDs, Gleitkommagrößen, die sich nicht sauber komprimieren, und Schemaänderungen, die technisch valide sind und trotzdem nachgelagerte Reader brechen. Das sind keine Zeichen dafür, dass Parquet versagt hätte. Es sind Erinnerungen daran, dass das Format als Fundament entworfen wurde und nicht als Garantie, dass jeder Datensatz allein aus Standardeinstellungen gute Größe, Geschwindigkeit und Kompatibilität erhält.
In einer Parquet-Datei: von Row Groups bis Pages
Eine Produktionsabfrage ist für eine Partition langsam und für die übrigen 364 Tage der Tabelle schnell. Der übliche Grund ist nicht „Parquet ist langsam“. Es ist, dass die Datei so angelegt wurde, dass die Engine weit mehr Bytes lesen musste, als die Abfrage brauchte.
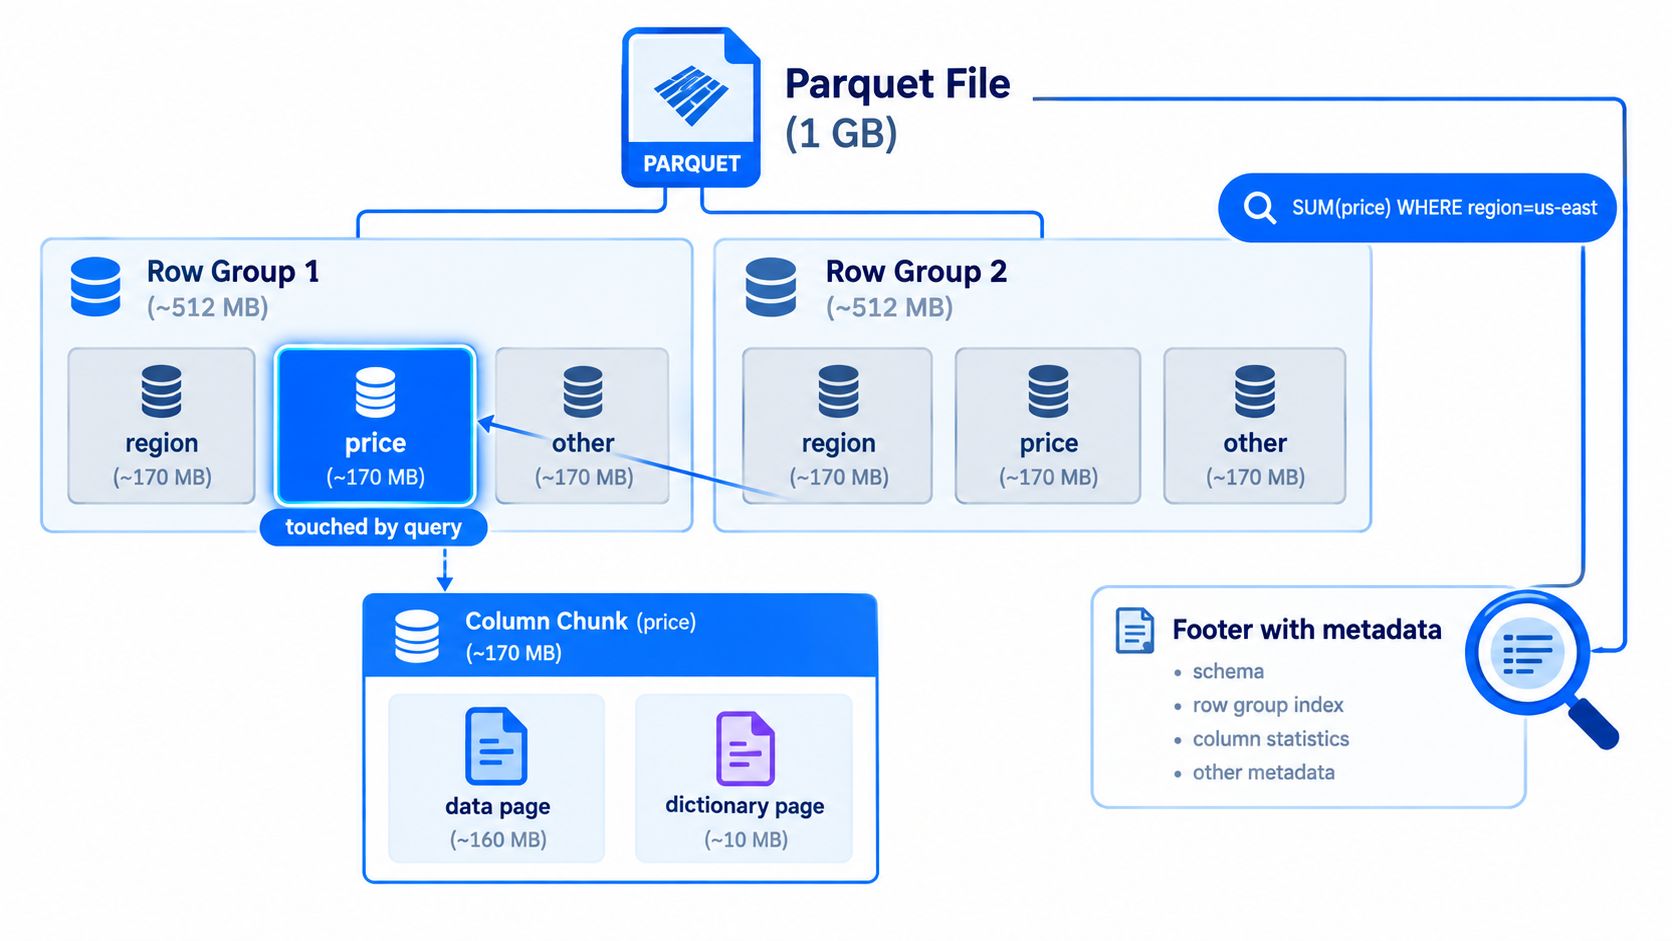
Parquet erschließt sich am besten, wenn Sie sich sein Speicherlayout als verschachtelte Behälter vorstellen. Eine Datei enthält Row Groups. Jede Row Group enthält je Spalte einen Column Chunk. Jeder Column Chunk zerfällt in Pages. Diese Hierarchie erlaubt Engines, price zu lesen, ohne comment_text anzufassen, oder Datenblöcke zu überspringen, die einem Filter nicht entsprechen können. Die Parquet-Page-Index-Dokumentation beschreibt die Struktur und die optionalen feineren Metadaten für das Überspringen von Pages (Dokumentation zum Parquet Page Index).
Auf Row-Group-Ebene beginnen
Wer aus einer Row-Store-Denkweise kommt, dem hilft die Row Group, das Modell neu zu rahmen. Sie ist eine horizontale Scheibe der Tabelle, innerhalb dieser Scheibe aber spaltenweise gespeichert.
Nehmen wir an, eine Datei enthält Spalten wie region, price und event_date. Eine Row Group enthält dann drei Column Chunks: einen für region, einen für price und einen für event_date. Die Werte liegen nicht Zeile für Zeile, sondern als drei getrennte Datenläufe innerhalb dieser Row Group. Deshalb kann eine Abfrage, die nur price braucht, das Lesen der Bytes der beiden anderen Spalten vermeiden.
Für scanlastige Analytik sind Row Groups die erste nützliche Einheit für Parallelisierung und Überspringen. Hier beginnen auch viele operative Abwägungen. Eine zu kleine Row Group erzeugt überschüssige Metadaten und zu viele winzige Lesevorgänge. Eine zu große Row Group kann selektive Abfragen mehr Daten lesen lassen als nötig und macht Retries und Rewrites im Object Storage teurer.
Dann auf die Pages zoomen
Pages sind die kleineren Blöcke innerhalb jedes Column Chunk. Encoding und Komprimierung geschehen auf dieser Ebene.
Das Detail klingt mechanisch, wirkt aber auf reale Workloads. Eine Spalte mit langen Strings hoher Kardinalität wie URLs, Geräte-IDs oder Session-Token sieht auf Dateiebene oft gut aus und komprimiert sich Page für Page trotzdem schlecht. Dasselbe Muster zeigt sich bei Gleitkommagrößen, die sich kaum wiederholen und auf Standard-Encodings schlecht ansprechen. 2026 sind das noch immer die beiden Fälle, in denen Teams entdecken, dass „in Parquet gespeichert“ nicht automatisch „klein und schnell“ bedeutet.
Ein nützliches Denkmodell ist ein Lagerhaus. Die Datei ist das Gebäude. Row Groups sind Gänge. Column Chunks sind die Regale für eine Produktart in einem Gang. Pages sind die Kisten in jedem Regal. Eine Abfrage sollte so wenige Kisten wie möglich öffnen.
Was ein Reader tatsächlich tut
Ein Reader beginnt mit den Footer-Metadaten und entscheidet dann, welche Row Groups und Spalten sich zu öffnen lohnen. Fragt eine Abfrage SUM(price) mit region = 'us-east' ab, kann die Engine oft die Row-Group-Statistiken für region prüfen und Row Groups überspringen, deren Werte nicht passen können. Braucht sie nur price, kann sie zusätzlich die übrigen Column Chunks dieser Row Groups ungelesen lassen.
Das ist der Idealfall.
Der Haken ist, dass das Überspringen von der Datenverteilung und vom Schreibverhalten abhängt. Sind die Zeilen zufällig gemischt und enthält jede Row Group jede region, helfen Min- und Max-Statistiken weniger. Ist eine Stringspalte unsortiert und stark eindeutig, enthalten Page-Grenzen womöglich so viel Variation, dass Page-Skipping wenig bringt. Das Format stellt die Mechanik bereit, aber die Anordnung Ihrer Daten entscheidet, ob diese Mechanik Arbeit spart.
Warum Page-Metadaten heute mehr zählen
Page-Metadaten gehören zu den interessanteren Entwicklungen für Produktionssysteme, weil sie verschwendete Lesevorgänge innerhalb einer Row Group verringern können, nicht nur zwischen Row Groups. Das zählt, je größer Dateien werden und je häufiger selektive Filter auftreten.
In der Praxis ist es ebenfalls ungleichmäßig. Manche Engines schreiben die Metadaten, manche lesen sie, manche ignorieren sie. Der operative Fehler besteht darin, Unterstützung anzunehmen, weil die Spezifikation das Feature enthält. Teams, die ihren Stack 2026 aktualisieren, sollten das Verhalten mit ihren tatsächlichen Engines und Cloud-Storage-Pfaden prüfen, besonders in gemischten Landschaften, die Spark zum Schreiben und DuckDB, Trino oder Warehouse-Reader zum Abfragen nutzen.
Konfigurationsempfehlung gegenüber der Praxis
Die Parquet-Konfigurationsempfehlung rät zu großen Row Groups und kleinen Pages, mit Beispielen wie 512 MB bis 1 GB Row Groups und 8 KB Page-Größen sowie HDFS-orientierten Layout-Annahmen (Parquet-Konfigurationsempfehlung).
Diese Zahlen sind als Formatleitlinie nützlich, nicht als universelle Einstellungen.
Im Object Storage hängt die praktische Wahl oft von Reader-Parallelität, Partitionsgrößen, Retry-Kosten und der Form Ihrer Prädikate ab. Eine Batch-Faktentabelle, die von Anfang bis Ende gescannt wird, profitiert womöglich von größeren Row Groups. Ein Datensatz, den selektive Kunden- oder Zeitfilter treffen, fährt vielleicht mit einem anderen Gleichgewicht besser. Der häufige Fehler ist, Standardwerte von einer Engine oder einem Speichersystem auf ein anderes zu übertragen und dasselbe Verhalten zu erwarten.
Behalten Sie diese Hierarchie im Kopf:
Datei: das Objekt, das in S3, GCS, ADLS oder HDFS liegt
Row Group: eine horizontale Scheibe von Zeilen und die Haupteinheit für grobes Überspringen
Column Chunk: die Daten einer Spalte innerhalb einer Row Group
Page: der Block, der codiert, komprimiert und mit feineren Metadaten manchmal übersprungen wird
Wenn Sie diese vier Ebenen verstehen, hört Parquet auf, undurchsichtig zu wirken. Es wird zu einer Reihe von Speicherentscheidungen, die Sie prüfen, messen und justieren können.
Parquet Version 1 gegenüber Version 2 in der Praxis
Die Parquet-Spezifikation hat mehrere Releases durchlaufen, und die nützliche Frage lautet, welche Fähigkeiten Ihre Reader und Writer unterstützen.
Parquet v2 brachte mehr als ein neues Etikett. Es erweiterte, wie das Format verschachtelte Daten, Null-Darstellung und Metadaten für feineres Überspringen behandelt. Die Dateistruktur fühlt sich weiterhin vertraut an, doch die Unterstützung der neueren Fähigkeiten landet ungleichmäßig in den Engines. Deshalb kann „v2 schreiben“ je nach Landschaft ein guter Standard oder eine Interoperabilitätsfalle sein.
Die Fähigkeitsmatrix, auf die es ankommt
Fähigkeit | Parquet v1 | Parquet v2 | 2026 verlässlich? |
|---|---|---|---|
Grundlegendes spaltenorientiertes Layout | Ja | Ja | Ja |
Min-/Max-/Null-Statistiken im Footer auf Row-Group-Ebene | Ja | Ja | Ja |
Unterstützung verschachtelter Daten mit Repetition und Definition Levels | In der Formatfamilie unterstützt | Fortgeführt und weit verbreitet | Meist ja, aber Reader-Verhalten bei komplexen Schemata prüfen |
Page-Statistiken über den Page Index | Nein | Ja | Nur wenn Ihre Engine sie ausdrücklich unterstützt und nutzt |
Verbesserte Null-Behandlung in neueren Page-Formaten | Begrenzt | Bessere Unterstützung | Oft ja, aber Engine-abhängig |
Neuere optionale Features wie Bloom-Filter | Nein | Im Ökosystem verfügbar | Nein, zuerst Reader-Unterstützung prüfen |
Worauf Sie sich gefahrlos verlassen können
Wenn Sie Dateien für gemischte Umgebungen mit Spark, DuckDB, Trino und BigQuery schreiben, bleiben die sichersten Annahmen die Grundlagen: Spaltenprojektion, Row-Group-Statistiken, Standard-Encodings und gängige Kompressions-Codecs.
Nicht universell sicher ist alles, was von neueren optionalen Metadaten oder frischen Spec-Features abhängt. Diese Vorsicht zählt umso mehr, als Parquet sich weiterentwickelt. 2026 veröffentlichte das Projekt Parquet 2.14.0 und hob Arbeiten am logischen Typ FILE, an adaptivem verlustfreiem Gleitkomma-Encoding (ALP) sowie an verbesserter Timestamp-Ordnung hervor. Das Projekt weist zugleich darauf hin, dass der Rollout gestaffelt erfolgt und ALP als „in preview“ markiert ist, während die Implementierungen nachziehen (Blog zum Apache-Parquet-Format).
Kompatibilitätsregel: Schreiben Sie für den ältesten Reader, den Sie nicht kontrollieren können.
Das ist die praktische Perspektive. Für neue Pipelines ist v2 meist das bessere Writer-Ziel. Doch bevor Sie sich auf neuere Page-Metadaten, fortgeschrittene Timestamp-Semantik oder Preview-Encodings verlassen, prüfen Sie jede Engine, die die Dateien lesen wird. Nutzt Ihr Team Databricks oder gemischte Lakehouse-Reader, werden Databricks-Datenqualitätskontrollen Teil des Dateiformat-Gesprächs, weil Kompatibilitätsprobleme oft als nachgelagerte Qualitätsvorfälle auftauchen und nicht als offensichtliche Lesefehler.
Encodings und Kompressions-Codecs, die wirklich etwas bewirken
Eine Parquet-Datei wird in zwei getrennten Schritten klein, und die Produktionsabstimmung fällt leichter, wenn Sie diese Schritte auseinanderhalten.
Zuerst codiert Parquet eine Spalte in eine Form, die zur Gestalt der Daten passt. Danach läuft ein Kompressions-Codec über die entstandenen Bytes. Überspringt man diese Unterscheidung, schiebt man ein Größenproblem schnell Snappy oder ZSTD in die Schuhe, obwohl es mit einer schlechten Encoding-Wahl begann. Forschung, die Encoding- und Kompressionsverhalten von Parquet über analytische Workloads vergleicht, fand, dass die Paarung mehr zählt als der Codec allein (Forschungsüberblick zu Parquet-Kompression und -Encodings).
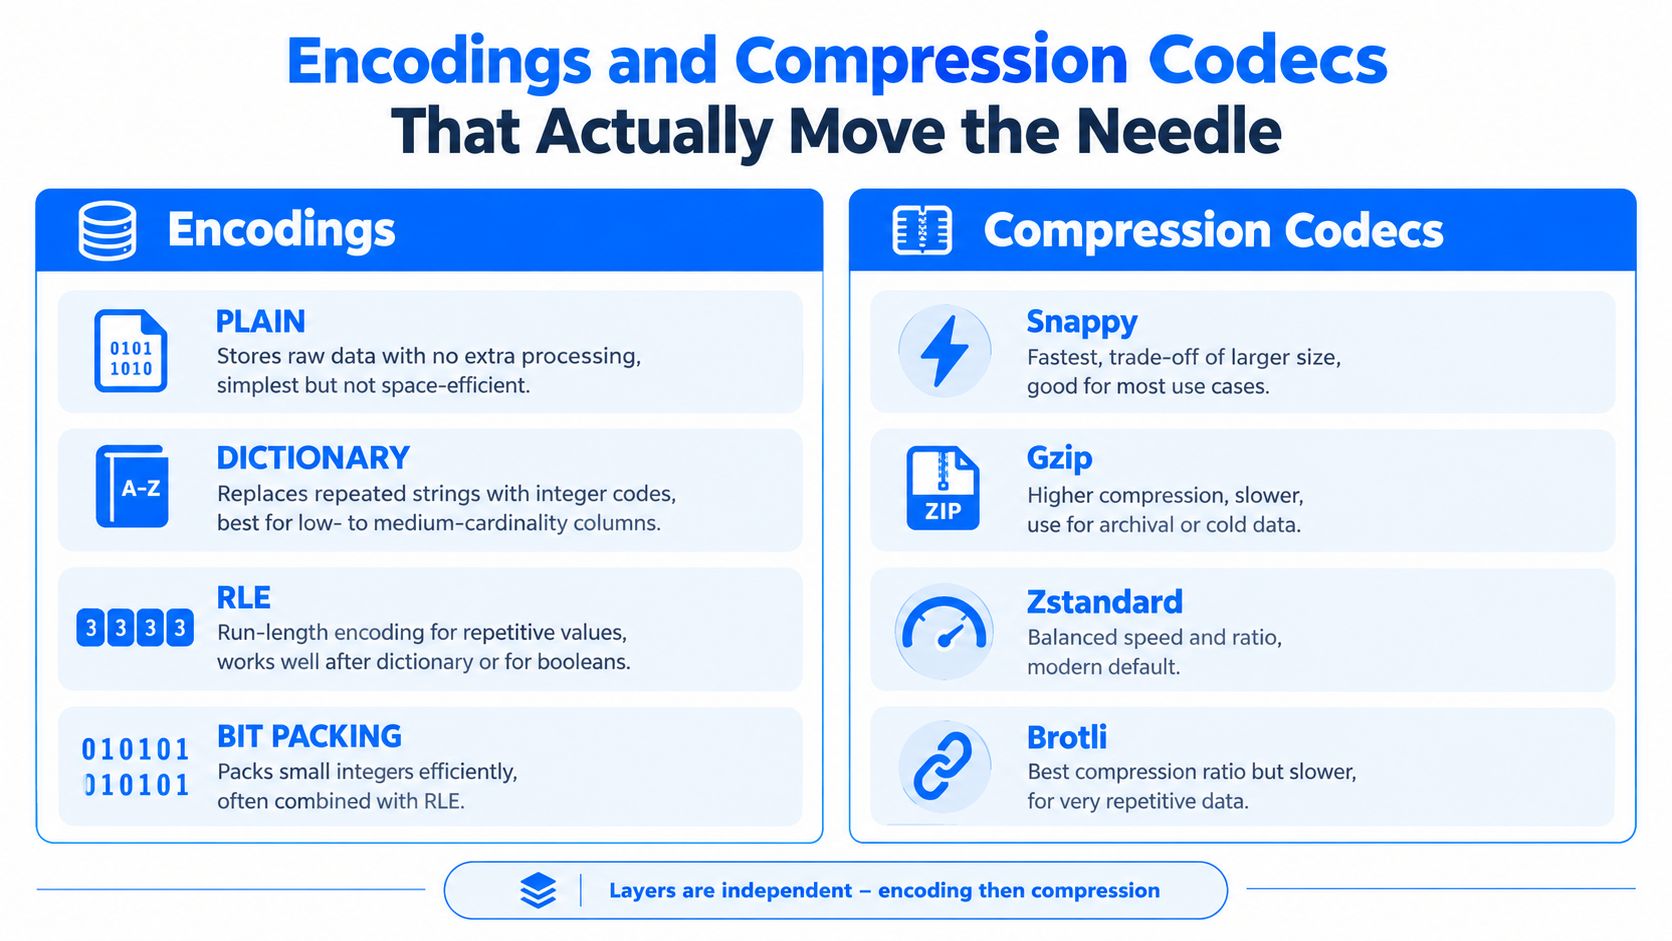
Encoding funktioniert wie das Sortieren von Werkzeug in beschriftete Kisten, bevor ein Lkw beladen wird. Komprimierung sind die Gurte und die Folie, die nach dem Beladen angelegt werden. Gutes Packen beginnt bei den Kisten.
Encodings zuerst, Codecs danach
Die gängigen Encodings lösen unterschiedliche Probleme:
PLAIN: Werte direkt speichern. Guter Rückfall, schwach bei der Größe.
DICTIONARY: Wiederholte Werte durch kleine Ganzzahlcodes ersetzen. Stark bei Strings niedriger und mittlerer Kardinalität, Enums und vielen ID-artigen Spalten.
RLE und Bit-Packing: Wiederholte oder schmale Ganzzahlen kompakt ablegen. Nützlich für Boolesche Werte, Dictionary-Indizes und wiederholungsreiche Daten.
DELTA-Encodings: Änderungen zwischen benachbarten Werten statt jedes vollen Werts speichern. Passt am besten zu sortierten Ganzzahlen, Zählern und manchen zeitorientierten Spalten.
Ein konkretes Beispiel hilft. Angenommen, eine status-Spalte enthält über 100 Millionen Zeilen nur pending, paid und failed. Dictionary-Encoding macht aus diesen Strings winzige Codes wie 0, 1 und 2. RLE und Bit-Packing können anschließend lange Läufe oder Werte geringer Bitbreite effizient ablegen. Danach hat ZSTD oder Snappy einen deutlich einfacheren Bytestrom zu komprimieren. Speichert dieselbe Datei rohe Strings mit PLAIN-Encoding, muss der Codec weit mehr leisten und erzielt meist schlechtere Ergebnisse.
Derselbe Forschungsüberblick berichtet, dass Parquet gemischte analytische Daten oft drastisch verkleinert und dass ZSTD Snappy beim Kompressionsverhältnis üblicherweise schlägt, während Snappy weiterhin besser abschneidet als unkomprimierte Daten. Er hält außerdem fest, dass Dictionary-Encoding in Verbindung mit Bit-Packing und RLE besonders wirksam bei ganzzahlartigen Spalten niedriger Kardinalität ist. Dieses Muster deckt sich mit dem, was Data Engineers in Faktentabellen und Event-Logs sehen.
Sinnvolle Paarungen nach Datenform
Lassen Sie die Gestalt der Spalte die Wahl bestimmen.
Kategoriale Felder, Ländercodes, Statuswerte, Produktarten: Dictionary plus ZSTD ist ein starker Standard.
Boolesche Flags, null-lastige Indikatorspalten, partitionsartige Marker in der Datei: RLE-freundliche Pfade funktionieren meist gut, weil Wiederholung dominiert.
Sortierte Zeitstempel, Sequenznummern, monoton steigende Zähler: Delta-Encodings können die Nutzlast senken, bevor ein Codec läuft.
Interaktive Abfragepfade, bei denen CPU-Zeit zählt: Snappy bleibt beliebt, weil die Dekodierkosten vorhersehbar sind.
Archivdatensätze, bei denen Speicherkosten wichtiger sind als Schreibgeschwindigkeit: ZSTD, GZIP oder manchmal Brotli können die zusätzliche CPU wert sein.
Der häufige Fehler ist, eine globale Codec-Richtlinie anzuwenden und die Sache für erledigt zu halten. Eine Tabelle mit UUIDs, User Agents, Preisen, Booleschen Werten und Ereigniszeiten enthält fünf verschiedene Kompressionsprobleme.
Wo Standardeinstellungen 2026 noch zurückbleiben
Diesen Teil überspringen viele Parquet-Erklärungen.
Die Standardeinstellungen von Parquet sind bei zwei Spaltentypen weiterhin ungleichmäßig, die in realen Systemen ständig vorkommen: Strings hoher Kardinalität und Gleitkommawerte. Dictionary-Encoding verliert seinen Vorteil, wenn fast jeder String verschieden ist, wie bei URLs, Request-IDs, User Agents und langen Textattributen. Gleitkommazahlen haben ein anderes Problem. Allzweck-Codecs können sie verkleinern, doch die Bytemuster sind oft so verrauscht, dass die Gewinne schwächer ausfallen als erwartet.
Diese Lücke ist ein wichtiger Grund, warum sich die Parquet-Diskussion 2026 neueren Arbeiten wie FSST für Strings und ALP für Gleitkommadaten zugewandt hat. Der Punkt ist nicht, dass das heutige Parquet kaputt wäre. Der Punkt ist, dass Standard-Encodings bei Telemetrie, Logs, Metriken, Modellausgaben, Preisen und Prozentwerten weiterhin Geld liegen lassen. Eine brauchbare Zusammenfassung dieser Richtung findet sich in der Diskussion zu FSST und ALP für Parquet-Encodings.
Die Reader-Unterstützung entscheidet weiterhin, was Sie gefahrlos einsetzen können. Preview-Encodings oder frisch hinzugefügte Verfahren können die Dateigröße in Benchmarks verbessern, doch eine Produktionspipeline stellt eine härtere Frage: Können Spark, Trino, DuckDB, Ihr Ingestion-Job und Ihre Recovery-Werkzeuge die Dateien nächsten Monat alle gleich lesen?
Was in der Produktion wirklich etwas bewirkt
Drei Entscheidungen zählen meist mehr als Codec-Debatten in sozialen Netzwerken.
Passen Sie das Encoding zur Kardinalität. Dictionary-Encoding ist hervorragend, bis das Wörterbuch so groß wird, dass es sich nicht mehr rechnet.
Sortieren oder clustern Sie Daten vor dem Schreiben, wenn möglich. Bessere lokale Wertemuster geben Delta, RLE, Statistiken und Komprimierung mehr Angriffsfläche.
Benchmarken Sie ganze Lesepfade, nicht nur die Dateigröße. Eine um 20 Prozent kleinere Datei ist kein Gewinn, wenn die CPU-Kosten die Dashboard-Latenz hochtreiben oder Batch-SLAs strecken.
Eine weitere Abwägung verdient Ehrlichkeit. Die kleinste Datei ist nicht immer die günstigste im Betrieb. Teams sparen oft mehr mit einer etwas größeren Datei, die jede Engine schnell und zuverlässig dekodiert, als mit einer aggressiven Encoding-Wahl, die Kompatibilitätsrisiko oder schwer zu debuggende Reader-Fehler einbringt.
Schemaevolution, ohne nachgelagerte Reader zu brechen
Schemaevolution ist der Punkt, an dem gute Praktiken für Parquet-Dateiformate Ihr Team entweder retten oder verraten. Das Dateiformat ist flexibel genug, um Veränderung zu tragen, doch das heißt nicht, dass jede Änderung sicher ist.
Die sicherste Haltung ist schlicht: Hinzufügen ist meist einfacher als Verändern.
Änderungen, die meist sicher sind
Diese Änderungen sind weitgehend beherrschbar, wenn sich Ihre Reader anständig verhalten:
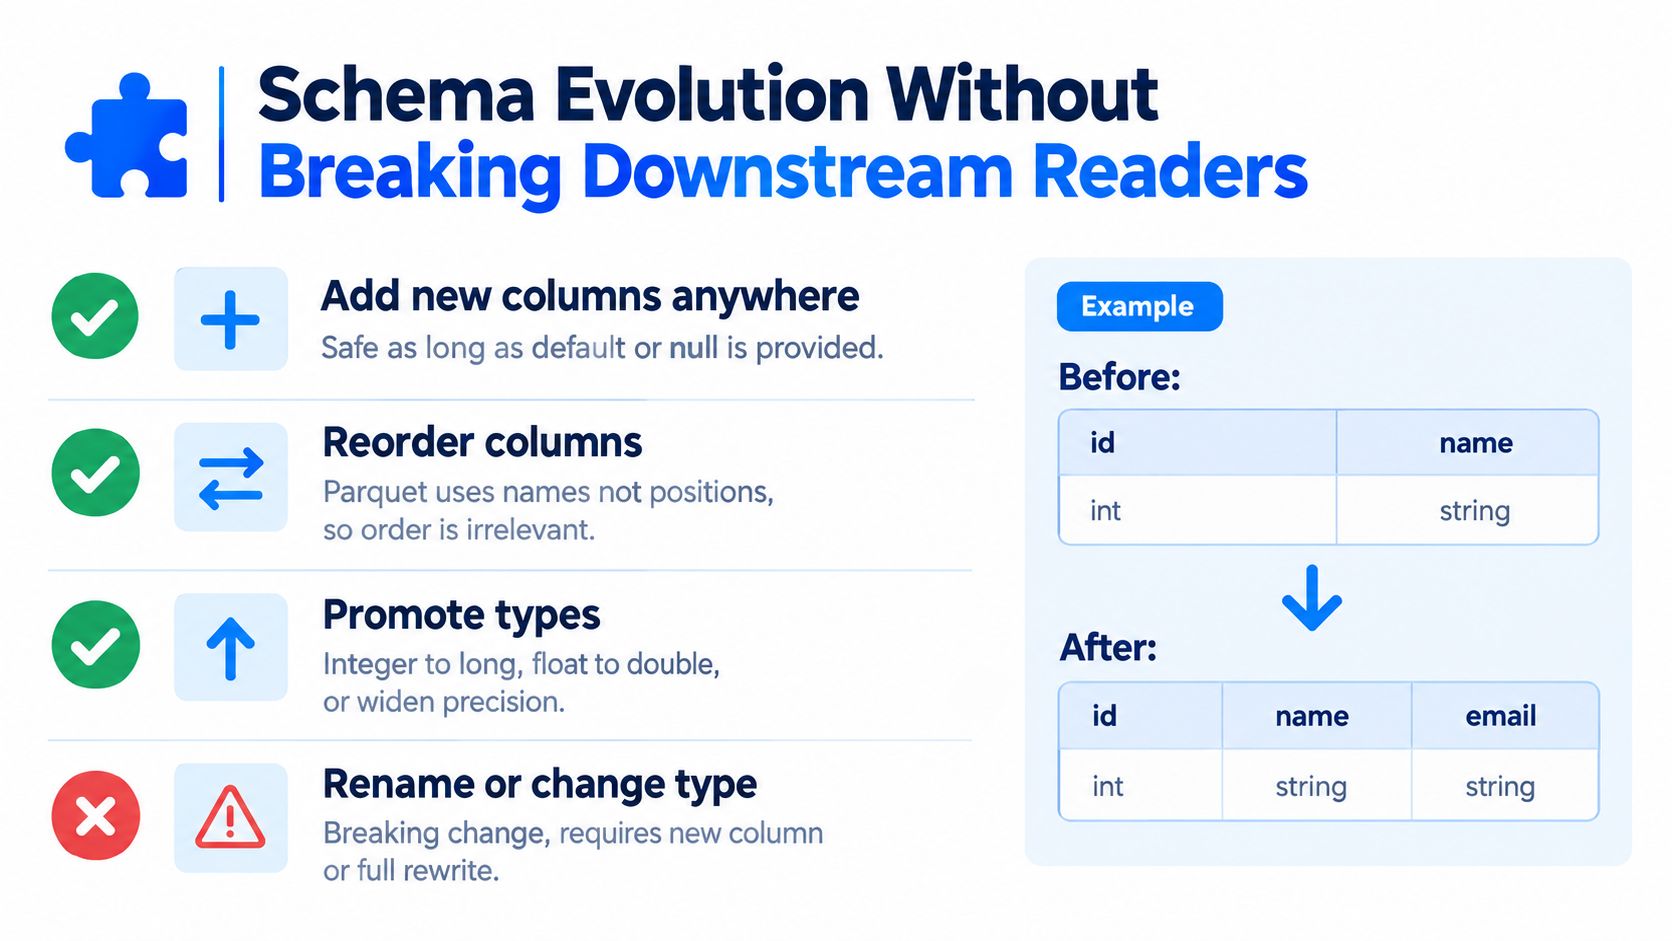
Eine neue Spalte hinzufügen: Alte Dateien haben sie nicht, daher liefern Reader meist Nullwerte oder Standardwerte.
Spalten umordnen: Reader nutzen in der Regel Schemametadaten und nicht die sichtbare Position in der Datei.
Einen Typ erweitern: Der Wechsel von einem engeren zu einem breiteren kompatiblen Typ ist oft akzeptabel, wenn die Engine ihn unterstützt.
Diese Muster passen dazu, wie Parquet das Schema in Metadaten ablegt, statt eine positionsbasierte Auslegung zu erzwingen. Sie verdienen trotzdem Tests, sind aber nicht die Änderungen, die üblicherweise stillen Schaden anrichten.
Änderungen, die stille Fehler verursachen
Umbenennungen sind die klassische Falle. Eine Umbenennung sieht für nachgelagerte Reader oft aus wie „eine Spalte entfernt, eine hinzugefügt“. Es wird keine Ausnahme ausgelöst. Sie erhalten schlicht Nullwerte, wo zuvor Daten standen.
Typänderungen können schlimmer sein. Ändert sich die logische Bedeutung unter gleichem Feldnamen, entstehen Werte, die zwar parsen, aber nicht mehr dasselbe bedeuten. So debuggen Teams am Ende „valide“ Zeilen, die sich nicht mehr abstimmen lassen.
Umbenennungen sind in Parquet-Pipelines keine Metadaten-Kosmetik. Sie sind Migrationsereignisse.
Gewohnheiten, die Pipeline-Verfall verhindern
Einige operative Gewohnheiten bringen viel:
Frieren Sie Schemaverträge außerhalb des Writer-Codes ein. Ein Registry-, Repository- oder katalogbasierter Prozess ist besser als „was der Job heute Nacht eben ausgibt“.
Behandeln Sie Umbenennungen als zweistufige Migration. Neues Feld anlegen, backfillen, Reader umstellen, dann das alte stilllegen.
Prüfen Sie Typerweiterung und logische Typkompatibilität vor dem Release. Nutzen Sie dieselben Reader-Bibliotheken, auf die Ihre nachgelagerten Engines setzen.
Überwachen Sie strukturellen Drift fortlaufend. Werkzeuge wie Schema Tracker sind nützlich, weil sie hinzugefügte oder entfernte Spalten und Datentypänderungen erkennen, bevor diese Änderungen in Produktionsvorfälle münden.
Verarbeitet Ihr Team regulierte Daten oder viel geteilte nachgelagerte Nutzung, zählt Schemadisziplin mehr als Codec-Feinschliff. Kompressionsfehler kosten Geld. Schemafehler kosten Vertrauen.
Wie Parquet im Vergleich zu ORC und Avro abschneidet
Parquet, ORC und Avro lösen verschiedene Teile des Datenlebenszyklus. Teams geraten in Schwierigkeiten, wenn sie von einem Format alles verlangen.
Avro ist zeilenorientiert und passt gut an Ingest-Grenzen. Parquet und ORC sind spaltenorientiert und passen deutlich besser zu analytischen Lesevorgängen. Sobald Sie die Wahl am Workload statt an Markentreue ausrichten, werden die Abwägungen klarer.
Parquet, ORC und Avro auf einen Blick
Kriterium | Parquet | ORC | Avro |
|---|---|---|---|
Speichermodell | Spaltenorientiert | Spaltenorientiert | Zeilenorientiert |
Beste Passung | Engine-übergreifende Analytik und Lakehouse-Austausch | Warehouse-lastige Umgebungen, oft Hive-zentriert | Streaming, Message-Puffer, zeilenweiser Austausch |
Column Pruning | Stark | Stark | Schwach im Vergleich zu spaltenorientierten Formaten |
Predicate Pushdown | Stark, wenn Statistiken vorhanden und gut geschrieben sind | Stark | Begrenzt, weil spaltenorientierte Statistiken im Parquet-Stil fehlen |
Schemabehandlung | Selbstbeschreibende Dateimetadaten | Selbstbeschreibende Dateimetadaten | Starke schemazentrierte Abläufe |
Verschachtelte Daten | Unterstützt | Unterstützt | Unterstützt |
Breite Werkzeug-Interoperabilität | Sehr stark über moderne Analytics-Engines hinweg | Stark, am stärksten aber oft in ORC-freundlichen Stacks | Stark für Ingestion- und Serialisierungsabläufe |
Eine praktische Entscheidungsregel
Wählen Sie Avro, wenn Ihnen zeilenweise Schreibvorgänge, Event-Austausch und schemagesteuerte Ingestion wichtig sind. Es ist ein gutes Grenzformat.
Wählen Sie ORC, wenn Ihr Stack eng an Engines und Abläufe angelehnt ist, die es bevorzugen, besonders in Umgebungen mit etablierten Warehouse-Konventionen.
Wählen Sie Parquet, wenn breite Interoperabilität am meisten zählt. Das umfasst gemischte Engines, offene Tabellenformate, Ad-hoc-Analytik und Lakehouse-Datensätze, die viele Werkzeuge ohne Verhandlung lesen müssen.
Dass Parquet dieses Mittelfeld immer wieder gewinnt, liegt weniger an einem einzelnen Killer-Feature als an der Schwerkraft des Ökosystems. Es reist gut zwischen Readern, und für die meisten Analytics-Teams zählt das ebenso viel wie reine Dateieffizienz.
Best Practices für verlässliche Parquet-Pipelines
Eine Parquet-Pipeline scheitert meist auf gewöhnliche Weise. Ein Writer-Upgrade ändert das Standard-Encoding einer Spalte. Ein Streaming-Job wirft über Nacht Tausende 5-MB-Dateien aus. Ein Nullable-Feld erscheint bei einem Produzenten als INT32 und bei einem anderen als INT64. Zum Schreibzeitpunkt sieht nichts dramatisch aus, doch am nächsten Morgen scannt Trino mehr Daten als erwartet, Spark verliert auf einer Partition den Predicate Pushdown, und ein nachgelagertes Modell liest Nullwerte, wo es Werte erwartet hat.
Das ist die Produktionsrealität, auf die zu optimieren ist. Verlässlichkeit entsteht weniger aus einer perfekten Dateieinstellung als daraus, Dateilayout, Schemaregeln und Reader-Kompatibilität explizit zu machen.
Die Betriebs-Checkliste
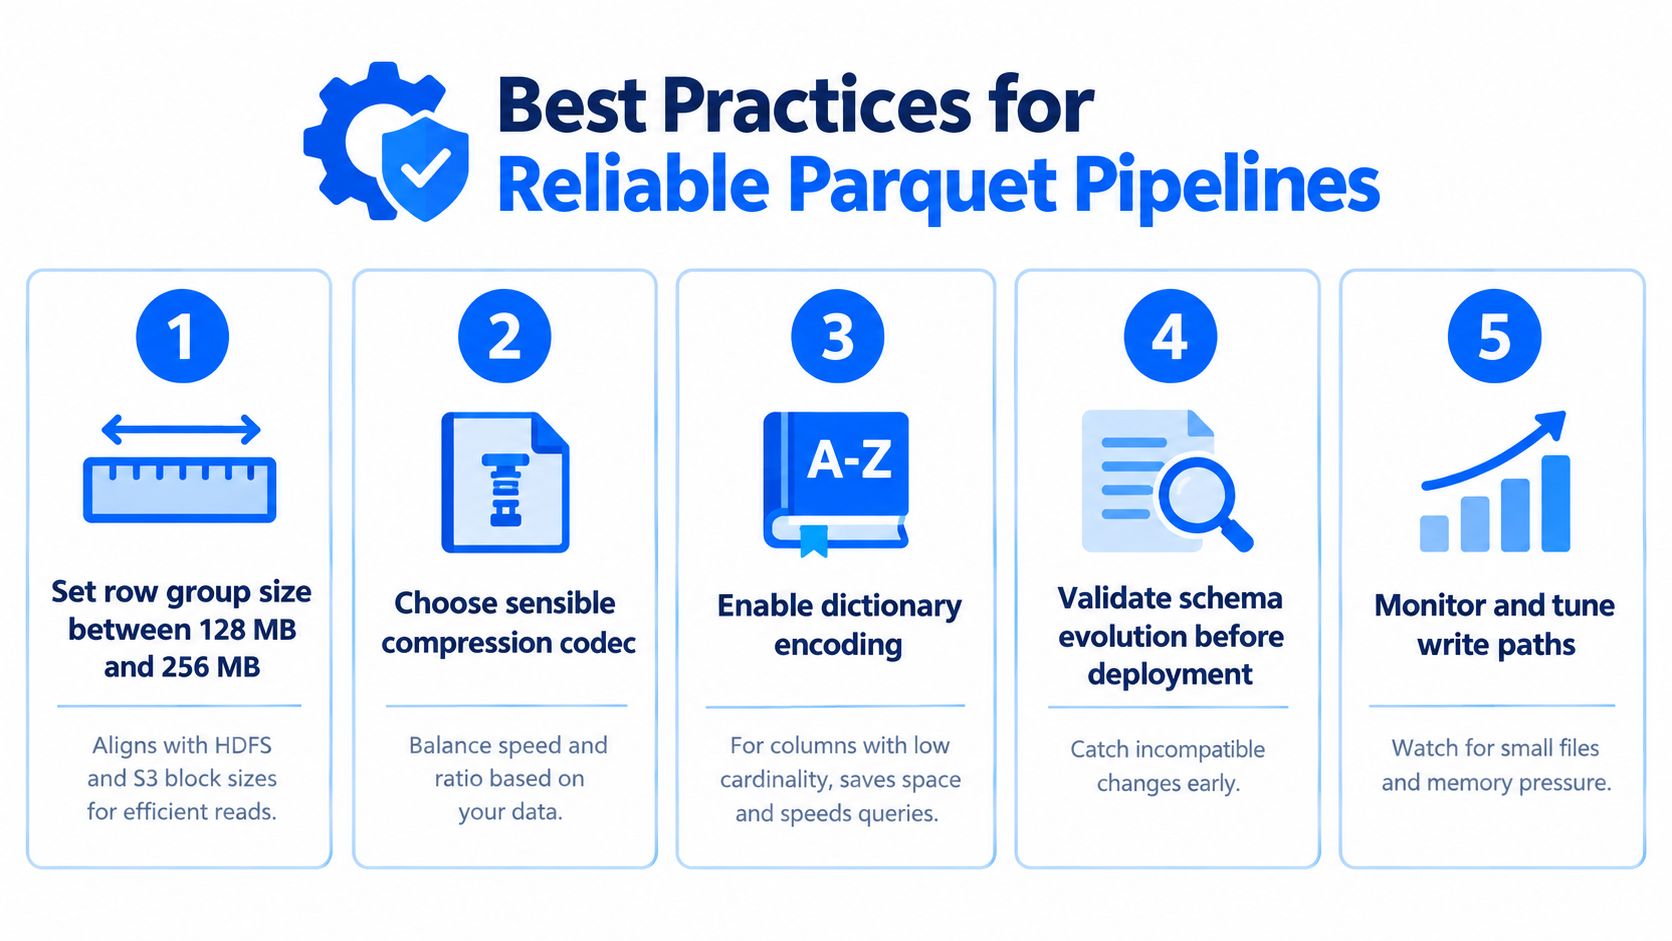
Wählen Sie Row-Group-Größen bewusst. Viele Teams starten bei etwa 128 MB und justieren nach Scanmustern, Speicherdruck und Verhalten des Object Store. Größere Row Groups können die Scaneffizienz verbessern, vergrößern aber den Schadensradius, wenn Statistiken schwach sind. Kleinere Row Groups geben Readern mehr Gelegenheiten zum Überspringen, doch zu viele davon erzeugen Metadaten-Overhead. Behandeln Sie Row-Group-Größe wie Lagerregale. Ist jede Kiste winzig, verlieren Sie Zeit mit dem Hantieren. Ist jede Kiste riesig, öffnen Sie ständig Behälter voller Daten, die Sie nicht brauchten.
Stoppen Sie das Wachstum winziger Dateien früh. Das ist einer der häufigsten Fehler in Parquet-Pipelines. Kleine Dateien verschwenden Planungszeit, erhöhen den Metadatenaufwand und senken die Leseeffizienz in Spark, Trino, DuckDB und Cloud-Warehouses gleichermaßen. Leert ein Kafka-Sink alle paar Sekunden, machen Sie Kompaktierung zu einem erstklassigen Job und nicht zu einem Nachgedanken.
Passen Sie Encodings an die tatsächliche Spaltenform an. Standardwerte sind für Ganzzahlen und gängige Dimensionen oft akzeptabel. Für Strings hoher Kardinalität, lange IDs und viele Gleitkommaspalten sind sie deutlich unbefriedigender. Diese Lücke zählt 2026 mehr, weil Teams zunehmend Embeddings, Feature-Ausgaben und maschinell erzeugte Kennungen in Parquet ablegen und der Standard-Writer-Pfad für diese Formen weiterhin Geld liegen lässt. Dictionary-Encoding hilft, wenn Wiederholung real ist. Es hilft deutlich weniger, wenn nahezu jeder Wert eindeutig ist.
Schreiben Sie Daten so, dass Statistiken eine Chance haben. Predicate Pushdown hängt von mehr ab als von „Statistiken aktiviert“. Enthält eine Tagespartition in jeder Row Group gemischte Kunden, Regionen und Ereignistypen, werden Min- und Max-Werte zu schwachen Filtern. Sortieren oder Clustern vor dem Schreiben bringt für die Überspringeffizienz oft mehr als ein Wechsel des Kompressions-Codecs.
Behandeln Sie Schemaevolution wie eine API-Änderung. Eine Nullable-Spalte hinzuzufügen ist meist risikoarm. Ein Feld umzubenennen, die numerische Breite zu ändern, die Timestamp-Semantik zu verschieben oder Required auf Optional zu kippen kann Reader auf subtile Weise brechen. Prüfen Sie Schemaänderungen vor dem Deployment und testen Sie sie gegen die Engines, die in der Produktion zählen, nicht nur gegen die Writer-Bibliothek. Ein praktischer Weg, diese Prüfungen zu formalisieren, ist sie in Ihre Best Practices für Datenpipelines zu Validierung, Monitoring und Änderungskontrolle einzubetten.
Testen Sie Parquet über Engines hinweg, nicht nur innerhalb eines Stacks. Eine Datei, die in Spark valide aussieht, kann in Trino, pandas, Arrow oder einem Warehouse-Reader dennoch Randfälle offenlegen. Logische Typen, Page-Indizes, Null-Behandlung und Timestamp-Auslegung unterscheiden sich weiterhin genug, dass Cross-Reader-Tests echte Produktionsfehler aufdecken.
Die Produktionsfragen, die 2026 stärker zählen
Dateiabstimmung zählt weiterhin, doch zwei Themen verdienen nun mehr Aufmerksamkeit.
Erstens sind Standard-Encodings für moderne Workloads weiterhin ungleichmäßig. Parquet bleibt für viele analytische Tabellen hervorragend, doch Strings hoher Kardinalität und gleitkommalastige Datensätze komprimieren und scannen oft weniger effizient, als Engineers erwarten. Speichert Ihr Lake Modell-Features, Telemetrie-IDs oder halbstrukturierte Dimensionen in Spalten aufgelöst, benchmarken Sie Writer-Einstellungen auf Ihren eigenen Daten, statt Standardwerten zu vertrauen.
Zweitens ist der Kompatibilitätsverzug real. Ein Feature, das in die Spezifikation aufgenommen wird, steht erst an der Startlinie. Operativ sicher wird es, wenn Ihre Reader, Validatoren und Katalogwerkzeuge es alle gleich auslegen. Deshalb gehören zu verlässlicher Parquet-Arbeit Versionstests, Schema-Diff-Prüfungen und Observability. digna ist eine Option, die Teams für diese operative Schicht nutzen: Sie überwacht Schemaänderungen, Timeliness, Anomalien und Validierungssignale innerhalb der Kundenumgebung.
Verlässlichkeitsprobleme bei Parquet bleiben selten im Speicher. Sie zeigen sich später als langsamere Scans, stiller Typdrift, kaputte Dashboards und Modelle, die auf der falschen Datenform trainiert wurden.
Row-Group-Größen und Codec-Entscheidungen driften, wenn sich Writer ändern. Verbinden Sie diese Praktiken deshalb mit Data Platform Observability, die meldet, wenn das Dateilayout nicht mehr zur Leitlinie passt.
Häufig gestellte Fragen
Welche Row-Group- und Page-Größen empfiehlt Parquet?
Die Parquet-Konfigurationsempfehlung rät zu großen Row Groups und kleinen Pages, mit Beispielen wie 512 MB bis 1 GB Row Groups und 8 KB Pages unter HDFS-orientierten Layout-Annahmen. Viele Teams im Object Storage starten stattdessen näher bei 128 MB und justieren nach Scanmustern, Speicherdruck und Store-Verhalten.
Was ist der Unterschied zwischen Parquet Version 1 und Version 2?
Die Spezifikation hat mehrere Releases durchlaufen, doch die praktische Frage lautet, welche Fähigkeiten Ihre Reader und Writer tatsächlich umsetzen, und nicht, welche Versionsnummer Sie anpeilen. Für gemischte Umgebungen mit Spark, DuckDB, Trino und BigQuery bleibt sicherer Boden: Spaltenprojektion, Row-Group-Statistiken, Standard-Encodings und gängige Codecs.
Welche Schemaänderungen brechen nachgelagerte Parquet-Reader?
Umbenennungen sind die klassische Falle. Eine Umbenennung wirkt für nachgelagerte Reader wie eine entfernte plus eine neue Spalte, sodass keine Ausnahme ausgelöst wird — Sie erhalten schlicht Nullwerte, wo zuvor Daten standen. Nullable-Spalten hinzuzufügen ist weitgehend sicher; bei Typänderungen und umgebauter Verschachtelung beginnen die stillen Fehler.
Wie verbessern Page-Metadaten die Abfrageleistung?
Sie senken verschwendete Lesevorgänge innerhalb einer Row Group, nicht nur zwischen Row Groups. Ein Reader startet beim Footer, entscheidet, welche Row Groups und Spalten sich zu öffnen lohnen, und nutzt dann Page-Statistiken, um Pages nicht zu dekodieren, die dem Filter nicht entsprechen können. Das zählt umso mehr, je größer Dateien werden und je selektiver Filter ausfallen.
Sollte ich Parquet, ORC oder Avro verwenden?
Wählen Sie nach Lebenszyklusphase statt nach Benchmark. Avro passt zu zeilenweisen Schreibvorgängen, Event-Austausch und schemagesteuerter Ingestion und ist damit ein gutes Grenzformat. Parquet und ORC zielen beide auf analytische Scans, wobei Parquet bei der Ökosystembreite meist vorn liegt. Ärger beginnt, wenn ein Format jede Phase abdecken soll.



