Parquet-Dateiformat erklärt: ein praktischer Leitfaden 2026
|
10
min. Lesezeit

Sie haben vermutlich schon mit Parquet zu tun, selbst wenn Sie es nicht selbst gewählt haben. Ein Warehouse-Export landet in S3, Ihr Spark-Job liest eine Lake-Tabelle auf Parquet-Dateien, oder Athena scannt weiter Datensätze, die jemand weiter oben im letzten Jahr auf drei verschiedene Arten partitioniert hat. An den meisten Tagen fühlt es sich schnell und unsichtbar genug an, dass niemand Fragen stellt.
Dann geht etwas kaputt. Eine Abfrage, die früher flog, beginnt zu schleppen. Ein neuer Writer rollt ein Feature aus, das eine Engine lesen kann und eine andere nicht. Ein einziges umbenanntes Feld wird zu einer Woche voller Nullwerte weiter unten. Das ist der Moment, in dem das Parquet-Dateiformat aufhört, eine Dateiendung zu sein, und zu einem operativen Thema wird.
Inhaltsverzeichnis
Wie Parquet Geschwindigkeit liefert: Predicate Pushdown und Column Pruning
Partitionierung, Dateigröße und Best Practices für Speicherung
Schemaevolution, Interoperabilität und die stillen Fallstricke
Schema-Drift, Timeliness und Observability für Parquet-Pipelines
Warum Parquet zum spaltenorientierten Standardformat wurde
Ein häufiges Analytics-Muster sieht so aus: Ein Team speichert eine breite Verkaufstabelle mit vielen Attributen, doch die meisten Dashboard-Abfragen berühren nur eine Handvoll Spalten. In einem zeilenorientierten Export wie CSV muss die Engine trotzdem jede Zeile als Text durchkauen. In Parquet kann sich die Engine auf die Spalten konzentrieren, die die Abfrage braucht. Dieser Unterschied ist der Grund, warum es für analytische Speicherung immer wieder gewählt wird.
Parquet entstand nicht zufällig. Es begann als Open-Source-Zusammenarbeit zwischen Twitter und Cloudera, mit der ersten Veröffentlichung am 13. März 2013, Parquet 1.0 im Juli 2013, und wurde bis zum 27. April 2015 zum Top-Level-Projekt der Apache Software Foundation, so die Dokumentation zum Apache-Parquet-Dateiformat. Apaches eigene Beschreibung ist weiterhin die klarste: Parquet ist ein quelloffenes, spaltenorientiertes Datendateiformat für effiziente Speicherung und Abfrage.
Warum spaltenorientierte Speicherung die Standardwahl verändert hat
Schlicht gesagt speichert Parquet Werte spaltenweise statt zeilenweise. Alle order_total-Werte liegen zusammen. Alle country-Werte liegen zusammen. Das verschafft Query-Engines zwei Vorteile:
Selektives Lesen: Sie können Spalten überspringen, die Ihr SQL nie referenziert.
Bessere Packung: Ähnliche Werte komprimieren sich gut, weil das Format vor der Komprimierung Encodings anwenden kann.
Diese Kombination passt gut zu modernen Analytics-Engines und Lakehouse-Tabellenformaten. Wenn Sie vor der Vertiefung eine kürzere Einführung möchten, bietet digna eine nützliche Parquet-Übersicht.
Praxisregel: Wenn Ihr Workload überwiegend aus Scans, Aggregationen und Filtern über große Datensätze besteht, passt Parquet meist besser zum Zugriffsmuster als Textformate.
Warum es sich so weit verbreitet hat
Parquet wurde zum Bindegewebe zwischen Spark-Pipelines, Warehouse-Exporten, Data Lakes im Object Storage und Tabellenformaten wie Iceberg, Delta Lake und Hudi. Teams schätzen es, weil es offen, typisiert und breit unterstützt ist. Sie mögen außerdem, dass es physische Speicherung von der Wahl der Query-Engine trennt. Eine Datei, die in einem Teil des Stacks geschrieben wurde, lässt sich oft anderswo lesen.
Dieses „oft“ zählt. Portabilität ist real, aber nicht automatisch, sobald neuere Features und gemischte Engine-Versionen in die Produktion kommen.
Engine | Native Parquet-Unterstützung | Typisches Muster |
|---|---|---|
Spark | Ja | Batch-Transformation und Lakehouse-Tabellen |
BigQuery | Ja | Externe Tabellen und Dateiaustausch |
Redshift Spectrum | Ja | Abfragen von Daten im Object Storage |
DuckDB | Ja | Lokale Analysen und Ad-hoc-Abfragen |
Athena | Ja | Serverlose Scans über partitionierte Lake-Daten |
In einer Parquet-Datei: Row Groups, Column Chunks und Pages
Eine Parquet-Datei ergibt mehr Sinn, wenn Sie sich eine typische Warehouse-Abfrage vorstellen. Eine Analystin fragt drei von fünfzig Spalten ab, gefiltert auf die letzte Woche. Ob sich diese Abfrage schnell oder träge anfühlt, hängt stark davon ab, wie Parquet die Bytes in der Datei anordnet, und nicht nur von der lesenden SQL-Engine.
Mit der Row Group beginnen
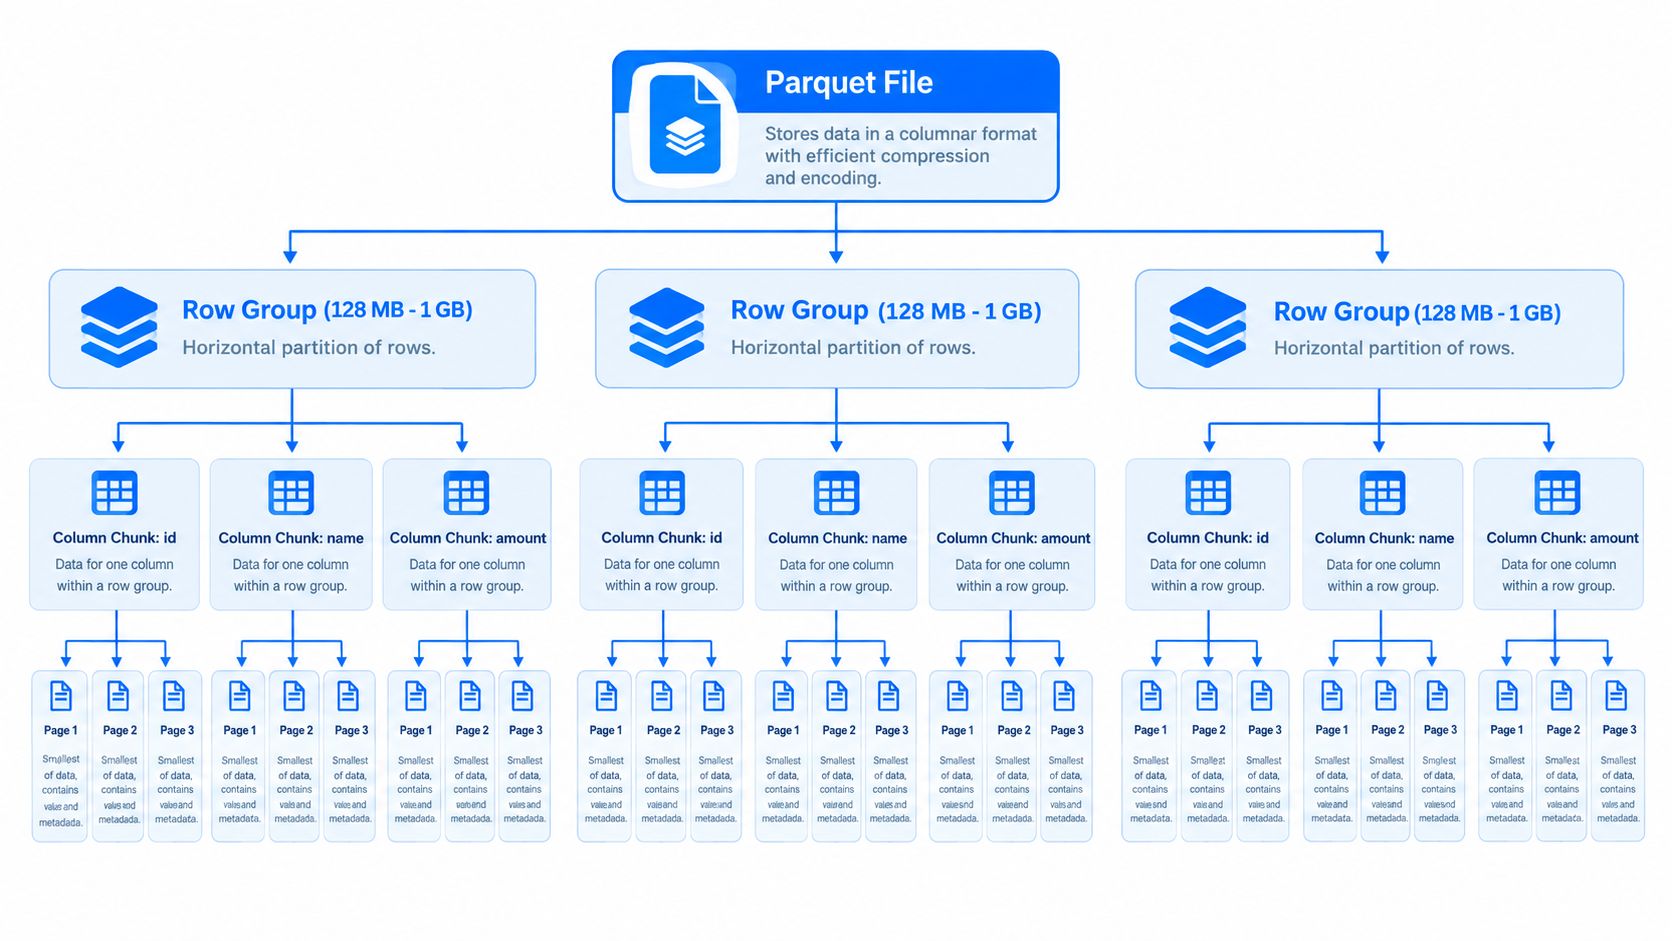
Eine Parquet-Datei ist in Row Groups unterteilt. Jede Row Group ist eine horizontale Scheibe der Tabelle und enthält damit denselben Satz Spalten für eine Teilmenge der Zeilen.
Die Größe der Row Group prägt das Leseverhalten stärker, als viele Teams erwarten. Frühere Apache-Parquet-Empfehlungen raten zu großen Row Groups, weil größere Gruppen meist größere Column Chunks erzeugen und sequenzielle I/O begünstigen. In der Produktion kann das scanlastigen Workloads helfen. Es schafft auch einen Zielkonflikt. Sehr große Row Groups senken den Metadaten-Overhead, können selektive Lesevorgänge aber weniger wendig machen, weil die Engine weiterhin auf Row-Group-Ebene plant.
Innerhalb jeder Row Group speichert Parquet genau einen Column Chunk je Spalte im Schema, und jeder Chunk liegt zusammenhängend in der Datei, wie im parquet-format-Repository definiert. Dieses Layout ist ein großer Teil davon, warum Column Pruning funktioniert. Braucht eine Abfrage order_total und order_date, kann die Engine die Bytes für customer_notes, device_model und alles andere ignorieren.
Dann in Column Chunk und Page hineinzoomen
Ein Column Chunk hält die Werte einer Spalte für eine Row Group. Dieser Chunk wird dann in Pages aufgeteilt, die kleineren Einheiten, die Parquet codiert und komprimiert.
Pages zählen, weil dort Speicherentscheidungen konkret werden. Page-Metadaten halten fest, welches Encoding und welche Komprimierung verwendet wurden. Existiert eine Dictionary Page, muss sie zuerst im Column Chunk stehen, und es darf höchstens eine Dictionary Page je Column Chunk geben, so die Apache-Parquet-Dokumentation zu Column Chunks.
Ein praktisches Denkmodell lautet:
Die Datei enthält ein physisches Parquet-Objekt.
Row Groups teilen die Zeilen in große Blöcke.
Column Chunks speichern eine Spalte für eine Row Group.
Pages speichern codierte und komprimierte Ausschnitte dieses Chunks.
Eine Tabellenkalkulations-Analogie hilft hier. Row Groups sind wie Bänder von Zeilen quer über das Blatt. Column Chunks sind die vertikalen Streifen für jedes Feld innerhalb eines Bandes. Pages sind die kleineren Pakete in jedem Streifen, die der Reader Stück für Stück dekodieren kann.
Warum der Footer die Leseplanung bestimmt
Der Footer ist der Ort, an dem Parquet die Karte aufbewahrt. Er speichert das Schema sowie Metadaten, die dem Reader sagen, wo Row Groups und Column Chunks liegen. Bevor eine Query-Engine kluge Entscheidungen über das Lesen treffen kann, braucht sie in der Regel diesen Footer.
Dieses Design ist hervorragend für analytische Planung. Für Punktzugriffe ist es schwächer.
Lautet Ihr Workload „scanne einen Monat Ereignisse und aggregiere“, hilft die Footer-zuerst-Planung der Engine, Arbeit zu sparen. Lautet er „hole einen Datensatz per ID“, muss der Reader den Footer trotzdem finden und parsen, bevor er die richtige Region der Datei lokalisieren kann. Die Parquet-Dokumentation von Apache Arrow hält zudem fest, dass Parquet-Daten in Blöcken dekodiert und nicht direkt auf Byte-Ebene bearbeitet werden, was ein Grund ist, warum das Abrufen einzelner Zeilen schlecht zum Format passt.
Das ist eine der Produktionslücken, die einfache Parquet-Erklärungen auslassen. Teams hören oft „spaltenorientiert heißt schnell“ und wenden Parquet dann auf jedes Zugriffsmuster an. Für Batch-Analytik trifft das meist zu. Für anfragegetriebene Lookups, CDC-Validierungssonden oder operative Debugging-Abläufe, in denen jemand sofort eine Zeile braucht, bricht es häufig.
Der Footer spielt später auch in Interoperabilitätsprobleme hinein. Verschiedene Engines können sich einig sein, dass die Datei existiert, und dennoch über neuere Metadaten-Features, Page-Indizes oder optionale Statistiken uneins sein. Wenn das passiert, ist das Symptom selten dramatische Korruption. Es ist meist leiser. Filter prunen nicht mehr so gut wie erwartet, eine Engine liest mehr Bytes als eine andere, oder die Abfragelatenz driftet Monate nach einem Writer-Upgrade nach oben.
Für Analytik ist die Footer-zuerst-Planung eine Stärke. Für Punktabfragen ist sie Overhead.
Deshalb funktioniert Parquet am besten, wenn Sie es als analytisches Dateiformat behandeln, beobachten, wie Ihre Engines seine Metadaten nutzen, und nachforschen, wenn „gescannte Bytes“ oder die Pruning-Rate der Row Groups plötzlich schlechter werden.
Encoding- und Komprimierungsoptionen, die wirklich zählen
Teams vermischen oft Encoding und Komprimierung, doch beide lösen unterschiedliche Probleme. Encoding strukturiert Werte innerhalb einer Page um. Die Komprimierung verkleinert danach den codierten Bytestrom. In Parquet stapeln sich diese Schichten.
Encodings verändern zuerst die Gestalt der Daten
Parquet unterstützt Encodings auf Page-Ebene, darunter PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY und BYTE_STREAM_SPLIT, sowie Kompressions-Codecs wie SNAPPY, GZIP, BROTLI, ZSTD und LZ4_RAW, wie in der Parquet-Formatreferenz zusammengefasst.
Was in der Produktion zählt, ist die Gestalt der Daten:
Dictionary-artige Pfade helfen, wenn Werte sich wiederholen, etwa bei Statusfeldern, Ländercodes oder Produktkategorien.
RLE funktioniert gut, wenn wiederholte Werte in Läufen auftreten, besonders nach dem Sortieren.
Delta-artige Encodings sind nützlich, wenn sich Werte schrittweise ändern, etwa bei steigenden IDs oder Zeitstempeln.
Byte Stream Split kann manchen numerischen Workloads helfen, doch die Kompatibilität hinkt über Werkzeuge hinweg womöglich hinterher.
Eine empirische Auswertung spaltenorientierter Formate ergab, dass Parquets aggressives Dictionary-Encoding über viele Datentypen hinweg oft starke Komprimierung bei vertretbarer Dekodierleistung lieferte und dass der Pfad aus Bit-Packing plus RLE typischerweise schneller dekodierte als komplexere Mehr-Algorithmen-Ansätze, so das Evaluationspapier zu spaltenorientierten Formaten.
Die Komprimierung sollte zu Ihrem operativen Ziel passen
Ein nützlicher Weg zur Codec-Wahl ist zu entscheiden, worauf Sie optimieren:
Schnelle Lesevorgänge und breite Kompatibilität: nutzen Sie Snappy.
Kompaktere Speicherung mit ausgewogenem Kompromiss: nutzen Sie ZSTD, wo Ihr Engine-Stack es problemlos unterstützt.
Maximale Verdichtung bei langsamerem Lesen und Schreiben: nutzen Sie GZIP für kalte oder weniger interaktive Datensätze.
Kurzfassung: Wählen Sie das Encoding nach dem Wertemuster der Spalte und danach die Komprimierung nach dem Kompromiss zwischen Speicher und CPU.
Datengestalt | Encoding | Komprimierung | Warum es funktioniert |
|---|---|---|---|
Wiederholte Strings in Logs | Dictionary oder RLE_DICTIONARY | SNAPPY | Wiederholte Werte packen kompakt und Snappy hält den Dekodier-Overhead niedrig |
Sortierte Status-Flags oder Regionscodes | RLE | ZSTD | Lange Läufe komprimieren effizient und ZSTD wägt Verhältnis und Lesekosten meist gut ab |
Steigende IDs oder geordnete Zeitstempel | DELTA_BINARY_PACKED | GZIP oder ZSTD | Kleine Schrittänderungen codieren kompakt, bevor der Codec läuft |
Gemischte Dimensionsspalten niedriger Kardinalität | Dictionary | SNAPPY oder ZSTD | Ähnliche Werte profitieren vom Dictionary-Lookup und bleiben portabel |
Analytische Merkmale mit vielen Gleitkommawerten | BYTE_STREAM_SPLIT, wo unterstützt | ZSTD | Kann das numerische Layout verbessern, prüfen Sie aber zuerst die Reader-Unterstützung |
Die Warnung betrifft die Portabilität. Die Spezifikation darf ein Encoding erlauben, das Ihr nachgelagerter Reader nicht vollständig umsetzt.
Wie Parquet Geschwindigkeit liefert: Predicate Pushdown und Column Pruning
Parquets Geschwindigkeit entsteht daraus, Daten nicht zu lesen, die Sie nicht brauchen. Das klingt offensichtlich, zerfällt aber in drei verschiedene Mechanismen mit unterschiedlichen Fehlerbildern.
Column Pruning nimmt den ersten Schnitt vor
Hat Ihre Faktentabelle viele Spalten und berührt Ihr SQL nur wenige, kann die Engine ausschließlich diese Column Chunks lesen. Das ist der sichtbarste Gewinn in analytischen Systemen. Es ist auch der Grund, warum Teams, die sich mit SQL-Abfrageoptimierung beschäftigen, oft entdecken, dass Dateiformat und Tabellenlayout ebenso wichtig sind wie der Abfragetext.
Praktisch gesprochen benötigt eine Abfrage wie:
keine Marketing-Attributionsfelder, Versandnotizen oder Dutzende ungenutzter Dimensionen. Mit Parquet kann der Planer diese Bytes oft vollständig vermeiden.
Beim Überspringen von Row Groups zahlen sich Layout-Entscheidungen aus
Parquet-Dateien speichern Metadaten, die Readern helfen zu entscheiden, ob eine Row Group einen Scan wert ist. Lautet der Filter region = 'EMEA' und zeigen die Statistiken einer Row Group nur Werte außerhalb dieses Bereichs, kann die Engine sie überspringen.
Die Sortierreihenfolge zählt. Schreiben Sie Zeilen in zufälliger Reihenfolge, werden Min- und Max-Statistiken weniger selektiv. Gruppieren Sie verwandte Werte zusammen, werden diese Statistiken deutlich nützlicher.
Verhalten auf Page-Ebene hilft, aber nur wenn die Daten mitspielen
Pages sind die kleinsten praktischen Einheiten innerhalb eines Column Chunk. Reader können das Dekodieren von Teilen eines Chunks vermeiden, wenn Metadaten und Filterlogik es zulassen. Dictionary-codierte Pages können außerdem Gleichheitsprädikate verbilligen, weil wiederholte Werte bereits zu Dictionary-Referenzen normalisiert wurden.
Allerdings schwächen sich diese Optimierungen ab, wenn:
Freitextspalten sich nicht sauber komprimieren oder prunen lassen
Felder hoher Kardinalität Werte über viele Gruppen verteilen
Punktabfragen eine winzige Antwort aus einer großen Datei brauchen
Unsortierte Schreibvorgänge Filterwerte über den Datensatz verschmieren
Abfragemuster | Gelesene Spalten | Gescannte Row Groups | Gelesene Bytes | Laufzeit |
|---|---|---|---|---|
Vollständiger Tabellenscan | Viele | Die meisten oder alle | Hoch | Am langsamsten |
Aggregation mit Column Pruning | Wenige | Die meisten oder alle | Geringer | Schneller |
Analytische Abfrage mit Prädikatfilter | Wenige | Nur ausgewählte Gruppen | Am geringsten von den dreien | Am schnellsten, wenn die Statistiken selektiv sind |
Die Falle besteht darin, Parquet in jeder Hinsicht für „schnell“ zu halten. Es ist schnell beim geplanten, sequenziellen analytischen Lesen. Es ist nicht wie ein indizierter Serving-Store gebaut.
Parquet gegenüber ORC, Avro, CSV und JSON
Die Wahl von Parquet fällt leichter, wenn Sie es mit den Formaten vergleichen, über die Teams üblicherweise diskutieren.
Zwei Analytics-Formate, ein Zeilenformat, zwei Austauschformate
Parquet und ORC zielen beide auf analytische Scans. Sie sind spaltenorientiert, komprimiert und für typisierte Daten entworfen. In der Breite gewinnt Parquet meist bei der Ökosystem-Reichweite über Engines und Lakehouse-Werkzeuge hinweg. ORC ergibt in manchen Hive-zentrierten Umgebungen weiterhin Sinn.
Avro ist ein anderes Tier. Es ist zeilenorientiert und eignet sich besser für satzweises Schreiben, Event-Austausch und schemareiche Pipelines, in denen das Bewahren der Zeilenstruktur wichtiger ist als Scaneffizienz.
CSV und JSON sind für Menschen und Allzweckwerkzeuge einfacher, verlagern aber Parsing- und Typisierungsarbeit auf die Lesezeit. Das macht sie meist zu schlechten Langzeitentscheidungen für große analytische Datensätze.
Nutzen Sie Parquet, wenn Sie wiederholte Scans und selektive Spaltenlesevorgänge erwarten. Nutzen Sie Avro, wenn Datensätze durch Streaming-Systeme wandern. Behalten Sie CSV und JSON für Austausch, Fehlersuche oder einfache Übergaben.
Die eigentliche Entscheidung ist die Passung zum Workload
Viele Teams fragen: „Welches Format ist am schnellsten?“ Die bessere Frage lautet: „Schnell wofür?“
Batch-Analytik: Parquet passt meist am besten.
Hive-lastiger Analytics-Stack: ORC verdient womöglich einen Blick.
Streaming-Datensätze und Event-Transport: Avro ist oft sauberer.
Ad-hoc-Inspektion und breite Werkzeugkompatibilität: CSV gewinnt weiterhin.
Austausch verschachtelter API-Payloads: JSON bleibt trotz der Kosten verbreitet.
Format | Layout | Komprimierungseffizienz | Scangeschwindigkeit | Schemaevolution | Beste Passung |
|---|---|---|---|---|---|
Parquet | Spaltenorientiert | Stark | Stark für Analytik | Gut, mit Einschränkungen über Reader hinweg | Data Lakes, BI, Batch-Analytik |
ORC | Spaltenorientiert | Stark | Stark für Analytik | Gut | Hive-orientierte analytische Umgebungen |
Avro | Zeilenorientiert | Mittel | Besser für Zeilenzugriff als für Spaltenscans | Stark für Datensätze | Streaming, Message-Payloads, Austausch |
CSV | Zeilenorientierter Text | Schwach | Schwach bei großen analytischen Lesevorgängen | Nicht eingebaut | Manuelle Inspektion, einfache Exporte |
JSON | Halbstrukturierter Text | Schwach bis mittel | Schwach bei großen Scans | Flexibel, aber lose durchgesetzt | API-Payloads, verschachtelter Austausch |
Partitionierung, Dateigröße und Best Practices für Speicherung
Eine typische Produktionsgeschichte geht so: Das Team wählte Parquet, die Abfragezeiten sahen im ersten Monat gut aus, und dann füllte sich der Lake mit winzigen Dateien, ungleichen Partitionen und Tabellen, die eine Engine schnell scannte, während eine andere mit Planungs-Overhead kämpfte. Das Format hat seine Arbeit getan. Das Layout nicht.
Wählen Sie Partitionsspalten, nach denen wirklich gefiltert wird
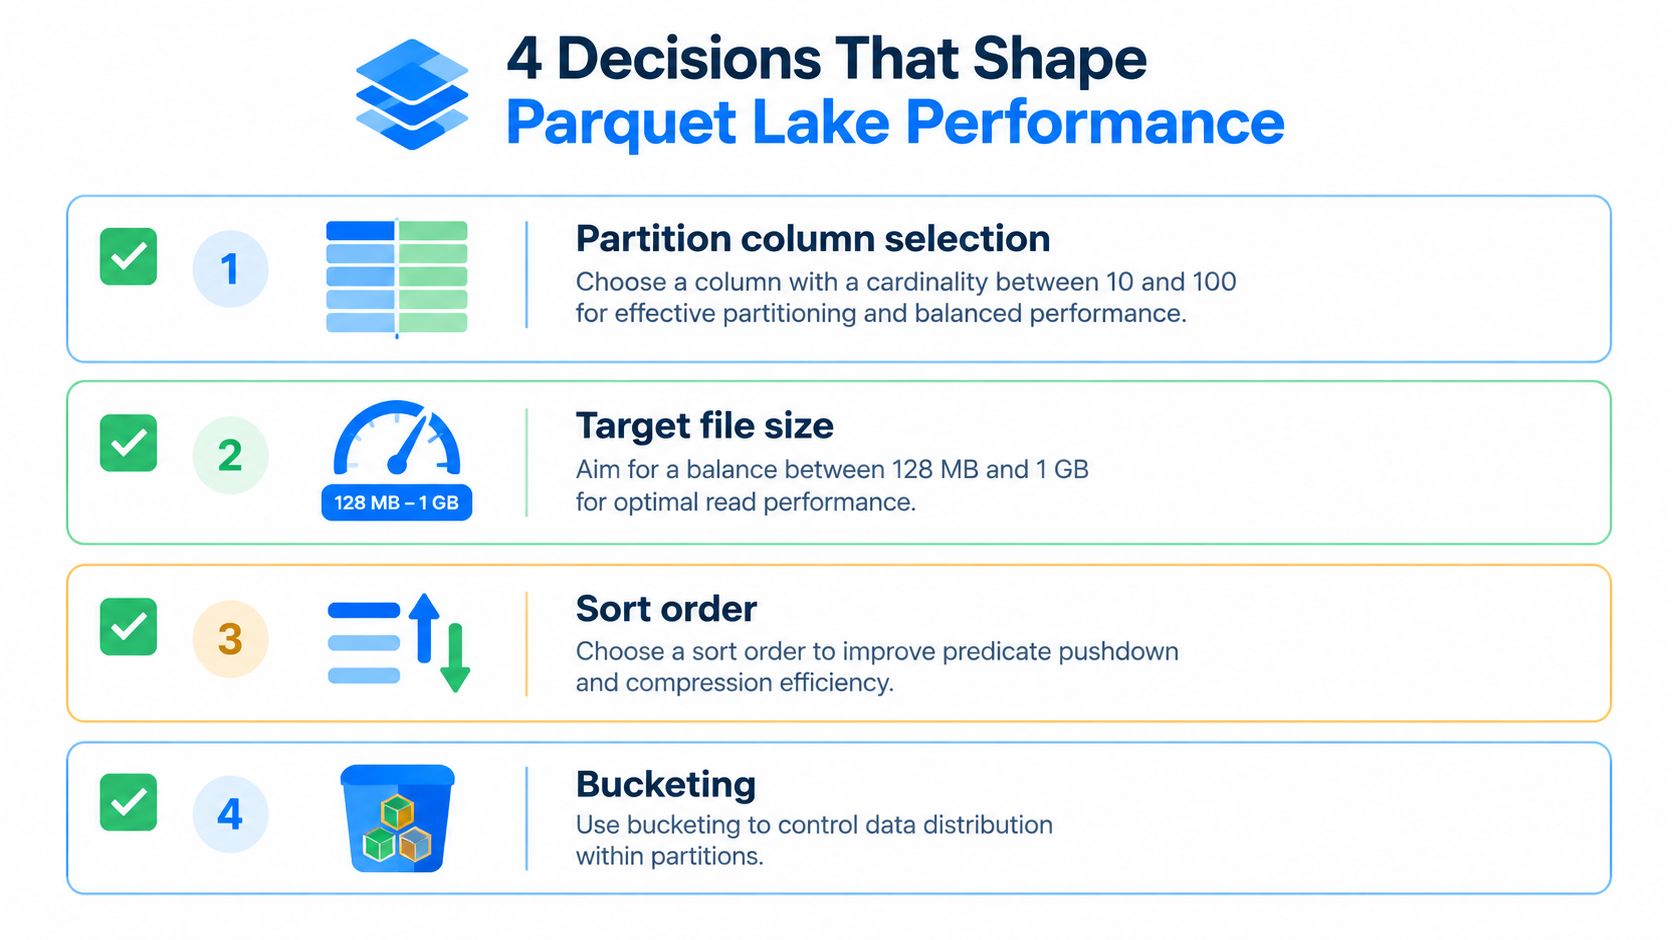
Partitionierung wirkt wie ein grobes Inhaltsverzeichnis. Sie hilft Readern, ganze Ordner zu überspringen, bevor sie überhaupt Parquet-Footer öffnen. Das ist mächtig, aber nur wenn der Partitionsschlüssel zu echten Abfragemustern passt.
Das Datum ist der übliche Startpunkt, weil Reporting und Backfills oft nach Tag, Woche oder Monat schneiden. Region, Umgebung, Mandantenstufe oder Geschäftsbereich können ebenfalls passen, wenn diese Felder häufig in WHERE-Klauseln auftauchen. Ein schlechter Schlüssel hat meist eines von zwei Problemen. Er ist entweder zu breit, um viel zu prunen, oder so hochkardinal, dass er in unzählige kleine Verzeichnisse und Dateien explodiert. Nach Nutzer-ID zu partitionieren ist der klassische Fehler.
Der Zielkonflikt wiegt schwerer, als viele Leitfäden zugeben. Gute Partitionierung beschleunigt breite analytische Lesevorgänge. Für Punktabfragen bringt sie wenig, weil Parquet weiterhin Footer-Metadaten braucht, bevor es die richtige Row Group finden kann. Umfasst Ihr Workload häufige Abrufe einzelner Datensätze, macht kein Partitionsschema Parquet zu einem Key-Value-Store.
Für Teams, die Batch-Writer und Kompaktierungsjobs bauen, sind diese Tipps zur ETL-Orchestrierung mit Python ein praktischer Begleiter, denn Partitionierung hält nur, wenn Scheduler, Retry-Logik und Writer-Ausgaben über die Zeit konsistent bleiben.
Die Dateigröße entscheidet, ob sich Object Storage schnell oder schwerfällig anfühlt
Die Dateigröße ist der Punkt, an dem viele Lakes aus der Form geraten. Sehr kleine Dateien erhöhen Listing-Overhead, Metadaten-Lesevorgänge und Planungszeit. Sehr große Dateien können die Parallelität senken und Retries teuer machen. Der Sweet Spot hängt von Engine, Netzwerk und Schreibpfad ab, doch das Ziel sind stabile, scanfreundliche Dateien statt der Größe, die zufällig aus vorgelagerten Micro-Batches fällt.
Auch die Größe der Row Groups zählt. Größere Row Groups verbessern oft sequenzielle Lesevorgänge und Komprimierung, machen selektive Lesevorgänge aber ungenauer, wenn Ihre Sortierreihenfolge schlecht ist. Deshalb sollten Dateigröße und Sortierreihenfolge gemeinsam gewählt werden und nicht als getrennte Stellschrauben.
Object Storage bringt eine weitere Verhaltensebene mit. Ein Data Lake auf S3-kompatiblem Speicher verhält sich nicht wie eine lokale Platte mit billigen Verzeichnisoperationen. Die Kosten zeigen sich in List-Aufrufen, Öffnungslatenz und dem Fan-out kleiner Dateien. Diese Einführung dazu, wie sich S3 als Dateisystem verhält, ist eine nützliche Referenz für dieses Denkmodell.
Beobachten Sie in der Produktion einige Signale: durchschnittliche Dateigröße je Tabelle, Dateianzahl je Partition, Kompaktierungsrückstand sowie Planungszeit gegenüber Scanzeit. Steigt die Planungszeit weiter, während das Datenvolumen flach bleibt, ist das Dateilayout oft der erste Ort, an dem man nachsieht.
Sortieren und Bucketing helfen, aber nur an den richtigen Stellen
Sortieren ist eine der wertvollsten Gewohnheiten für Parquet-Writer. Wenn ähnliche Werte zusammen landen, werden Row-Group-Statistiken selektiver, die Komprimierung verbessert sich, und Engines können zuverlässiger mehr Daten überspringen. Filtern Analystinnen und Analysten häufig auf event_date, customer_region oder ein anderes selektives Feld, kann eine Sortierung nach diesem Feld Footer-Metadaten weit nützlicher machen.
Bucketing löst ein anderes Problem. Es kann die Verteilung innerhalb einer Partition vorhersehbarer machen, was manchen join-lastigen Pipelines hilft. Es bringt außerdem operativen Aufwand mit sich und wird über Engines hinweg nicht gleich gut unterstützt, also behandeln Sie es als workload-spezifische Wahl und nicht als Standard.
Eine praktische Checkliste:
Partitionieren Sie für gängige Filter: Beginnen Sie mit Feldern, die verlässlich in Abfrageprädikaten auftauchen.
Halten Sie die Dateianzahl im Griff: Kompaktieren Sie nach Streaming- oder stark parallelen Schreibvorgängen.
Sortieren Sie innerhalb von Partitionen: Bessere Ordnung macht Row-Group-Statistiken vertrauenswürdig.
Verfolgen Sie Layout-Drift über die Zeit: Wachsende Zahlen kleiner Dateien und langsamere Planung sind Frühwarnzeichen.
Setzen Sie Bucketing gezielt ein: Wenden Sie es dort an, wo das Join-Verhalten die Wartungskosten rechtfertigt.
Schemaevolution, Interoperabilität und die stillen Fallstricke
Parquets Ruf für Portabilität ist nur bis zu einem gewissen Punkt verdient. Die unbequeme Produktionsrealität ist, dass sich die Spezifikation schneller bewegt als viele Reader-Stacks.
Offenes Format bedeutet keine einheitliche Unterstützung
Apaches Material zum Implementierungsstand zeigt, dass die Unterstützung nach Engine und Erscheinungsjahr fragmentiert ist, wobei manche neueren Fähigkeiten noch nicht breit umgesetzt und einige Features über Reader hinweg nur teilweise unterstützt sind, so die Seite zum Parquet-Implementierungsstand. Die Versionshinweise warnen zudem, dass manche Features vorwärtskompatibel sind und andere nicht.
Das heißt, ältere Reader öffnen eine Datei vielleicht noch, verlieren dabei aber Metadaten, verpassen Leistungsverbesserungen oder scheitern an nicht unterstützten Encodings. Neuere Arbeiten wie adaptives verlustfreies Gleitkomma-Encoding und neue logische Typen vergrößern die Lücke zwischen dem, was das Format ausdrücken kann, und dem, was jede Engine in Ihrem Stack verlässlich konsumiert.
Die Falle zeigt sich meist Monate nach dem Rollout
Die gefährlichen Fehler sind nicht immer laut. Manchmal liest eine Engine ein Feld wie erwartet, eine andere liefert Nullwerte, und eine dritte fällt auf einen langsameren Dekodierpfad zurück. Das fangen Sie in einem schnellen Smoke-Test nicht ab, wenn alle nur mit der Writer-Engine validieren.
Einige Fehlermuster tauchen immer wieder auf:
Abweichungen logischer Typen: Zeitstempel, Dezimalzahlen und verschachtelte Typen können über Reader hinweg unterschiedlich dargestellt werden.
Lücken bei der Encoding-Kompatibilität: Neuere Encodings können ältere Engines überraschen.
Dictionary-Fallback-Verhalten: Verschiedene Writer wechseln Strategien unterschiedlich, was Dateigröße und Scangeschwindigkeit beeinflusst.
Footer-zuerst-Latenz: Selbst winzige Lesevorgänge zahlen weiterhin die zuvor besprochenen Metadatenzugriffskosten.
Wenn Ihr Team Databricks-lastige Pipelines und Verbraucher über mehrere Engines betreut, wird ein eigener Ansatz für Datenqualität in Databricks relevant, weil Typdrift und Uneinigkeit zwischen Readern sich zuerst als Qualitätsvorfälle zeigen und nicht als Parser-Fehler.
Feature | Spark 3.5 | Trino 470 | DuckDB 1.2 | Athena |
|---|---|---|---|---|
Grundlegendes Parquet-Lesen | Breit unterstützt | Breit unterstützt | Breit unterstützt | Breit unterstützt |
Neuere Encodings | Pro Release prüfen | Pro Release prüfen | Pro Release prüfen | Pro Release prüfen |
Verschachtelte logische Typen | Meist machbar, sorgfältig testen | Sorgfältig testen | Sorgfältig testen | Sorgfältig testen |
Erhalt der Metadaten | Je nach Workflow unterschiedlich | Je nach Workflow unterschiedlich | Je nach Workflow unterschiedlich | Je nach Workflow unterschiedlich |
Fragen Sie nicht nur „Kann diese Engine Parquet lesen?“. Fragen Sie „Kann genau diese Reader-Version Dateien aus genau dieser Writer-Konfiguration sicher lesen?“
Schema-Drift, Timeliness und Observability für Parquet-Pipelines
Ein Parquet-Footer ist nicht nur Reader-Metadaten. In einer reifen Plattform wird er zu einer Observability-Fläche.

Schema-Drift kündigt sich meist zuerst in den Metadaten an
Wenn ein Writer eine Spalte ergänzt, einen Typ ändert, ein Feld entfernt oder das Sortierverhalten anpasst, erscheinen diese Änderungen in den Dateimetadaten, bevor nachgelagerte Dashboards die volle Tragweite zeigen. Das macht die Footer-Inspektion zur nützlichen Frühwarnung.
Häufige Drift-Signale sind:
Unerwartet nullable Felder: Eine neue Spalte erscheint, doch Konsumenten füllen sie nicht konsistent.
Typerweiterung: Ganzzahlartige Felder werden zu breiteren numerischen Typen und nachgelagerte Logik ändert ihr Verhalten.
Entfernte oder umbenannte Felder: Reader können weiterhin erfolgreich sein, doch die Geschäftslogik liest zunehmend leere Ergebnisse.
Partitionsabweichung: Verzeichnisbenennung und Dateischema erzählen nicht mehr dieselbe Geschichte.
Timeliness und Dateisemantik hängen zusammen
Parquet-Pipelines erzeugen außerdem eigene Frischeprobleme. Eine Tabelle kann im Speicher vorhanden wirken, während ein Teil der Dateien noch unvollständig, verspätet oder mit inkonsistenten Metadaten geschrieben ist. Streaming-Writer können Teilausgaben hinterlassen, die Konsumenten verwirren, wenn Ihre Plattform den Datensatz zu früh als „bereit“ markiert.
Deshalb überwachen Engineers mehr als die Ankunftszeit. Sie prüfen auch Dateianzahlen, Änderungszeitpunkte, Schemakonsistenz über Partitionen hinweg sowie Writer-Metadaten wie created_by und Sortierinformationen.
Ein Weg, das zu operationalisieren, ist Data-Lake-Monitoring, das Signale auf Datei- und Datensatzebene gemeinsam beobachtet, statt Speicher als Blackbox zu behandeln. In diesem Zusammenhang passt digna als eine Option für Teams, die Schemaänderungen, Timeliness, Anomalien und Validierung über Lake- und Warehouse-Pipelines hinweg in der eigenen Umgebung überwachen wollen.
Worauf Sie in der Produktion achten sollten
Würde ich eine neue Analytics-Engineerin in einen parquet-lastigen Lake einarbeiten, würde ich ihr sagen, mit vier Prüfungen zu beginnen:
Footer-Diffs zwischen Tagesladungen: Stille Schemaänderungen früh erkennen.
Wachstum kleiner Dateien je Partition: Abfrageschmerz beginnt oft hier.
Kompatibilitätsmatrix von Reader und Writer: Führen Sie eine ausdrückliche Liste je Engine-Version.
Timeliness gekoppelt an die vollständige Bereitschaft des Datensatzes: Alarmieren Sie nicht nur bei fehlenden Ordnern.
Die nützlichsten Parquet-Metadaten sind nicht dazu da, die Datei elegant zu machen. Sie sind dazu da, Ihnen Ärger zu zeigen, bevor Nutzer fragen, warum das Dashboard falsch aussieht.
Parquet funktioniert gut, wenn Ihr Workload zu seinem Entwurf passt, doch es braucht disziplinierte Überwachung, sobald mehrere Engines, Writer und nachgelagerte Konsumenten ins Spiel kommen. digna hilft Teams, Schemaänderung, Timeliness, Validierung und Datenverhalten in der eigenen Umgebung zu verfolgen, also genau dort, wo Probleme in Parquet-Pipelines zuerst auftauchen. Läuft Ihr Lakehouse auf Parquet und beginnen Ihre Vorfälle mit stillem Drift statt mit lauten Ausfällen, lohnt sich ein Blick.
Footer-Metadaten machen Schema-Drift früh sichtbar, aber jemand muss sie im Blick behalten — das ist die Aufgabe einer Data-Quality-Management-Schicht über dem Lake.
Häufig gestellte Fragen
Warum wurde Parquet zum spaltenorientierten Standardformat?
Parquet wurde zum Bindegewebe zwischen Spark-Pipelines, Warehouse-Exporten, Object-Storage-Lakes und Tabellenformaten wie Iceberg, Delta Lake und Hudi. Teams übernahmen es, weil es offen, typisiert und breit unterstützt ist und weil es physische Speicherung von der Engine-Wahl trennt — eine von einem Werkzeug geschriebene Datei bleibt für ein anderes lesbar.
Welche Encodings und Kompressions-Codecs unterstützt Parquet?
Parquet unterstützt Encodings auf Page-Ebene, darunter PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY und BYTE_STREAM_SPLIT, sowie Codecs wie SNAPPY, GZIP, BROTLI, ZSTD und LZ4_RAW. Encoding strukturiert Werte innerhalb einer Page um; die Komprimierung verkleinert danach den codierten Bytestrom. Wählen Sie den Codec danach, worauf Sie optimieren — Lesegeschwindigkeit, Speicherkosten oder Schreibdurchsatz.
Was ist Predicate Pushdown in Parquet?
Predicate Pushdown erlaubt einem Reader, Daten anhand von Metadaten zu überspringen, bevor er etwas davon dekodiert. Row-Group-Statistiken halten den Wertebereich fest, sodass ein Filter auf region = 'EMEA' Row Groups verwerfen kann, deren Statistiken keinen Treffer zulassen. Es wirkt zusammen mit Column Pruning, das zuerst ungenutzte Spalten entfernt.
Wie sollten Parquet-Dateien partitioniert und dimensioniert werden?
Partitionieren Sie nach Spalten, nach denen wirklich gefiltert wird — Partitionierung wirkt wie ein grobes Inhaltsverzeichnis, mit dem Reader ganze Ordner überspringen, bevor sie einen Footer öffnen. Bei der Größe erhöhen sehr kleine Dateien Listing- und Planungsaufwand, während sehr große die Parallelität senken und Retries teuer machen. Eine Sortierung nach einem selektiven Feld schärft die Row-Group-Statistiken.
Ist Schemaevolution in Parquet über Engines hinweg sicher?
Nur bis zu einem gewissen Punkt. Apaches Material zum Implementierungsstand zeigt eine nach Engine und Erscheinungsjahr fragmentierte Unterstützung, wobei manche neueren Features nur teilweise umgesetzt sind. Die gefährlichen Fehler sind die stillen: Eine Engine liest ein Feld korrekt, während eine andere Nullwerte liefert. Nur mit der Writer-Engine zu validieren verbirgt das über Monate.



