Das offene Tabellenformat Iceberg einfach erklärt
|
8
min. Lesezeit

Ihr Dashboard meldet, der gestrige Umsatz sei gefallen, doch das Problem liegt weniger offen. Eine Engine las ein Verzeichnis, bevor ein neuer Batch vollständig committet war, eine andere deutete eine Partition anders, und eine dritte sieht weiterhin ein älteres Schema. Die Dateien existieren, und dennoch kann die Tabelle keine verlässliche Antwort liefern.
Genau dieses Problem adressiert das offene Tabellenformat Iceberg. Es legt eine strukturierte Metadaten- und Transaktionsschicht über Daten in offenen Dateien und lässt Teams zugleich frei, Engines wie Spark, Flink, Trino oder Hive zu nutzen. Die wichtige Entscheidung 2026 lautet allerdings nicht nur, ob Iceberg ein gutes Tabellenformat ist. Sie lautet: welcher Katalog kontrolliert Metadaten, Richtlinien und Zugriffspfad über diese Engines hinweg.
Inhaltsverzeichnis
Im Inneren der Architektur des offenen Tabellenformats Iceberg
Transaktionsgarantien, Schemaevolution und Partitionierungsstrategien
Ökosystem-Integrationen, Migrationsmuster und Beispielabläufe
Best Practices, Performance-Tuning und Fehlersuche für die Produktion
Einführung in moderne Tabellenformate und warum sie zählen
Ein klassischer Data Lake beginnt oft damit, dass ein Ingestion-Job Parquet-Dateien in den Object Storage schreibt, ein Metastore einen Tabellenort erfasst und eine Query-Engine Dateien durch Durchsuchen von Ordnern entdeckt. Für rein anhängende Daten kann das funktionieren, doch operativer Druck stellt sich schnell ein.
Ein Produzent schreibt womöglich in das falsche Datumsverzeichnis. Ein Reparaturjob verändert womöglich Dateien, während eine Dashboard-Abfrage läuft. Eine Analystin liest womöglich eine Mischung aus alten und neuen Dateien. Ändert sich das Partitionslayout der Tabelle, müssen womöglich alle Produzenten und Konsumenten die Änderung manuell verstehen. Der Data Lake verhält sich dann weniger wie eine Datenbank und mehr wie ein geteilter Ordner mit undokumentierten Regeln.
Offene Tabellenformate verbessern diese Anordnung, indem sie eine Tabellenabstraktion über die Dateien legen. Sie verfolgen Schemata, Snapshots, Metadaten auf Dateiebene und Commits, sodass Query-Engines verstehen können, welche Dateien zu einer konsistenten Version der Tabelle gehören. Die Daten bleiben in offenen Speicherformaten, doch Nutzende gewinnen datenbankähnliches Verhalten.
Für digna-Kundinnen und -Kunden und ähnliche Unternehmensteams bedeutet Verlässlichkeit mehr als erfolgreiche Abfragen. Eine Reporting-Tabelle muss pünktlich eintreffen, die erwartete Struktur behalten, fachliche Validierungen bestehen und genug Historie offenlegen, um einen Vorfall zu untersuchen. Iceberg hilft, das transaktionale und strukturelle Fundament der Tabelle zu legen. Observability muss weiterhin um dieses Fundament herum arbeiten und prüfen, ob Daten ankamen, ob sich Werte unerwartet änderten und ob nachgelagerte Konsumenten kompatibel bleiben. Teams, die das breitere Konzept erkunden, können diese Übersicht zu offenen Tabellenformaten als zusätzlichen Kontext nutzen.
Praxisregel: Behandeln Sie ein offenes Tabellenformat als Verlässlichkeitsschicht für Dateien, nicht als vollständige Governance-Plattform.
Apache Iceberg entstand 2017 bei Netflix, um Skalierungs- und Konsistenzprobleme in Hive-artigen Tabellen anzugehen. Netflix spendete es im November 2018 an die Apache Software Foundation, und das Projekt erreichte im Mai 2020 den Top-Level-Status bei Apache. Die Spezifikation setzte sich über das stabile Release 1.0.0 im Oktober 2022 und das Release 1.6.1 im August 2024 fort, gemäß der Projektgeschichte von Apache Iceberg.
Dieser Leitfaden beginnt beim grundlegenden Tabellenmodell und geht dann durch Icebergs Metadatenarchitektur, transaktionales Verhalten, Formatvergleiche, Migrationsmuster und Produktionsbetrieb. Der abschließende Fokus liegt auf Governance, denn die Dateispezifikation ist nur ein Teil einer Unternehmensdatenplattform.
Was ein offenes Tabellenformat ist und wie es funktioniert
Stellen Sie sich einen rohen Data Lake als Lagerhalle voller beschrifteter Kisten vor. Die Parquet-Dateien sind die Kisten, Ordner sind grobe Lagerbereiche, und eine Query-Engine ist eine Arbeitskraft, die nach den Kisten sucht, die eine Antwort enthalten könnten. Ohne verlässliches Inventar sucht sie womöglich zu viel, übersieht relevante Dateien oder kombiniert Kisten aus unvereinbaren Lieferungen.
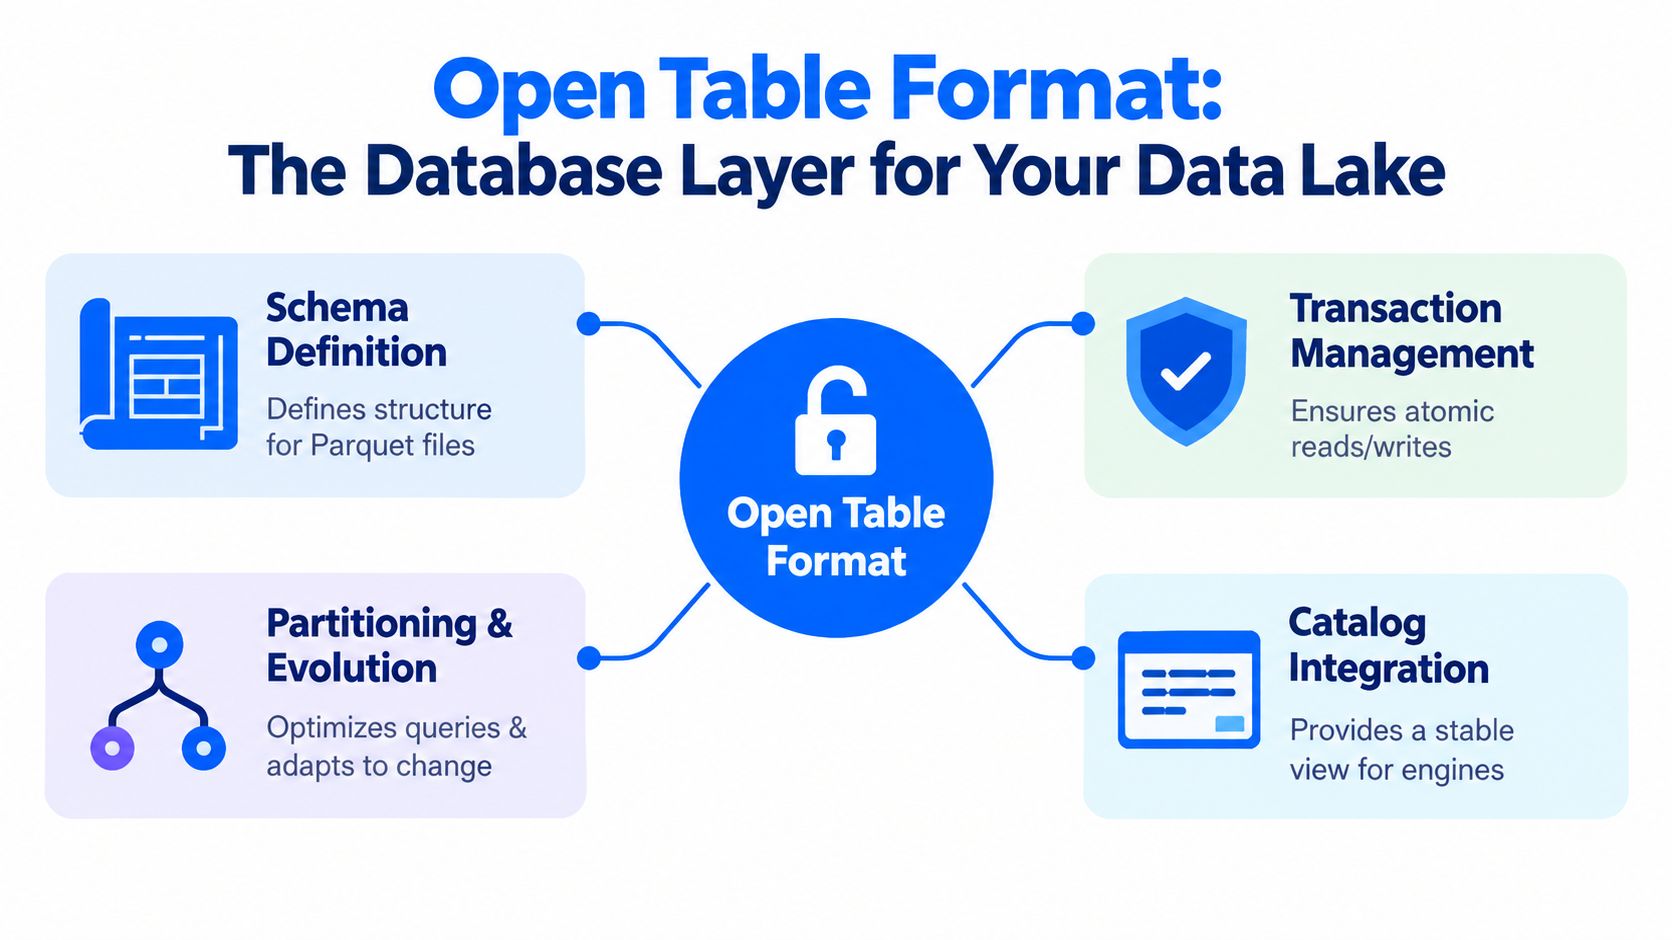
Ein offenes Tabellenformat ergänzt dieses Inventar und einen Satz Regeln. Es umfasst meist drei verbundene Schichten:
Datendateien halten die eigentlichen Datensätze, häufig in spaltenorientierten Formaten wie Parquet.
Tabellenmetadaten beschreiben Schemata, Snapshots, Dateien, Statistiken und Partitionsinformationen.
Ein Katalog gibt Engines einen stabilen Weg, die aktuellen Tabellenmetadaten zu finden und Zugriffsrichtlinien anzuwenden.
Diese dritte Schicht wird leicht unterschätzt. Das Format definiert, wie der Tabellenzustand dargestellt wird, während der Katalog definiert, wie Engines diesen Zustand finden. Ein Spark-Job, eine Flink-Pipeline und eine Trino-Abfrage können nur dann mit derselben Tabelle arbeiten, wenn sie die Tabelle über einen kompatiblen Katalog auflösen und die relevante Formatversion deuten können.
Von Dateien zur verwalteten Tabelle
Angenommen, eine Pipeline empfängt Verkaufsdatensätze. Sie schreibt Parquet-Datendateien in den Object Storage, legt sie aber nicht in einen Datumsordner und hofft, dass jeder Leser das Layout versteht. Iceberg erfasst die Dateien in Manifesten, verknüpft sie mit einem Tabellen-Snapshot und veröffentlicht einen neuen Metadatenzustand über den Katalog.
Ein Reader ermittelt zuerst den aktuellen Tabellenzustand. Dann nutzt er Metadaten zur Planung des Scans und wählt nur Dateien aus, die passende Datensätze enthalten könnten. Das unterscheidet sich davon, die Engine jedes Objekt listen und jede Datei prüfen zu lassen.
Das Wort offen bezieht sich auf mehr als quelloffenen Code. Ein offenes Tabellenformat will eine dokumentierte Spezifikation bieten, die mehrere Engines umsetzen können. Icebergs Spezifikation ist durch formale Versionen fortgeschritten. Die Apache-Dokumentation hält fest, dass die Versionen 1, 2 und 3 vollständig und von der Community angenommen sind, während Version 4 in aktiver Entwicklung bleibt. Die Dokumentation nennt außerdem 1.11.0 als neueste Dokumentationsversion im Jahr 2026, was fortgesetzte Investitionen in die Iceberg-Spezifikation und -Dokumentation widerspiegelt.
Offenheit senkt die Abhängigkeit von einer Query-Engine, beseitigt aber nicht automatisch anbieterspezifisches Verhalten. Reader und Writer brauchen weiterhin kompatible Funktionsunterstützung, und der Katalog kann eigene Richtlinien, Anmeldedaten oder Governance-Regeln anwenden. Diese Unterscheidung wird zentral, sobald mehrere Engines Produktionstabellen teilen.
Im Inneren der Architektur des offenen Tabellenformats Iceberg
Icebergs Architektur versteht man am leichtesten vom Katalog abwärts. Der Katalog verweist auf die aktuelle Metadatendatei. Diese Metadaten benennen den aktiven Snapshot und verbinden die Tabelle mit einer oder mehreren Manifestlisten. Manifestlisten verweisen auf Manifestdateien, und Manifeste beschreiben die dem Snapshot verfügbaren Datendateien.

Einem Tabellenlesevorgang folgen
Ein vereinfachter Lesevorgang sieht so aus:
Die Engine fragt den Katalog nach dem aktuellen Metadatenort der Tabelle.
Die Metadatendatei benennt den aktuellen Snapshot.
Der Snapshot verweist auf eine Manifestliste.
Die Manifestliste benennt Manifestdateien.
Die Engine wertet Manifesteinträge aus und liest passende Datendateien.
Die Daten selbst bleiben in Dateien wie Parquet. Wer eine separate Erläuterung des zugrunde liegenden Speicherformats sucht, findet in diesem Parquet-Leitfaden nützlichen Hintergrund. Icebergs Beitrag ist die Organisation auf Tabellenebene rund um diese Dateien.
Manifeste speichern Partitionswerte für Datendateien. Enthält eine Abfrage ein Prädikat, kann die Engine dieses mit den Partitionstupeln vergleichen und Dateien verwerfen, die nicht passen können. Das ist metadatengetriebenes Pruning. Die Engine wendet weniger Aufwand auf, um irrelevante Dateien zu öffnen, und die Planung hängt nicht davon ab, Verzeichnisnamen manuell zu deuten.
Iceberg unterstützt außerdem Hidden Partitioning. Ein Produzent kann einen Zeitstempel schreiben, während die Tabelle intern eine Partitionstransformation anwendet, etwa das Ableiten eines Datums oder das Kürzen eines Werts. Produzenten und Konsumenten müssen keine separate Partitionsspalte direkt verwalten, was Fehler durch uneinheitliche Partitionsausdrücke reduziert.
Warum Snapshots zählen
Jeder Schreibvorgang erzeugt einen neuen Snapshot. Ein Reader löst einen Snapshot auf und plant gegen diesen konsistenten Zustand, statt eine Tabelle zu beobachten, während Dateien hinzukommen oder entfernt werden. Dieser Entwurf trägt Snapshot-Isolation sowie serialisierbare, atomare Tabellenänderungen, sodass Reader keine teilweisen oder nicht committeten Schreibvorgänge sehen.
Das Snapshot-Modell ermöglicht auch Time Travel. Eine Analystin, die eine Dashboard-Abweichung untersucht, kann einen früheren Tabellenzustand abfragen, sofern die betreffenden Snapshots und Dateien noch vorhanden sind. Das macht historische Untersuchungen präziser, als sich auf kopierte Auszüge oder manuell aufbewahrte Ordner zu stützen.
Die Performance-Dokumentation von Apache Iceberg hält fest, dass die Metadatenarchitektur selbst Multi-Petabyte-Tabellen von einem einzelnen Knoten aus lesbar machen kann, ohne dass eine verteilte SQL-Engine allein zum Durchsieben der Tabellenmetadaten nötig wäre. Dieselbe Dokumentation nennt Fälle mit einer zehnfachen Leistungsverbesserung, wie in der Iceberg-Performance-Dokumentation beschrieben. Die praktische Lehre lautet, dass Metadatenentwurf die Planungskosten ebenso beeinflussen kann wie das Dateilayout die Scankosten.
Transaktionsgarantien, Schemaevolution und Partitionierungsstrategien
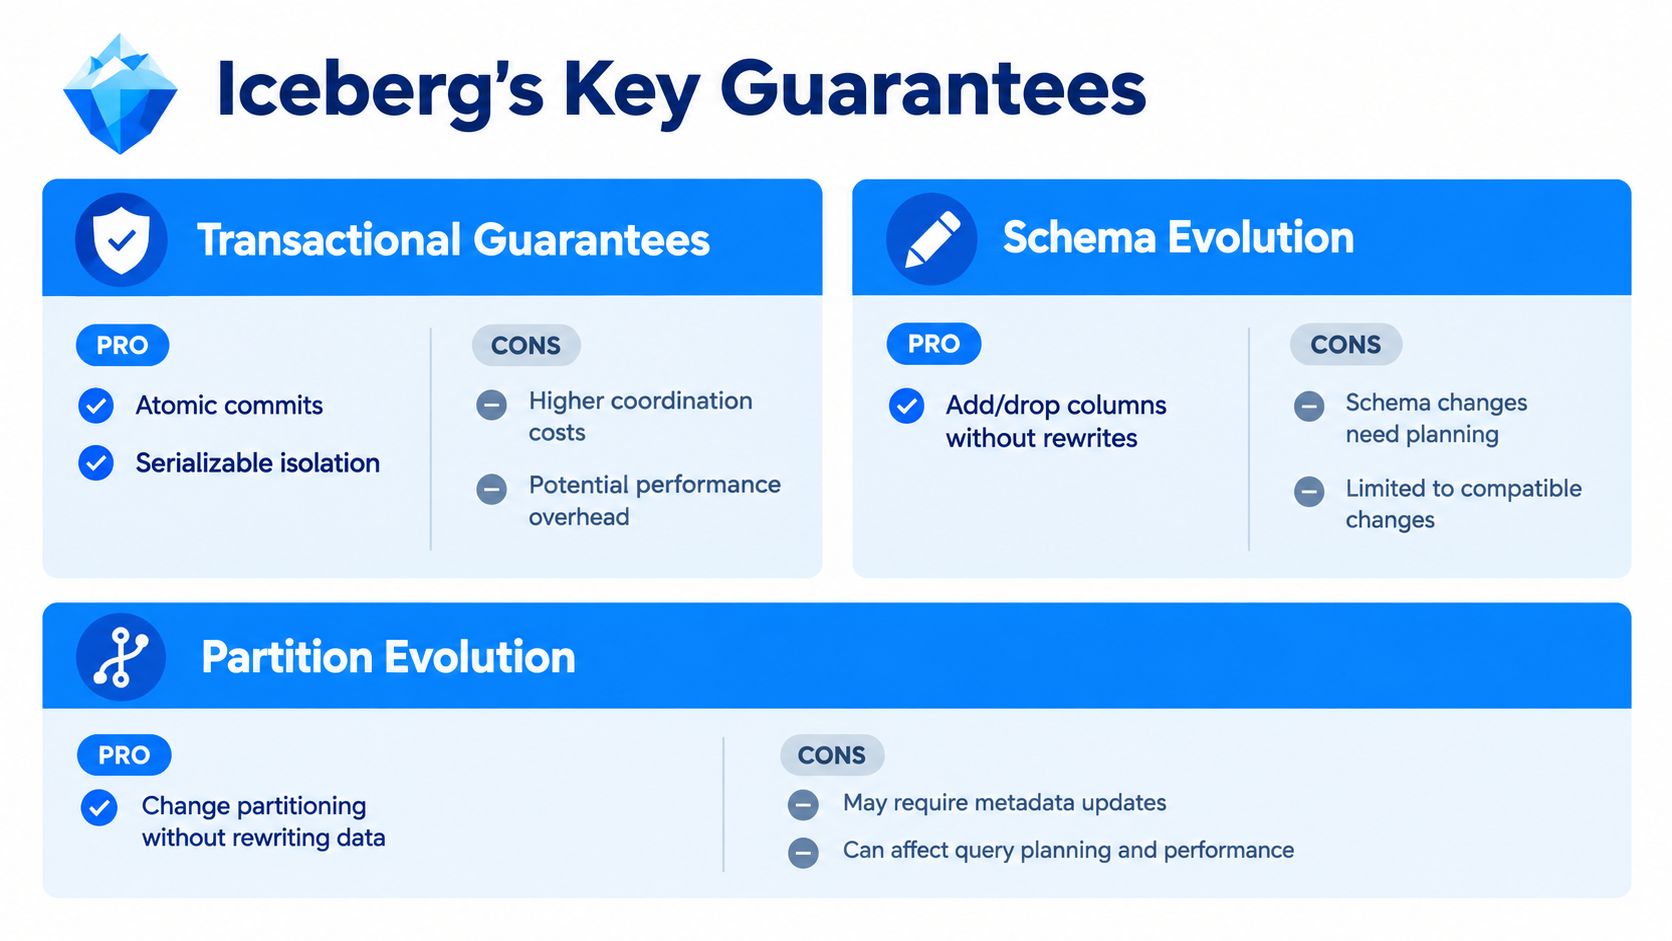
Icebergs Wert wird klarer, wenn sich eine Tabelle ändert, während Menschen und Pipelines sie weiter nutzen. Ein Writer veröffentlicht keinen halbfertigen Tabellenzustand. Er bereitet einen neuen Snapshot vor und committet diesen Zustand atomar. Reader sehen weiterhin den vorherigen committeten Snapshot, bis der neue sichtbar wird.
Das gibt Teams Snapshot-Isolation und serialisierbare Tabellenänderungen. Nebenläufige Writer brauchen weiterhin eine Konfliktstrategie, und ein fehlgeschlagener Commit kann Retry-Logik erfordern, doch Reader kombinieren keinen unvollständigen Schreibvorgang versehentlich mit einem älteren Tabellenzustand.
Änderungen ohne Neuschreiben der Daten
Iceberg unterstützt Schemaevolution wie das Hinzufügen, Entfernen, Umbenennen und Umordnen von Spalten, ohne bestehende Datendateien neu zu schreiben. Die Metadaten verfolgen das logische Schema, sodass eine Spaltenumbenennung nicht bedeuten muss, jede historische Datei physisch neu zu schreiben.
Diese Fähigkeit macht Disziplin nicht überflüssig. Ein umbenanntes Feld kann nachgelagerte Werkzeuge verwirren, die Spalten über den Namen identifizieren, und ein entferntes Feld kann Berichte oder Modelle beeinträchtigen. Schemakompatibilitätsprüfungen und Benachrichtigungen an Konsumenten bleiben wichtig, besonders wenn verschiedene Engines Formatfunktionen unterschiedlich weit unterstützen. Ein System zur Schemaverfolgung wie digna Schema Tracker kann neben der Tabelle sitzen und strukturelle Änderungen erkennen, bevor sie zu nachgelagerten Vorfällen werden.
Partitionsevolution folgt einem ähnlichen Prinzip. Iceberg behandelt eine Änderung der Partitionsspezifikation als Metadatenoperation. Alte Dateien bleiben in ihrem bestehenden Layout, während neue Dateien die aktualisierte Spezifikation nutzen. Teams können die Partitionierung an neue Zugriffsmuster anpassen, ohne die gesamte historische Tabelle neu zu schreiben oder offline zu nehmen.
Hidden Partitioning bedacht wählen
Hidden Partitioning ist nützlich, wenn Teams physische Organisation wollen, ohne jedem Produzenten die Partitionsmechanik offenzulegen. Ein Zeitstempelfeld kann datumsbasiertes Pruning tragen, ohne dass jeder Ingestion-Job eine passende Partitionsspalte korrekt befüllen muss.
Es gibt einen Kompromiss. Nach einer Partitionsevolution kann eine Tabelle Dateien enthalten, die unter verschiedenen Spezifikationen geschrieben wurden. Iceberg kann über diese Historie hinweg planen, doch Betreiber müssen weiterhin beobachten, ob altes und neues Layout ungleiches Scanverhalten erzeugen. Partitionsänderungen sollten beobachteten Abfragemustern folgen und kein Ersatz dafür sein, den Zugriff auf den Workload zu verstehen.
Löschvorgänge auf Zeilenebene
Iceberg-Format v2 unterstützt Löschvorgänge auf Zeilenebene über separate Delete-Dateien, statt vollständige Datendateien neu zu schreiben. Positionelle Deletes identifizieren eine Zeile über Dateipfad und Zeilenposition. Equality-Deletes identifizieren Zeilen über passende Spaltenwerte, was Update- und Delete-Abläufe mit geringerer Schreibverstärkung tragen kann, wie in dieser Erläuterung zu Iceberg-Löschvorgängen auf Zeilenebene beschrieben.
Delete-Dateien bringen Wartungsüberlegungen mit sich. Abfragen müssen womöglich Basisdaten und Löschinformationen zusammenführen, und Kompaktierung oder Rewrite-Vorgänge konsolidieren das Layout später möglicherweise. Das Format senkt die unmittelbare Rewrite-Last, beseitigt aber nicht das Lebenszyklusmanagement.
Iceberg, Delta Lake und Hudi für Ihr Lakehouse vergleichen
Iceberg, Delta Lake und Hudi adressieren alle die Lücke zwischen unverwalteten Datendateien und datenbankähnlichem Tabellenverhalten. Die richtige Wahl hängt vom Workload, den Engines, der Katalogstrategie und den operativen Diensten ab, die Ihr Team zu betreiben bereit ist.
Kriterien | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Primäre Passung | Engine-übergreifende analytische Tabellen und offene Interoperabilität | Starke Ausrichtung auf das Databricks-Ökosystem | Update-lastige und streaming-orientierte Lakehouse-Workloads |
Metadatenmodell | Architektur aus Snapshot, Manifestliste und Manifest | Entwurf rund um ein Transaktionslog | Entwurf rund um Zeitachse und Tabellendienste |
Schemaevolution | Unterstützt Änderungen wie Hinzufügen, Entfernen, Umbenennen und Umordnen | Unterstützt Schemaevolution, wobei das Verhalten von Laufzeit und Funktionsunterstützung abhängt | Unterstützt breite Fähigkeiten zur Schemaevolution |
Partitionsstrategie | Hidden Partitioning und reine Metadaten-Partitionsevolution | Partitionsverwaltung hängt von Tabellen- und Plattformkonfiguration ab | Nutzt Partitionierung plus Clustering und Tabellendienste |
Zeilenänderungen | v2-Delete-Dateien mit positionellen und Equality-Deletes | Updates und Deletes über Delta-Operationen | Starke Unterstützung für Upserts, Deletes und inkrementelle Abläufe |
Engine-Wahl | Auf breite Engine-Interoperabilität ausgelegt | Besonders natürlich in Databricks-Deployments | Starke Spark- und Streaming-Integration, mit breiterer Ökosystem-Unterstützung |
Katalogfrage | Der Katalog ist zentral für Auffindbarkeit und Governance | Katalog und Plattformdienste beeinflussen die Offenheit stark | Der Katalog ist für den einfachen Tabellenbetrieb womöglich weniger zentral, doch Governance braucht weiterhin umgebende Dienste |
Diese Beschreibungen sind architektonische Orientierung, kein universeller Benchmark. Die Abfragegeschwindigkeit hängt von Dateigrößen, Datenverteilung, Sortierreihenfolge, Kompaktierung, Engine-Versionen, Workload-Form und Katalogimplementierung ab. Ein Plattformteam sollte repräsentative Lese- und Schreibvorgänge testen, statt allein nach Funktions-Häkchen zu wählen.
Das Format am Betriebsmodell ausrichten
Wählen Sie Iceberg, wenn mehrere Engines Tabellen teilen müssen und das Team eine breit spezifizierte Tabellenschicht mit Hidden Partitioning und unabhängiger Evolution schätzt. Wählen Sie Delta Lake, wenn tiefe Databricks-Integration, native Plattformdienste und ein einheitliches Anbieter-Betriebsmodell schwerer wiegen als der Bedarf an breiterer Katalogneutralität.
Hudi verdient Beachtung, wenn häufige Updates, Change Capture, inkrementelle Verarbeitung oder Streaming-Ingestion den Entwurf bestimmen. Sein Ansatz umfasst Speicher-Engine- und Tabellenverwaltungsfähigkeiten, die prägen können, wie die Plattform Indizierung, Kompaktierung und Ingestion handhabt.
Die wichtigere Frage liegt oft außerhalb der Dateispezifikation. Ein Governance-Team braucht einen Ort, um Namensräume, Eigentum, Klassifizierung, Berechtigungen und Prüfhistorie zu verwalten. Iceberg liefert Tabellentransaktionen und Metadaten, bietet aber für sich genommen kein vollständiges engine-übergreifendes Richtliniensystem. Teams, die Iceberg neben Databricks-Workloads bewerten, können außerdem Überlegungen zur Datenqualität in Databricks durchgehen, besonders dort, wo Plattformkontrollen und Verlässlichkeitsprozesse aufeinandertreffen.
Ökosystem-Integrationen, Migrationsmuster und Beispielabläufe
Iceberg fügt sich über zwei Schnittstellen in ein Lakehouse ein: Speicher und Katalog. Spark oder Flink erzeugen womöglich die Daten, Trino oder Hive fragen sie ab, und Object Storage hält die Dateien. Der Katalog bindet diese Aktivitäten an eine Tabellenidentität und legt die Metadaten offen, die jede kompatible Engine braucht.
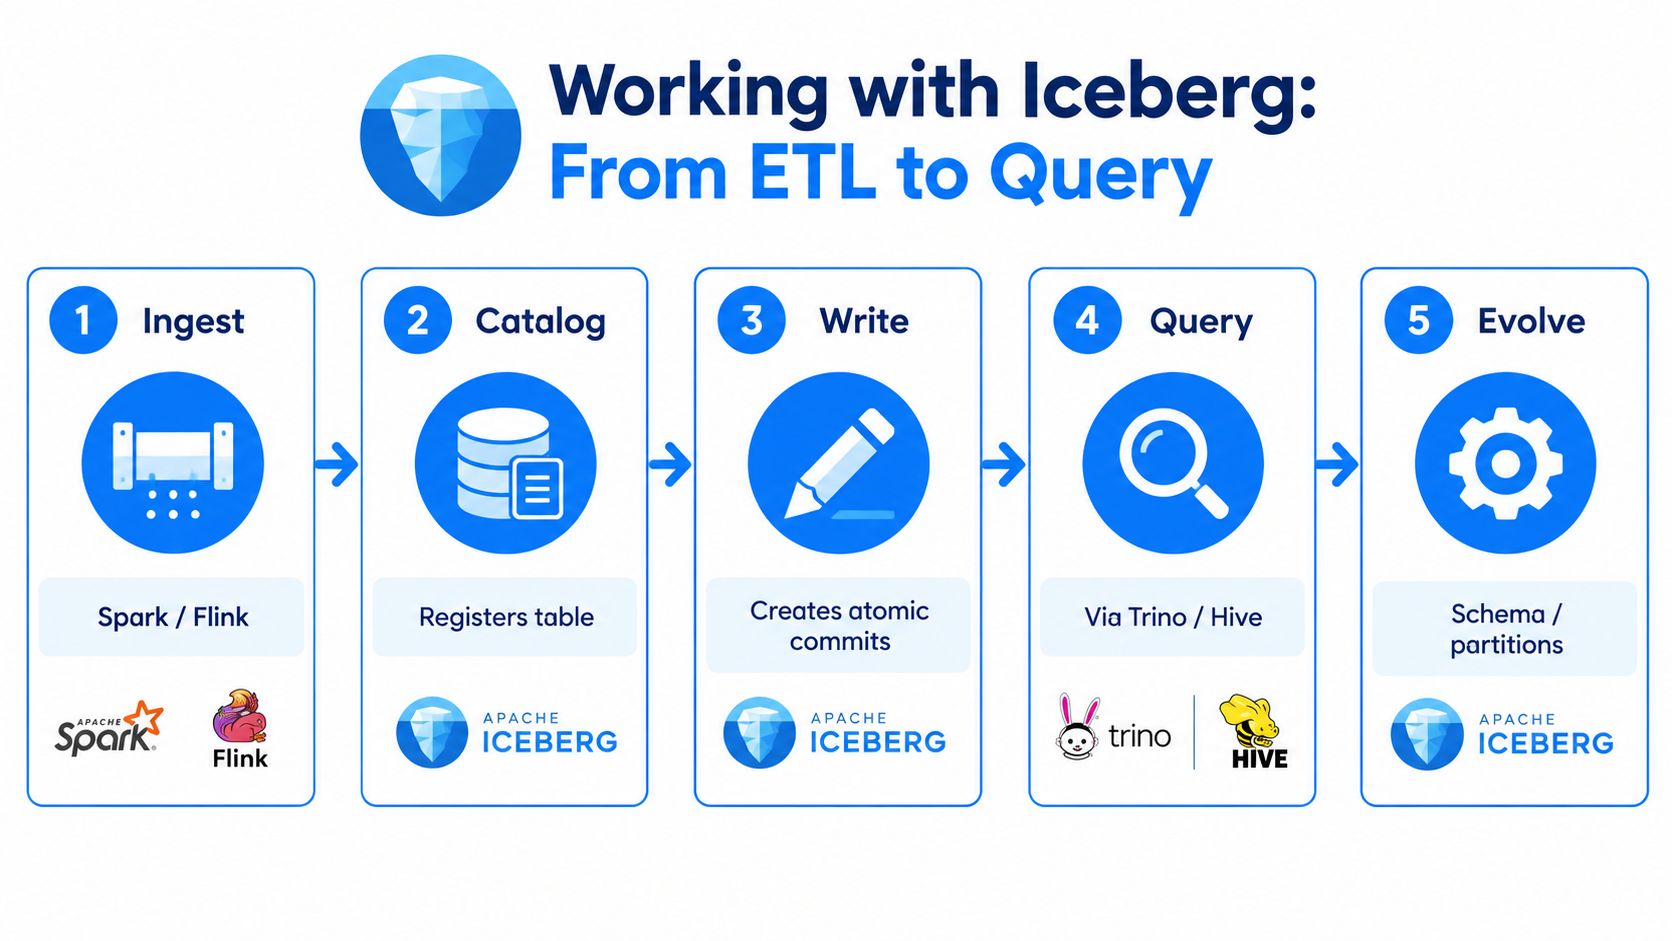
Ein repräsentativer Ablauf sieht so aus:
Ingest: Spark oder Flink empfängt Batch- oder Streaming-Datensätze.
Katalog: Die Tabelle wird über einen Katalog wie Hive Metastore, AWS Glue Catalog oder einen Iceberg-REST-Katalog registriert.
Schreiben: Die Engine erzeugt Datendateien und veröffentlicht einen atomaren Snapshot.
Abfragen: Trino, Hive, Spark oder eine andere kompatible Engine löst die Tabelle über den Katalog auf.
Weiterentwickeln: Die verantwortliche Person ändert Schema oder Partitionsspezifikation, während sich der Workload entwickelt.
Die genaue Syntax variiert je Engine, doch die Konzepte bleiben stabil. Ein SQL-Ablauf könnte eine Tabelle mit explizitem Schema anlegen, Datensätze einfügen, eine Spalte ändern und einen früheren Snapshot abfragen. Ein Spark-Job könnte Icebergs DataFrameWriterV2-Schnittstelle nutzen, während Flink seinen Iceberg-Sink und die Katalogkonfiguration verwendet.
Migration ohne Kontrollverlust
Eine Migration von Hive zu Iceberg kann verschiedene Wege gehen. Teams können bestehende Daten konvertieren und über Iceberg-Metadaten registrieren, oder sie schreiben Dateien neu, um das Layout zu verbessern, Schemata zu vereinheitlichen und alte Partitionsannahmen zu entfernen. Metadatenkonvertierung kann Störungen verringern, während ein Rewrite die Gelegenheit schafft, Datendateien zu optimieren. Die Wahl hängt vom Zustand der bestehenden Tabelle und der Bereitschaft zur Migrationsarbeit ab.
Eine Migration von Delta zu Iceberg erfordert dieselbe Sorgfalt, mit zusätzlicher Aufmerksamkeit für Transaktionshistorie, nicht unterstützte Funktionen, Deletes, generierte Spalten und nachgelagerte Abhängigkeiten. Ein Migrationsplan sollte Reader und Writer inventarisieren, bevor die Verantwortung für die Tabelle wechselt. Der Leitfaden zur Planung von Datenmigrationen kann helfen, Abhängigkeiten, Validierung und Rollout-Entscheidungen zu ordnen.
Observability rund um die Tabelle
Icebergs Snapshots sagen Ihnen, welcher Tabellenzustand committet wurde. Sie sagen nicht, ob eine Quelle die erwarteten Datensätze geliefert hat, ob fachliche Werte plausibel sind oder ob eine Kennzahl im Dashboard ihr normales Verhalten verlassen hat. Diese Prüfungen gehören in das umgebende Verlässlichkeitssystem.
Ein Team kann zum Beispiel Satzregeln nach einem Snapshot-Commit validieren, die Ankunftszeit jedes erwarteten Ladevorgangs verfolgen, aktuelle Kennzahlen mit historischem Verhalten vergleichen und Schemaänderungen melden, bevor BI-Modelle scheitern. Die Prüfungen können an Ort und Stelle gegen die Tabelle laufen, ohne die zugrunde liegenden Daten in einen separaten Monitoring-Speicher zu kopieren.
Best Practices, Performance-Tuning und Fehlersuche für die Produktion
Der produktive Iceberg-Betrieb dreht sich darum, Metadaten, Dateien, Snapshots und Richtlinien gemeinsam gesund zu halten. Eine Tabelle kann transaktional korrekt bleiben und dennoch teuer abzufragen werden, weil sie zu viele kleine Dateien, veraltete Snapshots oder überlappende Layouts aus mehreren Partitionsspezifikationen enthält.
Beginnen Sie mit der Dateiverwaltung. Beobachten Sie die Entstehung kleiner Dateien, kompaktieren Sie kompatible Dateien und wählen Sie Schreibeinstellungen, die praktikable Dateigrößen für die bedienenden Engines erzeugen. Kompaktierung sollte Belegen aus dem Workload folgen. Eine Tabelle für häufige inkrementelle Lesevorgänge braucht womöglich einen anderen Wartungsrhythmus als eine Tabelle für gelegentliche analytische Scans.
Metadaten verdienen eigenes Monitoring. Verfolgen Sie Manifestwachstum, Planungslatenz, Snapshot-Anhäufung und Muster fehlgeschlagener Commits. Lassen Sie Snapshots gemäß Wiederherstellungs- und Prüfanforderungen ablaufen und bereinigen Sie verwaiste Dateien erst, nachdem Sie bestätigt haben, dass kein aktiver Snapshot oder externer Prozess noch von ihnen abhängt.
Betriebsregel: Wartung ist kein Hausputz. Sie ist Teil des Abfrage- und Wiederherstellungsentwurfs der Tabelle.
Die Fehlersuche wird systematischer, wenn Symptome auf Schichten abgebildet werden:
Langsame Planung: Prüfen Sie Manifestanzahl, Metadatenwachstum und Antwortzeit des Katalogs, bevor Sie die Query-Engine verantwortlich machen.
Langsame Scans: Prüfen Sie die Wirksamkeit des Pruning, Dateigrößen, Datenverteilung und ob evolvierte Partitionsspezifikationen ungleiche Layouts erzeugen.
Fehlende Datensätze: Vergleichen Sie das erwartete Ingestion-Fenster mit dem committeten Snapshot und validieren Sie die Quelllieferung separat.
Schemafehler: Bestimmen Sie den Writer, der das Schema geändert hat, und prüfen Sie dann Reader-Kompatibilität und nachgelagerte Annahmen.
Commit-Konflikte: Prüfen Sie nebenläufige Writer, Retry-Verhalten und Wartungsjobs, die um dieselbe Tabelle konkurrieren könnten.
Unerwartetes Speicherwachstum: Untersuchen Sie aufbewahrte Snapshots, Delete-Dateien, fehlgeschlagene Schreibvorgänge und verwaiste Datendateien.
Formatupgrades brauchen einen Rollout-Plan. Iceberg-Versionswechsel erfolgen tabellenweise auf Wunsch, sodass ältere Tabellen neben neueren bestehen können. Die Ökosystem-Umfrage zu Apache Iceberg 2025 berichtete, dass 78,6 % der Befragten Iceberg unter den offenen Tabellenformaten ausschließlich nutzen, während eine unabhängige Unternehmensstudie 58 % mit Iceberg für geschäftskritische Analytik, 95 % mit Nutzung oder Nutzungsplanung für KI/ML und 79 % mit Verlagerung oder geplanter Verlagerung der restlichen Daten nach Iceberg binnen zwölf Monaten nannte. Diese Zahlen stammen aus der Zusammenfassung der Umfrage „State of the Apache Iceberg Ecosystem“ 2025 und signalisieren Dynamik, nicht den Beweis, dass jede Organisation den Betrieb gemischter Versionen gelöst hätte.
Die nächste Planungsfrage ist Iceberg v3, mit Fähigkeiten wie Row Lineage, Deletion Vectors und neuen logischen Typen. Testen Sie Reader und Writer gemeinsam, definieren Sie Kompatibilitätsschranken und aktualisieren Sie repräsentative Tabellen vor dem breiten Rollout. Das Format mag offen sein, doch eine Landschaft kann dennoch verborgene Verlässlichkeitsschulden ansammeln, wenn Kataloge, Engines und Governance-Richtlinien unterschiedlich schnell weiterziehen.
Der Katalog sollte mit gleicher Sorgfalt gewählt werden. Iceberg liefert ACID-Verhalten, Schemaevolution und Time Travel, während Lineage, Klassifizierung, Zugriffskontrolle und einheitliche Prüfpfade vom Katalog und Governance-Stack abhängen. Databricks kündigte Managed Iceberg, Iceberg v3 und Foreign Iceberg als allgemein verfügbar im Unity Catalog zum 28. Mai 2026 an, während Snowflake Polaris in den Horizon Catalog für Iceberg-REST-Interoperabilität einbettete, wie in den Materialien zur Apache-Iceberg-Spezifikation beschrieben. Diese Bewegungen im Ökosystem bekräftigen die zentrale Entscheidung: Engine-übergreifende Offenheit hängt nicht nur von den Tabellendateien ab, sondern auch davon, wer Metadatenzugriff und Richtliniendurchsetzung kontrolliert.
digna läuft in Ihrer eigenen Umgebung und verbindet Schema-Tracking, Timeliness-Überwachung, Validierung in der Datenbank, Anomalieerkennung und Data Platform Observability rund um kritische Tabellen und Pipelines. Besuchen Sie digna, um zu sehen, wie Ihr Team Iceberg-basierte Analytik überwachen kann, ohne Produktionsdaten zu bewegen.
Die meisten produktiven Iceberg-Vorfälle entpuppen sich als Wertprobleme im Metadaten-Kostüm, planen Sie also Data Quality Management parallel zur Migration ein.
Häufig gestellte Fragen
Welches Problem löst Iceberg?
Es verhindert, dass verschiedene Engines uneins darüber sind, was eine Tabelle enthält. Ohne Tabellenformat kann eine Engine ein Verzeichnis lesen, bevor ein Batch vollständig committet ist, eine andere eine Partition anders deuten und eine dritte weiterhin ein älteres Schema sehen, während jede beteiligte Datei vollkommen gültig ist.
Wie ist eine Iceberg-Tabelle aufgebaut?
Iceberg führt eine Metadatenkette: Ein Katalogeintrag verweist auf eine Metadatendatei, die den aktuellen Snapshot beschreibt, dieser Snapshot verweist auf eine Manifestliste, und Manifeste zählen Datendateien mit ihren Statistiken auf. Jeder Commit schreibt neue Metadaten, statt die alten zu verändern, und genau das macht Rollback günstig.
Unterstützt Iceberg nebenläufige Writer?
Ja, über optimistische Nebenläufigkeit. Jeder Writer bereitet seine Änderungen vor und versucht dann, den Metadatenzeiger der Tabelle zu tauschen; ist zuvor ein anderer Commit gelandet, versucht er es gegen den neuen Zustand erneut. Konkurrierende Schreibvorgänge auf dieselben Dateien scheitern laut, statt einander still zu überschreiben.
Welche Engines arbeiten mit Iceberg?
Spark, Trino, Flink, Dremio, Snowflake und BigQuery lesen Iceberg unter anderen, doch die Funktionsabdeckung unterscheidet sich: Manche Engines lesen, schreiben aber nicht, und neuere Fähigkeiten landen ungleichmäßig. Bestätigen Sie, dass die konkret benötigten Operationen von jeder Engine in Ihrem Stack unterstützt werden, nicht nur von der, mit der Sie testen.
Was geht mit Iceberg in der Produktion meist schief?
Kleine Dateien und nicht abgelaufene Snapshots, in dieser Reihenfolge. Streaming oder häufige Batch-Schreibvorgänge erzeugen viele kleine Datendateien und eine lange Metadatenkette, was die Planung verlangsamt, bis Kompaktierung und Snapshot-Ablauf planmäßig laufen. Keines von beidem verschlechtert die Korrektheit, weshalb sich das Symptom als schleichend steigende Abfragelatenz zeigt.



