ETL-Datenqualität: Ein praktischer Leitfaden für zuverlässige Pipelines
|
6
min. Lesezeit

Ihre Pipeline wurde um 2:14 Uhr grün. Bis zum Frühstück starrt die Finanzabteilung auf Umsatzzeilen, die keinen Sinn ergeben, Analysten fragen sich, ob das Warehouse defekt ist, und Ihr Orchestrierungstool behauptet weiterhin steif und fest, dass alles erfolgreich war. Diese Lücke zwischen Job-Health und Data-Health ist der Punkt, an dem die ETL-Datenqualität in der Praxis meist scheitert.
Der schwierige Teil ist nicht das Ausführen von Prüfungen. Es geht darum, Kontrollen zu entwerfen, die bemerken, wenn sich das Verhalten der Daten geändert hat, und nicht nur, wenn eine Aufgabe fehlgeschlagen ist. ETL-Pipelines können pünktlich abgeschlossen werden, Zeilenanzahlen erreichen und dennoch korrumpierte, veraltete oder strukturell inkompatible Daten nachgelagert übertragen. Deshalb muss die Qualität an den Daten selbst gemessen werden, nicht an dem Erfolgs-Flag, das dem Job beigefügt ist.
Inhaltsverzeichnis
Die fünf Qualitätsdimensionen, die jede ETL-Pipeline überwachen muss
Regelbasierte Validierung versus KI-gestützte Anomalieerkennung
Validierungsmechaniken auf Datensatzebene, die Fehler abfangen
Schema-Drift und wie man ihn erkennt, bevor nachgelagerte Systeme brechen
Aufbau eines geschichteten ETL-Qualitäts-Stacks in der Praxis
Häufige Missverständnisse und eine praktische Qualitäts-Checkliste
Wenn grüne Pipelines fehlerhafte Daten produzieren
Ein grüner Durchlauf kann völlig in Ordnung aussehen, bis jemand das Dashboard öffnet und Zahlen sieht, die nicht mit der Realität übereinstimmen. Die ETL-Schicht kann erfolgreich abgeschlossen werden, während ein Quellsystem ein Dezimalfeld ändert, eine Datei halbleer landet oder eine Typkonvertierung gültige Werte in etwas verwandelt, das zwar geladen wird, aber nicht mehr das bedeutet, was es einmal bedeuten sollte. Bis die Finanzabteilung, der Betrieb oder die BI-Abteilung das Problem bemerkt, ist der Pipeline-Vorfall bereits Schnee von gestern und die Bereinigung hat sich nachgelagert verlagert.
Die historische ETL-Forschung zeigt schonungslos, woher diese Fehler kommen. Eine Studie über ETL-Bereitstellungen ergab, dass das vorzeitige Scheitern von ETL-Jobs, gesperrte Systeme während der Ausführung und das Nichtauffinden von Daten im Ziel, weil Primärschlüssel falsch transformiert wurden, zu den häufigsten Problemen gehörten. Dieselben Prozesse verursachten Probleme bei der Genauigkeit, Timeliness, Glaubwürdigkeit und darstellerischen Konsistenz (ETL-Datenqualitäts-Fehlerstudie). Die Lektion ist einfach. Die Pipeline selbst kann den Fehler einführen, selbst wenn das Quellsystem in Ordnung aussah.
Warum der Ausführungsstatus nicht ausreicht
Orchestrationstools melden meistens nur, ob eine Aufgabe ausgeführt wurde, nicht aber, ob sich die Daten korrekt verhalten haben. Ein Job kann im Zeitplan abgeschlossen werden und dennoch Teilladungen liefern, eine Partition übersehen oder Werte während der Transformation erzwingen. Aus diesem Grund gehören Kontrollen in die Datenschicht, nicht nur in die Workflow-Schicht.
Praktische Regel: Betrachten Sie jeden erfolgreichen ETL-Lauf als unverifiziert, bis die Daten die Aktualitäts-, Schema- und Datensatzprüfungen bestanden haben.
Die Kosten, wenn man hier Fehler macht, sind nicht abstrakt. Schlechte Datenqualität kostet Unternehmen laut Schätzungen von Gartner durchschnittlich 12,9 Millionen US-Dollar pro Jahr, und Branchenübersichten weisen darauf hin, dass schlechte Daten in einigen Unternehmen zu 15 % bis 25 % Umsatzverlust führen können, weshalb frühe ETL-Qualitätskontrollen so wichtig sind (Kosten schlechter Datenqualität). Eppler und Helfert beschrieben zudem 23 verschiedene Kostenarten, die mit qualitativ minderwertigen Daten verbunden sind, darunter Wartung, zusätzlicher Arbeitsaufwand, erneute Dateneingabe, Umsatzverluste, Kundenverluste und Nacharbeit. Sie identifizierten auch 10 Kategorien von Kosten für die Qualitätssicherung von Daten, wie Inspektion, Fehlervermeidung, Reparatur, Schulung und Prozessverbesserung. Einfach ausgedrückt: Die Rechnung wird fällig, egal ob Sie in Qualität investieren oder nicht.
Was normalerweise zuerst bricht
Die Fehler, die am meisten schmerzen, sind die stillen. Eine Datei kommt zu spät an, wird aber trotzdem geladen. Ein Quellsystem fügt eine Spalte hinzu und Ihr Parser ignoriert sie. Ein numerisches Feld wird zu Text und das Warehouse akzeptiert es nach einer Typkonvertierung. Keines dieser Probleme stoppt unbedingt den Job, aber sie vergiften die Daten.
Die richtige Antwort ist eine geschichtete Überwachung, nicht das Hoffen auf das Beste. Sie benötigen Verhaltenssignale, die Ihnen mitteilen, wenn die Pipeline Daten produziert, die nicht mehr der von Ihnen erwarteten Form, dem Timing oder der Verteilung entsprechen. Das bedeutet, über die Ausführung hinaus auf die Eigenschaften der Datensätze selbst zu schauen.
Die fünf Qualitätsdimensionen, die jede ETL-Pipeline überwachen muss
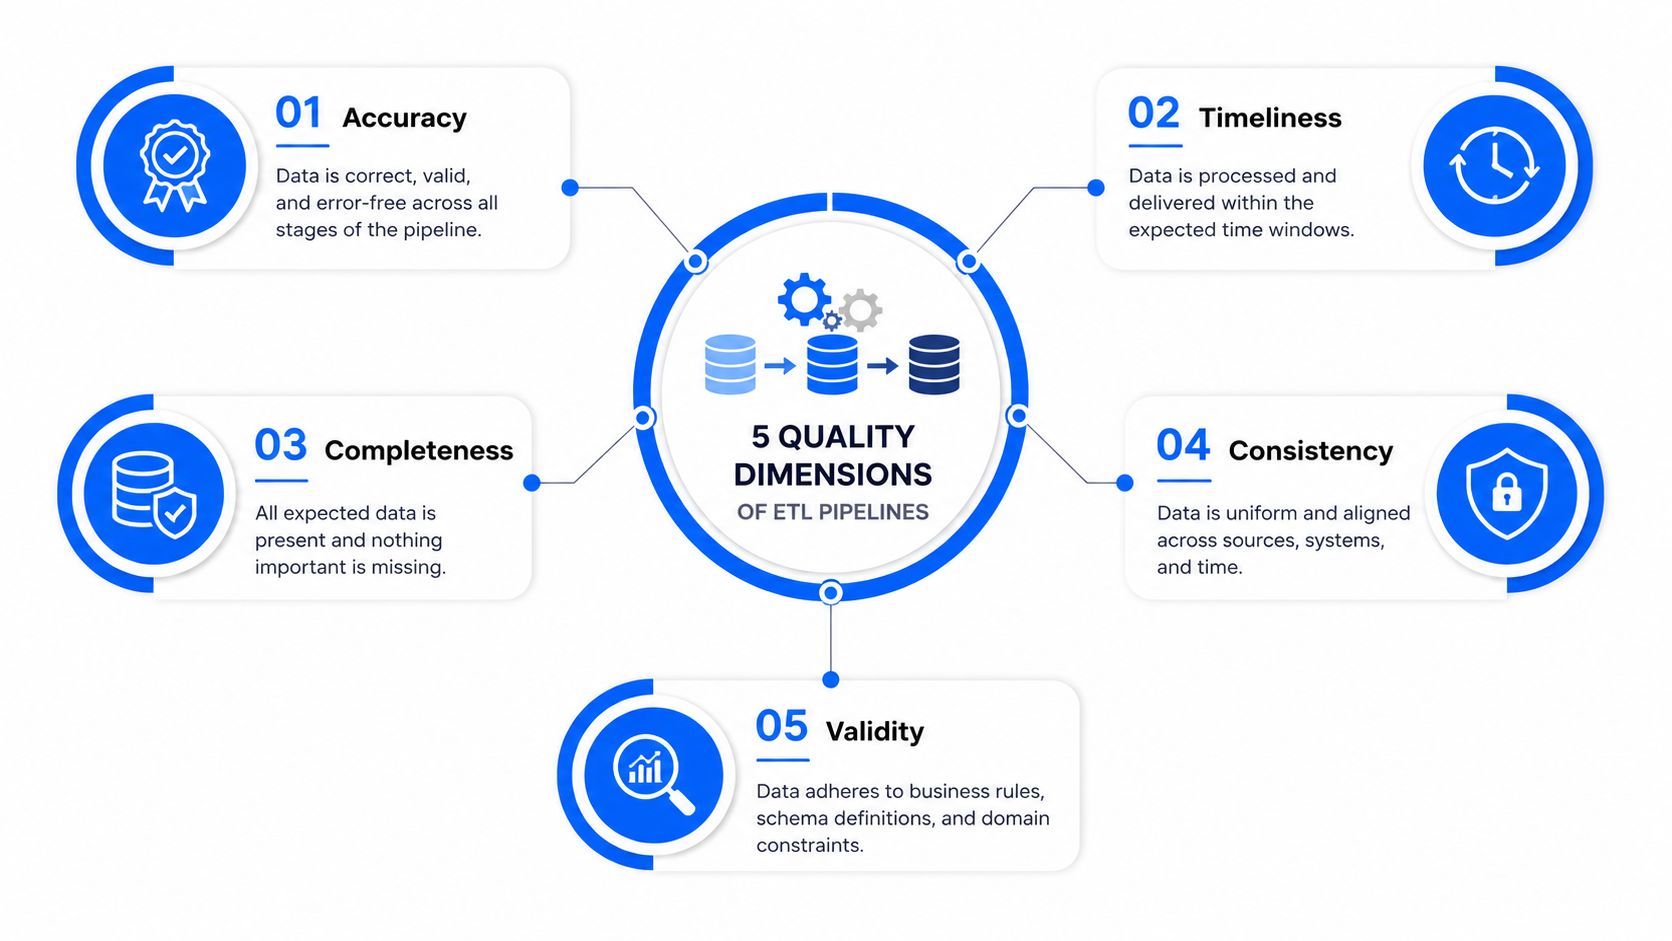
ETL-Qualität funktioniert am besten, wenn man aufhört, sie wie eine einzige Kennzahl zu behandeln. Die moderne Observability-Forschung strukturiert das Problem um Freshness, Schema, Volume, Distribution und Lineage, und diese Aufteilung lässt sich nahtlos auf die älteren akademischen Dimensionen wie Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit und Eindeutigkeit übertragen (moderne Observability-Säulen, akademischer Überblick über ETL-Qualitätsdimensionen). Jede davon fängt ein anderes Fehlermuster ab, und keine ersetzt die andere.
Freshness sagt Ihnen, ob der neueste gültige Datensatz eintrifft. Schema fängt strukturellen Drift ab, einschließlich neuer Spalten, entfernter Felder und Typänderungen. Volume markiert plötzliche Einbrüche oder Spitzen, die auf Kürzungen oder Duplikate hindeuten. Distribution macht subtilere Verschiebungen sichtbar, wie Änderungen der Null-Werte-Rate oder verschobene Wertebereiche. Lineage verknüpft ein Problem zurück zur Quelle und dem Transformationsschritt, der es verursacht hat.
Warum die fünf Säulen zusammenarbeiten müssen
Wenn Sie nur das Schema überwachen, verpassen Sie veraltete, aber strukturell gültige Daten. Wenn Sie nur das Volumen überwachen, kann eine fehlerhafte Ladung dennoch durchgehen, weil die Zeilenanzahl normal aussieht. Wenn Sie nur die Aktualität überwachen, können Sie immer noch eine strukturell falsche Datei pünktlich ausliefern. Deshalb sind dies Verhaltenssignale und keine austauschbaren Kontrollkästchen.
Eine gute Ressource für Teams, die hierfür Disziplin aufbauen möchten, sind die Schulungsstandards für Datenqualität, insbesondere wenn Sie versuchen, Analysten, Ingenieure und governance-Verantwortliche auf die gleichen Erwartungen auszurichten. Es geht nicht darum, mehr Hürden aufzubauen. Es geht darum, das richtige Fehlermuster sichtbar zu machen, bevor das Warehouse der einzige Ort wird, an dem es jemand bemerkt.
Ich führe auch eine einfache interne Referenz für Teams, die eine formalere Aufteilung der Säulen wünschen, in dignas Dimensionen der Datenqualität. Diese Art von gemeinsamem Vokabular ist wichtig, wenn verschiedene Teams dieselben Wörter für unterschiedliche Dinge verwenden.
Was jede Dimension tatsächlich abfängt
Freshness fängt fehlende oder verzögerte Lieferungen ab, bevor Dashboards veralten.
Schema fängt unangekündigte Strukturänderungen ab, die Verbraucher blockieren oder Zuordnungen beschädigen.
Volume fängt Kürzungen, Duplikate und Teilladungen ab.
Distribution fängt Verschiebungen bei Null-Werte-Raten, Wertebereichen und Kardinalitäten ab, die Zeilen-für-Zeilen-Regeln oft übersehen.
Lineage hilft Ihnen, den Fehler zu einem Quellsystem, Job oder Transformationsschritt zurückzuverfolgen.
Ein Warehouse sieht nur dann gesund aus, wenn man die richtige Schicht überprüft.
Die stärksten Observability-Implementierungen verlangen nicht von einer einzigen Dimension, die gesamte Arbeit zu erledigen. Sie nutzen jede Dimension als einen anderen Blickwinkel auf dieselbe Pipeline, sodass ein Problem dort abgefangen werden kann, wo es entstanden ist, und nicht erst, nachdem es die nachgelagerte Berichterstattung bereits beeinflusst hat.
Regelbasierte Validierung versus KI-gestützte Anomalieerkennung
Eine regelbasierte Validierung ist nach wie vor unerlässlich, deckt jedoch nur das ab, was Sie bereits erwarten. Wenn ein Umsatzfeld niemals negativ sein darf, wenn ein Ländercode in einem definierten Set liegen muss oder wenn ein Fremdschlüssel existieren muss, bevor eine Faktentabelle geladen wird, sollte dies durch eine Regel erzwungen werden. Das ist eine harte Kontrolle, und harte Kontrollen sind gut.
Das Problem ist, dass Regeln blind für Verhaltensweisen sind, die sich verschieben, ohne eine harte Einschränkung zu verletzen. Eine Quelle kann anfangen, Datensätze zu spät zu senden, ein Feld kann verrauschter werden, ein Join kann übereinstimmende Schlüssel verlieren oder eine Verteilung kann so stark driften, dass sie Analysen beschädigt, während sie dennoch jede statische Prüfung besteht. Hier verdient die Anomalieerkennung ihren Platz. Für einen breiteren Überblick über dieses Muster lohnt sich der Leitfaden zur ETL-Anomalieerkennung neben dignas Ansatz zur Anomalieerkennung.
Der praktische Kompromiss ist einfach. Regeln sind präzise und leicht zu erklären. Die Anomalieerkennung deckt ein breiteres Feld ab, benötigt jedoch eine Baseline und kann Rauschen erzeugen, wenn man Zuständigkeiten und Alarmierung nicht sorgfältig abstimmt. Meiner Erfahrung nach geraten Teams in Schwierigkeiten, wenn sie die Anomalieerkennung als Ersatz für deterministische Prüfungen betrachten. Das ist sie nicht.
Wo welcher Ansatz gewinnt
Dimension | Regelbasierte Validierung | KI-gestützte Anomalieerkennung |
|---|---|---|
Einrichtungskosten | Geringer für bekannte Einschränkungen | Höher, da ein historisches Baseline-Verhalten benötigt wird |
Abdeckung | Eng, aber exakt | Breiter, fängt Drift und ungewöhnliche Muster ab |
Wartungsaufwand | Wächst mit der Anzahl der Regeln | Wächst, wenn Baselines, Owner und Abstimmung nicht gepflegt werden |
Latenz bis zur Erkenntnis | Sofort bei definierten Fehlern | Schnell, sobald Muster gelernt sind, aber nicht immer sofort am ersten Tag |
Blinde Flecken | Unbekannte Unbekannte und Verhaltensdrift | Harte geschäftliche Invarianten und explizite Richtlinienvorgaben |
Wie man sie schichtet, ohne Alarm-Chaos zu verursachen
Beginnen Sie mit Regeln für Invarianten, die Sie niemals lockern möchten. Schichten Sie dann die Anomalieerkennung darüber für die Metriken, die zur Drift neigen, wie Volumen, Null-Werte-Raten und Feldkorrelationen. Wenn ein Datensatz eine der beiden Schichten nicht besteht, leiten Sie ihn in eine Quarantäne oder eine Überprüfungsschleife weiter, anstatt ihn weiter nachgelagert fließen zu lassen.
Dieser Ansatz sorgt auch dafür, dass Ihre Kontrollen erklärbar bleiben. Ingenieure können eine fehlgeschlagene Einschränkung debuggen. Analysten können verstehen, warum sich eine Baseline geändert hat. Governance-Teams erhalten ein Protokoll darüber, was blockiert wurde und warum. Wenn es gut gemacht ist, fühlt sich das System weniger wie eine Wand aus starren Prüfungen an, sondern eher wie ein fein abgestimmtes Set von Leitplanken.
Validierungsmechaniken auf Datensatzebene, die Fehler abfangen
Prüfungen auf Datensatzebene funktionieren nur, wenn sie sich an den geschäftlichen Auswirkungen orientieren und nicht nur am Status "Bestanden" oder "Fehlgeschlagen". Ein fehlendes Nullable-Feld in einem Datensatz mit geringem Risiko ist nicht dasselbe wie ein fehlender Schlüssel in einer Umsatzfaktentabelle. Die Kontrolle muss diesen Unterschied widerspiegeln, sonst wird sie entweder zu streng, um praktikabel zu sein, oder zu locker, um eine Rolle zu spielen.
Klinische ETL-Arbeit zeigt, wie schnell die Qualität sinken kann, wenn Definitionen ungenau sind. In einer Krankenhausstudie variierten die Fehlerraten bei manueller Extraktion und automatisiertem Export je nachdem, ob mehrdeutige Felder ausgeschlossen wurden. Dies weist auf eine einfache Lektion hin: Automatisierung garantiert keine Qualität, und Klarheit in den Datendefinitionen verändert die Fehlerraten erheblich.
Nutzen Sie Schwellenwerte, nicht nur Zählungen
Eine Fehlerrate von 0,1 % bei einer Ladung von 50 Millionen Zeilen ist ein anderes betriebliches Problem als dieselbe Rate bei einem Batch von 1.000 Zeilen. Erstere kann Zehntausende von fehlerhaften Zeilen verbergen. Letzteres ist vielleicht eine kleine, aber kritische Stichprobe, bei der schon ein einziger Fehler zählt.
Aus diesem Grund sind Schweregradstufen wichtig. "Warnen", "Quarantäne" und "Anhalten" geben der Pipeline Raum zu reagieren, ohne gleichzeitig starr und zu nachgiebig zu werden.
Die Validierungsmechaniken sollten konkret bleiben. Ein ETL-Validierungsartikel aus dem Jahr 2021 empfiehlt die korrekte Spaltenanzahl, Datentypen und Spalten-Constraints sowie das Vorhandensein und die Reihenfolge von Spalten für Flat Files zusammen mit Primärschlüssel-, Fremdschlüssel- und Unique-Index-Constraints (Artikel über Validierungsmechaniken). Dies bleibt das Rückgrat einer zuverlässigen Validierung auf Datensatzebene.
Prüfungen, die sich in der Praxis auszahlen
Null-Wert-Erkennung: Profilieren Sie Spalten und legen Sie akzeptable Dichtebereiche fest, insbesondere für geschäftskritische Pflichtfelder.
Schlüsseldurchsetzung: Weisen Sie doppelte Primärschlüssel und verwaiste Fremdschlüssel ab, bevor sie nachgelagerte Joins kontaminieren.
Domänenvalidierung: Verwenden Sie kontrollierte Werte für Felder wie ISO-Ländercodes und andere endliche Enums.
Geschäftliche Schwellenwerte: Drücken Sie Umsatztoleranzgrenzen, Rückgaberatenlimits oder Stornierungsschwellenwerte als Prozentsätze der eingehenden Zeilen aus.
Spät eintreffende Fakten: Validieren Sie gegen Gültigkeitsfenster, damit Ereignisse im korrekten Zeitabschnitt landen.
Ich ziehe es vor, mehrdeutige Zeilen unter Quarantäne zu stellen, anstatt sie den vertrauenswürdigen Datensatz verändern zu lassen. Die Quarantäne gibt den Datenproduzenten die Möglichkeit, die Quelle oder das Mapping zu korrigieren, ohne das Warehouse in eine Müllhalde zu verwandeln.
Betriebliche Regel: Wenn das Team nicht erklären kann, warum das Ignorieren einer fehlgeschlagenen Zeile sicher ist, ist es nicht sicher, sie zu ignorieren.
Ein praktischer Punkt: Schreiben Sie nicht für jeden Sonderfall Regeln. Beginnen Sie mit den Feldern, die Finanzen, Compliance, Kunden-Workflows und das Modelltraining steuern. Dort werden Qualitätsmängel am schnellsten teuer.
Prüfungstyp | Was es abfängt | Leitfaden für Schwellenwerte | Empfohlene Maßnahme |
|---|---|---|---|
Null-Prüfungen | Fehlende erforderliche Werte | Festgelegt nach Feldkritikalität und Datensatzgröße | Warnung bei Feldern mit geringem Risiko, Quarantäne bei kritischen Feldern |
Schlüssel-Constraints | Duplikate und fehlerhafte Beziehungen | Nulltoleranz für Identitätsschlüssel | Anhalten oder Quarantäne |
Domänenregeln | Ungültige Codes und Werte außerhalb des Sets | Verwendung endlicher Listen erlaubter Werte | Ablehnen oder an Fehlerbehebung weiterleiten |
Bereichsprüfungen | Ausreißer und unmögliche Werte | Definition geschäftsspezifischer Grenzen | Warnung bei weichen Limits, Quarantäne bei harten Limits |
Gültigkeitsdatum | Verspätete oder falsch datierte Ereignisse | Gegen erwartete Zeitfenster validieren | Quarantäne und bei Bedarf erneut verarbeiten |
Für Teams, die ein breiteres Kontrollset wünschen, ist dignas Leitfaden für Data Validation Regeln und kontinuierliche Qualität eine nützliche Ergänzung zu diesen Prüfungen auf Datensatzebene.
Timeliness-Überwachung und erwartete Lieferfenster
Eine Pipeline kann grün sein und dennoch veraltete Daten liefern. Das ist es, was morgendliche Dashboards unbrauchbar macht, nicht eine Fehlermeldung eines Jobs. Timeliness muss als SLA behandelt werden, mit einem erwarteten Lieferfenster, das darauf abgestimmt ist, wann das Unternehmen den Datensatz tatsächlich nutzt.
Die Kontrolle ist im Konzept einfach und in der Praxis unerbittlich. Vergleichen Sie die erwartete Ankunft mit der tatsächlichen Ankunft und kennzeichnen Sie den Lauf dann als früh, spät, fehlend oder unvollständig. Ein Vertriebs-Feed, der vor einer Umsatzprüfung um 8:00 Uhr morgens eintreffen muss, hat ein enges Fenster, während ein Berichts-Feed am Nachmittag ein längeres tolerieren kann. Nutzen Sie den geschäftlichen Stichtag als Referenzpunkt, nicht den Zeitplan im Orchestrierungstool.
Der sauberste Weg, dieses Fenster festzulegen, besteht darin, aus früheren Laufmustern, der Quell-Commit-Kadenz und der Konsumzeit zu lernen. Wenn das Team zu Beginn des Tages Dashboards prüft, kann eine Verzögerung von zehn Minuten eine Rolle spielen. Wenn die Daten erst nach dem Mittagessen verwendet werden, ist dieselbe Verzögerung möglicherweise nur Rauschen. dignas Leitfaden für Timeliness-Metriken bietet einen nützlichen Rahmen, um diese Fenster festzulegen und konsistent zu messen.
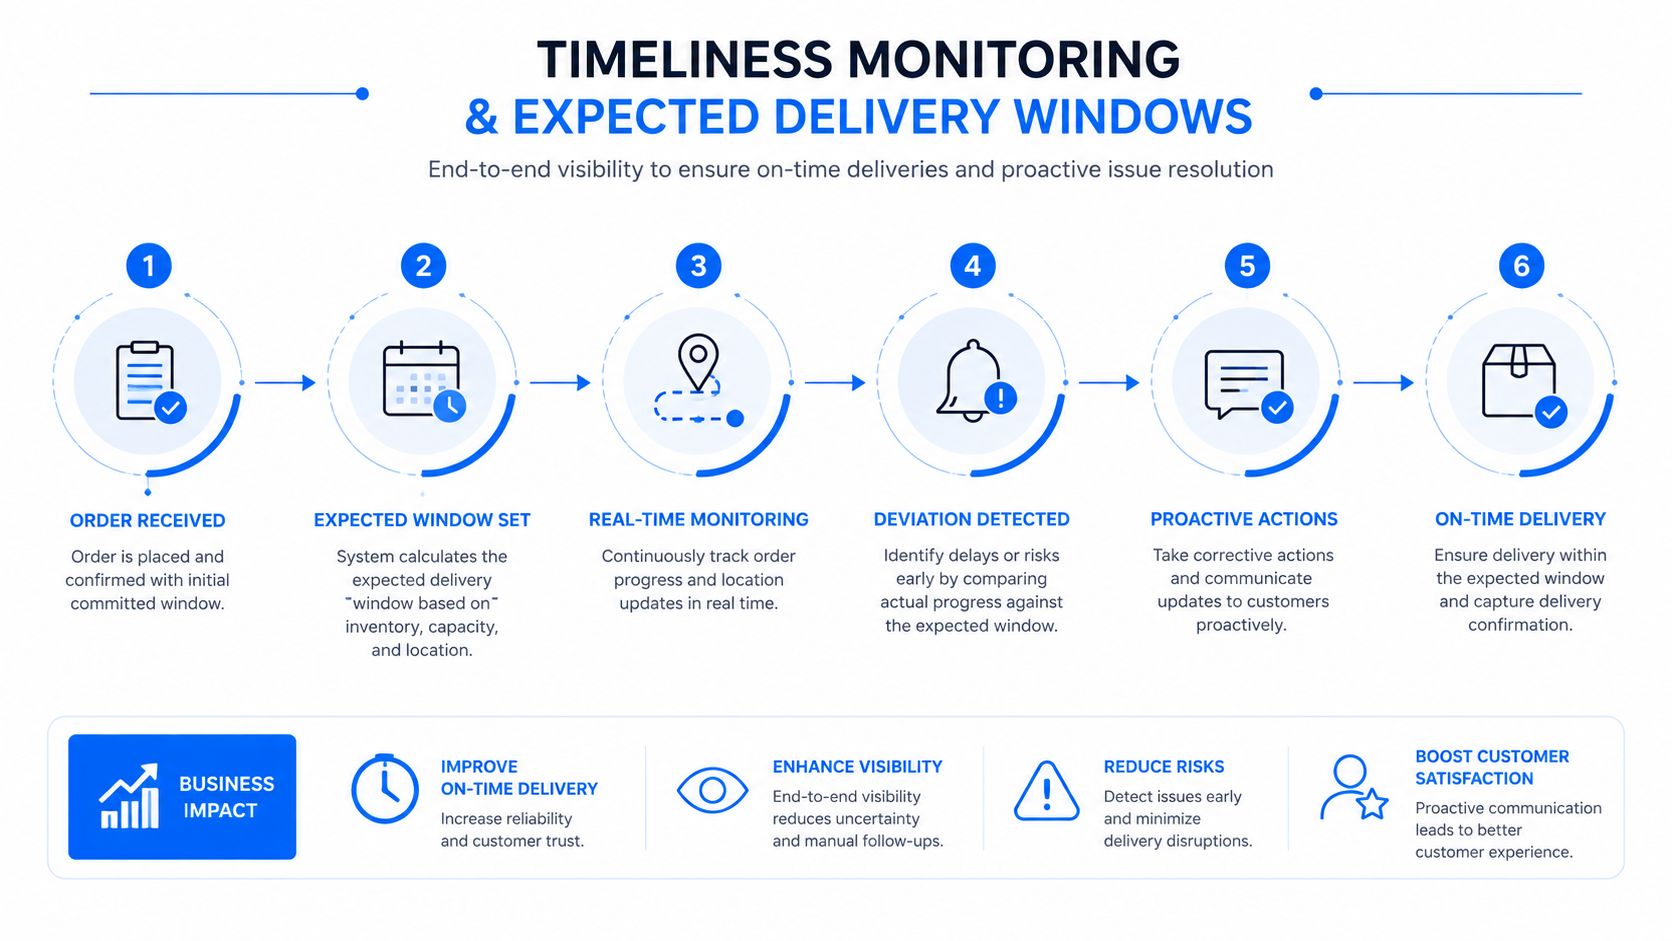
Überwachen Sie mehr als nur den letzten Zeitstempel. Heartbeat-Prüfungen zeigen, ob die Quelle noch Daten produziert. Watermarks zeigen, wie weit die Pipeline fortgeschritten ist. Inkrementelle Fertigstellungsmarker zeigen, ob alle Partitionen angekommen sind – dort verstecken sich oft unvollständige Ladungen.
Die Alarmierungsrichtlinie sollte die Art des Fehlers widerspiegeln, nicht nur das Vorhandensein einer Verzögerung.
Frühes Eintreffen: Meist harmlos, aber nützlich, wenn es auf eine Änderung des vorgelagerten Zeitplans hinweist.
Spätes Eintreffen: Alarmieren Sie, sobald die Verzögerung das geschäftliche Zeitfenster des Datensatzes überschreitet.
Fehlende Ladungen: Eskalieren Sie schnell, wenn die Daten vor einer bekannten Verbrauchsfrist fehlen.
Teilladungen: Behandeln Sie diese als hochriskant, wenn erwartete Dateigruppen oder Partitionen unvollständig sind.
Der wichtige Unterschied liegt zwischen einer routinemäßigen Verzögerung und einer Verspätung, die eine Vorstandssitzung oder einen Kunden-Workflow stört. Diese Entscheidung gehört in die Überwachungsrichtlinie und nicht in den Kopf von jemandem um 7:50 Uhr morgens. Die Timeliness-Kontrolle funktioniert, wenn sie dem Team Zeit zum Handeln gibt und wenn sie stille Veraltung abfängt, bevor jemand den Zahlen vertraut.
Schema-Drift und wie man ihn erkennt, bevor nachgelagerte Systeme brechen
Schema-Drift ist tückisch, da die Pipeline oft weiterläuft, während die nachgelagerten Systeme um sie herum zusammenbrechen. Quellsysteme ändern ihre Struktur ohne Vorwarnung, und das Laden sieht immer noch erfolgreich aus, bis ein Dashboard, ein Modell oder ein nachgelagerter Job aufgrund fehlender oder veränderter Felder fehlschlägt. Deshalb gehört Schema-Drift in dieselbe Kontrollschicht wie die Validierung und die Timeliness-Überwachung, nicht in eine nachträgliche Bereinigungswarteschlange. Die praktische Definition von Drift ist die unangekündigte oder schrittweise Änderung einer Quellstruktur im Laufe der Zeit im Vergleich zum Pipeline-Schema, weshalb sie eine aktive Überwachung anstelle einer einmaligen Genehmigung erfordert (Schema-Drift-Definition).
Am besten denkt man über Drift nach Typen nach. Additiver Drift bringt neue Spalten ein. Subtraktiver Drift entfernt Felder, die Verbraucher erwarten. Mutativer Drift ändert Typ, Präzision oder Nullability. Dies sind unterschiedliche Fehlermuster, die unterschiedliche Reaktionen erfordern. Eine Änderung, die für die Ingestion sicher ist, kann dennoch eine nachgelagerte semantische Schicht oder ein Modell-Feature-Set beschädigen.
Schema-Drift erklärt stellt das betriebliche Problem klar dar. Wenn sich die Struktur ändert und niemand es bis zum Verbrauch bemerkt, entstehen die Kosten später in Form von schlechten Joins, fehlgeschlagenen Casts oder stillem Datenverlust.
Drift an der Grenze erkennen
Vertragsprüfungen sollten durchgeführt werden, sobald Daten die Ingestion-Grenze überschreiten. Versionierte Schema-Registries helfen, wenn sich vorgelagerte Systeme absichtlich weiterentwickeln. Diff-Jobs, die DDL-Snapshots vergleichen, fangen Änderungen ab, die der Code-Review entgangen sind. Inferenzprüfungen können unerwartete Spalten markieren, selbst wenn der Produzent sie nie angekündigt hat.
Die Mechanik ist entscheidend. Die Validierung gegen die deklarierte Struktur sollte Spaltenvorhandensein, Typ, Einschränkungen und Reihenfolge für Flat Files sowie Primärschlüssel-, Fremdschlüssel- und Eindeutigkeitsprüfungen abdecken, wo diese Regeln gelten. Diese Prüfungen sind nicht glamourös, aber sie verhindern eine Menge Ärger, bevor er sich in nachgelagerte Tabellen und Berichte ausbreitet.
Reagieren, ohne jede Änderung in einen Ausfall zu verwandeln
Drift-Typ | Beispielhafte Änderung | Erkennungsmethode | Empfohlene Reaktion |
|---|---|---|---|
Additiv | Neues Feld zu einem Payload hinzugefügt | Schema-Diff, Inferenz, Contract-Check | Nullable-Hinzufügung zulassen, dann nachgelagerte Modelle aktualisieren |
Subtraktiv | Bestehende Spalte entfernt | Grenzvalidierung, Snapshot-Diff | Blockieren oder an Kompatibilitätsschicht weiterleiten |
Mutativ | Typ- oder Präzisionsänderungen | Typvalidierung, Registry-Vergleich | Quarantäne, sorgfältig mappen und den Vertrag versionieren |
Strikte Fail-Policies klingen sicher, bis sie mehr Vorfälle verursachen, als sie verhindern. Ich habe erlebt, dass Teams harmlose additive Änderungen abgelehnt haben und dann den nächsten Sprint damit verbracht haben, die nachgelagerten Systeme manuell wieder freizugeben. Eine abwärtskompatible Evolution funktioniert meist besser. Nullable-Hinzufügungen, Dual-Write-Übergänge und wiederholbare nachgelagerte Lasten sind sicherer, als so zu tun, als würden sich Schemata niemals ändern.
Planen Sie für Drift, dann bleiben die Kontrollen länger nützlich. Gehen Sie davon aus, dass das Schema fix ist, und das nächste vorgelagerte Release wird Ihnen das Gegenteil beweisen.
Aufbau eines geschichteten ETL-Qualitäts-Stacks in der Praxis
Ein grüner ETL-Lauf kann immer noch schlechte Daten liefern. Das passiert meistens, weil eine Kontrolle zu viel tun muss, während der eigentliche Fehler eine Schicht weiter liegt. Ein nützlicher Qualitäts-Stack trennt diese Aufgaben. Prüfungen auf Zeilenebene laufen inline während der Extraktion oder Transformation. Anomalieerkennungen auf Aggregationsebene laufen an den Ladegrenzen. Freshness- und Lineage-Prüfungen laufen nach dem Commit, sobald Sie bestätigen können, dass der Datensatz angekommen ist, und nachverfolgen können, wie er sich bewegt hat.
Diese Aufteilung ist in der Praxis wichtig. Statische Regeln sind gut darin, bekannte schlechte Muster abzufangen. Verhaltensüberwachung fängt Drift, Verzögerungen und subtile Verschiebungen ab, die starre Regeln übersehen.
Wie der Stack normalerweise reift
Die erste Version sollte leichtgewichtig sein. Beginnen Sie mit nicht-blockierenden Sonden bei jedem Phasenübergang, damit das Team sehen kann, was sich geändert hat, bevor entschieden wird, ob der Ladevorgang gestoppt werden soll. Sobald sich das Signal verbessert, befördern Sie die Prüfungen, die echte Mängel aufdecken, zu Orchestrierungs-Gates. Behalten Sie den Rest als Warnungen oder Quarantänepfade bei.
Ein häufiges Fehlermuster besteht darin, jedes Problem als Regel-Schreib-Aufgabe zu behandeln. Teams enden mit einer starren Logik, die harmlose Änderungen blockiert und dennoch signifikanten Drift übersieht. Das stärkere Muster ist die geschichtete Kontrolle, bei der Verteilungsprofilierung, Alarmierung bei Ankunftsfenstern und Lineage-bewusste Schema-Verträge jeweils einen anderen Teil des Risikos abdecken. Die genauen Werkzeuge variieren. Das Designprinzip nicht.
Ein Praxisbeispiel verdeutlicht diesen Kompromiss. Eine in ITSV-Material beschriebene Implementierung ersetzte Tausende statischer Validierungsregeln durch Profiling, Timeliness-Warnungen und Schema-Verträge, was das Alarmrauschen reduzierte und umsatzrelevante Drifts früher aufdeckte. Dieses Ergebnis liegt weniger am spezifischen Stack als vielmehr an der Passgenauigkeit. Harte Gates sollten Fehler behandeln, die nachgelagerte Systeme unbrauchbar machen. Alles andere sollte die Bediener informieren, ohne routinemäßige Abweichungen in einen Ausfall zu verwandeln.
Wer was im Stack besitzt
Data Engineers: Besitzen die Pipeline-Grenzen, Schema-Verträge und das Routing von Fehlern.
Analytics Engineers: Besitzen die Erwartungen an die Modelle, Verteilungsprüfungen und semantische Validierung.
Governance-Teams: Besitzen Standards, Schweregrad-Richtlinien und Eskalationspfade.
Business-Inhaber: Besitzen die Bedeutung des Alarms, insbesondere wenn eine Zeile technisch gültig, aber geschäftlich falsch ist.
Bauen Sie den Kontroll-Stack genauso auf wie die Pipeline, mit klarer Verantwortung, Tests und Rollback-Pfaden.
digna passt in dieses Modell, da es in der eigenen Umgebung des Kunden läuft und Anomalieerkennung, Timeliness-Überwachung, Validierung auf Datensatzebene, Schema-Tracking und Plattform-Metriken kombiniert. Der Punkt ist nicht das Markenlabel. Der Punkt ist, dass die Prüfungen nah an den Daten bleiben und das Betriebsmodell innerhalb der Umgebung bleibt, in der die Pipeline läuft.
Behandeln Sie den Stack als Produktfläche, nicht als einmaliges Projekt. Profilieren Sie jeden Datensatz, weisen Sie jedes Fehlermuster einem einzigen Verantwortlichen zu, leiten Sie Alarme an das Team weiter, das handeln kann, und mustern Sie Kontrollen aus, sobald eine andere Schicht dieselbe Lücke sauberer schließt. Qualität hält stand, wenn der Stack mit Disziplin gepflegt wird, nicht wenn die Anzahl der Regeln immer weiter steigt.
Häufige Missverständnisse und eine praktische Qualitäts-Checkliste
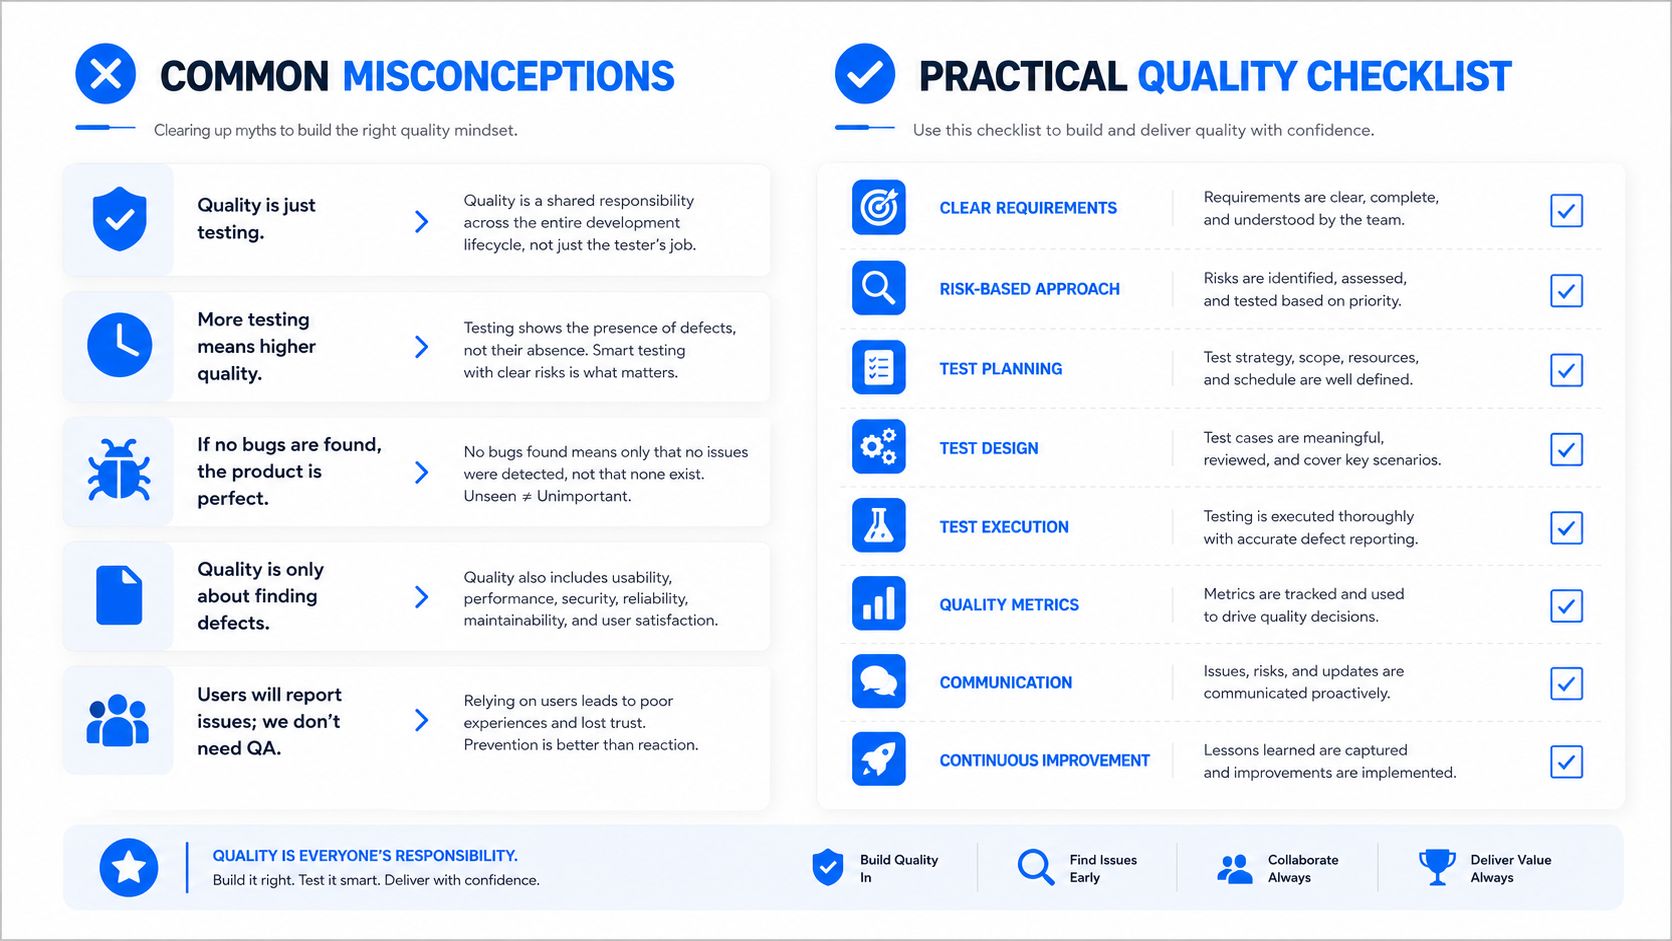
Das erste Missverständnis ist, dass mehr Regeln automatisch bessere Qualität bedeuten. In der Realität führt das Anhäufen statischer Prüfungen meist zu Alarm-Müdigkeit, starren Pipelines und einem Rattenschwanz an Regeln, denen niemand vertraut. Das zweite Missverständnis ist, dass eine grüne Pipeline vertrauenswürdige Daten bedeutet. Das tut sie nicht, da der Job erfolgreich sein kann, während der Payload veraltet, verschoben oder strukturell falsch ist. Das dritte ist, dass Schema-Drift ein einmaliges Migrationsproblem ist. Das ist es nicht, es ist ein kontinuierlicher Prozess.
Diese Fehler verschwinden, sobald man die Aufgabe jeder Kontrolle trennt. Regeln messen das Erwartete. Anomalien fangen das Unerwartete ab. Die Drifterkennung überwacht die Struktur, während sie sich im Laufe der Zeit verändert. Wenn das Team diese Aufgaben vermischt, sind das Ergebnis eine unruhige Überwachung und eine langsame Reaktion auf Vorfälle.
Eine Checkliste, die Sie diese Woche anwenden können
Zuerst die Quelle profilieren: Lernen Sie die Feldformen, Null-Muster und Verteilungen kennen, bevor Sie Regeln schreiben.
Statische Schwellenwerte durch gleitende Baselines ersetzen: Nutzen Sie beobachtetes Verhalten, wenn der Datensatz von Natur aus variabel ist.
Auf Abwesenheit alarmieren, nicht nur auf Anwesenheit: Fehlende Daten sind oft das erste Anzeichen für eine fehlerhafte Ladung.
Jedes Schema versionieren: Behandeln Sie strukturelle Änderungen als gesteuertes Ereignis, nicht als Überraschung.
Jedem Alarm einen menschlichen Besitzer zuweisen: Alarme ohne klare Zuständigkeit werden zu Hintergrundrauschen.
Die nachhaltigsten Programme jagen nicht perfekten Regeln hinterher. Sie bauen Observability auf, schaffen klare Verantwortlichkeiten und lassen das Kontrollmodell mit der Pipeline wachsen. Das ist der Unterschied zwischen einem System, das sauber aussieht, und einem, das zuverlässig bleibt, wenn sich das Verhalten der Quelle ändert.
Wenn Sie die ETL-Datenqualität über Warehouses, Lakes und Streaming-Pipelines hinweg festigen möchten, beginnen Sie mit Kontrollen, die das Datenverhalten überwachen, und nicht nur den Status der Aufgaben. digna hilft Teams, Anomalien, Schema-Drift, Timeliness und Validierung in ihrer eigenen Umgebung zu überwachen, sodass die Prüfungen nah an den Daten bleiben und die Verantwortlichkeiten klar sind. Besuchen Sie digna, um zu sehen, wie dieser Ansatz in Ihren Stack passt.
Häufig gestellte Fragen
Warum liefern grüne ETL-Pipelines trotzdem kaputte Daten?
Weil Orchestrierungswerkzeuge meist melden, ob ein Task lief, und nicht, ob sich die Daten korrekt verhalten haben. Die praktische Regel lautet, jeden erfolgreichen ETL-Lauf als ungeprüft zu behandeln, bis die Daten Aktualitäts-, Schema- und Satzprüfungen bestanden haben.
Welche Qualitätsdimensionen sollte jede ETL-Pipeline überwachen?
Fünf, denn ein einzelner Wert verbirgt den Fehler. Aktualität sagt, ob der neueste gültige Datensatz eintrifft, die übrigen decken Volumen, Schema, Verteilung und Validität auf Satzebene ab. Jede erfasst eine andere Fehlerklasse, und erst die getrennte Betrachtung macht das Signal nützlich.
Welche ETL-Fehler schmerzen am meisten?
Die leisen. Eine abstürzende Pipeline meldet sich selbst und wird repariert, ein Lauf, der durchläuft und dabei still eine Partition verliert, einen Typ umwandelt oder ungültige Datensätze zulässt, reist bis ins Dashboard, bevor jemand eine Frage stellt.
Was kostet mangelhafte ETL-Datenqualität?
Gartner schätzt mangelhafte Datenqualität auf durchschnittlich 12,9 Millionen USD pro Organisation und Jahr, und Branchenzusammenfassungen nennen bei manchen Unternehmen 15 % bis 25 % Umsatzverlust. Frühe Kontrollen zählen, weil die Kosten mit jedem nachgelagerten Schritt wachsen.
Ist mehr Testen die Antwort?
Geschichtetes Monitoring ist es, nicht Hoffnung und keine längere Testsuite. Deterministische Prüfungen erfassen bekannte Regelverstöße, statistische Prüfungen erfassen Verhalten, das Regeln nicht beschreiben, und Schema-Tracking erfasst strukturelle Änderungen, und keine Schicht deckt die beiden anderen ab.



