Enterprise Data Quality Management: Ein Praxisleitfaden
|
8
min. Lesezeit

Um 8:47 Uhr öffnet ein Analytics-Lead das Executive-KPI-Dashboard und sieht stagnierenden Umsatz. Die Prognose der Vorwoche versprach zweistelliges Wachstum. Der Chief Revenue Officer fragt bereits im Messenger-Thread, wer für die Zahl verantwortlich ist, während der Source-of-Truth-Bericht eine nächtliche Aktualisierung ohne erkennbaren Fehler zeigt.
Drei Pipelines speisen die betroffene Tabelle. Keine protokollierte einen eindeutigen Fehler. Das Team prüft das Warehouse, verfolgt den vorgelagerten Event-Stream, inspiziert die dbt-Modelle und sieht schließlich die BI-Schicht durch. Zwei Tage zuvor hatte ein Anbieter ein Feld in seinem Payload umbenannt. Der daraus folgende Join-Fehler entfernte Zeilen, ohne die Pipeline zu stoppen.
Genau diese operative Lücke muss Enterprise Data Quality Management schließen. Es sollte Schema-Drift, Aktualitätslücken, Anomalien fehlender Zeilen und unerwartete fachliche Veränderungen erkennen, bevor sie eine Vorstandssitzung erreichen. Die Disziplin ist keine quartalsweise Aufräumübung. Sie ist ein kontinuierliches Kontrollsystem für die Daten, die Reporting, Analytik, Compliance und KI antreiben.
Inhaltsverzeichnis
Wenn das Morgen-Dashboard bricht und niemand weiß, warum
Was Enterprise Data Quality Management wirklich bedeutet
Mit Verhalten beginnen, nicht nur mit Regeln
Verträge explizit machen
Aktualität als Qualitätsdimension behandeln
Struktur verfolgen und Signale verbinden
Kernfähigkeiten und die Kennzahlen, die sie wirksam machen
Architektur- und Bereitstellungsmuster für das Unternehmen
Berechnung nah an den Daten halten
Isolationsanforderungen und Deployment aufeinander abstimmen
Fähigkeiten in operativen Stufen einkaufen
Best Practices und eine realistische Umsetzungs-Roadmap
Phase eins adressiert sichtbare Fehler
Phase zwei macht aus Annahmen Verträge
Phase drei macht Qualität zum Teil der Auslieferung
Wie eine modulare Plattform operative Probleme löst
Datenqualität als Betriebsdisziplin neu denken
Wenn das Morgen-Dashboard bricht und niemand weiß, warum
Das Dashboard scheiterte nicht so, wie viele erwarten. Es gab keinen Warehouse-Ausfall. Kein Orchestrierungsjob wurde rot. Kein Alert meldete, dass sich das Anbieter-Payload geändert hatte. Aus Sicht der Plattform bewegten sich Daten weiter, Modelle liefen weiter, und das BI-Werkzeug bediente weiterhin Abfragen.
Aus Sicht des Geschäfts war das Dashboard falsch.
Die Untersuchung folgte dem üblichen Weg. Der Analytics-Lead verglich das Dashboard mit einer Warehouse-Abfrage, prüfte, ob die nächtliche Tabelle eingetroffen war, und sah die Pipeline-Logs durch. Ein Engineer inspizierte den Event-Stream auf fehlende Nachrichten und öffnete dann den Transformationscode, um den betroffenen Join zu verfolgen. Der Fehler lag nach dem Ingest, aber vor dem Dashboard, sodass jedes Team nur Teilbelege und keine gemeinsame Erklärung hatte.
Operative Regel: Ein erfolgreicher Pipeline-Lauf beweist nicht, dass die Daten zwecktauglich sind.
Die stille Feldumbenennung war nur ein Teil des Vorfalls. Ein Schema Tracker hätte die strukturelle Änderung beim Eintreffen des Anbieter-Payloads erkennen können. Eine Timeliness-Kontrolle hätte melden können, dass die Quelle später als im normalen Liefermuster war. Ein Anomaliedetektor hätte das Muster fehlender Zeilen in der transformierten Tabelle bemerken können. Eine gemeinsame Observability-Sicht hätte diese Signale verbunden, statt Engineers zur Suche in vier Systemen zu zwingen.
Der Unterschied zählt, weil schlechte Datenqualität ein finanzielles Risiko darstellt und nicht bloß ein Engineering-Ärgernis. Die von Branchenzusammenfassungen zu Data-Management-Statistiken zitierte Schätzung von Gartner beziffert die durchschnittlichen jährlichen Kosten schlechter Datenqualität auf 12,9 Mio. USD je Organisation. Dieselbe Quelle weist darauf hin, dass Forschung der MIT Sloan häufig mit Umsatzverlusten von 15 % bis 25 % in Verbindung gebracht wird. Diese Zahlen rahmen Qualitätsmanagement als Betriebsausgabe und als Disziplin zum Schutz des Umsatzes.
Ein funktionierendes Programm hätte die Umsatztabelle des Dashboards als überwachtes Produktionsasset behandelt. Es hätte erwartetes Volumen, Aktualität, Schema und Join-Verhalten definiert, Verantwortung zugewiesen und relevante Abweichungen an die Menschen geleitet, die reagieren können.
Ziel ist nicht, jeden unvollkommenen Datensatz zu verhindern. Ziel ist, dass ein kaputtes Dashboard nicht das erste Monitoring-Signal ist.
Praktische Hinweise, wie aus diesen Signalen nützliche Stakeholder-Sichten werden, bietet dieser Ansatz zum Aufbau von Datenqualitäts-Dashboards, die wirklich funktionieren.
Was Enterprise Data Quality Management wirklich bedeutet
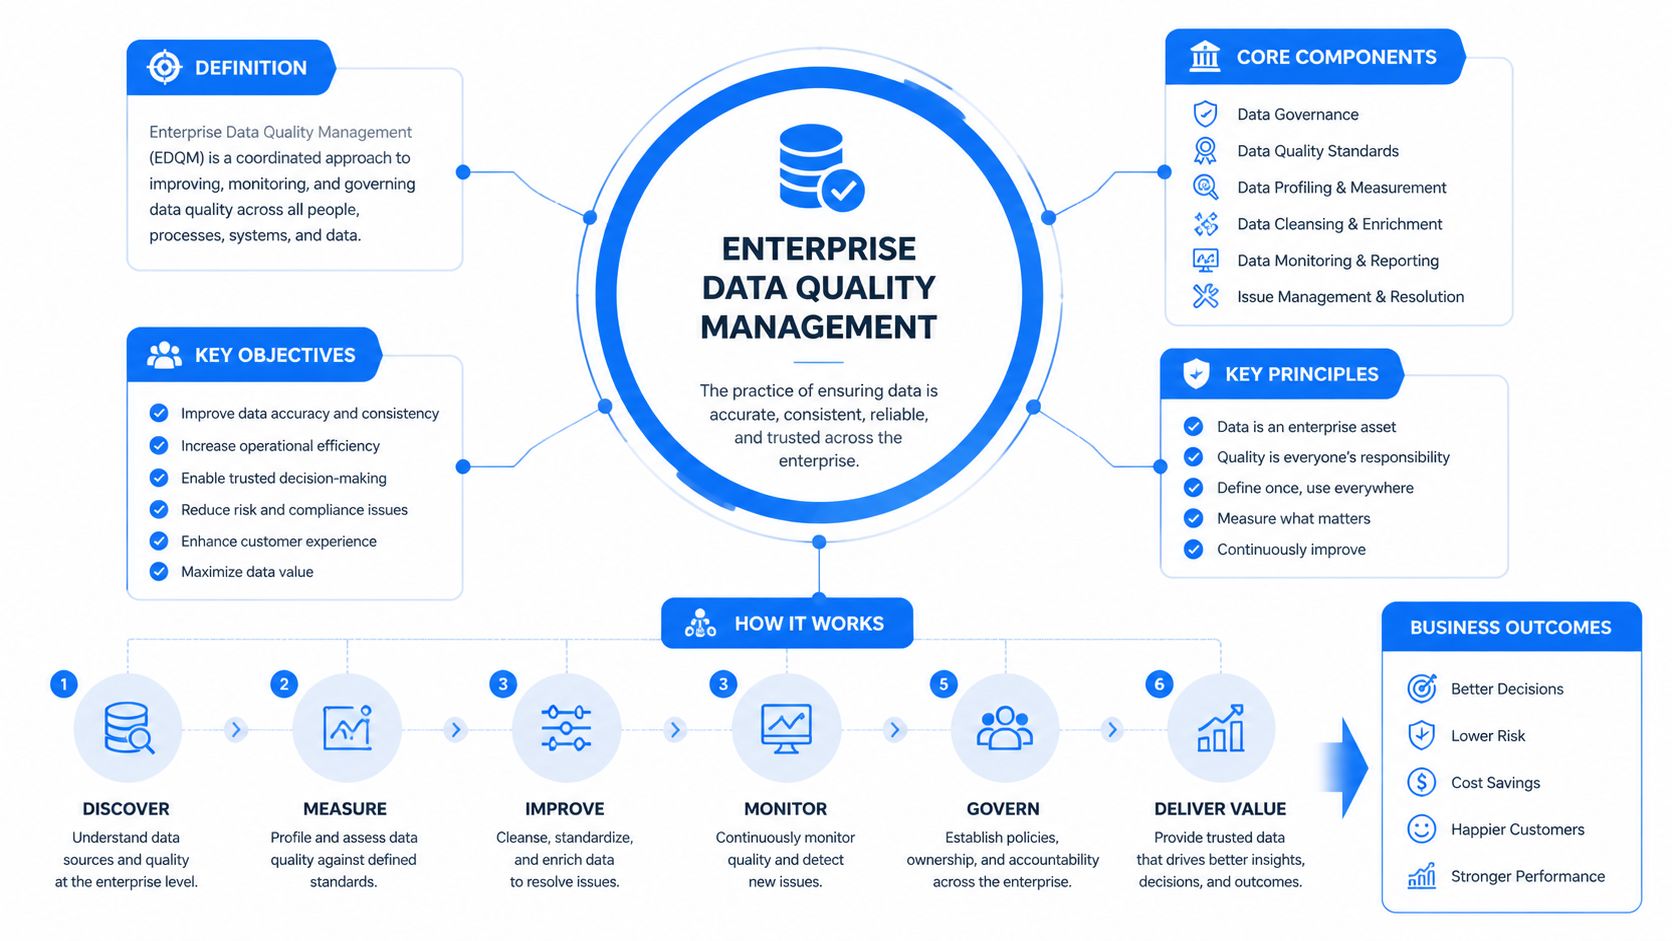
Enterprise Data Quality Management ist eine Betriebsdisziplin, die Daten über Ingest, Transformation, Speicherung und Nutzung hinweg zwecktauglich hält. Sie behandelt Qualität als Regelkreis, nicht als Aufräumprojekt: erwartetes Verhalten definieren, Eingehendes prüfen, Abweichungen erklären, Reaktion zuweisen und Ergebnis festhalten. Das EDM Council beschreibt diese Arbeit über den gesamten Datenlebenszyklus, und sein globaler Data-Management-Benchmark-Bericht stützt einen reifegradorientierten Ansatz aus wiederholbaren Dimensionen und Scorecards.
Diese Unterscheidung zählt bei operativen Fehlern. Ein veraltetes Dashboard verweist auf Aktualitätskontrollen, Schema-Drift erfordert strukturelle Prüfungen, Pipeline-Verzögerungen erfordern Liefermonitoring, und eine unerwartete KPI kann Abstimmung oder Anomalieanalyse erfordern. Jede Fähigkeit sollte eine wiederkehrende Frage beantworten und zu einer konkreten Handlung führen.
Mit Verhalten beginnen, nicht nur mit Regeln
Anomalieerkennung findet Verhaltensänderungen, bevor ein Team weiß, welche Regel zu schreiben wäre. Eine plötzliche Volumenverschiebung, ein ungewöhnliches Null-Muster oder eine Verteilungsänderung kann einen vorgelagerten Fehler offenlegen, selbst wenn die Tabelle noch ihrem deklarierten Schema entspricht.
Eine deterministische Regel und eine gelernte Baseline dienen verschiedenen Zwecken. Eine Regel kann einen fehlenden Pflichtwert ablehnen. Eine Baseline kann eine starke Veränderung der historischen Null-Rate dieses Feldes melden. Skalierte Programme nutzen beides, weil bekannte Verstöße und unbekannte Muster verschiedene Signale brauchen.
Verträge explizit machen
Validierungsregeln setzen fachliche und technische Verträge durch. Sie können Formate, zulässige Werte, Feldbeziehungen, referenzielle Integrität und Bedingungen prüfen, etwa ob ein Transaktionsdatum vor der Kontoeröffnung liegt.
Eine Regel hat nur dann operativen Wert, wenn ihre Bedeutung und die Reaktion klar sind. Jede fehlgeschlagene Prüfung sollte zeigen, was sich geändert hat, welche Konsumenten betroffen sein könnten und ob die Pipeline stoppen, Datensätze in Quarantäne stellen oder mit einem Vorfall weiterlaufen soll. Ohne Owner und Reaktionsschwelle wird ein wachsendes Regelwerk zu Rauschen.
Aktualität als Qualitätsdimension behandeln
Timeliness-Monitoring beantwortet, ob Daten verfügbar und aktuell sind, wenn ein Dashboard, ein Modell oder ein operativer Prozess sie braucht. Datenqualität umfasst üblicherweise Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit, Eindeutigkeit, Integrität, Verlässlichkeit und Zugänglichkeit, wie dieser Leitfaden zu Datenqualitätsdimensionen darlegt.
Der Leitfaden zu Datenqualitätsdimensionen liefert zudem ein nützliches Vokabular für die Diskussion dieser Dimensionen. Ein Dashboard kann korrekte Werte enthalten und dennoch versagen, wenn seine Daten mehrere Tage alt sind. Timeliness-Kontrollen sollten daher erwartete Ankunftsmuster mit der tatsächlichen Lieferung vergleichen, statt nur zu prüfen, ob ein geplanter Job irgendwann endete.
Struktur verfolgen und Signale verbinden
Schema-Tracking erkennt hinzugefügte oder entfernte Felder, Datentypänderungen, Änderungen der Nullbarkeit und veränderte verschachtelte Pfade. Observability verbindet Schema-, Aktualitäts-, Volumen-, Qualitäts-, Lineage- und Plattformsignale, sodass ein Engineer ein operatives Ereignis untersucht, statt in getrennten Systemen zu suchen.
Zusammen bilden diese Komponenten einen Regelkreis. Das System legt erwartetes Verhalten fest, erkennt eine Abweichung, liefert Kontext, leitet den Vorfall weiter und hält das Ergebnis fest. Dieser Kreis schützt das Vertrauen in Analytik und KI wirksamer als ein statischer Katalog von Prüfungen.
Kernfähigkeiten und die Kennzahlen, die sie wirksam machen
Eine Scorecard wird nützlich, wenn jede Dimension zu einer Entscheidung führt. Die neun gängigen Dimensionen liefern ein Vokabular, doch Engineers brauchen messbare Signale, die an Tabellen, Streams, Modelle, Owner und Eskalationswege gebunden sind.
Genauigkeit ist selten ein einzelner universeller Prozentwert, weil der erwartete Wert aus einem Referenzsystem, einem Abstimmungsprozess oder einer vertrauenswürdigen fachlichen Berechnung stammen kann. Auf Zeilenebene können Teams Ausreißerkennzeichen, unerwartete Wertebereiche und Abweichungen gegenüber maßgeblichen Datensätzen überwachen. Die Kennzahl zählt erst, wenn jemand weiß, ob das Ergebnis Untersuchung, Quarantäne oder Annahme auslösen soll.
Vollständigkeit braucht mehr als eine generische Null-Prüfung. Verfolgen Sie Null-Raten für Pflichtfelder, fehlende Geschäftsschlüssel, Lücken in Datums- oder Ereignisfolgen und fehlende Partitionen. Eine Tabelle kann eine niedrige Gesamt-Null-Rate haben, während einem kritischen Segment genau die Werte fehlen, die einen aufsichtsrechtlichen Bericht speisen.
Konsistenz verbindet Systeme, die übereinstimmen sollten. Gleichen Sie Kunden-, Konten-, Auftrags- oder Transaktionszahlen zwischen Quell- und Warehouse-Schicht ab. Prüfen Sie referenzielle Integrität zwischen Fakten- und Dimensionstabellen und melden Sie unvereinbare Definitionen derselben KPI. Systemübergreifende Vergleiche legen oft Probleme offen, die Validierung auf Zeilenebene übersieht.
Timeliness sollte Aktualitätsverzug, erwartete Lieferfenster und die Zahl verspäteter oder fehlender Ladungen nutzen. Der Leitfaden zum Timeliness-Monitoring hilft beim Definieren von Aktualitätsmaßen für Tabellen und Event-Streams. Eine geplante Erwartung kann angeben, wann eine Ladung eintreffen sollte, während eine gelernte Erwartung ungewöhnliche Drift im normalen Liefermuster erkennt, ein Ansatz, den dignas Best Practices für Data Pipelines beschreiben.
Gültigkeit umfasst Schemakonformität, zulässige Werte, Formate und Geschäftsregeln. Eindeutigkeit prüft doppelte Kennungen, wiederholte Datensätze und ungelöste Entitätszuordnungen. Integrität und Zugänglichkeit lassen sich ergänzen, wo Beziehungen, Berechtigungen und Verfügbarkeit für das Datenprodukt wesentlich sind.
Dimension | Zentrale Kennzahlen | Operatives Signal |
|---|---|---|
Genauigkeit | Ausreißerkennzeichen, Referenzabweichungen, Abstimmungsergebnisse | Unerwartete Werte oder Quellabweichungen untersuchen |
Vollständigkeit | Null-Rate, Zahl fehlender Schlüssel, Folgenlücken | Unvollständige Datensätze isolieren oder den Produzenten kontaktieren |
Konsistenz | Systemübergreifende Abweichung, Verstöße gegen referenzielle Integrität | Widersprüchliche Definitionen oder gebrochene Beziehungen nachverfolgen |
Timeliness | Aktualitätsverzug, Zahl verspäteter Ladungen, Abweichung von der erwarteten Lieferung | Eskalieren, bevor ein Bericht oder Modell veraltete Daten nutzt |
Gültigkeit | Schemakonformität, Verstöße gegen zulässige Werte, Regelverletzungen | Ungültige Datensätze ablehnen, isolieren oder bereinigen |
Eindeutigkeit | Dublettenzahl, Rate doppelter Schlüssel, Ausnahmen bei der Entitätsauflösung | Datensätze zusammenführen oder Identitätslogik korrigieren |
Die Scorecard sollte möglichst auf Datensatz- und Feldebene arbeiten. Ein Qualitätswert auf Tabellenebene kann die genau verursachende Spalte verbergen, während eine Feldsicht dem Engineer hilft, den gebrochenen Vertrag schnell zu identifizieren.
Teams, die solche Kontrollen aufbauen, brauchen mitunter spezialisierte Unterstützung bei der Besetzung, besonders wenn sie Data Quality Engineers in LATAM rekrutieren wollen. Menschen bleiben Teil des Kontrollsystems. Jede Kennzahl braucht einen Owner, einen Schwellenwert, einen Benachrichtigungsweg und ein Reaktions-Playbook.
Ohne diese Elemente füllen Messungen einen Bericht. Mit ihnen sagt die Scorecard dem Team, was als Nächstes zu tun ist.
Architektur- und Bereitstellungsmuster für das Unternehmen
Die Architektur entscheidet, ob Datenqualitätskontrollen Teil des Produktionsbetriebs werden oder ein isoliertes Monitoring-Projekt bleiben. Das richtige Muster hängt davon ab, wo sensible Daten liegen, wie viel Infrastruktur das Team betreiben kann und wie schnell Sicherheits- und Einkaufsteams einen neuen Dienst freigeben können.
Berechnung nah an den Daten halten
In-Database- oder In-Pipeline-Ausführung führt Profiling, Validierung und Metrikberechnung in Systemen wie Snowflake, BigQuery, Databricks oder einer Orchestrierungsschicht aus. Das reduziert unnötige Bewegung sensibler Zeilen und lässt Kontrollen neben den Workloads laufen, die sie schützen.
Dieses Muster passt zu Teams mit strikten PII-Grenzen oder der Präferenz, Rohdaten in bestehenden Governance-Kontrollen zu halten. Es begrenzt zudem ein häufiges Umsetzungsproblem, bei dem Monitoring eine zweite Kopie der Produktionsdaten verlangt und einen weiteren Synchronisationspfad einführt.
Isolationsanforderungen und Deployment aufeinander abstimmen
Banken, Gesundheitsorganisationen und Behörden verlangen mitunter Private Cloud, VPC-isolierte oder On-Premises-Bereitstellung. Die Entscheidung ist nicht nur technische Präferenz. Sie kann von Datenresidenz, internen Sicherheitsprüfungen, Netzwerkarchitektur und davon abhängen, ob ein Anbieter ohne Zugriff auf Produktionsdaten arbeiten kann.
Ein Deployment, das Sicherheitsanforderungen erfüllt, aber umfangreiche Infrastrukturverantwortung verlangt, kann ein kleines Plattformteam überfordern. Umgekehrt kann eine bequeme gehostete Option in der Anbieterprüfung hängen bleiben, wenn sie den Handhabungsregeln der Organisation widerspricht.
Fähigkeiten in operativen Stufen einkaufen
Modulare Lizenzierung erlaubt einem Team, mit einem fokussierten Problem zu beginnen, etwa Anomalieerkennung oder Timeliness, und dann Schema-Tracking, Validierung oder breitere Observability zu ergänzen, sobald Verantwortlichkeiten und Reaktionsroutinen reifen. So zahlt man nicht für Kontrollen, die die Organisation noch nicht wirksam betreiben kann.
Muster | Wo es läuft | Beste Eignung | Zentrale Abwägung |
|---|---|---|---|
In-Database oder In-Pipeline | Warehouse, Lakehouse oder Orchestrator | Teams, die Datenbewegung minimieren | Muss zu bestehenden Compute- und Pipeline-Mustern passen |
Private oder isolierte Bereitstellung | Kunden-Cloud, VPC oder Rechenzentrum | Regulierte oder sicherheitssensible Landschaften | Erfordert Infrastruktur- und Freigabekapazität |
Modulare Einführung | Zuerst ausgewählte Fähigkeiten, breitere Abdeckung später | Kleine Teams, die Wert schrittweise nachweisen | Abdeckung kann ohne Wachstumsplan fragmentiert bleiben |
Architektur ist auch eine Beschaffungsfrage. Eine technisch leistungsfähige Engine schafft keinen Wert, wenn die Rechtsprüfung das Deployment blockiert, die Budgetfreigabe zu spät kommt oder Engineers eine Architektur pflegen müssen, die nicht zu ihrem Stack passt. Teams, die die umgebende Enterprise-Datenplattform bewerten, sollten Sicherheitsgrenzen, Integrationsaufwand, Verantwortung und Betriebskosten in dieselbe Entscheidung einbeziehen.
Best Practices und eine realistische Umsetzungs-Roadmap
Ein Rollout sollte mit geschäftskritischen Fehlerbildern beginnen, nicht mit dem Versuch, alle Assets auf einmal zu überwachen. Das erste Ziel ist, dass die Organisation nicht länger durch Eskalation aus der Führungsebene von Datenfehlern erfährt.
Phase eins adressiert sichtbare Fehler
Beginnen Sie damit, die fünf umsatzkritischsten Tabellen zu instrumentieren. Setzen Sie Volumen- und Aktualitätsalerts und leiten Sie sie in den bestehenden Slack- oder PagerDuty-Workflow des Teams. Der genaue Kanal zählt weniger als die Gewissheit, dass die Datenverantwortlichen das Signal vor den Dashboard-Konsumenten sehen.
Nutzen Sie die erste Phase, um Baselines und Verantwortlichkeiten zu etablieren. Halten Sie für jede Tabelle das normale Ankunftsmuster, erwartetes Volumenverhalten, kritische Felder, nachgelagerte Konsumenten und den Eskalationskontakt fest. Ergänzen Sie keine komplexen Geschäftsregeln, bevor das Team auf einfache Aktualitäts- und Volumenvorfälle verlässlich reagieren kann.
Phase zwei macht aus Annahmen Verträge
Arbeiten Sie danach mit den produzierenden Teams an Validierungsregeln für die relevanten Felder und Beziehungen. Ein Datenkontrakt sollte Schema, zulässige Werte, Pflichtfelder, Verantwortung und das Vorgehen benennen, wenn der Produzent die Struktur ändert.
Benachrichtigungen zu Schemaänderungen sollten eintreffen, bevor Drift nachgelagerte Modelle erreicht. Die Meldung sollte geändertes Feld, Typ- oder Strukturunterschied, erstes beobachtetes Auftreten, betroffenen Datensatz und bekannte Konsumenten enthalten. Dieser Kontext hilft dem Produzenten, die Quelle zu reparieren, statt jedes nachgelagerte Team denselben Bruch neu entdecken zu lassen.
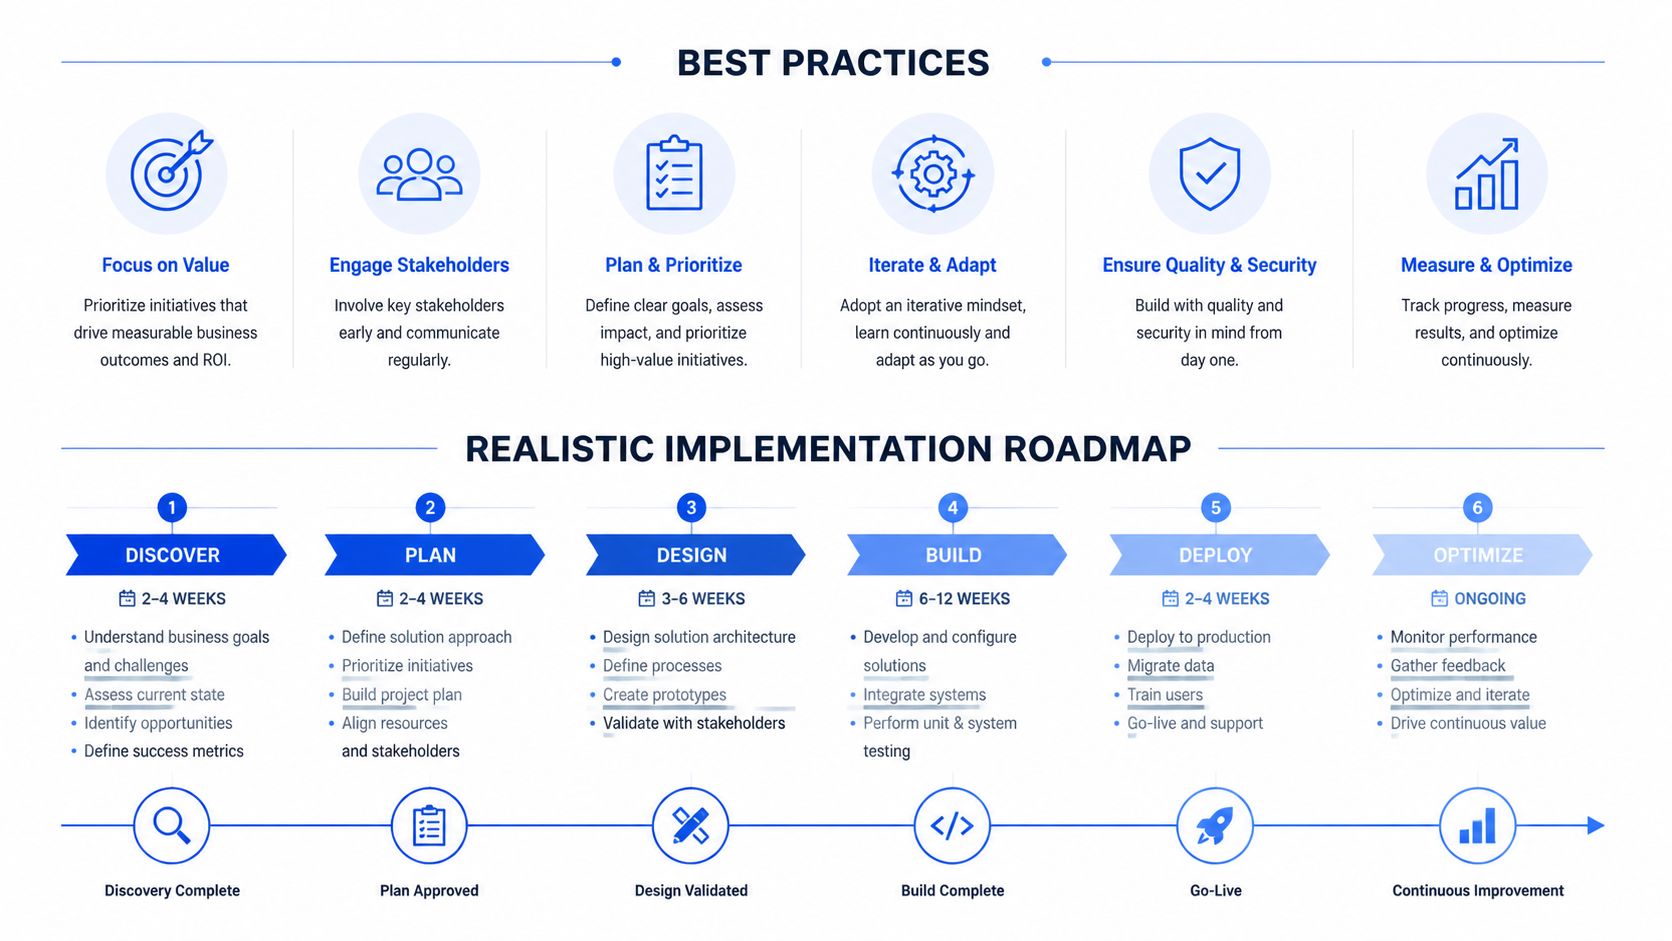
Phase drei macht Qualität zum Teil der Auslieferung
Betten Sie wichtige Prüfungen in die CI für Pipeline-Code und Schemaänderungen ein. Ein Pull Request, der ein Modell oder einen Kontrakt ändert, sollte zeigen, welche Qualitätskontrollen betroffen sind und ob bekannte Konsumenten kompatibel bleiben.
Standardisieren Sie Vorfall-Postmortems entlang Fehlermechanismus, Erkennungslücke, Verantwortungslücke und präventiver Kontrolle. Koppeln Sie Qualitäts-KPIs an SLA-Reviews, damit wiederkehrende Vorfälle Planung und Servicegespräche beeinflussen und nicht nur ein Engineering-Backlog.
Ein praxisnaher Ansatz zur Umsetzung von Datenqualität sollte auch die Gewohnheiten enthalten, die Abdeckung vor Verfall schützen:
Gemeinsame Namen nutzen: Verwenden Sie einheitliche Bezeichnungen für Dimensionen, Kennzahlen, Alerts, Datensätze und Schweregrade.
Eine Regelquelle pflegen: Speichern Sie aktive Kontrakte und Validierungsdefinitionen an einem Ort, den Teams finden und prüfen können.
Datensatz-Owner benennen: Geben Sie jedem kritischen Asset einen benannten fachlichen Owner und einen technischen Responder.
Alert-Verhalten prüfen: Untersuchen Sie, welche Alerts noch auslösen, welche ignoriert werden und welche kein sinnvolles Risiko mehr abbilden.
Ausnahmen dokumentieren: Halten Sie akzeptierte Abweichungen fest, damit temporäre Freigaben nicht zu unsichtbaren Dauerfehlern werden.
Das Programm wird tragfähig, wenn jede neue Prüfung einen Grund, einen Owner und einen Reaktionsweg hat. Abdeckung sollte wachsen, weil das Team aus Vorfällen gelernt hat, nicht weil ein Dashboard vollständiger aussieht.
Wie eine modulare Plattform operative Probleme löst
Eine modulare Plattform lässt sich leichter bewerten, wenn jedes Modul an ein Fehlerbild gekoppelt ist. Die Frage ist nicht, ob ein Feature existiert. Die Frage ist, was jemand damit in einer echten Betriebswoche erkennen oder verhindern kann.
Anomalieerkennung adressiert das Problem des überraschenden Dashboards. Ein Händler kann Aktionsumsatz, Bestellvolumen und Kundenaktivität gegen gelernte Baselines überwachen. Eine ungewöhnliche Bewegung kann eine Untersuchung auslösen, bevor ein Führungsreview stattfindet, selbst wenn die Pipeline Erfolg meldet.
Schema-Tracking adressiert das Problem des gebrochenen Nachtjobs. Ein Logistikteam, das Flottentelemetrie erhält, muss wissen, wann eine Quelle ein Feld ergänzt, entfernt, einen Typ ändert oder einen verschachtelten Pfad umbaut. Der Vergleich von Feldmengen und Struktureigenschaften gibt Engineers ein frühes Signal, bevor nachgelagerte Transformationen scheitern. Praktische Monitoring-Empfehlungen raten, Quelle, Datensatz, Kontraktversion, erstes Auftreten und betroffene Konsumenten festzuhalten, was die Behebung direkter macht. Diese Details behandelt die Anleitung zum Monitoring von Schema-Drift.
Timeliness-Kontrollen adressieren Vorfälle mit veralteten Berichten. Ein Finanzteam kann erwartetes Lieferverhalten für Risiko- oder Transaktionsdaten definieren und eine verspätete Ladung von einer erwarteten Kalenderabweichung unterscheiden. Das Ergebnis ist ein Reaktionssignal, das auf fachlicher Verfügbarkeit beruht und nicht bloß auf Jobabschluss.
Validierungsregeln adressieren das Risiko regulatorischer Einreichungen. Eine Bank kann Kontrahentenfelder, zulässige Werte, erforderliche Beziehungen und Auditbedingungen prüfen, bevor ein Einreichungs-Workflow die Daten nutzt. Die Kontrolle ersetzt keine Governance. Sie übersetzt Governance-Anforderungen in wiederholbares Pipeline-Verhalten.
Observability adressiert das Problem, nicht zu wissen, was das Team nicht weiß. Sie verbindet Aktualität, Schema, Volumen, Validierung, Geschäftskennzahlen und Plattformverhalten, sodass Engineers eine Abweichung im Kontext untersuchen können.
Eine Plattform wie digna kombiniert Anomalieerkennung, Timeliness-Monitoring, Validierung auf Satzebene, Schema-Tracking, historische Analyse und In-Database-Ausführung, mit Bereitstellung in der Cloud, VPC oder im Rechenzentrum des Kunden. Ihre modulare Struktur erlaubt Teams, mit einem engen operativen Bedarf zu starten und erst zu erweitern, wenn sie Verantwortung und Reaktionskapazität zuweisen können.
Dieser Ansatz schützt auch bestehende Investitionen. Teams müssen nicht jede Pipeline ersetzen, um Monitoring zu ergänzen. Sie können Kontrollen um die wichtigsten Datenprodukte legen, nachweisen, dass Vorfälle leichter zu erkennen und zu lösen sind, und die Abdeckung dann über Finanzwesen, Gesundheit, Telekommunikation oder öffentliche Domänen ausweiten.
Datenqualität als Betriebsdisziplin neu denken
Mehr Validierungsregeln zu ergänzen fühlt sich produktiv an, weil die Regelzahl leicht darstellbar ist. Es garantiert keine vertrauenswürdigen Daten. Eine Regel ohne Owner, ein Schwellenwert ohne Reaktionsplan und ein Dashboard ohne Eskalation erzeugen den Anschein von Kontrolle, während dieselben Fehler weiterlaufen.
Das operative Maß ist ein anderes. Fragen Sie, ob das Team Vorfälle früher erkennt, Ursachen schneller findet, Berichtszyklen schützt und wiederholte Abstimmungsarbeit reduziert. Ergebnisse aus Unternehmensbefragungen zeigen, warum das zählt: In einem Branchenbrief von 2024 berichteten 95 % der Datenverantwortlichen und Praktiker von einem Datenqualitätsproblem mit direkter Geschäftswirkung, 95 % sagten, Observability allein reiche zur Ursachenbestimmung nicht, und 87 % sagten, klassische regelbasierte Ansätze skalierten nicht. Diese Zahlen stammen aus Anomalos Executive Brief zum Stand der Enterprise-Datenqualität.
Drei operative Verschiebungen machen den Unterschied:
Verantwortung zuweisen: Jeder kritische Datensatz braucht einen benannten fachlichen Owner und einen technischen Responder.
Kennzahlen an Ergebnisse binden: Verbinden Sie Aktualitäts-, Vollständigkeits- und Anomaliesignale mit Berichten, Modellen, regulatorischen Abläufen und Geschäfts-KPIs.
Fehlerbilder prüfen: Untersuchen Sie wiederkehrende Vorfälle quartalsweise und entfernen oder überarbeiten Sie Kontrollen, die Teams routinemäßig ignorieren.
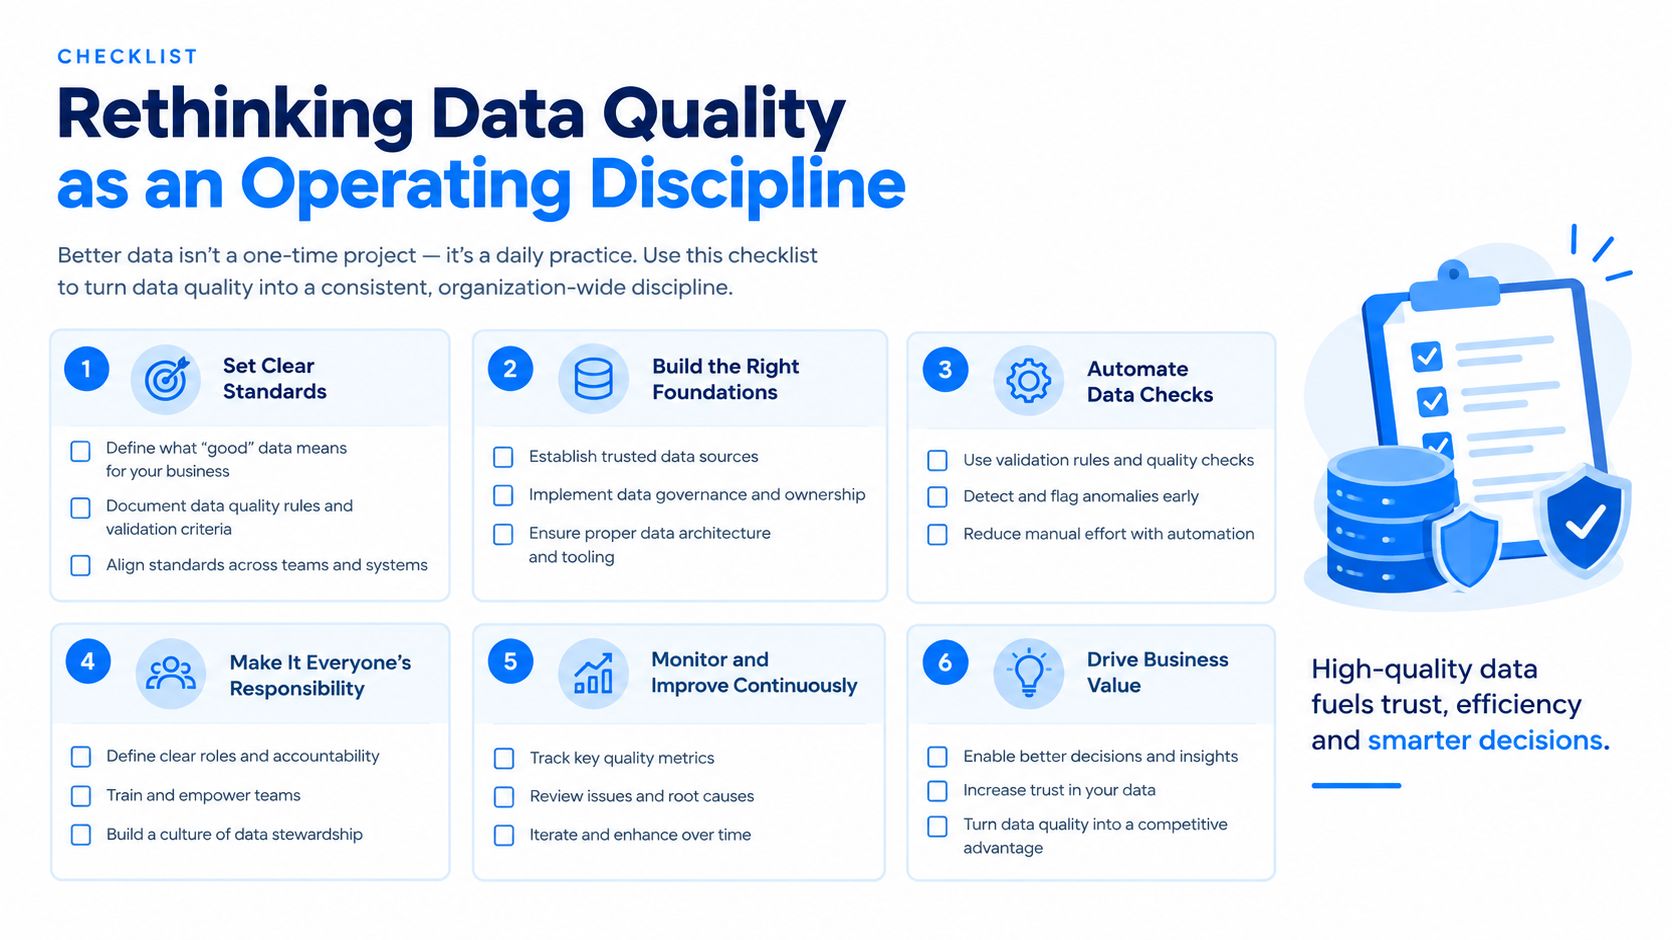
Nutzen Sie diese Checkliste zu Beginn des nächsten Quartals:
Identifizieren Sie die kritischen Datensätze hinter den wichtigsten Entscheidungen.
Bestätigen Sie für jeden davon Owner, Responder, Schwellenwert und Eskalationsweg.
Entfernen Sie doppelte oder nicht handlungsleitende Regeln.
Ergänzen Sie Monitoring für die häufigsten Aktualitäts-, Schema-, Volumen- und Vollständigkeitsfehler.
Prüfen Sie jeden ignorierten Alert und entscheiden Sie, ob Sie ihn korrigieren, unterdrücken oder eskalieren.
Halten Sie für jeden wiederkehrenden Vorfall den Präventionsschritt fest.
Enterprise Data Quality Management funktioniert, wenn Kontrollen Teil davon werden, wie Teams Datenprodukte betreiben. Beginnen Sie bei den Fehlern, die Entscheidungen unterbrechen, und bauen Sie dann die technische Abdeckung und Verantwortlichkeit auf, die ihre Rückkehr verhindert.
Wenn veraltete Dashboards, stille Schemaänderungen oder unerklärte KPI-Verschiebungen die Zeit Ihres Teams verbrauchen, besuchen Sie digna und erkunden Sie eine Plattform in Ihrer Umgebung für Anomalieerkennung, Timeliness-Monitoring, Validierung und Schema-Tracking. Beginnen Sie mit den wichtigsten Datenassets, verbinden Sie Alerts mit verantwortlichen Ownern und weiten Sie die Abdeckung aus, während Ihr Betriebsmodell reift.
Die Erkennungsschicht für Fehler, für die keine Regel geschrieben wurde, zeigt Data Observability.
Häufig gestellte Fragen
Was ist Enterprise Data Quality Management?
Es ist die Praxis, Daten über die gesamte Landschaft hinweg statt je Projekt vertrauenswürdig zu halten, indem Verhaltensmonitoring, explizite Datenkontrakte, Aktualitätsverfolgung und Schemabewusstsein so kombiniert werden, dass Probleme auftauchen, bevor eine Entscheidung darauf beruht.
Warum brechen Dashboards, wenn keine Pipeline einen Fehler meldete?
Weil der meiste Schaden leise entsteht. Ein Anbieter benennt ein Feld im Payload um, ein Join verwirft stillschweigend die davon abhängigen Zeilen, und jeder Job meldet weiterhin Erfolg. Orchestrierung bestätigt, dass Software lief; sie sagt nichts darüber, ob die entstandenen Zahlen noch dasselbe bedeuten wie letzte Woche.
Welche Kennzahlen zählen bei Enterprise-Datenqualität am meisten?
Abdeckung kritischer Datensätze, Zeit bis zur Erkennung und bis zur Behebung, Wiederholungsrate und der Anteil der Probleme, die das Monitoring findet statt ein Fachanwender meldet. Letzteres ist das klarste Signal dafür, ob Ihre Kontrollen oder Ihre Stakeholder die Erkennung leisten.
Wo sollten Datenqualitätsprüfungen laufen?
So nah an den Daten wie möglich. Die Berechnung im Warehouse zu halten vermeidet, sensible Datensätze aus ihrem bestehenden Sicherheitsperimeter zu bewegen, und skaliert mit ohnehin bezahltem Speicher, was zählt, wenn Isolationsanforderungen eine Extraktion zu einem externen Dienst ausschließen.
Wie sieht ein realistischer Rollout aus?
Drei Phasen. Beginnen Sie mit sichtbaren Fehlern, damit der Nutzen offensichtlich ist, machen Sie dann aus den zugrunde liegenden Annahmen explizite Kontrakte und schließlich Qualität zum Teil der Auslieferung, sodass Kontrollen Releases beeinflussen. Die volle Fähigkeit vor Phase eins zu kaufen erzeugt meist Alerts ohne Owner.