Echtzeit-Datenqualität: Ein praktischer Leitfaden für 2026
|
7
min. Lesezeit

Sie kennen das Gefühl bereits. Das Dashboard sah am Morgen gut aus, das Quellsystem hatte sich bis zum Mittagessen geändert, und als es jemandem auffiel, hatte das Data Warehouse bereits eine Geschichte erzählt, die nicht stimmte. In regulierten Umgebungen ist eine solche Lücke kein kosmetisches Problem. So wird aus einer veralteten Einspeisung eine schlechte Entscheidung, ein fehlerhafter Bericht oder ein Vorfall, den niemand sauber erklären kann.
Echtzeit-Datenqualität ist die Disziplin, diese Fehler abzufangen, während sich die Daten noch in Bewegung befinden. Das bedeutet, dass Qualitätsprüfungen kein nächtlicher Bereinigungsjob mehr sind, sondern Teil des Live-Betriebspfads, gekoppelt an Aktualität, Latenz, Schemaänderungen und Nullwerte-Zählungen als beobachtbare Gesundheitssignale IBM-Observability-Metriken. Es bedeutet auch, dass die Architektur eine harte Wahrheit respektieren muss: Die Streaming-Validierung muss kontinuierlich laufen, ohne die End-to-End-Latenz zu beeinträchtigen IJERET-Streaming-Qualitätsforschung.
Inhaltsverzeichnis
Echtzeit- vs. Batch-Qualität und wo beide an ihre Grenzen stoßen
Wie In-Database-Ausführung, Anomalieerkennung und Schema-Tracking zusammenpassen
Eine Checkliste für den schrittweisen Rollout für den Einstieg
h2 id="48">Der Moment, in dem Batch-Qualität nicht mehr funktioniert
Der Fehlermodus ist bekannt. Ein Finanz-Dashboard sieht am Dienstag konsistent aus, ein Modell bewertet normal, und am Freitag driften die Zahlen ab, aber niemand kann den genauen Moment benennen, in dem die Daten schlecht wurden. Batch-Prüfungen können besagen, dass der gestrige Ladevorgang erfolgreich war, während das Kernproblem zwischen den Jobs begann und sich nachgelagert fortpflanzte, bevor jemand die Möglichkeit hatte, es zu stoppen.
Deshalb ist Echtzeitqualität nicht einfach „schnellere Batch-Verarbeitung“. Es ist ein anderes Betriebsmodell. Die Streaming-Qualitätsforschung beschreibt, dass Qualitätsmetriken kontinuierlich berechnet werden, damit Teams Probleme erkennen können, sobald Daten eintreffen, und nicht erst nach nächtlichen Verarbeitungsjobs. Dies stellt eine bedeutende Verschiebung im Denken von Ingenieuren über Kontrolle dar, nicht nur über Tools ACM-Streaming-Analytics-Paper.
Aktualität verändert die Definition von Qualität
In der Praxis ist die fehlende Dimension oft die Rechtzeitigkeit. Ein Datensatz kann technisch valide und dennoch operativ falsch sein, wenn er verspätet, unvollständig oder außerhalb des Taktes eintrifft. Deswegen spielen Aktualität, Latenz und Pipeline-Verhalten heute eine ebenso große Rolle wie die klassischen Dimensionen Genauigkeit und Vollständigkeit.
Praktische Regel: Wenn das Dashboard von zeitkritischen Daten abhängt, betrachten Sie Verzögerungen als Qualitätsmangel und nicht nur als ein Ärgernis in der Pipeline.
Die Batch-Validierung hat immer noch ihre Berechtigung, insbesondere für retrospektive Audits und tiefgehendes Profiling. Aber bei Betrug, operativen Abläufen und kundenorientierten Workflows führt das Warten auf den nächsten geplanten Job dazu, dass sich schlechte Datensätze verbreiten. Echtzeitqualität existiert, weil sich die geschäftlichen Kosten von Verzögerungen bemerkbar machen, bevor das Batch-Fenster schließt.
Was Echtzeit-Datenqualität tatsächlich bedeutet
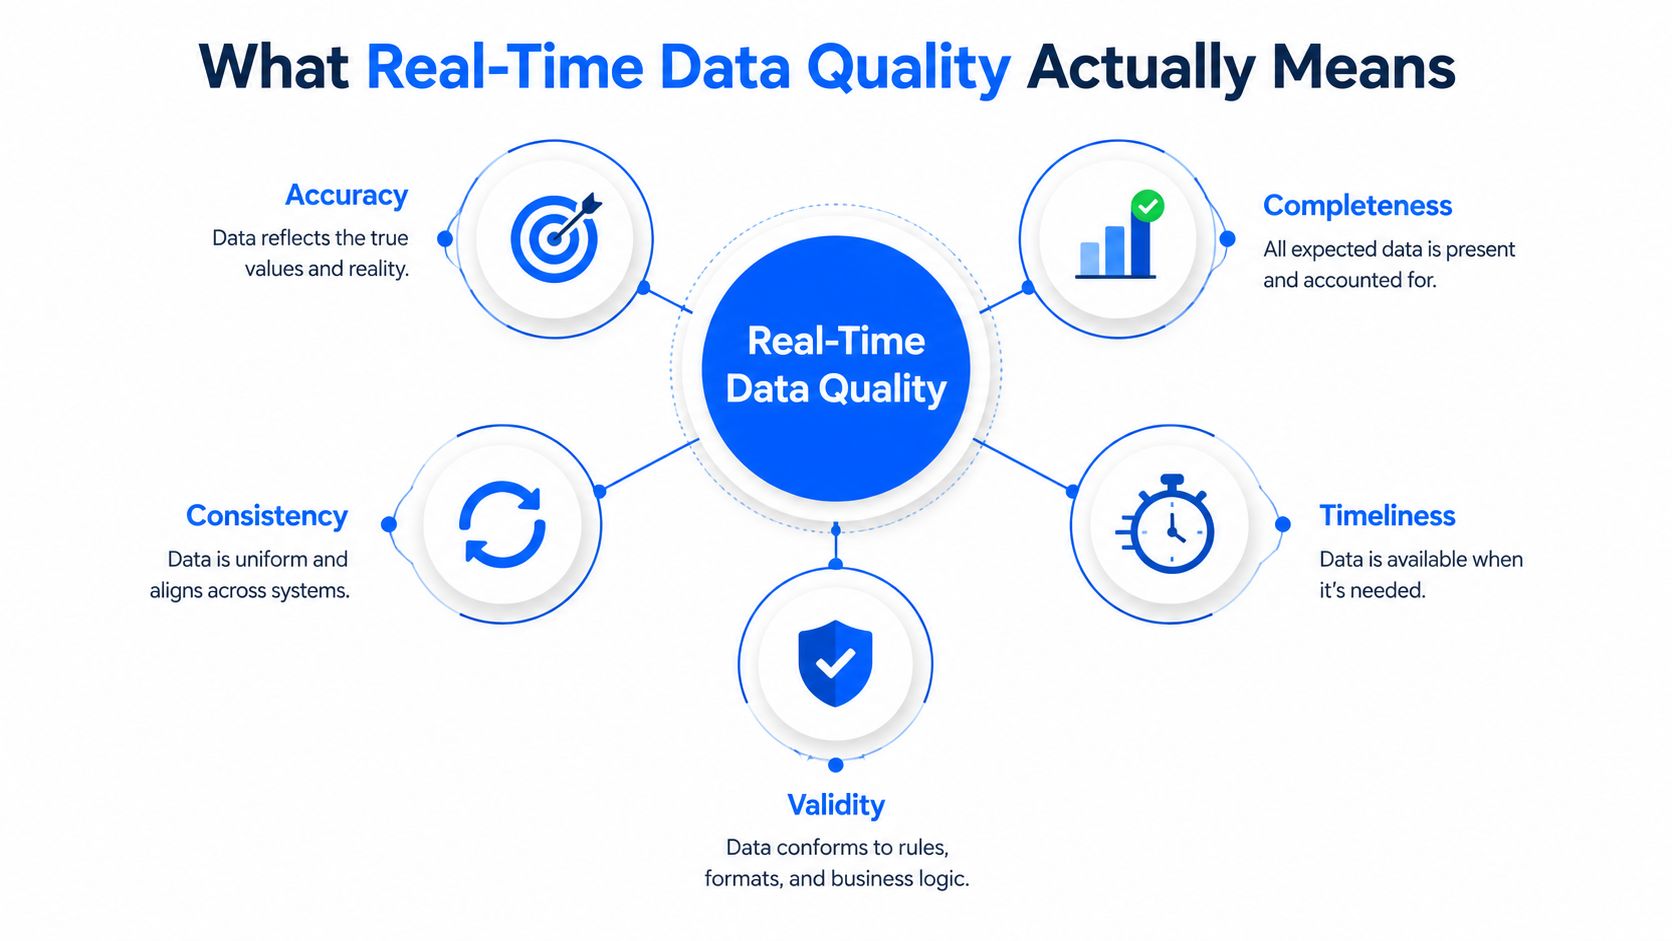
Eine nützliche Definition ist einfach. Echtzeit-Datenqualität ist die kontinuierliche Überprüfung von Daten, während sie sich durch die Pipeline bewegen, mit Kontrollen, die im Moment des Eintreffens beurteilen, ob jeder Datensatz für die nachgelagerte Nutzung geeignet ist. Es geht nicht darum, ein zweites Data Warehouse mit Regeln aufzubauen, sondern zu verhindern, dass strukturelle und verhaltensbezogene Probleme die Grenze zu den Produktionssystemen überschreiten.
Aktualität steht im Mittelpunkt
Bei Echtzeitsystemen ist die Aktualität meist die erste Metrik, die Probleme aufzeigt. Eine Standarddefinition dafür ist die Zeit, die seit dem Schreiben des letzten Datensatzes in einen Datensatz im Vergleich zu einem SLA vergangen ist Soda-Leitfaden für Aktualitätsmetriken. Das macht Aktualität pragmatisch und nicht philosophisch.
Die restlichen Dimensionen lassen sich leichter beurteilen, sobald die Aktualität gegeben ist:
Vollständigkeit zeigt Ihnen, ob die erwarteten Felder und Quellen eingetroffen sind.
Gültigkeit sagt Ihnen, ob die Werte dem erwarteten Format, Typ und Bereich entsprechen.
Konsistenz zeigt Ihnen, ob dieselbe Entität systemübergreifend übereinstimmt.
Eindeutigkeit zeigt Ihnen, ob Duplikate in den Stream gelangen.
Zu den Standarddimensionen von IBM gehören Genauigkeit, Vollständigkeit, Konsistenz, Rechtzeitigkeit, Gültigkeit und Eindeutigkeit, und die Definition von Gültigkeit der britischen Regierung legt den Fokus auf Format, Typ und Bereich IBM-Datenqualitätsdimensionen.
Ein einzelner Datensatz kann zum Zeitpunkt der Erfassung im Hinblick auf all diese Aspekte bewertet werden. Wenn ein Bestellereignis pünktlich eintrifft, mit dem richtigen Schema, einer akzeptierten Währung, ohne doppelte ID und mit passenden Kunden-Stammdaten, wird es freigegeben. Wenn es verspätet oder mit einer Typänderung eintrifft, sollte das System die spezifische Dimension kennzeichnen, die fehlgeschlagen ist, und es nicht einfach als „schlecht“ markieren.
Rechtzeitigkeit ist keine Nebenmetrik. In Live-Systemen ist sie Teil der Definition von Qualität selbst.
Echtzeit- vs. Batch-Qualität und wo beide an ihre Grenzen stoßen
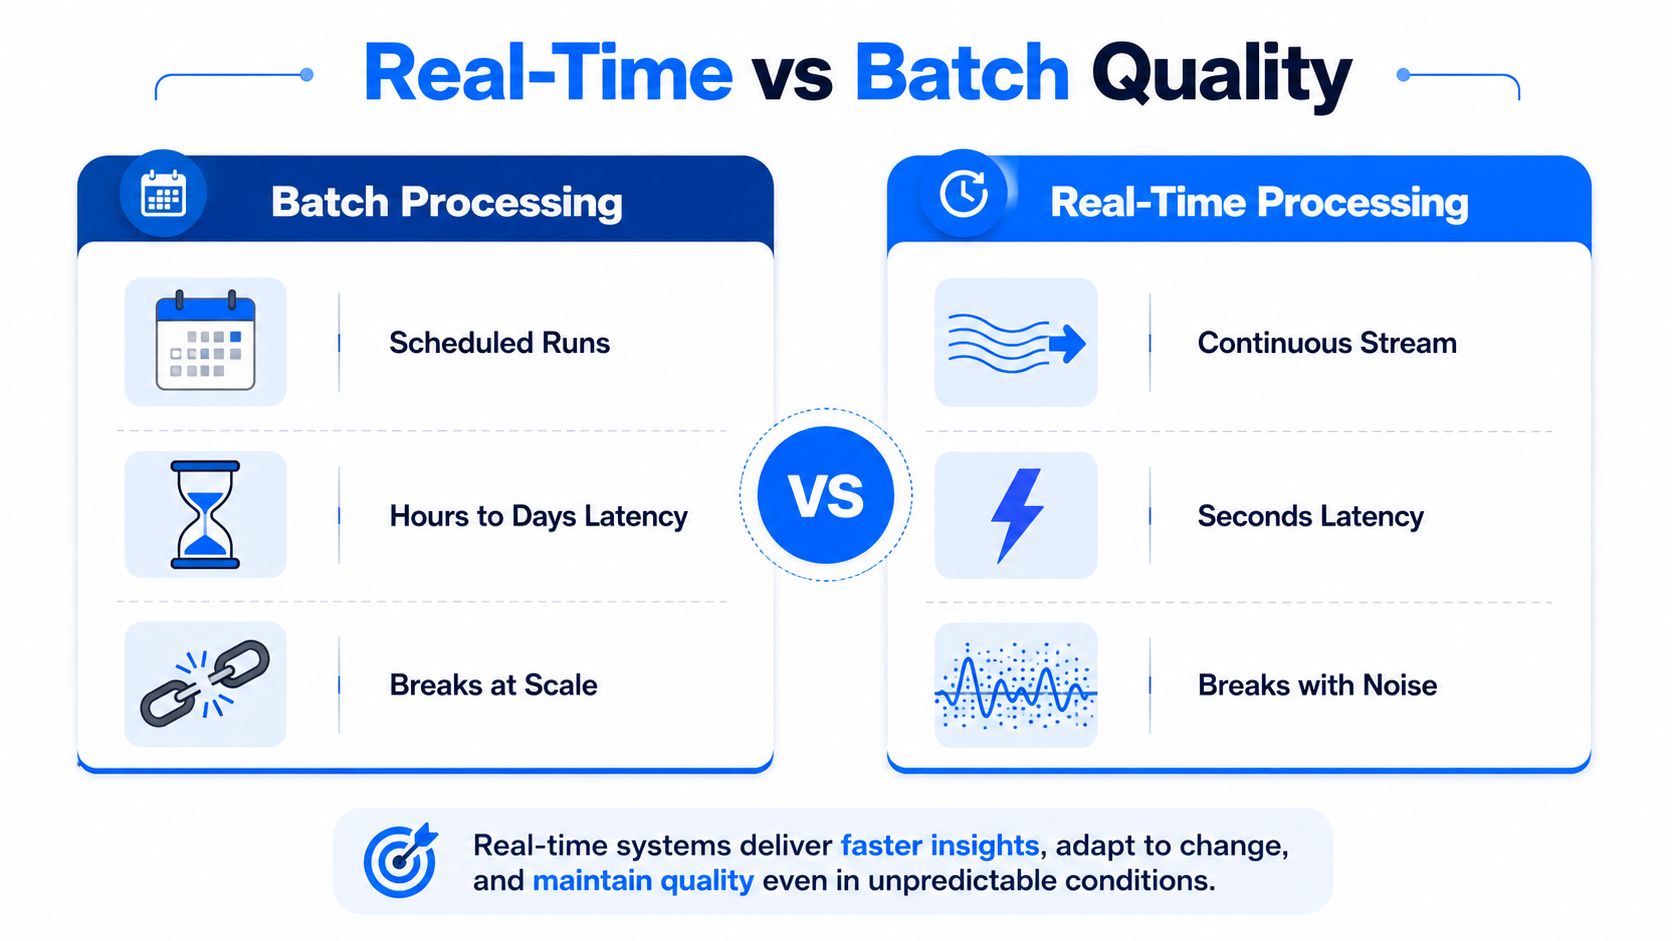
Batch-Qualität und Echtzeit-Qualität sind keine Konkurrenten. Sie sind unterschiedliche Kontrollbereiche. Batch bietet Ihnen Breite, historischen Kontext und kostengünstigere retrospektive Analysen. Echtzeit bietet Ihnen die Möglichkeit, fehlerhafte Ereignisse zu blockieren, bevor sie Dashboards, Modelle oder Kunden-Workflows verunreinigen.
Der Unterschied ist wichtig, da sich derselbe Datensatz unter den beiden Systemen anders verhält. Ein nächtlicher Job kann fehlerhafte Zeilen nach dem Laden erkennen, während eine Streaming-Prüfung sie bereits bei der Erfassung stoppen kann. Geplante Micro-Batches verringern die Lücke, hinterlassen aber immer noch blinde Flecken zwischen den Durchläufen. Kontinuierliches Streaming schließt diese Lücke, indem es validiert, während sich die Daten noch in Bewegung befinden Confluent-Leitfaden für Streaming-Architekturen.
Wo Batch-Verarbeitung immer noch hingehört
Die Batch-Qualität hat nach wie vor ihren Platz in Programmen, die ein tieferes Profiling, Untersuchungen nach Vorfällen oder revisionssichere Nachweise erfordern. Sie ist nützlich, wenn Sie große Historien scannen, Verteilungen vergleichen oder nachweisen möchten, dass eine Kontrolle nach einem bestimmten Zeitplan ausgeführt wurde. Mit anderen Worten: Batch eignet sich gut für Analysen.
Wo sie kläglich versagt
Sie versagt, wenn es dem Unternehmen auf den aktuellen Zustand der Welt ankommt. Umsatz-Dashboards, Betrugserkennung, klinische Alarmierung und operative SLAs hängen alle von Daten ab, die aktuell genug sind, um darauf zu reagieren. Wenn ein Lieferant einen nächtlichen Durchlauf verpasst, kann der Bericht immer noch sauber aussehen, obwohl das Warehouse bereits Stunden hinterherhinkt. Das ist die schlimmste Art von Fehler, da die Zahlen vertrauenswürdig erscheinen.
Batch sagt, dass der Job beendet ist. Echtzeit sagt, dass die Daten immer noch einsatzbereit sind.
Die praktische Antwort ist meist eine Mischung aus beidem. Lassen Sie Batch die tiefgehende retrospektive Arbeit erledigen, aber verschieben Sie Erfassungsprüfungen, Rechtzeitigkeitsprüfungen und geschäftskritische Validierungen in den Streaming-Pfad. Auf diese Weise wird der nächtliche Bericht zur Bestätigung und nicht zur ersten Verteidigungslinie.
Blick in die Echtzeit-Qualitätspipeline
Eine praktische Streaming-Pipeline folgt fünf Schritten. Erfassen Sie zunächst Ereignisse in einer Streaming-Schicht. Validieren Sie dann das Schema an der Grenze, wenden Sie Geschäftsregeln auf die Payload an und leiten Sie ungültige Datensätze in die Quarantäne weiter, anstatt sie zu verwerfen. Berechnen Sie danach kontinuierlich Qualitäts-KPIs und schlagen Sie Alarm, wenn Schwellenwerte überschritten werden. Ein Confluent-Pipeline-Ablauf ist eine nützliche Referenz für diese Abfolge.
Warum der Ort der Ausführung wichtig ist
Der größte Fehler, den Teams machen, besteht darin, Daten in eine separate Qualitäts-Engine zu verschieben, obwohl das Quellsystem bereits über genügend Kontext verfügt, um sie zu bewerten. Eine Studie aus Cambridge über Echtzeit-Big-Data-Systeme ergab, dass der Overhead für Qualitätsprüfungen von Übertragungen zwischen Modulen, Nachrichtensynchronisation und Algorithmenkomplexität abhängt. Aus diesem Grund können zusätzliche Zwischenschritte die gesamte Pipeline verlangsamen Cambridge Echtzeit-Big-Data-Studie. In der Praxis drängt dies Teams zu In-Stream- und In-Database-Prüfungen.
Die Durchsetzung von Schemata gehört in die Erfassung, da dies der kostengünstigste Ort ist, um strukturelle Abweichungen abzufangen. Geschäftsregeln gehören direkt dahinter, solange das Ereignis noch handlungsrelevant ist. Die Quarantäne ist kein Fehlerzustand, sondern ein Kontrollpunkt. Schlechte Datensätze sollten isoliert, gekennzeichnet und zur Überprüfung bereitgehalten werden, ohne nachgelagerte Systeme zu verunreinigen.
Die Architektur benötigt zudem einen gemeinsamen Ort, an dem Ingenieure und Analysten Vorfälle einsehen können. Eine einzige Benutzeroberfläche für Anomalien, Validierungsfehler und Verzögerungen bei der Rechtzeitigkeit reduziert Übergaben, insbesondere wenn Plattform- und Geschäftsteams denselben Datensatz im selben Fenster betrachten müssen. Das ist umso wichtiger, wenn das Betriebsmodell Echtzeit-Datenmonitoring beinhaltet, da die Personen, die die Pipeline überwachen, Rauschen schnell von echten Ausfällen trennen müssen.
Für Teams, die Tools evaluieren, ist die praktische Checkliste einfach: Schema-Enforcement, Streaming-Regeln, Quarantäne und sichtbare Metriken. Das richtige Setup ist dasjenige, das die Prüfungen nah an den Daten hält, Fehler beobachtbar macht und die Latenz innerhalb des Fensters hält, das das Unternehmen tolerieren kann.
Wie In-Database-Ausführung, Anomalieerkennung und Schema-Tracking zusammenpassen
Die effektivsten Systeme betrachten Monitoring-Module nicht als isolierte Funktionen. Sie arbeiten wie eine Steuerungsebene. Die In-Database-Ausführung belässt die Daten an Ort und Stelle, sodass Prüfungen innerhalb der kundeneigenen Umgebung stattfinden. Dies reduziert Datenbewegungen und stimmt die Qualitätsschicht mit der bestehenden governance ab. Die Anomalieerkennung fügt ein grundlegendes Lernen hinzu, sodass das System Abweichungen melden kann, ohne dass Ingenieure jeden Schwellenwert manuell festlegen müssen.
Drei Funktionen, drei verschiedene Fehlermodi
Die Anomalieerkennung ist dann am stärksten, wenn sich das Verhalten verschiebt, das Schema aber stabil bleibt. Sie lernt die normale Form eines Datensatzes und kennzeichnet ungewöhnliche Muster, Spitzen oder Einbrüche. Das Schema-Tracking deckt eine andere Klasse von Fehlern ab: hinzugefügte Spalten, entfernte Spalten und Änderungen des Datentyps, die nachgelagerte Verbraucher stören können, noch bevor die Geschäftslogik überhaupt ausgeführt wird.
Die Überwachung der Rechtzeitigkeit schließt die Lücke, die die anderen beiden offenlassen. Ein Datensatz kann statistisch normal aussehen und dennoch zu spät, zu früh oder gar nicht eintreffen. Aus diesem Grund gehören Eingangsmuster, erwartete Lieferzeiten und die Erkennung von Verzögerungen in denselben operativen Denkprozess wie Anomalieerkennung und Validierung.
Gute Qualitätssysteme verlangen nicht von einem einzigen Modul, jedes Problem zu lösen. Sie stapeln Module so, dass jedes einen anderen Fehlermodus abfängt.
Für einen praktischen Blick auf die Modellauswahl ist der Leitfaden Auswahl der richtigen Lösung zur Anomalieerkennung nützlich, wenn Sie entscheiden müssen, ob Sie sich auf deterministische Prüfungen, erlernte Baselines oder beides verlassen wollen. Und wenn Sie diesen Ansatz in einen Warehouse-zentrierten Stack integrieren, ist das interne Framework zu Databricks Datenqualitäts-Framework ein hilfreicher Referenzpunkt.
digna passt als eine Option auf dem Markt in dieses Muster, da es Prüfungen in der eigenen Umgebung des Kunden ausführt, In-Database-Ausführung unterstützt und Anomalieerkennung, Rechtzeitigkeit, Validierung und Schema-Tracking in einer Plattform kombiniert. Diese Kombination ist wichtiger als jedes einzelne Feature.
KPIs, die Sie tatsächlich verfolgen sollten
Ein Echtzeit-Programm benötigt kein riesiges Dashboard. Es braucht eine kurze Liste von Metriken, die direkt dem operativen Risiko zugeordnet sind. Beginnen Sie mit Aktualität, Latenz, der Anzahl veralteter Datensätze, dem Prozentsatz der Werte außerhalb akzeptierter Bereiche, dem Anteil der Datensätze, die Validierungsregeln verletzen, sowie Syntax- oder Formatfehlern wie ungültigen E-Mail-Adressen Alation-Datenqualitätsmetriken.
Die richtige Metrik hängt von dem Fehler ab, den Sie verhindern wollen. Die Aktualität sagt Ihnen, ob der letzte Ladevorgang nutzbar ist. Die Latenz sagt Ihnen, wie viel des Datensatzes das SLA-Fenster eingehalten hat. Die Validierungsfehlerrate zeigt Ihnen, ob die Regeln zu locker sind oder sich die vorgelagerten Daten geändert haben. Werte außerhalb des zulässigen Bereichs fangen fehlerhafte Geschäftsereignisse ab, die syntaktisch dennoch valide aussehen.
Zentrale KPIs für Echtzeit-Datenqualität
Dimension | Metrik | Messmethode | Referenz-Schwellenwert |
|---|---|---|---|
Aktualität | Zeit seit dem neuesten Datensatz | Vergleich der letzten Schreibzeit mit dem SLA-Fenster | Definiert pro kritischem Datensatz |
Latenz | Prozentsatz der innerhalb des SLA aktualisierten Datensätze | Messung der Datensätze, die innerhalb des erwarteten Fensters eintreffen | Definiert pro Pipeline |
Vollständigkeit | Fehlende Pflichtfelder | Zählung der vorhandenen Pflichtfelder pro Datensatz | Definiert pro Datensatz-Tier |
Gültigkeit | Datensätze außerhalb des akzeptierten Bereichs | Validierung von Typ, Format und Bereich bei Erfassung | Definiert durch Geschäftsregel |
Validierung | Datensätze, die Regeln verletzen | Zählung abgewiesener oder unter Quarantäne gestellter Datensätze | Definiert pro Kontrolle |
Als Faustregel gilt, jede technische Metrik mit einer geschäftlichen Konsequenz zu verknüpfen. Wenn eine Umsatz-Tabelle ihr Aktualitäts-SLA verfehlt, ist das Problem kein gelbes Symbol, sondern ein verpasstes Berichtsfenster. So bleibt das Monitoring nützlich und ist nicht nur dekorativ.
Um das Programm auf Kurs zu halten, definieren Sie die Metrik, legen Sie den Schwellenwert fest, automatisieren Sie die Prüfung und verfolgen Sie das Ergebnis im Zeitverlauf. Die interne Seite zu Datenqualitätsmetriken ist ein guter Ausgangspunkt, um diese Disziplin in ein wiederholbares Betriebsmuster zu verwandeln.
Gemeinsame Herausforderungen und Sicherheitsaspekte
Die meisten Echtzeit-Qualitätsprogramme scheitern an der Governance, nicht an der Erkennungslogik. Schwellenwerte werden zu aggressiv gewählt, und es stellt sich eine Alarm-Müdigkeit ein. Die Zuständigkeiten verschwimmen, wenn ein Vorfall gleichzeitig das Quellteam, das Plattformteam und den Geschäftsinhaber betrifft. Dann kauft jemand ein weiteres Tool, und der Stack wird schwieriger zu verwalten.
Sicherheit wird in der Architektur entschieden, nicht im Richtliniendokument
Regulierte Teams achten genau darauf, wo die Prüfungen laufen. Wenn ein Anbieter verlangt, dass Daten die Umgebung des Kunden verlassen, führt dies zu einem Prüfungsaufwand und oft zu einer Blockade. Die Ausführung von Prüfungen direkt in der Datenbank – innerhalb der Cloud des Kunden, der VPC oder einer On-Premises-Umgebung – hält die Qualitätsschicht unter denselben Zugriffskontrollen wie das Warehouse selbst.
Das ändert auch die Wirtschaftlichkeit des Monitorings. Eine transparente, nutzungsstabile Preisgestaltung erleichtert es, die Abdeckung zu erweitern, ohne befürchten zu müssen, dass jeder neue Alarm oder Scan zu unerwarteten Kosten führt. Eine einzige gemeinsame Benutzeroberfläche hilft ebenfalls, da Ingenieure, Analysten und Governance-Teams dieselbe Anomalie, dasselbe Aktualitätsproblem, denselben Validierungsfehler oder dieselbe Schemaänderung überprüfen können, ohne Screenshots hin und her zu schicken.
Der Hauptfehler besteht darin, Echtzeitqualität als ein Nischen-Utility zu betrachten. In der Praxis ist sie gleichzeitig Teil der Plattform-Observability, des Business-Monitorings und der Kontrolldurchsetzung. Teams, die diese Anforderungen zentralisieren, verbringen in der Regel weniger Zeit mit dem Abgleich von Tools und mehr Zeit mit der Behebung des eigentlichen Datenproblems.
Eine Checkliste für den schrittweisen Rollout für den Einstieg
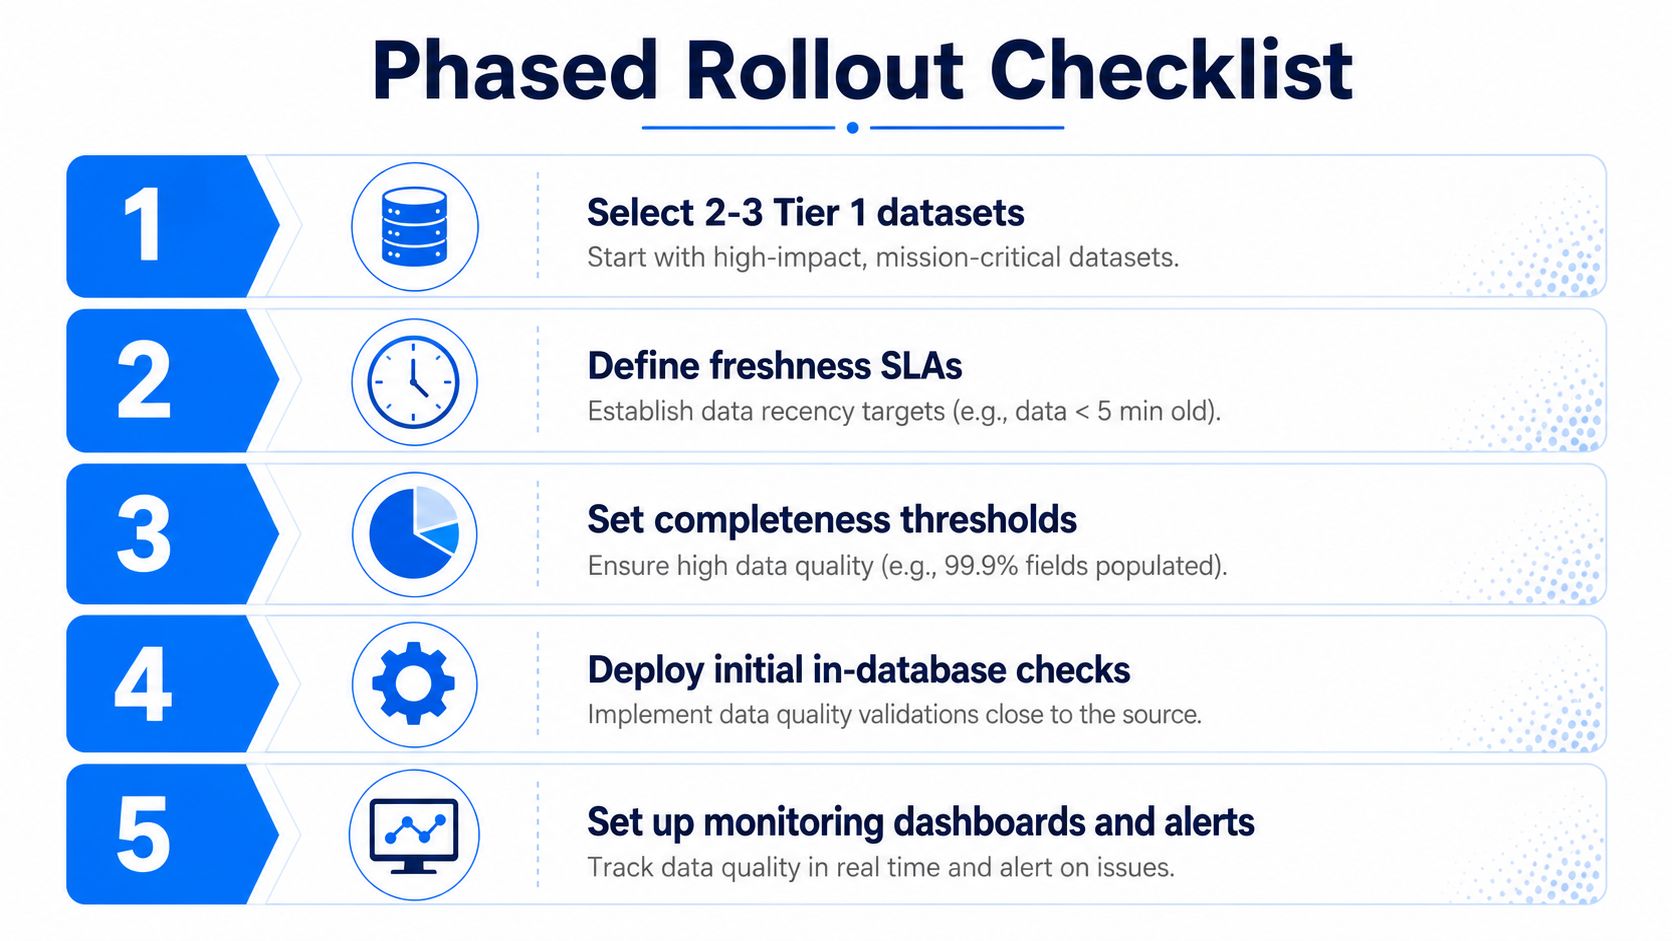
Fangen Sie klein an. Wählen Sie zwei oder drei Tier-1-Datensätze aus, bei denen veraltete oder ungültige Daten ein offensichtliches geschäftliches Risiko darstellen. Definieren Sie zuerst Aktualitäts- und Vollständigkeits-SLAs, und aktivieren Sie dann die In-Database-Ausführung, damit die Prüfungen dort stattfinden, wo die Daten bereits liegen.
Ein Rollout, der nicht unter dem eigenen Gewicht zusammenbricht
Wählen Sie die richtigen Datensätze aus. Beginnen Sie mit Tabellen, die sich direkt auf Berichte, Compliance oder Kunden-Workflows auswirken.
Definieren Sie Aktualitäts-SLAs. Legen Sie das akzeptable Alter der Daten explizit fest.
Legen Sie Vollständigkeits-Schwellenwerte fest. Entscheiden Sie, was „nutzbar“ bedeutet, bevor der erste Alarm ausgelöst wird.
Richten Sie erste In-Database-Prüfungen ein. Fangen Sie strukturelle und regelbasierte Fehler ab, ohne zusätzliche Datenbewegungen zu verursachen.
Schalten Sie Monitoring und Alarme ein. Integrieren Sie Vorfälle in die Kanäle, die Ihr Team bereits nutzt.
Der Fehler, den es zu vermeiden gilt, ist eine breite Abdeckung, bevor Sie die Zuständigkeiten und Schwellenwerte feinabgestimmt haben. Ein fehleranfälliger Pilotbetrieb mit zu viel Rauschen wird ignoriert. Ein fokussierter Pilotbetrieb zeigt dem Team, wie sich die Kontrollen verhalten, und genau das ist das Ziel.
Wenn Sie im Finanzwesen, im Gesundheitswesen, in der Telekommunikation oder im öffentlichen Sektor arbeiten, gilt dasselbe Muster – nur mit anderen Kontrollen und Berichtspflichten. Es geht darum, vertrauenswürdige Daten zum Standardzustand der Plattform zu machen, statt zu einer wöchentlichen Notfallübung.
Wenn Sie dieses Betriebsmodell aufbauen und eine Plattform suchen, die Prüfungen innerhalb Ihrer eigenen Umgebung belässt, In-Database-Ausführung unterstützt und Rechtzeitigkeit, Validierung, Anomalieerkennung und Schema-Tracking in einem Workflow zusammenführt, besuchen Sie digna. Sie wurde für Teams entwickelt, die wollen, dass sich Echtzeit-Datenqualität wie eine operative Disziplin verhält, und nicht wie ein Batch-Job mit kürzerem Intervall.
Häufig gestellte Fragen
Was ist Real Time Data Quality?
Die Disziplin, Fehler zu erfassen, während die Daten noch in Bewegung sind, statt nachdem sie gelandet sind. Es ist kein schnelleres Batch-Prüfen, sondern ein anderes Betriebsmodell, denn das Zeitfenster zum Eingreifen schließt sich, während der Strom weiterläuft.
Welche Dimension fehlt im Streaming zuerst?
Timeliness. Bei kontinuierlichen Daten hört Verzögerung auf, ein Planungsdetail zu sein, und wird zum Defekt selbst, weshalb Frische die Arbeitsdefinition von Qualität in einem Echtzeitsystem verändert.
Wann zählt Verzögerung als Qualitätsdefekt?
Immer wenn das Dashboard von zeitkritischen Daten abhängt. Dann ist eine Verzögerung kein zu duldendes Pipeline-Ärgernis, sondern ein Versagen der Daten, das zu sein, was sie behaupten, und verdient dieselbe Behandlung wie ein falscher Wert.
Warum funktioniert Batch-Qualität nicht mehr?
Weil ihre Annahmen brechen. Batch-Prüfung baut auf ein Fenster, in dem Daten lange genug stillstehen, um inspiziert zu werden, und sobald dieses Fenster verschwindet, kommen dieselben Prüfungen nach den Entscheidungen an, die sie schützen sollten.
Was ändert sich in der Architektur?
Die Platzierung der Kontrolle, nicht ihr Inhalt. Dieselben Fragen zu Aktualität, Volumen, Verteilung und Validität gelten, doch sie müssen gegen einen laufenden Strom ausgeführt werden und schnell genug eine Antwort liefern, um zu zählen.