Datenqualitätskontrolle in der Forschung: Ein praktischer Leitfaden
|
6
min. Lesezeit
Datenqualitätsprobleme entdeckt man selten, solange der Datensatz noch frisch aus der Erhebung kommt. Man findet sie, nachdem eine Tabelle kopiert, eine Datei zusammengeführt und ein Feldname geändert wurde – und jemand fragt, warum eine Zeile plötzlich ein unmögliches Datum zeigt oder ein fehlendes Follow-up, das niemand rechtzeitig gemeldet hat. Genau so sieht Datenqualitätskontrolle in der Forschung aus: keine ordentliche Checkliste am Ende, sondern eine Kette von Kontrollen, die jede Übergabe überstehen muss.
Inhaltsverzeichnis
Warum Datenqualitätskontrolle in der Forschung unbemerkt scheitert
Ein Forschungsteam kann wochenlang sauber wirkende Datensätze erheben und trotzdem ein Chaos erben. Die Fehler bleiben oft verborgen, weil Transkription, Übertragung, Aktualisierung und Speicherung jeweils neue Gelegenheiten für stille Abweichungen schaffen – und viele Teams die Qualität nur bei der Erhebung prüfen. Wenn jemand einen Ausreißer oder eine fehlende Variable bemerkt, ist das Quellformular womöglich längst vergraben, das Schema hat sich verschoben, und aus der Bereinigung wird eine Rekonstruktion.
Deshalb behandeln die stärksten Systeme Qualität als Verpflichtung über den gesamten Lebenszyklus, nicht als einmaliges Audit. Ein guter Ausgangspunkt ist, die strukturellen Gründe für das Scheitern von Projekten zu betrachten und den Prozess darum herum zu korrigieren, nicht nur die Symptome – wie in diesem praxisnahen Beitrag darüber beschrieben, warum Datenqualitätsprojekte scheitern.
Faustregel: Wenn ein Datensatz den Besitzer wechseln kann, kann er an Integrität verlieren.
Der Rest dieses Leitfadens konzentriert sich auf fünf Dinge, die auch unter Druck Bestand haben: Validierung an jedem Verarbeitungsschritt, messbare Schwellenwerte, Provenienz und Dokumentation, Reproduzierbarkeit und Audit-Trails. Diese Kombination ist wichtig, denn die größten Fehler sind nicht dramatisch, sondern alltäglich – und genau alltägliche Fehler rutschen bei Teams durch, die erst an der Ziellinie prüfen.
Die fünf Dimensionen der Datenqualität
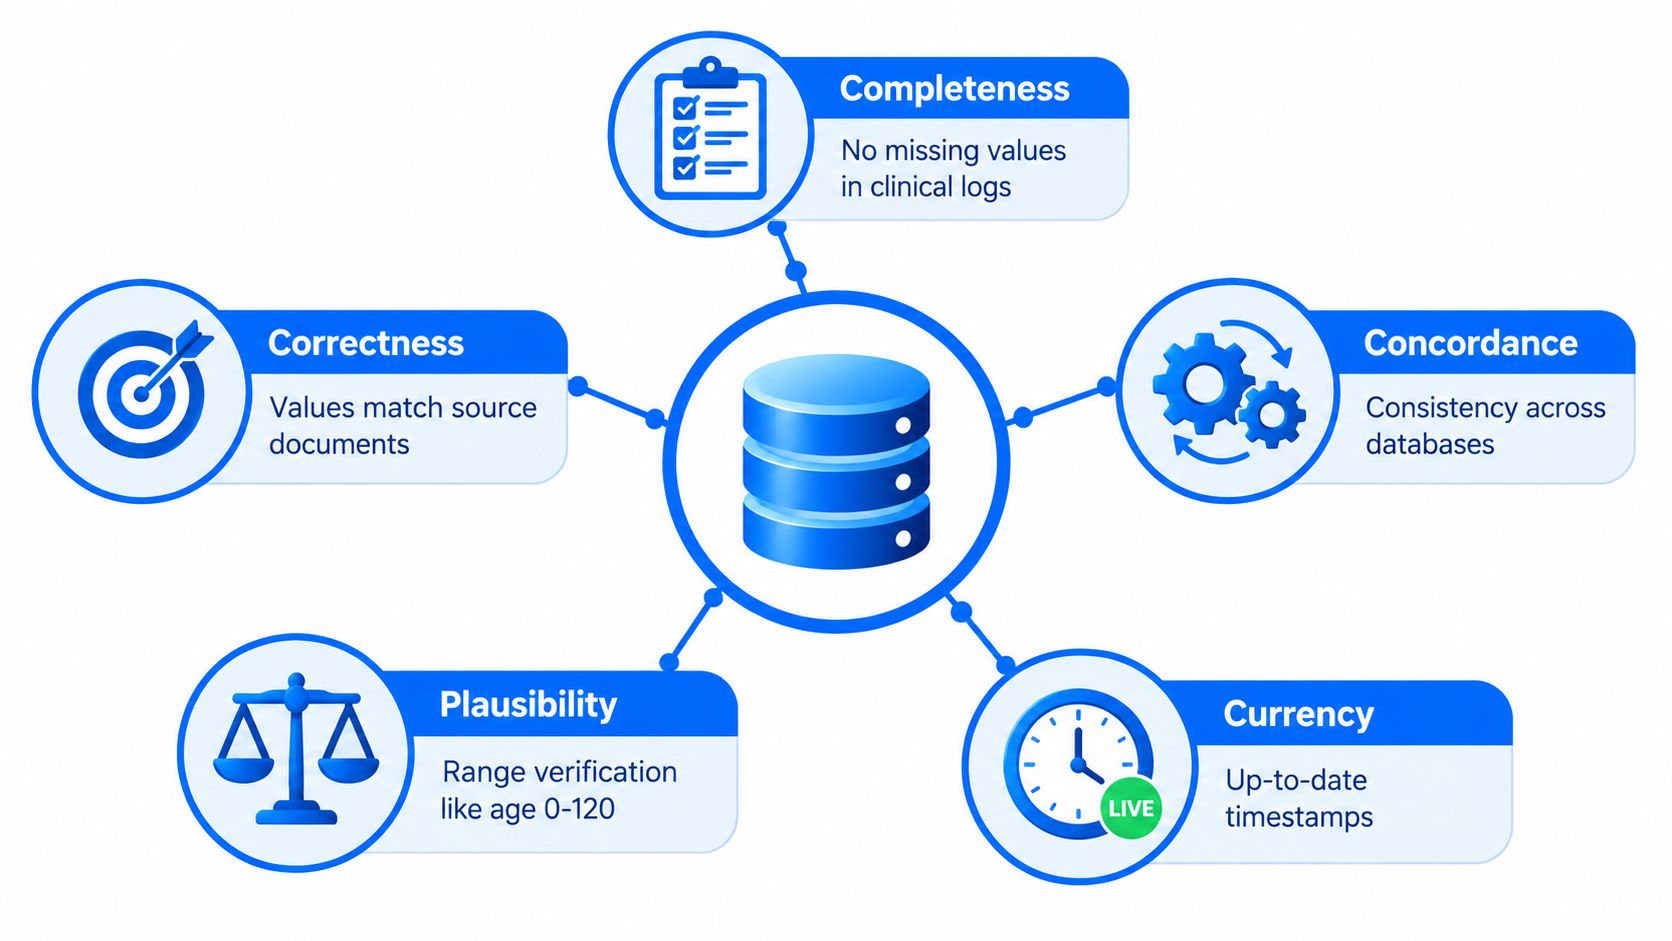
Gute Qualitätskontrolle beginnt mit einer gemeinsamen Sprache. Wenn ein Team sagt „die Daten sehen gut aus“, ohne zu benennen, was geprüft wurde, redet man meist aneinander vorbei. Die fünf Dimensionen – Vollständigkeit, Korrektheit, Konkordanz, Plausibilität und Aktualität – geben dem Team eine Möglichkeit, fehlende Werte von Widersprüchen und veraltete Daten von unmöglichen Werten zu unterscheiden.
Was jede Dimension aufdeckt
Bei Vollständigkeit geht es um Lücken. Ein fehlender Folgebesuch, ein leeres Laborfeld oder ein übersprungenes Einwilligungsdatum gehören hierher – und sie sind nicht dasselbe Problem wie falsche Werte. Ein einfacher wöchentlicher Vollständigkeitsbericht zu den Schlüsselfeldern reicht aus, um sichtbar zu machen, wo sich die Lücken häufen.
Korrektheit fragt, ob ein Wert mit der Quelle übereinstimmt. Wenn ein Geburtsdatum falsch eingetippt oder ein Laborwert aus der falschen Zeile kopiert wurde, kann die Zahl perfekt formatiert und trotzdem falsch sein. Eine praktikable Prüfung ist ein gezielter Abgleich mit den Quelldokumenten anhand einer kleinen Stichprobe der wichtigsten Datensätze.
Konkordanz bedeutet Übereinstimmung zwischen Systemen. Zwei Datenbanken, die beim Einschlussstatus desselben Teilnehmers voneinander abweichen, verursachen später Abstimmungsaufwand. Vergleichen Sie deshalb Identifikatoren, Besuchsdaten und Statusflags früh über alle Systeme hinweg. An dieser Stelle vertrauen viele Teams der „Master“-Tabelle zu sehr und übersehen, dass der Master nur der letzte Ort ist, an dem der Fehler gelandet ist.
Plausibilität erfasst Werte, die technisch gültig, aber nicht glaubwürdig sind. Ein Alter von 0 in einer Erwachsenenkohorte, ein Entlassungsdatum vor der Aufnahme oder eine unplausible Zeitstempelfolge sollten eine Prüfung auslösen, selbst wenn das Feld die Formatprüfungen besteht. Hier brauchen Teams in der Regel regelbasierte Alerts, nicht nur menschliche Sichtprüfung.
Aktualität bedeutet zeitnahe Verfügbarkeit. Ein Datensatz kann korrekt und trotzdem zu alt für die Nutzung sein, besonders in Längsschnittstudien, in denen Statusänderungen zählen. Ein veralteter Zeitstempel oder eine verspätete Aktualisierung verdient eine eigene Prüfung, denn veraltete Daten tarnen sich oft als vollständige Daten.
Der Beitrag zu den Dimensionen der Datenqualität ist hilfreich, wenn Ihr Team ein gemeinsames Vokabular braucht, bevor Regeln geschrieben werden. Teams gewichten Korrektheit oft zu stark und prüfen Plausibilität und Aktualität zu wenig – genau dort verstecken sich die stillen Fehler.
Nützlichkeitstest: Wenn eine Prüfung Ihnen nicht sagen kann, welche Art von Problem sie gefunden hat, ist sie noch nicht präzise genug.
Validierung an jedem Verarbeitungsschritt verankern
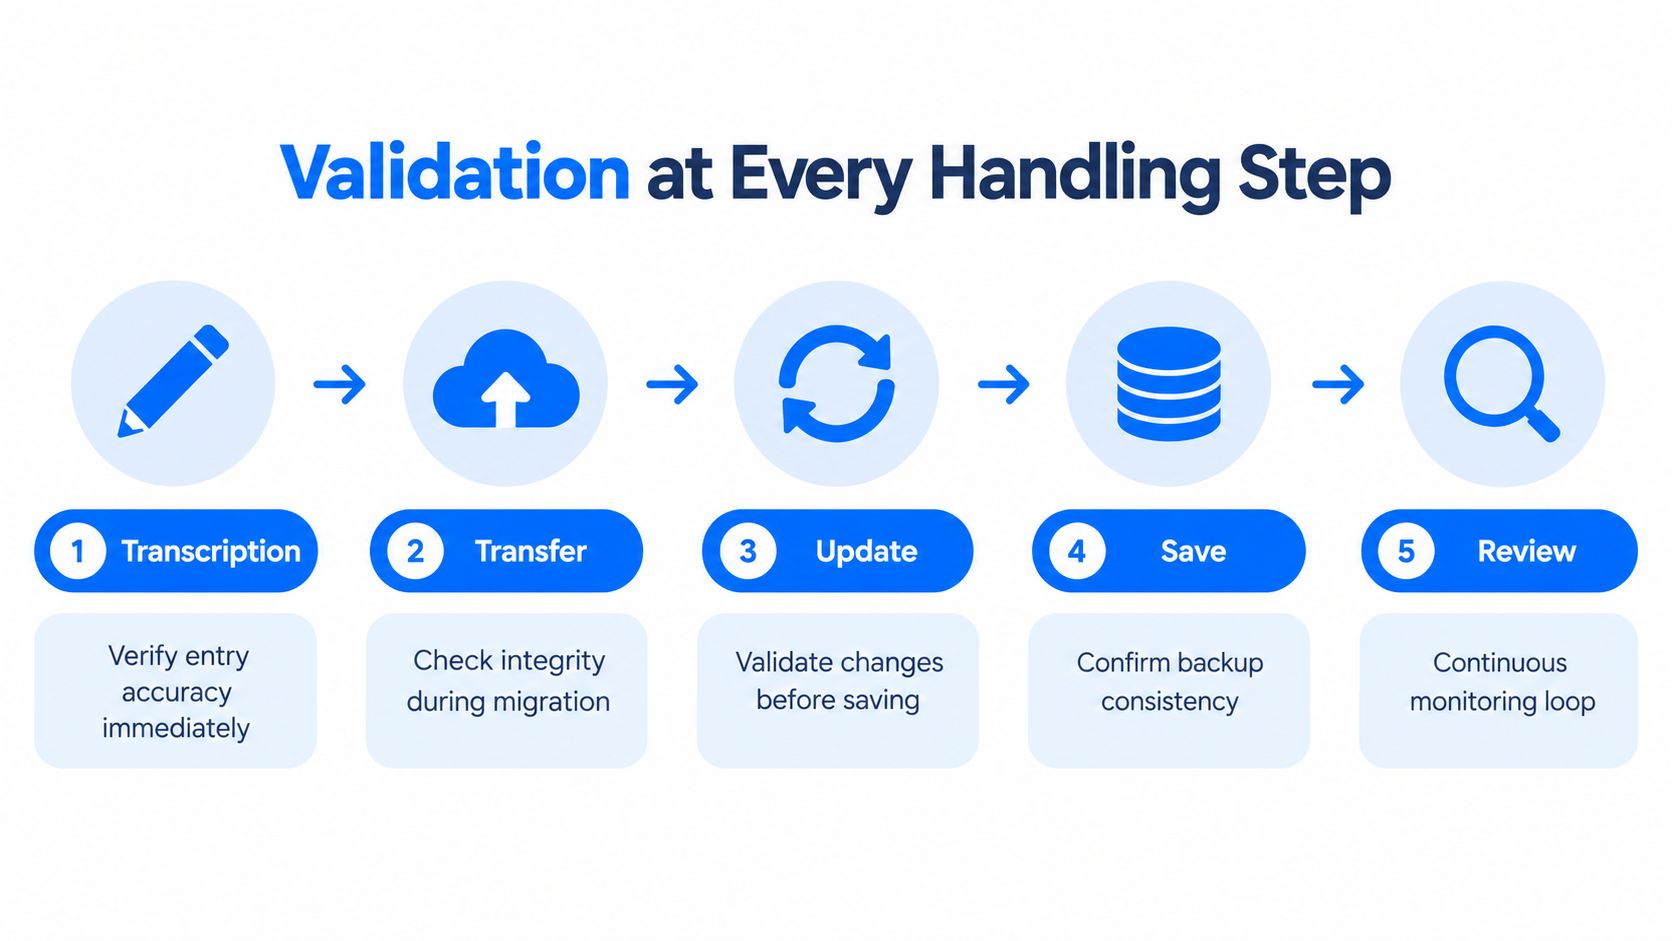
Qualitätskontrolle gehört an jeden Punkt, an dem Daten berührt werden, nicht nur in eine abschließende Prüfung. Leitlinien der klinischen Forschung sind eindeutig: Validierung soll stattfinden, wenn Daten transkribiert, übertragen, aktualisiert oder auf ein neues Medium gespeichert werden. Zu den klassischen Verfahren gehören Doppelerfassung, programmatische Bereichs- und Konsistenzprüfungen, regelmäßige Überprüfung der Fehlerrate und Prüfung durch Vorgesetzte oder Kollegen. Es geht um Auditierbarkeit, denn jeder Verarbeitungsschritt ist eine Stelle, an der Fehler entstehen oder verschleiert werden können.
Ein Papierformular auf dem Weg in die Analyse
Beginnen Sie mit Papierformularen. Bei der Transkription erfasst eine Person den Datensatz, eine andere prüft eine Stichprobe nach oder führt eine Doppelerfassung für Felder durch, bei denen man sich leicht vertippt, etwa Datumsangaben oder numerische Messwerte. Ein einfaches Abweichungsprotokoll macht sich hier schnell bezahlt.
Sobald die Daten in eine Tabellenkalkulation wandern, führen Sie sofort Bereichsprüfungen und Konsistenzregeln aus. Ein Geburtsdatum in der Zukunft, ein fehlender Besuchscode oder ein Laborwert außerhalb des zulässigen Wertebereichs sollte die Datei stoppen, bevor jemand mit der Analyse beginnt.
Wenn die Tabelle zur Analysedatenbank wird, prüfen Sie die Übertragung selbst. Das heißt: Zeilenanzahlen, Schlüsselidentifikatoren und alle Felder vergleichen, die anfällig für Abschneiden, Umkodierung oder Typkonvertierung sind. Wenn ein Problem erst in der Datenbank auftaucht, haben Sie bereits die Chance verloren zu erkennen, ob es aus der Erfassung oder der Migration stammt.
Leiten Sie Änderungen nach Aktualisierungen durch eine Prüfung von Kollegen oder Vorgesetzten. Diese Prüfung muss nicht zeremoniell sein, sie muss nur eine Frage beantworten: Hat die Aktualisierung die Bedeutung des Datensatzes bewahrt?
Die Seite zu Validierungsregeln und kontinuierlichen Prüfungen ist ein gutes Beispiel dafür, wie Teams diese Leitplanken in täglich laufenden Systemen operationalisieren. Entscheidend ist, die Prüfung an den Schritt zu koppeln, denn ein periodischer Durchlauf nach drei Übergaben kommt bereits zu spät.
Eine Prüfung nach der Übertragung ist besser als nichts, aber sie ist nicht dasselbe, wie die Übertragung selbst zu kontrollieren.
Messbare Schwellenwerte für das Qualitätsmonitoring
Qualitätskontrolle wird operativ, sobald sich das Team auf Zahlen einigt statt auf Slogans. Belastbare Schwellenwerte, benannte Verantwortliche und ein fester Prüfrhythmus machen aus Qualitätsmetriken echte Kontrollen. Ein Dashboard ohne verantwortliche Person ist nur Tapete.
Stichproben bleiben wichtig. Die Leitlinien zur Qualitätssicherung stützen harte Grenzwerte, auf die Teams reagieren können. Auf Studienzentrumsebene sollten höchstens 5 % der eingeschlossenen Teilnehmer die Ein- oder Ausschlusskriterien verfehlen, der Einschluss sollte fristgerecht mindestens 90 % des Ziels erreichen, die Drop-out-Rate sollte bei höchstens 5 % liegen und die Fehlerrate bei der Datenerfassung bei höchstens 0,001 %.
Metrik | Schwellenwert | Monitoring |
|---|---|---|
Zufällige Quellprüfung | 5 % der Datensätze | Ausgewählte Datensätze mit den Quelldokumenten abgleichen |
Verfehlte Ein- oder Ausschlusskriterien | Höchstens 5 % pro Zentrum | Screening-Protokolle und Protokollabweichungen prüfen |
Rekrutierungsfortschritt | Mindestens 90 % des Ziels fristgerecht | Rekrutierung gegen geplante Meilensteintermine verfolgen |
Drop-out-Rate | Nicht mehr als 5 % | Retentions- und Rückzugsprotokolle überwachen |
Fehlerrate bei der Datenerfassung | Nicht mehr als 0,001 % | Erfasste Werte mit Quellfeldern vergleichen und Abweichungen protokollieren |
Es geht nicht darum, diese Kennzahlen zu sammeln und später zu bewundern. Es geht darum, sie in einem festen Rhythmus zu prüfen, jedem Schwellenwert eine verantwortliche Person zuzuordnen und den Reaktionsweg festzuhalten, bevor die erste Überschreitung eintritt. Hier hilft eine Ansicht für das Aktualitätsmonitoring, denn eine verspätete Prüfung ist oft gleichbedeutend mit gar keiner Prüfung.
Halten Sie die Reaktion verhältnismäßig zur Fehlerart. Eine kleine Häufung von Erfassungsfehlern erfordert gezielte Nachprüfungen, während wiederholte Zielverfehlungen bei Rekrutierung oder Retention meist bedeuten, dass sich der Prozess selbst ändern muss. Wenn ein Schwellenwert keine klare Maßnahme auslöst, ist er nur Dekoration.
Provenienzdokumentation und Audit-Trails
Die Frage eines Auditors ist nie abstrakt. Meist lautet sie: „Woher kommt diese Zahl?“ Wenn Ihre Antwort Erinnerungen, Nebengespräche und die Suche in alten Exporten erfordert, ist der Prozess noch nicht auditierbar. Provenienzdokumentation ist die Aufzeichnung von Herkunft, Verarbeitung und Transformation, mit der Sie diese Frage ohne hektische Suche beantworten können.
Ein belastbarer Provenienznachweis zeigt, wer die Daten angefasst hat, was sich geändert hat, wann und warum. Er bewahrt außerdem den ursprünglichen Wert, wenn eine Korrektur vorgenommen wird, denn das Original ist oft die einzige Möglichkeit zu beurteilen, ob eine Korrektur berechtigt oder nur bequem war. Das ist besonders wichtig, wenn mehrere Personen dasselbe Feld in mehreren Tools bearbeitet haben.
Was der Audit-Trail enthalten muss
Die sauberste Struktur ist einfach: versionskontrollierte Datendateien, ein Änderungsprotokoll pro Verarbeitungsschritt, schriftliche Rückfragen zu verdächtigen oder fehlenden Werten und eine ausdrückliche Angabe nicht wiederherstellbarer fehlender Werte im Analyseplan. Die schriftlichen Rückfragen sind wichtig, weil sie Unsicherheit in eine nachvollziehbare Entscheidung verwandeln, statt sie als vergrabene Ausnahme zu belassen.
Die Forschungsleitlinien zur iterativen Datenqualitätskontrolle sind hier unmissverständlich. Teams sollten während der Erhebung einfache statistische Prüfungen durchführen, schriftliche Rückfragen zu verdächtigen oder fehlenden Werten stellen und nicht wiederherstellbare fehlende Werte im Analyseplan ausdrücklich ausweisen (Leitfaden zum iterativen Workflow). Das ist kein bürokratischer Mehraufwand, sondern der Weg, die Analyse ehrlich darüber zu halten, was sich nicht reparieren lässt.
Wenn Sie den Weg von der Quelle zur Analyse nicht zeigen können, haben Sie keinen Trail, sondern eine Geschichte.
Ein Peer-Reviewer, der fragt „woher kommt diese Zahl“, sollte den Quelldatensatz, die angewandte Transformation, das Datum der Änderung und die Person sehen können, die sie freigegeben hat. Wenn die Antwort ein Rekonstruktionsprojekt ist, ist der Trail zu dünn für ernsthafte Arbeit. Provenienz ermöglicht es dem Team, die Zahl zu erklären, statt eine Erinnerung daran zu verteidigen.
Wo KI in die Datenqualitätskontrolle passt
KI ist in der Datenqualitätskontrolle nützlich, aber nur in einem engen Korridor. Sie kann Anomalien sichtbar machen, verdächtige Datensätze clustern und Muster erkennen, die sich schwer als Regeln kodieren lassen – das zählt, wenn der Datensatz groß und die Baseline stabil ist. Außerdem verkürzt sie die manuelle Triage, wenn sie neben der deterministischen Validierung arbeitet, statt sie zu ersetzen. Für Teams, die diese Ebene aufbauen, ist der Beitrag wie KI Datenanomalien in Datenpipelines erkennt das richtige Modell zum Studieren.
Das Risiko: Automatisierte Bereinigung kann plausibel aussehende Korrekturen erfinden, die falsch sind. Aktuelle wissenschaftliche Veröffentlichungen verweisen auf eine echte Lücke bei standardisierten Benchmarks für LLM-basierte Datenqualitätssysteme und warnen, dass automatisierte Bereinigung halluzinierte Korrekturen einführen kann. Behandeln Sie KI als Assistenz für Prüfer, nicht als Instanz, die Datensätze eigenmächtig umschreibt.
Sichere und unsichere Einsatzszenarien
Zu den sicheren Einsatzszenarien gehören das Markieren von Anomalien zur Prüfung, das Priorisieren von Datensätzen für die menschliche Sichtung und das Vorschlagen möglicher Probleme, die eine Person bestätigen kann. Unsicher ist es, Quellwerte ohne Offenlegung zu überschreiben, mehrdeutige Datensätze ohne menschliche Freigabe aufzulösen oder KI als alleinigen Gatekeeper für die Freigabe einzusetzen.
Die Leitplanke ist unspektakulär, aber wirksam. Bewahren Sie die Originalwerte neben allen automatisierten Korrekturen auf, prüfen Sie Stichproben der von der KI markierten Datensätze und dokumentieren Sie den Entscheidungsweg für jede akzeptierte Änderung. Speichern Sie den Originalwert in einer separaten Spalte mit dem Zeitstempel der Transformation und dem Namen der freigebenden Person, damit jede Korrektur umkehrbar und auditierbar bleibt. Wenn Ihr Team eine breitere Governance-Perspektive sucht, ist die Ressource Governance und KI-Datentools von MakeAutomation eine sinnvolle Ergänzung, weil sie KI in operative Kontrollen einbettet statt in einen Hype.
Für Teams, die KI einsetzen wollen, ohne die Kontrolle abzugeben, kann eine Plattform wie digna in der Validierungs- und Anomalieebene sitzen, wo Prüfungen nachvollziehbar und an die zugrunde liegenden Daten gebunden bleiben. Das ist das richtige Muster: KI hilft beim Erkennen, Menschen entscheiden.
Ihre Checkliste zur Datenqualitätskontrolle
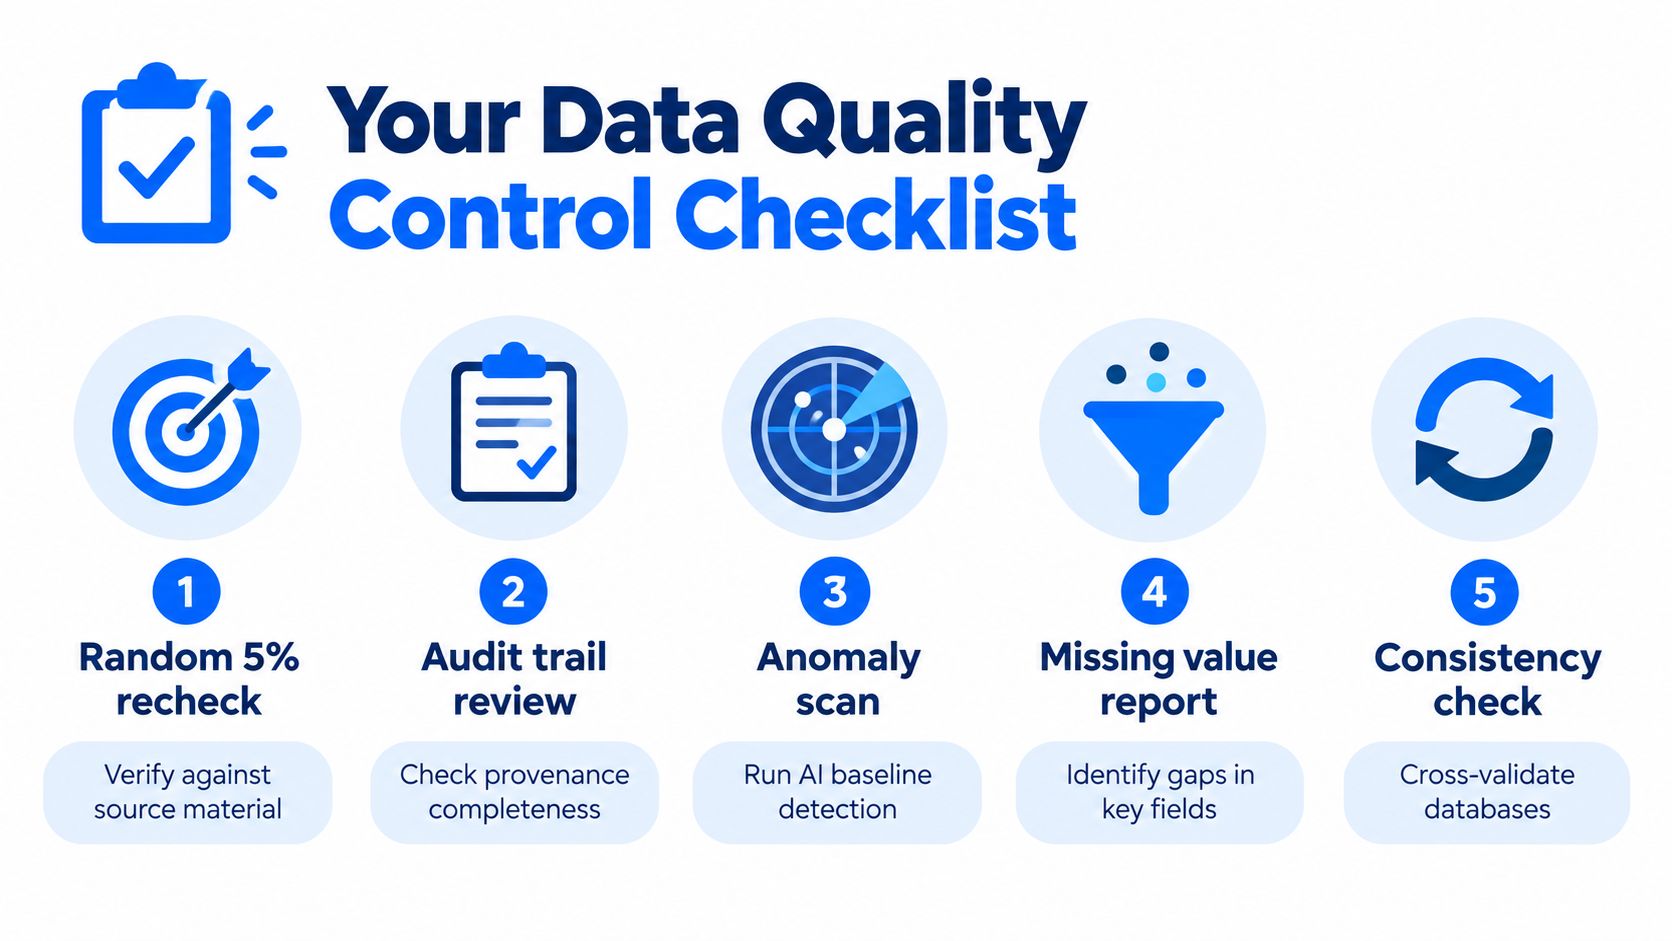
Eine Checkliste funktioniert nur, wenn sie kurz genug für den laufenden Betrieb und streng genug ist, um Abweichungen vor Beginn der Analyse zu erkennen. Halten Sie sie griffbereit am Arbeitsplatz, nicht in einem Foliensatz.
Zufällige Quellprüfung: Prüfen Sie wöchentlich nach festem Plan eine zufällige Stichprobe von 5 % gegen das Quellmaterial, damit Transkriptionsabweichungen auffallen, solange die Datei noch offen ist.
Validierung bei jeder Übergabe: Verknüpfen Sie Transkription, Übertragung, Aktualisierung, Speicherung und Prüfung jeweils mit einer konkreten Kontrolle. Ein allgemeines Versprechen, „später zu prüfen“, überlebt keine ausgelastete Pipeline.
Verantwortliche für Schwellenwerte benannt: Bestimmen Sie eine Person, die die Schwellenwerte für Rekrutierung, Drop-out und Erfassungsfehler planmäßig prüft. Metriken verändern Verhalten nur, wenn jemand klar dafür verantwortlich ist.
Provenienz erfasst: Führen Sie versionskontrollierte Dateien, ein Änderungsprotokoll und schriftliche Rückfragen zu verdächtigen oder fehlenden Werten, jeweils verknüpft mit der exakten Transformation. So werden spätere Audits möglich, ohne die gesamte Kette aus dem Gedächtnis zu rekonstruieren.
KI-Korrekturen geprüft: Verlangen Sie eine menschliche Prüfung der von der KI markierten Datensätze, bewahren Sie den Originalwert auf und protokollieren Sie, warum eine Korrektur angenommen oder abgelehnt wurde.
Datenbankübergreifende Konsistenz: Vergleichen Sie Schlüsselfelder über Systeme hinweg, damit Konkordanzprobleme vor der Veröffentlichung auffallen, nicht danach.
Wenn Sie ein praxistaugliches Betriebsmodell suchen, kombinieren Sie diese Checkliste mit einer laufenden Kontrollebene statt mit einer weiteren Tabelle. Ein Setup aus Governance und KI-Datentools kann Validierung auf Datensatzebene, Anomalieerkennung, Aktualitätsmonitoring und Schema-Tracking in der Umgebung halten, in der die Daten bereits liegen. digna passt in genau diese Art von Kontrollschleife, wenn Forschungsteams Prüfungen brauchen, die nachvollziehbar bleiben und an die zugrunde liegenden Datensätze gebunden sind.
Für Teams, die die oben beschriebenen Bereichs-, Konsistenz- und Vollständigkeitsprüfungen bei jeder Übergabe automatisch ausführen möchten statt in einem periodischen Durchlauf, führt digna Data Validation Regeln auf Datensatzebene direkt in der Datenbank aus, in der die Forschungsdaten bereits liegen.
Häufig gestellte Fragen
Was sind die fünf Dimensionen der Datenqualität in der Forschung?
Vollständigkeit, Korrektheit, Konkordanz, Plausibilität und Aktualität. Zusammen unterscheiden sie fehlende von falschen Werten, Abweichungen zwischen Systemen von unmöglichen Einträgen und veraltete von aktuellen Datensätzen. So erhält ein Forschungsteam eine gemeinsame Sprache dafür, was eine Prüfung tatsächlich gefunden hat, statt nur zu sagen, die Daten sähen gut aus.
Wann sollte in einem Forschungsprojekt validiert werden?
An jedem Punkt, an dem Daten verarbeitet werden: wenn sie transkribiert, übertragen, aktualisiert oder auf ein neues Medium gespeichert werden. Typische Kontrollen sind Doppelerfassung, programmatische Bereichs- und Konsistenzprüfungen, regelmäßige Überprüfung der Fehlerrate sowie die Prüfung von Aktualisierungen durch Kollegen oder Vorgesetzte – nicht nur ein abschließender Durchlauf vor der Analyse.
Welche Qualitätsschwellenwerte werden in der klinischen Forschung verwendet?
Die NINDS-Leitlinien empfehlen, dass höchstens 5 % der Teilnehmer eines Zentrums die Ein- oder Ausschlusskriterien verfehlen, der Einschluss fristgerecht mindestens 90 % des Ziels erreicht, die Drop-out-Rate bei höchstens 5 % und die Fehlerrate bei der Datenerfassung bei höchstens 0,001 % liegt. Zusätzlich wird eine zufällige Stichprobe von 5 % der Datensätze gegen die Quelldokumente geprüft.
Was sollte ein Audit-Trail für Forschungsdaten enthalten?
Versionskontrollierte Datendateien, ein Änderungsprotokoll pro Verarbeitungsschritt, schriftliche Rückfragen zu verdächtigen oder fehlenden Werten und eine ausdrückliche Angabe nicht wiederherstellbarer fehlender Werte im Analyseplan. Er sollte zeigen, wer einen Wert wann und warum geändert hat, und den Originalwert neben jeder Korrektur bewahren.
Kann man KI die Bereinigung von Forschungsdaten anvertrauen?
Nur als Assistenz. KI ist nützlich, um Anomalien zu markieren und Datensätze für die menschliche Prüfung zu priorisieren, doch automatisierte Bereinigung kann plausibel aussehende Korrekturen erfinden, die falsch sind. Bewahren Sie Originalwerte neben jeder Korrektur auf, prüfen Sie Stichproben der von der KI markierten Datensätze und verlangen Sie eine menschliche Freigabe, bevor eine Änderung übernommen wird.



