Datenqualitäts-Risikomanagement: Ein praktischer Leitfaden
|
8
min. Lesezeit
Ein Dashboard ist veraltet, aber die Pipeline ist grün. Ein Modell liefert ungewohnte Ergebnisse, obwohl sich am Deployment nichts geändert hat. Ein regulatorischer Bericht enthält inkonsistente Summen, und die Untersuchung beginnt mit einer hektischen Suche in Ingestions-Protokollen, Transformations-Code und Tabellenkalkulationen. In jedem dieser Fälle tritt der sichtbare Fehler am Ende des Prozesses auf, während das zugrunde liegende Qualitätsproblem schon viel früher aufgetreten sein kann.
Dieses Muster ist Data Engineers vertraut, da die traditionelle Datenqualitätsarbeit oft erst dann beginnt, wenn jemand einen geschäftlichen Schaden bemerkt. Teams reparieren Datensätze, aktualisieren eine Regel, führen einen Job erneut aus und machen weiter. Dieselbe Schwachstelle kehrt zurück, wenn eine Upstream-Quelle ihr Schema ändert, eine Lieferung verspätet eintrifft oder sich eine Metrik außerhalb ihres normalen Verhaltens verschiebt.
Datenqualitäts-Risikomanagement behandelt diese Ereignisse als Kontrollfehler und nicht als isolierte Bereinigungstickets. Das praktische Ziel besteht darin, abnormales Verhalten zu erkennen, kritische Datensätze zu validieren, Liefererwartungen zu verfolgen und Vorfälle weiterzuleiten, bevor sie sich auf Entscheidungen, die Compliance oder Systeme mit Kundenkontakt auswirken. Dies ist auf Unternehmensebene von Bedeutung, da die weithin zitierte Schätzung von IBM die jährlichen Kosten für schlechte Datenqualität in den Vereinigten Staaten im Jahr 2016 auf etwa 3,1 Billionen US-Dollar bezifferte (SAP-Community-Diskussion über die IBM-Schätzung).
Inhaltsverzeichnis
Warum Datenqualitäts-Risikomanagement jetzt wichtig ist
Die Kosten für reaktive Bereinigung
Die Dimensionen des Datenqualitätsrisikos verstehen
Dimensionen mit Fehlerarten abgleichen
Priorisierung nach Konsequenzen
Erstellung eines Datenqualitäts-Risikoregisters
Operative Felder nutzen
Beispieleinträge für das Datenqualitäts-Risikoregister
Monitoring-Strategien, die Risiken frühzeitig erkennen
Anomalieerkennung
Timeliness-Monitoring
Überwachung von Schemaänderungen
Entwurf von Kontrollen und Eskalations-Workflows
Validierung nah an den Daten platzieren
Meldungen nach Auswirkung weiterleiten
Statistische Annahmen validieren
Messung der Programmeffektivität und Iteration
Signalqualität messen, nicht das Alert-Volumen
Überprüfung des Registers als Kontrollartefakt
Erste Schritte mit Ihrem Datenqualitäts-Risikoprogramm
In kontrollierten Schritten erweitern
Warum Datenqualitäts-Risikomanagement jetzt wichtig ist
Ein Datenteam kann über eine zuverlässige Orchestrierung, erfolgreiche Job-Status und umfangreiche Unit-Tests verfügen und dennoch unbrauchbare Daten liefern. Eine Quelle sendet möglicherweise eine gültige Datei mit einer unvollständigen Geschäftspopulation. Eine Tabelle wird eventuell erfolgreich mit einer umbenannten Spalte geladen. Ein Bericht aktualisiert sich möglicherweise planmäßig mit Datensätzen, die nicht mehr den Annahmen entsprechen, die seinen Berechnungen zugrunde liegen.
Das Produktionssymptom bestimmt in der Regel, wer benachrichtigt wird. Analysten sehen ein veraltetes Dashboard. Compliance-Teams finden eine Inkonsistenz. Data Scientists hinterfragen eine Modellausgabe. Ingenieure verfolgen das Problem dann über Systeme hinweg, von denen jedes einen Erfolg gemeldet hat. Diese Untersuchung ist teuer, da die technische Integrität einer Pipeline und die Eignung ihrer Daten für die Nutzung unterschiedliche Kontrollfragen sind.
Die Kosten für reaktive Bereinigung
Die manuelle Pflege von Regeln funktioniert, solange die Anzahl der Quellen, Tabellen und Anwendungsfälle überschaubar bleibt. Sie scheitert, wenn Teams jeden erwarteten Wert, jedes Liefermuster und jede strukturelle Abweichung von Hand codieren müssen. Regelmäßige Audits haben eine ähnliche Einschränkung. Sie können historische Fehler identifizieren, fangen aber ein stilles Versagen zwischen den Überprüfungszyklen nicht zuverlässig auf.
Ein kontinuierliches Programm beobachtet das Verhalten, anstatt auf eine Beschwerde zu warten. Es vergleicht das aktuelle Volumen und die Verteilungen mit etablierten Baselines, bewertet, ob die Daten eintrafen, als die Konsumenten sie benötigten, und identifiziert strukturelle Änderungen, bevor die nachgelagerte Logik ausfällt. Die Validierung auf Datensatzebene fügt eine separate Ebene für Geschäftsregeln hinzu, die durch aggregiertes Monitoring nicht erfasst werden können.
Operative Regel: Ein grüner Pipeline-Status beweist nur, dass der Workflow abgeschlossen wurde. Er beweist nicht, dass die resultierenden Daten korrekt, rechtzeitig, kohärent oder für eine Entscheidung geeignet sind.
Der Wandel ist auch organisatorischer Natur. Datenqualität wird zu einer gemeinsamen Risikodisziplin mit Eigentümern, Schweregraden, Reaktionswegen und Nachweisen. Eine nützliche Übersicht über den geschäftlichen Nutzen dieses Ansatzes finden Sie in dignas Erklärung der Vorteile der Datenqualität, aber die Frage der Implementierung bleibt operativer Natur: Welche Fehler sind am wichtigsten, wie wird das Team sie erkennen und was passiert nach einer Meldung?
Teams sollten mit den Datenprodukten beginnen, die die regulierte Berichterstattung, finanzielle Entscheidungen, den Kundenbetrieb oder das maschinelle Lernen beeinflussen. Sie müssen nicht sofort alles überwachen. Sie benötigen Kontrollen an den Punkten, an denen ein unentdeckter Fehler ein Ergebnis verändern würde.
Die Dimensionen des Datenqualitätsrisikos verstehen
Eine Pipeline kann erfolgreich beendet werden, während ihre Ausgabe unsicher bleibt. Eine numerisch korrekte Tabelle, die nach einer Berichtsfrist eintrifft, ist operativ unbrauchbar. Eine vollständige Tabelle mit widersprüchlichen Definitionen in verschiedenen Systemen kann zu einer irreführenden Unternehmenssicht führen. Ein frischer Datensatz mit einer unerwarteten Typänderung kann nachgelagerte Konsumenten blockieren, ohne dass sich Werte ändern.
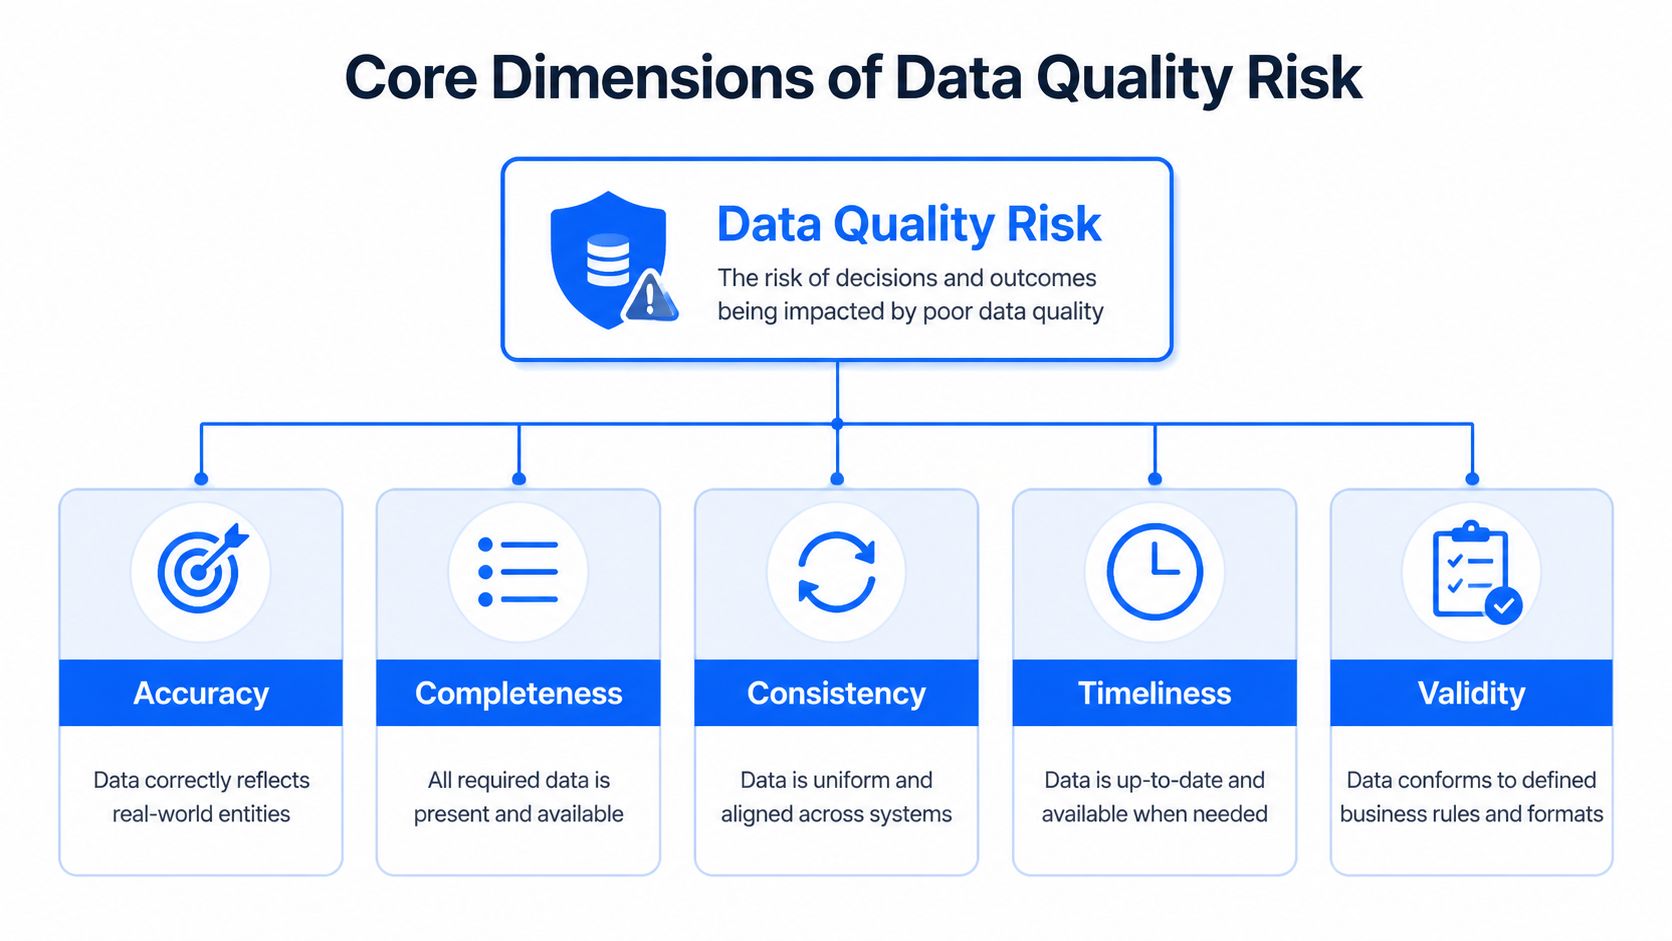
Das Qualitätsrisiko benötigt daher Dimensionen, die sich auf beobachtbare Fehlerarten abbilden lassen. ISO 8000-61:2016 definiert Prozesse für das Datenqualitätsmanagement, während das Data Quality Assessment Framework des IWF die Qualität um Integrität, methodische Fundiertheit, Genauigkeit und Zuverlässigkeit, Nutzbarkeit und Zugänglichkeit herum organisiert (ISO 8000-61 Referenz, IWF Data Quality Assessment Framework). Diese Referenzen unterstützen eine wiederkehrende Bewertung anstelle einer einmaligen Bereinigung. Teams können auch diesen praktischen Leitfaden zu den Dimensionen der Datenqualität lesen, wenn sie ihr Kontrollvokabular definieren.
Dimensionen mit Fehlerarten abgleichen
Genauigkeit fragt, ob Datensätze die Welt oder die Ereignisse, die sie beschreiben, korrekt darstellen. Ein falscher Kontostatus, Betrag oder eine falsche Kundenkennung kann eine Entscheidung verfälschen, selbst wenn jede erwartete Zeile vorhanden ist.
Vollständigkeit umfasst erforderliche Datensätze und Felder. Fehlende optionale Attribute können tolerierbar sein, während fehlende Kennungen oder regulatorische Felder einen Prozess stoppen können.
Konsistenz, in einigen statistischen Richtlinien auch Kohärenz genannt, prüft, ob Definitionen und Werte über Systeme hinweg übereinstimmen. Unterschiedliche Darstellungen desselben Kunden, Produkts oder derselben Transaktion führen zu Abstimmungsaufwand und können die Berichterstattung untergraben.
Timeliness misst, ob Daten verfügbar sind, wenn der Konsument sie benötigt. Ein täglicher Planungsdatensatz und ein operativer Risikofeed haben unterschiedliche Liefererwartungen, sodass das Monitoring produktspezifische Schwellenwerte verwenden muss.
Gültigkeit prüft Formate, Domänen, Beziehungen und Geschäftsregeln. Ein Wert kann den richtigen Datentyp haben und dennoch gegen einen zulässigen Status oder eine Beziehung verstoßen.
Priorisierung nach Konsequenzen
Die gleichmäßige Überwachung jeder Spalte verschwendet Entwicklungsaufwand und erzeugt Alert-Rauschen. Klassifizieren Sie Datenprodukte nach Kritikalität, identifizieren Sie die Dimensionen, die eine Entscheidung verändern könnten, und verknüpfen Sie jedes Risiko mit einer Kontrolle. Nutzen Sie die Anomalieerkennung für unerwartete Volumen- oder Verteilungsänderungen, Timeliness-Prüfungen für verspätete oder fehlende Ladungen und Schema-Tracking für strukturelle Änderungen, bevor Konsumenten scheitern. Die IWF-Richtlinie erkennt auch Relevanz, Genauigkeit, Timeliness, Kohärenz, Interpretierbarkeit und Zugänglichkeit an, sodass Genauigkeit nicht die einzige überwachte Dimension sein sollte.
Eine praktische Bewertung stellt drei Fragen:
Was könnte sich ändern? Identifizieren Sie die betroffene Entscheidung, den Bericht, das Modell oder den Prozess.
Wie würde ein Fehler aussehen? Definieren Sie das Signal, z. B. eine fehlende Ladung, eine Verteilungsverschiebung, ein ungültiger Datensatz oder eine Schemaänderung.
Welche Reaktion ist angemessen? Wählen Sie basierend auf Auswirkung und Vertrauen eine Blockierung, eine Warnung, ein Ticket oder eine Trendüberprüfung.
Diese Zuordnung verhindert, dass Teams nur das überwachen, was leicht zu messen ist. Eine Qualitätsdimension wird operativ nützlich, wenn sie mit einem benannten Konsumenten, einem beobachtbaren Signal und einer definierten Reaktion verknüpft ist.
Erstellung eines Datenqualitäts-Risikoregisters
Ein Risikoregister sollte einem Ingenieur helfen zu entscheiden, was um zwei Uhr morgens zu prüfen ist. Breite Einträge wie „Kundendaten könnten ungenau sein“ bieten keine klare Maßnahme, keinen Nachweisbedarf oder Eskalationspfad.
Beginnen Sie mit den Datenbeständen, die Entscheidungen, Berichte, Modelle oder operative Workflows unterstützen. Erfassen Sie für jeden Bestand den Eigentümer, die Konsumenten, die Liefererwartung, sensible Felder, Upstream-Abhängigkeiten und bekannte Fehlerarten. Beschreiben Sie dann jedes Risiko als Ursache, Ereignis und Konsequenz. „Ein Upstream-Team entfernt ein erforderliches Feld, was dazu führt, dass die Pipeline zur Kundenberechtigung unvollständige Entscheidungen trifft“ gibt den Zuständigen weitaus mehr Richtung als nur „Schema-Drift“.
Operative Felder nutzen
Jeder Eintrag benötigt genügend Details, um die Arbeit zu priorisieren und eine Reaktion zu unterstützen:
Risikobeschreibung: Nennen Sie den Fehler und seine geschäftlichen Konsequenzen.
Schweregrad: Beschreiben Sie die Auswirkungen, wenn das Ereignis einen Konsumenten erreicht. Verwenden Sie kritisch, hoch, mittel oder niedrig mit intern vereinbarten Definitionen.
Wahrscheinlichkeit: Basieren Sie dies auf der beobachteten Historie, dem Verhalten der Quelle, der Änderungshäufigkeit und der Prozesskomplexität statt auf Intuition.
Eigentümer: Weisen Sie die Person oder das Team zu, die in der Lage sind, die Untersuchung durchzuführen und die Behebung zu koordinieren.
Mitigation: Benennen Sie die Prüfung, das Gate, den Fallback, die Abstimmung oder die Eskalationsmaßnahme.
Nachweis: Speichern Sie die Alarmhistorie, Validierungsergebnisse, Lineage und Behebungsnotizen.
Überprüfungsstatus: Erfassen Sie, ob die Kontrolle aktiv, fehleranfällig, fehlend oder in der Neubewertung ist.
Das Register sollte ein Quellenproblem von einem Erkennungsproblem unterscheiden. Wenn eine Lieferung verspätet ist, kann das Quellenteam für die Behebung verantwortlich sein, während das Plattformteam für das Timeliness-Monitoring zuständig ist. Diese Aufteilung hält die Verantwortlichkeiten präzise und verhindert, dass eine Meldung zu einem Ersatz für eine tatsächliche Behebung wird.
Für hochpriorisierte Felder kann ein Katalog kritischer Datenelemente Teams dabei helfen, Kontrollen auf Datensätze und Attribute zu konzentrieren, die am wahrscheinlichsten Entscheidungen beeinflussen.
Beispieleinträge für das Datenqualitäts-Risikoregister
Risikobeschreibung | Schweregrad | Wahrscheinlichkeit | Eigentümer | Mitigationsstrategie |
|---|---|---|---|---|
Eine erforderliche Upstream-Spalte wird entfernt oder umbenannt, was nachgelagerte Transformationen unterbricht | Hoch | Mittel | Datenplattform-Team | Schemaänderungen verfolgen, Kompatibilität testen und abhängige Jobs stoppen, wenn die Änderung gegen den Vertrag verstößt |
Kritische Pipeline trifft nach dem Berichtsfenster des Konsumenten ein | Hoch | Mittel | Eigentümer des Quellensystems | Ankunftsmuster überwachen, erwartete Lieferzeit berechnen und ausgebliebene Ladungen eskalieren |
Geschäftsregel unterscheidet sich zwischen operativen und analytischen Systemen | Hoch | Mittel | Datendomänen-Eigentümer | Validierung auf Datensatzebene ausführen und Ergebnisse über Systeme hinweg abgleichen |
Aktualität nimmt ab, ohne dass ein Job fehlschlägt | Mittel | Mittel | Analytics-Engineering-Team | Lieferung überwachen und Schwellenwerte aktualisieren, wenn sich das Verhalten der Quelle ändert |
Optionale Felder werden in einer Quellpopulation unerwartet null | Mittel | Niedrig | Data Steward | Verteilungen verfolgen, die Quellenänderung untersuchen und akzeptierte Ausnahmen dokumentieren |
Behandeln Sie das Register als ein aktives Kontrollprotokoll, nicht als ein einmaliges governance-Dokument. Überprüfen Sie es, wenn sich eine Quelle, eine Integrationsmethode, ein Modell oder ein Geschäftsprozess ändert. Integrierte Datenprodukte können Risiken durch Verknüpfung, Harmonisierung oder Modellierung einführen, nicht nur durch die ursprüngliche Quelle. Ein geändertes Schema, eine verspätete Ladung oder eine Verteilungsverschiebung sollte den entsprechenden Risikoeintrag, seine Nachweise oder seinen Eigentümer aktualisieren.
Das Register beweist seinen Wert, wenn es die Monitoring-Konfiguration, Eigentümerdiskussionen und Vorfallprüfungen steuert. Es sollte zeigen, welche Risiken über aktive Kontrollen verfügen, welche Meldungen Rauschen verursachen und welche Lücken noch Entwicklungsarbeit erfordern. Diese Verbindung führt das Team von der reaktiven Brandbekämpfung hin zur kontinuierlichen Kontrolle.
Monitoring-Strategien, die Risiken frühzeitig erkennen
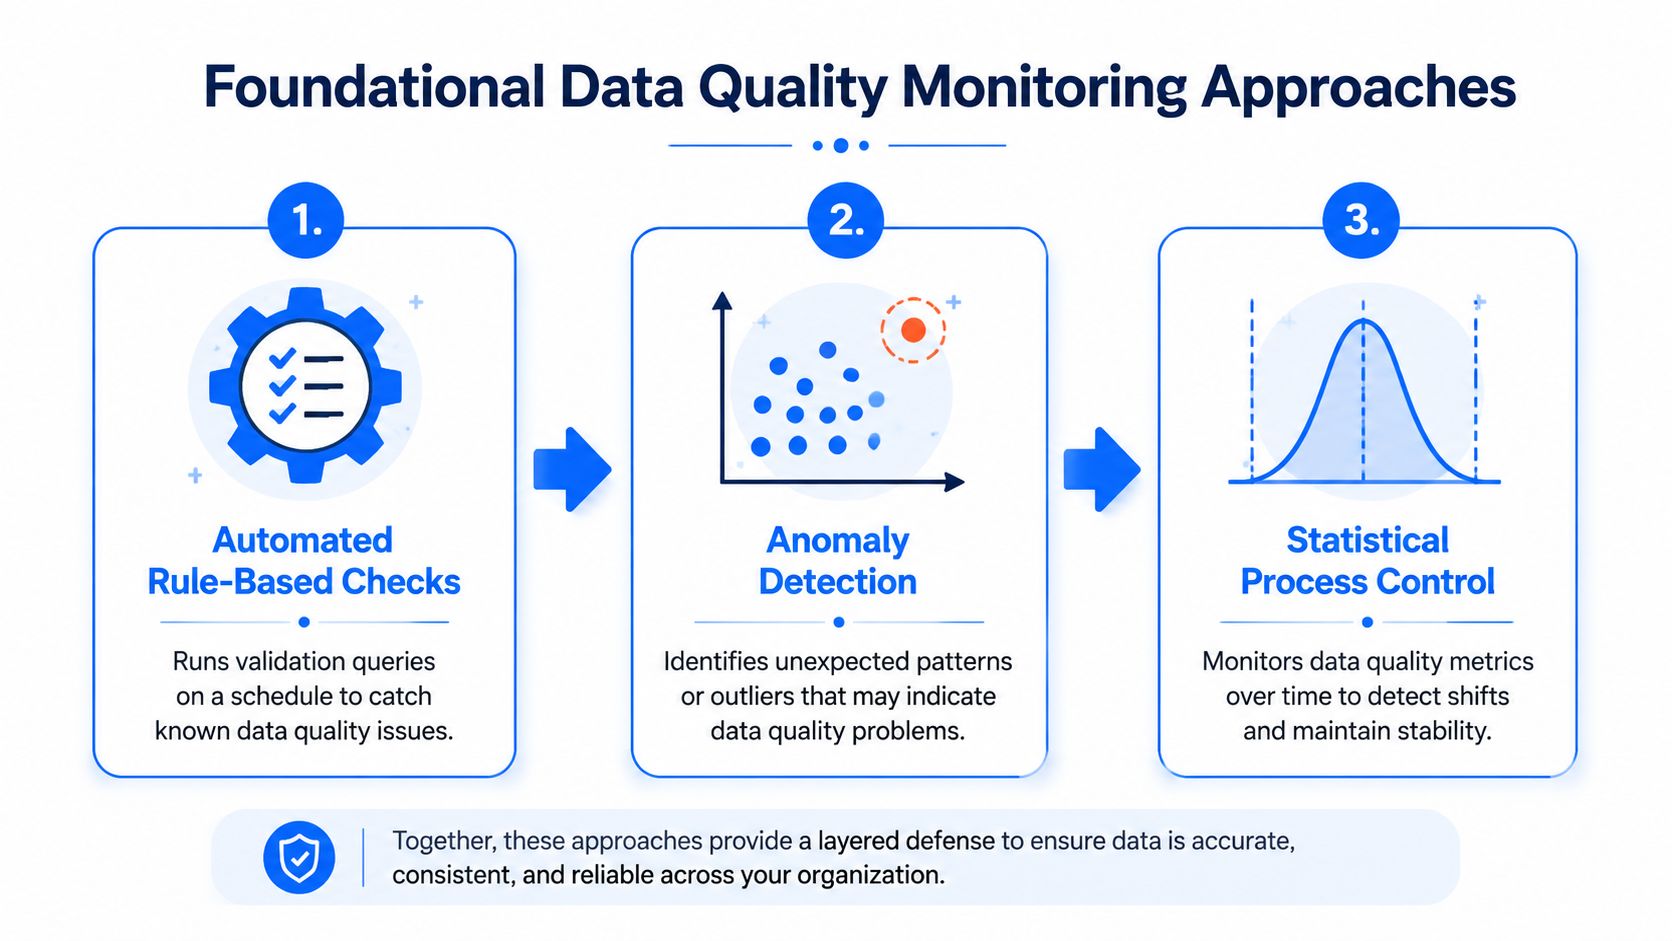
Eine Pipeline kann grün sein, während Konsumenten unbrauchbare Daten erhalten. Das Produktionsmonitoring benötigt mehrere Ebenen: deterministische Regeln für bekannte Verstöße, Anomalieerkennung für ungewohntes Verhalten, Timeliness-Prüfungen für das Lieferrisiko und Schema-Tracking für strukturelle Verträge.
Anomalieerkennung
Das Lernen von Baselines hilft, wenn Ingenieure nicht für jedes gültige Muster eine Regel schreiben können. Monitore können Volumen, Null-Verhalten, Verteilungen und Geschäftsmetriken untersuchen und dann wesentliche Abweichungen vom etablierten Verhalten des Datensatzes melden.
Ein ungewöhnlicher Wert ist nicht automatisch ein Vorfall. Saisonalität, geplante Releases, Akquisitionen und legitime Geschäftsereignisse können eine Baseline verschieben. Trennen Sie technische Metriken von Geschäftsmetriken, fügen Sie Meldungen operativen Kontext hinzu und lassen Sie Eigentümer Ereignisse als erwartet oder unerwartet kennzeichnen. Diese Entscheidungen verbessern spätere Untersuchungen, ohne jede Ausnahme in eine dauerhafte manuelle Regel zu verwandeln.
Timeliness-Monitoring
Eine Ladung kann erfolgreich sein und dennoch zu spät für die Konsumenten eintreffen. Verfolgen Sie das Ankunftsmuster jedes kritischen Datensatzes, einschließlich fehlender, verspäteter und unerwartet früher Lieferungen. Berechnen Sie ein erwartetes Lieferfenster aus dem beobachteten Verhalten und legen Sie die Reaktion entsprechend der Frist des Konsumenten fest.
Ein verspäteter Feed kann eine Warnung rechtfertigen, wenn ein nachgelagertes Dashboard über einen Fallback verfügt. Dieselbe Verzögerung kann eine Eskalation erfordern, wenn sie eine regulatorische Einreichung oder Risikoberechnung betrifft. Alert-Meldungen sollten die letzte erfolgreiche Ankunft, das erwartete Fenster, die betroffenen Produkte und den Eigentümer enthalten, der den Quellenstatus bestätigen kann.
Teams, die das Design von Benachrichtigungen formalisieren, können diesen Leitfaden für Echtzeit-Alerting nutzen, um Meldungen auf den richtigen Empfänger auszurichten und vermeidbares Rauschen zu reduzieren.
Überwachung von Schemaänderungen
Schema-Drift führt zu verwirrenden Vorfällen, da eine Quelle verfügbar bleiben kann, während Konsumenten ihre Ausgabe falsch interpretieren. Verfolgen Sie hinzugefügte und entfernte Spalten, umbenannte Felder, Änderungen des Datentyps und Änderungen, die gegen einen dokumentierten Vertrag verstoßen.
Eine kompatible Hinzufügung muss möglicherweise überprüft werden, ohne dass ein Ausfall erforderlich ist. Das Entfernen eines erforderlichen Feldes oder das Ändern eines Typs sollte im Allgemeinen die abhängige Verarbeitung pausieren, bis der Eigentümer die Auswirkungen bestätigt. Speichern Sie das Vorher-Nachher-Schema mit dem Alert, damit Ingenieure die Änderung nicht mühsam aus den Deployment-Protokollen rekonstruieren müssen.
Diese Signale sind in einer einzigen operativen Ansicht am nützlichsten. Ein Ansatz für das Datenmonitoring und -reporting sollte die Anomalie, die Lieferhistorie, das Schema-Ereignis, das betroffene Asset und den aktuellen Vorfallsstatus zusammen darstellen. Das Tool ist weniger wichtig als die Beibehaltung des Kontexts von der Erkennung bis zur Behebung, damit Teams die reaktive Brandbekämpfung durch eine kontinuierliche Kontrolle ersetzen können.
Entwurf von Kontrollen und Eskalations-Workflows
Eine Meldung wird erst dann zu einer Kontrolle, wenn das Team die Reaktion, den Verbleib der Daten, den verantwortlichen Eigentümer und die für den Abschluss erforderlichen Nachweise definiert. Ohne diese Entscheidungen erzeugt das Monitoring zwar Benachrichtigungen, begrenzt aber nicht das nachgelagerte Risiko.
Nutzen Sie harte Kontrollen, wenn sich ungültige Daten nicht weiter verbreiten dürfen. Eine Pipeline kann einen Datensatz mit einer unmöglichen Beziehung ablehnen, eine nachgelagerte Veröffentlichung pausieren, wenn ein erforderliches Schemafeld verschwindet, oder einen Batch unter Quarantäne stellen, der gegen einen kritischen Vertrag verstößt. Nutzen Sie weiche Kontrollen für ungewöhnliche, aber potenziell legitime Aktivitäten, wie z. B. eine unerwartete Änderung des Geschäftsvolumens, die eine menschliche Überprüfung anstelle einer automatischen Blockierung erfordert.

Validierung nah an den Daten platzieren
Prüfungen auf Datensatzebene setzen Regeln durch, die aggregierte Metriken nicht beweisen können. Validieren Sie erforderliche Felder, zulässige Werte, Entitätsbeziehungen, Gültigkeitsdaten, Duplikatbedingungen sowie regulatorische oder vertragliche Anforderungen. Führen Sie diese Prüfungen nach Möglichkeit in der Datenbank aus. Die Berechnung in der Nähe der Daten zu halten, reduziert Datenbewegungen, respektiert Sicherheitsgrenzen und vermeidet das Laden großer Tabellen in den Anwendungsspeicher.
Ein praktisches Entwicklungsmuster kombiniert ein standardisiertes Framework für Schemaerwartungen mit direktem SQL für große Geschäftsregelprüfungen. SecurityScorecard beschreibt die Verwendung von Great Expectations für die Schemavalidierung, DataHub für zentrale Sichtbarkeit und Apache Airflow für die Orchestrierung. Das Team platzierte Geschäftsregelprüfungen in datenbankseitigem SQL, anstatt sehr große Tabellen in Python zu laden (Bericht zur Pipeline-Validierung).
Prinzip des Kontrolldesigns: Stoppen Sie die Pipeline, wenn der erwartete geschäftliche Schaden der Weiterverbreitung die operativen Kosten einer Blockierung übersteigt.
Meldungen nach Auswirkung weiterleiten
Ein nutzbarer Eskalationspfad erfasst vier Entscheidungen:
Problem erkannt: Erfassen Sie die genaue Prüfung, den beobachteten Wert, das erwartete Verhalten, den Zeitstempel und das betroffene Asset.
Team-Alert: Benachrichtigen Sie den Eigentümer, der die Untersuchung durchführen kann, anstatt einen breiten Kanal ohne verantwortlichen Empfänger zu nutzen.
Auswirkungsanalyse: Identifizieren Sie nachgelagerte Berichte, Modelle, Konsumenten und regulatorische Prozesse.
Behebungsticket: Erfassen Sie die Behebung, den Verbleib der Daten, die Grundursache und die Nachweise, die den Abschluss unterstützen.
Benachrichtigen Sie den On-Call-Ingenieur oder Datenbesitzer bei Ereignissen, die kritische Produkte beschädigen können. Senden Sie Abweichungen mit geringeren Auswirkungen an eine Überprüfungswarteschlange. Gleiche Dringlichkeit führt dazu, dass Empfänger lernen, das System zu ignorieren.
Teams, die Eigentumsverhältnisse und Reaktionspfade formalisieren, können diesen Leitfaden zur Eskalationsunterstützung nutzen, um Wege und Verantwortlichkeiten zu definieren. Eine gemeinsame Vorfallsansicht sollte offene Probleme, betroffene Assets, die Historie von Wiederholungen und den aktuellen Status beibehalten, sodass Ingenieure, Analysten und Stakeholder dieselben operativen Nachweise sehen.
Statistische Annahmen validieren
Die Anomalieerkennung erfordert weiterhin Urteilsvermögen. Ein statistischer Qualitäts-Workflow sollte die Projektziele und das Stichprobendesign klären, die Daten überprüfen, eine geeignete Methode auswählen, deren Annahmen verifizieren und erst dann Schlussfolgerungen ziehen (statistischer Qualitäts-Workflow).
Diese Abfolge begrenzt falsch-positive und falsch-negative Ergebnisse, die durch missverstandene Daten verursacht werden. Ausreißer, nicht-zufällige Fehlwerte, Saisonalität oder ein ungeeigneter Stichprobenrahmen können wie Qualitätsfehler aussehen, wenn sie stattdessen den Messprozess widerspiegeln. Wählen Sie die einfachste gültige Methode, dokumentieren Sie ihre Annahmen und verlangen Sie eine Überprüfung, wenn diese Annahmen nicht mehr zutreffen.
Messung der Programmeffektivität und Iteration
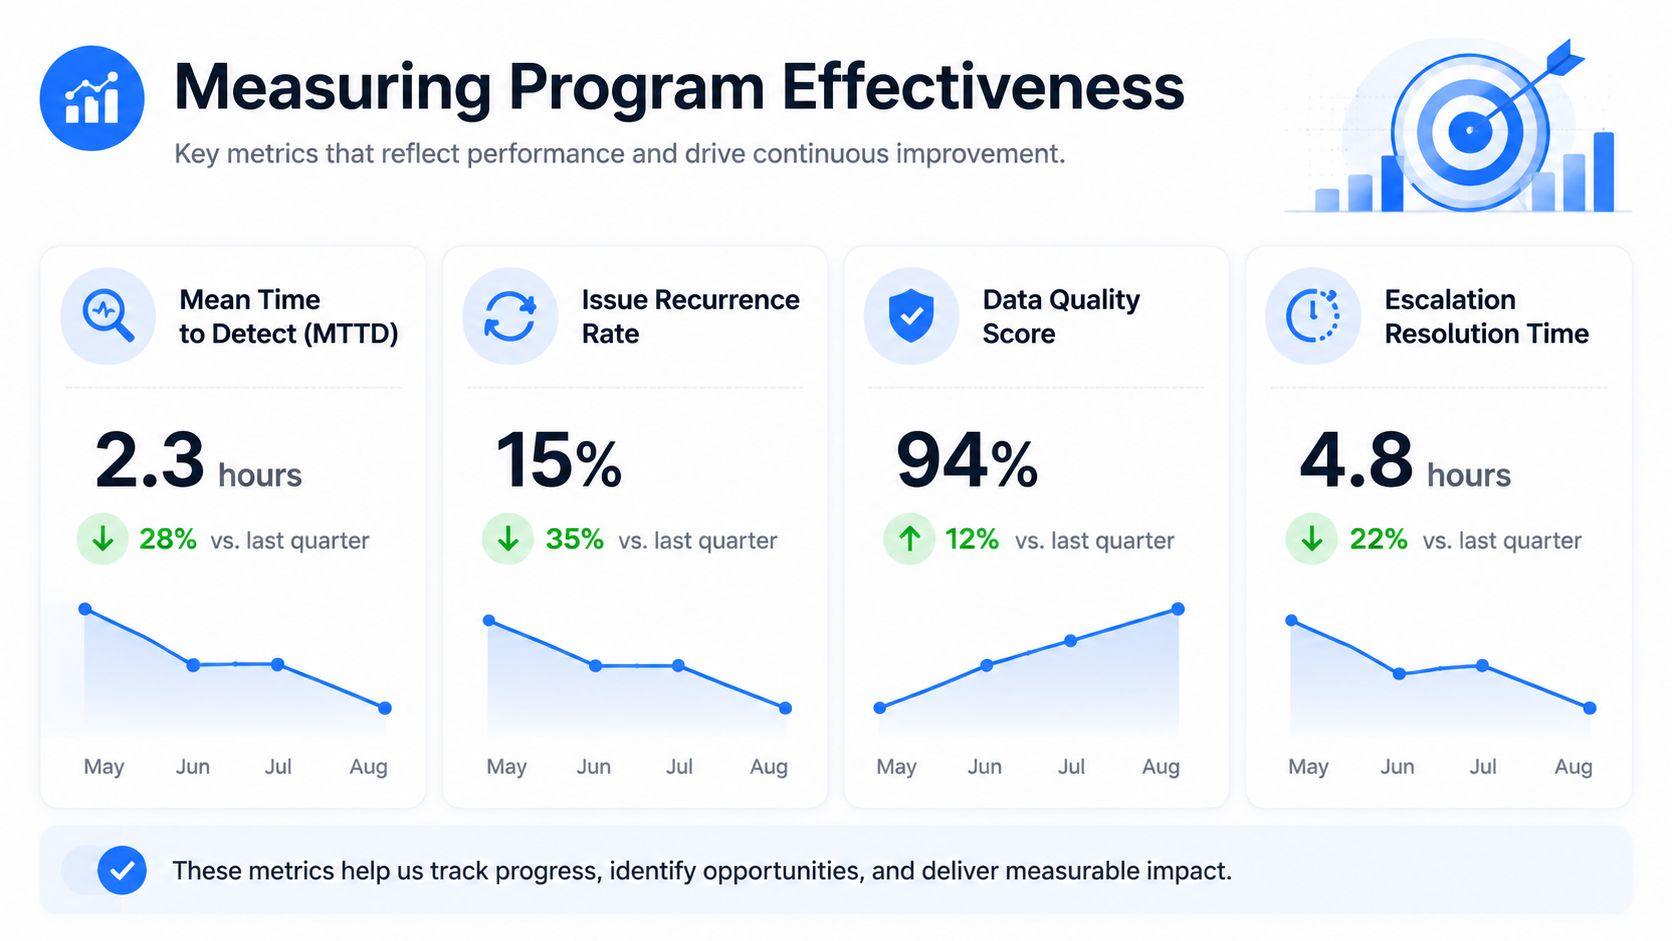
Ein Qualitätsprogramm beweist seinen Wert in der Produktion, indem es Risiken reduziert, Reaktionen verkürzt oder Unsicherheiten sichtbar macht. Ein hoher Dashboard-Score allein beweist wenig. Kennzahlen müssen Erkennung, Untersuchung, Kontrollverhalten und geschäftliche Auswirkungen miteinander verbinden.
Verfolgen Sie die mittlere Zeit bis zur Erkennung, die mittlere Zeit bis zur Behebung, die Wiederholungsrate, die Falsch-Positiv-Rate, die Abdeckung kritischer Assets und den Anteil der Vorfälle mit einem identifizierten Eigentümer. Segmentieren Sie die Ergebnisse nach Schweregrad und Datenprodukt. Andernfalls können viele Prüfungen mit geringer Auswirkung einen kritischen Feed mit schwachen Kontrollen maskieren. Ein praktisches Framework für Datenqualitätsmetriken kann dabei helfen, diese Messungen über Produkte hinweg zu standardisieren.
Signalqualität messen, nicht das Alert-Volumen
Ein schneller Alert führt dennoch zu Untersuchungsaufwand, wenn der Kontext fehlt. Prüfen Sie, ob jede Benachrichtigung die betroffene Tabelle, das geänderte Verhalten, die erwartete Baseline, den wahrscheinlichen Eigentümer und den verfügbaren Behebungspfad identifiziert. Wiederholte Alarme für ein akzeptiertes saisonales Muster weisen meist auf ein Problem mit dem Schwellenwert oder der Baseline hin.
Überprüfen Sie historische Observability-Daten auf Volatilität, wiederkehrende Fehler und schleichende Verschlechterung. Nutzen Sie diese Muster, um den Monitoring-Umfang und die Kontrollstärke anzupassen. Erweitern Sie Schwellenwerte nicht nur, um Rauschen zu unterdrücken. Erfassen Sie das Risiko, das der breitere Schwellenwert akzeptiert, und verifizieren Sie, dass der Kompromiss angemessen bleibt.
Das Vertrauensproblem kann auch nach der Bereitstellung von Observability bestehen bleiben. Ein BARC-Bericht von 2025 stellte fest, dass 42 % der Organisationen den Ergebnissen von KI/ML immer noch nicht vertrauen, während 58 % Programme für Data Observability implementiert oder optimiert hatten (Diskussion der BARC-Umfrage). Das Monitoring ist daher notwendig, aber nicht ausreichend. Teams benötigen Anomaliesignale zusammen mit Timeliness-Monitoring, Schema-Tracking und Validierung auf Datensatzebene, um zu erklären, warum einem Modell oder Dashboard vertraut werden sollte.
Überprüfung des Registers als Kontrollartefakt
Vorfallprüfungen sollten Wahrscheinlichkeit, Schweregrad, Eigentümerschaft und Mitigationsstatus aktualisieren. Fügen Sie ein Risiko hinzu, wenn eine Quelle eine neue Integrationsmethode einführt oder sich ein Geschäftsprozess ändert. Ziehen Sie eine Kontrolle erst dann zurück, wenn das zugrunde liegende Risiko beseitigt wurde, nicht nur, weil die Meldungen aufgehört haben.
Die Global Third-Party Risk Management Survey 2026 von KPMG ergab, dass nur 17 % der Organisationen ihre Datenqualität auf dem höchsten Niveau beschrieben. Sie zeigte auch, dass 52 % der Befragten mit qualitativ hochwertigen Daten volles Vertrauen in Entscheidungen des Risikomanagements hatten, verglichen mit 40 % der Befragten mit schlechter Datenqualität, die kein Vertrauen hatten (KPMG-Umfrage). Die operative Implikation ist direkt: Eine schwache Datenqualität verringert das Vertrauen in Entscheidungen, einschließlich automatisierter Risiko-Workflows.
Jeder Vorfall ist ein Beleg für das Kontrollsystem. Das Ziel ist eine schnellere, präzisere Erkennung folgenschwerer Fehler mit einer klaren Dokumentation darüber, wie die Organisation reagiert hat.
Erste Schritte mit Ihrem Datenqualitäts-Risikoprogramm
Beginnen Sie mit einem einzelnen kritischen Datenprodukt, nicht mit einer unternehmensweiten Bestandsaufnahme. Benennen Sie die Konsumenten, dokumentieren Sie die unterstützten Entscheidungen, listen Sie die Upstream-Abhängigkeiten auf und erfassen Sie die Fehlerarten, die den Ingenieuren bereits bekannt sind. Wählen Sie dann ein kleines Kontrollset aus, das verschiedene Risiken abdeckt, wie z. B. Anomalieerkennung für das Verhalten, Timeliness-Monitoring für die Lieferung, Schema-Tracking für die Struktur und Validierung auf Datensatzebene für die Geschäftslogik.
Die erste Baseline sollte beobachtbar und revidierbar sein. Erfassen Sie das normale Ankunftsverhalten, das erwartete Volumen, wichtige Verteilungen, erforderliche Felder und das aktuelle Schema. Definieren Sie, wer Alerts erhält und wann ein Fehler die Veröffentlichung blockiert. Wenn das Team die Reaktion nicht erklären kann, ist die Prüfung nicht bereit für die Produktion.
In kontrollierten Schritten erweitern
Ein modularer Rollout ermöglicht es Teams zu lernen, ohne eine unüberschaubare Anzahl an Meldungen zu erzeugen:
Mit dem Asset mit den schwerwiegendsten Konsequenzen beginnen: Wählen Sie den Datensatz, bei dem ein Fehler Auswirkungen auf Entscheidungen, die Compliance oder den Kundenbetrieb hätte.
Eine einzelne Monitoring-Funktion hinzufügen: Beginnen Sie mit Timeliness oder Anomalieerkennung, wenn das Hauptproblem ein stiller Verhaltenswechsel ist. Fügen Sie Schema- und Validierungskontrollen hinzu, sobald das Fehlerbild klarer wird.
Prüfungen nah an der Quelle ausführen: Die Ausführung in der Datenbank begrenzt unnötige Bewegungen und hält sensible Daten innerhalb der Kundenumgebung.
Jeden Alert überprüfen: Kennzeichnen Sie erwartete Änderungen, passen Sie Schwellenwerte an und wandeln Sie wiederkehrende Erkenntnisse in dokumentierte Kontrollen um.
Abdeckung gezielt erweitern: Fügen Sie Assets hinzu, wenn eine neue Quelle, ein neues Modell, ein neuer Bericht oder ein neuer regulatorischer Prozess ein wesentliches Risiko darstellt.
In regulierten Umgebungen sind die Anforderungen an das Deployment wichtig. Eine Plattform, die in einer Private Cloud, einer VPC oder einem Rechenzentrum läuft, kann die lokale Kontrolle der Produktionsdaten unterstützen. Datenbankinterne Prüfungen können mit Sicherheitsanforderungen in Einklang gebracht werden, während statistische Methoden in Kombination mit maschinellem Lernen die Anomalieerkennung an das Baseline-Verhalten jedes Datensatzes anpassen können. Preismodelle, die Gebühren für API-Aufrufe oder das Alert-Volumen vermeiden, können zudem die Planung der Erweiterung erleichtern, auch wenn Teams den Umfang der aktiven Tabellen und die Eigentümerschaft definieren sollten, bevor sie weitere Daten aufnehmen.
Datenqualitäts-Risikomanagement ist dann erfolgreich, wenn es Teil der Release-, Vorfalls- und Änderungsmanagement-Routinen wird. Behandeln Sie Qualität als ein fortlaufendes Kontrollsystem, und Teams können veraltete Feeds, instabile Schemata, ungewöhnliches Verhalten und ungültige Datensätze erkennen, bevor diese Fehler zu geschäftlichen Vorfällen werden.
digna bietet eine Plattform für Datenqualität und Observability in Unternehmen, die in Ihrer Umgebung läuft und Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking, Validierung auf Datensatzebene und historische Analysen kombiniert. Besuchen Sie digna, um einen modularen Ausgangspunkt zu evaluieren, mit dem Sie kritische Datenqualitätsrisiken in kontinuierliche, umsetzbare Kontrollen verwandeln.
Häufig gestellte Fragen
Was verändert Datenqualitäts-Risikomanagement?
Es behandelt Vorfälle als Kontrollversagen statt als einzelne Aufräumtickets. Diese Umdeutung führt ein Team weg vom wiederholten Beheben desselben Defekts hin zur Frage, welche Kontrolle ihn hätte fangen sollen und warum sie es nicht tat.
Was belegt ein grüner Pipeline-Status tatsächlich?
Nur, dass der Workflow abgeschlossen wurde. Er belegt nicht, dass die entstandenen Daten genau, rechtzeitig, kohärent oder für eine Entscheidung geeignet sind, weshalb ein Team verlässliche Orchestrierung, erfolgreiche Jobstatus und viele Unit-Tests haben und dennoch unbrauchbare Daten liefern kann.
Warum skaliert reaktives Aufräumen nicht?
Weil manuelle Regelpflege nur funktioniert, solange Zahl der Quellen, Tabellen und Anwendungsfälle beherrschbar bleibt. Jenseits dieses Punktes ersetzt ein kontinuierliches Programm, das Verhalten beobachtet, das Modell aus Warten auf Beschwerden und Schreiben weiterer Regeln.
Wo startet ein Risikoprogramm?
Bei den Datenprodukten, die regulatorisches Reporting, finanzielle Entscheidungen, Kundenbetrieb oder Machine Learning beeinflussen. Dort zu beginnen bindet die ersten Kontrollen an Folgen, die auch außerhalb des Datenteams sichtbar sind.
Wie hoch sind die Kosten auf nationaler Ebene?
IBMs vielzitierte Schätzung bezifferte die jährlichen Kosten mangelhafter Datenqualität in den Vereinigten Staaten 2016 auf rund 3,1 Billionen USD. Zahlen dieser Größenordnung sind richtungsweisend statt präzise, erklären aber, warum sich die Disziplin von Aufräumen zu Risiko verschoben hat.



