Wie Sie Datenqualitäts-Dashboards erstellen, die wirklich funktionieren
|
7
min. Lesezeit

Sie kennen das Muster bereits. Ein Dashboard sieht um 8:30 Uhr hervorragend aus, jemand nimmt an, dass die nächtliche Beladung stattgefunden hat, und wenn die Finanzabteilung die Zahlen in der Vorstandssitzung öffnet, starrt sie auf die Daten der letzten Woche. Niemand wird benachrichtigt, weil nichts im herkömmlichen Sinne „kaputt“ ging, was das Dashboard erklären könnte – sondern nur die Pipeline, das Timing und das Vertrauen in den Bericht.
Das ist das eigentliche Problem bei vielen Dashboards für Datenqualität. Sie erwecken den Eindruck von Aufsicht, verhalten sich aber wie Dekoration, es sei denn, sie sind mit der Datenreise, expliziten Kontrollen und der Eigenverantwortung verknüpft. Ein nützliches Dashboard zeigt nicht nur eine Bewertung an, sondern teilt dem Team mit, was fehlgeschlagen ist, wo es fehlgeschlagen ist, wer dafür verantwortlich ist und was als Nächstes zu tun ist.
Inhaltsverzeichnis
Warum die meisten Dashboards für Datenqualität schon vor dem Mittagessen scheitern
Visualisieren Sie die Datenreise, bevor Sie eine einzelne Metrik auswählen
Die sechs KPIs, die jedes Dashboard für Datenqualität tracken muss
Panel-Muster für Timeliness, Anomalien, Schemata und Validierung
Visuelle Muster wählen, die Entscheidungen in weniger als zehn Sekunden ermöglichen
Alarmierung, Eskalation und das Abstellen von Alarm-Müdigkeit
Architektur, In-Database-Berechnung und Governance-Übergaben
Warum die meisten Dashboards für Datenqualität schon vor dem Mittagessen scheitern
Der Montagmorgen legt meist die Schwachstellen offen. Die Finanzabteilung öffnet ein Dashboard, sieht die Zahlen der letzten Woche, und niemand bemerkt, dass die nächtliche Beladung verzögert war, weil die Ansicht immer noch sauber geladen wird. Der Bericht sieht fehlerfrei aus, das Führungskräfte-Meeting beginnt, und die erste Person, die merkt, dass ein Problem vorliegt, ist diejenige, die erklären muss, warum das Dashboard durch Unterlassung gelogen hat.
Dieses Fehlermuster ist typisch, weil Teams Dashboards wie statische Berichte anstelle von operativen Kontrollebenen behandeln. Sie überwachen nachgelagerte Symptome, nachdem die Daten bereits konsumiert wurden. Das bedeutet, dass der Alarm erst nach den geschäftlichen Auswirkungen eintrifft. Sie verlassen sich auch auf binäre Bestanden/Fehlgeschlagen-Prüfungen, was ein falsches Gefühl der Sicherheit erzeugt, da ein grünes Licht oft langsamen Verfall, mangelnde Frische oder eine Schemaänderung verbirgt, die noch nicht explodiert ist.
Praktische Regel: Wenn das Dashboard Ihnen nicht sagen kann, was sich geändert hat, wann es sich geändert hat und wer handeln soll, ist es kein Kontrollsystem.
Ein besseres Dashboard hätte die Verzögerung sofort aufgezeigt, als die geplante Bereitstellung fehlschlug, und nicht erst, nachdem die Finanzabteilung den Bericht aktualisiert hat. Es hätte gezeigt, dass das Problem im Bereitstellungspfad lag und nicht in der nachgelagerten Geschäftslogik. Dieser Unterschied ist wichtig, denn ein veralteter Batch, ein fehlerhafter Join und eine fehlende Spalte erfordern jeweils unterschiedliche Reaktionen – und ein einziger allgemeiner Gesundheitswert verbirgt diesen Unterschied.
Viele Teams machen auch denselben strukturellen Fehler bei der Zuständigkeit. Sie sammeln eine Flut von Metriken, aber niemand weiß, welches Team für die Behebung zuständig ist oder welche Prüfung welchem Risiko zugeordnet ist. Das Ergebnis sind Alarmrauschen, diffuse Verantwortlichkeiten und Dashboards, auf die bei einem Vorfall kurz geschaut und die den Rest der Woche ignoriert werden.
Visualisieren Sie die Datenreise, bevor Sie eine einzelne Metrik auswählen
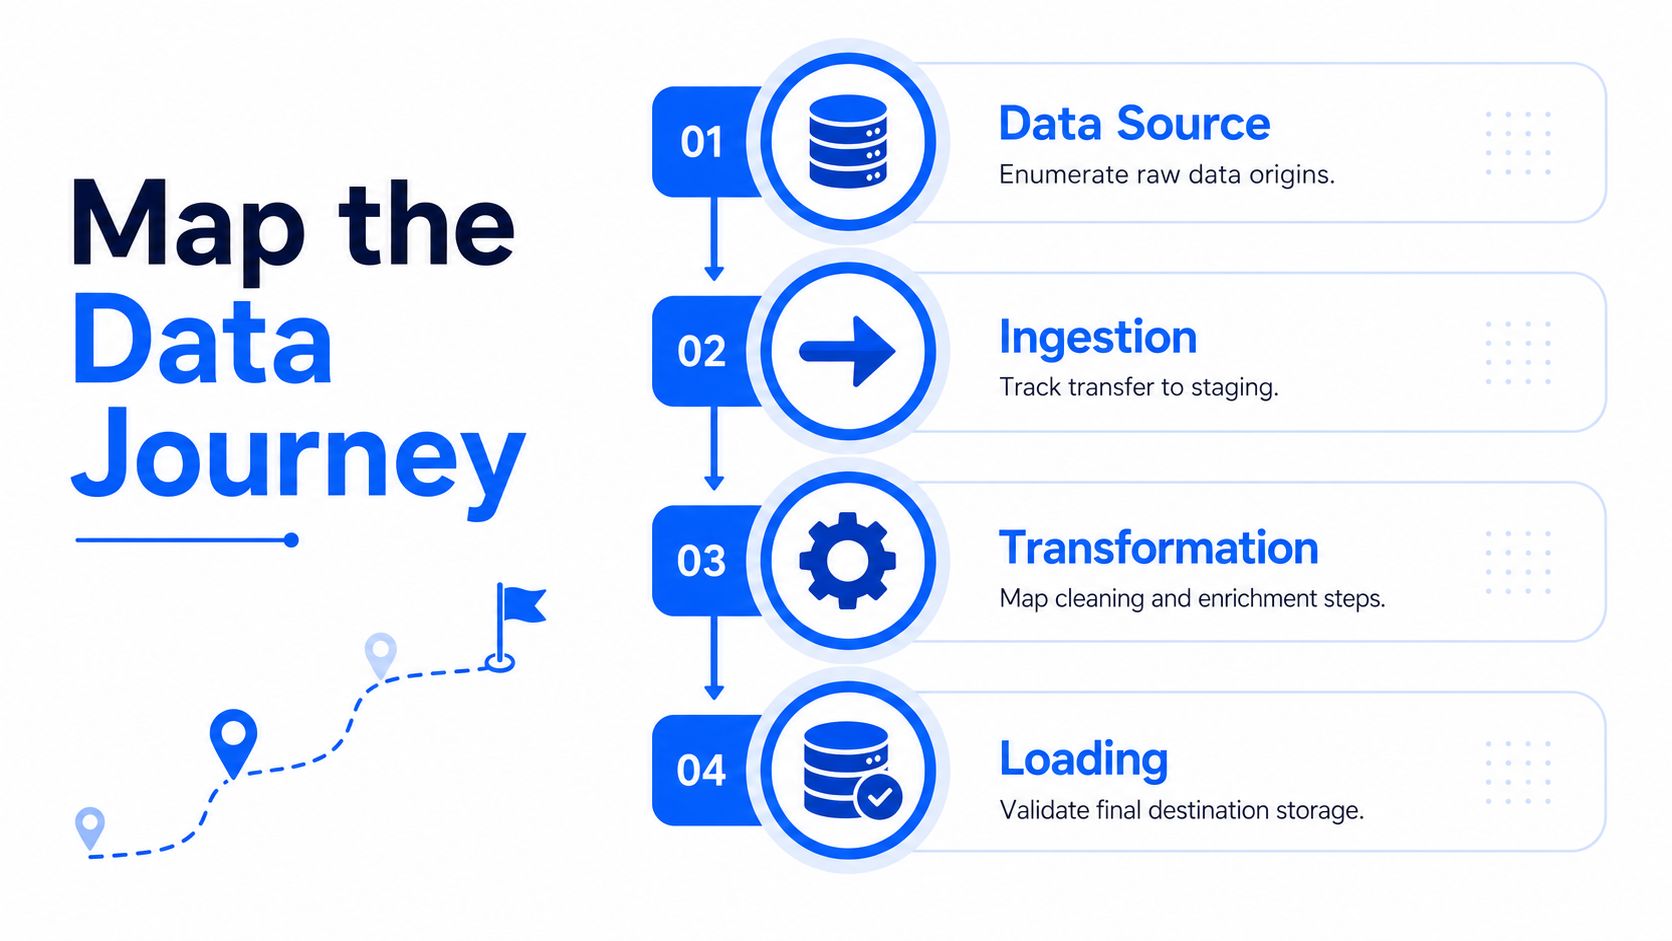
Ein Dashboard wird erst dann nützlich, wenn die Pipeline als eine Abfolge kontrollierbarer Schritte verstanden wird. Beginnen Sie damit, die gesamte Datenreise von der Quelle über die Erfassung und Transformation bis hin zur Bereitstellung abzubilden, und identifizieren Sie, wo in jeder Phase Fehler auftreten können. Diese Zuordnung macht den Unterschied aus zwischen dem Erkennen eines fehlerhaften Ergebnisses und dem Verhindern des Fehlers im Vorfeld. Deshalb ist der Prozesskontext wichtiger als das reine Metrikvolumen.
Kontrollen an Fehlermodi koppeln
Jedes Risiko sollte an der Stelle kontrolliert werden, an der es auftreten kann. In der Praxis bedeutet dies, zu entscheiden, ob die Kontrolle präventiv, detektivisch oder korrigierend ist, anstatt generische Prüfungen an das Ende der Pipeline zu werfen und auf das Beste zu hoffen. Eine verspätete Lieferantendatei ist nicht dasselbe wie ein fehlerhafter Datensatz, und ein doppelter Schlüssel im Staging ist nicht dasselbe wie eine fehlerhafte Referenztabelle.
Die nützliche Designeinheit ist der Kontrolldatensatz. Dokumentieren Sie für jede Kontrolle das Risiko, die Auswirkungen bei Nichtentdeckung, die Kontrollbeschreibung und den Ausführungsnachweis. Diese Struktur macht das Dashboard auditierbar und gibt den Bedienern eine konkrete Handlungsempfehlung anstelle einer vagen roten Kachel.
Eine Kundenbestellungs-Pipeline ist ein gutes Beispiel. Bei der Erfassung kann eine präventive Kontrolle eine fehlerhafte Datei zurückweisen, bevor sie importiert wird. Während der Transformation kann eine detektivische Kontrolle einen unerwarteten Anstieg von Nullwerten im Bestellstatus aufdecken. Beim Laden kann eine korrigierende Kontrolle einen fehlerhaften Batch in eine Quarantänetabelle umleiten und den Dateneigentümer benachrichtigen.
Überwachen Sie nicht nur die finale Tabelle. Wenn Fehler bereits im Upstream auftreten, kommt das nachgelagerte Symptom zu spät, um geschäftlichen Schaden zu verhindern.
Eine einfache und funktionierende Mapping-Disziplin
Jede Phase aufzählen. Schreiben Sie auf, wo Daten eingehen, wie sie sich bewegen, ihre Form ändern und nutzbar werden.
Den Fehlermodus benennen. Denken Sie an fehlende Dateien, doppelte Zeilen, ungültige Codes, Schema-Drift oder veraltete Ladungen.
Den Kontrolltyp wählen. Präventiv, um fehlerhafte Daten zu stoppen; detektivisch, um Drift zu erkennen; korrigierend, um Behebungsmaßnahmen einzuleiten.
Zuständigkeit festhalten. Die Kontrolle ist unvollständig, solange niemand für die Reaktion verantwortlich ist.
Ein wenig Disziplin an dieser Stelle erspart später viel unruhiges Monitoring. Wenn das Dashboard an der Datenreise verankert ist, hat jede Metrik ihren Platz und jeder Alarm weist auf ein echtes operatives Risiko hin.
Die sechs KPIs, die jedes Dashboard für Datenqualität tracken muss
Die sechs Kerndimensionen bilden nach wie vor das Rückgrat jedes professionellen Dashboards für Datenqualität, aber sie funktionieren nur, wenn jede einzelne an eine messbare Kontrolle gekoppelt ist. Es geht nicht darum, die Daten abstrakt zu bewerten. Es geht darum zu erkennen, ob sich ein bestimmtes Risiko verschlimmert, stabil bleibt oder bereits einen Geschäftsprozess stört.
Jede Dimension als Kontrollsignal messen
Genauigkeit ist die Übereinstimmung zwischen dem Datensatz und einem vertrauenswürdigen System of Record. In der Praxis kann dies einen stichprobenartigen Abgleich zwischen Quell- und Zieldatensätzen oder einen Vergleich auf Feldebene für kritische Attribute bedeuten.
Vollständigkeit wird meist als Nullwert-Rate ausgedrückt, aber auch die Abweichung der Zeilenanzahl ist wichtig. Eine Tabelle kann befüllt aussehen und dennoch kann ein großer Teil der erwarteten Datensätze fehlen.
Konsistenz prüft, ob Beziehungen über Tabellen hinweg Bestand haben. Die referenzielle Integrität ist das offensichtliche Beispiel, aber auch die feldübergreifende Übereinstimmung, bei der eine Spalte logisch mit einer anderen übereinstimmen muss.
Data Timeliness erfordert mehr Sorgfalt als eine einfache Frischeprüfung. Die erwartete Ankunftszeit im Vergleich zur tatsächlichen Ankunftszeit zeigt Ihnen, ob die Verzögerung harmlos oder ein geschäftliches Problem ist. Diese Unterscheidung ist für volatile Pipelines unerlässlich.
Gültigkeit misst, ob Werte auf Datensatzebene den Geschäftsregeln entsprechen, wie z. B. erlaubte Bereiche, Formate oder bedingte Logik.
Eindeutigkeit verfolgt doppelte Schlüssel oder andere Duplizierungsmuster, die nachgelagerte Zählungen, Joins oder Kundenansichten verfälschen würden.
Die praktischste Methodik besteht darin, zuerst die kritischen Datenelemente zu definieren, Geschäftsregeln auf technische Prüfungen abzubilden und dann abgestufte Schwellenwerte anstelle eines binären Bestanden/Fehlgeschlagen-Modells zu verwenden. Best Practices in der Praxis empfehlen, Felder zu priorisieren, die sich auf die Compliance, das Berichtswesen oder den Umsatz auswirken, und dann Schweregradbereiche festzulegen, damit Teams Prioritäten setzen können, anstatt jeden Fehler als gleich dringend zu behandeln. Dieselbe Quelle empfiehlt auch einen strengen Bronze-Schwellenwert unter 95 % für eine sofortige Behebung. Dies ist ein nützliches Muster, wenn ein Feld für einen regulierten Workflow oder einen Umsatzbericht von zentraler Bedeutung ist. Praktisches Framework für Genauigkeit und Vertrauen
Dimension | Kontrolltyp | Beispielmetrik | Bronze-Schwellenwert-Muster |
|---|---|---|---|
Genauigkeit | Detektivisch | Stichprobenartiger Datensatzabgleich mit dem System of Record | Sofortige Überprüfung, wenn kritische Felder abweichen |
Vollständigkeit | Detektivisch | Nullwert-Rate und Abweichung der Zeilenanzahl | Unterhalb des strengen Mindestwerts für Pflichtfelder |
Konsistenz | Detektivisch | Fehler bei der referenziellen Integrität | Sofortige Behebung bei fehlerhaften Beziehungen |
Data Timeliness | Präventiv oder detektivisch | Erwartete Ankunftszeit im Vergleich zur tatsächlichen Ankunftszeit | Verzögerung außerhalb des vereinbarten Zeitfensters |
Gültigkeit | Präventiv oder detektivisch | Erfolgsquote der Regeln bei Prüfungen auf Feldebene | Unterhalb des Mindestwerts für regulierte oder risikoreiche Felder |
Eindeutigkeit | Detektivisch | Rate doppelter Schlüssel | Sofortige Untersuchung bei Identitäts- oder Transaktionsschlüsseln |
Ein häufiger Fehler besteht darin, allen sechs Dimensionen das gleiche Gewicht zu geben. Das verwässert die Aufmerksamkeit und erzeugt unnötiges Alarmrauschen, da nicht jede Regel die gleiche operative Reaktion verdient. Eine kleine Anzahl kritischer Prüfungen mit klaren Bereichen und Zuständigkeiten ist jedes Mal besser als ein riesiger Haufen grüner und roter Badges. Für einen detaillierteren Metrik-Katalog lohnt es sich, den internen Leitfaden auf dignas Seite für Datenqualitätsmetriken mit Ihrer eigenen Liste kritischer Datenelemente abzugleichen.
Panel-Muster für Timeliness, Anomalien, Schemata und Validierung
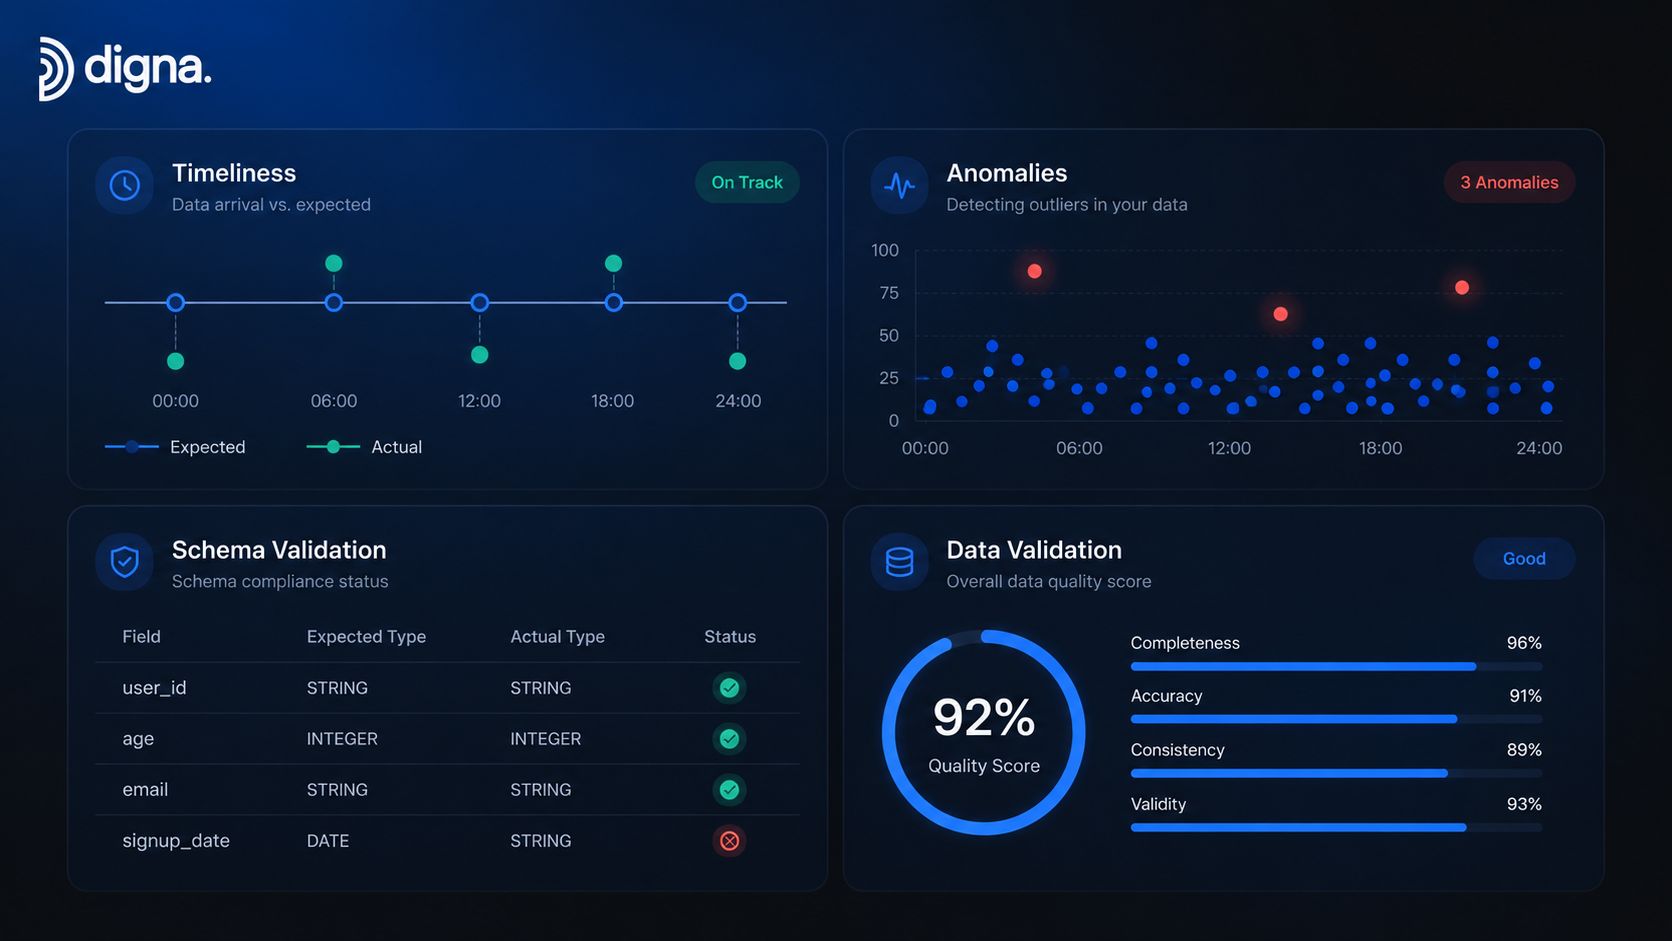
Die Oberfläche eines Dashboards sollte die Art der Fragestellung widerspiegeln, nicht umgekehrt. Die Einstiegsansicht benötigt eine schnelle Übersicht darüber, ob die Pipeline fehlerfrei läuft. Die Drilldown-Ansichten benötigen genügend Details, um zu erklären, warum dies nicht der Fall ist. Diese Trennung ist wichtig, da ein Gesundheitswert ohne einsehbare Panels zu einem statischen Screenshot und nicht zu einem Arbeitswerkzeug wird.
Panels für Timeliness und Anomalien
Ein Timeliness-Panel sollte die erwartete Ankunftszeit mit der tatsächlichen vergleichen und die Verzögerung unübersehbar machen. Wenn sich ein Batch um einige Minuten verzögert, erfordert dies eine andere operative Haltung als ein Batch, der den Zeitplan komplett verpasst hat. Das nützliche Ergebnis ist die Verzögerung in einer konkreten Zeiteinheit, ergänzt durch eine sichtbare Zeitplanmarkierung, die dem Bediener zeigt, ob das Problem Routine oder ungewöhnlich ist.
Das Anomalie-Panel sollte das erlernte Basisverhalten im Vergleich zum aktuellen Wert anzeigen und Punkte hervorheben, die außerhalb des erwarteten Korridors liegen. Das funktioniert besser als eine einzelne Zahl, da es sowohl allmähliche Abweichungen als auch abrupte Brüche erfasst. Historischer Kontext gehört ebenfalls hierher, da ein plötzlicher Ausschlag ohne das vorherige Muster, das „normal“ definiert, wenig aussagt.
Panels für Schemata und Validierung
Ein Schema-Tracker sollte hinzugefügte Spalten, entfernte Spalten und Typänderungen mit Zeitstempeln und betroffenen nachgelagerten Objekten protokollieren. Dadurch kann das Engineering den Auswirkungsbereich erkennen, bevor ein fehlerhaftes Feld das Berichtswesen oder das Modell-Scoring erreicht. Es hilft auch, wenn sich eine harmlos aussehende Umbenennung in einen Produktionsvorfall verwandelt, weil ein nachgelagerter Job immer noch die alte Struktur erwartet.
Das Validierungs-Panel sollte fehlgeschlagene Regeln auf Datensegmentebene, Beispieldatensätze und die Zuständigkeitsweiterleitung auflisten. Es sollte die tatsächlich fehlerhaften Zeilen nicht hinter einem aggregierten Wert verstecken. Bediener müssen wissen, was fehlgeschlagen ist, welchen Datensatz es betrifft und wer für die Behebung verantwortlich ist.
Eine gute Startseite beantwortet eine Frage: Steuert irgendetwas auf einen Ausfall zu? Alles andere gehört eine Klicktiefe weiter nach unten.
Plattformen wie digna organisieren diese Oberflächen um Data Timeliness, Data Anomalies, Schema Tracker und Data Validation. Diese Anordnung lässt sich gut auf die oben genannten Panels übertragen, da sie das operative Monitoring von der forensischen Untersuchung trennt. Die interne Best-Practice-Notiz unter Observability Best Practices ist ein nützlicher Orientierungspunkt, wenn Sie entscheiden, wie viele Details auf den ersten Bildschirm und wie viele in den Drilldown gehören.
Visuelle Muster wählen, die Entscheidungen in weniger als zehn Sekunden ermöglichen
Jedes Diagramm auf einem Dashboard für Datenqualität sollte eine Entscheidung in weniger als zehn Sekunden ermöglichen. Wenn es das nicht kann, nimmt es wahrscheinlich Platz weg, der einer Scorecard, einer Trendlinie oder einer Lineage-Ansicht gehören sollte. Das richtige Muster hängt davon ab, ob der Betrachter etwas erkennen, vergleichen oder untersuchen muss.

Das Diagramm auf die Entscheidung abstimmen
Eine Scorecard mit Ampelfarben funktioniert am besten, wenn die einzige Frage ist, ob im Moment Handlungsbedarf besteht. Das ist nützlich für eine Führungskraft, die ein schnelles Signal über mehrere kritische Datensätze hinweg benötigt.
Eine gestapelte Trendlinie ist besser geeignet, wenn es darum geht, schleichenden Verfall zu erkennen. Einzelwert-Anzeigen sehen zwar sauber aus, verbergen jedoch, ob eine Metrik Woche für Woche abweicht oder sich innerhalb der normalen Varianz stabil verhält.
Eine Topologie- oder Lineage-Ansicht ist die einzig ehrliche Möglichkeit, den Auswirkungsbereich einer Schemaänderung aufzuzeigen. Wenn sich die Umbenennung einer Spalte auf drei nachgelagerte Jobs und zwei Dashboards auswirkt, sollte der Betrachter diesen Pfad sehen und nicht nur die fehlerhafte Tabelle.
Separate Ansichten für verschiedene Rollen nutzen
Eine Führungsansicht sollte den Status des Programms auf wenige Entscheidungen komprimieren. Eine Data-Steward-Ansicht benötigt Zuständigkeiten, Ausnahmen und den Status der Behebung. Die Ansicht eines On-Call-Engineers benötigt Zeitstempel, Beispiele und die spezifische Kontrolle, die fehlgeschlagen ist.
Dieselbe zugrunde liegende Metrik kann allen drei Zielgruppen dienen, jedoch nicht in der gleichen Darstellung. Ein klares Balkendiagramm kann für die Priorisierung ausreichen, während ein dichter Drilldown-Baum für die nachträgliche Untersuchung besser geeignet ist. Dekorative Visualisierungen sind verschwendet, wenn sie die Zeit bis zur Aktion nicht verkürzen.
Wenn ein Diagramm beeindruckend aussieht, aber den nächsten Schritt nicht beeinflusst, gehört es in eine Präsentationsfolie und nicht in ein Monitoring-System.
Die Faustregel ist einfach: Nutzen Sie die am einfachsten verständliche visuelle Darstellung, die die operative Frage noch beantwortet. Alles, was komplexer ist, erhöht die kognitive Belastung, ohne die Behebung zu verbessern.
Alarmierung, Eskalation und das Abstellen von Alarm-Müdigkeit
Bei der Alarmierung entscheidet sich, ob Dashboards Vertrauen gewinnen oder es dauerhaft verlieren. Wenn jede Schwellenwertüberschreitung dieselbe Art von Lärm verursacht, glauben die Bediener dem System irgendwann nicht mehr. Wenn das System nur bei schwerwiegenden Fehlern alarmiert, übersieht es den schleichenden Verfall, der sich früher kostengünstig hätte beheben lassen.
Alarme nach Zuständigkeit und Schweregrad gestalten
Abgestufte Alarme funktionieren besser als ein einzelner Schwellenwert, da sie sich den entsprechenden Reaktionspfaden zuordnen lassen. Ein kritischer Bereich sollte einen namentlich genannten Eigentümer benachrichtigen. Ein hoher Bereich kann eine dringende Überprüfung auslösen. Niedrigere Bereiche sollten protokolliert, im Trend beobachtet und bis zu einer Aggregation zurückgehalten werden, sofern sie nicht dauerhaft bestehen.
Jeder Alarm benötigt einen definierten Eigentümer und einen Link zum Runbook. Ohne dies ist der Alarm nur eine Beschwerde mit einem Zeitstempel. Die Zuordnung von Zuständigkeiten ist wichtig, da die Person, die das Signal empfängt, bereits wissen sollte, ob sie es beheben, umleiten oder eskalieren kann.
Der schwierigste Teil ist die Feinabstimmung. Ein öffentliches ITSV-Beispiel beschrieb über 140 tägliche Alarme, von denen die meisten ignoriert wurden, da die Flut im Posteingang es unmöglich machte, Signale von Rauschen zu trennen. Das sind die Kosten einer unkalibrierten Alarmierung, und genau deshalb sind das Erlernen von Basiswerten und die Zuordnung von Zuständigkeiten so wichtig. Bedeutung von Dashboards für Datenqualität und Alarm-Müdigkeit
Rauschen reduzieren, ohne echte Risiken zu verbergen
Bekanntermaßen unbedenkliche Zeitfenster sollten unterdrückt werden. Geplante Wartungsarbeiten, Batch-Umstellungen und geplante Backfills sollten das Team nicht alarmieren, wenn das Ereignis erwartet und dokumentiert war. Ruhezeiten und Ausnahmezeitfenster halten das Dashboard nutzbar, ohne dass es zu einer Sicherheitslücke wird.
Die operative Metrik, auf die es am meisten ankommt, ist nicht die reine Anzahl der Alarme. Es ist die Frage, ob die Leute schnell auf die richtigen Alarme reagieren und ob das System weiterhin Fehlalarme produziert. Wenn die Reaktionsquote schwach ist, ist der Schwellenwert wahrscheinlich zu empfindlich eingestellt, die Weiterleitung fehlerhaft oder der Eigentümer existiert nicht wirklich.
Ich habe erlebt, dass Teams ihr Vertrauen erst wiedererlangt haben, nachdem sie die alarmwürdigen Bedingungen auf die Handvoll reduziert haben, die den Betrieb oder die Compliance gefährden. Alles andere wird weiterhin aufgezeichnet, unterbricht aber niemanden in der Nacht, es sei denn, die geschäftlichen Auswirkungen rechtfertigen es. Diese Balance macht aus einem Dashboard ein echtes Kontrollsystem anstelle einer dauerhaften Sirene.
Architektur, In-Database-Berechnung und Governance-Übergaben
Die Standardarchitektur für ein professionelles Dashboard ist die In-Database-Metrikberechnung. Belassen Sie die Analysen dort, wo die Daten bereits liegen, um Frische zu wahren, unnötige Datenbewegungen zu reduzieren und das Kopieren sensibler Datensätze in ein anderes System nur zu Messzwecken zu vermeiden. Dieses Muster erleichtert es auch, Trendanalysen, Anomalieerkennung und Schema-Tracking auf demselben Metrikspeicher zu halten, ohne die Pipeline zu fragmentieren.
Das Dashboard mit Governance verbinden, nicht nur mit Monitoring
Das Dashboard sollte nahtlos an die Governance übergeben werden. Data Stewards verantworten die geschäftliche Interpretation der Panels, das Engineering ist für die operativen Prüfungen zuständig und das Audit benötigt eine nachvollziehbare Historie darüber, was sich geändert hat und was unternommen wurde. Diese Übergabe funktioniert nur, wenn das Dashboard genügend Kontext für die Überprüfung zurückschreibt, einschließlich des Prüfungsverlaufs und des Ausführungsnachweises.
Das Plattformdesign ist entscheidend. Ein System wie digna berechnet Signale innerhalb der Kundenumgebung. Dies hält die operative Ansicht im Einklang mit dem Datenresidenzmodell und vermeidet zusätzliche Kopien nur für das Monitoring. Derselbe Ansatz unterstützt auch Governance-Workflows, da die Ergebnisse mit Data Contracts, Lineage und Review-Prozessen verknüpft werden können, ohne das Dashboard zu einer isolierten Insel zu machen.
Der saubere Einführungspfad ist unkompliziert:
Berechnung nah an den Daten halten. Aktualitätssignale sind schwächer, wenn sie von Bewegungen über Systeme hinweg abhängen.
Historie pro Prüfungslauf speichern. Eine Zeile pro Durchlauf liefert Ihnen Trends, nicht nur den aktuellen Zustand.
Ergebnisse an Eigentümer weiterleiten. Ein Ergebnis ohne Zuständigkeit ist nur eine Notiz.
Governance aus demselben Metrikspeicher speisen. Das hält Stewardship, Audit und Engineering im Einklang.
Ein Dashboard ist nicht das eigentliche Lieferergebnis. Es ist der Kontrollpunkt, an dem Betrieb, Analytik und Governance aufeinandertreffen. Wenn es so aufgebaut ist, hilft das Dashboard Teams dabei, Verfall früher zu erkennen, die richtige Behebungsmaßnahme zuzuweisen und zu beweisen, dass die Maßnahme erfolgreich war.
Wenn Sie Dashboards für Datenqualität erstellen oder überarbeiten, konzentrieren Sie sich auf Prozessmapping, abgestufte Schwellenwerte und Alarm-Zuständigkeiten, bevor Sie das Design verfeinern. digna bietet In-Database-Monitoring für Anomalien, Timeliness, Validierung, Schemaänderungen und Trendanalysen, damit Teams den Kontrollkreis innerhalb ihrer eigenen Umgebung belassen können. Besuchen Sie digna, wenn Sie ein Dashboard-Design wünschen, das Prüfungen, Zuständigkeiten und Reaktionen miteinander verbindet, ohne das Monitoring in eine weitere Lärmquelle zu verwandeln.


