Datenbank-Performance-Tuning: So meistern Sie Ihr System
|
8
min. Lesezeit
Ihr Dashboard ist nicht von einem Tag auf den anderen ausgefallen. Es wurde jede Woche ein wenig langsamer. Ein Finanzbericht, der früher sofort geladen wurde, hängt nun zu Spitzenzeiten. Eine BI-Aktualisierung verpasst zunehmend ihr Zeitfenster. Eine ML-Feature-Pipeline läuft zwar noch, doch das Datenprofil dahinter hat sich gerade so weit verschoben, dass sich die Abfragepläne nicht mehr so verhalten wie beim letzten Tuning des Systems.
Genau dort stehen derzeit viele Teams. Sie behandeln Datenbank-Performance-Tuning als Übung zur Optimierung langsamer Abfragen, obwohl das eigentliche Problem Drift ist. Nicht nur Workload-Drift, sondern Data Drift. Zeilenzahlen ändern sich, Verteilungen verschieben sich, ein Feld, das Nullwerte zulässt, liefert plötzlich neue Muster, ein Schema-Update wird unbemerkt eingespielt – und die Baseline, der Sie vertraut haben, beschreibt die Realität nicht mehr.
Klassisches Tuning bleibt wichtig. Sie benötigen weiterhin Ausführungspläne, Index-Reviews, Speichereinstellungen und diszipliniertes Rollback. Doch statisches Tuning ist unvollständig in Systemen, in denen sich die Gestalt der Daten täglich ändert.
Inhaltsverzeichnis
Mehr als langsame Abfragen: Die eigentliche Ursache von Performance-Problemen
Eine Baseline festlegen: Probleme messen und diagnostizieren
Mehr als langsame Abfragen: Die eigentliche Ursache von Performance-Problemen
Die meisten Performance-Vorfälle beginnen nicht mit einer einzelnen, offensichtlich fehlerhaften Abfrage. Sie beginnen mit einem System, das weniger vorhersehbar wird. Ein Dashboard ist morgens schnell und mittags sprunghaft. Ein Warehouse-Job, der bequem in sein Batch-Zeitfenster passte, kollidiert plötzlich mit anderen Workloads. Niemand hat gestern das SQL geändert, und dennoch spüren die Nutzer die Verschlechterung.
Das alte Vorgehen lautet: die langsamste Abfrage finden und optimieren. Das hat weiterhin seinen Wert, übersieht aber eine wachsende Klasse von Problemen, bei denen das SQL nur das Symptom ist. Aktuelle Analysen zeigen, dass 68 % der Performance-Verschlechterungen von Datenbanken in den Jahren 2024–2025 nicht auf ineffiziente Abfragen zurückgehen, sondern auf vorgelagerte Datenqualitätsprobleme, die Zugriffsmuster unerwartet verändern – dennoch verknüpfen nur 12 % der Inhalte zum Tuning Observability-Metriken mit Performance-Tuning, so die Analyse von Last9 zum Datenbank-Performance-Tuning.
Warum stabile Systeme instabil werden
Eine Abfrage kann für die Datengestalt des letzten Monats völlig angemessen und für die heutige ungeeignet sein. PostgreSQL ist ein gutes Beispiel. Eine Tabelle sammelt Änderungen an, Autovacuum gerät in Rückstand, Bloat wächst, und was wie ein moderater Scan aussah, wird zu unschönem I/O-Verhalten. SQL-Server-Teams beobachten ähnliche Drift bei tempdb-Konkurrenz und Planauswahl unter sich ändernden Workload-Mustern. Teradata-Umgebungen können auf Systemebene gesund wirken, während sich eine einzelne Workload-Klasse unauffällig so weit verschiebt, dass Warteschlangen und Antwortzeiten verzerrt werden.
Statisches Tuning setzt voraus, dass die Daten ähnlich bleiben. Produktivsysteme halten sich selten an diese Annahme.
Deshalb braucht Datenbank-Performance-Tuning einen breiteren Blickwinkel. Sie verwalten nicht nur Abfragetext und Engine-Einstellungen. Sie verwalten auch die Bedingungen, unter denen diese Abfragen laufen.
Eine praktische Denkweise dafür ist:
Langsames SQL bedeutet oft schlechte Zugriffspfade, ungünstige Joins, veraltete Statistiken oder übermäßige Lesevorgänge.
Performance-Drift bedeutet oft, dass sich der Workload geändert hat, weil sich die Daten geändert haben.
Geschäftliche Auswirkungen zeigen sich zuerst in veralteten Berichten, verzögerten Dashboards und weniger zuverlässigen Modellergebnissen.
Teams, die an Full-Stack-Performance für Entwickler arbeiten, wissen bereits, dass Latenz meist schichtübergreifend entsteht. Bei der Datenbankarbeit ist das nicht anders. Wenn ein vorgelagerter Load doppelte Datensätze einführt, die Kardinalität verschiebt oder das Eintreffmuster neuer Daten verändert, kann sich Ihr Abfrageplan verschlechtern, obwohl der Anwendungscode unverändert bleibt.
Der verborgene Bruch in den meisten Tuning-Workflows
Klassische Baselines sind oft Momentaufnahmen. Sie erfassen eine gute Phase, vielleicht eine schlechte, und vergleichen beide. Das ist nützlich, verrät Ihnen aber nicht, wann die Baseline selbst nicht mehr vertrauenswürdig ist, weil Schema, Volumen, Aktualität oder Verteilung gedriftet sind.
In dieser Lücke entstehen viele wiederkehrende Vorfälle. Die Datenbank ist nicht plötzlich schlechter geworden. Ihr Umfeld hat sich verändert, und das Team hat weiter gegen ein veraltetes Bild optimiert.
Eine Baseline festlegen: Probleme messen und diagnostizieren
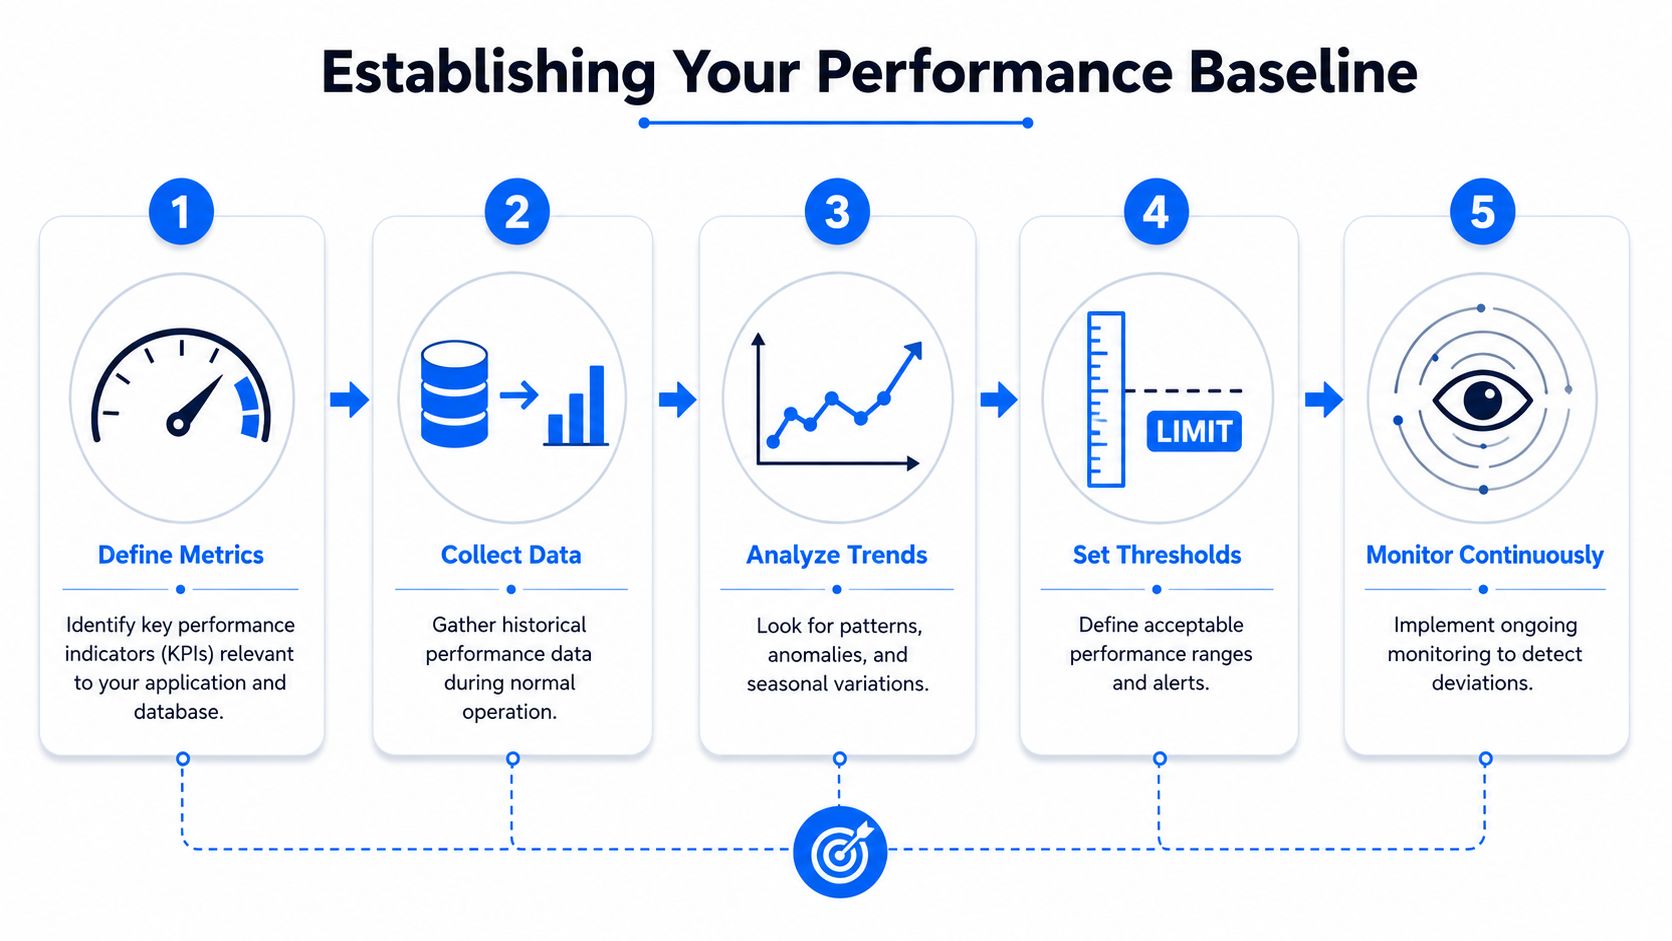
Datenbank-Performance-Tuning beginnt mit Belegen. Wenn Sie den Normalzustand des Systems nicht beschreiben können, können Sie auch nicht beurteilen, ob eine Änderung etwas verbessert oder das Problem nur verlagert hat.
Der Kern-Workflow hat sich nicht verändert, weil er funktioniert. Der Lebenszyklus „Messen, Analysieren, Optimieren, Validieren“ ist der allgemein anerkannte Standard: Latenz, Durchsatz und Ressourcenauslastung müssen vor jeder Optimierung erfasst werden, damit Änderungen gegen eine Baseline validiert werden, wie in dieser Übersicht zum Lebenszyklus des Performance-Tunings beschrieben.
Erst messen, dann eingreifen
Gute Teams werden an dieser Stelle ungeduldig. Das ist verständlich. Die Nutzer warten, und es gibt Druck, „einfach einen Index hinzuzufügen“ oder „mehr Speicher zuzuweisen“. Widerstehen Sie diesem Impuls, bis Sie eine Baseline aus gesunden und ungesunden Phasen erfasst haben.
Die Tuning-Empfehlungen von Oracle sind hier nach wie vor nützlich, weil sie darauf bestehen, vollständige Statistiken zu Betriebssystem, Datenbank und Anwendung sowohl in guten als auch in schlechten Zuständen zu erheben. Diese Disziplin ist wichtig. Fehlende Statistiken sind kein Formalitätsproblem. Sie machen die Ursachenanalyse zum Ratespiel.
Praxisregel: Wenn Sie den Zustand vorher nicht erfasst haben, können Sie nicht belegen, dass der Zustand nachher besser ist.
Die Baseline-Erfassung sollte den gesamten Betriebsbereich des Workloads abdecken und nicht nur eine einzelne langsame Anweisung. Das bedeutet, zu messen, was das System nach Modul, Zeitfenster und Ressourcentyp tut.
Für Teams, die ihr Monitoring verbessern möchten, lohnt es sich, diese Techniken für Datenbank-Monitoring und -Auditing parallel zu den nativen Werkzeugen der Engine zu prüfen.
Was die Baseline erfassen sollte
Die konkreten Werkzeuge unterscheiden sich je nach Plattform, die Kategorien sind jedoch dieselben. Query Store in SQL Server und Azure SQL, pg_stat_statements in PostgreSQL, die Performance-Views von Oracle und die Systemtabellen von Teradata helfen alle dabei, dieselben Arten von Belegen sichtbar zu machen.
Signal | Worauf Sie achten sollten | Worauf es meist hindeutet |
|---|---|---|
Latenz | Steigende Tail-Latenz und instabile Antwortzeiten | Planänderungen, I/O-Druck, Blockierungen, Cache-Misses |
Durchsatz | Weniger abgeschlossene Arbeit pro Modul oder Job-Zeitfenster | Konkurrenz, Warteschlangen, Write Amplification |
CPU und Speicher | Sättigung, plötzliche Verschiebungen, schlechtes Cache-Verhalten | Schlechte Pläne, Überbuchung, zu kleine Caches |
I/O und Wartezeiten | Lesespitzen, Spills, Speicherdruck, Wait Events | Fehlende Indizes, Sortierdruck, Bloat, temporäre Arbeitslast |
Fehler und Wiederholungen | Timeouts, häufiger Verbindungswechsel, fehlgeschlagene Aktualisierungen | Ressourcenerschöpfung, falsch dimensionierte Pools, Sperrketten |
Erfassen Sie diese Metriken nach Möglichkeit unter reproduzierbarer Last. Wenn Sie nur während eines Ausfalls Stichproben nehmen, wissen Sie nicht, ob das Problem eine Ausnahme oder Teil eines Trends ist.
Eine solide Baseline beantwortet in der Regel vier betriebliche Fragen:
Was war langsam. Nicht eine einzelne Anekdote, sondern die betroffenen Abfrageklassen, Jobs und Nutzerpfade.
Wo lag der Druck. CPU, Speicher, Storage, temporärer Speicherplatz oder Parallelität.
Wann hat es sich geändert. Nach einem Deployment, nach dem Eintreffen von Daten, während eines Reporting-Zeitfensters oder während Wartungsarbeiten im Hintergrund.
Hat das Unternehmen es bemerkt. Verzögerte Dashboards, veraltete Analysen, verletzte SLAs oder verzögertes Model Scoring.
Baselines brauchen Kontext, nicht nur Metriken
Eine zu enge Baseline kann Sie in die Irre führen. Angenommen, eine Warehouse-Abfrage wurde langsamer, nachdem eine Schemaänderung eine neue Spalte hinzugefügt hat und die nachgelagerte ETL begann, diese mit unerwarteten Null-Mustern zu befüllen. Der Abfrageplan mag der unmittelbare Mechanismus sein, doch die Diagnose ist erst vollständig, wenn Sie die Veränderung der Performance mit der Veränderung der Datengestalt verknüpfen.
Deshalb endet ausgereiftes Datenbank-Performance-Tuning nicht bei „Metriken sammeln“. Es verknüpft Systemmetriken mit dem zeitlichen Ablauf des Workloads, dem Schemazustand und dem Eintreffverhalten der Daten. Andernfalls ist Ihre Baseline zwar präzise, aber unvollständig.
Hotspots priorisieren, um die größten Erfolge zu erzielen
Sobald Sie das System vermessen haben, lauert die nächste Falle: wahlloses Tuning. Teams ertrinken in Diagrammen und verbringen dann eine Woche damit, Abfragen mit geringer Wirkung zu polieren, während der eigentliche Engpass weiter CPU verbrennt oder das I/O sättigt.
Der schnellste Ausweg ist eine Priorisierung nach Wirkung. Nicht danach, welche Abfrage hässlich aussieht. Nicht danach, welcher Alarm zuerst ausgelöst wurde. Sondern danach, welcher Hotspot die relevantesten Ressourcen verbraucht oder die meisten Nutzer beeinträchtigt.
Nach Wirkung priorisieren, nicht nach Ärgernis
Eine Abfrage, die ständig läuft und moderat Ressourcen verschwendet, kann wichtiger sein als ein spektakulärer einmaliger Bericht. SQL Server Query Store, die Visualisierungen von Azure SQL, die Workload-Views von Oracle, pg_stat_statements in PostgreSQL und die Workload-Metriken von Teradata helfen alle, dieselbe Frage zu beantworten: Was ist wiederholt so teuer, dass es das Systemverhalten prägt?
Beginnen Sie mit einem kurzen Priorisierungsmodell:
Häufigkeit zählt. Eine kleine Ineffizienz, die den ganzen Tag ausgeführt wird, kann die Gesamtlast dominieren.
Reichweite zählt. Abfragen, die an gemeinsam genutzte Dashboards oder zentrale APIs gebunden sind, verdienen mehr Aufmerksamkeit als Nischen-Admin-Jobs.
Ressourcentyp zählt. CPU-lastige und I/O-lastige Hotspots erfordern unterschiedliche Lösungswege.
Zeitpunkt zählt. Ein Job, der mit dem morgendlichen Reporting kollidiert, kann dringlicher sein als eine langsamere Aufgabe, die über Nacht läuft.
Optimieren Sie nicht zuerst die lauteste Abfrage. Optimieren Sie die, die die Plattform am stärksten verzerrt.
Bei den Ausführungsplänen wird das konkret. Achten Sie auf Full Scans großer Relationen, teure Joins mit schlechten Zeilenschätzungen, Spills in temporären Speicher oder wiederholte Key Lookups, die die Lesevorgänge aufblähen. Prüfen Sie in PostgreSQL, ob Checkpoint-Druck oder Autovacuum-Rückstand zeitlich mit der Verlangsamung zusammenfallen. Untersuchen Sie in SQL Server das tempdb-Verhalten und die Muster bei Memory Grants. Prüfen Sie in Teradata, welche Workload-Klassen in der Warteschlange stehen und ob eine Abfragefamilie Ressourcen monopolisiert.
Wie ein echter Hotspot aussieht
Ein echter Hotspot hat in der Regel eine dieser Formen:
Eine Reporting-Abfrage, die auf einer mittelgroßen Tabelle unauffällig war, nun aber weit mehr Daten scannt, weil sich die Verteilung verschoben hat.
Eine häufig ausgeführte Transaktionsanweisung, die nach Drift der Statistiken einen effizienten Zugriffspfad verloren hat.
Eine Warehouse-Transformation, deren Zwischensortiervolumen so lange wuchs, bis sie zu spillen begann.
Ein breiter BI-Join, der akzeptabel war, bevor Schema-Drift vorgelagert doppelte oder verwaiste Schlüssel einführte.
Denken Sie in Aufwand und Wirkung, bevor Sie Objekte ändern. Manche Erfolge sind einfach: Statistiken aktualisieren, einen offensichtlich ungenutzten Index entfernen, der Schreibkosten verursacht, oder ein Prädikat korrigieren, das die Indexnutzung verhindert. Andere erfordern mehr Sorgfalt, weil sie das Anwendungsverhalten oder das Speicherdesign verändern.
Es geht nicht darum, einen perfekten Backlog aufzubauen. Es geht darum, die wenigen Änderungen zu identifizieren, die die Plattform wieder zu stabilen Berichten, vorhersehbaren Batch-Zeitfenstern und zuverlässigen nachgelagerten Consumern führen.
Den Kern optimieren: Abfrage- und Schema-Tuning
Sobald die Hotspots priorisiert sind, optimieren Sie zuerst den Kernpfad. Das bedeutet in der Regel Abfragemuster, Indizes, Statistiken und erst danach umfangreichere Schemaänderungen. Die meisten Systeme bieten noch überraschend viel risikoarmes Verbesserungspotenzial, bevor jemand über Repartitionierung oder ein grundlegendes Redesign sprechen muss.
Mit risikoarmen Änderungen beginnen
Ein disziplinierter Workflow beginnt klein. Aktualisieren Sie Statistiken, wenn sie veraltet sind. Prüfen Sie Ausführungspläne. Fügen Sie Indizes nur hinzu oder passen Sie sie an, wenn Plan und Zugriffsmuster dies rechtfertigen. Kleinere SQL-Umschreibungen, Korrekturen am Connection Pool und die Validierung von Plänen gehören in der Regel vor ein strukturelles Redesign.
Ein praktischer Fehler zeigt sich überall: Teams fügen immer weitere Indizes hinzu, ohne zu prüfen, ob sich bestehende bereits überschneiden oder ob der Schreibpfad zusätzliche Wartungskosten verkraftet. Die in dieser Übersicht zum Datenbank-Performance-Tuning zusammengefassten Empfehlungen weisen hier in die richtige Richtung. Das Entfernen ungenutzter oder redundanter Indizes kann Schreib-Overhead und Speicherkosten senken, während blindes Hinzufügen weiterer Indizes den Optimizer zu schlechten Entscheidungen oder größerem Wartungsaufwand verleiten kann.
Einige Tuning-Maßnahmen zahlen sich regelmäßig aus:
Index-Wildwuchs bereinigen. Redundante Indizes erhöhen die Schreibkosten und können die Fehlersuche erschweren.
Kurze, zweckgerichtete Indizes bevorzugen. Große textähnliche Felder sind meist schlechte Indexkandidaten, weil sie die Strukturgröße und den Rechenaufwand aufblähen.
Cache-Verhalten nach Abfrageänderungen prüfen. Buffer Pools sollten den Working Set aufnehmen, ohne den gesamten Systemspeicher zu belegen.
Regelmäßig prüfen. Index-Reviews und eine saubere Konfigurationspflege verhindern den schleichenden Verfall, der sich in ausgereifte Systeme einschleicht.
KI-Umschreibungen mit Bedacht einsetzen
KI-gestütztes Umschreiben von Abfragen ist verlockend, weil es schnelle Erfolge verspricht. Manchmal hilft es. Es kann Vereinfachungen von Joins, bereinigte Prädikate oder alternative Formulierungen vorschlagen, die Menschen unter Zeitdruck übersehen würden.
Doch KI hat in Produktivdatenbanken eine scharfe Kante. Eine Branchenumfrage aus dem Jahr 2025 ergab, dass 44 % der KI-generierten Abfrageoptimierungen in Finanz- und Gesundheitsdatensätzen subtile Fehler einführten, weil die Behandlung von Nullwerten oder die Semantik von Datumsbereichen falsch interpretiert wurde, so diese Zusammenfassung einer Branchenumfrage zu KI-gestütztem Tuning.
Dieses Ergebnis deckt sich mit dem, was erfahrene Engineers bereits wissen: Abfragegeschwindigkeit ist nicht dasselbe wie Abfragekorrektheit.
Behandeln Sie KI-Vorschläge wie den Entwurf eines Junior-Reviewers:
Prüfen Sie die Änderung im Ausführungsplan.
Validieren Sie die Semantik auf Datensatzebene.
Vergleichen Sie Ergebnismengen anhand repräsentativer Grenzfälle.
Achten Sie genau auf die Behandlung von Nullwerten, Datumsgrenzen und das Verhalten bei Duplikaten.
Schnelleres SQL, das die falschen Zeilen zurückgibt, ist ein Produktionsfehler und keine Optimierung.
In Analytics- und ML-Systemen ist das noch wichtiger. Ein subtiler semantischer Fehler in einer Reporting-Abfrage kann zu einem veralteten oder irreführenden KPI werden. Eine fehlerhafte Umschreibung in einer Feature-Pipeline kann Modelleingaben verändern, während das Warehouse „schneller“ wirkt.
Wissen, wann sich Schemaänderungen lohnen
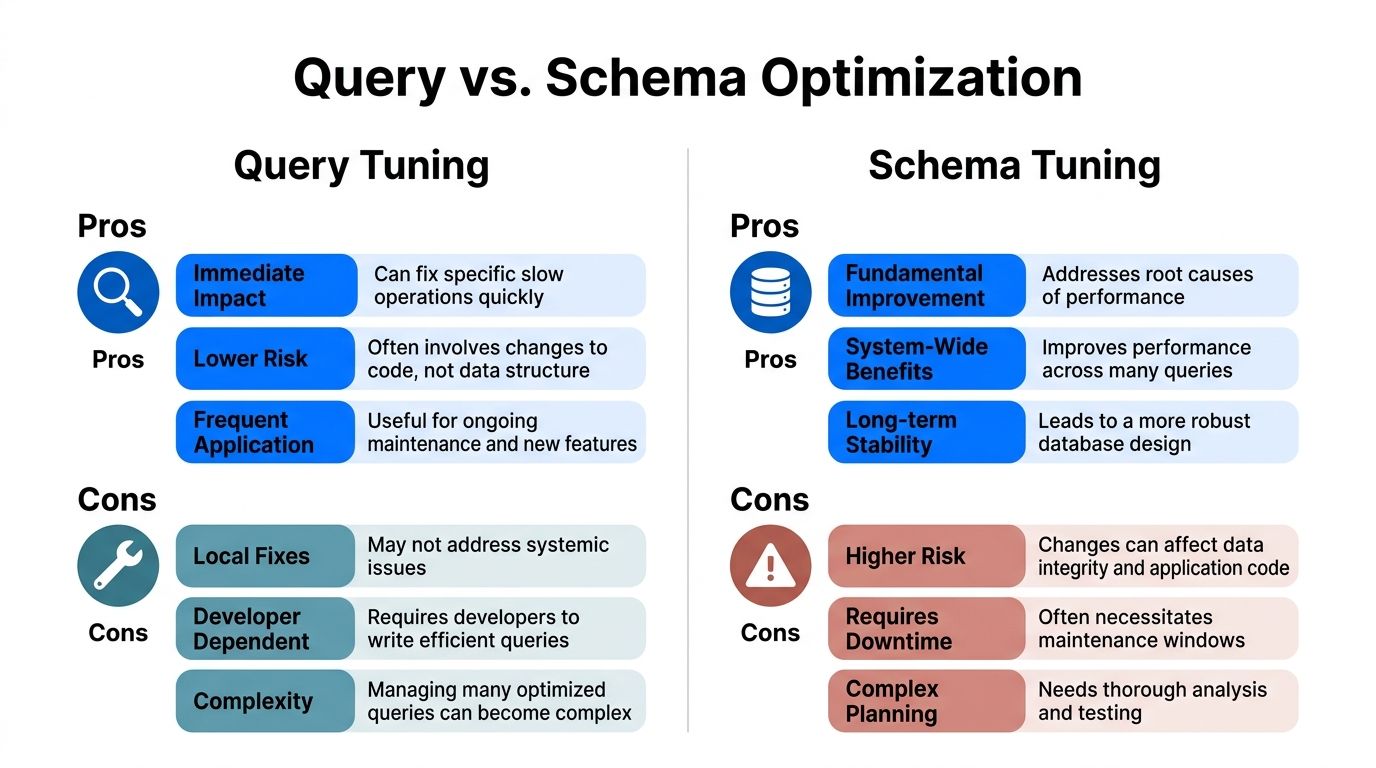
Abfrage-Tuning wirkt lokal. Schema-Tuning wirkt systemisch. Deshalb können Schemaänderungen einen breiten Nutzen bringen, bergen aber auch mehr Risiko.
Setzen Sie Schemaänderungen ein, wenn das Problem strukturell und nicht kosmetisch ist. Beispiele sind Tabellen, die ihrem aktuellen Layout klar entwachsen sind, Join-Pfade, die wiederholt von ungünstigen Schlüsselstrukturen abhängen, oder Workloads, die Partitionierung und Lifecycle-Management statt einer weiteren Runde Abfrage-Pflaster benötigen.
Eine nützliche Einordnung der Wahl:
Option | Am besten geeignet, wenn | Wichtigster Kompromiss |
|---|---|---|
Abfrage-Tuning | Eine kleine Anzahl von Anweisungen das Problem verursacht | Möglicherweise beheben Sie nur lokale Symptome |
Index-Tuning | Zugriffspfade falsch oder unvollständig sind | Schreibvorgänge werden teurer |
Schema-Tuning | Viele Abfragen unter derselben Designbeschränkung leiden | Höheres Änderungsrisiko und mehr Abstimmungsbedarf |
Die Reihenfolge ist entscheidend. Beginnen Sie mit der am wenigsten disruptiven Option, die das Problem plausibel lösen kann. Wenn sich nichts bewegt, setzen Sie die Änderung sauber zurück und gehen zur nächsten Ebene über.
Diese Denkweise verhindert, dass Datenbank-Performance-Tuning in ein unbeabsichtigtes Redesign ausartet.
Die Engine tunen: Konfiguration und Ressourcen anpassen
Sobald die Arbeit an Abfragen und Schema läuft, richten Sie die Aufmerksamkeit auf die Engine selbst – eine Phase, in der viele Teams entweder zu viel oder zu wenig tun. Entweder drehen sie an jedem Regler, den sie finden, oder sie lassen offensichtliche Ressourcenprobleme unangetastet, weil sie annehmen, „es muss am SQL liegen“.
Beides ist ein Fehler.
Konfiguration als Experiment behandeln
Konfigurations-Tuning funktioniert nur, wenn es einer strikten Methode mit jeweils nur einer Änderung folgt. Die Tuning-Methodik von Oracle ist in diesem Punkt eindeutig, nachzulesen in den Empfehlungen zu einer schrittweisen Tuning-Methode. Ändern Sie jeweils nur einen Parameter oder ein Objekt, erfassen Sie Metriken vorher und nachher, und erklären Sie keinen Erfolg, solange der kausale Zusammenhang nicht eindeutig ist.
Das gilt für Speichereinstellungen, Connection Pools, Parallelität, Speicherplatzierung und Diagnosewerkzeuge. Es gilt auch für den kleinen, aber häufigen Stolperstein, Produktions-Tracing oder Extended-Event-Sitzungen nach einer Untersuchung weiterlaufen zu lassen. Diese Werkzeuge können Teil des Latenzprofils werden, wenn niemand sie wieder entfernt.
Eine sinnvolle Reihenfolge sieht so aus:
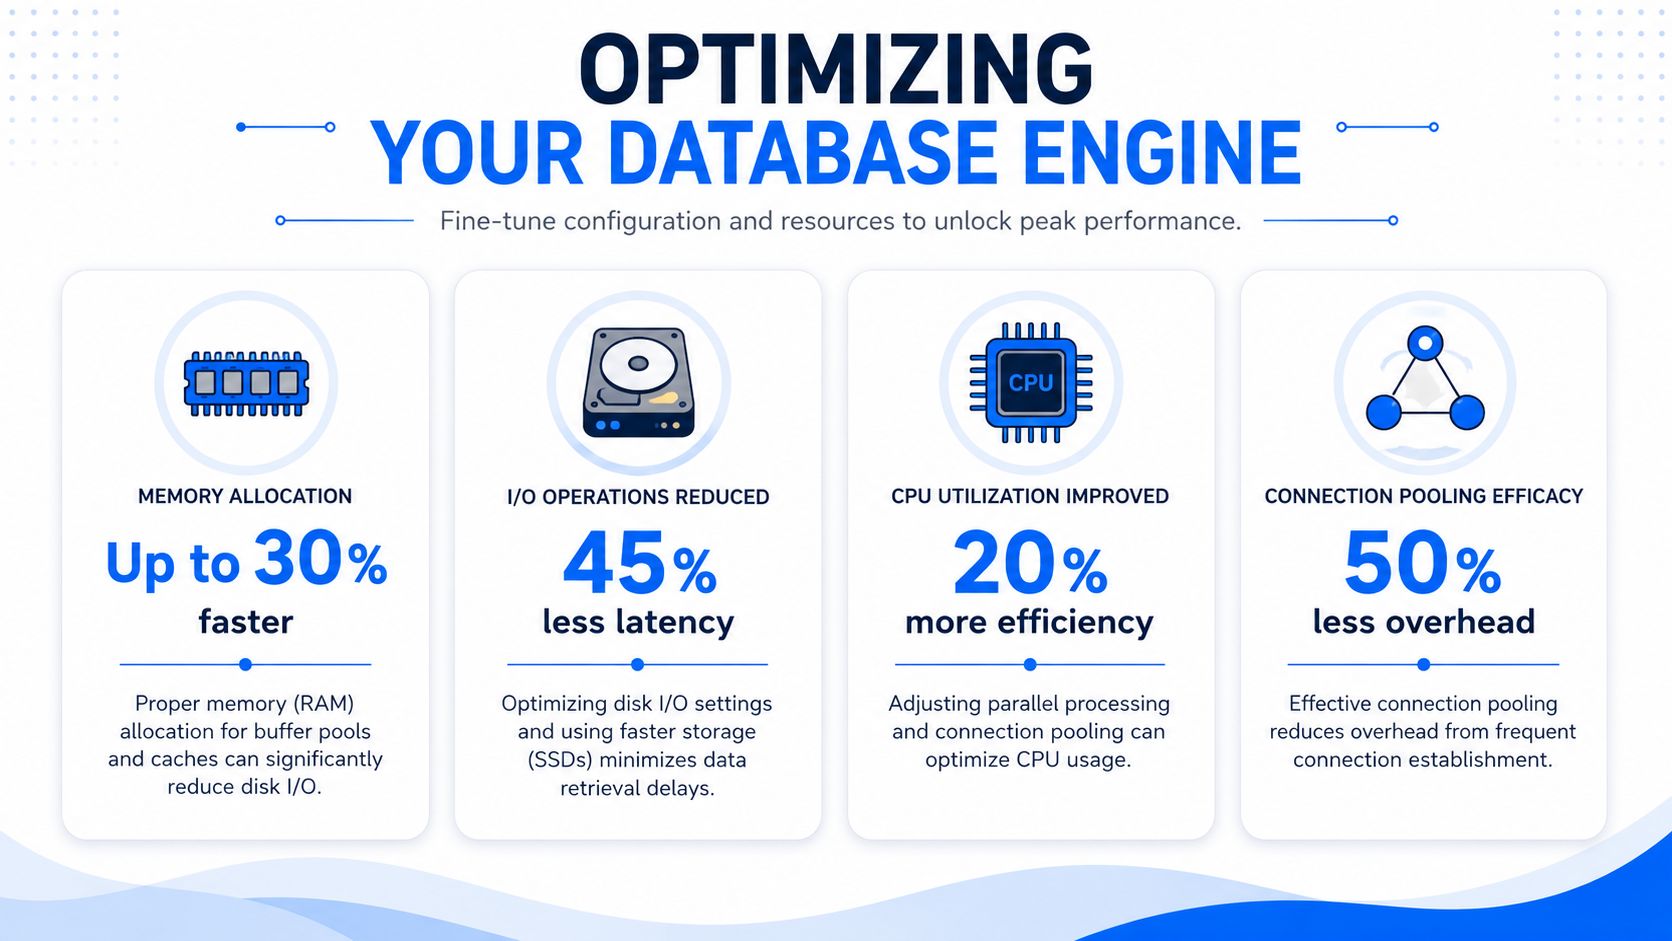
Zuerst der Speicher. Prüfen Sie, ob der Buffer Pool bzw. die Shared Buffers den Working Set aufnehmen können, ohne dem restlichen Host Ressourcen zu entziehen.
Danach das Verbindungsverhalten. Zu viele aktive Sitzungen können künstliche Konkurrenz und Druck auf den Scheduler erzeugen.
Anschließend der I/O-Pfad. Achten Sie auf Muster bei temporären Spills, die Warteschlangentiefe oder eine ungünstige Platzierung kritischer Dateien.
Erst dann tiefere Regler anpassen. Parallelität, Worker-Einstellungen und fortgeschrittenes Engine-Verhalten erfordern stärkere Belege.
Plattformspezifische Prüfungen, auf die es ankommt
Die Details der Engines unterscheiden sich, doch einige Prüfungen sind zu wichtig, um sie auszulassen.
Zusammenspiel von Oracle und Betriebssystem
Eine wichtige, seit Langem bekannte Regel von Oracle gilt nach wie vor: Übersteigt die Kernel-Auslastung des Betriebssystems 40 %, ist die wahrscheinliche Ursache eine Konkurrenz auf Betriebssystemebene wie Paging, Swapping, Overhead bei der Netzwerkübertragung oder Prozess-Thrashing und nicht nur fehlerhaftes SQL, wie in Oracles Leitfaden zum Performance-Tuning dokumentiert. Wenn dieser Schwellenwert erreicht wird, hören Sie auf, so zu tun, als sei das Problem auf eine einzelne Abfrage beschränkt.
SQL Server und tempdb
Wenn tempdb ungünstig platziert oder für den Workload zu klein dimensioniert ist, wird der Rest der Tuning-Diskussion schnell unübersichtlich. Spills, Versionierungsdruck und parallele temporäre Aktivitäten lassen Symptome einer „langsamen Abfrage“ schlimmer erscheinen, als sie sind.
PostgreSQL und Wartungsverhalten
Beobachten Sie Checkpoints und Autovacuum genau. Gerät Autovacuum in Rückstand, kann Tabellen-Bloat gewöhnliche Lesevorgänge in teures I/O verwandeln. Passen die Checkpoint-Einstellungen nicht zum Schreibmuster, wird die Latenz sprunghaft.
Teradata und Workload-Klassen
Bei Teradata können Systemdurchschnitte Probleme verbergen. Aufschlussreich ist das Verhalten auf Workload-Ebene, die Warteschlangen und wie viel eine einzelne Aktivitätsklasse in kritischen Zeitfenstern verbraucht.
Beim Engine-Tuning kommt es am meisten auf Disziplin an. Eine Änderung, ein Messzyklus, ein Rollback-Pfad.
Ohne diese Strenge wird Datenbank-Performance-Tuning zum Aberglauben. Sie wissen dann nicht, ob die Speicheränderung geholfen hat, ob die Pool-Änderung der Parallelität geschadet hat oder ob eine Storage-Korrektur ein Planproblem eine Woche lang verdeckt hat.
Vom reaktiven Tuning zur kontinuierlichen Observability
Einmalige Tuning-Sitzungen sind weiterhin notwendig. Sie reichen nur nicht mehr aus.
Der Grund ist einfach: Ihre Datenplattform verändert sich weiter, nachdem die Tuning-Sitzung beendet ist. Tabellen wachsen. Vorgelagerte Jobs treffen verspätet ein. Schemas driften. Datensatzverteilungen verschieben sich. Eine Baseline, die in einer sauberen Phase erfasst wurde, bildet die Realität der Produktion nach und nach nicht mehr ab.
Statische Baselines veralten
Wenn Sie die Performance erst wieder betrachten, wenn sich Nutzer beschweren, sind Sie immer in der Defensive. Bis dahin hat sich das Problem bereits in veraltete Berichte, defekte Dashboards, verzögerte Analysen oder unzuverlässige KI-Features fortgepflanzt.
Kontinuierliche Observability schließt diese Lücke. Der entscheidende Wandel besteht darin, nicht nur Engine-Metriken zu beobachten, sondern auch die Datenbedingungen, die Performance-Annahmen ungültig machen:
Volumenanomalien, die Zugriffsmuster verändern
Schemaänderungen wie hinzugefügte Spalten, entfernte Felder oder Typänderungen
Timeliness-Drift, wenn erwartete Daten verspätet oder gar nicht eintreffen
Qualitätsprobleme auf Datensatzebene wie Duplikate, Null-Anomalien und fehlerhafte Beziehungen
KI kann hier helfen, wenn sie für die Anomalieerkennung eingesetzt wird und nicht für blindes Umschreiben von Abfragen. KI-gestützte Anomalieerkennung kann den Aufwand für die manuelle Pflege von Regeln um bis zu 90 % senken, wenn unüberwachte Methoden das normale Verhalten erlernen und adaptive Schwellenwerte automatisch festlegen, so die Beschreibung der Enterprise-Datenplattform von digna. Das ist wichtig, weil manuell gepflegte Schwellenwerte in dynamischen Warehouses schlecht altern.
Was kontinuierliche Observability verändert
Der architektonische Baustein, der dies praxistauglich macht, ist die In-Database-Analyse. Die In-Database-Metrikberechnung eliminiert Kosten für Datenbewegung, indem die Prüfung direkt in den Quelldatenbanken ausgeführt wird. Das ermöglicht Echtzeit-Monitoring und Baseline-Learning, während die Kundendaten privat in der eigenen Umgebung verbleiben, wie in dieser Übersicht zur In-Database-Workload-Analyse beschrieben.
Dieses Modell ist besonders nützlich in Private-Cloud- und On-Premises-Umgebungen, in denen Teams Transparenz benötigen, ohne sensible Produktionsdaten zu exportieren. Es passt auch zur Arbeitsweise von Data Engineers. Wenn Observability nah an den Workload-Tabellen von Teradata, den Systemstatistiken von PostgreSQL oder der im Warehouse hinterlegten Validierungslogik laufen kann, können Sie Drift abfangen, bevor sie zu einem Vorfall wird, den Nutzer bemerken.
Ein stärkeres Betriebsmodell kombiniert:
Abfrage- und Engine-Telemetrie,
Schema-Tracking,
Aktualitäts-Monitoring,
Anomalieerkennung für die Datengestalt,
und Validierung auf Datensatzebene, verknüpft mit Geschäftsregeln.
Wenn Sie eine umfassendere Einführung in dieses Betriebsmodell suchen, ist diese Übersicht zu Data Observability in der Praxis ein guter Ausgangspunkt.
Datenbank-Performance-Tuning funktioniert am besten, wenn es sich von einer Rettungsaktion zu einem kontinuierlichen Regelkreis entwickelt. So schützen Sie nicht nur die Abfragelatenz, sondern auch das Vertrauen in die Ergebnisse, die Ihre Datenbank liefert.
Wenn Ihr Team Datenbank-Performance mit Data Drift, Schemaänderungen, Timeliness und Validierung auf Datensatzebene in einem Betriebsmodell verbinden möchte, ist digna genau dafür gebaut. digna führt Analysen innerhalb Ihrer Umgebung aus, hilft, Anomalien aufzudecken, bevor sie zu veralteten Berichten oder unzuverlässigen KI-Eingaben werden, und gibt Engineers die Möglichkeit, Performance-Baselines auch bei sich ändernden Daten verlässlich zu halten.
Um die Datenbedingungen zu beobachten, die eine Tuning-Baseline unbemerkt ungültig machen – etwa Volumenverschiebungen, Schemaänderungen und verspätete Loads –, sehen Sie sich an, wie digna Data Platform Observability direkt in Ihrer eigenen Datenbank umsetzt.
Häufig gestellte Fragen
Was führt dazu, dass sich die Datenbank-Performance mit der Zeit verschlechtert?
Oft sind es die Daten, nicht das SQL. Die im Artikel zitierte Analyse von Last9 führt 68 % der Performance-Verschlechterungen von Datenbanken in den Jahren 2024–2025 auf vorgelagerte Datenqualitätsprobleme zurück, die Zugriffsmuster verändern – etwa sich verschiebende Zeilenzahlen, schiefe Verteilungen, neue Null-Muster oder unbemerkte Schema-Updates, die eine alte Baseline obsolet machen.
Was sollte eine Baseline für die Datenbank-Performance enthalten?
Eine nützliche Baseline erfasst Latenz, Durchsatz, CPU und Speicher, I/O und Wait Events sowie Fehler und Wiederholungen, gemessen sowohl in gesunden als auch in ungesunden Phasen. Sie sollte vier Fragen beantworten: Was war langsam, wo lag der Druck, wann hat es sich geändert und hat das Unternehmen es durch verzögerte Dashboards oder verletzte SLAs bemerkt?
Wie entscheide ich, welche langsamen Abfragen ich zuerst optimiere?
Priorisieren Sie Hotspots nach Wirkung, nicht danach, welche Abfrage am hässlichsten aussieht oder zuerst einen Alarm ausgelöst hat. Berücksichtigen Sie Häufigkeit, Reichweite, Ressourcentyp und Zeitpunkt: Eine kleine Ineffizienz, die den ganzen Tag ausgeführt wird, kann die Gesamtlast dominieren, und ein Job, der mit dem morgendlichen Reporting kollidiert, kann wichtiger sein als eine langsamere nächtliche Aufgabe. Query Store und pg_stat_statements helfen dabei.
Ist es sicher, SQL-Abfragen mit KI umzuschreiben?
Nur mit sorgfältiger Prüfung. Eine im Artikel zitierte Branchenumfrage aus dem Jahr 2025 ergab, dass 44 % der KI-generierten Abfrageoptimierungen in Finanz- und Gesundheitsdatensätzen subtile Fehler einführten, meist bei der Behandlung von Nullwerten und Datumsbereichen. Behandeln Sie Vorschläge wie den Entwurf eines Juniors: Prüfen Sie den Plan, vergleichen Sie Ergebnismengen und testen Sie Grenzfälle.
Wie sollten Änderungen an der Datenbankkonfiguration getestet werden?
Ändern Sie jeweils nur einen Parameter, erfassen Sie Metriken vorher und nachher und halten Sie einen Rollback-Pfad bereit – gemäß der schrittweisen Methode von Oracle. Gehen Sie in dieser Reihenfolge vor: zuerst Speicher, dann Verbindungsverhalten, dann der I/O-Pfad und erst danach Parallelität oder Worker-Einstellungen. Oracle wertet zudem eine Kernel-Auslastung des Betriebssystems von über 40 % als Zeichen für Konkurrenz auf Betriebssystemebene.


