Datenplausibilität: Wie Sie Daten erkennen, die falsch aussehen, aber Ihre Regeln bestehen
|
8
min. Lesezeit

Daten können jede Validierungsregel bestehen und dennoch unplausibel sein.
Das ist die betriebliche Lücke hinter vielen fehlerhaften Dashboards, irreführenden Berichten und unzuverlässigen KI-Eingaben. Die traditionelle Data Validation prüft explizit definierte Bedingungen wie Datentypen, Pflichtfelder, zulässige Werte und maximale Schwellenwerte. Datenplausibilität stellt eine andere Frage: Verhält sich die Datenebene im geschäftlichen Kontext wie erwartet?
Eine Transaktion kann eine gültige Währung, einen gültigen Zeitstempel und einen Betrag unter dem konfigurierten Limit enthalten und dennoch ein schwerwiegendes Datenproblem darstellen. Eine verspätete Datei kann vollständig sein, wenn sie schließlich eintrifft, aber unbrauchbar für eine Entscheidung, die bereits früher davon abhing. Ein Schema kann technisch lesbar bleiben, während eine subtile strukturelle Änderung die Bedeutung nachgelagerter Metriken verändert.
Das finanzielle Risiko ist beträchtlich. Der weithin zitierte Benchmark besagt, dass schlechte Datenqualität Unternehmen im Durchschnitt ca. 12,9 Millionen US-Dollar pro Jahr kostet, während IBM im Jahr 2026 berichtete, dass mehr als ein Viertel der Unternehmen jährlich über 5 Millionen US-Dollar verlieren und 7 % sogar 25 Millionen US-Dollar oder mehr verlieren, weil die Datenqualität unzureichend ist. IBM berichtete auch, dass 43 % der Chief Operations Officers die Datenqualität als ihre wichtigste Datenpriorität identifizierten, was zeigt, dass dies ein betriebliches Risiko und nicht bloß eine Unannehmlichkeit für die Analytik ist. Siehe die IBM-Analyse zu den Kosten schlechter Datenqualität für den breiteren geschäftlichen Kontext.
Inhaltsverzeichnis
Wenn valide Daten falsch aussehen
Was Daten unplausibel macht
Plausibilität ist mehrdimensional
Warum regelbasierte Validierung zu kurz greift
Wo explizite Regeln funktionieren
Wo Regeln teuer werden
Wie Organisationen unplausible Daten erkennen
Erwartete Bereiche
Historische Baselines
Statistische Verteilungen
Trends und Peer-Vergleiche
Validierung vs. Plausibilität vs. Anomalieerkennung
Wie digna Datenplausibilität unterstützt
Kontinuierliche Überwachung unplausibler Daten
Wenn valide Daten falsch aussehen
Regeln sind nützlich, weil sie bekannte Erwartungen in wiederholbare Prüfungen verwandeln. Sie erfassen Nullwerte, fehlerhafte Bezeichner, ungültige Daten, doppelte Schlüssel und Werte außerhalb eines genehmigten Bereichs. Aber sie erfassen nur das, was bereits zuvor beschrieben wurde.
Die Plausibilitätsüberwachung schließt die Lücke zwischen technischer Gültigkeit und kontextueller Eignung. Ein Wert kann eine Regel erfüllen, während er dem historischen Verhalten, der Verteilung, dem Timing oder den Beziehungen widerspricht, die den Datensatz nützlich machen. Deshalb bedeutet ein fehlerfreier Validierungsbericht nicht zwangsläufig, dass die Daten für Finanzen, Betrieb, aufsichtsrechtliche Berichterstattung oder maschinelles Lernen sicher sind.
Eine praktische Unterscheidung hilft:
Gültigkeit: Der Datensatz entspricht einer expliziten strukturellen oder geschäftlichen Regel.
Qualität: Der Datensatz ist genau, vollständig, konsistent, zeitnah, eindeutig und für den vorgesehenen Verwendungszweck geeignet.
Plausibilität: Der Wert oder das Verhalten ist im Kontext sinnvoll.
Anomalieerkennung: Die aktuelle Beobachtung weicht wesentlich vom gelernten oder erwarteten Verhalten ab.
Der Unterschied zwischen Datengültigkeit und allgemeiner Datenqualität ist wichtig, da Teams eine bestandene Regel oft als Beweis dafür werten, dass keine weitere Untersuchung erforderlich ist. In der Produktion scheitert diese Annahme, wenn das Problem eine schleichende Drift, ein verspätetes Eintreffen, eine Änderung der Verteilung oder ein multivariates Muster ist, das keine einzelne Regel auf Feldebene ausdrücken kann.
Praktische Regel: Eine bestandene Validierungsregel bedeutet „diese bekannte Bedingung wurde nicht verletzt“. Es bedeutet nicht „es ist nichts Ungewöhnliches passiert“.
Die Plausibilität ist daher kein Ersatz für die Validierung. Sie ist eine zweite Ebene, die Verhalten, Kontext und Veränderungen testet. Die traditionelle Validierung prüft, wonach Sie bereits wissen, dass Sie suchen müssen. Die Plausibilitätsüberwachung kann Verhaltensweisen aufdecken, mit denen Sie nicht gerechnet haben.
Was Daten unplausibel macht
Unplausible Daten sind Daten, die technisch akzeptabel erscheinen, aber im Widerspruch zu den Mustern, Beziehungen, dem Timing oder dem geschäftlichen Kontext stehen, die für ihre Verwendung erwartet werden. Das Wort „unplausibel“ bedeutet nicht „falsch“. Es bedeutet, dass die Beobachtung Aufmerksamkeit verdient, weil ihr Verhalten mit dem verfügbaren Kontext schwer zu erklären ist.
Betrachten Sie einen Transaktionsbetrag innerhalb eines zulässigen Bereichs, der jedoch drastisch über der normalen Aktivität des Kunden liegt. Eine Regel akzeptiert vielleicht jeden Wert von 0 € bis 1 Million €, während das etablierte Muster des Kunden eine ungewöhnlich große Transaktion untersuchenswert macht. Dasselbe Problem tritt bei der Volumenüberwachung auf. Ein Anstieg der täglichen Bestellungen um 500 % kann eine erfolgreiche Kampagne, ein echtes saisonales Ereignis, eine doppelte Erfassung oder einen fehlerhaften Join widerspiegeln. Die Zahl ist ein Signal, kein Urteil.
Weitere Beispiele sind:
Ein Alter des Kunden, das in einen technisch gültigen menschlichen Bereich fällt, für das Segment jedoch höchst ungewöhnlich ist.
Eine plötzliche Verschiebung einer Produktpreisverteilung, obwohl jeder einzelne Preis innerhalb der zulässigen Grenzen bleibt.
Ein regionaler Umsatzwert, der völlig von historischen Mustern abweicht, obwohl er Typ-, Null- und Bereichsprüfungen besteht.
Eine wiederkehrende verspätete Lieferung, bei der die Tabelle zwar vollständig bleibt, die nachgelagerten Benutzer jedoch Entscheidungen mit veralteten Daten treffen müssen.
Eine Beziehung zwischen Feldern, die sich ändert, sodass sich beispielsweise Mengen und Summen nicht mehr wie in der Vergangenheit gemeinsam bewegen.

Plausibilität ist mehrdimensional
Datenqualitätsteams arbeiten üblicherweise über Dimensionen hinweg, darunter Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Gültigkeit und Eindeutigkeit. Ein Datensatz kann gültig, aber unpünktlich, vollständig, aber inkonsistent oder strukturell korrekt, aber ungenau sein. Die Plausibilitätsüberwachung hilft, diese Kombinationen aufzudecken, indem sie das Verhalten des Datensatzes untersucht, anstatt Felder isoliert zu prüfen.
Die Anomalieerkennung ist besonders nützlich für die Identifizierung von Ausreißern, aber ein Ausreißer sollte nicht automatisch gelöscht oder abgelehnt werden. Eine Werbeaktion, eine Übernahme, ein Ausfall oder ein Marktereignis kann eine legitime Anomalie erzeugen. Die richtige Reaktion besteht darin, Kontext hinzuzufügen, die Auswirkungen zu bewerten und zu entscheiden, ob die Beobachtung eine echte Änderung oder einen Datenfehler darstellt. Praktische Anleitungen zu Methoden zur Identifizierung von Ausreißern bekräftigen diese Unterscheidung.
Warum regelbasierte Validierung zu kurz greift
Nehmen wir eine gängige Regel:
Der Transaktionsbetrag muss zwischen 0 € und 1 Million € liegen.
Unter dieser Regel bestehen 500 €, 50.000 € und 900.000 € alle die Prüfung. Die Regel tut genau das, wofür sie entwickelt wurde, und das ist wertvoll. Sie verhindert, dass Werte außerhalb des akzeptierten Bereichs in nachgelagerte Prozesse gelangen.
Nehmen wir jedoch an, dass die historischen Transaktionen eines Kunden normalerweise zwischen 50 € und 500 € liegen. Eine Transaktion über 900.000 € kann legitim sein, weicht jedoch so stark vom etablierten Verhalten dieses Kunden ab, dass sie überprüft werden muss. Die statische Regel kann dieses Urteil nicht fällen, da sie keine Darstellung der kundenspezifischen Historie besitzt.
Wo explizite Regeln funktionieren
Die regelbasierte Validierung bleibt das richtige Werkzeug, wenn die Erwartung bekannt und stabil ist:
Ein erforderlicher Bezeichner darf nicht null sein.
Ein Datum muss ein akzeptiertes Format verwenden.
Ein Status muss zu einer genehmigten Gruppe gehören.
Ein Transaktionsbetrag darf ein vertragliches Limit nicht überschreiten.
Ein Datensatz muss eine dokumentierte Beziehung zwischen Feldern erfüllen.
Diese Prüfungen sind transparent, leicht zu prüfen und nützlich für die Durchsetzung deterministischer Kontrollen. Sie führen auch zu umsetzbaren Fehlermeldungen, wenn die geschäftliche Bedingung explizit ist.
Wo Regeln teuer werden
Probleme entstehen, wenn Teams versuchen, jede erdenkliche geschäftliche Erwartung manuell zu kodieren. Sie fügen Regeln für jede Region, jedes Produkt, jeden Kundentyp, jedes saisonale Muster, jede Ausnahme und jeden Betriebszustand hinzu. Das Ergebnis ist ein wachsender Wartungsaufwand, häufige Änderungen der Schwellenwerte und ein Überwachungssystem, das immer noch Muster übersieht, an deren Definition niemand gedacht hat.
Statistische Ansätze lösen ein anderes Problem. Das ML.TFDV_VALIDATE von BigQuery vergleicht beispielsweise Trainings- und Serving-Statistiken, um anomale Unterschiede zwischen Datensätzen zu identifizieren, was verdeutlicht, dass Validierung und Anomalieerkennung unterschiedliche Kontrollebenen sind. Die Perspektive Datenvalidierungsregeln und kontinuierliche Datenqualität ist hier nützlich: Deterministische Prüfungen setzen bekannte Bedingungen durch, während die statistische Überwachung nach unerwarteten Änderungen sucht.
Ein starkes Produktionsdesign entscheidet sich nicht für einen einzigen Ansatz. Es nutzt die explizite Validierung für bekannte Einschränkungen und die Anomalieerkennung für Verhaltensweisen, die aus der Evidenz gelernt werden müssen.
Wie Organisationen unplausible Daten erkennen
Organisationen bewerten die Plausibilität in der Regel, indem sie verschiedene Formen des erwarteten Verhaltens kombinieren. Da kein einzelner Schwellenwert für jeden Datensatz funktioniert, sollte das Überwachungsdesign die Granularität, Saisonalität, Latenz und geschäftliche Bedeutung jeder Metrik widerspiegeln.
Erwartete Bereiche
Beginnen Sie mit Bereichen, in denen die geschäftliche Erwartung klar ist. Ein Preis, ein Alter, eine Menge oder ein Saldo kann eine vertretbare Unter- und Obergrenze haben. Diese Prüfungen sind einfach und erklärbar, erkennen jedoch keinen ungewöhnlichen Wert, der innerhalb des Bereichs bleibt.
Historische Baselines
Eine Baseline beschreibt normales Verhalten anhand historischer Beobachtungen. Ein praktischer Workflow sammelt repräsentative Baseline-Daten, leitet eine statistische Beschreibung ab und testet neue Daten kontinuierlich dagegen. Ein von der Teststatistik erkannter Änderungspunkt kann dann als Anomalie behandelt werden, wie in diesem Leitfaden zur Baseline-gesteuerten Anomalieerkennung beschrieben.
Baselines sollten segmentiert werden, wenn der Kontext das erwartete Muster verändert. Das tägliche Bestellvolumen erfordert möglicherweise ein separates Verhalten für Wochentage und Wochenenden. Die Kundenausgaben müssen möglicherweise innerhalb von Kundensegmenten verglichen werden und nicht über die gesamte Population hinweg.
Statistische Verteilungen
Mittelwerte allein können wichtige Veränderungen verbergen. Überwachen Sie die Verteilung von Preisen, Mengen, Salden oder kategorischen Werten. Ein stabiler Mittelwert kann mit einer starken Verschiebung der Streuung, einer neuen Konzentration um einen Wert oder dem plötzlichen Verschwinden einer Kategorie einhergehen.
Praktische Detektoren definieren einen akzeptablen Bereich basierend auf normalem Verhalten. Ein üblicher Ausgangspunkt für die Z-Score-Anomalieerkennung ist 3, was unter der Annahme einer Normalverteilung etwa drei Standardabweichungen vom Mittelwert entspricht, wie in Nokias Leitfaden zur Baseline-Erkennung dokumentiert. Dieser Schwellenwert ist ein Ausgangspunkt, keine universelle Produktionseinstellung.
Trends und Peer-Vergleiche
Trendprüfungen identifizieren plötzliche Anstiege, Rückgänge, Umkehrungen oder eine anhaltende Drift. Peer-Vergleiche fügen Kontext hinzu, indem sie ähnliche Regionen, Produkte, Einheiten oder Geschäftsbereiche vergleichen. Eine Region mag global ungewöhnlich aussehen, im Vergleich zu ihren eigenen saisonalen Peers jedoch normal sein.
Schließlich fügen Sie eine regelbasierte Plausibilität hinzu, wenn die geschäftliche Erwartung bekannt, aber kontextbezogener ist als eine einfache Gültigkeitsprüfung. Starke Datenqualitätsprogramme kombinieren erwartete Bereiche, historische Baselines, Verteilungen, Trends, Peer-Vergleiche und deterministische Regeln.
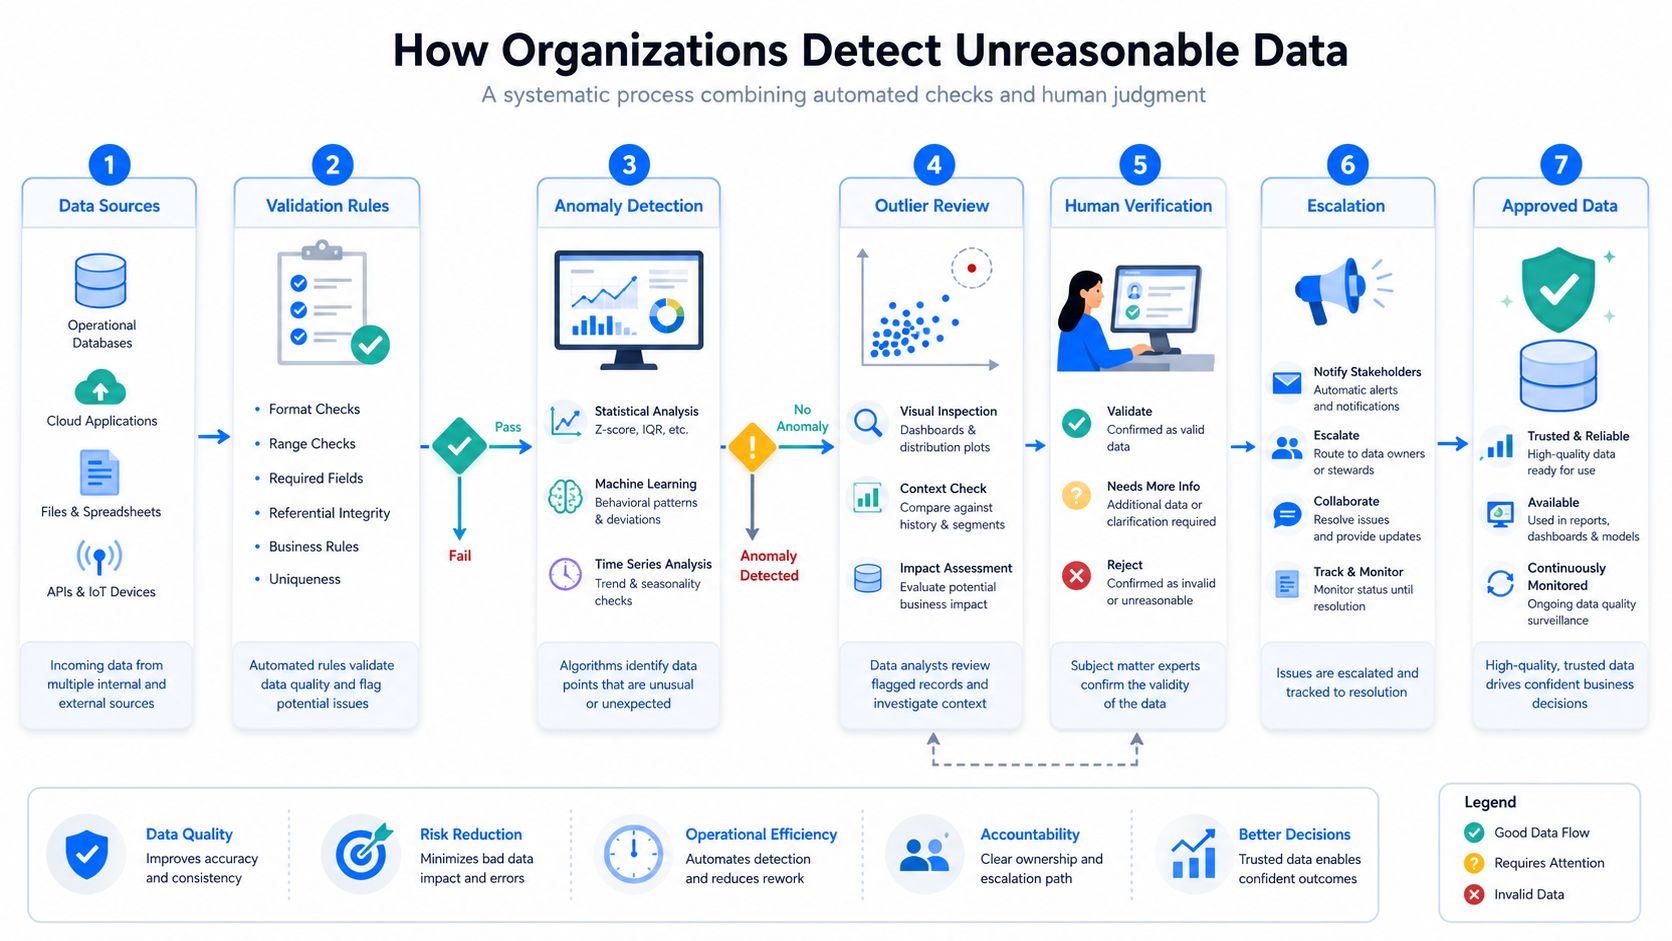
Für allgemeinere Implementierungshinweise bietet die Anomalieerkennung für frühzeitige Datenprobleme einen nützlichen operativen Rahmen. Die wichtigste Designentscheidung besteht darin, Warnungen auf die Konsequenzen abzustimmen. Eine kleine Verschiebung in einer Tabelle mit geringen Auswirkungen kann rein informativ sein, während eine geringfügige Änderung in einem aufsichtsrechtlichen oder finanziellen Datensatz eine sofortige Eskalation erfordern kann.
Validierung vs. Plausibilität vs. Anomalieerkennung
Ein Einzelhandelsunternehmen ist ein klares Beispiel dafür, wie sich die drei Mechanismen unterscheiden. Seine tägliche Umsatztabelle enthält normalerweise rund 2 Millionen Transaktionen. Eines Tages enthält die Tabelle 2,1 Millionen, was eine Volumenregel bestehen kann, da die Tabelle vorhanden, gefüllt und innerhalb eines breiten operativen Limits ist. Dennoch steigt der durchschnittliche Bestellwert um 350 %, was zu einer Verhaltensänderung führt, die eine statische Validierung möglicherweise nie untersucht.
Die Reaktion sollte vielschichtig sein:
Die Validierung prüft die bekannten Einschränkungen. Sie bestätigt, dass Beträge, Daten, Bezeichner und Pflichtfelder definierten Regeln entsprechen.
Die Plausibilität prüft den geschäftlichen Kontext. Sie fragt, ob der Betrag für den Kunden, das Produkt, die Region oder den Vertriebskanal plausibel ist.
Die Anomalieerkennung vergleicht das aktuelle Verhalten mit der Historie. Sie markiert die plötzliche Änderung des durchschnittlichen Bestellwerts und möglicherweise damit verbundene Verschiebungen der Verteilung.
Die historische Analyse liefert Kontext. Das Team prüft Kampagnen, Preisänderungen, Werbeaktionen, das Erfassungsverhalten und Ereignisse im Quellsystem.
Die Untersuchung bestimmt das Ergebnis. Die Anomalie kann eine echte Verkaufsaktivität, doppelte Datensätze, ein Währungsproblem oder einen Transformationsfehler darstellen.
Ansatz | Frage | Beispiel |
|---|---|---|
Validierung | Erfüllt der Wert die Regel? | Betrag ≤ 1 Mio. € |
Plausibilitätsregel | Erfüllt er eine erwartete geschäftliche Bedingung? | Betrag im erwarteten Kundenbereich |
Anomalieerkennung | Ist das Verhalten im Vergleich zur Historie ungewöhnlich? | Anstieg des durchschnittlichen Bestellwerts um 350 % |
Die Unterscheidung ähnelt anderen Disziplinen der Betriebsüberwachung. Teams, die sich mit vorausschauender Wartung mit Forge Reliability befassen, werden dasselbe Prinzip erkennen: Ein System kann innerhalb eines zulässigen Betriebsbereichs bleiben, während sich sein Verhalten so weit verschiebt, dass eine Inspektion gerechtfertigt ist. Auf Datenplattformen bedeutet dies die Überwachung der Entwicklung und der Beziehungen, nicht nur des Status „bestanden“ oder „fehlgeschlagen“.
Aus diesem Grund sollte Data Observability versus Datenqualität nicht als binäre Entscheidung behandelt werden. Die Validierung bietet Kontrolle über bekannte Anforderungen. Plausibilität bietet kontextbezogenes Urteilsvermögen. Die Anomalieerkennung bietet einen adaptiven Vergleich mit dem beobachteten Verhalten.
Wie digna Datenplausibilität unterstützt
digna Data Anomalies adressiert die betriebliche Lücke zwischen manuell erstellten Regeln und verhaltensbasierter Überwachung. Es nutzt KI-gestütztes Baseline-Lernen und kontinuierliche Anomalieerkennung, um Abweichungen vom historischen Verhalten zu identifizieren, ohne dass Teams jede mögliche Bedingung im Voraus definieren müssen.
Das Modul kann unerwartete Volumenänderungen, Verteilungsverschiebungen, ungewöhnliche Metrikwerte, abrupte Änderungen historischer Muster und wiederkehrende Anomalien aufdecken. Das macht es relevant, wenn Daten syntaktisch valide bleiben, sich aber in einer Weise ändern, die sich auf Berichte, betriebliche Entscheidungen oder KI-Eingaben auswirken könnte.
digna Data Analytics hilft Ermittlern, den historischen Kontext hinter einer Warnung zu untersuchen. Teams können historische Observability-Metriken verwenden, um Trends, Volatilität und statistische Muster zu überprüfen, anstatt eine Anomalie als isoliertes Ereignis zu behandeln. digna Data Validation bleibt nützlich, wenn die erwartete Bedingung explizit als Geschäftsregel, Audit-Anforderung oder Kontrolle auf Datensatzebene formuliert werden kann.
Das Implementierungsmodell ist für Unternehmensteams von Bedeutung. digna läuft innerhalb der eigenen Infrastruktur des Kunden, wobei die Metrikberechnung und -analyse in der Datenbank durchgeführt werden, sodass die Produktionsdaten vor Ort bleiben. Die Bereitstellung kann in einer privaten Cloud oder einer On-Premises-Umgebung innerhalb der Cloud, VPC oder des Rechenzentrums des Kunden erfolgen.
Der praktische Nutzen ergibt sich eher aus der Kombination als aus einem einzelnen Modul. Anomalien identifizieren unerwartetes Verhalten, Analytics liefert Kontext, Validation setzt bekannte Bedingungen durch, und die zugehörige Überwachung kann Aktualitäts- oder Schemaänderungen verfolgen, die ansonsten valide Daten für die Nutzung unsicher machen.
Kontinuierliche Überwachung unplausibler Daten
Die kontinuierliche Überwachung beginnt mit der Priorisierung, nicht mit dem Versuch, jede Spalte gleichermaßen zu überwachen. Identifizieren Sie Datensätze, deren unplausibles Verhalten sich auf die Finanzberichterstattung, Kundenentscheidungen, die betriebliche Steuerung, die regulatorische Arbeit oder KI-Systeme auswirken könnte. Definieren Sie dann das beobachtenswerte Verhalten, wie z. B. Volumen, Ankunftszeit, Verteilungen, Beziehungen und Geschäftsmetriken.
Ein nützliches Betriebsmodell besteht aus vier Teilen:
Baseline: Lernen Sie normales Verhalten aus repräsentativen historischen Daten.
Erkennung: Vergleichen Sie neue Beobachtungen mit erwarteten Mustern und markieren Sie signifikante Abweichungen.
Kontext: Zeigen Sie den historischen Trend, die betroffenen Dimensionen und zugehörige Metriken an.
Aktion: Leiten Sie die Warnung an einen Verantwortlichen weiter, der das Ergebnis untersuchen, klassifizieren und dokumentieren kann.
Automatisierung ist unerlässlich, da eine manuelle Überprüfung nicht skalierbar ist. In einer aufsichtsrechtlichen Präsentation zu Data Governance wurde berichtet, dass 42 % der weltweiten Befragten den Mangel an Fähigkeiten und Personal als das größte Hindernis für qualitativ hochwertige Daten nannten. Diese Einschränkung macht eine kontextsensitive Überwachung praktischer, als ohnehin überlastete Teams mit der Erstellung und Pflege von Regeln für jedes erdenkliche Szenario zu beauftragen. Dasselbe Prinzip gilt für betriebliche Feeds, bei denen es auf Aktualität ankommt, einschließlich zuverlässiger Methoden zur Bereitstellung von E-Sport-Daten, da eine vollständige Datennutzlast, die zu spät eintrifft, ihren geschäftlichen Zweck dennoch verfehlen kann.
Eine Anomalie bedeutet nicht, dass die Daten falsch sind. Sie bedeutet, dass die aktuelle Beobachtung vom erwarteten Verhalten abweicht und klassifiziert werden muss. Teams sollten aufzeichnen, ob die Ursache ein legitimes geschäftliches Ereignis, eine Änderung des Quellsystems, ein Pipeline-Fehler, eine doppelte Last, eine verspätete Lieferung oder ein zu empfindlicher Schwellenwert war.
Die besten Warnsysteme messen auch die Qualität der Warnmeldungen. Unterdrücken Sie bekannte Ereignisse, wenn dies angemessen ist, segmentieren Sie Baselines nach aussagekräftigem Kontext und priorisieren Sie Vorfälle nach dem nachgelagerten Schaden und nicht danach, wie oft eine Regel fehlschlägt. Dies reduziert das Rauschen und schont die Aufmerksamkeit für Änderungen, die zu Fehlentscheidungen führen können.
Für Organisationen, die Daten für KI vorbereiten, ist die Bereitschaftslücke erheblich. Precisely berichtete, dass nur 12 % der Organisationen ihre Daten als ausreichend hochwertig und für KI zugänglich erachteten, während 64 % die Datenqualität als ihre größte Herausforderung für die Datenintegrität nannten und 49 % unzureichende Automatisierungswerkzeuge als Haupthindernis anführten. Diese Ergebnisse stützen ein klares Betriebsprinzip: Die Datenqualitätsüberwachung muss nicht nur prüfen, ob Daten gültig sind, sondern auch, ob sie für die Entscheidung, die sie nutzt, vertrauenswürdig bleiben.
digna kombiniert Data Anomalies, Data Analytics, Data Validation, Aktualitätsüberwachung und Schema-Tracking, um Daten zu erkennen, die statische Regeln bestehen, sich aber unerwartet verhalten. Besuchen Sie digna, um zu sehen, wie die In-Database-Plattform Ihrem Team helfen kann, unplausible Daten kontinuierlich zu überwachen und Anomalien zu untersuchen, bevor sie die Analytik oder KI beeinträchtigen.
Häufig gestellte Fragen
Wie unterscheiden sich Validität, Qualität, Plausibilität und Anomalieerkennung?
Als vier getrennte Tests. Validität fragt, ob der Datensatz einer expliziten Regel entspricht; Qualität, ob er genau, vollständig, konsistent, rechtzeitig, eindeutig und nutzbar ist; Plausibilität, ob der Wert im Kontext Sinn ergibt; Anomalieerkennung, ob die aktuelle Beobachtung materiell vom gelernten Verhalten abweicht.
Warum beendet eine bestandene Regel die Untersuchung zu früh?
Weil Teams sie als Beleg werten, dass nichts weiter nötig sei. Eine Transaktion kann eine gültige Währung, einen gültigen Zeitstempel und einen Betrag unter der konfigurierten Grenze enthalten und dennoch ein ernstes Datenproblem darstellen, und jede dieser Prüfungen meldet Erfolg.
Wie groß ist die finanzielle Exposition?
Der vielzitierte Maßstab liegt bei durchschnittlich rund 12,9 Millionen USD pro Jahr, und IBM berichtete 2026, dass mehr als ein Viertel der Organisationen jährlich über 5 Millionen USD verliert, während 7 % wegen mangelhafter Datenqualität 25 Millionen USD oder mehr verlieren.
Welche Lücke deckt Plausibilitätsmonitoring ab?
Die zwischen technischer Validität und kontextueller Eignung. Regeln verwandeln bekannte Erwartungen in wiederholbare Prüfungen, was nützlich und zugleich begrenzt ist, denn sie können nur jene Fehler kodieren, die jemand bereits beschreiben konnte.
Wo richten unplausible Werte den größten Schaden an?
In Dashboards, Berichten und KI-Eingaben, denn alle drei konsumieren Datensätze, die die Validierung bestanden haben. Der Fehler ist bauartbedingt leise: Nichts brach ab, also veranlasste nichts jemanden zum Hinsehen, bis eine nachgelagerte Zahl keinen Sinn mehr ergab.



