Was ist Data Drift und wie lässt er sich verhindern?
|
5
min. Lesezeit

Sie haben ein Dashboard, das am Montag noch gut aussah, ein Modell, das letzte Woche die Validierung bestanden hat, und einen Stakeholder, der fragt, warum sich die Zahlen heute „falsch“ anfühlen. So kündigt sich Data Drift meistens an: durch eine fehlerhafte Prognose, eine seltsame Empfehlung oder einen Bericht, der nicht mehr mit dem übereinstimmt, was die Teams vor Ort sehen.
Das Ärgerliche daran ist, dass im offensichtlichen Sinne nichts „kaputtgehen“ muss. Die Pipeline kann weiterlaufen, die Tabellen können sich weiter füllen und das Modell kann immer noch selbstbewusste Antworten liefern. Das Kernproblem ist, dass sich die Welt weiterbewegt hat, während Ihr Datenstack an einer älteren Version verankert blieb.
Wenn gute Modelle schlecht werden: Die stille Bedrohung durch Data Drift
Ein Modell, das im Test perfekt funktionierte, kann in der Produktion plötzlich bizarre Entscheidungen treffen, und das erste Anzeichen ist oft keine rote Fehlermeldung. Es ist ein Vertriebsteam, das ein Dashboard infrage stellt, ein Finanzteam, das abweichende Zahlen abgleicht, oder ein Betriebsleiter, der fragt, warum dieselbe Eingabe jetzt zu einer anderen Entscheidung führt. In dieser Kluft zwischen „gestern funktionierte es noch“ und „macht heute keinen Sinn mehr“ lebt Data Drift.
In der Praxis bedeutet Data Drift, dass sich die statistischen Eigenschaften der Eingabedaten im Laufe der Zeit ändern, sodass die Trainingsverteilung nicht mehr mit den Live-Bedingungen übereinstimmt. Diese Diskrepanz kann sich in BI-Ebenen, Berichtsflüsse und automatisierte Entscheidungen einschleichen, nicht nur in Machine-Learning-Ergebnisse. In Spanien ist dies immer schwerer zu ignorieren, da der DESI 2022-Bericht der Europäischen Kommission feststellte, dass 75 % der Unternehmen bereits mindestens ein grundlegendes Niveau an digitaler Intensität aufwiesen, was über dem EU-Durchschnitt von 69 % liegt (DESI 2022-Kontext für Spanien).
Deshalb ist das Problem nicht nur die Modellqualität. Es ist die Kontinuität. Wenn der Großteil eines Unternehmens bereits auf Daten basiert, kann sich eine kleine Verschiebung bei Transaktionen, dem Kundenverhalten oder Schema-Mustern schnell im restlichen Stack ausbreiten. Das Risiko zeigt sich zuerst als Verwirrung, dann als Fehlentscheidungen und schließlich darin, dass die Menschen das Vertrauen in die Zahlen verlieren.
Halten Sie das Modell mit Datenqualitätsprüfungen ehrlich
Praktische Regel: Wenn Stakeholder fragen „Warum sieht das falsch aus?“, noch bevor sie fragen „Wie genau ist das Modell?“, haben Sie es bereits mit einem Observability-Problem zu tun, nicht mit einem Modellierungsproblem.
Das Schiff-des-Theseus-Problem für Ihre Daten
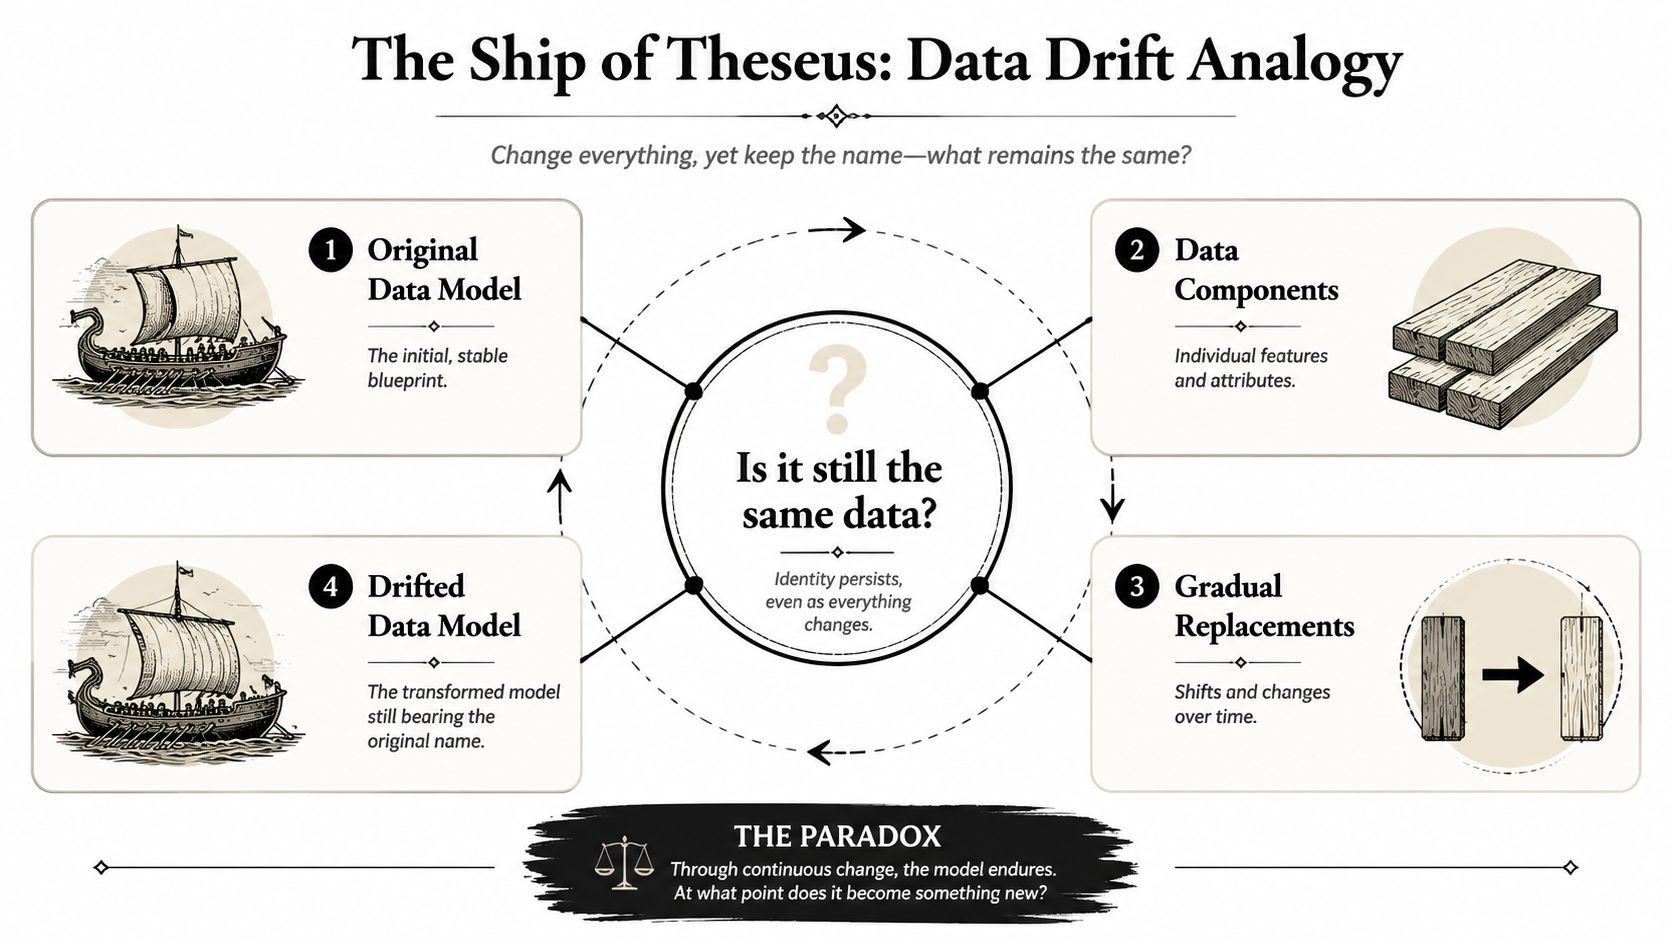
Data Drift passt gut zum Paradoxon vom Schiff des Theseus. Eine Pipeline kann denselben Namen, dieselben Tabellen und sogar denselben Dashboard-Titel behalten, während ihre Inhalte langsam nicht mehr zu den Daten passen, auf denen sie aufgebaut wurde. Ein Feature kommt plötzlich mit anderen Werten an, ein anderes verspätet sich, eine Quelle verwendet ein Kategorie-Label für etwas leicht anderes wieder, und der Live-Datensatz wird zu einem anderen Objekt, obwohl niemand ihn umbenannt hat.
Das macht Drift in der Produktion so schwer zu erkennen. Er tritt meist nicht als einzelner, offensichtlicher Fehler auf. Er schleicht sich als kleine Ersetzungen ein, die für sich genommen harmlos wirken, dann aber die Gesamtverteilung so weit verschieben, dass sich das Verhalten von Berichten, Warnmeldungen und Modellen ändert. In der Praxis benötigen Teams Drift-Überwachung und Verteilungsvergleiche, denn das Warten auf einen sichtbaren geschäftlichen Ausfall bedeutet, dass sich die Diskrepanz bereits im gesamten Stack ausgebreitet hat.
Langsamer Drift und plötzliche Verschiebung sind nicht dasselbe
Langsamer Drift fühlt sich an wie das Beobachten einer sich durch die Gezeiten verändernden Küstenlinie. Die Veränderung ist da, aber man bemerkt sie erst, wenn man die heutigen Daten mit dem Referenzdatensatz des letzten Monats vergleicht. Eine plötzliche Verschiebung fühlt sich eher wie eine Straßensperrung nach einem Sturm an. Die Route von gestern existiert zwar noch im Gedächtnis, funktioniert aber im Live-Betrieb nicht mehr.
Langsamer Drift zeigt sich meist im Kundenmix, in Transaktionsmustern und im saisonalen Verhalten. Plötzliche Verschiebungen resultieren meist aus einem Release, einer regulatorischen Änderung oder einem Update des Quellsystems. Der Fehler besteht darin, beide Fälle als ein einziges Genauigkeitsproblem zu behandeln und zu hoffen, dass ein erneutes Training alles auf einmal repariert.
In einer europäischen Berichtsstruktur ist dieser Unterschied auch außerhalb des Modells selbst von Bedeutung. Eine langsame Änderung in einem Umsatzfeed kann Finanz-Dashboards wochenlang verzerren, bevor es jemand bemerkt. Eine plötzliche Schemaänderung kann Compliance-Berichte beschädigen, Auditoren frustrieren und Teams dazu bringen, im BI-Layer nach einem falschen Fehler zu suchen, während das Quellsystem sich weiter verändert. Dieselbe Pipeline kann auf dem Papier gesund aussehen und dennoch an den Stellen falsch sein, an denen geschäftliche Entscheidungen getroffen werden.
Strukturelle Änderungen können Ihre Pipeline beschädigen
Ein stabiles Label auf instabilen Daten ist einer der schnellsten Wege, um Vertrauen zu verlieren.
Die üblichen Verdächtigen hinter einer Data-Drift-Katastrophe
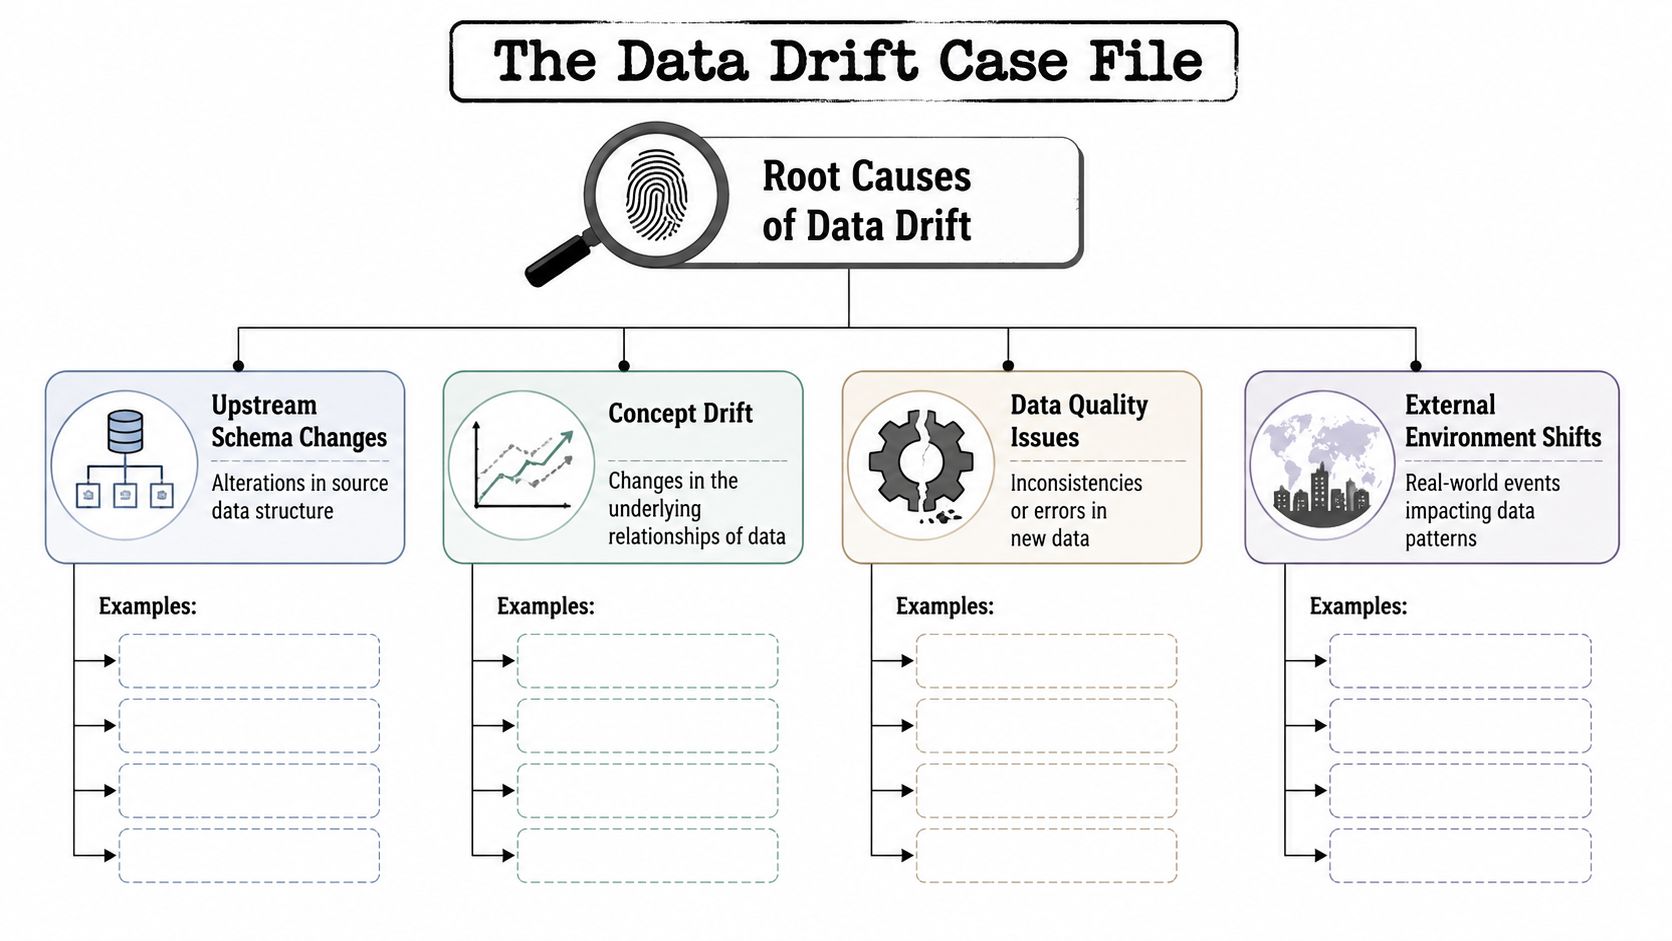
Der schnellste Weg, Drift zu diagnostizieren, besteht darin, sich anzusehen, wo Veränderungen normalerweise in das System gelangen. In spanischen Unternehmen ist dies noch wichtiger als in einer sauberen Demo-Umgebung, da das staatliche Statistikamt 2024 berichtete, dass 78,7 % der Großunternehmen Cloud-Computing-Dienste nutzen. Das bedeutet mehr bewegliche Teile, mehr Abhängigkeiten und mehr Orte, an denen sich das Verhalten ändern kann (Cloud-Nutzung und Drift-Risiko in Spanien). Ein komplexer Stack verursacht Drift nicht von selbst, bietet ihm aber mehr Einfallstore.
Vier Orte, an denen Drift meistens beginnt
Vorgelagerte Schemaänderungen: Eine Spalte wird umbenannt, ein Typ ändert sich oder ein Feld verschwindet. Dashboards stimmen nicht mehr überein, Feature-Pipelines interpretieren Werte falsch und Berichte driften von der Realität der Quelle ab.
Concept Drift: Die Beziehung zwischen Eingaben und Ergebnissen ändert sich. Ein Muster, das früher eine bestimmte Bedeutung hatte, bedeutet nicht mehr dasselbe.
Datenqualitätsprobleme: Fehlende Werte, duplizierte Datensätze, verzögerte Ladevorgänge und fehlerhafte Einträge verzerren sowohl Analysen als auch Modelleingaben auf subtile Weise.
Verschiebungen im externen Umfeld: Marktverhalten, regulatorische Änderungen und betriebliche Störungen verändern den Rhythmus der Daten ohne Vorwarnung.
Diese Ursachen schmerzen deshalb so sehr, weil sie sich nicht nur auf die Modellgenauigkeit auswirken. Sie können gesetzliche Berichte unbrauchbar machen, die Aktualität der Business Intelligence (BI) verzerren und kundenorientierte Analysen autoritär aussehen lassen, obwohl sie veraltet sind. In stark cloudbasierten Umgebungen verteilt sich diese Fragilität über mehr Dienste, Zeitpläne und Datenfeeds, sodass Teams in Abhängigkeitsketten denken müssen, nicht nur in Tabellen.
Eine nützliche Angewohnheit ist es, jede fehlerhafte Metrik bis zum ersten System zurückzuverfolgen, das sich geändert hat, und nicht bis zum letzten, das ausgefallen ist. Dort liegt meistens die eigentliche Ursache.
Ihr Werkzeugkasten zur Data-Drift-Erkennung
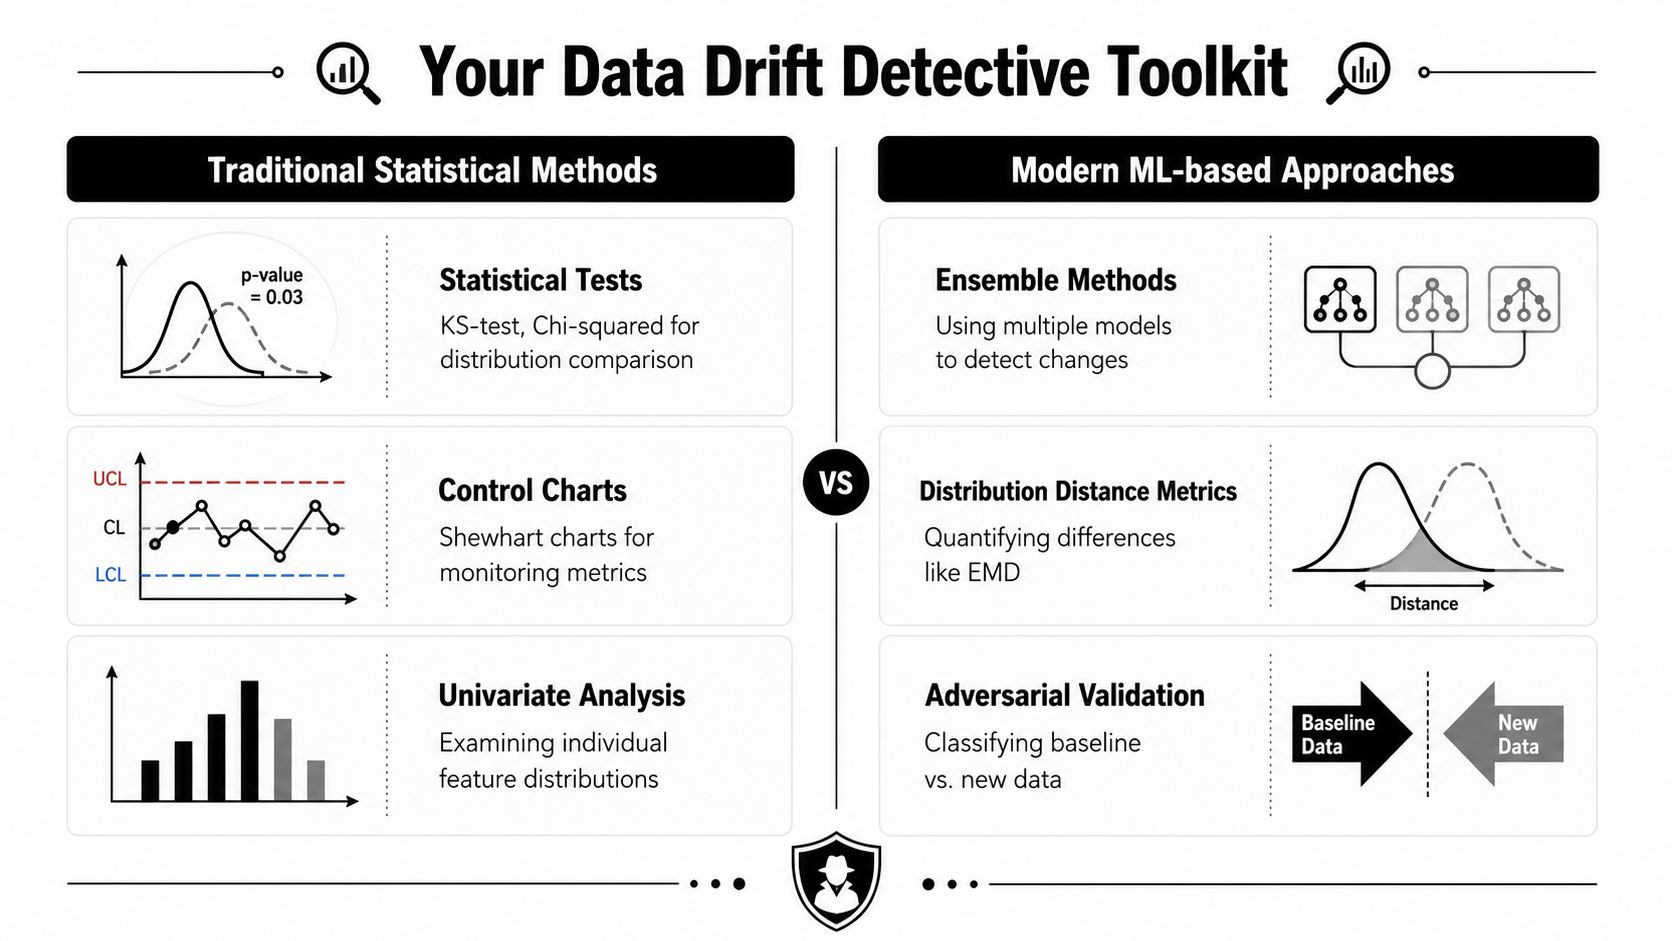
Ein Drift-Detektor erledigt eine Aufgabe besonders gut. Er beantwortet die Frage, ob die Live-Daten noch mit der Baseline übereinstimmen, und zwar bevor ein veralteter Feed zu einem fehlerhaften Dashboard, einem irreführenden Bericht oder einem Compliance-Problem führt. In einem europäischen Berichts-Stack ist das für die Aktualität der BI ebenso wichtig wie für die Genauigkeit des Modells.
Traditionelle statistische Methoden haben nach wie vor ihre Daseinsberechtigung, weil sie klar und nachvollziehbar sind. Moderne Observability-Tools ergänzen diese durch eine kontinuierliche Überwachung, sodass Teams nicht warten müssen, bis jemandem auffällt, dass eine Grafik merkwürdig aussieht oder sich ein nachgelagerter Verbraucher beschwert.
Die statistische Seite
Die klassischen Werkzeuge sind direkt, und deshalb bleiben sie im Werkzeugkasten. Der Kolmogorow-Smirnow-Test vergleicht zwei Verteilungen und zeigt, ob sie sich voneinander unterscheiden. Der Chi-Quadrat-Test eignet sich für kategoriale Verschiebungen. Distanzmaße wie die Jensen-Shannon-Divergenz und der Population Stability Index (PSI) helfen dabei, zu messen, wie weit sich die aktuelle Charge vom Referenzdatensatz entfernt hat (gängige Methoden zum Drift-Vergleich).
Diese Methoden funktionieren am besten, wenn das Team weiß, welche Felder wichtig sind, und einen klaren Schwellenwert für Maßnahmen festlegen möchte. Sie sind weniger hilfreich, wenn das Problem innerhalb einer Untergruppe, einer verzögerten Datei oder einer kleinen Kombination von Änderungen über mehrere Spalten hinweg liegt. Ein einzelner Gesamtwert kann diese Art von Drift übersehen, und in der Praxis ist das der Grund, warum ein sauber aussehender Bericht dennoch falsch sein kann.
Die Observability-Seite
Eine Plattform wie digna deckt die betriebliche Seite des Problems ab. Sie kann normales Verhalten erlernen, Anomalien in der Pipeline verfolgen und strukturelle Änderungen aufzeigen, ohne dass ein Analyst jede Regel manuell pflegen muss. Das ist wichtig, wenn der Stack zu viele Tabellen, Zeitpläne und nachgelagerte Verbraucher enthält, um sie alle einzeln zu überprüfen.
Praktische Regel: Nutzen Sie statistische Tests für Präzision und Observability für die Abdeckung. Wenn Sie nur eines von beiden haben, wird Ihnen etwas entgehen.
Die stärksten Teams kombinieren beide Ansätze. Sie vergleichen Chargen mit einer Baseline, überwachen Verteilungsänderungen auf Feature-Ebene und behalten auch die Pünktlichkeit sowie Schemaänderungen im Auge. Auf diese Weise führen eine verspätete Datei, ein fehlerhafter Join und eine echte Verteilungsverschiebung nicht zur selben ungenauen Fehlermeldung. Ein schnelles Beispiel dafür, wie eine Anomalieüberwachung Probleme aufdecken kann, bevor sie sich ausbreiten, finden Sie unter Probleme frühzeitig erkennen, bevor sie sich ausbreiten.
Aufbau Ihres Data-Drift-Abwehrsystems
Die wirksamste Abwehr gegen Drift ist unspektakulär, diszipliniert und kontinuierlich. Sie benötigen klare Data Contracts, versionierte Eingaben, überwachte Baselines und Benachrichtigungen, die bei echten Änderungen anschlagen und nicht bei jedem harmlosen Ausschlag. Wenn ein Team erst nach dem Versagen eines Modells nach Problemen sucht, ist es bereits zu spät, um das Vertrauen in die Ergebnisse zu sichern.
Planen Sie für den gesamten Datenpfad, nicht nur für das Modell
Beginnen Sie mit Verträgen, die definieren, wie eine gute Eingabe aussieht. Versionieren Sie dann die Daten und das Modell gemeinsam, damit Sie feststellen können, ob eine Änderung von der Quelle oder vom Algorithmus stammt. Fügen Sie anschließend eine Überwachung hinzu, die sowohl den Inhalt als auch das Timing im Blick behält, da eine verspätete Datei einem Dashboard genauso schaden kann wie eine fehlerhafte Struktur.
Die Berücksichtigung von Segmenten ist hierbei entscheidend. Eine Verschiebung kann in einer einzelnen Produktlinie oder einer bestimmten Kundenkohorte existieren, während die aggregierten Metriken immer noch gut aussehen. Genau so schleicht sich falsche Sicherheit ein. Die Überwachung auf der richtigen Datenebene reduziert fälschlicherweise negative Befunde und hilft Ihnen, Korrekturmaßnahmen dorthin zu leiten, wo sie benötigt werden (segmentbewusste Drifterkennung).
Sorgen Sie dafür, dass Benachrichtigungen nützlich bleiben
Eine Flut an Fehlermeldungen beeinträchtigt die Observability schneller als der Drift selbst. Wenn jede kleine Schwankung dieselbe Dringlichkeitsstufe auslöst, achten die Leute irgendwann nicht mehr darauf. Ein gutes System unterscheidet zwischen Schemaänderungen, Timing-Problemen und echten Verteilungsänderungen und leitet diese jeweils an die zuständige Person weiter.
Data Contracts machen Qualität zu einer gemeinsamen Erwartung
Nutzen Sie Monitoring, um den Schadensradius zu begrenzen. Eine laute Warnung ist kostengünstiger zu ignorieren, als ein stiller Ausfall erst spät zu entdecken.
Ein wachsames Datenteam werden
Für Organisationen in Spanien und in der gesamten EU ist Drift kein bloßes technisches Ärgernis. Er betrifft die Compliance, die Berichterstattung und die betriebliche Ausfallsicherheit, da die DSGVO (in Spanien durch Behörden wie die AEPD durchgesetzt) verlangt, dass Daten präzise und unversehrt sein müssen (DSGVO-Erwartungen an Datengenauigkeit und -integrität). Wenn Datensätze, Schemata oder Bereitstellungsmuster unbemerkt driften, können sich fehlerhafte Daten in Profile, Berichte und automatisierte Entscheidungen einschleichen, bevor überhaupt jemand die Chance hat, dies zu bemerken.
Deshalb ist die richtige Einstellung nicht: „Überwacht das Modell.“, sondern vielmehr: „Schützt die Datenumgebung.“ Das Modell ist nur ein Konsument dieser Umgebung. Finanzen, BI, Compliance und Betrieb sind alle von denselben Signalen abhängig, und eine unauffällige Änderung an diesen Signalen kann zu einem geschäftlichen Problem werden, lange bevor sie sich als Fehler im Modell bemerkbar macht.
Nutzen Sie die Zuverlässigkeits-Checkliste, um Ihre Kontrollen zu verschärfen
Ein wachsames Datenteam behandelt Data Drift als Kontinuitätsproblem und nicht als Randaufgabe für MLOps. Es überwacht Verteilungsänderungen, verfolgt Versionen, prüft die Aktualität und sorgt für klare Zuständigkeiten, wenn sich etwas ändert. Das ist der Unterschied zwischen Systemen, die einfach nur laufen, und Systemen, denen man auch an einem schlechten Tag noch vertrauen kann.
Buchen Sie eine personalisierte Demo und sehen Sie selbst, wie der digna Schema Tracker Ihre konfigurierten Tabellen kontinuierlich auf das Hinzufügen, Entfernen oder Umbenennen von Spalten sowie auf Änderungen der Datentypen überwacht.
Häufig gestellte Fragen
Was ist Data Drift?
Data Drift ist eine Veränderung der statistischen Eigenschaften von Eingabedaten im Zeitverlauf, sodass die Trainingsverteilung nicht mehr den realen Bedingungen entspricht. Der Artikel betont, dass dies über Machine Learning hinausgeht: Die Abweichung kann in BI-Schichten, Reporting-Abläufe und automatisierte Entscheidungen gelangen, während die Pipelines normal weiterlaufen.
Was verursacht Data Drift?
Die meisten Drifts haben vier Quellen: Schemaänderungen im Upstream wie eine umbenannte Spalte oder ein geänderter Typ, Concept Drift, bei dem Eingaben anders mit Ergebnissen zusammenhängen, Datenqualitätsprobleme wie fehlende Werte oder verspätete Ladevorgänge sowie externe Veränderungen in Märkten, Politik oder Betrieb. Verfolgen Sie eine fehlerhafte Kennzahl bis zum ersten geänderten System zurück.
Wie erkennt man Data Drift mit statistischen Tests?
Der Kolmogorov-Smirnov-Test vergleicht zwei Verteilungen, der Chi-Quadrat-Test eignet sich für kategoriale Verschiebungen, und Distanzmaße wie die Jensen-Shannon-Divergenz und der Population Stability Index (PSI) messen, wie weit sich ein Batch vom Referenzdatensatz entfernt hat. Diese Methoden funktionieren am besten, wenn Sie wissen, welche Felder wichtig sind, und klare Schwellenwerte wollen.
Was ist der Unterschied zwischen langsamem Data Drift und einer plötzlichen Verschiebung?
Langsamer Drift entsteht allmählich, oft im Kundenmix, in Transaktionsmustern oder im saisonalen Verhalten, und zeigt sich erst beim Vergleich der heutigen Daten mit dem Referenzdatensatz des Vormonats. Eine plötzliche Verschiebung folgt meist auf ein Release, eine regulatorische Änderung oder ein Update des Quellsystems. Ein häufiger Fehler ist, beides als ein einziges Genauigkeitsproblem zu behandeln, das Retraining lösen soll.
Reicht es, das Modell neu zu trainieren, um Data Drift zu stoppen?
Nein. Der Artikel empfiehlt eine Abwehr aus Data Contracts, gemeinsamer Versionierung von Daten und Modell, Überwachung von Inhalt und Timing sowie segmentbezogenen Prüfungen, denn eine Verschiebung kann sich in einer Produktlinie verbergen, während Aggregate unauffällig wirken. Kombinieren Sie statistische Tests für Präzision mit Observability für Abdeckung und leiten Sie jeden Alarm an den richtigen Verantwortlichen weiter.



