10 najlepszych narzędzi do zapewniania jakości danych na rok 2026: przewodnik ekspercki
|
7
min. czyt.

Pakiet przeznaczony na spotkanie zarządu ma być gotowy o godzinie 8:00. O 7:15 następuje przesunięcie na pulpicie nawigacyjnym przychodów. Zadanie w procesie przetwarzania danych wciąż świeci się na zielono, ale zmiana schematu u źródła usunęła pole, od którego zależą finanse. Zanim ktokolwiek wykryje problem, dyrektorzy mają już w swoich skrzynkach odbiorczych sprzeczne dane.
Ten scenariusz jest powszechny. Model AI ulega dryfowi po niezauważonej zmianie u źródła. Raport o kondycji klientów pobiera zdublowane konta. Analitycy przestają ufać hurtowni danych i zaczynają ręcznie weryfikować wyniki. Nie są to odosobnione błędy w raportowaniu. To awarie operacyjne spowodowane przez dane, które dotarły z opóźnieniem, uległy uszkodzeniu bez wiedzy zespołu lub przestały odpowiadać logice biznesowej w dalszej części procesu.
Przestoje danych są kosztowne, ponieważ rozprzestrzeniają się w systemach szybciej, niż zespoły są w stanie sprawdzić to ręcznie. Wnioski planistyczne Precisely na rok 2025, podsumowane w analizie wyników przygotowanej przez Alation, pokazują, jak wysoką pozycję zajmuje jakość danych wśród obaw związanych ze spójnością danych w organizacjach planujących kolejny rok.
Rynek narzędzi odpowiedział na to zapotrzebowanie, ale same listy funkcji niewiele pomagają podczas oceny. Głównym kryterium jest dopasowanie. Niektóre platformy najlepiej sprawdzają się w natywnym monitorowaniu hurtowni danych i kontrolach wewnątrzbazowych. Inne są lepsze do celów ładu danych (Data Governance) w przedsiębiorstwach, środowisk bogatych w MDM lub szerokiej obserwowalności (Observability) w rurociągach danych, BI i systemach uczenia maszynowego. Kompromisy szybko wychodzą na jaw podczas wdrożenia. Jakość alertów, głębokość śledzenia pochodzenia danych (lineage), utrzymanie reguł, ograniczenia prywatności oraz to, jak wiele metadanych dostawca musi pobrać, mają większe znaczenie niż dopracowana prezentacja demonstracyjna.
Najlepsze narzędzia do kontroli jakości danych znajdują się obecnie bliżej operacji produkcyjnych niż tradycyjne, przeprowadzane po fakcie testy QA. Monitorują one świeżość, schemat, wolumen, rozkłady danych, pochodzenie (lineage) i reguły biznesowe na tyle wcześnie, aby zespoły mogły zareagować, zanim menedżer, analityk lub klient wykryje problem jako pierwszy.
Ten przewodnik został stworzony z myślą o tym procesie decyzyjnym. Wykracza poza podsumowania dostawców, oferując praktyczne ramy oceny, macierz porównawczą, rekomendacje dla konkretnych przypadków użycia, takich jak opcje stawiające na prywatność w porównaniu z opcjami przyjaznymi dla startupów, oraz listę kontrolną integracji, z której można skorzystać we współpracy z interesariuszami ds. inżynierii, analityki i ładu (governance). Aby uzyskać szerszy obraz ewolucji platform, zobacz to porównanie platform automatyzacji i narzędzi do kontroli jakości danych.
Spis treści
1. digna
Dlaczego digna się wyróżnia
Gdzie pasuje najlepiej
2. Monte Carlo
Co Monte Carlo robi dobrze
3. Anomalo
Gdzie Anomalo zasługuje na swoje miejsce
4. Soda
Dlaczego Soda dobrze sprawdza się w środowiskach kierowanych przez inżynierów
5. Metaplane
6. Acceldata
Gdzie Acceldata ma sens
7. IBM Data Observability by Databand
Gdzie pasuje Databand
8. Ataccama ONE
Dlaczego Ataccama jest inna
9. Informatica Data Quality
Kiedy Informatica jest właściwym wyborem
10. Qlik Talend Data Quality
Gdzie Qlik Talend pasuje najlepiej
Top 10 narzędzi do kontroli jakości danych – porównanie funkcji
Dokonanie właściwego wyboru – od oceny do działania
1. digna

digna to jedno z nielicznych narzędzi w tej kategorii, które poważnie traktuje architekturę stawiającą prywatność na pierwszym miejscu, nie rezygnując z nowoczesnej obserwowalności (observability). Łączy w jednej platformie wykrywanie anomalii, monitorowanie terminowości, śledzenie schematów, walidację na poziomie rekordów i analizę metryk historycznych, jednocześnie działając w środowisku klienta, zamiast opierać się na szerokim przesyłaniu danych do kontrolowanego przez dostawcę stosu SaaS.
Ma to większe znaczenie, niż przyznaje większość stron porównawczych. Jedną z największych luk na rynku jest rzadkie wsparcie dla wykonywania operacji wewnątrz baz danych w środowiskach regulowanych. Dotyczy to szczególnie sytuacji, w których zespoły potrzebują obserwowalności (observability) i kontroli jakości bez ujawniania danych produkcyjnych zewnętrznemu dostawcy, na co wskazuje lakeFS w artykule o luce w prywatności w narzędziach do kontroli jakości danych. Jeśli pracujesz w finansach, ochronie zdrowia, telekomunikacji lub sektorze publicznym, nie jest to tylko miły dodatek. Często decyduje to o tym, czy narzędzie w ogóle da się wdrożyć.
Dlaczego digna się wyróżnia
Najsilniejszą stroną projektu digna jest to, że nie zmusza do dokonywania pozornego wyboru między obserwowalnością (observability) a klasyczną jakością danych. Wiele zespołów kończy na łączeniu jednego produktu do wykrywania anomalii, innego do reguł i trzeciego do raportowania. digna utrzymuje te przepływy pracy w jednym interfejsie, co zmniejsza tarcia przy przekazywaniu zadań, gdy metryka ulega pogorszeniu i ktoś musi szybko odpowiedzieć na trzy pytania: co się zmieniło, kiedy to się zaczęło i których rekordów dotyczy problem.
Obliczanie metryk wewnątrz bazy danych i uczenie się linii bazowych również współgrają z platformami danych w przedsiębiorstwach skuteczniej niż podejścia czysto SaaS-owe. Dane pozostają na miejscu. Ograniczasz ich przesyłanie. Możesz korzystać z wdrożeń w chmurze prywatnej lub on-premise. Dla zespołów podlegających rygorystycznym nakazom lokalizacji danych lub zgodności (Compliance), ten wybór architektoniczny jest często ważniejszy niż głośne deklaracje o AI.
Szczegółowe porównanie dostawców jest dostępne w przewodniku digna na temat narzędzi i platform automatyzacji jakości danych w 2026 roku.
Zasada praktyczna: Jeśli weryfikacja bezpieczeństwa prawdopodobnie zdominuje Twój cykl zakupowy, wczesne wytypowanie platform działających wewnątrz bazy danych pozwala zaoszczędzić miesiące stracone na marnowanie czasu podczas oceny.
Gdzie pasuje najlepiej
digna doskonale nadaje się dla zespołów, które potrzebują jednej warstwy operacyjnej do obsługi ukrytych awarii, takich jak opóźnienia w ładowaniu, dryf schematu, niestałe metryki i naruszenia reguł biznesowych na poziomie rekordów. Świetnie sprawdza się również wtedy, gdy zespół platformy danych chce oferować czytelne pulpity nawigacyjne zarówno dla inżynierów, jak i interesariuszy biznesowych, zamiast kolejnej specjalistycznej konsoli.
Zalety i wady w praktyce wyglądają następująco:
Najlepsza dla środowisk prywatnych: Działa w infrastrukturze kontrolowanej przez klienta, co pomaga zespołom, które nie mogą pozwolić dostawcy na dostęp do danych.
Szerokie pokrycie funkcjonalne: Terminowość, walidacja, wykrywanie anomalii, śledzenie schematów i analityka znajdują się w jednym produkcie.
Dobra dla operacji regulowanych prawnie: Odpowiada organizacjom potrzebującym silnej kontroli prywatności bez utraty głębi obserwowalności (observability).
Brak publicznych cen: Aby zrozumieć strukturę pakietów, konieczna będzie rozmowa z działem sprzedaży.
Mniej idealna dla zwolenników wyłącznie rozwiązań SaaS: Zespoły, które oczekują w pełni zarządzanego narzędzia działającego wyłącznie w chmurze publicznej, mogą preferować inny model.
2. Monte Carlo
Monte Carlo to wciąż jedna z najbardziej rozpoznawalnych marek w dziedzinie obserwowalności danych (Data Observability) i dzieje się tak nie bez powodu. Narzędzie stworzono dla zespołów poszukujących szerokiego, automatycznego monitorowania hurtowni, procesów ETL, BI i coraz częściej modeli AI, gdzie śledzenie pochodzenia (lineage) oraz klasyfikacja incydentów stanowią centrum obsługi produktu.
Największą zaletą jest tu szeroki zakres operacyjny. Monte Carlo sprawdza się doskonale, gdy problemem nie jest jedna uszkodzona tabela, ale splątany ekosystem rurociągów danych, pulpitów nawigacyjnych i zależnych od nich elementów, w którym analiza obszaru wpływu awarii (blast-radius) ma tak samo duże znaczenie jak samo wykrycie problemu.
Co Monte Carlo robi dobrze
Monte Carlo zazwyczaj najlepiej radzi sobie w większych organizacjach zajmujących się danymi, które mierzą się z na tyle wysoką złożonością, by uzasadnić wdrożenie scentralizowanych procesów obsługi incydentów. Monitory świeżości, schematu, wolumenu i dystrybucji danych to dziś absolutny standard, ale praktyczna wartość Monte Carlo tkwi w debugowaniu wspieranym przez analizę pochodzenia danych (lineage) oraz w skoordynowanej reakcji wielu zespołów.
Ceną za to jest waga rozwiązania. Mniejsze zespoły często uznają pakiety korporacyjne, koordynację wdrożenia i proces zakupowy prowadzony przez dział sprzedaży za zbyt obciążające. Jeśli potrzebujesz jedynie lekkich kontroli na wąskim wycinku swojej hurtowni danych, Monte Carlo może sprawiać wrażenie zakupu całego centrum dowodzenia w sytuacji, gdy tak naprawdę potrzebujesz zwykłego czujnika dymu.
Wybierz Monte Carlo, gdy koszt braku wiedzy o wpływie awarii na kolejne etapy procesu jest wyższy niż koszt utrzymania platformy klasy enterprise.
Kilka praktycznych uwag:
Świetnie pasuje do zarządzania incydentami w przedsiębiorstwach: Pomaga zespołom ujednolicić monitorowanie i ścieżki eskalacji.
Pochodzenie danych (lineage) to prawdziwy wyróżnik: Usprawnia analizę przyczyn źródłowych, gdy pulpity i modele zależą od wielu wcześniejszych zasobów.
Mniej przyjazne dla nielicznych zespołów: Startupy i zwięzłe grupy analityczne mogą uznać zakres tego narzędzia za zbyt szeroki.
Należy spodziewać się formalnego cyklu sprzedaży: Ceny nie są publicznie dostępne.
3. Anomalo
Anomalo opiera się na prostej obietnicy, która przemawia do przeciążonych pracą zespołów zajmujących się danymi: wykrywanie wadliwych danych bez konieczności ręcznego tworzenia nieskończonych reguł przez pracowników. Właśnie dlatego wyróżnia się w środowiskach o dużej liczbie tabel, ciągłych zmianach i mocno ograniczonym czasie inżynierów.
To kategoria narzędzi, którą umieściłbym na krótkiej liście, gdy zespół mówi: „Wiemy, że potrzebujemy lepszego monitorowania, ale nie mamy mocy przerobowych na definiowanie progów dla wszystkiego”.
Gdzie Anomalo zasługuje na swoje miejsce
Anomalo kładzie nacisk na nienadzorowane monitorowanie, automatyczne wsparcie w określaniu przyczyn źródłowych (root-cause) oraz integracje z komponentami nowoczesnego stosu danych. W praktyce oznacza to, że może to zmniejszyć obciążenie związane z utrzymaniem systemów opartych intensywnie na regułach, zwłaszcza gdy zbiory danych ewoluują szybciej niż dokumentacja czy ład (governance).
Mimo to autonomiczny monitoring to nie magia. Zespoły nadal muszą wykazywać się odpowiedzialnością, dyscypliną przy segregowaniu alertów i jasnością co do tego, które anomalie mają znaczenie dla biznesu. Narzędzie może wskazać problemy. Nie zdecyduje jednak, czy spóźniony strumień danych o sprzedaży detalicznej jest pilny, akceptowalny czy oczekiwany w tygodniu zamykającym kwartał. Nadal potrzebujesz kontekstu operacyjnego.
Co sprawdza się dobrze w przypadku Anomalo:
Małe obciążenie związane z tworzeniem reguł: Przydatne, gdy zespoły nie chcą utrzymywać kontroli dla każdej tabeli z osobna.
Integracje przyjazne dla przedsiębiorstw: Rozwiązanie jest dostosowane do większych, nowoczesnych stosów danych.
Dobre dopasowanie do szybko zmieniających się danych: Automatyczne wykrywanie pomaga tam, gdzie stałe progi zawodzą.
Cennik wymaga kontaktu z dostawcą: Jasność w kwestii budżetu pojawia się na późniejszym etapie procesu.
Niezbyt lekka opcja: Małe zespoły mogą preferować prostsze ścieżki lub rozwiązania open-source.
4. Soda

Soda trafia do zespołów, które chcą, aby jakość danych działała jako część systemu inżynieryjnego, a nie jako odrębna warstwa nadzoru. Stanowi silną opcję, gdy kryteria oceny faworyzują kontrole wewnątrz bazy danych, reguły kontrolowane wersjami i wyraźną odpowiedzialność w ramach inżynierii danych lub inżynierii analitycznej.
Ta różnica ma duże znaczenie przy wyborze narzędzia. Niektóre platformy optymalizują proces pod kątem szerokiego wykrywania anomalii przy mniejszym nakładzie pracy na konfigurację. Soda wybiera odwrotną drogę. Zespoły same definiują kontrole, decydują o miejscu ich uruchamiania i zarządzają nimi w taki sam sposób, w jaki zarządzają modelami dbt, testami i zmianami wdrożeniowymi.
Dlaczego Soda dobrze sprawdza się w środowiskach kierowanych przez inżynierów
Główną zaletą Sody jest kontrola.
Soda Core i SodaCL dają zespołom model „checks-as-code” (kontrole jako kod), który naturalnie wpisuje się w pull requesty, procesy CI oraz przepływy wydań (release workflows). Dla organizacji, które już teraz weryfikują przekształcenia przez Gita i wdrażają zmiany w różnych środowiskach, to architektoniczne dopasowanie ma zazwyczaj większe znaczenie niż długa lista funkcji. Korzyścią jest powtarzalność. Kompromisem – utrzymanie systemu.
Ten kompromis staje się wyraźniejszy w miarę rozszerzania zakresu działalności. Pokrycie małego zestawu kluczowych dla biznesu danych jest zazwyczaj proste. Jednak setki tabel w różnych domenach mogą prowadzić do rozrostu reguł, luk w odpowiedzialności i fałszywych alarmów, chyba że zespoły odpowiednio wcześnie ujednolicą szablony, poziomy krytyczności i procesy weryfikacji.
Soda jest zazwyczaj dobrym wyborem, gdy zespół oczekuje:
Kontroli zdefiniowanych w kodzie: Świetne dopasowanie do przepływów dbt i egzekwowania zasad CI/CD.
Opcji wykonywania operacji w bazie danych: Przydatne dla zespołów chcących trzymać walidację blisko hurtowni danych.
Ścieżki stopniowego wdrażania: Najpierw open source, a następnie zarządzana współpraca w miarę dojrzewania programu.
Jasnej odpowiedzialności operacyjnej: Najlepsze rozwiązanie, gdy inżynierowie są gotowi utrzymywać reguły w dłuższym horyzoncie czasowym.
Cennika opartego na indywidualnej wycenie: Ocena budżetu wymaga więcej pracy, gdy zespół wychodzi poza warstwę open-source.
Zespoły o wysokiej dyscyplinie inżynieryjnej często szybko czerpią wartość z Sody. Zespoły szukające bezobsługowego monitorowania zazwyczaj wolą narzędzia oferujące większy stopień automatyzacji, a mniej samodzielnego pisania reguł.
W macierzy porównawczej Soda zazwyczaj osiąga wysokie wyniki w kategoriach przejrzystości, dopasowania do przepływu pracy i kontroli nad wdrożeniem. Uzyskuje niższe noty w bezobsługowym pokryciu procesów. Nie jest to jednak wada. Jest to świadomy wybór projektantów, który dla odpowiedniego zespołu okaże się strzałem w dziesiątkę.
5. Metaplane
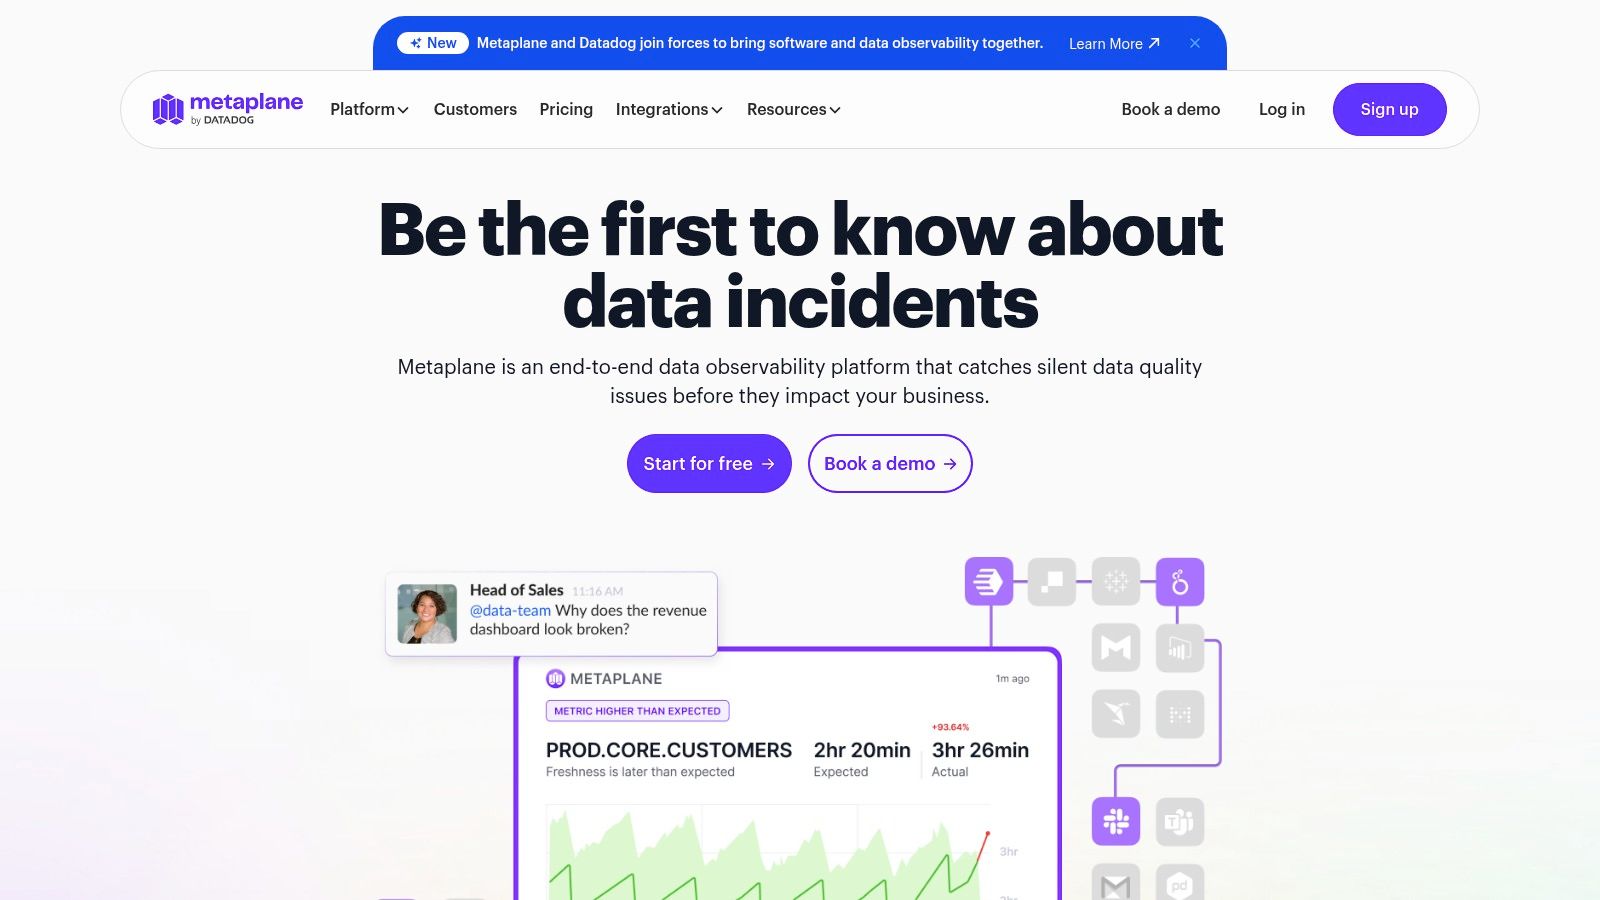
Częsty scenariusz wygląda tak: hurtownia danych działa na tyle sprawnie, by obsługiwać raportowanie, ale zaufanie do niej spada, ponieważ tabele psują się bez ostrzeżenia, świeżość danych ulega rozstrojowi w nocy, a nikt nie widzi problemu, dopóki pulpit nawigacyjny nie zaświeci się na czerwono na oczach przedstawicieli biznesu. Zespoły w takiej sytuacji zwykle nie proszą na starcie o pełny program zarządzania governance. Chcą wczesnego ostrzegania, szybkiej konfiguracji i wystarczającego kontekstu, aby skierować incydent do właściwej osoby.
Metaplane dobrze wpisuje się w tę potrzebę. Jest to produkt stawiający na obserwowalność (observability-first), skierowany do nowoczesnych zespołów danych, które potrzebują szybkiego pokrycia monitoringiem – szczególnie w środowiskach opartych na hurtowniach danych i technologii dbt. Ten nacisk ma znaczenie. Metaplane dąży do skrócenia czasu reakcji na sygnał o błędzie, a nie do zastąpienia każdej powiązanej funkcji w stosie zarządzania danymi.
To rozróżnienie kształtuje ocenę. Jeśli celem jest szerokie administrowanie, zarządzanie politykami oraz ład danych (data governance) w skali całej firmy, Metaplane wyda się zbyt wąski. Jeśli celem jest wykrywanie problemów ze świeżością, schematem, wolumenem lub rozkładem danych, zanim zauważą je interesariusze, węższy zakres może być zaletą, ponieważ wdrożenie przebiega zazwyczaj szybciej, a odpowiedzialność jest jaśniejsza.
Zespoły często wybierają Metaplane z kilku praktycznych powodów:
Szybki proces wdrażania (onboarding): Dobre rozwiązanie dla zespołów, które potrzebują uruchomienia monitoringu bez długiego procesu wdrażania całej platformy.
Obserwowalność (Observability) przed ładem (governance): Świetne rozwiązanie do wykrywania problemów w danych produkcyjnych, słabiej przystosowane do katalogowania, zarządzania pochodzeniem danych (lineage governance) czy programów zorientowanych na intensywną administrację (stewardship).
Dopasowanie do nowoczesnego stosu (modern stack): Dobrze sprawdza się w środowiskach analitycznych zbudowanych wokół hurtowni chmurowych i przepływów dbt.
Stopniowe wdrażanie: Wspiera rozsądną ścieżkę adaptacji, gdzie zespoły zaczynają od zasobów krytycznych dla przychodów lub przeznaczonych dla kadry zarządzającej.
Kompromis w kwestii głębokości: Zyskujesz szybkość i koncentrację na celu, ale większe przedsiębiorstwa mogą nadal potrzebować osobnych narzędzi do szerszych funkcji zarządzania danymi.
In a comparison matrix, Metaplane usually scores well on implementation speed, usability, and modern observability coverage. It scores lower when the evaluation criteria favor all-in-one governance breadth or deep rule-driven control. For many midmarket teams, that is an acceptable trade-off. The right question is not whether Metaplane does everything. It is whether your team needs fast incident detection inside the warehouse, or a broader system that spans quality, governance, and stewardship from the start.
6. Acceldata
Acceldata to coś, co nazwałbym szeroką platformą operacyjną, a nie wąskim, punktowym rozwiązaniem do kontroli jakości danych. Obejmuje niezawodność danych, obserwowalność rurociągów (pipeline observability), widoczność infrastruktury oraz nadzór nad kosztami i wydajnością. To bardzo duży obszar działania, co może być idealnym rozwiązaniem w rozbudowanych środowiskach i całkowicie chybionym pomysłem w mniejszych firmach.
Kluczowe pytanie nie brzmi, czy Acceldata ma wystarczająco dużo funkcji. Pytanie brzmi, czy Twoja organizacja potrzebuje jednego produktu do połączenia jakości, wydajności obliczeniowej i oczekiwań dotyczących poziomu usług (SLA).
Gdzie Acceldata ma sens
Acceldata najlepiej sprawdza się w dużych środowiskach hybrydowych lub chmurowych, w których incydenty często wiążą się zarówno z objawami w danych, jak i przyczynami leżącymi po stronie infrastruktury. W takich realiach dzielenie narzędzi na jakość danych, obserwowalność platformy i zarządzanie kosztami może tworzyć martwe punkty i zamieszanie wokół odpowiedzialności. Szerszy zasięg platformy Acceldata pomaga zamknąć tę lukę.
Minus to złożoność. Zespoły dysponujące stosunkowo czystym i nowoczesnym stosem hurtowni danych mogą nie potrzebować aż tak rozbudowanego obszaru platformy. Lepszym wyborem może być dla nich bardziej skoncentrowane narzędzie do obserwowalności lub walidacji.
Praktyczne kompromisy:
Użyteczne przy złożoności hybrydowej: Pasuje organizacjom o wielowarstwowej strukturze infrastruktury.
Dobre dla operacji zorientowanych na SLA: Niezawodność i wydajność są w tym produkcie ściśle powiązane.
Może zmniejszyć rozrost bazy dostawców: Jeśli potrzebujesz obserwowalności danych i infrastruktury w jednym miejscu.
Zazwyczaj zbyt ciężkie dla małych zespołów: Zakres i procesy zakupowe są mocno skoncentrowane na realiach korporacyjnych.
Proces zakupowy sterowany przez dział sprzedaży: Należy liczyć się z formalną oceną i zaangażowaniem wielu interesariuszy.
7. IBM Data Observability by Databand
IBM Data Observability by Databand to mocna opcja dla organizacji poszukujących zarządzania incydentami danych pod parasolem dużej korporacji. Skupia się na niezawodności rurociągów danych, wykrywaniu anomalii, alertach oraz tworzeniu linii bazowych na podstawie metadanych – z dodatkowym komfortem w postaci dokumentacji IBM, uporządkowanego procesu wdrażania i kanałów wsparcia.
Ta ostatnia kwestia ma większe znaczenie, niż zazwyczaj przyznają to marketingowcy. Niektóre zespoły nie kupują narzędzia najciekawszego pod kątem technicznym. Kupują to, które działy zakupów, bezpieczeństwa i operacji są w stanie realnie obsłużyć.
Gdzie Databand fits
Databand wydaje się mieć najwięcej sensu w środowiskach korporacyjnych korzystających już z rozwiązań IBM lub wykazujących silną preferencję dla uznanych dostawców. Jest szczególnie przydatny, gdy kondycja rurociągów, orkiestracja zadań i alerty operacyjne mają tak samo duże znaczenie jak kontrole jakości na poziomie tabel.
Rozwiązanie to jest mniej atrakcyjne dla zespołów poszukujących zwinnego, stworzonego z myślą o programistach produktu, który mogłyby samodzielnie przetestować i skalować przy minimalnym nakładzie procedur. Atuty IBM to ład (governance), wsparcie i gotowość do wdrożeń korporacyjnych. Są to cenne wartości, ale wiążą się z cięższym procesem operacyjnym.
Zrównoważona ocena:
Dobrze dopasowany do korporacyjnej kontroli operacyjnej: Silny w obszarze zapobiegania incydentom i zarządzanego wsparcia.
Sprawdza się w formalnych środowiskach IT: Pomocny tam, gdzie liczą się procedury i dokumentacja.
Integruje się z przepływami opartymi na kodzie: Użyteczny dla zespołów inżynieryjnych w dużych przedsiębiorstwach.
Może wydawać się zbyt ciężki dla małych grup: Lepiej przystosowany do wdrożeń w skali całej organizacji.
Szczegóły handlowe nie są w pełni publiczne: Należy zaplanować proces sprzedaży prowadzony przez dostawcę.
8. Ataccama ONE
Ataccama ONE to nie tylko narzędzie do kontroli jakości danych. To szersza platforma budowania zaufania do danych (data trust), która łączy profilowanie, reguły, karty wyników (scorecards), obserwowalność (observability), możliwości katalogowe, pochodzenie (lineage) i kwestie typu MDM. Takie pozycjonowanie czyni ją atrakcyjną dla firm zmęczonych prowadzeniem osobnych inicjatyw dla governance i jakości.
To zupełnie inny proces zakupowy niż w przypadku narzędzi takich jak Metaplane czy Soda. Nie rozwiązywasz jedynie problemu monitoringu. Wybierasz szerszy model operacyjny.
Why Ataccama is different
Ataccama jest najsilniejsza, gdy organizacja chce, aby jakość była ściśle powiązana z katalogiem, administracją (stewardship) i zarządzaniem danymi referencyjnymi. Jeśli zarówno Twój zespół ds. ładu (governance), jak i inżynieryjny są interesariuszami, ujednolicony pakiet może ograniczyć dublowanie pracy i uniknąć problemu z przekazywaniem zadań, w którym jeden zespół widzi problemy, a inny jest właścicielem definicji.
Kompromisem jest tu waga wdrożenia. Szerokie pakiety zazwyczaj wymagają dłuższego czasu na uruchomienie i większej spójności w zakresie odpowiedzialności, metadanych oraz projektowania przepływów pracy. Często przynoszą korzyści w regulowanych lub wielodomenowych przedsiębiorstwach. Z kolei nierzadko rozczarowują zespoły, które oczekiwały jedynie szybkiego wykrywania anomalii.
Czego można się spodziewać po Ataccama:
Szerokie pokrycie platformy: Jakość, governance, lineage i powiązane dyscypliny współgrają ze sobą.
Dobre dla sektorów regulowanych: Szczególnie tam, gdzie liczy się własność danych i audytowalność.
Elastyczne opcje wdrażania: Przydatne w modelach chmurowych, hybrydowych i lokalnych (on-premise).
Dłuższa krzywa wdrożenia: Szeroki zakres zwiększa nakład pracy związany z konfiguracją i zarządzaniem zmianą.
Model cenowy dla przedsiębiorstw: Warunki handlowe są ustalane na podstawie indywidualnej wyceny.
9. Informatica Data Quality
Informatica Data Quality pozostaje jedną z najbardziej uznanych marek w dziedzinie jakości danych dla przedsiębiorstw. Oferuje profilowanie, tworzenie reguł, karty wyników, obsługę wyjątków oraz wykonywanie operacji w chmurze w ramach szerszego ekosystemu Informatica.
Dla wielu firm zaletą nie jest nowość rozwiązania. Jest nią znajomość systemu, jego głębokość oraz możliwość dostosowania go do istniejących inwestycji w integrację, ład (governance) czy dane podstawowe (master data) od tego samego dostawcy.
Kiedy Informatica jest właściwym wyborem
Informatica jest zazwyczaj bezpiecznym wyborem, gdy organizacja potrzebuje głębokiego pokrycia funkcji, szerokiego wsparcia dla przedsiębiorstw oraz integracji z dojrzałym stosem zarządzania danymi. Jest szczególnie przydatna, gdy praca nad jakością wiąże się ze zgodnością (Compliance), administracją danymi (stewardship) i obsługą wyjątków, a nie tylko z alertami o anomaliach.
Ostrzeżenie jest proste. Informatica może być trudniejszym wdrożeniem niż bardziej wyspecjalizowane narzędzia – zarówno pod kątem operacyjnym, jak i komercyjnym. Pakiety oparte na zużyciu i licencjonowanie korporacyjne mogą również sprawić, że modelowanie kosztów będzie mniej intuicyjne dla zespołów przyzwyczajonych do prostych stawek za użytkownika lub za tabelę.
Jeśli Twoja organizacja ufa już marce Informatica w sąsiednich przepływach pracy, zakup Informatica Data Quality jest często prostszy niż wprowadzanie zupełnie nowej kategorii platformy.
Oto praktyczny widok:
Głęboka funkcjonalność dla przedsiębiorstw: Silna pozycja w obszarze profilowania, zarządzania regułami i przepływów pracy z wyjątkami.
Dobre dopasowanie do ekosystemu: Najlepsza opcja, gdy Informatica jest już elementem stosu technologicznego.
Użyteczne opcje skalowania chmury: Wykonywanie operacji w modelu serverless może pomóc przy elastycznych obciążeniach roboczych.
Złożone pakiety: Modele cenowe i modele oparte na zużyciu wymagają dokładnej analizy.
Mniej idealne dla zwinnych zespołów: Istnieją łatwiejsze do wdrożenia narzędzia, jeśli Twoje potrzeby są wąskie.
10. Qlik Talend Data Quality
Qlik Talend Cloud wprowadza jakość danych do szerszej platformy integracyjnej i analitycznej. To kluczowy pryzmat do jego oceny. Jeśli szukasz niezależnego, wysoce wyspecjalizowanego narzędzia, to prawdopodobnie nie jest to Twój pierwszy wybór. Jeśli jednak korzystasz już z rozwiązań Qlik lub Talend, ta opcja staje się znacznie bardziej interesująca.
Tego rodzaju dopasowanie platformy ma znaczenie, ponieważ wiele organizacji woli uniknąć kolejnego dostawcy rozwiązań jakościowych, jeśli mogą w rozsądny sposób rozszerzyć posiadane już środowisko integracyjne.
Gdzie Qlik Talend pasuje najlepiej
Qlik Talend Data Quality jest najbardziej przekonujący, gdy profilowanie, reguły, administracja (stewardship) i przepływy pracy integracyjnej muszą współistnieć w jednym miejscu. Zespoły, które polegają już na Talend w kwestii rurociągów danych, mogą często działać szybciej, rozbudowując posiadane zasoby, zamiast wdrażać osobną warstwę obserwowalności z osobną administracją i procesami zakupowymi.
Słabą stroną jest tu niezależność modułowa. Ze względu na to, że moduł jakości żyje wewnątrz szerszej platformy, może nie wydawać się tak wyspecjalizowany ani lekki jak dedykowane produkty do obserwowalności danych (Data Observability). Dla niektórych kupujących to zupełnie w porządku. Dla innych oznacza to, że płacą za strukturę platformy, której wcale nie planowali kupować.
Realistyczne podsumowanie:
Najlepsze dla dotychczasowych klientów Qlik lub Talend: Dopasowanie do platformy to główny powód, dla którego warto umieścić to rozwiązanie na krótkiej liście.
Mocne połączenie DI (integracja danych) i DQ (jakość danych): Przydatne, gdy integracja i jakość należą operacyjnie do jednego obszaru.
Dobre wsparcie dla przedsiębiorstw: Dokumentacja oraz szersze wsparcie techniczne dostawcy są na dojrzałym poziomie.
To nie jest czyste, samodzielne narzędzie jakościowe: Nabywcy powinni oczekiwać korzyści z całej, szerszej platformy.
Cennik jest pakietowy i zorientowany na przedsiębiorstwa: Należy spodziewać się zaangażowania działu sprzedaży.
Top 10 narzędzi do kontroli jakości danych – porównanie funkcji
Produkt | ✨ Kluczowy wyróżnik | 🏆 Atuty | ★ Jakość/UX | 💰 Ceny / Wartość | 👥 Najlepsze dla |
|---|---|---|---|---|---|
digna | Wykrywanie anomalii przez AI wewnątrz bazy danych + chmura on‑prem/prywatna | Nastawienie na prywatność (privacy-first), ujednolicona DQ + obserwowalność (observability), szybka instalacja | ★★★★☆ | 💰Wycena indywidualna; wysoka wartość dla bezpiecznych środowisk | 👥 Przedsiębiorstwa dbające o bezpieczeństwo, inżynierowie i analitycy danych |
Monte Carlo | Kompletne śledzenie pochodzenia (end‑to‑end lineage) + obserwowalność AI (w tym agenci/LLM) | Lider kategorii; mocna klasyfikacja incydentów i analiza obszaru wpływu awarii (blast-radius) | ★★★★★ | 💰Wycena indywidualna; orientacja na przedsiębiorstwa | 👥 Duże przedsiębiorstwa ujednolicające operacje związane z incydentami |
Anomalo | Nienadzorowane / „autonomiczne” wykrywanie anomalii | Redukuje koszty utrzymania reguł; sprawdzone na dużą skalę (finanse/handel detaliczny) | ★★★★☆ | 💰Wycena indywidualna; sprzedaż korporacyjna | 👥 Przedsiębiorstwa potrzebujące automatycznego wykrywania anomalii |
Soda | Rdzeń open-source (SodaCL) + zarządzana chmura (Cloud) | Model „checks‑as‑code”, integracja z CI/CD, dopasowanie do ładu (governance) | ★★★★ | 💰Wersja Core bezpłatna; Cloud na podstawie indywidualnej wyceny | 👥 Inżynierowie danych, zespoły DevOps i zespoły ds. ładu (governance) |
Metaplane | Rozwiązanie natywne dla dbt, cennik za tabelę i szybkie wdrażanie | Prosta konfiguracja; przejrzysty cennik; monitorowanie na poziomie tabel | ★★★★ | 💰Model oparty na zużyciu; dostępny darmowy pakiet | 👥 Małe/średnie zespoły i projekty oparte na dbt |
Acceldata | Obserwowalność (Observability) + optymalizacja mocy/kosztów/wydajności | Szerokie pokrycie rurociągów (pipelines) i infrastruktury; kontrola nad SLA i wydatkami | ★★★★ | 💰Wycena korporacyjna; wysoka wartość przy dużym zakresie wdrożenia | 👥 Duże, złożone i hybrydowe środowiska danych |
IBM Data Observability (Databand) | Rozwiązanie SaaS wspierane przez IBM, dbające o niezawodność rurociągów danych | Wsparcie korporacyjne, bogata dokumentacja, integracje z rurociągami | ★★★★ | 💰SaaS/wycena indywidualna; procesy korporacyjne IBM | 👥 Klienci IBM i korporacyjne zespoły operacyjne |
Ataccama ONE | Zunifikowane budowanie zaufania (DQ + katalog + MDM) | Kompleksowy ład (governance), integracja z katalogiem i MDM | ★★★★ | 💰Wycena indywidualna; wyższy koszt TCO dla całego pakietu | 👥 Branże regulowane wymagające zintegrowanego ładu (governance) |
Informatica Data Quality | Dojrzałe DQ z funkcjami profilowania i opcjami bezserwerowymi (serverless) | Głębokie funkcje korporacyjne; skalowalne modele wykonywania operacji | ★★★★ | 💰Model oparty na zużyciu; złożone pakiety | 👥 Duże organizacje regulowane o bardzo dużych potrzebach DQ |
Qlik Talend Data Quality | DQ wbudowane w proces integracji danych (Talend) | Zintegrowane DI+DQ; funkcje nadzoru (stewardship) i naprawy danych | ★★★★ | 💰Sprzedaż pakietowa/indywidualna wycena przez Qlik Talend Cloud | 👥 Zespoły mocno zaangażowane w ekosystemy Qlik/Talend |
Dokonanie właściwego wyboru – od oceny do działania
Rzeczywista ocena zazwyczaj zaczyna się w ten sam sposób. Pulpit nawigacyjny przestaje działać, biznes pyta, czy liczba jest błędna, czy rurociąg danych jest opóźniony, a zespół zdaje sobie sprawę, że trzy różne narzędzia mogą wychwycić część problemu, ale żadne nie wpisuje się czysto w stosowany model operacyjny.
Dlatego wybór narzędzia powinien zaczynać się od ograniczeń, a nie od siatek funkcji. Pierwsze pytanie brzmi: gdzie uruchamiane są kontrole i kto ma dostęp do danych produkcyjnych. W przypadku zespołów ze środowisk regulowanych ta jedna decyzja natychmiast eliminuje dużą część rynku. Jeśli dane nie mogą opuścić Twojego środowiska, wykonywanie operacji wewnątrz bazy danych oraz wdrożenie kontrolowane przez klienta są wymaganiami podstawowymi. digna pasuje do tego modelu dzięki wykrywaniu anomalii, walidacji, monitorowaniu terminowości i śledzeniu schematów, które mogą działać bez wysyłania danych produkcyjnych do środowiska kontrolowanego przez dostawcę.
Następne pytanie dotyczy odpowiedzialności. Zespoły o silnie rozwiniętych praktykach inżynierii analitycznej często preferują model „checks-as-code”, kontrolę wersji oraz spójność z procesami CI/CD. Zespoły zorientowane na obserwowalność (observability) dbają zazwyczaj bardziej o automatyczne wykrywanie, kontekst pochodzenia danych (lineage), precyzyjne dostrajanie alertów oraz reagowanie na incydenty. Żaden z modeli nie jest obiektywnie lepszy. Niewłaściwy model generuje systemy monitoringu, które świecą pustkami, ignorowane alerty i reguły, których nikt nie utrzymuje po zakończeniu projektu pilotażowego.
Tolerancja wdrożeniowa ma równie duże znaczenie. Wielkie pakiety, takie jak Ataccama ONE, Informatica i IBM Data Observability by Databand, mogą pasować do organizacji, w których jakość danych wiąże się z administracją (stewardship), zgodnością z przepisami (Compliance) i formalnymi procesami operacyjnymi. Niosą za sobą również dłuższe cykle wdrażania, potrzebę większej koordynacji między interesariuszami oraz wyższy całkowity koszt (TCO). Mniejsze zespoły często czerpią więcej wartości z produktów rozwiązujących węższy problem, szczególnie gdy natychmiastowym wyzwaniem są awarie świeżości danych, dryf schematu lub uszkodzone pulpity nawigacyjne na kolejnych etapach.
Przypadki użycia powinny kształtować krótką listę kandydatów.
Jeśli główną przeszkodą jest kwestia bezpieczeństwa i prywatności, daj priorytet narzędziom działającym w Twojej hurtowni lub infrastrukturze. Jeśli szybkość działania startupu liczy się bardziej niż szeroki zakres governance, wybieraj produkty z szybką konfiguracją, przejrzystą wyceną i niskim narzutem na zarządzanie regułami. Jeśli środowisko jest już ujednolicone pod kątem dbt, Airflow, Databricks, Snowflake lub głównego korporacyjnego stosu integracyjnego, kładź duży nacisk na natywne integracje. Tarcia przy integracji to najkrótsza droga do tego, by obiecujący projekt demonstracyjny (PoC) stał się nieużywanym oprogramowaniem zostawionym na półce.
Punkty odniesienia (benchmarks) wciąż mogą pomóc. Przegląd wskaźników jakości danych przygotowany przez 6Sigma przydaje się jako przypomnienie, że jakość wymaga mierzalnych celów w zakresie dokładności, kompletności, spójności i kontroli duplikatów. Dokładne progi będą się różnić w zależności od domeny. Rurociąg finansowy i strumień zdarzeń analitycznych produktu nie powinny podlegać tym samym progom tolerancji. Liczy się to, by narzędzie wspierało monitorowanie, alerty, naprawę błędów i raportowanie trendów zgodnie ze standardami akceptowanymi przez Twój biznes.
Nowoczesne procesy wykrywania zmieniają również procedury oceny. Automatyczne wykrywanie anomalii wyłapuje dziś klasy problemów, które umykają regułom statycznym, zwłaszcza stopniowy dryf czy nieoczekiwane zmiany w rozkładzie lub czasie wpływu danych. Nie zastępuje to jednak kontroli deterministycznych. Logika biznesowa wciąż wymaga wyraźnej walidacji. W praktyce najsilniejsze konfiguracje łączą jedno i drugie: sztywne reguły dla znanych trybów awarii oraz adaptacyjne monitorowanie dla problemów, o których zakodowaniu nikt wcześniej nie pomyślał.
Przeprowadź projekt pilotażowy (PoC) jako ćwiczenie operacyjne, a nie jako prezentację sprzedażową. Wybierz niewielki zestaw kluczowych dla biznesu tabel i przetestuj sześć aspektów: świeżość, wykrywanie zmian schematu, przesunięcia wolumenu danych, poprawność na poziomie poszczególnych pól, kierowanie alertów oraz proces określania przyczyny źródłowej (root-cause). Zaangażuj w to działy bezpieczeństwa, platformy oraz osoby, które będą odpowiedzialne za incydenty po uruchomieniu produkcyjnym. Jeśli proces zatwierdzenia utknie na etapie dostępu do danych, schematu wdrożenia lub obciążeń związanych z utrzymaniem systemu – nie jest to kwestia drugorzędna. To konkretny wynik testu.
Właściwy wybór to narzędzie, które Twój zespół jest w stanie obsługiwać co tydzień bez nadludzkiego wysiłku. Czasami jest to pakiet korporacyjny. Czasami lżejsza warstwa obserwowalności (observability). A czasami produkt stawiający na prywatność, stworzony do wykonywania operacji wewnątrz bazy danych.
Jako oddzielne przypomnienie operacyjne dla zespołów zarządzających przepływami komunikacji z klientami równolegle z dbałością o higienę danych, warto również dowiedzieć się, jak zapobiegać odrzuceniom wiadomości e-mail.
Jeśli Twój zespół potrzebuje podejścia do jakości i obserwowalności (observability) danych zorientowanego przede wszystkim na prywatność (privacy-first), warto przyjrzeć się bliżej platformie digna – forum – wersja angielska. Zaprojektowano ją dla zespołów, które potrzebują wykrywania anomalii, walidacji rekordów, monitorowania terminowości i śledzenia schematów w środowiskach kontrolowanych przez klienta, bez dawania dostawcom wglądu w dane produkcyjne.
Jeśli Twoja krótka lista zależy od natywnego wsparcia dla hurtowni danych i stosu pipeline'ów, przegląd integracji digna pokazuje, z jakimi platformami danych łączy się digna, zanim zdecydujesz się na proof of concept.
Najczęściej zadawane pytania
Jakie są najlepsze narzędzia do jakości danych w 2026 roku?
Przewodnik porównuje dziesięć platform: digna, Monte Carlo, Anomalo, Soda, Metaplane, Acceldata, IBM Data Observability by Databand, Ataccama ONE, Informatica Data Quality i Qlik Talend Data Quality. Żadna nie wygrywa we wszystkim; właściwy wybór zależy od tego, gdzie działają kontrole, kto za nie odpowiada i jaki nakład wdrożeniowy zespół jest w stanie udźwignąć.
Które narzędzie do jakości danych sprawdzi się w środowiskach regulowanych lub wrażliwych na prywatność?
Warto szukać narzędzi działających we własnej infrastrukturze. Przewodnik wskazuje digna jako opcję privacy-first, ponieważ oblicza metryki i uczy się baseline'ów bezpośrednio w bazie danych, on-premises lub w chmurze prywatnej, bez wysyłania danych produkcyjnych do dostawcy. W finansach, ochronie zdrowia, telekomunikacji czy sektorze publicznym często przesądza to o możliwości wdrożenia.
Czym Soda różni się od Monte Carlo?
Soda opiera się na modelu checks-as-code: zespoły piszą kontrole w SodaCL, wersjonują je w Git i uruchamiają w CI/CD, co daje kontrolę, ale wymaga utrzymania wraz ze wzrostem liczby tabel. Monte Carlo stawia na szeroki, zautomatyzowany monitoring z triażem incydentów wspieranym przez lineage i analizą zasięgu skutków, co pasuje do dużych organizacji ze złożonymi pipeline'ami.
Jak przeprowadzić proof of concept narzędzia do jakości danych?
Należy traktować go jako ćwiczenie operacyjne, a nie sprzedażowe. Wybierz niewielki zestaw tabel krytycznych dla biznesu i przetestuj sześć obszarów: aktualność, wykrywanie zmian schematu, zmiany wolumenu, poprawność na poziomie pól, routing alertów oraz proces analizy przyczyn. Zaangażuj bezpieczeństwo, zespół platformy i osoby, które będą obsługiwać incydenty.
Czy stosować reguły, czy automatyczne wykrywanie anomalii?
Jedno i drugie, według przewodnika: najlepsze konfiguracje łączą twarde reguły dla znanych błędów z adaptacyjnym monitoringiem problemów, których nikt nie przewidział. Wykrywanie anomalii wychwytuje stopniowy dryf i nieoczekiwane zmiany rozkładu lub terminów, a jawna walidacja pozostaje potrzebna dla logiki biznesowej, która musi być spełniona dla każdego rekordu.



