Kompletność jako wymiar jakości danych: Przewodnik na rok 2026
|
8
min. czyt.

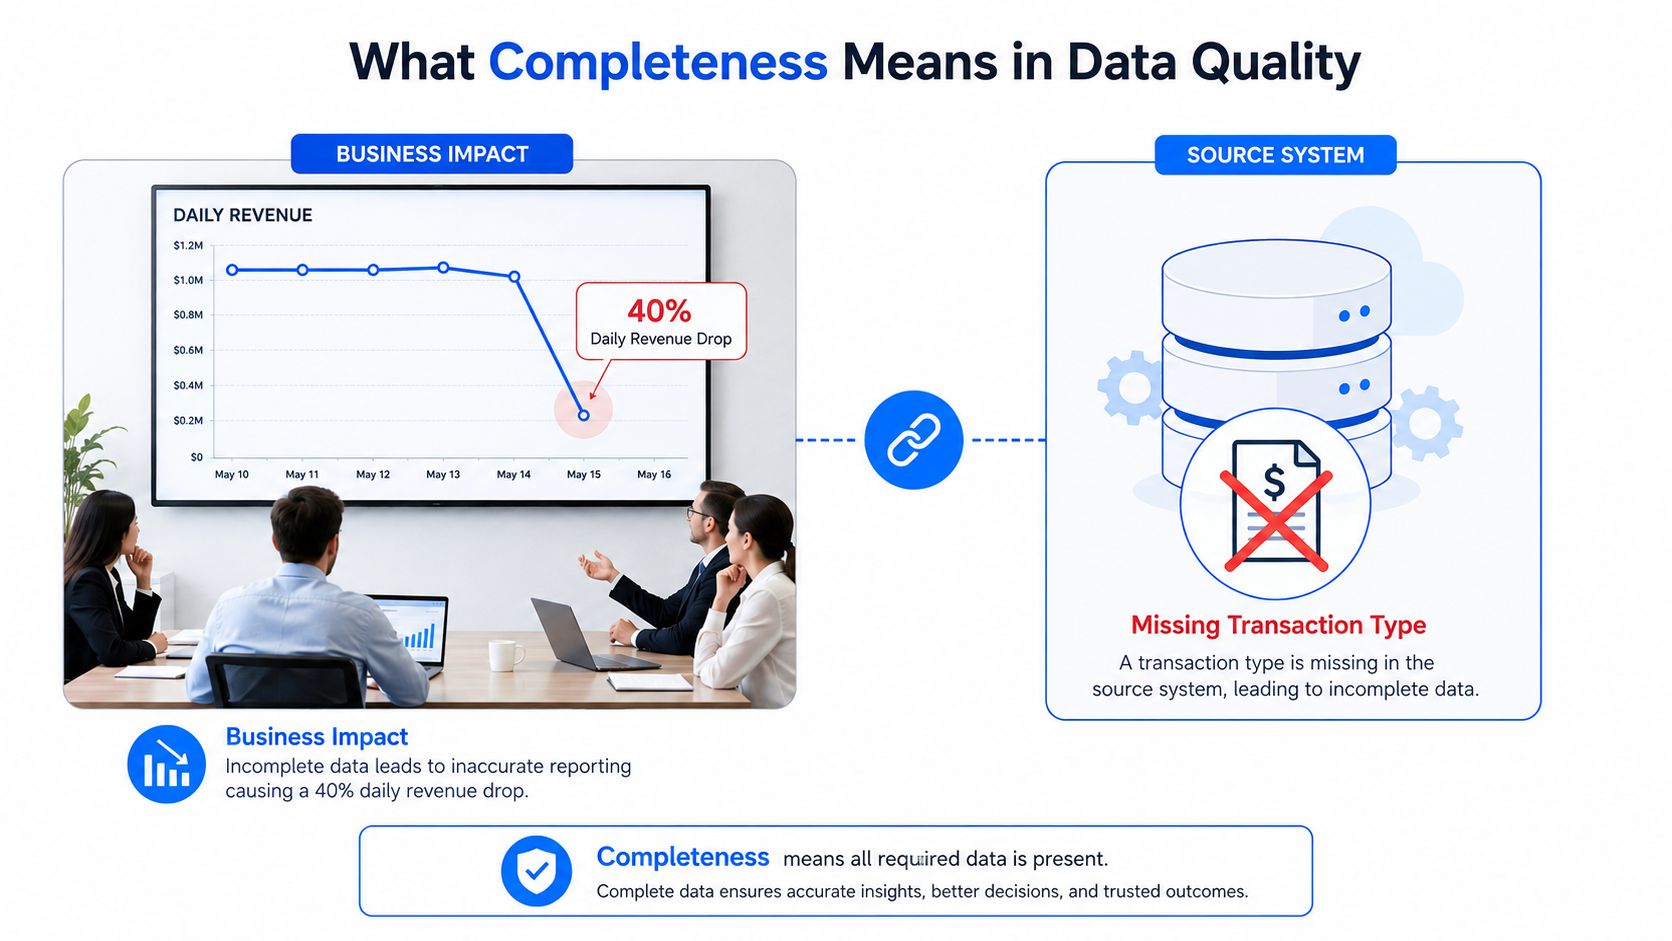
Twój codzienny pulpit nawigacyjny przychodów wygląda normalnie, dopóki któregoś ranka łączna kwota gwałtownie nie spadnie. System źródłowy jest online, potok raportuje sukces, a większość kolumn jest uzupełniona. Problem polega na tym, że jeden typ transakcji nigdy nie dotarł lub identyfikator klienta zniknął podczas eksportu. To jest ten rodzaj awarii, do ujawniania którego została stworzona kompletność jakości danych.
Kompletność w jakości danych oznacza, czy obecne są wszystkie dane wymagane do zamierzonego celu. Obejmuje to wymagane wartości w rekordach, rekordy, które powinny istnieć, ale ich brakuje, oraz oczekiwane wolumeny danych w plikach lub okresach czasu. Zbiór danych może nie zawierać oczywistych pustych miejsc, a mimo to być niekompletny, jeśli cała grupa klientów, transakcji lub zdarzeń została wykluczona.
Praktycznym standardem jest przydatność do określonego celu. Zbiór danych może być wystarczająco kompletny do jednej analizy i niekompletny do innej, ponieważ każdy przypadek użycia wymaga innych pól, rekordów, pokrycia i wzorców dostarczania. Wyjaśnienie wymiarów jakości danych przygotowane przez rządy Wielkiej Brytanii bezpośrednio wskazuje na to rozróżnienie, definiując kompletność w odniesieniu do danych wymaganych do określonego zastosowania, a nie do zapełnienia każdego możliwego pola.
Spis treści
Co oznacza kompletność w jakości danych
Załóżmy, że pulpit nawigacyjny zespołu finansowego pokazuje niespodziewany spadek przychodów. Analityk sprawdza tabelę transakcji i stwierdza, że większość wierszy ma identyfikatory klientów, daty, kwoty i statusy płatności. Tabela na pierwszy rzut oka wygląda dobrze. Późniejsze porównanie ujawnia, że w ostatnim ładowaniu brakowało transakcji mobilnych, więc w raporcie brakowało prawidłowych rekordów, a nie tylko zawierał on puste komórki.
To rozróżnienie definiuje kompletność jako wymiar jakości danych. Zadaje pytanie, czy zbiór danych zawiera wszystko, co jest potrzebne do realizacji jego określonego celu. Pytanie nie brzmi: „Czy wszystkie kolumny są pełne?”. Brzmi: „Czy te dane zawierają wymagane wartości, rekordy i pokrycie potrzebne do podjęcia decyzji, którą ktoś zamierza podjąć?”
Dlaczego wartości inne niż null nie wystarczą
Tabela klientów może mieć niski wskaźnik wartości null, jednocześnie pomijając każdego klienta utworzonego za pośrednictwem określonego kanału. Tabela transakcji może zawierać poprawnie sformatowane wiersze, a jednocześnie brakować w niej całego typu zdarzenia. Codzienny plik może zawierać kompletne rekordy, ale reprezentować tylko część oczekiwanej działalności biznesowej.
Kompletność działa zatem na poziomie wyższym niż komórka:
Kompletność pola dotyczy tego, czy wymagane atrybuty są uzupełnione.
Kompletność rekordu dotyczy tego, czy pojawia się każde wymagane powiązanie lub zdarzenie.
Kompletność pliku dotyczy tego, czy dotarł oczekiwany plik, partycja lub ładunek.
Kompletność populacji dotyczy tego, czy zbiór danych reprezentuje odpowiednią populację ze świata rzeczywistego, w tym grupy, daty i typy transakcji.
Historia tego pojęcia odzwierciedla to szersze spojrzenie. Badania traktowały kompletność jako nazwany atrybut jakości danych od co najmniej 1983 roku, kiedy Bailey i Pearson włączyli ją do podstawowych atrybutów jakości informacji wyjściowych. Późniejsze prace podsumowały kompletność jako to, czy wszystkie istotne dane są rejestrowane, podczas gdy współczesne wytyczne opierają ją na potrzebach konkretnego zastosowania. Przydatny przegląd koncepcji pokrycia danych od Wine Labs może pomóc zespołom myśleć szerzej niż tylko o zapełnionych kolumnach i badać, czy docelowa populacja jest reprezentowana.
Praktyczna zasada: Zdefiniuj, co musi być obecne, zanim obliczysz, czy dane są kompletne.
Jasna definicja operacyjna brzmi: Kompletność to obecność wszystkich wymaganych danych dla określonego celu biznesowego, w tym wymaganych wartości, rekordów, plików i pokrycia populacji. Zespoły ustanawiające szersze ramy mogą również zapoznać się z tym, jak definiuje się i mierzy wymiary jakości danych.
Trzy warstwy kompletności
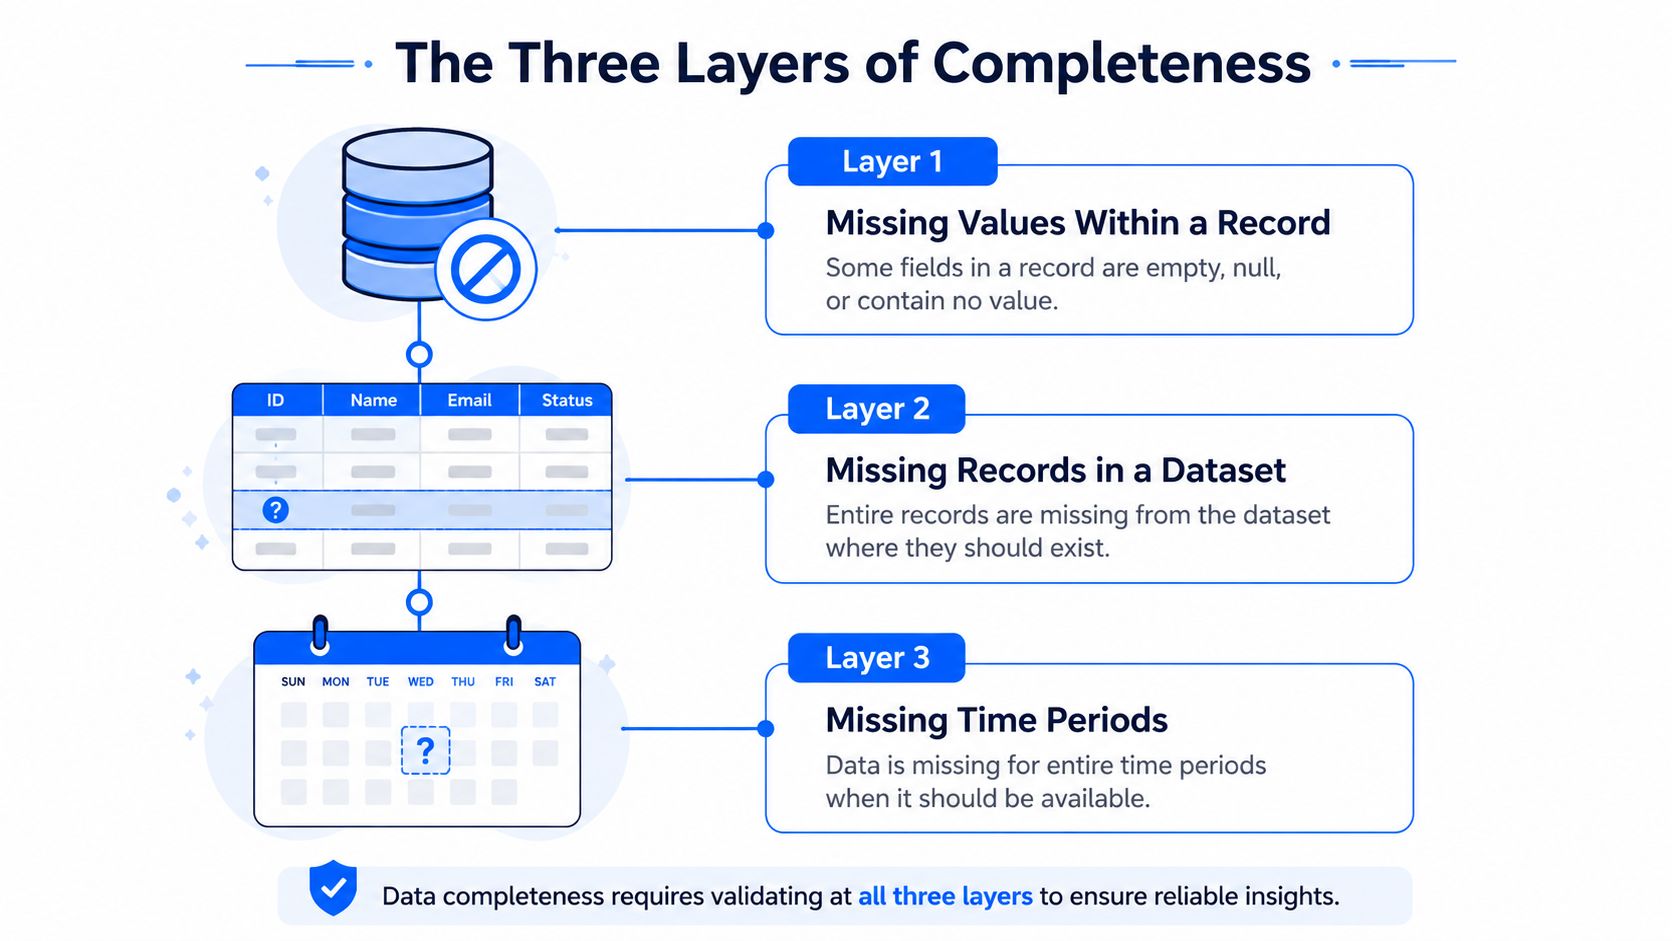
Zespoły często traktują kompletność jako ćwiczenie polegające na sprawdzaniu wartości null. To pozwala wyłapać tylko jedną warstwę problemu. Niezawodny program kompletności danych oddziela luki wewnątrz rekordów od brakujących rekordów i brakującego pokrycia w czasie lub oczekiwanych wolumenach.
Pomyśl o bibliotece. W książce może brakować stron, wymaganej książki może nie być na półce lub biblioteka mogła przestać katalogować nowe pozycje przez kilka dni. Każda sytuacja reprezentuje niekompletność, ale każda wymaga innego testu.
Pierwsza warstwa to brakujące wartości
Pierwsza warstwa dotyczy atrybutów wewnątrz rekordu. Wiersz klienta może istnieć, ale jego identyfikator klienta, kod pocztowy, status zgody lub znacznik czasu utworzenia mogą być puste, mieć wartość null lub zostać zastąpione wartością domyślną.
W tym przypadku dobrze sprawdzają się kontrole pól wymaganych. Zespół identyfikuje pola potrzebne do wykonania zadania, zlicza rekordy, w których tych pól brakuje, i monitoruje wynik w czasie. Brakujący kod pocztowy może ograniczyć analizę regionalną, podczas gdy brak podstawowego identyfikatora może całkowicie uniemożliwić złączenia.
Nie każda pusta komórka jest automatycznie błędem. Opcjonalne informacje profilowe mogą być zasadnie niedostępne, podczas gdy identyfikator wymagany do rozstrzygania tożsamości zazwyczaj nie jest opcjonalny. Definicja biznesowa musi powstać przed ustaleniem progu.
Druga warstwa to brakujące rekordy
Druga warstwa dotyczy całych wierszy. Oczekiwany klient, zamówienie, płatność lub zdarzenie nigdy nie trafia do tabeli docelowej. Walidacja na poziomie wiersza tego nie wykryje, ponieważ nie ma wiersza do sprawdzenia.
Zespoły mogą to wykryć poprzez uzgadnianie z autorytatywnym źródłem, oczekiwanymi zakresami kluczy, inwentaryzacją zdarzeń, sumami kontrolnymi lub porównaniami między systemami nadrzędnymi i podrzędnymi. Na przykład, jeśli system zarządzania zamówieniami rejestruje identyfikator zamówienia, ale nie ma go w tabeli hurtowni danych, hurtownia jest niekompletna, nawet jeśli każdy wiersz, który dotarł, pomyślnie przechodzi kontrole pól.
Trzecia warstwa to brakujący wolumen lub pokrycie
Trzecia warstwa dotyczy kształtu zbioru danych w czasie, plikach, partycjach lub populacjach biznesowych. Codzienna tabela zdarzeń może zawierać prawidłowe wiersze, ale ładowanie może być znacznie mniejsze niż oczekiwany wolumen. Może brakować partycji, plik źródłowy może być pusty lub nowy typ zdarzenia może przestać napływać po zmianie schematu.
Ta warstwa łączy kompletność z terminowością. Spóźniony plik jest niekompletny dla pulpitu nawigacyjnego, który musi odzwierciedlać najnowszy okres sprawozdawczy, nawet jeśli plik ostatecznie dotrze. Łączy się to również ze zmianami schematu (schema drift). Jeśli źródło usunie kolumnę lub zmieni strukturę zdarzenia, procesy podrzędne mogą utracić fakty potrzebne do danego przypadku użycia.
Kompletność a dokładność — czym się różnią
Kompletność i dokładność odpowiadają na różne pytania.
Kompletność: Czy wymagane dane są obecne?
Dokładność: Czy dane poprawnie reprezentują rzeczywisty obiekt, zdarzenie lub wartość?
Rekord może być obecny, ale błędny. Może być również poprawny tam, gdzie istnieje, ale brakować go w zbiorze danych.
Rozważmy tabelę klientów używaną do łączenia klientów z zamówieniami. Każdy uzupełniony adres e-mail ma oczekiwany format, a istniejące dane klienta zgadzają się z systemem źródłowym. Jednak niektóre identyfikatory klientów mają wartość null. Wartości, które istnieją, mogą być dokładne, ale tabela jest niekompletna dla złączeń opartych na tożsamości, ponieważ brakuje wymaganych identyfikatorów.
Teraz odwróćmy problem. Każdy wiersz klienta zawiera identyfikator klienta, więc tabela wydaje się kompletna. Jednak niektóre identyfikatory wskazują na niewłaściwe osoby, ponieważ nadrzędny proces mapowania przypisał je błędnie. Zbiór danych jest kompletny pod względem obecności, ale niedokładny pod względem znaczenia.
Wymiar | Kluczowe pytanie | Typowa awaria | Przydatna kontrola |
|---|---|---|---|
Kompletność | Czy wszystkie wymagane dane są obecne? | Brakujące identyfikatory klientów lub brak transakcji | Kontrole wymaganych pól, uzgadnianie i kontrole wolumenu |
Dokładność | Czy dane odzwierciedlają rzeczywistość? | Identyfikator powiązany z niewłaściwym klientem | Porównanie z autorytatywnym źródłem |
Oba | Czy wymagane dane są obecne i poprawne? | Brakujące lub błędnie przypisane konto | Oddzielne kontrole kompletności i dokładności |
Zespoły mylą te wymiary, ponieważ widoczne puste miejsce łatwo zidentyfikować, podczas gdy błędna wartość może wyglądać całkowicie wiarygodnie. Uzupełnione pole nie jest dowodem na to, że jest ono dokładne, a dokładny podzbiór nie jest dowodem na to, że obecna jest cała populacja.
Reakcja operacyjna powinna polegać na rozdzieleniu tych kontroli. Kontrole kompletności szukają wartości null, brakujących kluczy, brakujących zdarzeń, brakujących plików i nieoczekiwanych wolumenów. Kontrole dokładności porównują wartości z zaufanymi referencjami, walidują powiązania tożsamości lub sprawdzają, czy fakty biznesowe odpowiadają rzeczywistości. Szersze wyjaśnienie pojęcia Data Observability w porównaniu z jakością danych pomaga umieścić te kontrole w szerszym modelu operacyjnym.
Metryki, wskaźniki i kontrole wymaganych pól
Pomiar zaczyna się od jasnego oczekiwania. Przed obliczeniem wskaźnika kompletności zdefiniuj wymagane pola, wymagane rekordy, odpowiednią populację, harmonogram dostarczania i dopuszczalne odchylenia dla danego przypadku użycia.
Najprostszą metryką na poziomie pola jest wskaźnik kompletności:
Wskaźnik kompletności = obecne wymagane wartości ÷ oczekiwane wymagane wartości
Jeśli tabela zawiera rekordy, w których powinien być obecny wymagany identyfikator klienta, zlicz uzupełnione identyfikatory i podziel tę liczbę przez liczbę rekordów, które powinny je zawierać. Wynik można wyrazić jako stosunek lub procent. Ta sama logika ma zastosowanie do oczekiwanych rekordów, plików, partycji lub zdarzeń.
Komplementarną miarą jest wskaźnik wartości null (null rate):
Wskaźnik wartości null = brakujące wartości ÷ oczekiwane wartości
Wskaźnik wartości null, który mógłby być tolerowany w przypadku opcjonalnego atrybutu marketingowego, może być niedopuszczalny w przypadku klucza głównego. Progi muszą odzwierciedlać konsekwencje biznesowe, a nie uniwersalny cel. Brakujący e-mail może zmniejszyć zasięg kampanii, podczas gdy brakujący identyfikator konta może uniemożliwić uzgadnianie, śledzenie pochodzenia danych (lineage) i podrzędne złączenia.
Wybór stałych i adaptacyjnych progów
Używaj stałego progu, gdy reguła jest nieodłączną częścią kontraktu danych (Data Contract). Klucz główny może być wymagany dla każdego zaakceptowanego rekordu, a brakująca wartość powinna wywołać błąd niezależnie od historycznych zachowań.
Używaj progu adaptacyjnego, gdy oczekiwana wartość zmienia się w zależności od harmonogramu, sezonu, dnia, zachowania źródła lub aktywności biznesowej. Historyczne punkty odniesienia mogą zidentyfikować nietypowy spadek liczby codziennych rekordów bez zmuszania inżynierów do utrzymywania osobnej liczby dla każdego okresu.
Praktyczny projekt monitorowania łączy oba podejścia:
Kontrole wymaganych pól identyfikują brakujące wartości w krytycznych kolumnach.
Uzgadnianie rekordów identyfikuje oczekiwane powiązania lub zdarzenia, które nigdy nie dotarły.
Kontrole wolumenu porównują zaobserwowane liczby z oczekiwanymi zakresami.
Kontrole rozkładu identyfikują zmiany, które mogą wskazywać na częściową populację lub utraconą kategorię.
Monitorowanie trendów pokazuje, czy problem z kompletnością jest stabilny, poprawia się, czy pogarsza.
Poniższa tabela przypisuje typowe kontrole do możliwości wdrożeniowych.
Wymiar | Metryka | Przykładowa kontrola | Możliwość digna |
|---|---|---|---|
Kompletność pola | Wskaźnik wartości null dla wymaganego pola | Identyfikator klienta jest obecny dla każdego wymaganego rekordu klienta | Data Validation |
Kompletność rekordu | Liczba brakujących kluczy | Identyfikatory zamówień w źródle są nieobecne w hurtowni danych | Data Validation |
Kompletność pliku | Status przybycia lub ładowania | Brakuje zaplanowanej partycji transakcji | Data Anomalies |
Kompletność wolumenu | Zaobserwowana vs oczekiwana liczba rekordów | Dzienny wolumen zdarzeń jest niespodziewanie niski | Data Anomalies |
Kompletność rozkładu | Pokrycie kategorii lub zdarzeń | Typ transakcji znika z najnowszego ładowania | Data Anomalies |
Kompletność trendu | Wskaźnik kompletności w czasie | Pokrycie wymaganych pól spada w kolejnych ładowaniach | Data Analytics |
Zespoły mogą rozszerzyć ten model o metryki jakości danych i praktyki pomiarowe. Ważną kwestią jest mierzenie poziomu, na którym występuje awaria. Pojedynczy ogólny wynik może ukryć brakującą populację, dlatego należy osobno raportować metryki pól, rekordów, plików i wolumenu.
Rzeczywiste przykłady niekompletnych danych przedsiębiorstwa
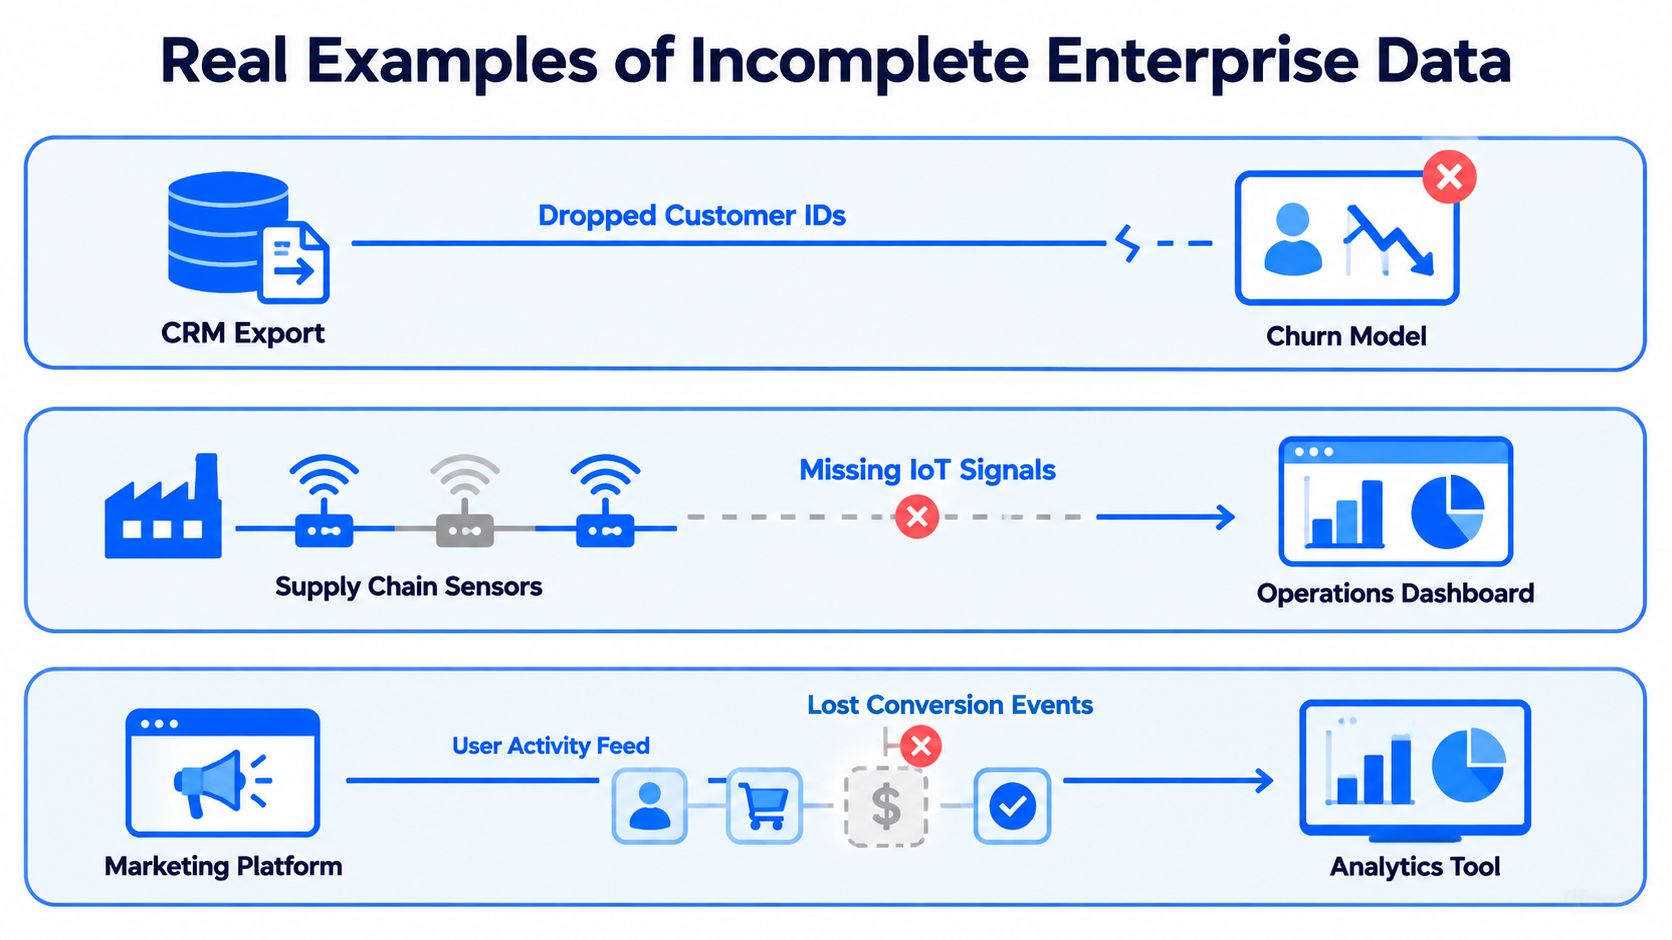
Problemy z kompletnością zazwyczaj najpierw objawiają się jako symptomy biznesowe. Model traci moc predykcyjną, łączna kwota przychodów wydaje się niska lub operacyjny pulpit nawigacyjny zgłasza nieprawdopodobny spadek. Przyczyna techniczna często leży wcześniej w potoku danych.
Eksport z systemu CRM traci identyfikatory klientów
Eksport z CRM zawiera nowe rejestracje mobilne, ale pole identyfikatora klienta jest dla tej grupy puste. Wiersze są obecne, a imiona i adresy e-mail mogą wyglądać na prawidłowe, jednak proces rozstrzygania tożsamości nie może niezawodnie połączyć tych klientów z zamówieniami, historią wsparcia ani wcześniejszą aktywnością.
Biznes zauważa lukę w analizie odpływu klientów (churn) lub niewyjaśniony wzrost liczby niezidentyfikowanych klientów. Reguła wymaganego pola dla identyfikatora klienta pozwoliłaby wychwycić ten błąd na poziomie rekordu. Porównanie populacji według kanału pozyskania ujawniłoby, że problem dotyczy konkretnej grupy, a nie całego eksportu.
Kanał płatności pozostawia transakcje jako niedokończone
Procesor płatności nadal wysyła wiersze transakcji, ale niektóre płatności pozostają oznaczone jako oczekujące na czas nieokreślony. Tabela wydaje się uzupełniona, ale proces rozliczania przychodów na koniec miesiąca nie może traktować tych transakcji jako rozliczonych ani uwzględnić ich w oczekiwanym wyniku finansowym.
Luka w kompletności to nie tylko wartość null. Wymagany cykl życia transakcji jest niekompletny dla celów raportowania. Kontrole powinny porównywać oczekiwane stany transakcji i sumy uzgodnień, podczas gdy monitorowanie terminowości powinno identyfikować rekordy, które nie wykazują postępu w zdefiniowanym oknie operacyjnym.
Partycjonowane ładowanie zdarzeń zapisuje znacznie mniej wierszy
Codzienne przetwarzanie wsadowe normalnie tworzy dużą tabelę zdarzeń. Pewnego dnia partycjonowane ładowanie kończy się niepowodzeniem i do hurtowni trafia tylko niewielka część wierszy. Ocalałe wiersze przechodzą kontrole schematu i wymaganych pól, więc sam test na poziomie wiersza raportuje sukces.
Pierwszym widocznym symptomem może być pulpit nawigacyjny o niskiej aktywności lub brakujący segment w modelu analitycznym. Kontrola wolumenu uwzględniająca harmonogram porównałaby zaobserwowaną liczbę z zachowaniem historycznym i oflagowała ładowanie do zbadania. Monitorowanie rozkładu mogłoby następnie pokazać, które źródło, data lub typ zdarzenia zniknęły.
Te przykłady niosą wspólną lekcję: niekompletne dane nie zawsze wyglądają na uszkodzone wewnątrz wierszy, które dotarły. Monitorowanie musi testować to, co powinno było dotrzeć, a nie tylko to, co jest obecnie przechowywane.
Jak digna wspiera kompletność danych
Program kompletności wymaga zarówno reguł deterministycznych, jak i monitorowania behawioralnego. Właściwy wybór zależy od tego, czy oczekiwanie jest jawne, np. „identyfikator klienta jest wymagany”, czy też wyuczone na podstawie powtarzających się zachowań danych, np. nietypowej zmiany dziennego wolumenu.
digna Data Validation
digna Data Validation stosuje kontrole na poziomie rekordów pod kątem reguł biznesowych. Zespół może zdefiniować kontrole wymaganych pól dla identyfikatorów klientów, dat transakcji, kluczy kont lub innych atrybutów potrzebnych do określonego przepływu pracy. Moduł może również obsługiwać ukierunkowane kontrole pustych wartości i warunków biznesowych, które decydują o tym, czy rekord nadaje się do użytku.
Jest to najjaśniejsza kontrola dla pierwszej warstwy kompletności — brakujących wartości w rekordach. Może również wspierać logikę kompletności na poziomie rekordu, gdzie wiersz musi zawierać określoną kombinację wartości, zanim zostanie zaakceptowany do dalszego użytku.
digna Data Anomalies
digna Data Anomalies monitoruje nieoczekiwane zmiany w liczbie rekordów, wskaźnikach wartości null i rozkładach. Jej podejście oparte na uczeniu się punktu odniesienia (baseline) jest odpowiednie dla danych, które zmieniają się naturalnie, gdzie pojedynczy stały limit generowałby niepotrzebne alerty.
Pomaga to radzić sobie z brakującymi rekordami i brakującym wolumenem. Nieoczekiwane zmniejszenie liczby dziennych wierszy, zniknięcie kategorii transakcji lub nagły wzrost liczby wartości null mogą być badane pod kątem ewentualnego częściowego ładowania, przerwy w źródle lub zmiany w potoku. Moduł pomaga również ujawnić wzorce, które nie zostały objęte ręcznie zapisanymi regułami.
digna Data Analytics
digna Data Analytics zapewnia historyczną analizę metryk kompletności. Bieżący wskaźnik wartości null ma ograniczone znaczenie bez kontekstu. Widoki historyczne pomagają zespołom odróżnić stabilną charakterystykę od niedawnego pogorszenia i zidentyfikować, czy powtarzający się problem z ładowaniem staje się coraz częstszy.
Moduły można przypisać do trzech warstw:
Brakujące wartości: Data Validation sprawdza wymagane pola i warunki rekordów.
Brakujące rekordy: Walidacja i monitorowanie anomalii porównują oczekiwane i zaobserwowane pokrycie.
Brakujący wolumen lub okresy: Data Anomalies monitoruje liczby, rozkłady i zachowanie ładowania, podczas gdy Data Analytics pokazuje trend.
digna wykonuje obliczenia metryk i analizy w środowisku bazy danych klienta, dzięki czemu dane pozostają na swoim miejscu. Wdrożenie może odbyć się w chmurze prywatnej, VPC lub centrum danych, co wspiera zespoły, które potrzebują monitorowania kompletności bez przenoszenia danych produkcyjnych do zewnętrznej usługi.
Praktyczny projekt jest modułowy. Zespół może zacząć od jawnych reguł dla wymaganych pól, dodać wykrywanie anomalii dla nieoczekiwanych zmian i używać historycznej analityki do zarządzania progami i naprawy błędów. Śledzenie schematu i kontrole terminowości mogą uzupełniać tę konfigurację, gdy usunięte kolumny lub opóźnione ładowanie pośrednio powodują błędy kompletności.
Częstotliwość monitorowania, zarządzanie i typowe pytania
Monitorowanie kompletności działa najlepiej, gdy każda kontrola jest uruchamiana w punkcie, w którym jej niepowodzenie ma znaczenie. Kontrole wymaganych pól powinny być uruchamiane przy każdym istotnym ładowaniu. Kontrole wolumenu powinny być uruchamiane zgodnie z harmonogramem dostarczania zbioru danych. Wykrywanie anomalii powinno oceniać zachowanie w sposób ciągły lub za każdym razem, gdy pojawiają się nowe dane.
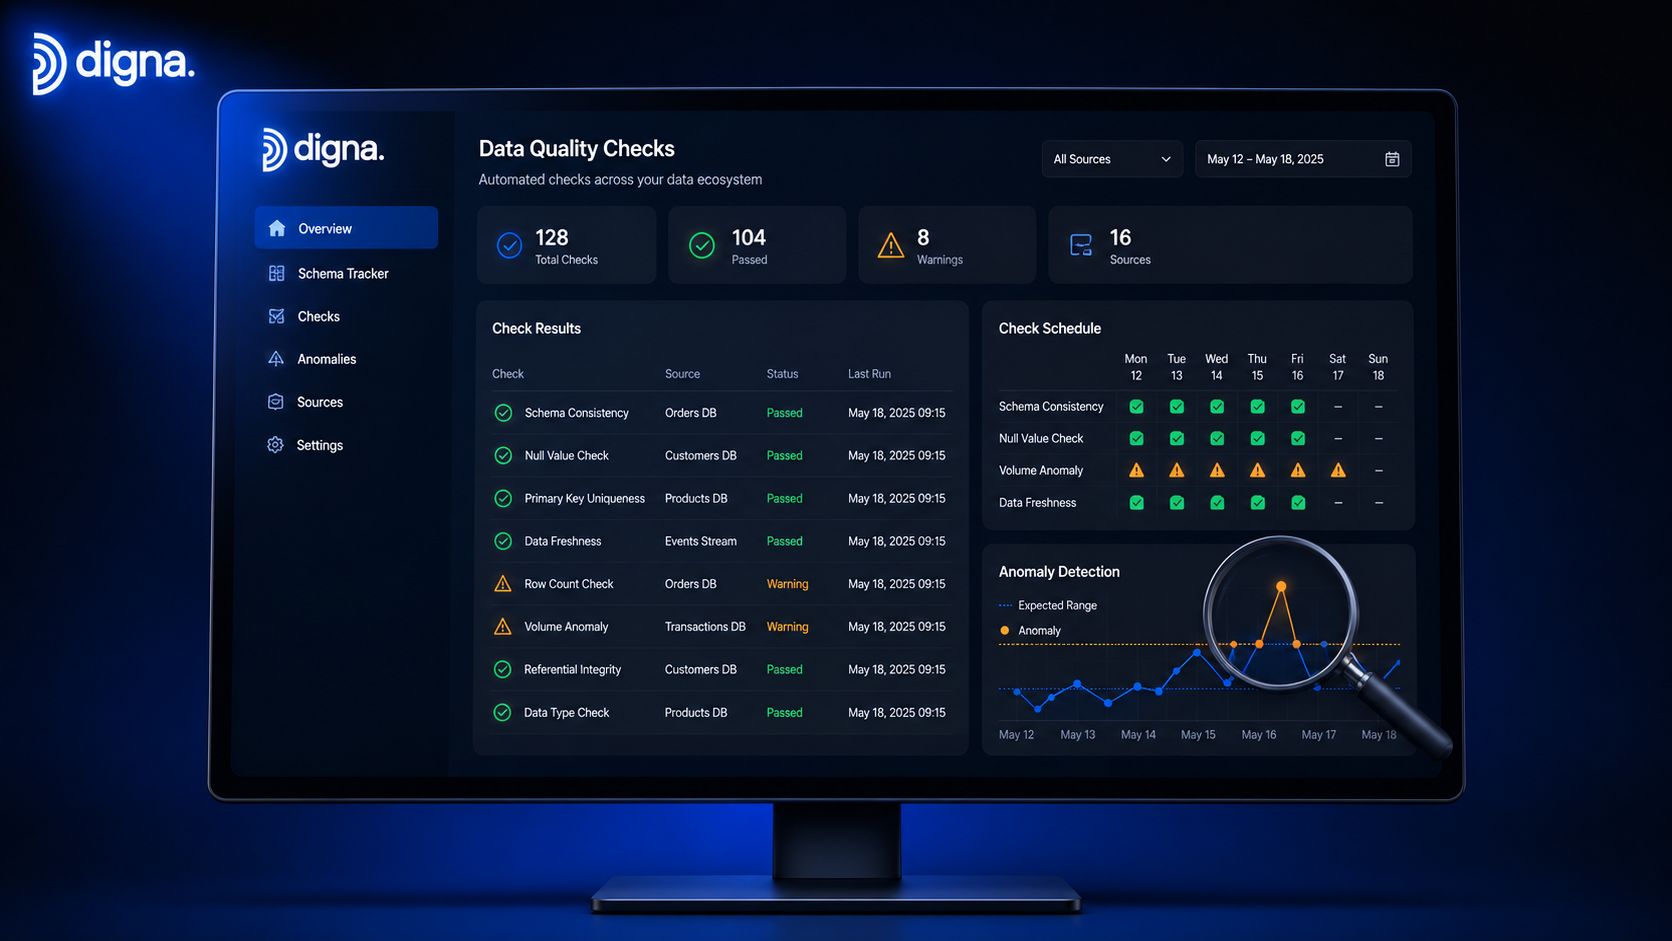
Przypisz własność (ownership) przed uruchomieniem alertów. Inżynierowie danych mogą badać nieudane ładowania, opiekunowie danych (data stewards) mogą definiować, które pola i populacje są wymagane, a właściciele biznesowi mogą decydować, czy luka blokuje raport, czy też wymaga jedynie ostrzeżenia. Używaj reguł ważności i kierowania, aby zespoły nie otrzymywały alertów o każdej niegroźnej zmianie.
Najczęściej zadawane pytania
Co to jest kompletność w jakości danych?
Kompletność to informacja o tym, czy obecne są wszystkie dane wymagane do zamierzonego celu. Obejmuje wymagane wartości, oczekiwane rekordy, odpowiednie pliki, okresy czasu i pokrycie populacji.
Jak mierzona jest kompletność danych?
Mierz obecne wymagane wartości w stosunku do oczekiwanych wymaganych wartości, obliczaj wskaźniki wartości null dla poszczególnych pól, uzgadniaj rekordy źródłowe i docelowe oraz porównuj zaobserwowane wolumeny z oczekiwanymi zakresami. Używaj osobnych metryk dla pól, rekordów, plików i populacji.
Jakie są przydatne metryki kompletności?
Przydatne metryki obejmują wskaźnik wartości null w wymaganych polach, wskaźnik kompletności, liczbę brakujących kluczy, uzgadnianie danych ze źródła do celu, status dotarcia plików, odchylenie wolumenu rekordów oraz pokrycie kategorii lub zdarzeń.
Co to jest dobry próg kompletności?
Nie ma jednego uniwersalnego progu. Ustal limit zgodnie z rolą pola, zamierzonym zastosowaniem i konsekwencjami braku danych. Podstawowy identyfikator zazwyczaj wymaga bardziej rygorystycznego traktowania niż opcjonalny atrybut opisowy.
Jak stale monitorować kompletność bez zmęczenia alertami?
Połącz stałe reguły dla kluczowych wymagań z adaptacyjnymi punktami odniesienia dla zmieniających się wolumenów. Grupuj powiązane alerty, przypisuj właścicieli, dokumentuj oczekiwane wyjątki i przeglądaj trendy historyczne przed zaostrzeniem progów.
Czym różni się kompletność od dokładności?
Kompletność pyta o to, czy wymagane dane istnieją. Dokładność pyta o to, czy dane odzwierciedlają rzeczywistość. Zbiór danych może być kompletny, ale błędny, lub dokładny tam, gdzie został uzupełniony, ale pozbawiony ważnych rekordów.
Krótki przewodnik wizualny może pomóc zespołom powiązać te praktyki z codziennym monitorowaniem:
Zacznij od sporządzenia listy danych, których wymaga Twój najważniejszy raport, model lub proces operacyjny. Następnie dodaj kontrole pól, uzgadnianie rekordów, monitorowanie wolumenu i przegląd historyczny z odpowiednią częstotliwością, zamiast polegać na pojedynczym wyniku kompletności.
digna oferuje Data Validation, Data Anomalies oraz Data Analytics, aby pomóc zespołom w egzekwowaniu reguł wymaganych pól, wykrywaniu nieoczekiwanych zmian w liczbach i wskaźnikach wartości null oraz monitorowaniu trendów kompletności w czasie we własnym środowisku. Odwiedź digna, aby poznać modułowe podejście do jakości i obserwowalności danych.