digna Demokratyzuje analizę szeregów czasowych i wykrywanie anomalii dla użytkowników biznesowych
|
6
min. czyt.
Problem z analizą szeregów czasowych dziś
Szeregi czasowe analiza tradycyjnie była domeną data scientistów.
Zrozumienie, jak dane ewoluują w czasie, identyfikacja trendów, sezonowości, zmienności i anomalii zwykle wymaga:
Python lub R
doświadczenia w modelowaniu statystycznym
zewnętrznych narzędzi lub notatników
złożonych potoków danych
Dla większości użytkowników biznesowych stanowi to barierę.
Mogą korzystać z pulpitów i raportów, ale nie potrafią odpowiedzieć na głębsze pytania, takie jak:
Czy ta zmiana jest oczekiwana czy nietypowa?
Czy w naszych danych występują powtarzające się wzorce?
Czy ten trend jest trwały, czy tymczasowy?
W rezultacie organizacje często polegają na wyspecjalizowanych zespołach w kwestii wniosków, które powinny być dostępne w całej firmie.
Dlaczego analiza szeregów czasowych ma znaczenie dla każdego zespołu
Nowoczesne środowiska danych są dynamiczne.
Dane nie zawodzą nagle, one ewoluują.
Koszty rosną stopniowo
Zachowania użytkowników zmieniają się w czasie
Metryki operacyjne dryfują
Wydajność staje się niestabilna
Bez analizy szeregów czasowych te zmiany pozostają niewidoczne, dopóki nie staną się problemami.
Dlatego zrozumienie zachowania danych w czasie nie jest już opcjonalne. To konieczność.
digna Wprowadza analizę szeregów czasowych dla użytkowników biznesowych
W najnowszej wersji digna wprowadza wbudowaną analizę szeregów czasowych i wykrywanie anomalii bezpośrednio do platformy, bez potrzeby posiadania wiedzy z zakresu data science.
Zamiast eksportować dane do zewnętrznych narzędzi, użytkownicy mogą teraz analizować trendy, wzorce i anomalie tam, gdzie dane już się znajdują.
To oznacza zmianę:
❌ Monitorowania danych
→ do
✅ Zrozumienia zachowania danych
Interaktywna analiza szeregów czasowych — bez kodowania
Nowy Wykres analityczny umożliwia użytkownikom interaktywne eksplorowanie zachowania danych.
Oferuje wbudowane metody statystyczne, które są automatycznie stosowane do Twoich zbiorów danych.
📊 Identyfikuj trendy za pomocą modeli regresji
Użytkownicy mogą stosować regresję liniową, kwadratową i sześcienną, aby zrozumieć, jak dane zmieniają się w czasie.
To pomaga odpowiadać na kluczowe pytania, takie jak:
Czy wykorzystanie rośnie w stałym tempie?
Czy wzrost przyspiesza, czy zwalnia?
Czy obserwujemy zmiany strukturalne?
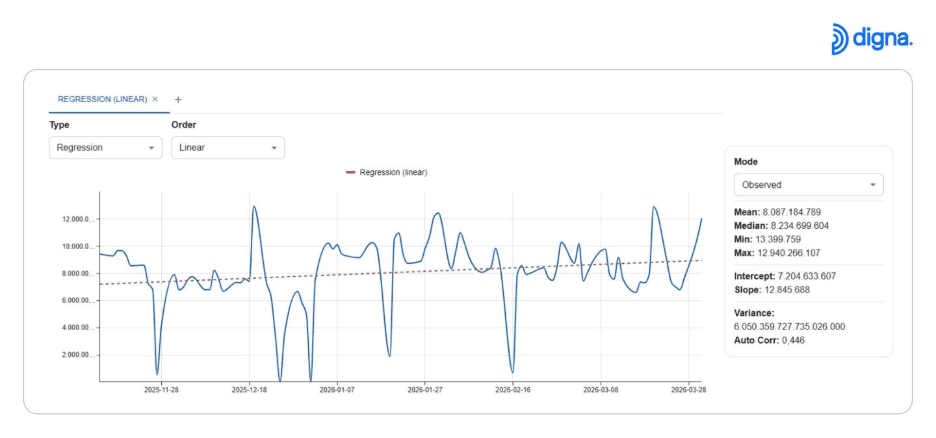
Wizualizowanie trendów za pomocą modeli regresji, aby zrozumieć długoterminowe zachowanie danych.
🔍 Wykrywaj punkty przełomu i zmiany strukturalne
Regresja odcinkowa pozwala użytkownikom identyfikować punkty, w których zmienia się zachowanie danych.
Jest to kluczowe do wykrywania:
nagłych zmian wydajności
zmian w zachowaniu użytkowników
nowych wzorców wprowadzonych przez aktualizacje systemu
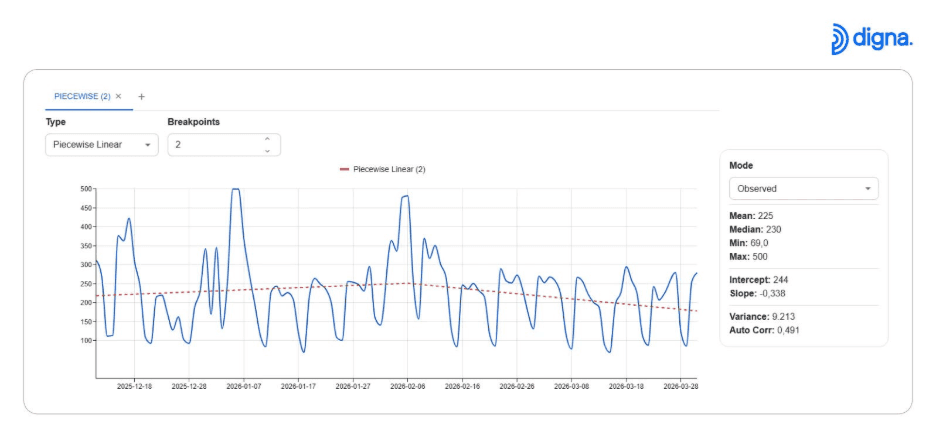
Identyfikowanie przełomów strukturalnych w danych szeregów czasowych w celu wykrywania zmian zachowań.
🔄 Odkryj sezonowość i powtarzające się wzorce
digna automatycznie wykrywa wzorce sezonowe i zachowania cykliczne.
Pomaga to zespołom odróżnić:
oczekiwane powtarzające się wzorce
prawdziwe anomalie
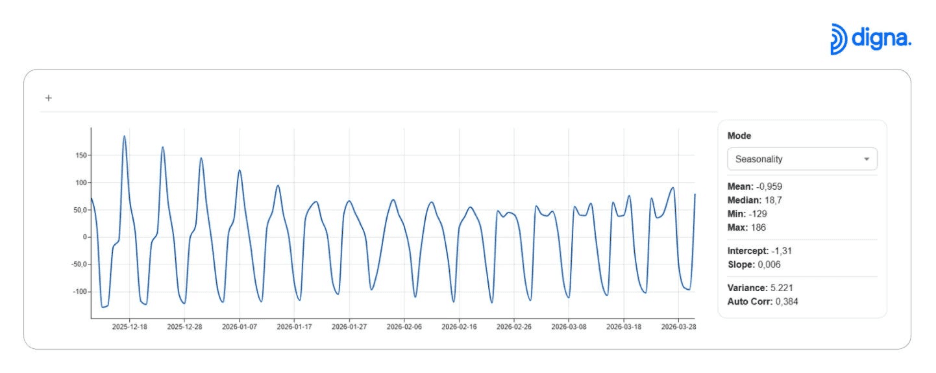
Wykrywanie powtarzających się wzorców i trendów sezonowych w danych.
📉 Analizuj zmienność i rozkład
Analiza kwantylowa i techniki wygładzania pozwalają użytkownikom zrozumieć zmienność oraz rozkład danych w czasie.
To umożliwia:
lepsze prognozowanie
lepsze wykrywanie anomalii
jaśniejsze zrozumienie zmienności
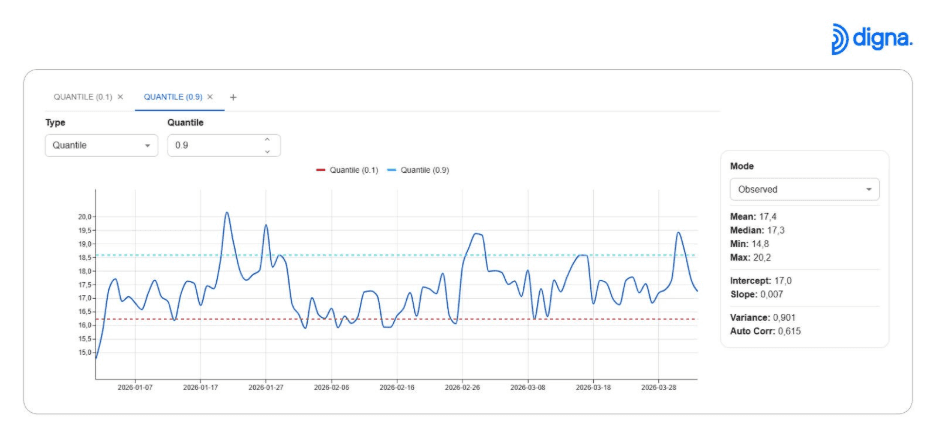
Zrozumienie zmienności i rozkładu za pomocą analizy kwantylowej.
Wbudowane wykrywanie anomalii — bez reguł
Tradycyjne wykrywanie anomalii opiera się na predefiniowanych regułach:
progi
statyczne warunki
ręcznie definiowane kontrole
Takie podejścia nie skalują się dobrze we współczesnych środowiskach.
digna stosuje inne podejście.
Dzięki metodom uczenia statystycznego, potrafi:
uczyć się, jak dane zachowują się w czasie
identyfikować odchylenia od oczekiwanych wzorców
wykrywać zarówno nagłe skoki, jak i stopniowy dryf
Pozwala to zespołom wcześniej identyfikować problemy, bez utrzymywania tysięcy reguł.
Od zależności od data science do analityki samoobsługowej
Jednym z największych efektów tej wersji jest demokratyzacja.
Użytkownicy biznesowi nie muszą już polegać na data scientistach, aby:
analizować trendy
wykrywać anomalie
rozumieć zachowania
Zamiast tego mogą:
eksplorować dane bezpośrednio
sami interpretować wzorce
podejmować szybsze decyzje
To zmniejsza wąskie gardła i przyspiesza generowanie wniosków w całej organizacji.
Dlaczego to ma znaczenie dla nowoczesnych przedsiębiorstw
Wraz ze skalowaniem systemów danych rośnie złożoność.
Organizacje potrzebują:
szybszego generowania wniosków
lepszej widoczności zachowania danych
skalowalnego monitorowania bez ręcznego wysiłku
Łącząc analizę szeregów czasowych i wykrywanie anomalii wewnątrz platformy, digna umożliwia zespołom:
wcześniej wykrywać problemy
szybciej rozumieć przyczyny źródłowe
zmniejszyć zależność od zewnętrznych narzędzi
utrzymywać jakość danych na dużą skalę
Analiza w bazie danych — bez przenoszenia danych
Cała analityka i walidacja w digna są wykonywane bezpośrednio w źródłowej bazie danych.
To zapewnia:
wysoką wydajność
wysokie bezpieczeństwo
zgodność z politykami governance danych
W przeciwieństwie do innych narzędzi nie ma potrzeby eksportowania danych do analizy.
Końcowe przemyślenia
Analiza szeregów czasowych i wykrywanie anomalii nie powinny być ograniczone wyłącznie do data scientistów.
W miarę jak dane stają się centralne dla każdej funkcji biznesowej, zrozumienie, jak zachowują się w czasie, musi stać się dostępne dla wszystkich.
Dzięki tej wersji digna udostępnia zaawansowaną analitykę bezpośrednio użytkownikom biznesowym, umożliwiając im wyjście poza monitoring i dojście do prawdziwego zrozumienia danych.
Dowiedz się więcej
Dowiedz się więcej o podejściu digna do jakości danych i observability:
Lub zapoznaj się z pełnymi szczegółami wydania:
👉 https://docs.digna.ai/changelog/Release_202604/
Opisane tu metody regresji, sezonowości i kwantyli należą do modułu digna śledzącego zachowanie danych w czasie, który szczegółowo przedstawia przegląd digna Data Analytics.
Najczęściej zadawane pytania
Czy użytkownicy biznesowi mogą analizować szeregi czasowe bez programowania?
Tak, dzięki Analytics Chart w digna. Zamiast Pythona lub R, wiedzy z modelowania statystycznego, notebooków czy złożonych potoków użytkownicy interaktywnie badają trendy, sezonowość i anomalie w samej platformie, a wbudowane metody statystyczne są automatycznie stosowane do ich zbiorów danych. Znika zależność od data scientistów przy codziennych pytaniach.
Jakie modele regresji obsługuje Analytics Chart w digna?
Analytics Chart obsługuje regresję liniową, kwadratową i sześcienną do analizy trendów oraz regresję odcinkową do wykrywania punktów załamania. Pozwalają one ocenić, czy wykorzystanie rośnie równomiernie, czy wzrost przyspiesza lub zwalnia i gdzie zmiany strukturalne, na przykład po aktualizacji systemu, zmieniły zachowanie danych.
Jak digna odróżnia sezonowość od prawdziwych anomalii?
digna automatycznie wykrywa wzorce sezonowe i zachowania cykliczne, więc powtarzające się wahania są rozpoznawane jako oczekiwane, a nie zgłaszane. Wykrywanie anomalii wykorzystuje uczenie statystyczne do modelowania zachowania danych w czasie i identyfikuje odchylenia, zarówno nagłe skoki, jak i stopniowy dryf, bez ręcznie utrzymywanych reguł.
Dlaczego wykrywanie anomalii oparte na regułach nie wystarcza?
Wykrywanie oparte na regułach opiera się na progach, statycznych warunkach i ręcznie definiowanych kontrolach, które nie skalują się w nowoczesnych środowiskach danych. Artykuł zestawia je z podejściem digna opartym na uczeniu statystycznym, które uczy się oczekiwanego zachowania i wychwytuje zarówno stopniowy dryf, jak i nagłe skoki, bez utrzymywania tysięcy reguł.
Czy digna eksportuje dane do analizy szeregów czasowych?
Nie. Wszystkie analizy i walidacje w digna są wykonywane bezpośrednio w źródłowej bazie danych, więc dane nigdy nie muszą trafiać do zewnętrznych narzędzi ani notebooków. Artykuł wskazuje trzy zalety podejścia in-database: wysoką wydajność, silne bezpieczeństwo i zgodność z obowiązującymi politykami data governance.


