Czym jest schemat w bazie danych? Przewodnik na 2026 rok
|
8
min. czyt.

Najprawdopodobniej nie sprawdzasz, czym jest schemat, z ciekawości teorii baz danych. Szukasz odpowiedzi, ponieważ coś w dalszej części przepływu danych wydaje się kruche. Dashboard przestał działać po rutynowym wdrożeniu. Pipeline zaczął zawodzić na tabeli, która „się nie zmieniła”. Model nadal generował wyniki, ale przestały one mieć sens.
To praktyczny powód, by interesować się schematami. Uwagę zwykle przyciągają wartości danych, podczas gdy struktura wokół nich zmienia się niezauważenie w tle. Właśnie tam zaczyna się wiele kosztownych awarii.
Jeśli najpierw chcesz podręcznikowej odpowiedzi, oto ona: schemat bazy danych to strukturalny plan, który określa sposób organizacji danych, w tym tabele, kolumny, typy danych, ograniczenia i relacje, takie jak klucze obce, zgodnie z opisem w definicji struktury schematu bazy danych według Oracle. Ta definicja to jednak dopiero punkt wyjścia. W rzeczywistych systemach schemat jest również kontraktem. Gdy ten kontrakt zmienia się bez kontroli, skutki jako pierwsze odczuwają zwykle pipeline’y, dashboardy i systemy ML.
Spis treści
Cicha awaria stojąca za niedziałającym dashboardem
Typowa awaria zaczyna się w zupełnie zwyczajny poranek. Programista BI otwiera dashboard przychodów i widzi puste pola tam, gdzie jeszcze wczoraj były trendy. Data engineer sprawdza warstwę orkiestracji i odkrywa, że jedna z dalszych transformacji zakończyła się błędem. System źródłowy działa. Moc obliczeniowa jest w porządku. Nic nie wygląda na przeciążone.
Przyczyna okazuje się mniejsza, niż ktokolwiek się spodziewał. Zespół po stronie źródła zmienił nazwę kolumny, usunął pole lub zmienił typ z wartości liczbowych na ciągi znaków. Nikt tego nie ogłosił. Żadna migracja nie dotarła do zespołu analitycznego. Pipeline nie był przeciążony ani źle skonfigurowany. Oczekiwał jednej struktury, a otrzymał inną.
Dlatego wprowadzające wyjaśnienia schematów często wydają się niepełne. Opisują schemat jako strukturę, co jest prawdą, ale nie dochodzą do konsekwencji operacyjnych. Najnowsze analizy branżowe wskazują, że od 60 do 70 procent awarii pipeline’ów danych wynika z nieoczekiwanych zmian schematu, a nie z problemów z wolumenem danych, na co zwraca uwagę omówienie ryzyka związanego ze schematem przez Cockroach Labs.
Dlaczego te awarie trudno zdiagnozować
Incydenty związane ze schematem są kłopotliwe, ponieważ nie zawsze kończą się głośnym błędem. Czasem zadanie przerywa się podczas parsowania. Czasem transformacja niezauważenie pomija pole. Czasem dashboard nadal się ładuje, ale metryka jest już błędna, ponieważ złączenie przestało pasować albo rzutowanie zaczęło zwracać wartości null.
Większość zespołów monitoruje liczbę wierszy i aktualność danych, zanim zacznie monitorować strukturę. To odwrotna kolejność, skoro od struktury zależy każde założenie w dalszej części przepływu.
Niedziałający dashboard jest zwykle tylko widocznym objawem. Właściwy problem leży poziom niżej, w kontrakcie określającym, jak dane mają wyglądać.
Prawdziwa lekcja
Jeśli monitorujesz wyłącznie wartości, przeoczysz dużą klasę awarii. Schematy zasługują na taką samą uwagę operacyjną jak kod, zadania i infrastruktura. Dla nowoczesnych zespołów danych pytanie „czym jest schemat w bazie danych” nie jest akademickie. To pytanie o niezawodność.
Plan Twojej bazy danych
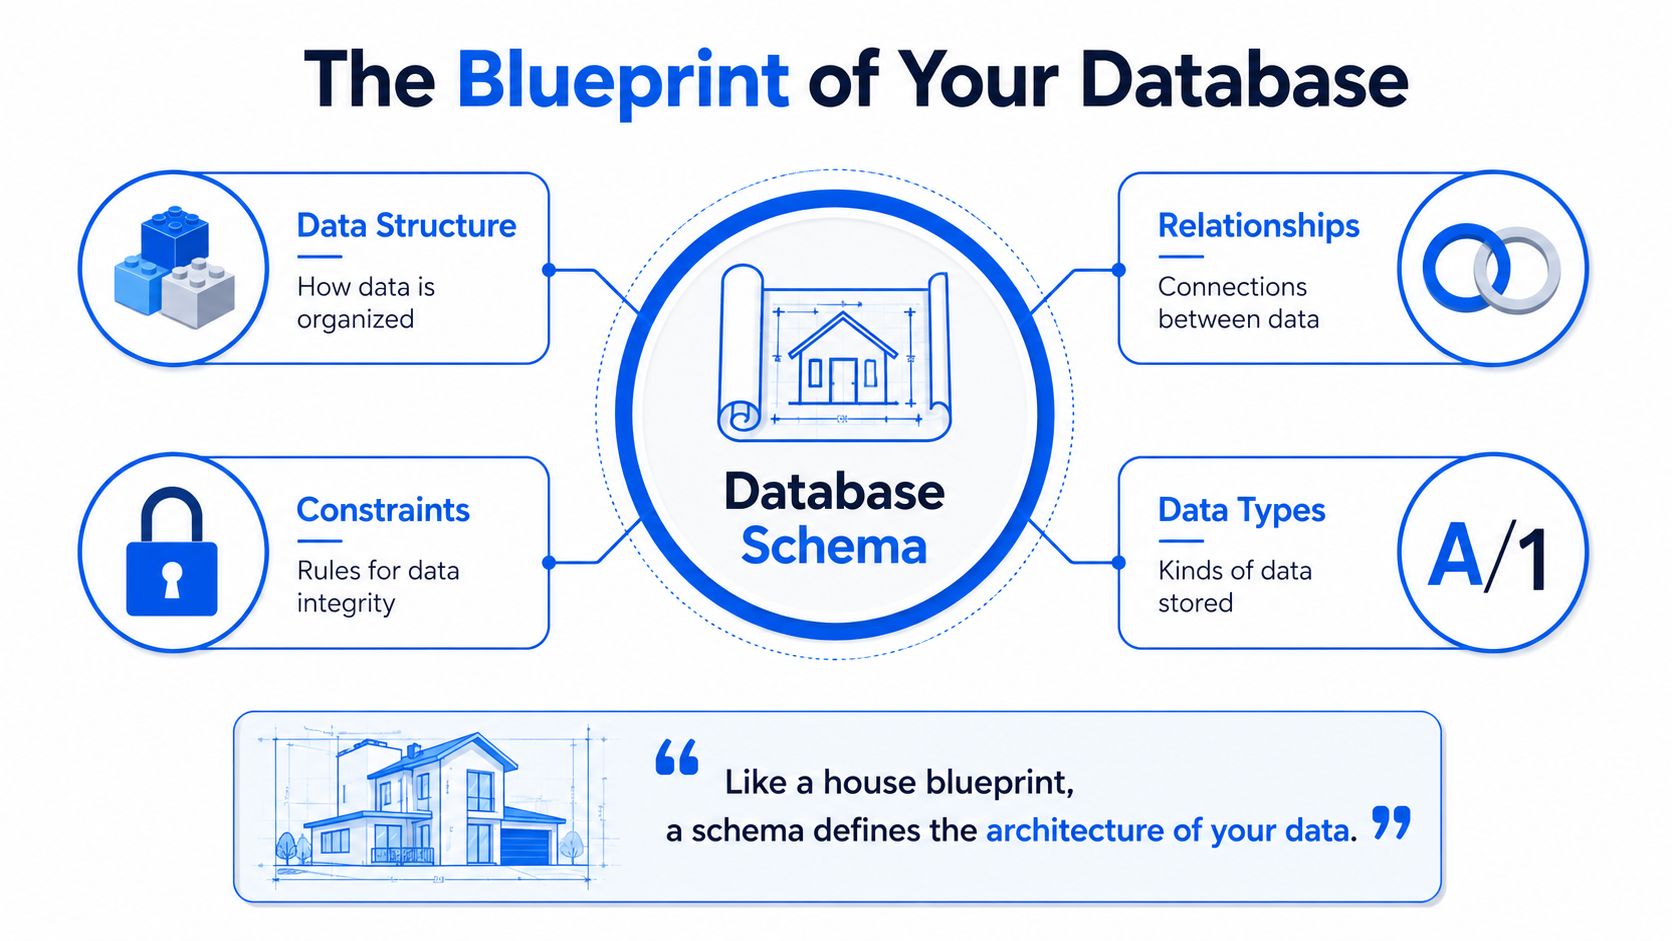
Najprościej zrozumieć schemat, traktując go jak plan budynku. Plan nie zawiera mebli ani ludzi w domu. Określa pomieszczenia, drzwi, ściany nośne oraz zasady, których musi przestrzegać budowa.
W relacyjnej bazie danych formalna wersja jest bardziej rygorystyczna. W relacyjnych systemach zarządzania bazami danych schemat jest formalnie definiowany jako zbiór ograniczeń integralności, czyli formuł logicznych zapobiegających wstawianiu danych naruszających reguły strukturalne, i pełni funkcję niezawierającego danych planu tabel, pól, typów danych i relacji, jak wyjaśnia przegląd schematów baz danych od IBM.
Co faktycznie obejmuje ten plan
Praktyczny schemat zwykle definiuje kilka podstawowych elementów:
Tabele reprezentują główne przechowywane encje, takie jak
customers,ordersczypayments.Kolumny definiują atrybuty każdej tabeli, na przykład
customer_id,emaillubcreated_at.Typy danych określają, jakiego rodzaju wartość może przechowywać każda kolumna, np. liczbę całkowitą, tekst lub znacznik czasu.
Ograniczenia wymuszają reguły takie jak
PRIMARY KEY,NOT NULLczy unikalność.Relacje łączą tabele za pomocą kluczy, zwykle poprzez odwołania kluczy obcych.
Wracając do analogii planu budynku: tabele to pomieszczenia, kolumny to elementy wyposażenia, typy danych to specyfikacje materiałów, a ograniczenia to wymogi przepisów budowlanych, które zapobiegają wadliwej konstrukcji.
Dlaczego ograniczenia mają znaczenie na produkcji
Sformułowanie „zbiór ograniczeń integralności” brzmi abstrakcyjnie, dopóki nie zmierzysz się ze złymi danymi. Ograniczenia zatrzymują niektóre klasy błędów, zanim trafią one do bazy danych. Klucz główny zapobiega zduplikowanym tożsamościom. Klucz obcy zapobiega osieroconym rekordom. Ograniczenie typu nie pozwala, by kolumna ze znacznikiem czasu przyjmowała dowolny tekst.
Ma to znaczenie, ponieważ zapobieganie jest tańsze niż sprzątanie. Gdy baza danych wymusza reguły strukturalne w momencie zapisu, dalsze zadania nie muszą zgadywać, czy kluczowe założenia nadal obowiązują.
Element schematu | Co robi | Typowa awaria przy braku zarządzania |
|---|---|---|
Definicja tabeli | Porządkuje dane encji | Brakujące lub zduplikowane pojęcia domenowe |
Definicja kolumny | Opisuje każdy atrybut | Niedziałające transformacje po zmianie nazw |
Typ danych | Kontroluje dozwolony format wartości | Błędy rzutowania, nadmiar wartości null, błędne agregacje |
Ograniczenie | Wymusza integralność | Duplikaty, nieprawidłowe odwołania, niespójne rekordy |
Relacja | Łączy encje w różnych tabelach | Nieprawidłowe złączenia i mylące raporty |
Praktyczna zasada: Jeśli pole jest na tyle ważne, by po nim łączyć, filtrować lub zasilać nim model, jego definicję w schemacie należy traktować jako część kontraktu produkcyjnego.
Co działa, a co nie
Sprawdza się jawna struktura. Jasno określona własność tabel. Przeglądane zmiany DDL. Ograniczenia odpowiadające rzeczywistości biznesowej.
Nie sprawdza się traktowanie schematu jak dokumentacji, którą tworzy się raz i o niej zapomina. Plan chroni tylko wtedy, gdy zespoły utrzymują jego zgodność z budynkiem, który zmieniają.
Schematy koncepcyjne, logiczne i fizyczne
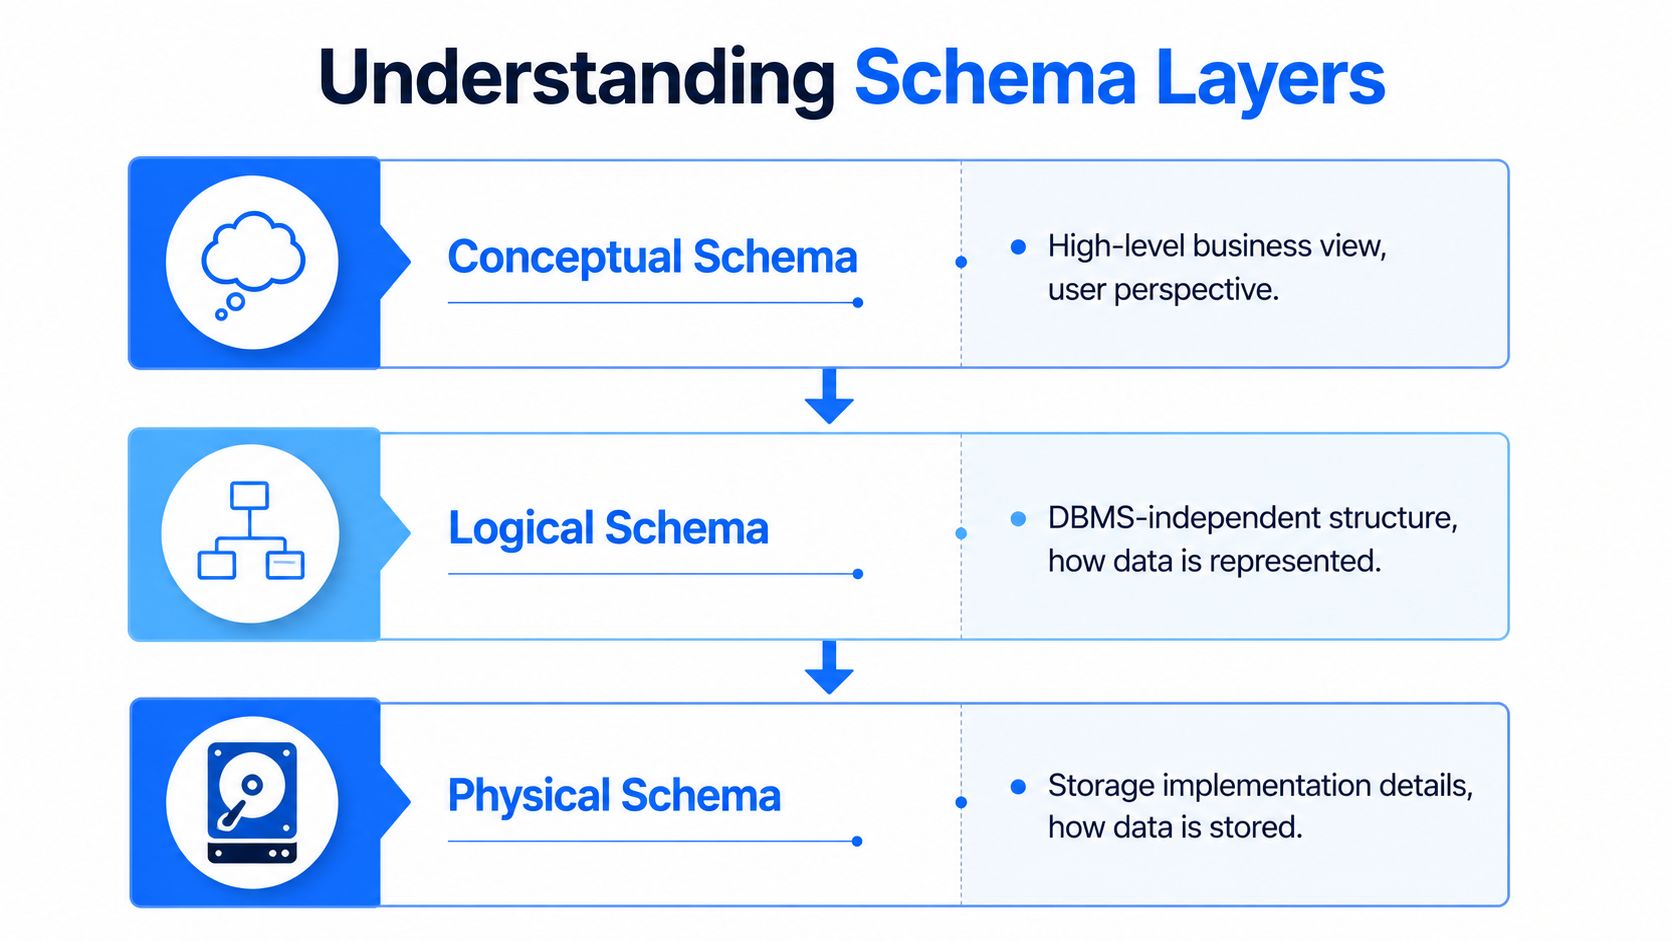
Schemat bazy danych zwykle przedstawia się jako definicję sposobu organizacji danych. W praktyce ta definicja istnieje na kilku poziomach, a każdy z nich wpływa na inny rodzaj decyzji. Jeśli zespół je miesza, zmiany schematu trudniej przeglądać, odpowiedzialność się rozmywa, a ryzyko produkcyjne rośnie.
Standardowy trójwarstwowy model pochodzi z architektury ANSI/SPARC: koncepcyjny, logiczny i fizyczny. Przegląd architektury trzech schematów od IBM to jeden z przykładów zastosowania tego modelu w praktyce.
Jeden przykład e-commerce w trzech warstwach
Jako konkretny przykład weźmy system handlowy.
Na poziomie koncepcyjnym biznes definiuje podstawowe obiekty: klientów, produkty, zamówienia i płatności. Ta warstwa oddaje znaczenie i reguły domeny biznesowej. Odpowiada na pytania, czym jest zamówienie, kim jest klient i czy zwrot należy do płatności, czy do zamówień.
Na poziomie logicznym ten biznesowy obraz staje się modelem danych. Inżynierowie definiują encje, atrybuty, klucze i relacje, takie jak customers do orders, orders do order_items oraz payments do orders. Nacisk kładzie się na strukturę i spójność, a nie na szczegóły przechowywania.
Na poziomie fizycznym projekt staje się wykonywalny w konkretnym silniku bazy danych. Pojawiają się tu typy danych, indeksy, klastrowanie, partycjonowanie, układ plików i opcje specyficzne dla silnika. To tutaj wydajność, koszt przechowywania i zachowanie operacyjne zaczynają się różnić między systemami, które na tablicy wyglądają podobnie.
Dlaczego te rozróżnienia mają znaczenie na produkcji
Każda warstwa zawodzi w inny sposób.
Błąd koncepcyjny daje niewłaściwy obiekt biznesowy. Błąd logiczny powoduje niedziałające złączenia, zduplikowane encje lub modele, które analitycy obchodzą własnym SQL. Błąd fizyczny spowalnia zapytania, zwiększa zajętość pamięci i zamienia rutynowe zmiany schematu w ryzykowne migracje.
Ten podział pomaga też w reagowaniu na incydenty. Jeśli dashboard przestaje działać, ponieważ customer_tier przeniesiono z jednej tabeli do drugiej, problem jest logiczny. Jeśli dashboard nadal działa, ale czas zapytań rośnie po zmianie partycjonowania, problem jest fizyczny. Jeśli dwa zespoły nie zgadzają się, czy użytkownicy wersji próbnej są klientami, problem jest koncepcyjny. Właściwe określenie warstwy skraca naprawę.
Schemat jako przestrzeń nazw
Systemy relacyjne używają słowa schemat także w drugim znaczeniu: jako przestrzeni nazw obiektów, takiej jak finance, sales czy analytics. Na platformach takich jak SQL Server i PostgreSQL taka przestrzeń nazw grupuje tabele, widoki i inne obiekty w nazwanej granicy z własnymi regułami dostępu.
Ma to znaczenie operacyjne. Projekt przestrzeni nazw wpływa na zarządzanie uprawnieniami, izolację wdrożeń i własność obiektów. Zespół może przechowywać tabele z poufnymi danymi medycznymi w jednym schemacie, a opracowane widoki raportowe publikować w innym. Dobrze zrobione, zmniejsza to ryzyko przypadkowego ujawnienia danych i ułatwia egzekwowanie odpowiedzialności.
Haczyk polega na tym, że inżynierowie często używają tego samego słowa dla obu pojęć. Czasem „zmiana schematu” oznacza zmianę typu kolumny. Czasem oznacza przeniesienie obiektu z staging do analytics. To różne zdarzenia o różnym zasięgu skutków. Traktowanie ich jako jednego sprawia, że przeglądy pomijają wpływ na dalsze systemy, a dryf schematu zamienia się później w niedziałające pipeline’y.
Schema-on-Write a Schema-on-Read
Nie każdy system nakłada strukturę na tym samym etapie. Właśnie tu wiele dyskusji o tym, „czym jest schemat w bazie danych”, nabiera nowoczesnego charakteru. Odpowiedź zmienia się w zależności od tego, kiedy wymuszasz kontrakt.
Schema-on-Write
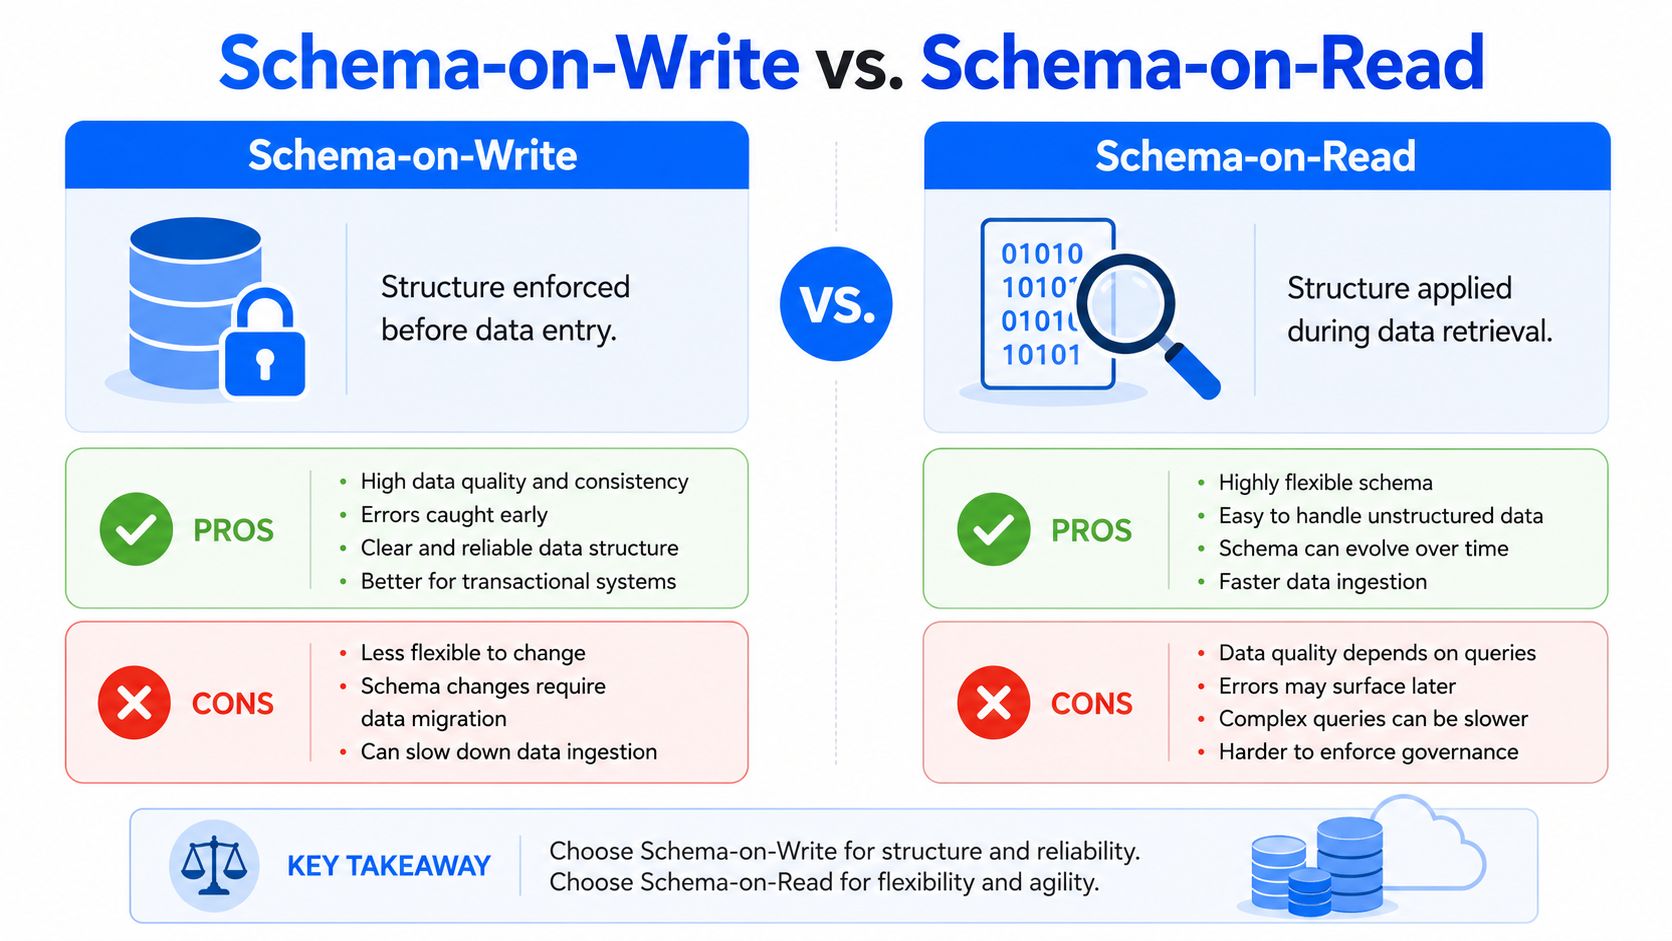
Tradycyjne systemy relacyjne zwykle stosują podejście schema-on-write. Dane muszą odpowiadać oczekiwanej strukturze, zanim baza danych je przyjmie. Jeśli tabela oczekuje znacznika czasu, a otrzymuje nieprawidłowy tekst, zapis powinien się nie powieść lub zostać odrzucony w ramach kontrolowanej transformacji.
Ta sztywność jest przydatna w systemach transakcyjnych. Płatności, zamówienia, salda kont i rekordy tożsamości korzystają ze ścisłej struktury, ponieważ ich odbiorcy potrzebują bardziej spójności niż elastyczności.
Zalety
Wysoka integralność przy pozyskiwaniu: nieprawidłowe rekordy są blokowane wcześnie.
Czystsze wykorzystanie w dalszych etapach: analitycy i aplikacje pracują z przewidywalnymi strukturami.
Jasne kontrakty: producenci i odbiorcy wiedzą, jakiego kształtu danych się spodziewać.
Wady
Wolniejsza adaptacja: zmiana modelu zwykle wymaga zaplanowania migracji.
Więcej koordynacji: zespoły po stronie źródła i odbiorców muszą się uzgodnić przed wdrożeniem.
Mniejsza tolerancja przy pozyskiwaniu surowych danych: dane półstrukturalne wymagają wstępnego przetworzenia.
Schema-on-Read
Jeziora danych i strefy surowych danych często stosują podejście schema-on-read. Zespoły najpierw pozyskują dane, a strukturę nakładają później, podczas odpytywania lub transformacji. Sprawdza się to dobrze, gdy dane wejściowe są zróżnicowane, półstrukturalne lub szybko się zmieniają.
Elastyczność jest realna. Podobnie jak ryzyko operacyjne. Jeśli każdy odbiorca inaczej wnioskuje strukturę, ten sam surowy zbiór danych może prowadzić do wielu interpretacji.
Podejście | Najlepsze zastosowanie | Główna zaleta | Główne ryzyko |
|---|---|---|---|
Schema-on-Write | Systemy transakcyjne, opracowane hurtownie danych | Spójność przed zapisem | Sztywność podczas zmian |
Schema-on-Read | Surowe jeziora danych, analityka eksploracyjna, zróżnicowane pozyskiwanie | Elastyczność przy przyjmowaniu danych | Niespójna interpretacja w dalszych etapach |
Co sprawdza się w praktyce
Błędem nie jest wybór jednego lub drugiego podejścia. Błędem jest założenie, że przy schema-on-read zarządzanie schematem przestaje być potrzebne. Tak nie jest. Nadal potrzebujesz kontraktów, katalogowania, walidacji i monitorowania zmian. W przeciwnym razie jezioro danych staje się miejscem, w którym odbiorcy wciąż na nowo odkrywają te same strukturalne niespodzianki.
Praktycznym wzorcem jest akceptowanie elastyczności przy pozyskiwaniu, a następnie wymuszanie silniejszej struktury w miarę przechodzenia danych do opracowanych warstw. Daje to zespołom swobodę szybkiego pozyskiwania danych, nie pozwalając, by dalsza analityka i modele opierały się na domysłach.
Gdy plany się zmieniają: ewolucja i dryf schematu
Żaden produkcyjny schemat nie pozostaje zamrożony. Produkty zyskują nowe funkcje. API się zmieniają. Aplikacje źródłowe wersjonują swoje dane. Regulacje wymuszają nowe pola. Zespoły dzielą jedną tabelę na trzy lub łączą dziesięć w jedną. Sama zmiana nie jest problemem.
Problemem jest to, czy zmiana jest celowa i widoczna.
Ewolucja schematu a dryf schematu
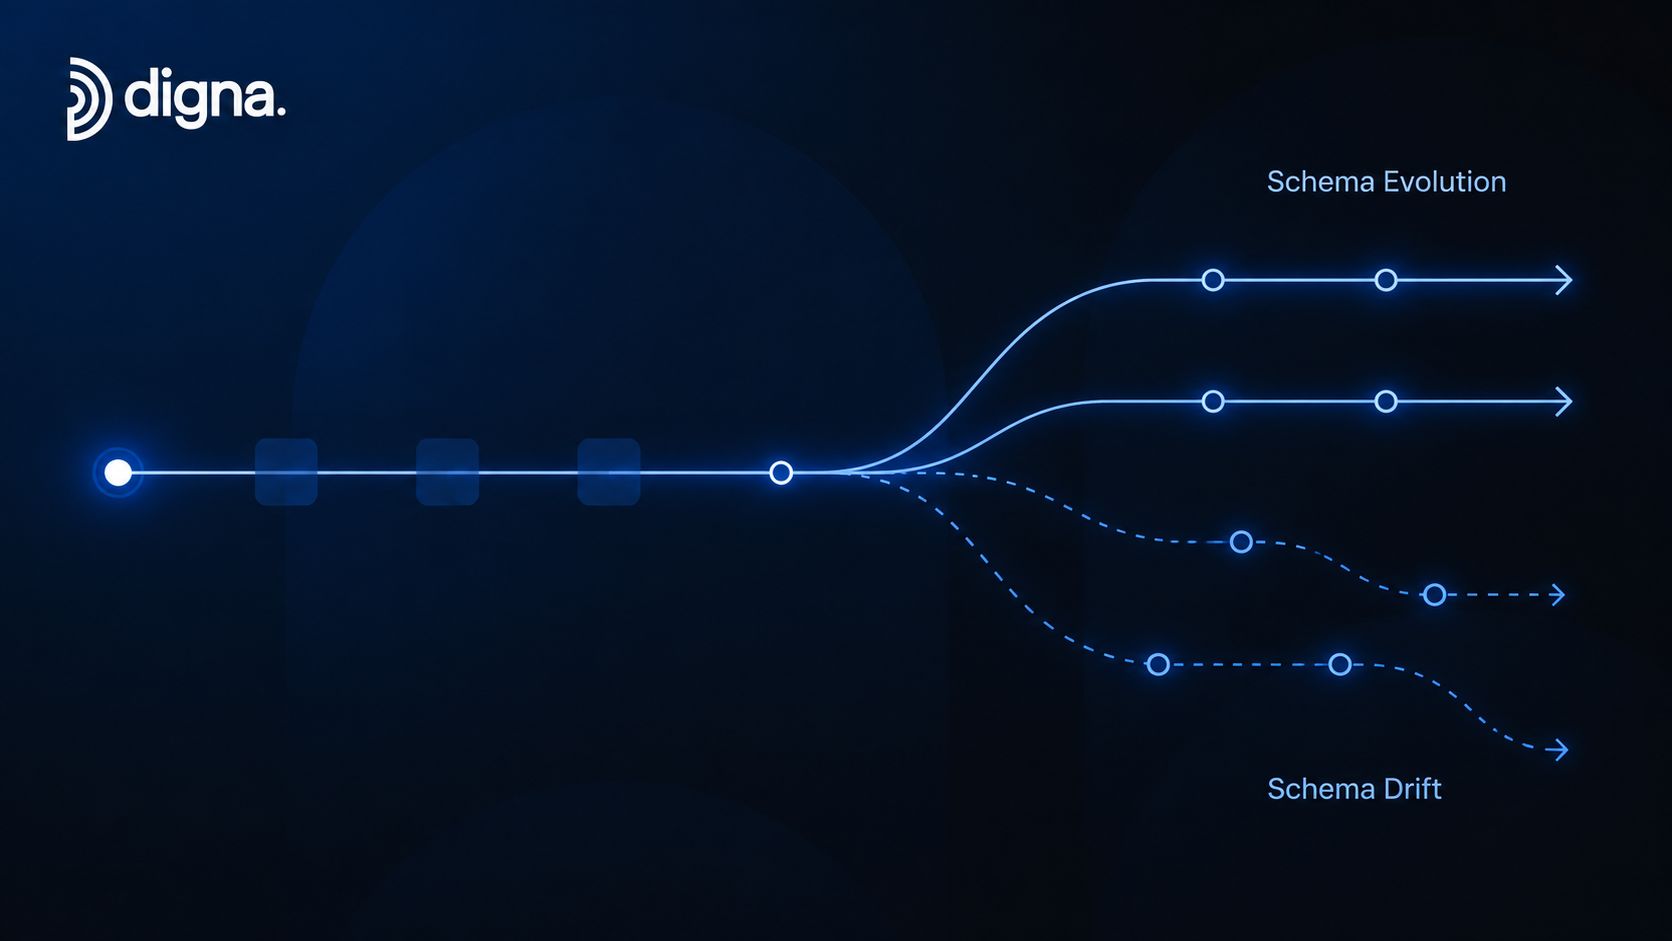
Ewolucja schematu to zmiana zaplanowana. Zespół wprowadza nową kolumnę dopuszczającą wartości null, publikuje migrację, aktualizuje kontrakt i koordynuje działania z odbiorcami. Może to nadal wymagać pracy, ale przynajmniej zmiana jest zamierzona.
Dryf schematu to sytuacja, w której kolumny są dodawane, usuwane lub modyfikowane bez odpowiedniej kontroli migracji. Zgodnie z tym wyjaśnieniem dryfu schematu i awarii w dalszych systemach takie zmiany mogą nieoczekiwanie zakłócić działanie aplikacji odbiorczych.
Jeśli chcesz dokładniej poznać ten mechanizm awarii, przydatny będzie przewodnik o tym, jak zmiany strukturalne psują pipeline’y danych, ponieważ przedstawia dryf jako problem niezawodności operacyjnej, a nie tylko modelowania.
Pięć typowych przyczyn w rzeczywistych systemach
Oto przyczyny, z którymi spotykam się najczęściej:
Prace nad funkcjami w aplikacjach źródłowych
Zespoły produktowe dodają pola na potrzeby nowych procesów, ale odbiorcy analityczni nigdy nie dowiadują się o wdrożeniu.Zmiany typów podczas refaktoryzacji usług
Usługa zaczyna emitować identyfikatory jako ciągi znaków zamiast wartości liczbowych albo zmienia się format pola daty.Zmiany w API dostawców zewnętrznych
Dostawcy dodają zagnieżdżone atrybuty, wycofują pola lub zmieniają nazwy kluczy w danych.Nieprzejrzane ręczne zmiany w bazie danych
Ktoś uruchamia DDL bezpośrednio na produkcji lub we współdzielonym środowisku bez ścieżki migracji.Rozbieżności między środowiskami
Środowiska dev, staging i produkcyjne przestają być zgodne, więc zachowanie pipeline’u zmienia się po wdrożeniu.
Jak wygląda zdrowa ewolucja
Dobra ewolucja pozostawia ślad. DDL jest wersjonowany. Odbiorcy wiedzą, co się zmieniło. Dla tabel o dużym znaczeniu istnieją okresy zachowania kompatybilności. Po wdrożeniu uruchamiane są kontrole walidacyjne.
Zaplanowana zmiana schematu to normalna praca inżynierska. Nieśledzona zmiana schematu to paliwo dla incydentów.
To rozróżnienie ma znaczenie, ponieważ oba zdarzenia mogą wyglądać identycznie na poziomie tabeli. Różnica tkwi w nadzorze, widoczności i w tym, czy ktokolwiek po stronie odbiorców miał szansę się przygotować.
Wysoki koszt cichych zmian schematu
Zmiana schematu staje się kosztowna w chwili, gdy dalsze systemy zakładają, że stara struktura nadal obowiązuje. Podręcznikowa definicja schematu jest prosta: określa tabele, kolumny, typy i relacje. Na produkcji decyduje on też o tym, czy dashboard jest wiarygodny, czy pipeline cech nadal odpowiada założeniom z treningu i czy inżynierowie spędzą popołudnie na dostarczaniu pracy, czy na usuwaniu skutków awarii.

Scenariusz pierwszy: pipeline szybko zawodzi
To widoczny tryb awarii. Kolumna źródłowa zostaje usunięta lub zmienia nazwę. Transformacja odwołuje się do starego pola. Zadanie kończy się błędem, uruchamiają się alerty, a dyżurny inżynier ma konkretny błąd do prześledzenia.
Taka awaria jest kosztowna, ale przynajmniej ma ograniczony zasięg. Zespół porównuje wersje, poprawia transformację, ponownie uruchamia zadanie i wyjaśnia opóźnienie użytkownikom. Tracisz czas inżynierów i aktualność danych, ale zwykle nie tracisz zaufania na długo, ponieważ awaria jest oczywista.
Scenariusz drugi: dashboard działa, ale wprowadza w błąd
To incydent, którego zespoły nie doceniają.
Zmiana typu, niezgodność kluczy lub zmienione zachowanie wartości null mogą pozostawić pipeline na zielono, podczas gdy metryka staje się błędna. Złączenie nadal się wykonuje, ale pasuje mniej wierszy. Rzutowanie nadal działa, ale nieprawidłowe wartości zamieniają się w null. Przychody trafiają do niewłaściwej kategorii albo KPI spada z powodów, które nie mają nic wspólnego z biznesem.
Gdy do tego dochodzi, problem opuszcza platformę danych i wkracza w proces decyzyjny. Analitycy zaczynają śledzić logikę modelu, tabele hurtowni i źródła danych. Menedżerowie kwestionują liczbę, zanim ktokolwiek zakwestionuje schemat. Kosztem nie są już tylko zasoby obliczeniowe czy godziny pracy inżynierów. To wolniejsze decyzje, powtarzana praca walidacyjna i mniejsze zaufanie do każdego raportu opartego na tym zbiorze danych.
Ciche problemy ze schematem są niebezpieczne, ponieważ wynik nadal wygląda na użyteczny.
Dlatego zarządzanie schematem należy do obszaru niezawodności, a nie tylko dokumentacji.
Scenariusz trzeci: system ML degraduje się bez wyraźnego błędu
Pipeline’y ML są mniej wyrozumiałe niż wiele procesów raportowych. Model może nadal generować wyniki, podczas gdy zestaw cech odbiega od tego, czego oczekiwano podczas treningu.
Pole liczbowe przychodzi jako tekst. Wartość kategoryczna otrzymuje nowe kodowanie. Rzadko wypełniana kolumna zaczyna być wypełniana inaczej po wdrożeniu aplikacji. Żadna z tych zmian nie musi zgłosić wyjątku, by wyrządzić szkody. Mogą one przesunąć rozkłady cech, naruszyć założenia zawarte w przetwarzaniu wstępnym i wywołać rozbieżność między treningiem a inferencją, której diagnoza zajmuje dni.
W praktyce dryf schematu staje się problemem operacji AI. Zespoły potrzebują kontroli struktury cech, zanim wynik modelu zostanie uznany za wiarygodny. Proces śledzenia zmian schematu dla produkcyjnych zasobów danych pomaga wychwycić takie zmiany, zanim dotrą do dalszych zadań scoringu lub ponownego trenowania.
Koszty odczuwalne nawet bez zgłoszonego incydentu
Nawet gdy nikt nie zgłasza incydentu, rachunek i tak przychodzi:
Przerwy w pracy inżynierów: data engineerowie i analytics engineerowie przerywają zaplanowaną pracę, by śledzić niezgodności strukturalne między systemami.
Utrata zaufania: użytkownicy biznesowi zaczynają żądać ręcznej weryfikacji, zanim podejmą działania na podstawie liczb z dashboardu.
Tarcia przy wdrożeniach: każda zmiana po stronie źródła wydaje się ryzykowna, ponieważ jej wpływ na dalsze systemy trudno przewidzieć.
Marnotrawstwo pamięci i zapytań: słaba dyscyplina schematu często prowadzi do zduplikowanych pól, niespójnych typów, szerszych niż potrzeba tabel i droższych wzorców przetwarzania.
Co działa, a co zawodzi
Zespoły osiągają lepsze wyniki, gdy traktują zmiany schematu jak zmiany produkcyjne wpływające na odbiorców. Przeglądaj DDL. Porównuj bieżącą strukturę z punktem odniesienia. Sprawdzaj, czy współdzielone modele, dashboardy i pipeline’y cech nadal odpowiadają kontraktowi, na podstawie którego je zbudowano.
Zawodzi nieformalna koordynacja. Wiadomość na czacie, informacja o wydaniu, której nikt nie czyta, albo założenie, że zielony pipeline oznacza, iż dane są nadal poprawne. Z operacyjnego punktu widzenia schemat jest częścią powierzchni kontraktowej platformy. Jeśli jej nie monitorujesz, ciche awarie stają się stałym źródłem kosztów.
Najlepsze praktyki zarządzania schematem i jego monitorowania
Ręczne zarządzanie schematem zwykle zawodzi na granicach między zespołami. Pull request zostaje scalony w repozytorium aplikacji, ale zespół analityczny tego repozytorium nie obserwuje. Ktoś aktualizuje konektor zewnętrzny, ale właściciel modelu nigdy nie widzi informacji o wydaniu. Dokumentacja istnieje, ale nie nadąża za rzeczywistością.
Lepszym podejściem jest traktowanie schematu jako obserwowalnego zasobu produkcyjnego.
Zbuduj proces zmian, z którego ludzie naprawdę będą korzystać
Rozbudowany model nadzoru dobrze wygląda na papierze, ale w praktyce często jest omijany. Utrzymuj proces na tyle prosty, by inżynierowie produktowi go przestrzegali.
Stosuj kilka prostych zasad:
Wersjonuj zmiany DDL: przechowuj definicje tabel i migracje w systemie kontroli wersji.
Przypisz własność tabel: każdy ważny zbiór danych powinien mieć zespół zatwierdzający zmiany strukturalne.
Klasyfikuj wpływ na odbiorców: zaznaczaj, czy zmiana jest addytywna, przełamująca kompatybilność, czy zmieniająca zachowanie.
Wymagaj notatek wdrożeniowych dla współdzielonych tabel: zwłaszcza dla tabel faktów i wymiarów w hurtowni oraz źródeł cech ML.
Monitoruj strukturę, nie tylko aktualność
Monitorowanie aktualności mówi, czy dane dotarły. Nie mówi, czy ich kształt nadal nadaje się do użytku. Liczba wierszy mówi o wolumenie. Nie mówi, czy zmieniono nazwę kluczowej kolumny.
Dlatego monitorowanie schematu musi porównywać bieżącą strukturę ze znanym punktem odniesienia i sygnalizować zmiany DDL, takie jak dodane kolumny, usunięte kolumny i modyfikacje typów. Jedną z opcji jest digna Schema Tracker, który monitoruje schematy tabel, kolumny i typy danych w celu wykrywania zmian strukturalnych. Szerszy wzorzec jest ważniejszy niż wybór dostawcy. Korzystaj z platformy, narzędzi wewnętrznych lub natywnych kontroli hurtowni, ale zadbaj o to, by struktura była częścią monitorowania operacyjnego.
Włącz alerty schematu do reagowania na incydenty
Alert schematu, który trafia do zapomnianej skrzynki, niewiele pomoże. Sygnał musi docierać do osób odpowiedzialnych za pipeline’y, dashboardy i dane wejściowe modeli.
Praktyczny wzorzec operacyjny wygląda następująco:
Kieruj alerty do tych samych kanałów co incydenty pipeline’ów: systemów dyżurowych, powiadomień na czacie lub narzędzi do obsługi incydentów.
Dołączaj definicje sprzed zmiany i po niej: inżynierowie potrzebują dokładnego porównania struktury, a nie ogólnikowego ostrzeżenia.
W miarę możliwości wskazuj powiązane zasoby: dashboardy, zadania, tabele cech i dalszych odbiorców.
Przeprowadzaj walidację po zmianie: po aktualizacjach strukturalnych weryfikuj kluczowe złączenia, reguły na poziomie wierszy i najważniejsze metryki.
Najważniejszy wniosek: Jeśli Twój zespół potrafi wykryć nieudane zadanie w ciągu kilku minut, ale nie wykrywa zmienionej kolumny, dopóki nie poskarży się interesariusz, Twój zestaw narzędzi monitorujących jest niekompletny.
Dbaj o użyteczność schematu
Dobre schematy są nie tylko poprawne. Są też łatwe w utrzymaniu. Normalizuj tam, gdzie poprawia to integralność i ogranicza duplikację. Stosuj konwencje nazewnictwa, które przetrwają rotację w zespole. Unikaj ukrywania kluczowej semantyki biznesowej w luźno typowanych polach, gdy właściwy model uczyniłby kontrakt jawnym.
Nie traktuj zarządzania schematem jako jednorazowego ćwiczenia projektowego. W działających systemach to ciągła praca operacyjna.
Jeśli zmiany schematu są jednym z najszybszych sposobów na zepsucie pipeline’ów, dashboardów i danych wejściowych modeli, wymagają pełnoprawnego monitorowania. digna pomaga zespołom śledzić zmiany strukturalne wraz z jakością danych, terminowością, walidacją i wykrywaniem anomalii, dzięki czemu problemy ze schematem wychodzą na jaw, zanim przerodzą się w incydenty w dalszych systemach.
Wykrycie zmiany schematu to tylko połowa pracy. Aby potwierdzić, że kluczowe złączenia i reguły na poziomie wierszy nadal obowiązują po aktualizacji strukturalnej, zobacz digna Data Validation.
Najczęściej zadawane pytania
Czym jest schemat w bazie danych?
Schemat to strukturalny plan bazy danych, który definiuje tabele, kolumny, typy danych, ograniczenia i relacje, takie jak klucze obce, ale nie zawiera samych danych. W systemach relacyjnych jest formalnie zbiorem ograniczeń integralności, a na produkcji pełni też funkcję kontraktu, od którego zależą pipeline’y, dashboardy i modele.
Czym różnią się schematy koncepcyjne, logiczne i fizyczne?
Te trzy warstwy ANSI/SPARC zawodzą w różny sposób. Warstwa koncepcyjna definiuje obiekty biznesowe, takie jak klienci i zamówienia, warstwa logiczna przekształca je w encje, klucze i relacje, a warstwa fizyczna dodaje typy danych, indeksy i partycjonowanie dla konkretnego silnika. Przeniesiona kolumna customer_tier to problem logiczny, a wolna partycja to problem fizyczny.
Czym różni się schema-on-write od schema-on-read?
W podejściu schema-on-write dane muszą odpowiadać oczekiwanej strukturze, zanim baza danych je przyjmie, co sprawdza się w przypadku płatności, zamówień i opracowanych hurtowni danych. Schema-on-read najpierw pozyskuje dane, a strukturę nakłada w momencie zapytania, co jest typowe dla jezior danych. Praktyczny wzorzec to elastyczność przy pozyskiwaniu i silniejsza struktura w opracowanych warstwach.
Czym różni się ewolucja schematu od dryfu schematu?
Ewolucja schematu jest zaplanowana: zespół dodaje kolumnę dopuszczającą null, publikuje migrację, aktualizuje kontrakt i koordynuje działania z odbiorcami. Dryf schematu to dodawanie, usuwanie lub modyfikowanie kolumn bez kontroli migracji. Na poziomie tabeli oba zdarzenia mogą wyglądać identycznie; różnicę stanowią nadzór, widoczność i to, czy zespoły odbiorców mogły się przygotować.
Dlaczego zmiany schematu psują pipeline’y danych?
Dalsze zadania zakładają, że stara struktura nadal obowiązuje, więc zmiana nazwy kolumny, usunięcie pola lub zmiana typu z liczby całkowitej na ciąg znaków może przerwać zadanie albo, co gorsza, pozostawić je na zielono, podczas gdy złączenia dopasowują mniej wierszy. Cockroach Labs, cytowane w artykule, wiąże od 60 do 70 procent awarii pipeline’ów z nieoczekiwanymi zmianami schematu.



