Soluzioni di data quality: la guida all'acquisto 2026
|
7
min di lettura

Probabilmente avete già visto questo tipo di guasto. La dashboard del venerdì sembrava pulita, i numeri del lunedì mattina non tornano e il team BI è bloccato a rintracciare un caricamento errato, una tabella sorgente in ritardo o una modifica dello schema che nessuno aveva annunciato. Quando qualcuno torna a fidarsi del report, il modello ha già prodotto output sospetti e il business ha smesso di agire sulla base dei dati.
Indice
Il guasto silenzioso all'interno della maggior parte delle piattaforme dati
Scegliere in base al carico di lavoro, non all'elenco delle funzionalità
Il guasto silenzioso all'interno della maggior parte delle piattaforme dati
Il guasto raramente sembra drammatico. Il warehouse continua a caricare, le dashboard continuano a essere visualizzate e gli alert restano muti. Poi un analista si accorge che una fonte del weekend è arrivata in ritardo, che una tabella dimensionale ha cambiato forma o che una metrica si è spostata quanto basta perché finanza e operations non concordino più sul numero.
È qui che le soluzioni di data quality si sono trasformate da strumento di pulizia di back-office in un livello di observability per i dati di produzione. Oggi la categoria viene trattata come una classe di piattaforme con monitoraggio continuo, validazione e anomaly detection lungo le pipeline di analytics e AI, non solo come uno strumento per correggere i record dopo che qualcuno si è lamentato. La definizione di Gartner coglie questo perimetro più ampio come un “insieme di processi e tecnologie per identificare, comprendere, prevenire, segnalare e correggere i problemi nei dati” a supporto del processo decisionale e della governance nei processi di business (l'inquadramento di mercato delle soluzioni di data quality di Atlan).
Cosa si rompe per primo in produzione
La prima cosa a cedere di solito è la fiducia, non la pipeline. Un modello può continuare a produrre punteggi, ma quando gli input derivano, l'output diventa difficile da difendere. Una dashboard BI può continuare ad aggiornarsi, ma se la freschezza o il drift dello schema cambiano il significato dei numeri, i team smettono di usarla ancora prima che qualcuno dimostri la causa principale.
Regola pratica: se gli utenti chiedono se una dashboard è “giusta” più spesso di quanto chiedano cosa significhi, la piattaforma ha bisogno di observability, non di un'altra pulizia batch.
Il vecchio modello presupponeva che il lavoro sulla qualità avvenisse in job di pulizia pianificati. Questo non regge nei cloud warehouse, negli ambienti misti batch e streaming o nei flussi di lavoro AI in cui i dati cambiano più velocemente di quanto vengano aggiornati gli insiemi di regole. Il cambiamento di mercato è importante perché la data quality è ora legata alla tempestività, al rilevamento delle modifiche di schema e a una governance pronta per l'AI, ed è per questo che gli acquirenti valutano queste piattaforme come parte del tessuto operativo dello stack dati, non come un ripensamento.
Cosa fanno davvero le soluzioni di data quality
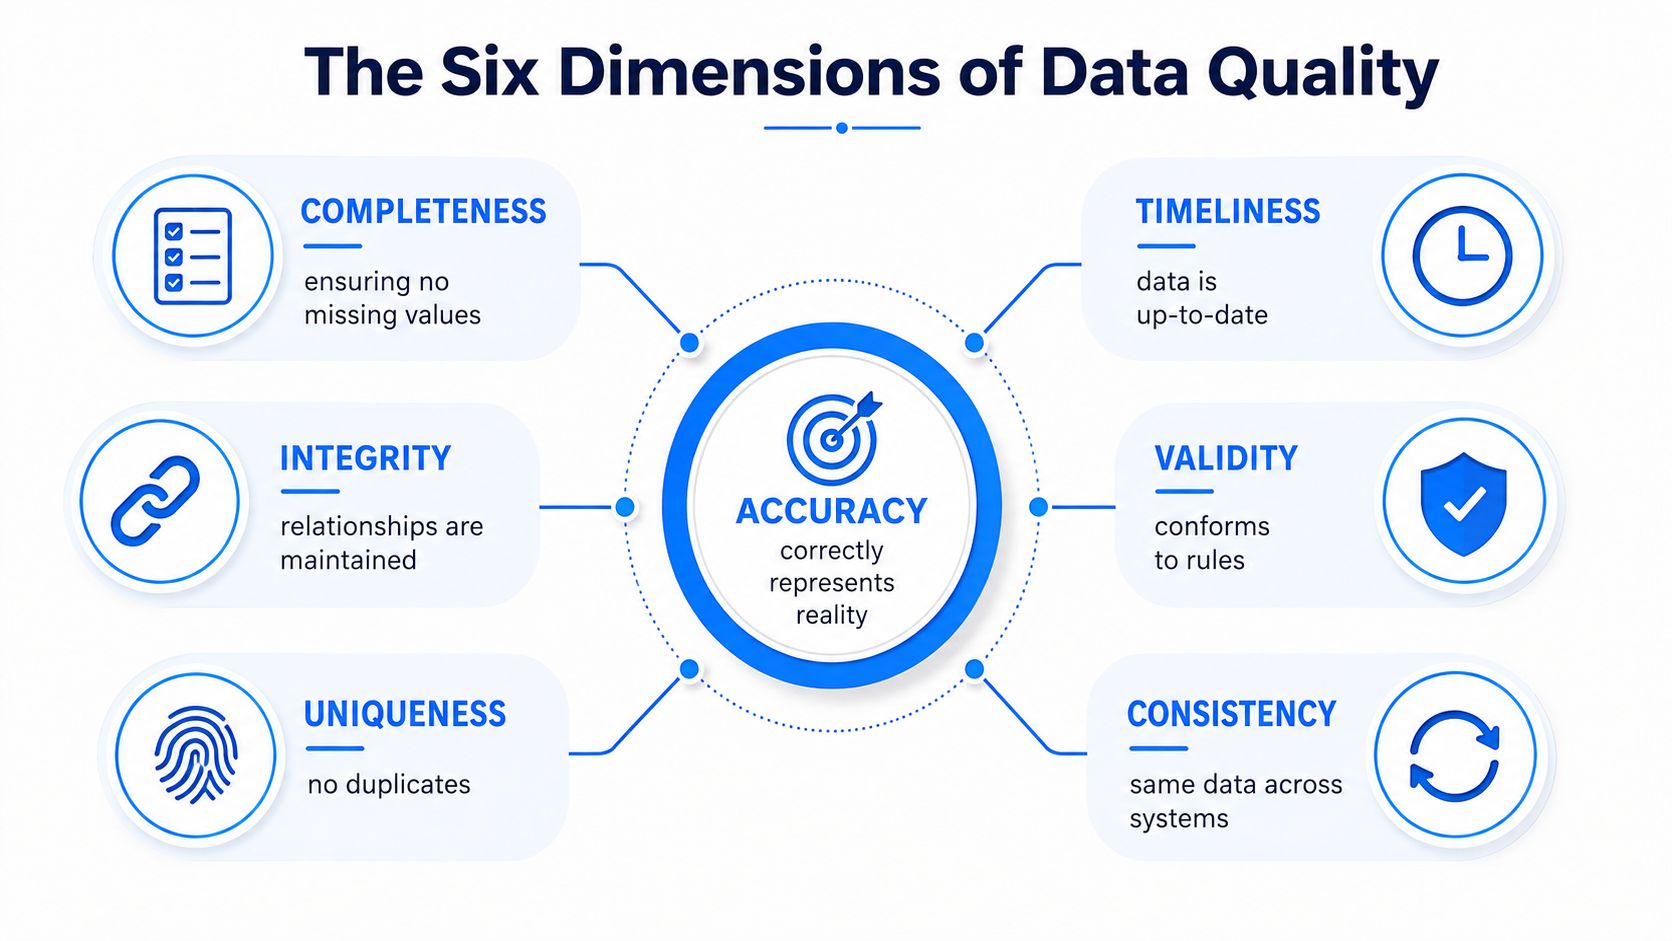
Sul piano tecnico, la categoria è diventata misurabile quando il settore ha smesso di trattare la qualità come un giudizio vago. Il Data Quality Assessment Framework organizza la qualità in completezza, tempestività, validità, integrità, unicità e coerenza, mentre linee guida più ampie aggiungono spesso accuratezza e accessibilità come caratteristiche di supporto (panoramica di Alation sui framework di data quality).
Le sei dimensioni in un warehouse in produzione
Una piattaforma pratica non si limita a dire “questa tabella è sbagliata”. Misura cosa non va.
La completezza verifica se mancano valori obbligatori.
La tempestività verifica se i dati sono arrivati quando dovevano.
La validità verifica se i valori rispettano regole, formati e intervalli ammessi.
L'integrità verifica se le relazioni tra le tabelle sono ancora valide.
L'unicità verifica se compaiono duplicati dove non dovrebbero.
La coerenza verifica se lo stesso concetto corrisponde tra sistemi diversi.
Questo framework è importante perché ha trasformato la qualità in un problema di ingegneria. Un punteggio di data quality può essere costruito a partire da dimensioni come accuratezza, completezza, coerenza, tempestività, validità e unicità e combinato in una percentuale ponderata, ed è così che team di ingegneria e stakeholder di business possono guardare lo stesso segnale senza leggere la stessa logica di query.
Il vocabolario operativo che gli acquirenti dovrebbero usare
Il modo più semplice per valutare i fornitori è chiedere quali dimensioni misurano, come le misurano e cosa fanno quando la metrica cambia. Se una piattaforma non sa esprimere valori mancanti, formati non validi, tassi di duplicazione o soglie di freschezza in un modo su cui il vostro team possa agire, non sta facendo lavoro di qualità in produzione.
Usate questa guida alle metriche di data quality per collegare le dimensioni ai controlli operativi prima di confrontare gli strumenti.
Il motivo per cui è diventata una categoria software è semplice. Quando la qualità diventa un insieme di metriche con baseline, soglie e drift, può essere monitorata in modo continuo. È molto diverso dal pulire i dati dopo che un report è andato storto.
Le quattro componenti tecniche che contano
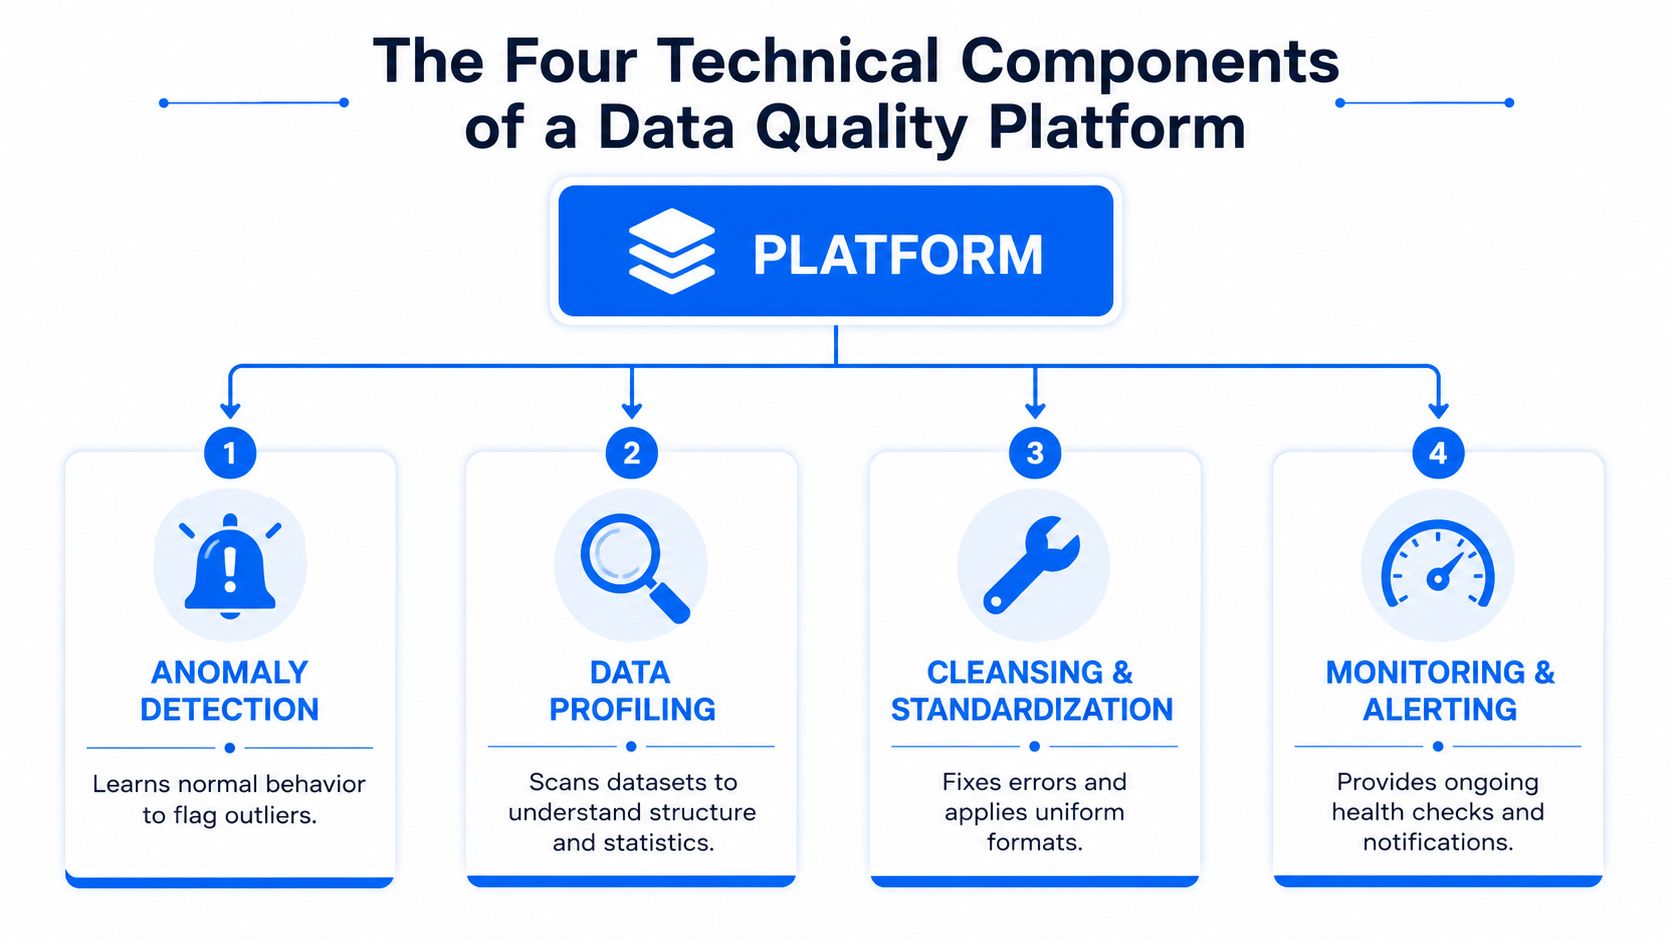
La maggior parte delle piattaforme di produzione si regge su quattro capacità, e non sono tutte intercambiabili. Anomaly detection, tempestività, validazione e schema tracking risolvono modalità di guasto diverse, e una buona piattaforma sa quale applicare per prima.
Anomaly detection e validazione non sono la stessa cosa
L'anomaly detection impara che aspetto ha la normalità, poi segnala le deviazioni in volume, distribuzione o comportamento senza costringere una persona a scrivere una nuova regola per ogni modifica di campo. Gartner descrive le moderne soluzioni di augmented data quality come la combinazione di profilazione e monitoraggio con AI/ML, analisi a grafo e analytics dei metadati per rilevare outlier, anomalie, pattern e drift su fonti on-premises, cloud, relazionali, non relazionali, batch e streaming (Gartner sulle soluzioni di augmented data quality).
La validazione è più circoscritta ed esplicita. Verifica se una riga rispetta una regola di business o tecnica nota, ed è ideale quando l'aspettativa è stabile, come un formato di codice, un campo obbligatorio o un valore entro limiti definiti.
Una distinzione utile è questa: l'anomaly detection trova ciò che non sapevate di dover cercare, la validazione impone ciò che sapete già dover essere vero.
Tempestività e schema tracking intercettano interruzioni diverse
La tempestività monitora le finestre di arrivo previste e rileva i ritardi. Se un caricamento sorgente arriva di solito entro una certa ora e non rispetta quel pattern, la piattaforma dovrebbe segnalarlo prima che i dati non aggiornati raggiungano una dashboard o un feature store ML. Lo schema tracking sorveglia colonne aggiunte, colonne rimosse e cambi di tipo, che sono spesso il motivo per cui le trasformazioni a valle falliscono o producono join errati.
Il grande valore non è solo il rilevamento, è il triage. Le linee guida del settore raccomandano di abbinare profilazione, controlli di freschezza e root cause analysis basata sul lineage, così che i team possano capire se il problema deriva da un ritardo della fonte, da un errore di trasformazione o da un drift a valle (linee guida di lakeFS sugli strumenti di data quality). Questo accorcia la risposta agli incidenti, perché l'alert indica la classe di guasto e non solo il sintomo.
Come le quattro componenti si collegano alle dimensioni della qualità
L'anomaly detection aiuta di solito con coerenza, integrità e talvolta completezza. La tempestività corrisponde direttamente alla tempestività. La validazione copre la validità e parte dell'accuratezza. Lo schema tracking protegge la coerenza e spesso spiega i problemi di integrità a valle.
Questa mappatura è il modello mentale da tenere a mente. Un fornitore può avere una validazione solida e non accorgersi comunque dei dati in ritardo. Un altro può individuare rapidamente le anomalie e ignorare comunque le regole di business. I sistemi di produzione hanno bisogno sia di copertura sia del giusto posizionamento.
Dove gira il motore della qualità
L'architettura è la vera decisione d'acquisto. Se il motore della qualità gira nel posto sbagliato, la piattaforma può essere tecnicamente capace e non superare comunque la revisione di sicurezza, introdurre latenza o violare i requisiti di residenza dei dati.
Tre modelli di esecuzione si comportano in modo molto diverso
L'esecuzione in-database mantiene i controlli all'interno del warehouse o del database del cliente. Di solito significa meno movimento di dati, minore esposizione e ispezione più rapida, perché i dati non lasciano il system of record. È adatta anche quando i team vogliono che il calcolo delle metriche resti vicino ai dati e quando i team privacy pretendono un controllo rigoroso.
Il SaaS gestito dal fornitore centralizza l'elaborazione nell'ambiente del fornitore. Il vantaggio è una gestione operativa più semplice, ma il compromesso è evidente: i dati devono attraversare un confine, il che solleva domande su accesso, residenza e su cosa esattamente venga copiato o trasformato.
I deployment ibridi suddividono il lavoro. Alcuni controlli restano vicini ai dati, mentre orchestrazione, alerting o flussi di metadati più ampi vivono altrove. Può funzionare bene, ma solo se la piattaforma rende la suddivisione abbastanza esplicita da permettere agli ingegneri di ragionare su latenza e sicurezza.
La prima domanda sull'architettura non è “quali funzionalità avete?”. È “dove vanno i dati e chi può vederli?”.
Perché i settori regolamentati pongono domande diverse
Finanza, sanità, telecomunicazioni e settore pubblico di solito si interessano meno a una lunga checklist di funzionalità e più alle conseguenze operative del deployment. Il fornitore può elaborare i dati senza esporre righe di produzione? La piattaforma può girare in private cloud o on-prem? Il modello aggiunge un overhead inutile alla pipeline? Può mantenere i dati residenti nell'ambiente del cliente?
È questa la lacuna della maggior parte delle pagine di mercato. Parlano di monitoraggio, governance e lineage, ma raramente pongono subito la questione del deployment. Per gli acquirenti regolamentati questa omissione costa cara, perché la topologia sbagliata può bloccare l'acquisto molto prima che la valutazione tecnica sia conclusa.
Domande che fanno emergere rapidamente il rischio architetturale
Dove avviene l'elaborazione? Se esce dal confine del vostro cloud, chiedete perché.
Quali dati vengono copiati? I metadati sono una cosa, i record di produzione un'altra.
Può girare nel vostro ambiente? In molte aziende private cloud e on-prem non sono facoltativi.
Cosa succede alla latenza? I passaggi aggiuntivi contano quando le pipeline sono già al limite.
La risposta giusta dipende dal carico di lavoro, ma l'architettura dovrebbe essere chiara prima che si parli di dashboard.
Scegliere in base al carico di lavoro, non all'elenco delle funzionalità
Le checklist di funzionalità nascondono la decisione centrale. Affidabilità della BI, rilevamento del drift nell'AI e verificabilità in ambito regolamentato non richiedono lo stesso mix di controlli, e acquistare la combinazione sbagliata porta di solito a uno di due esiti: troppi alert o troppo poco segnale.
Abbinate il carico di lavoro alla superficie di controllo
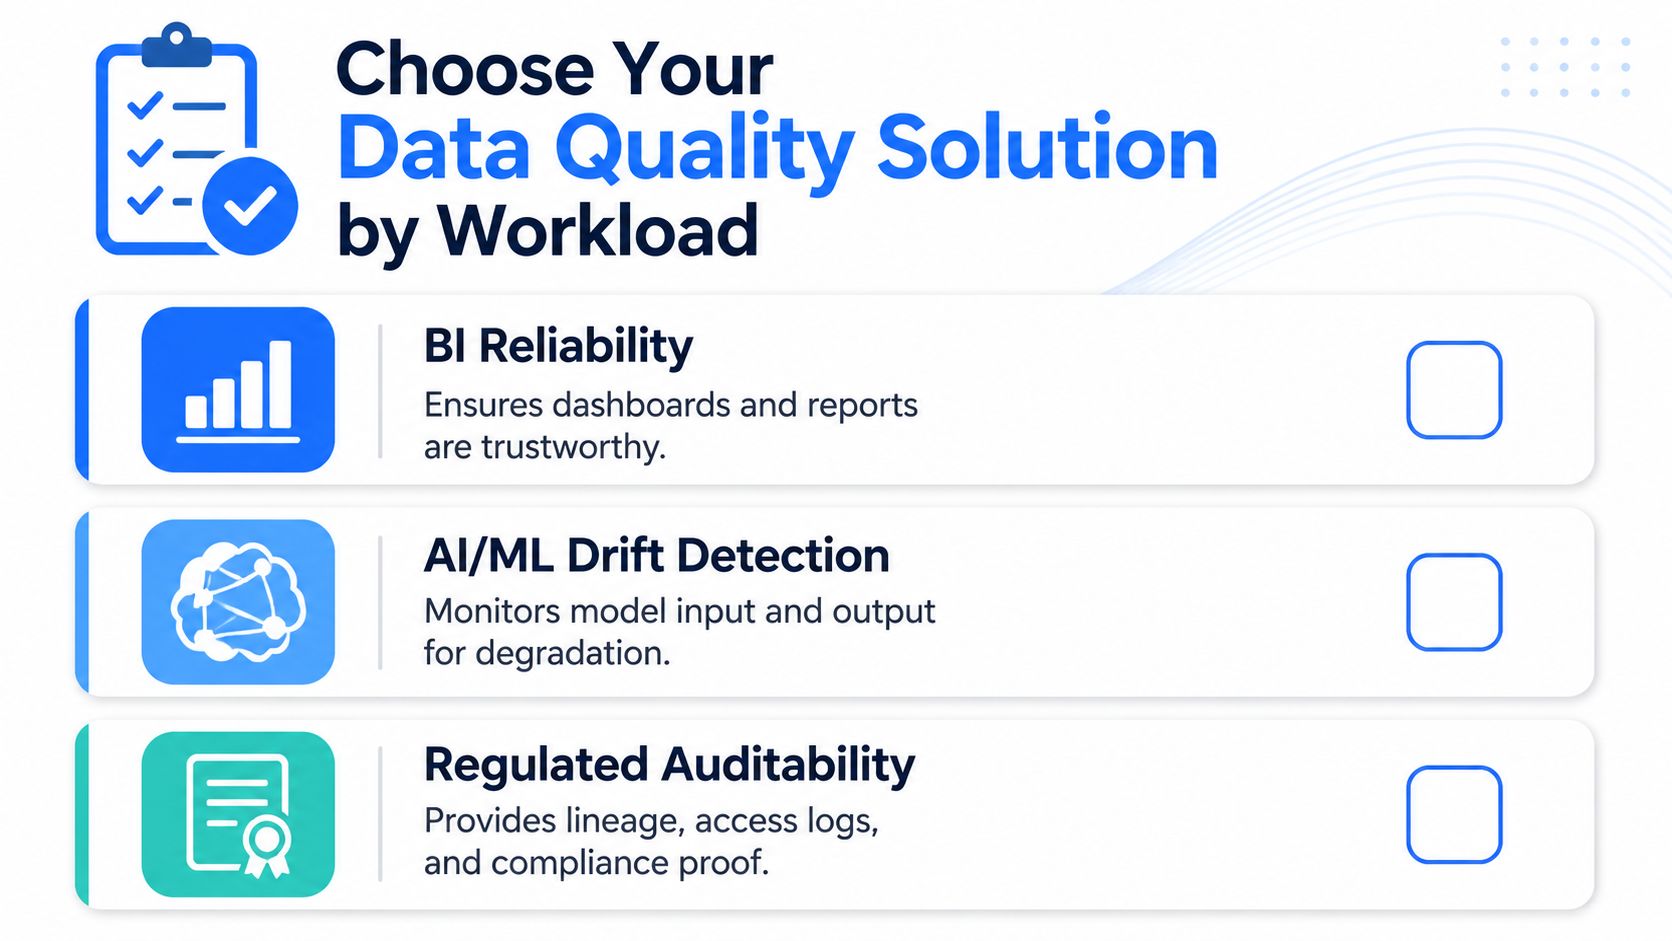
Per l'affidabilità della BI, contano prima di tutto tempestività e validazione. Le dashboard si rompono più spesso quando una fonte è in ritardo, un feed è incompleto o una regola di business cambia sotto il report. Una piattaforma dovrebbe rendere visibili presto i caricamenti non aggiornati e impedire che le righe errate raggiungano il reporting per il management.
Per il rilevamento del drift in AI e ML, anomaly detection e schema tracking hanno più peso. I modelli possono tollerare una certa variazione, ma non possono tollerare per sempre spostamenti silenziosi delle distribuzioni. Quando centinaia di tabelle cambiano nel tempo, le regole statiche non tengono il passo e l'apprendimento statistico diventa l'opzione pratica.
Per la verificabilità in ambito regolamentato, prevalgono validazione, integrità, contesto di lineage e audit trail. L'obiettivo non è solo intercettare un record errato. È dimostrare cosa è stato controllato, quando è stato controllato e quale logica è stata applicata.
È l'aspetto organizzativo a decidere se lo strumento sopravvive
I ricercatori del MIT che hanno descritto la gestione della data quality hanno individuato cinque fattori critici di successo: certificare i dati aziendali esistenti, standardizzare le definizioni dei dati, certificare le fonti esterne, controllare la generazione interna e garantire la verificabilità dei dati. Hanno descritto anche un modello operativo in cinque parti basato su una visione allineata al business, una responsabilità centrale nell'IS, formazione per project e system manager, formazione per l'intera organizzazione IS e miglioramento continuo (paper del MIT sulla gestione della data quality).
Non è un consiglio astratto di governance. Spiega perché alcuni deployment vengono adottati e altri abbandonati. Se la responsabilità non è chiara o gli audit trail sono deboli, lo strumento diventa l'ennesimo posto in cui gli alert vanno a morire.
Una breve checklist per la shortlist
Definite prima il carico di lavoro. Casi d'uso BI, AI o di audit richiedono segnali diversi.
Verificate la dimensione più debole. Dati in ritardo, modifiche di schema problematiche o violazioni delle regole di solito rivelano la lacuna.
Chiedete chi è responsabile delle eccezioni. Se nessuno si occupa del follow-up, la piattaforma invecchierà male.
Confermate la verificabilità. Vi serve la traccia, non solo l'alert.
Verificate il modello operativo. Il miglioramento continuo batte sempre la pulizia una tantum.
Dal proof of value alla produzione
La demo di proof of value più rapida di solito nasconde il lavoro di produzione più difficile. Una piattaforma fa un'ottima figura quando qualcuno la punta su una tabella di esempio pulita, poi si blocca quando deve apprendere le baseline, integrarsi con le pipeline e supportare le persone responsabili dei dati.
La sequenza di implementazione che funziona davvero
Iniziate con l'apprendimento delle baseline sui dati storici. In questo modo la piattaforma ottiene intervalli normali, distribuzioni attese e pattern di arrivo, invece di dover iniziare ogni controllo come una regola codificata a mano. Poi configurate i dataset e le tabelle di metriche che volete osservare, perché i sistemi di produzione hanno bisogno di un inventario chiaro di ciò che viene monitorato.
Segue la configurazione delle regole di validazione. I team codificano le aspettative di business che non possono essere dedotte statisticamente, come formati ammessi, valori obbligatori e controlli tra campi. Dopodiché integrate la piattaforma nei percorsi di ingestion e trasformazione, così che i controlli vengano eseguiti dove avvengono i guasti e non solo quando il warehouse è già inquinato.
Dove i team di solito si bloccano
La maggior parte dei blocchi avviene nei passaggi di consegna. I data engineer sono responsabili della pipeline, gli analisti della dashboard e il business del processo, ma nessuno è responsabile della coda delle eccezioni. Quando l'alerting è troppo rumoroso o l'interfaccia troppo tecnica, le persone smettono di aprirla. Quando il sistema richiede strumenti separati per tempestività, validazione e tracciamento delle modifiche di schema, il monitoraggio di routine diventa un peso invece che un'abitudine.
Regola pratica: se il primo mese richiede uno specialista per ogni nuova tabella, l'adozione in self-service farà fatica.
Cosa dovrebbe produrre la piattaforma lungo il percorso
Vi servono distribuzioni apprese, controlli di freschezza pianificati, snapshot dello schema e una vista condivisa dei trend che analisti e ingegneri possano leggere allo stesso modo. Un buon rollout semplifica anche la review degli incidenti, perché il team può confrontare la baseline di ieri con il guasto di oggi senza ricostruire a memoria l'intera pipeline.
Il flusso di monitoraggio è importante perché la qualità in produzione è un ciclo, non una configurazione una tantum. La piattaforma deve continuare ad apprendere, continuare a inviare alert e conservare abbastanza storico da spiegare cosa è cambiato.
Come tutto questo si combina in digna
Il problema enterprise non è difficile da descrivere. I report diventano obsoleti, i modelli derivano e le modifiche di schema passano inosservate perché i controlli vivono in troppi posti diversi. Una piattaforma aiuta solo se riunisce anomaly detection, tempestività, validazione e schema tracking in un unico modello operativo che resta vicino ai dati.
Cosa fanno insieme i componenti della piattaforma
digna Data Anomalies apprende il comportamento normale e segnala i cambiamenti inattesi senza richiedere una manutenzione costante delle regole. digna Data Analytics esamina le metriche storiche di observability, così che i team possano vedere trend, spostamenti e pattern invece di un singolo alert puntuale. digna Timeliness monitora gli arrivi rispetto ai pattern appresi e alle pianificazioni degli utenti, ed è ciò che intercetta i caricamenti in ritardo o mancanti prima che il business ne risenta.
digna Data Validation applica regole a livello di record per la logica di business e i requisiti di audit, mentre digna Schema Tracker segnala colonne aggiunte, rimosse o con tipo modificato. Questa combinazione corrisponde in modo pulito alle dimensioni della qualità discusse in precedenza, in particolare completezza, tempestività, validità, integrità, unicità e coerenza.
Perché qui conta il modello di esecuzione
È la scelta architetturale a rendere il prodotto rilevante per gli ambienti regolamentati. Il calcolo delle metriche in-database mantiene i dati residenti nell'ambiente del cliente, e il deployment in private cloud o on-prem significa che il fornitore non accede ai dataset di produzione. Questo riduce il movimento dei dati e rende molto più semplici le conversazioni su privacy e residenza con i team di sicurezza.
Anche l'interfaccia unificata conta nella pratica. Quando ingegneri, analisti e stakeholder possono vedere la stessa linea di trend, lo stesso alert e la stessa cronologia dello schema, i team passano meno tempo a riconciliare strumenti e più tempo a sistemare la pipeline. È questo il valore di combinare observability e qualità in un unico posto: meno punti di frizione tra rilevamento, spiegazione e azione.
L'unica domanda che dovrebbe guidare la vostra shortlist
La maggior parte delle discussioni d'acquisto parte dalle funzionalità e finisce con preoccupazioni architetturali che avrebbero dovuto venire prima. La domanda migliore è semplice: questa soluzione gira dove vivono i nostri dati, si adatta al nostro modello di sicurezza e governance e ci avvisa dei problemi prima che lo faccia il business?
Se la risposta è sì, confermate il resto nell'ordine. Verificate il luogo di esecuzione. Verificate l'accesso del fornitore ai dati di produzione. Verificate la copertura di anomaly detection, tempestività, validazione e schema tracking. Verificate l'adeguatezza al carico di lavoro che ha avviato la valutazione. Verificate che il modello operativo possa sostenere un miglioramento continuo invece di una pulizia una tantum.
Le moderne soluzioni di data quality non sono più strumenti di pulizia limitati. Sono piattaforme operative per observability, rilevamento delle modifiche di schema, monitoraggio tempestivo e governance pronta per l'AI. Se la vostra shortlist non sa spiegare questi elementi nel contesto del vostro ambiente, non è pronta per la produzione.
Se cercate una piattaforma costruita attorno a controlli di qualità in-database, deployment privato e monitoraggio continuo di anomalie, tempestività, validazione e modifiche di schema, date un'occhiata a digna. È pensata per i team che hanno bisogno che la data quality resti all'interno del proprio ambiente, offrendo al tempo stesso a ingegneri e stakeholder un unico posto in cui esaminare cosa è cambiato e perché.
Per vedere come anomaly detection, tempestività, validazione e schema tracking funzionano come un unico programma in-database su tutti i vostri warehouse, leggete la pagina sulla gestione della qualità dei dati con digna.
Domande frequenti
Cosa fanno davvero le soluzioni di data quality?
Monitorano, validano e rilevano anomalie in modo continuo lungo le pipeline di analytics e AI, invece di pulire i record dopo che qualcuno si è lamentato. La definizione di Gartner, citata nell'articolo, comprende l'identificazione, la comprensione, la prevenzione, la segnalazione e la correzione dei problemi nei dati. Le piattaforme moderne misurano dimensioni come completezza, tempestività, validità, integrità, unicità e coerenza.
Qual è la differenza tra anomaly detection e validazione dei dati?
L'anomaly detection impara che aspetto ha la normalità e segnala le deviazioni in volume, distribuzione o comportamento senza una nuova regola per ogni campo. La validazione è esplicita: verifica le righe rispetto a regole di business o tecniche note, come un formato di codice o un campo obbligatorio. Una trova l'ignoto; l'altra impone il noto.
Perché è importante dove gira uno strumento di data quality?
Il luogo di esecuzione spesso decide se uno strumento supera la revisione di sicurezza. L'esecuzione in-database mantiene i controlli all'interno del vostro warehouse, con meno movimento ed esposizione dei dati. Il SaaS gestito dal fornitore sposta i dati oltre un confine, sollevando questioni di residenza e accesso, mentre le configurazioni ibride suddividono il lavoro. Chiedete prima dove vanno i dati e chi può vederli.
Come si crea una shortlist di strumenti di data quality per il proprio carico di lavoro?
Scegliete in base al carico di lavoro, non all'elenco delle funzionalità. Per l'affidabilità della BI contano prima di tutto tempestività e validazione. Per il rilevamento del drift in AI e ML hanno più peso anomaly detection e schema tracking. Per la verificabilità in ambito regolamentato prevalgono validazione, integrità, contesto di lineage e audit trail. Poi verificate chi è responsabile delle eccezioni e se la verificabilità è coperta.
Qual è l'ordine giusto per implementare una piattaforma di data quality?
Iniziate con l'apprendimento delle baseline sui dati storici per ottenere intervalli normali, distribuzioni e pattern di arrivo. Poi configurate i dataset e le tabelle di metriche da osservare, quindi impostate le regole di validazione per le aspettative che non possono essere dedotte statisticamente, e infine integrate i controlli nei percorsi di ingestion e trasformazione in cui i guasti avvengono davvero.


