Software di data ingestion: scegliere lo strumento giusto per il 2026
|
7
min di lettura

Se gestite contemporaneamente dati provenienti da Salesforce, database di prodotto, piattaforme di assistenza, dispositivi IoT e flussi di eventi, sapete già che il problema non è raccogliere i dati. È portare i dati giusti nel posto giusto, in una forma di cui i sistemi a valle possano fidarsi. Spesso le organizzazioni non falliscono perché mancano dashboard o modelli. Falliscono perché l'infrastruttura sottostante è fragile, lenta o opaca.
È qui che il software di data ingestion smette di essere un'utility di sfondo e diventa parte del design centrale della vostra piattaforma. Il modo in cui acquisite i dati influisce sulla freschezza dei report, sugli input dei modelli, sulla risposta agli incidenti, sulla postura di compliance e sul fatto che qualcuno si fidi dei numeri presentati al consiglio di amministrazione. Spostate male i dati e ogni livello a valle ne eredita l'instabilità. Spostateli bene e il resto dello stack diventa più semplice.
Indice
Le fondamenta della moderna data analytics
Una configurazione enterprise tipica sembra ingannevolmente matura. Ogni team ha un sistema su cui fa affidamento. La finanza vive su una piattaforma, le operations su un'altra, l'assistenza clienti su una terza e l'engineering produce un flusso costante di eventi applicativi. Eppure l'analytics si blocca comunque, perché i dati arrivano in ritardo, in formati incoerenti o non raggiungono mai il data warehouse in condizioni abbastanza pulite da poter essere usati.
Il software di data ingestion è il livello che mette ordine in questo caos. Funziona come la rete logistica di una fabbrica di dati. Le materie prime arrivano da molte origini, ciascuna con requisiti diversi di imballaggio, tempistica e gestione. Il software di ingestion le raccoglie, le instrada e le consegna a data warehouse, data lake o store operativi dove analisti, strumenti di BI e sistemi di ML possono lavorarci.

Perché l'ingestion è al centro
L'errore che vedo più spesso è trattare l'ingestion come un'attività di integrazione una tantum. Non lo è. È un sistema operativo continuo, con le sue modalità di guasto. Le API cambiano. Gli schemi delle sorgenti subiscono drift. Il volume degli eventi ha picchi improvvisi. Le policy di accesso diventano più restrittive. Una pipeline che funzionava perfettamente durante un proof of concept può diventare gradualmente la parte meno affidabile della piattaforma quando arrivano il traffico di produzione e la complessità organizzativa.
Questo è importante perché i sistemi a valle non perdonano. Un caricamento in ritardo può rendere obsoleta una dashboard finanziaria. Una colonna eliminata senza che nessuno se ne accorga può rompere un modello di trasformazione. Un evento malformato può inquinare le feature usate da un servizio di raccomandazione. Spesso i team indagano su questi problemi prima a livello di reporting o di modello, anche se il guasto effettivo è nato nell'ingestion.
Regola pratica: se il primo miglio dello spostamento dei dati è instabile, ogni controllo successivo diventa più costoso.
Perché i team stanno investendo ora
La direzione del mercato riflette questo cambio di mentalità. Il mercato globale del software di data integration, che include le soluzioni di ingestion, dovrebbe crescere da 6,8 miliardi di USD nel 2026 a 16,1 miliardi di USD entro il 2033, con un CAGR del 13,1%, secondo Persistence Market Research sul mercato del software di data integration. Non si tratta solo di un ricambio di strumenti. È un segnale che le organizzazioni stanno riprogettando il modo in cui i dati si muovono tra sistemi multi-cloud, data lake e programmi di analytics.
In pratica, il business case è semplice:
Un accesso più rapido a dati utilizzabili significa che gli analisti passano meno tempo ad aspettare e più tempo a produrre decisioni.
Uno spostamento più affidabile tra i sistemi riduce le emergenze da gestire in engineering e analytics.
Passaggi più puliti verso le piattaforme a valle rendono più facile applicare qualità e osservabilità.
Un minore attrito operativo aiuta i team a scalare le integrazioni senza trasformare ogni nuova sorgente in un progetto su misura.
Il software di data ingestion non è l'intera piattaforma. Ma è la base su cui poggia ogni data product affidabile.
Architetture di ingestion batch, streaming e ibride
La scelta dell'architettura determina come arrivano i vostri dati, quanto carico operativo vi assumete e che tipo di garanzie potete offrire a valle. La maggior parte dei design di ingestion rientra in una di tre categorie: batch, streaming o ibrida.
Ingestion batch
L'ingestion batch è il furgone postale a orari fissi. Arriva in momenti noti, raccoglie molto materiale e lo consegna in blocco. È ancora il modello giusto per molti caricamenti nel data warehouse, estrazioni da ERP, backfill storici e sistemi in cui le API di origine hanno limiti rigidi o un supporto limitato agli eventi.
I design batch sono più facili da comprendere. Creano confini naturali per il ripristino e funzionano bene quando i consumatori tengono più alla completezza che all'immediatezza. Se state aggiornando dataset di finanza, procurement o pianificazione mensile, uno spostamento in blocco prevedibile è spesso un vantaggio, non un compromesso.
Ciò che non funziona è forzare il batch in casi d'uso che richiedono una reazione immediata. Se la logica antifrode, le notifiche ai clienti o gli alert operativi dipendono da una freschezza al minuto, un furgone notturno o orario è il mezzo sbagliato.
Ingestion in streaming
L'ingestion in streaming è la conduttura dell'acqua. I dati continuano a scorrere e i sistemi a valle possono consumarli quasi immediatamente. Questo offre ai team una freschezza migliore, ma alza anche l'asticella dell'engineering. Le pipeline continue richiedono una riflessione più attenta su ordinamento, comportamento dei retry, backpressure, idempotenza ed evoluzione degli schemi.
Gli strumenti moderni si affidano sempre più al change data capture, o CDC, per renderlo praticabile. L'ingestion basata su CDC può ridurre la latenza da ore a millisecondi, e strumenti come Fivetran ed Estuary Flow sincronizzano solo i dati modificati anziché estrazioni complete, il che può ridurre il carico sulle API fino al 90%, secondo la panoramica di Valiotti sugli strumenti di data ingestion. Questo conta quando acquisite dati da piattaforme SaaS con rate limit o da sistemi sorgente che non tollerano un polling intenso.
Lo streaming è potente, ma non è gratuito. I team spesso sottovalutano il lavoro operativo necessario per mantenere sana una conduttura veloce quando i contratti a monte iniziano a cambiare.
Ingestion ibrida
L'ingestion ibrida combina entrambi i modelli. Usa un percorso veloce per le modifiche recenti e un percorso in blocco per la completezza e la riconciliazione. Se il batch è il furgone postale e lo streaming è la conduttura dell'acqua, l'ibrido è la struttura che usa entrambi, perché ciascuno risolve un problema diverso.
Questo pattern è comune nelle grandi piattaforme perché rispecchia meglio la realtà. Gli utenti di business vogliono numeri aggiornati rapidamente, ma i team dati hanno anche bisogno di un livello storico affidabile da poter riconciliare, rieseguire e sottoporre ad audit. I design ibridi sono particolarmente utili quando lo streaming cattura le modifiche immediate mentre i job batch correggono i record arrivati in ritardo, ricostruiscono le partizioni o verificano la coerenza sul lungo periodo.
Usate l'ibrido quando la freschezza conta, ma la fiducia dipende ancora da una riconciliazione periodica.
Architetture di data ingestion a confronto
Caratteristica | Ingestion batch | Ingestion in streaming | Ingestion ibrida |
|---|---|---|---|
Modalità di consegna | Caricamenti in blocco pianificati | Flusso continuo di eventi o CDC | Flusso continuo più riconciliazione pianificata |
Ideale per | Analytics storica, aggiornamenti del data warehouse, backfill | Alert, sistemi operativi, analytics a bassa latenza | Ambienti misti con esigenze sia in tempo reale sia storiche |
Profilo di latenza | Latenza più alta per definizione | Latenza molto bassa se ben progettata | Bassa latenza per i dati recenti, maggiore completezza nel tempo |
Complessità operativa | Più bassa | Più alta | La più alta |
Modello di ripristino | Più facile da rieseguire a blocchi | Richiede replay e gestione dello stato accurati | Flessibile, ma con più componenti in gioco |
Struttura dei costi | Finestre di calcolo prevedibili | Overhead di elaborazione continuo | Spesa più ampia su entrambe le modalità |
Gestione delle modifiche di schema | Spesso intercettate al momento del caricamento | Devono essere gestite in modo continuo | Richiede sia resilienza sul percorso veloce sia verifica batch |
Modalità di guasto tipica | Dati obsoleti | Drift silenzioso o problemi nella gestione degli eventi | Lacune di coordinamento tra percorso veloce e lento |
Molti team scelgono l'architettura per abitudine. È un errore. Sceglietela in base alle aspettative dei consumatori, al comportamento delle sorgenti, alle esigenze di ripristino e alle garanzie di qualità che dovete mantenere dopo l'arrivo dei dati.
Valutare le funzionalità del software di data ingestion
La maggior parte delle demo dei fornitori fa sembrare tutte le piattaforme intercambiabili. Non lo sono. Quando valutate un software di data ingestion, la domanda utile non è "Si collega ai miei sistemi?". È "Riesce a mantenere affidabili quei collegamenti quando la produzione diventa caotica?"
La profondità dei connettori conta più del loro numero
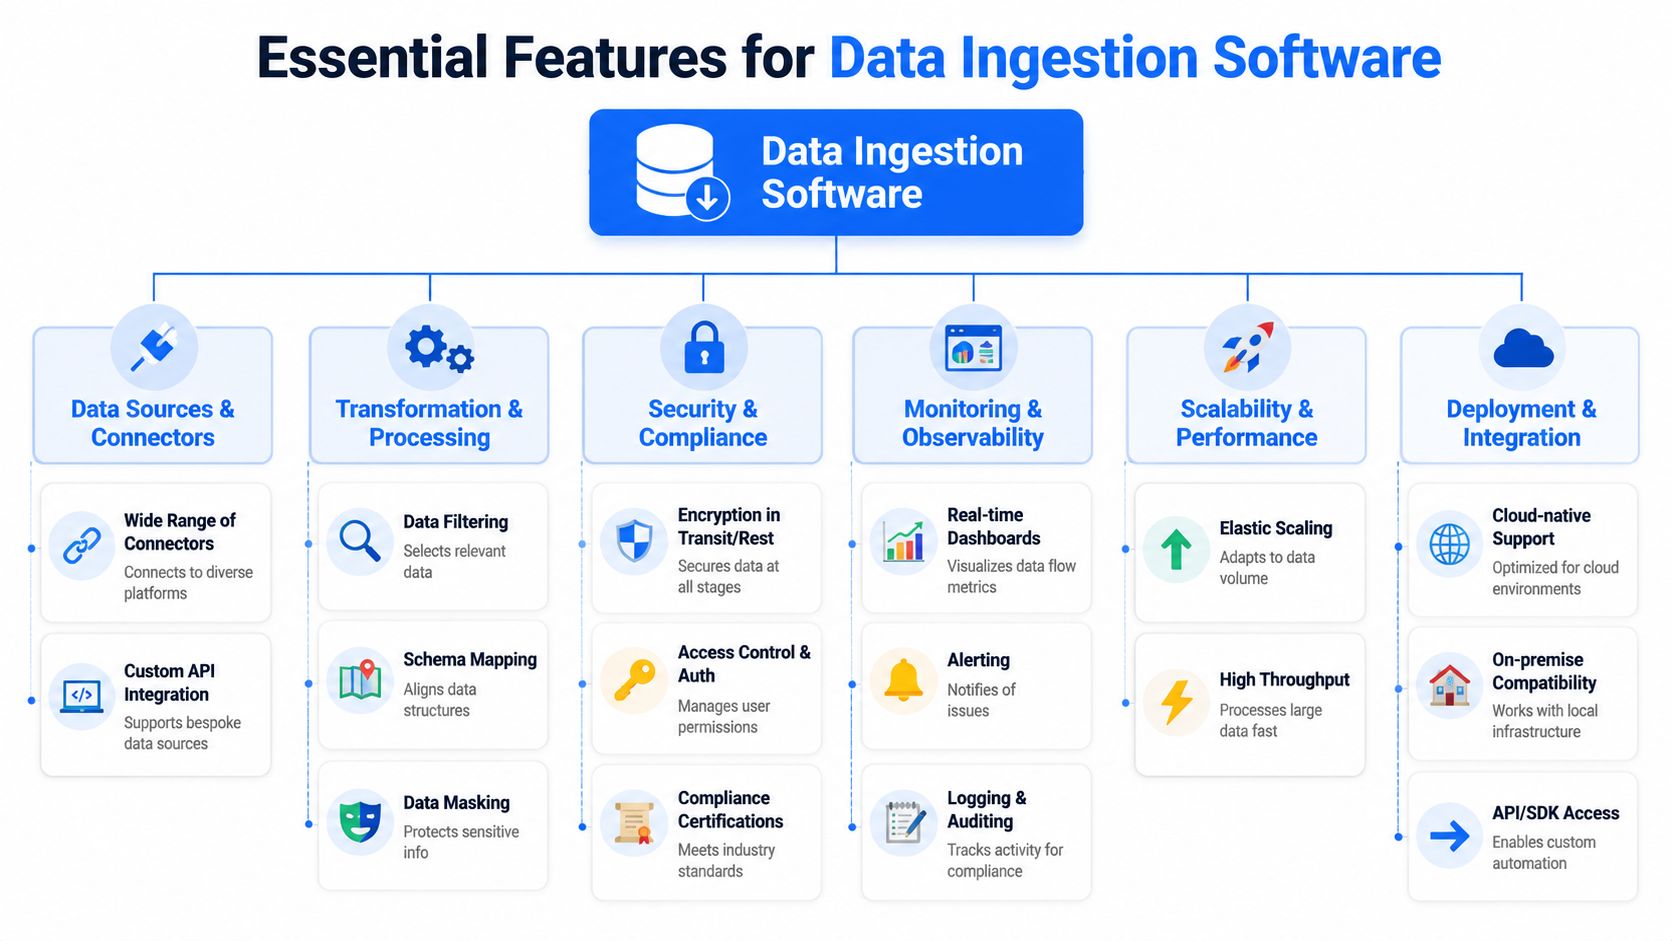
Un lungo catalogo di connettori fa bella figura in una pagina dei prezzi. Nella pratica, la profondità conta più dell'ampiezza. Un buon connettore gestisce i cambiamenti di autenticazione, le stranezze della paginazione, i campi in evoluzione e le sincronizzazioni incrementali senza costringere il vostro team a continui rattoppi.
Durante la valutazione, ponete domande come queste:
Come gestisce il connettore le modifiche di schema? Serve più di un'e-mail di avviso. Serve un comportamento prevedibile quando le colonne compaiono, scompaiono o cambiano tipo.
Supporta in modo pulito l'estrazione incrementale? I ricaricamenti completi sono costosi e spesso non necessari.
Cosa si rompe quando cambia l'API della sorgente? I prodotti maturi rendono questa situazione gestibile.
Potete estendere i connettori per i sistemi interni? La maggior parte delle aziende ha almeno una sorgente che nessun fornitore supporta out of the box.
Se la vostra roadmap include documenti non strutturati, PDF, moduli o contenuti aziendali semi-strutturati, vale la pena valutare anche strumenti diversi dai tradizionali prodotti di sincronizzazione SaaS. Un motore di estrazione dati basato su AI può essere utile quando l'ingestion parte da documenti grezzi anziché da tabelle o API pulite.
Come si riconosce una buona elaborazione
L'elaborazione in transito dovrebbe essere flessibile senza trasformare il livello di ingestion in una giungla di trasformazioni incontrollate. Le configurazioni più solide applicano di solito trasformazioni leggere durante l'ingestion e lasciano la logica di business più pesante alla modellazione nativa del data warehouse.
Cercate queste funzionalità:
Filtro e selezione, per non spostare record irrilevanti solo perché una sorgente li espone.
Mapping dello schema che supporti un allineamento controllato ai modelli di destinazione.
Mascheramento o protezione a livello di campo quando i valori sensibili non devono viaggiare in forma grezza.
Supporto per i pattern sia ETL sia ELT, perché sorgenti ed esigenze di compliance diverse richiedono approcci diversi.
Se la strategia della vostra piattaforma include un livello di affidabilità più ampio, assicuratevi che lo strumento di ingestion possa collegarsi in modo pulito al resto del vostro ecosistema. I team spesso sottovalutano il valore di integrazioni semplici con la piattaforma dati finché non iniziano a collegare tra loro monitoraggio, workflow del data warehouse e controlli a valle.
Prestazioni e adeguatezza operativa
Le dichiarazioni sulle prestazioni sono facili da gonfiare, quindi ancorate la vostra valutazione a metriche operative concrete. I benchmark sulla velocità di ingestion misurano tipicamente throughput, latenza ed efficienza delle risorse. Nelle pipeline ad alto throughput, Apache Kafka è stato citato con oltre 1 milione di messaggi al secondo e una latenza end-to-end inferiore a 10 ms con carichi enterprise tipici nella panoramica di Improvado su strumenti e benchmark di ingestion. Anche se non usate mai Kafka direttamente, queste sono le categorie di cui il vostro fornitore dovrebbe saper parlare con chiarezza.
La domanda giusta sulle prestazioni non è "Quanto è veloce?". È "Quanto è veloce con le mie modalità di guasto, il mio ritmo di modifiche degli schemi e le mie finestre di ripristino?"
Una checklist pratica per la valutazione dei fornitori:
Misurate il comportamento a regime. Chiedete come si comporta lo strumento con il normale carico quotidiano, non solo nelle demo sintetiche di picco.
Verificate le condizioni degradate. Cosa succede durante i retry, il throttling della sorgente o le interruzioni parziali della destinazione?
Esaminate l'efficienza delle risorse. Uno spostamento a bassa latenza che consuma troppo calcolo non è una vittoria.
Testate replay e backfill. Molti strumenti sembrano ottimi il primo giorno e diventano faticosi al centesimo, quando dovete rieseguire lo storico.
Controllate gli hook di monitoraggio. Se la piattaforma non riesce a far emergere in modo chiaro lag, stati di errore ed eventi di schema, le operations ne soffriranno.
Un buon software di data ingestion non si limita a spostare i dati velocemente. Si comporta in modo prevedibile quando contratti dati, sistemi sorgente e aspettative di business cambiano tutti contemporaneamente.
Proteggere le pipeline di ingestion on-premises e nel cloud
All'inizio i problemi di sicurezza nelle pipeline di ingestion raramente sono eclatanti. Di solito si manifestano come service account con permessi eccessivi, dati grezzi copiati nell'ambiente sbagliato o campi sensibili finiti dove non sarebbero mai dovuti arrivare. Poiché l'ingestion si trova al confine tra i sistemi, è uno dei primi punti da rafforzare.
Il modello di deployment è una decisione di sicurezza
La prima domanda è dove gira il software. Le piattaforme di ingestion SaaS offrono velocità e comodità, soprattutto per le sorgenti cloud più comuni. Il private cloud vi dà più controllo sui confini di rete e sulle policy operative. I deployment on-premises restano importanti quando la residenza dei dati, le regole di accesso interne o gli ambienti regolamentati limitano ciò che può uscire dal vostro perimetro.
Questo compromesso non riguarda solo la fiducia nel cloud. Riguarda chi controlla l'esecuzione, dove risiedono le credenziali, come vengono archiviati i log e se i dataset grezzi attraversano infrastrutture gestite dal fornitore. Nella finanza, nella sanità, nelle telecomunicazioni e nel settore pubblico, queste domande spesso determinano la shortlist prima ancora che inizi il confronto delle funzionalità.
Un modo pratico per inquadrarlo:
SaaS è adatto ai team che danno priorità a un rollout rapido e a un'ampia connettività gestita.
Private cloud funziona quando servono pattern gestiti con un controllo più forte sull'ambiente.
On-premises è adatto alle organizzazioni che non possono accettare l'accesso ai dati da parte del fornitore o un'elaborazione esternalizzata per i dataset critici.
Se il vostro team ha bisogno di supporto esterno per rafforzare la postura di sicurezza circostante, può essere utile un fornitore con esperienza nell'hardening operativo. Risorse come la cyber security di REDCHIP IT Solutions sono utili quando la sicurezza dell'ingestion deve essere allineata ai controlli infrastrutturali più ampi, anziché essere trattata come un'impostazione isolata di uno strumento.
I controlli di sicurezza che devono essere irrinunciabili
Il deployment è solo metà della storia. Il software ha bisogno anche di controlli solidi su come si muovono i dati e su chi può accedervi.
L'elenco di base è breve, ma serio:
Crittografia in transito e a riposo, affinché i dati non siano esposti mentre si spostano o si trovano in uno storage intermedio.
Controllo degli accessi basato sui ruoli per limitare chi può configurare i connettori, visualizzare i payload o avviare replay.
Isolamento delle credenziali e supporto alla rotazione, perché i segreti di lunga durata diventano debito operativo.
Mascheramento dei dati e gestione selettiva dei campi per gli elementi sensibili che non devono viaggiare in forma grezza.
Logging e auditabilità, affinché i team possano indagare su modifiche, guasti ed eventi di accesso.
Controlli di rete e di deployment coerenti con il resto degli standard della vostra piattaforma.
C'è un ulteriore elemento che vale la pena condividere con engineering e sicurezza insieme:
Le revisioni di sicurezza si concentrano spesso sul data warehouse di destinazione, perché è lì che i dati si accumulano. In pratica, il percorso di ingestion merita la stessa attenzione. È lì che si incontrano credenziali, trasformazioni, retry, buffer temporanei e interfacce esterne. Se non proteggete quel percorso, il resto della piattaforma eredita rischi evitabili.
Perché l'ingestion ha bisogno di data quality e observability
Una pipeline può essere verde ed essere comunque sbagliata. È questo il motivo principale per cui l'ingestion da sola non basta. Spedire i dati dalla sorgente alla destinazione dimostra solo che lo spostamento è avvenuto. Non dimostra che i dati siano arrivati completi, puntuali, strutturalmente coerenti o logicamente validi.
Consegnare i dati non significa potersene fidare
L'analogia più semplice è quella tra spedizione e ispezione. L'ingestion è il corriere che porta i pacchi alla banchina. Qualità e osservabilità sono il livello di ispezione che verifica se sono arrivati i pacchi giusti, se manca qualcosa e se il contenuto corrisponde alle aspettative.
Molti team cedono spesso a una falsa sicurezza. L'orchestratore dice che il job è stato completato. Il connettore non ha dato errori. La tabella di destinazione esiste. Ma gli analisti continuano a lamentarsi che la dashboard di ieri è obsoleta, che un KPI si è spostato all'improvviso o che un modello ha iniziato a prendere decisioni strane. Il problema di fondo è di solito uno di questi:
Problemi di puntualità, quando i dati arrivano in ritardo o non arrivano affatto.
Modifiche di schema che alterano i presupposti a valle senza rotture evidenti.
Drift dei valori che cambia il significato o la distribuzione di campi importanti.
Problemi di qualità a livello di record, come picchi di valori null, chiavi malformate o eventi duplicati.
Una piattaforma affidabile osserva queste condizioni dal momento in cui i dati arrivano, non solo dopo che gli utenti si accorgono che qualcosa si è rotto. Se state confrontando i confini tra queste discipline, questa spiegazione su data observability e data quality a confronto è un utile riferimento, perché i team spesso le confondono nelle discussioni di design.
Un programma di ingestion di successo non si ferma alla consegna. Produce prove che i dati consegnati sono utilizzabili.
Duplicati e anomalie non sono lo stesso problema
Una sfumatura gestita male di continuo è la differenza tra un duplicato e un'anomalia. Sembrano correlati, ma portano a percorsi di risoluzione diversi.
Secondo la panoramica di IBM sulla data ingestion, la confusione tra duplicazione e anomalia nel monitoraggio dell'ingestion viene affrontata raramente, e questa lacuna porta i team ad applicare regole per le anomalie ai record duplicati, sprecando risorse. È un fallimento pratico, non semantico.
Ecco la distinzione netta:
Problema | Cosa significa di solito | Risposta migliore |
|---|---|---|
Record duplicato | Lo stesso evento o entità di business è stato caricato più di una volta | Deduplicare, esaminare le chiavi, rivedere idempotenza e logica di replay |
Anomalia | È cambiato qualcosa nella forma, nella tempistica o nel comportamento statistico dei dati | Indagare su modifiche a monte, stato della pipeline o cambiamenti nei processi di business |
Se trattate i duplicati come anomalie, fate escalation del rumore invece di correggere la semantica dell'ingestion. Se trattate le anomalie come duplicati, rischiate di cancellare le prove di un problema reale a monte. Un'osservabilità solida separa presto queste classi, così gli engineer sanno se correggere la meccanica della pipeline, il comportamento della sorgente o le regole di business.
Un modello operativo solido di solito include entrambi:
Regole di validazione per le aspettative esplicite a livello di record
Monitoraggio della puntualità per arrivi e ritardi
Tracciamento dello schema per i cambiamenti strutturali
Rilevamento delle anomalie per variazioni inattese di distribuzione o pattern
È così che l'ingestion diventa una base affidabile invece di un semplice livello di trasporto.
La data ingestion nella pratica: casi d'uso e checklist
Il valore del software di data ingestion si vede più facilmente quando fallisce sotto carichi di lavoro reali. I casi d'uso mettono rapidamente in luce le decisioni architetturali, perché ciascuno dà importanza a una diversa combinazione di velocità, completezza e tolleranza al rumore.
Dove le scelte di ingestion emergono nei sistemi reali
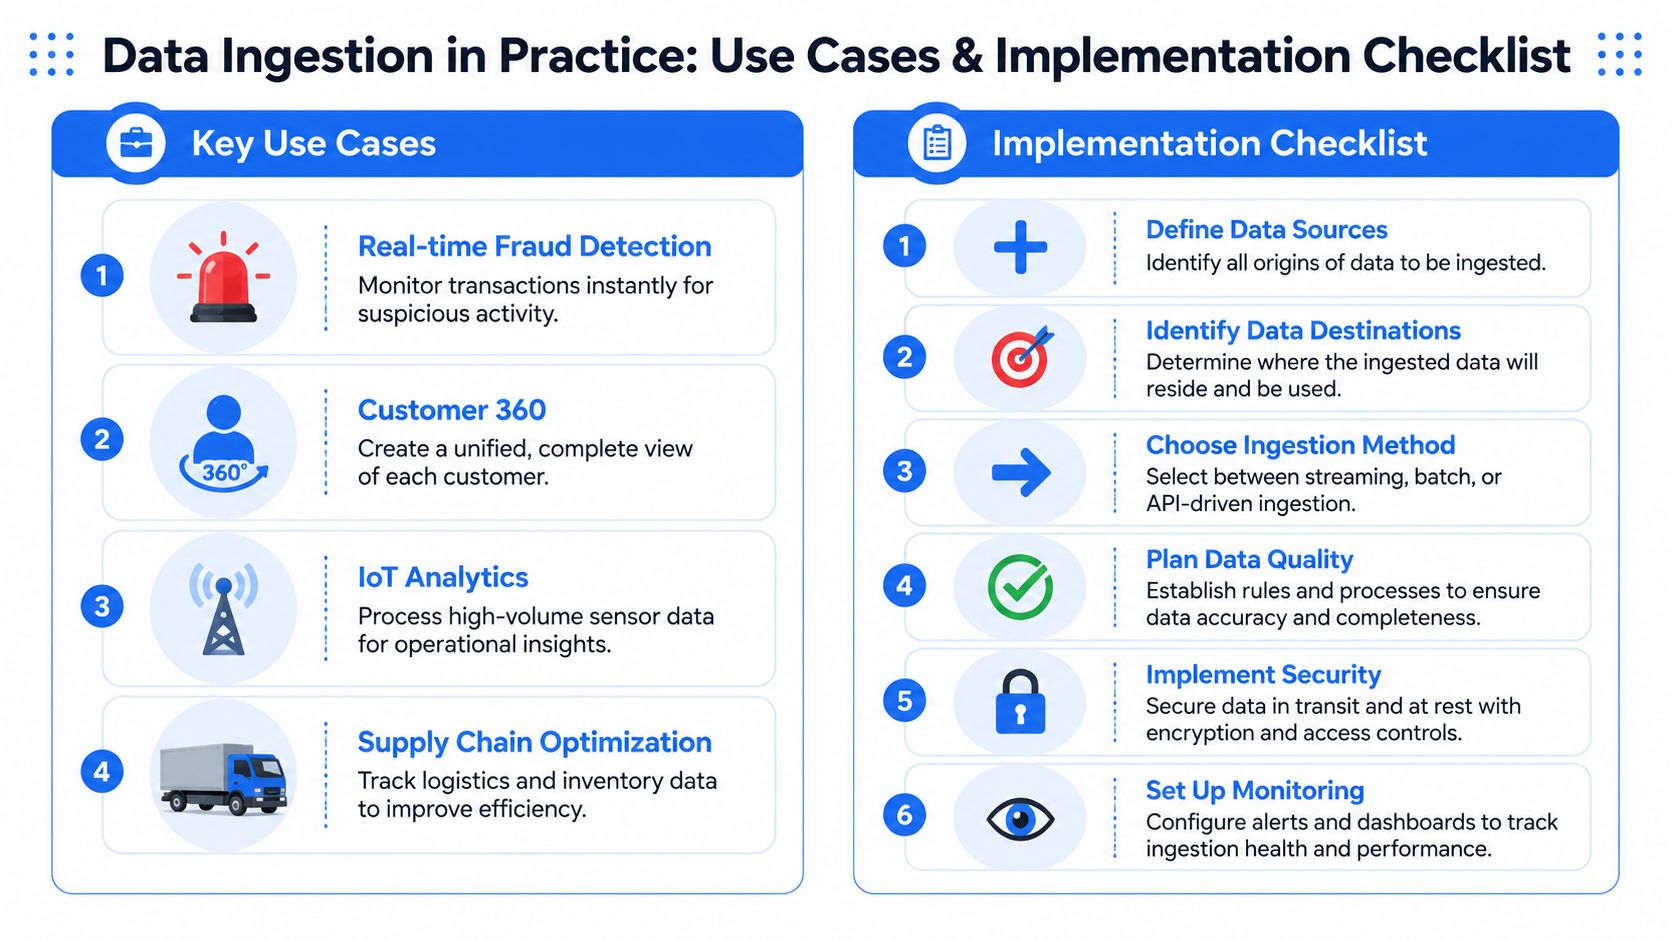
Nella finanza, l'ingestion in streaming supporta il monitoraggio delle transazioni e i workflow sulle attività sospette, dove aspettare un aggiornamento notturno non è accettabile. Nei progetti di modernizzazione del data warehouse, l'ingestion batch è spesso la risposta pratica, perché i team devono spostare in modo controllato grandi dataset storici prima di ottimizzare la freschezza. Nella customer analytics, i pattern ibridi sono comuni perché i team di business vogliono un'attività quasi aggiornata, mentre i data engineer hanno comunque bisogno di riconciliare i record arrivati in ritardo o corretti.
Le pipeline di AI e ML aggiungono un'ulteriore complicazione. I team spesso riducono la scelta di design a "tempo reale o batch", ma è una semplificazione eccessiva. Come osserva la spiegazione di Skyvia sulla data ingestion, i compromessi sulla latenza per le pipeline di AI e ML sono spesso semplificati troppo, e un'ingestion in tempo reale eccessiva può destabilizzare i modelli introducendo rumore più velocemente di quanto i modelli riescano ad adattarsi. Nella pratica succede quando le pipeline di feature inviano subito ogni nuovo segnale, anche se il modello o il processo di training non è progettato per assorbire quella volatilità.
Un'ingestion veloce è utile solo quando i consumatori a valle riescono a interpretare i dati in arrivo senza diventare meno stabili.
Lo stesso principio vale per l'analytics operativa. Il tempo reale non è necessariamente migliore. Lo è solo quando il workflow che consuma i dati ne trae beneficio e la piattaforma riesce a preservare la fiducia a quella velocità.
Una checklist pratica per il rollout
Un rollout di solito ha successo quando i team prendono alcune decisioni presto e in modo esplicito.
Censite sorgenti e owner
Elencate ogni sorgente, chi ne è responsabile, con quale frequenza cambia e che aspetto ha un guasto. Una responsabilità non chiara rallenta in seguito la risposta agli incidenti.Definite le destinazioni in base al caso d'uso
Non instradate tutto nello stesso posto per impostazione predefinita. Data warehouse, data lake, feature store e destinazioni operative richiedono spesso contratti di ingestion diversi.Scegliete l'architettura per ciascun data product
Usate batch, streaming o ibrido in base ai requisiti dei consumatori, non alle impostazioni predefinite degli strumenti.Stabilite le aspettative di qualità prima del primo caricamento
Documentate i campi obbligatori, i presupposti sull'unicità delle chiavi, le aspettative di puntualità e l'evoluzione accettabile degli schemi.Proteggete presto il percorso
Blindate credenziali, ambiti di accesso, logging e trattamento dei campi sensibili prima che le pipeline si moltiplichino.Pianificate il monitoraggio fin dal primo giorno
Tracciate guasti, lag, arrivi mancanti, modifiche di schema e variazioni sospette dei valori come parte dei criteri di lancio.Progettate replay e ripristino
Prima o poi ogni pipeline avrà bisogno di backfill, riconciliazione o supporto per riesecuzioni parziali.Create una checklist operativa per i team
Un framework condiviso aiuta quando analytics engineer, data engineer e responsabili della piattaforma lavorano tutti sullo stesso sistema. Questa checklist sull'affidabilità dei dati per i team dati è un utile punto di riferimento per trasformare l'affidabilità in un'abitudine operativa anziché in un ripensamento.
I team che lo fanno bene non si limitano a implementare l'ingestion. Definiscono cosa significa "arrivo sano" prima che i dati inizino a muoversi.
Scegliere la giusta strategia di ingestion per il 2026
Scegliere un software di data ingestion per il 2026 non significa davvero scegliere il prodotto con più connettori o con il setup più elegante. Significa scegliere una strategia adatta ai vostri data product, al vostro modello operativo e alla vostra tolleranza al rischio. Lo strumento sbagliato può certamente rallentarvi. Ma il fallimento più comune è acquistare uno strumento discreto e circondarlo di presupposti deboli.
Le decisioni chiave sono semplici. Adattate l'architettura al caso d'uso. Decidete dove deve girare il software in base alle esigenze di controllo e compliance. Valutate i connettori per la loro resilienza, non solo per la loro ampiezza. Fate delle prestazioni una questione di comportamento operativo, non di velocità da brochure. Poi aggiungete i controlli che trasformano lo spostamento in fiducia: controlli di puntualità, regole di validazione, consapevolezza dello schema e monitoraggio delle anomalie.
È questo il cambiamento chiave che fanno i team maturi. Smettono di chiedersi "Come acquisiamo più dati?" e iniziano a chiedersi "Come garantiamo che ogni consumatore a valle riceva dati abbastanza freschi, completi e affidabili da poterci agire?". Questo cambio di mentalità migliora più della salute delle pipeline. Riduce i cicli di debugging sprecati, dà agli analisti fiducia nei risultati e protegge i sistemi di ML da input fragili.
L'ingestion è la prima promessa che fa la vostra piattaforma dati. Promette che i dati arriveranno. Una piattaforma moderna deve fare anche una seconda promessa: i dati in arrivo saranno utilizzabili.
Se volete che questa seconda promessa sia integrata nel vostro stack, digna aiuta i team a monitorare la puntualità, rilevare le anomalie, validare i record e tracciare le modifiche di schema all'interno di ambienti controllati dal cliente, così che l'ingestion non si fermi alla consegna.
Domande frequenti
Che cos'è un software di data ingestion?
Un software di data ingestion raccoglie dati da molte sorgenti e li consegna a data warehouse, data lake o store operativi dove analisti, strumenti di BI e sistemi di ML possono utilizzarli. L'articolo lo paragona alla rete logistica di una fabbrica di dati e sottolinea che si tratta di un sistema operativo continuo, non di un'attività di integrazione una tantum.
Qual è la differenza tra ingestion batch, streaming e ibrida?
L'ingestion batch è il furgone postale a orari fissi, che carica i dati in blocco in momenti noti; lo streaming è la conduttura dell'acqua, che consegna flussi continui di eventi o CDC quasi immediatamente. L'ibrida combina un percorso veloce per le modifiche recenti con una riconciliazione batch pianificata, offrendo flessibilità ma la maggiore complessità operativa delle tre.
In che modo il change data capture migliora la data ingestion?
Il CDC sincronizza solo i dati modificati anziché estrazioni complete. Citando Valiotti, l'articolo osserva che l'ingestion basata su CDC può ridurre la latenza da ore a millisecondi e che strumenti come Fivetran ed Estuary Flow possono ridurre il carico sulle API fino al 90%, un aspetto importante per le sorgenti SaaS con rate limit.
Cosa bisogna valutare nella scelta degli strumenti di data ingestion?
Date priorità alla profondità dei connettori rispetto al loro numero: chiedete come i connettori gestiscono modifiche di schema, estrazione incrementale, cambiamenti delle API delle sorgenti e sistemi interni personalizzati. Poi testate il comportamento a regime, le condizioni degradate, l'efficienza delle risorse, replay e backfill e gli hook di monitoraggio, perché molti strumenti sembrano ottimi il primo giorno e faticosi al centesimo.
Qual è la differenza tra un duplicato e un'anomalia nella data ingestion?
Un duplicato significa che lo stesso evento o entità di business è stato caricato più di una volta e richiede una deduplicazione e una revisione dell'idempotenza e della logica di replay. Un'anomalia è un cambiamento nella forma, nella tempistica o nel comportamento statistico dei dati che richiede di indagare sulle modifiche a monte. Confondere i due spreca risorse o cancella prove.


