Qualità dei dati in tempo reale: guida pratica per il 2026
|
7
min di lettura

Conoscete già questa sensazione. Al mattino la dashboard sembrava a posto, all'ora di pranzo il sistema sorgente era cambiato e, quando qualcuno se n'è accorto, il warehouse raccontava già una storia non vera. Negli ambienti regolamentati, un divario del genere non è un problema estetico. È così che un feed non aggiornato si trasforma in una decisione sbagliata, in un report rotto o in un incidente che nessuno sa spiegare con chiarezza.
La qualità dei dati in tempo reale è la disciplina che intercetta questi guasti mentre i dati sono ancora in movimento. Significa che i controlli di qualità non sono più un'attività di pulizia notturna, ma fanno parte del percorso operativo live, legati a freschezza, latenza, modifiche allo schema e conteggi dei valori null come segnali osservabili dello stato di salute metriche di observability di IBM. Significa anche che l'architettura deve rispettare una dura verità: la validazione in streaming deve funzionare in modo continuo senza compromettere la latenza end-to-end (ricerca IJERET sulla qualità in streaming).
Indice
Il momento in cui la qualità batch smette di funzionare
La modalità di guasto è familiare. Il martedì una dashboard finanziaria appare coerente, un modello produce score normali, poi il venerdì i numeri iniziano a deviare, ma nessuno sa indicare il momento esatto in cui i dati si sono guastati. I controlli batch possono dire che il caricamento di ieri è andato a buon fine, mentre il vero problema è iniziato tra un job e l'altro e si è propagato a valle prima che qualcuno avesse la possibilità di fermarlo.
Per questo la qualità in tempo reale non è solo un “batch più veloce”. È un modello operativo diverso. La ricerca sulla qualità in streaming descrive metriche di qualità calcolate in modo continuo, così che i team possano rilevare i problemi all'arrivo dei dati anziché dopo i job di elaborazione notturni: un cambiamento significativo nel modo in cui gli ingegneri pensano al controllo, non solo agli strumenti articolo ACM sulla streaming analytics.
La freschezza cambia la definizione di qualità
Nella pratica, la dimensione che manca è spesso la timeliness. Un dataset può essere tecnicamente valido e tuttavia operativamente sbagliato se è in ritardo, mancante o arriva fuori dalla cadenza prevista. Per questo freschezza, latenza e comportamento delle pipeline contano oggi quanto le dimensioni classiche di accuratezza e completezza.
Regola pratica: se la dashboard dipende da dati sensibili al tempo, trattate il ritardo come un difetto di qualità, non come un semplice fastidio della pipeline.
La validazione batch ha ancora un ruolo, soprattutto per gli audit retrospettivi e la profilazione approfondita. Ma per frodi, operations e flussi rivolti ai clienti, aspettare il prossimo job pianificato è il modo in cui i record errati si diffondono. La qualità in tempo reale esiste perché il costo per il business del ritardo si manifesta prima che si chiuda la finestra batch.
Che cosa significa davvero qualità dei dati in tempo reale
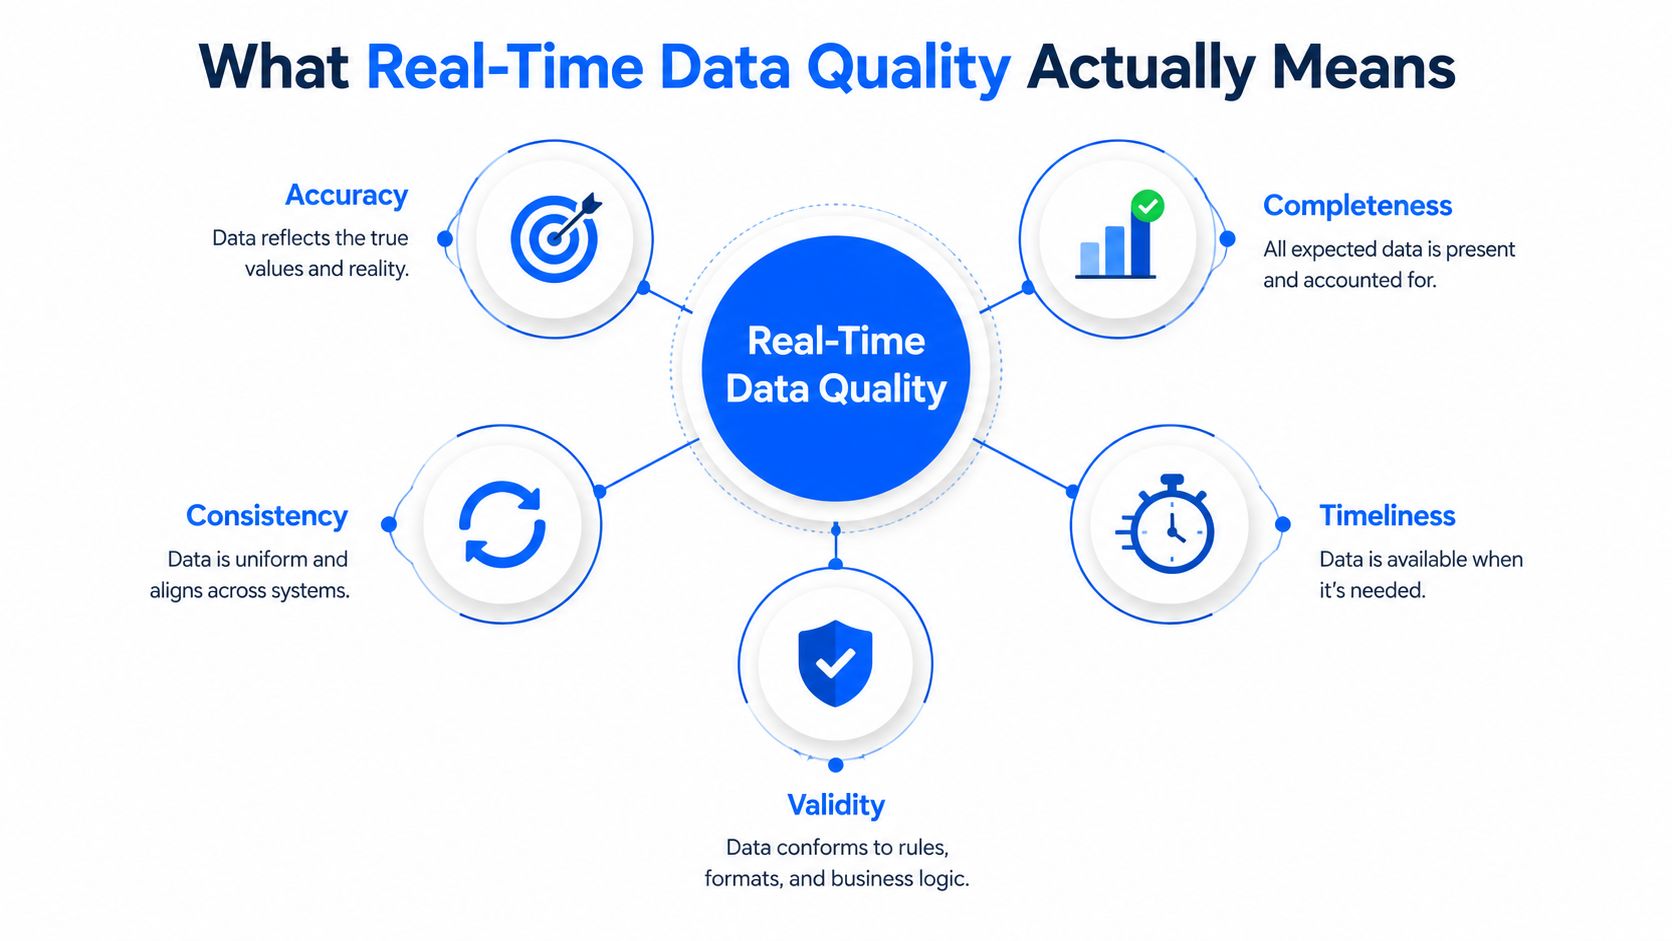
Una definizione utile è semplice. La qualità dei dati in tempo reale è il controllo continuo dei dati mentre attraversano la pipeline, con verifiche che stabiliscono se ogni record è adatto all'uso a valle nel momento in cui arriva. Lo scopo non è costruire un secondo warehouse di regole, ma impedire che problemi strutturali e comportamentali oltrepassino il confine verso i sistemi di produzione.
La freschezza è al centro
Nei sistemi in tempo reale, la freschezza è di solito la prima metrica a rivelare un problema. Un modo standard per definirla è il tempo trascorso dalla scrittura del record più recente in un dataset, misurato rispetto a uno SLA indicazioni di Soda sulla metrica di freschezza. Questo rende la freschezza un concetto operativo, non filosofico.
Le altre dimensioni diventano più facili da gestire una volta definita la freschezza:
La completezza vi dice se i campi e le sorgenti attesi sono arrivati.
La validità vi dice se i valori corrispondono a formato, tipo e intervallo attesi.
La coerenza vi dice se la stessa entità concorda tra i diversi sistemi.
L'unicità vi dice se nello stream si stanno infiltrando duplicati.
Le dimensioni standard di IBM includono accuratezza, completezza, coerenza, timeliness, validità e unicità, e la definizione di validità del governo britannico mantiene l'attenzione su formato, tipo e intervallo dimensioni della qualità dei dati secondo IBM.
Un singolo record può essere valutato rispetto a tutte queste dimensioni al momento dell'ingestione. Se un evento d'ordine arriva in tempo, con lo schema corretto, una valuta accettata, nessun ID duplicato e dati di riferimento del cliente corrispondenti, supera i controlli. Se arriva in ritardo o con una modifica di tipo, il sistema dovrebbe segnalare la dimensione specifica che non è stata rispettata, non limitarsi a marcarlo come “errato”.
La timeliness non è una metrica secondaria. Nei sistemi live fa parte della definizione stessa di qualità.
Qualità in tempo reale e qualità batch: dove cede ciascuna
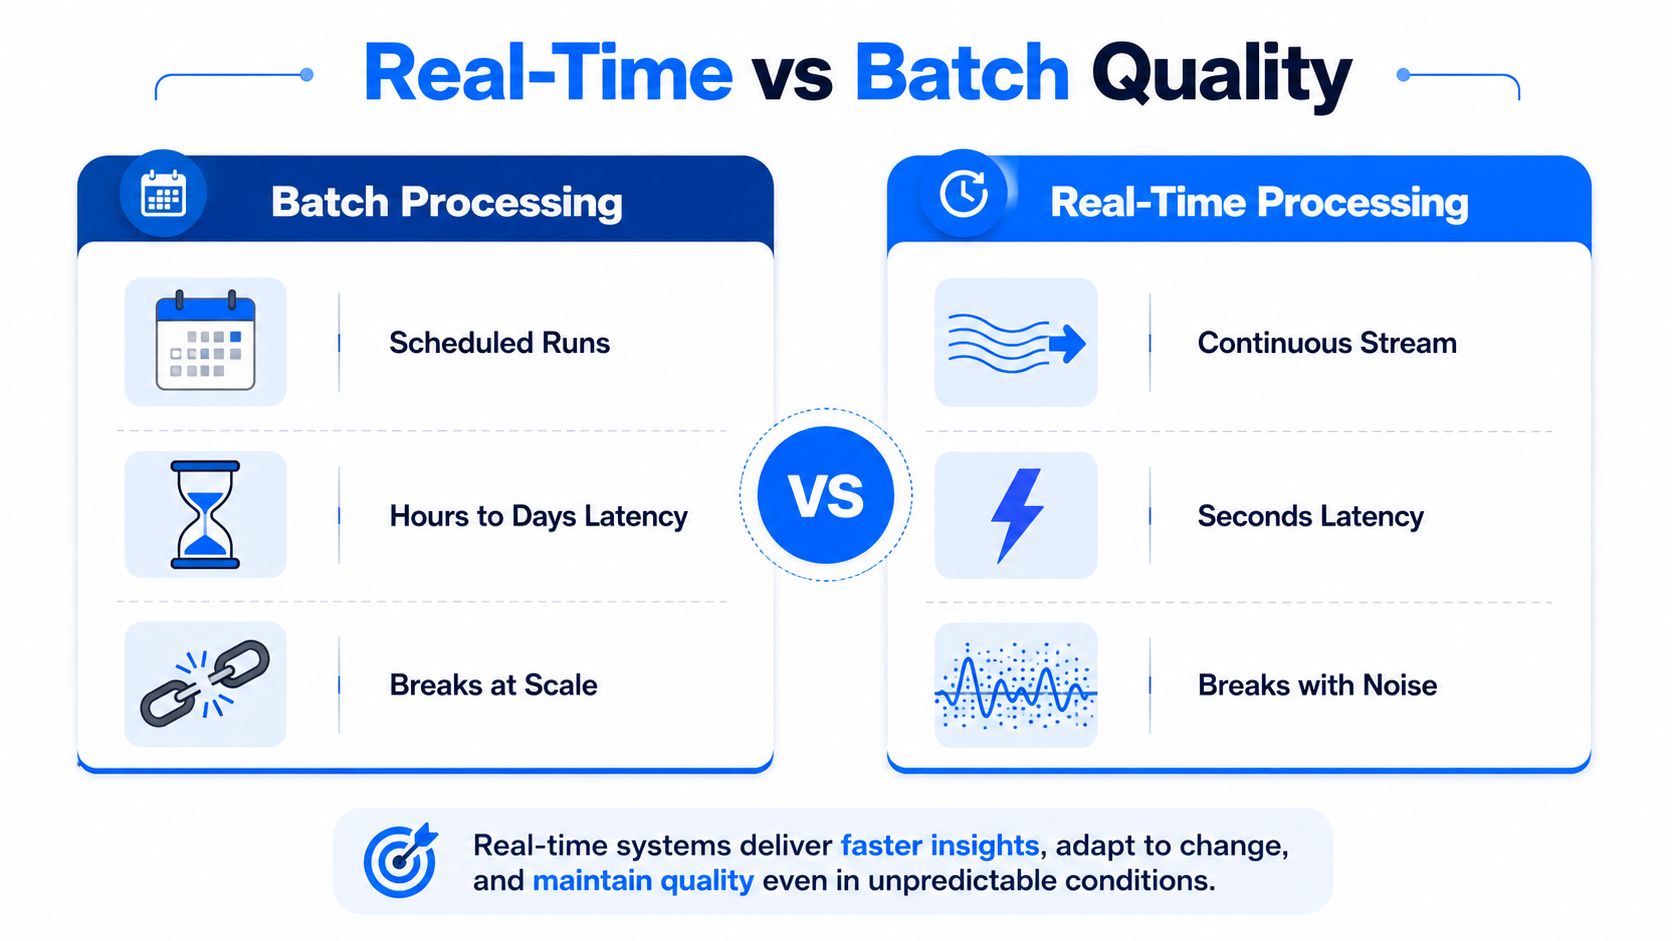
Qualità batch e qualità in tempo reale non sono rivali. Sono superfici di controllo diverse. Il batch offre ampiezza, contesto storico e un'analisi retrospettiva più economica. Il tempo reale offre la possibilità di bloccare gli eventi errati prima che contaminino dashboard, modelli o flussi rivolti ai clienti.
La distinzione conta perché lo stesso dataset si comporta in modo diverso nei due regimi. Un job notturno può intercettare righe malformate dopo il caricamento, mentre un controllo in streaming può fermarle all'ingestione. I micro-batch pianificati riducono il divario, ma lasciano comunque punti ciechi tra un'esecuzione e l'altra. Lo streaming continuo colma questo divario validando i dati mentre sono ancora in movimento indicazioni di Confluent sull'architettura di streaming.
Dove il batch ha ancora senso
La qualità batch si guadagna ancora il suo posto nei programmi che richiedono profilazione approfondita, indagini post-incidente o evidenze pronte per l'audit. È utile quando volete analizzare storici estesi, confrontare distribuzioni o dimostrare che un controllo è stato eseguito secondo una pianificazione specifica. In altre parole, il batch è adatto all'analisi.
Dove fallisce clamorosamente
Fallisce quando al business interessa lo stato attuale del mondo. Dashboard dei ricavi, rilevamento delle frodi, alert clinici e SLA operativi dipendono tutti da dati abbastanza aggiornati da poter agire. Se un fornitore salta un'esecuzione notturna, il report può sembrare pulito mentre il warehouse è già indietro di ore. È il peggior tipo di guasto, perché i numeri sembrano affidabili.
Il batch dice che il job è terminato. Il tempo reale dice che i dati sono ancora adatti all'uso.
La risposta pratica è di solito mista. Lasciate al batch il lavoro retrospettivo approfondito, ma spostate nel percorso di streaming i controlli all'ingestione, i controlli di timeliness e la validazione critica per il business. In questo modo il report notturno diventa una conferma, non la prima linea di difesa.
All'interno della pipeline di qualità in tempo reale
Una pipeline di streaming pratica segue cinque passaggi. Primo, acquisite gli eventi in un livello di streaming. Poi validate lo schema al confine, applicate le regole di business al payload e instradate i record non validi in quarantena invece di scartarli. Successivamente, calcolate i KPI di qualità in modo continuo e generate alert quando le soglie vengono superate. Il flusso di pipeline di Confluent è un riferimento utile per questa sequenza.
Perché conta il luogo di esecuzione
L'errore più grande che i team commettono è spostare i dati verso un motore di qualità separato quando il sistema sorgente dispone già di contesto sufficiente per valutarli. Uno studio di Cambridge sui sistemi big data in tempo reale ha rilevato che l'overhead dei controlli di qualità dipende dai trasferimenti tra moduli, dalla sincronizzazione dei messaggi e dalla complessità degli algoritmi: ecco perché passaggi aggiuntivi possono rallentare l'intera pipeline studio di Cambridge sui big data in tempo reale. Nella pratica, questo spinge i team verso controlli in-stream e in-database.
L'applicazione dello schema va collocata all'ingestione, perché è il punto più economico in cui intercettare il drift strutturale. Le regole di business vanno subito dopo, mentre l'evento è ancora gestibile. La quarantena non è uno stato di errore, ma un punto di controllo. I record errati dovrebbero essere isolati, etichettati e mantenuti disponibili per la revisione, senza lasciare che inquinino i sistemi a valle.
L'architettura ha bisogno anche di un luogo condiviso in cui ingegneri e analisti possano vedere gli incidenti. Un'unica UI per anomalie, errori di validazione e violazioni della timeliness riduce i passaggi di consegne, soprattutto quando team di piattaforma e team di business devono esaminare lo stesso record nella stessa finestra. Questo conta ancora di più quando il modello operativo include il monitoraggio dei dati in tempo reale, perché chi sorveglia la pipeline deve distinguere rapidamente il rumore dai guasti reali.
Per i team che valutano gli strumenti, la checklist pratica è semplice: applicazione dello schema, regole in streaming, quarantena e metriche visibili. La configurazione giusta è quella che mantiene i controlli vicini ai dati, rende osservabili i guasti e mantiene la latenza entro la finestra che il business può tollerare.
Come si integrano esecuzione in-database, rilevamento delle anomalie e tracciamento dello schema
I sistemi più efficaci non trattano i moduli di monitoraggio come funzionalità isolate. Funzionano come un control plane. L'esecuzione in-database mantiene i dati dove si trovano, così i controlli avvengono all'interno dell'ambiente del cliente, riducendo lo spostamento dei dati e allineando il livello di qualità alla governance esistente. Il rilevamento delle anomalie aggiunge l'apprendimento delle baseline, così il sistema può segnalare scostamenti senza costringere gli ingegneri a scrivere a mano ogni soglia.
Tre capacità, tre diverse modalità di guasto
Il rilevamento delle anomalie dà il meglio quando il comportamento cambia ma lo schema resta stabile. Apprende la forma normale di un dataset e segnala pattern insoliti, picchi o cali. Il tracciamento dello schema copre una classe diversa di guasti: colonne aggiunte, colonne rimosse e modifiche ai tipi di dato che possono rompere i consumatori a valle prima ancora che venga eseguita la logica di business.
Il monitoraggio della timeliness colma la lacuna lasciata dagli altri due. Un dataset può apparire statisticamente normale ed essere comunque in ritardo, in anticipo o mancante. Per questo pattern di arrivo, tempi di consegna attesi e rilevamento dei ritardi appartengono allo stesso cervello operativo del rilevamento delle anomalie e della validazione.
I buoni sistemi di qualità non chiedono a un solo modulo di risolvere ogni problema. Sovrappongono i moduli, così che ciascuno intercetti una diversa modalità di guasto.
Per un punto di vista pratico sulla scelta del modello, la guida per scegliere la soluzione di rilevamento delle anomalie più adatta è utile quando dovete decidere se affidarvi a controlli deterministici, a baseline apprese o a entrambi. E se state applicando questo approccio a uno stack incentrato sul warehouse, il framework interno sul framework di qualità dei dati per Databricks è un utile punto di riferimento.
digna si inserisce in questo schema come una delle opzioni sul mercato, perché esegue i controlli nell'ambiente del cliente, supporta l'esecuzione in-database e combina rilevamento delle anomalie, timeliness, validazione e tracciamento dello schema in un'unica piattaforma. Questa combinazione conta più di qualsiasi singola funzionalità.
I KPI da monitorare davvero
Un programma in tempo reale non ha bisogno di una dashboard gigantesca. Ha bisogno di un breve elenco di metriche che corrispondano direttamente al rischio operativo. Iniziate da freschezza, latenza, numero di record obsoleti, percentuale di valori al di fuori degli intervalli accettati, rapporto dei record che non superano le regole di validazione ed errori di sintassi o formato, come indirizzi email non validi metriche di qualità dei dati di Alation.
La metrica giusta dipende dal guasto che volete fermare. La freschezza vi dice se l'ultimo caricamento è utilizzabile. La latenza vi dice quanta parte del dataset ha rispettato la finestra dello SLA. Il tasso di errori di validazione vi dice se le regole sono troppo permissive o se i dati a monte sono cambiati. I valori fuori intervallo intercettano eventi di business errati che appaiono comunque sintatticamente validi.
KPI fondamentali della qualità dei dati in tempo reale
Dimensione | Metrica | Come misurarla | Soglia di riferimento |
|---|---|---|---|
Freschezza | Tempo trascorso dall'ultimo record | Confrontate l'ora dell'ultima scrittura con la finestra dello SLA | Definita per ogni dataset critico |
Latenza | Percentuale di record aggiornati entro lo SLA | Misurate i record che arrivano entro la finestra prevista | Definita per ogni pipeline |
Completezza | Campi obbligatori mancanti | Contate i campi obbligatori presenti in ogni record | Definita per livello di dataset |
Validità | Record al di fuori dell'intervallo accettato | Validate tipo, formato e intervallo all'ingestione | Definita dalla regola di business |
Validazione | Record che non superano le regole | Contate i record rifiutati o messi in quarantena | Definita per ogni controllo |
La regola empirica è collegare ogni metrica tecnica a una conseguenza di business. Se una tabella dei ricavi non rispetta lo SLA di freschezza, il problema non è un'icona gialla, ma una finestra di reporting mancata. È così che il monitoraggio resta utile invece che decorativo.
Per mantenere il programma con i piedi per terra, definite la metrica, fissate la soglia, automatizzate il controllo e monitorate il risultato nel tempo. La pagina interna sulle metriche di qualità dei dati è un buon punto di partenza per trasformare questa disciplina in un pattern operativo ripetibile.
Sfide comuni e considerazioni sulla sicurezza
La maggior parte dei programmi di qualità in tempo reale fallisce per problemi di governance, non per la logica di rilevamento. Le soglie diventano troppo aggressive e subentra l'alert fatigue. L'ownership si fa confusa quando un incidente coinvolge contemporaneamente il team della sorgente, il team di piattaforma e il business owner. Poi qualcuno acquista un altro strumento e lo stack diventa più difficile da gestire.
La sicurezza si decide nell'architettura, non nelle slide sulle policy
Ai team regolamentati interessa dove vengono eseguiti i controlli. Se un fornitore richiede che i dati escano dall'ambiente del cliente, questo crea un onere di revisione e spesso un ostacolo insormontabile. Eseguire i controlli in-database, all'interno del cloud, della VPC o dell'ambiente on-premises del cliente, mantiene il livello di qualità sotto gli stessi controlli di accesso del warehouse.
Questo cambia anche l'economia del monitoraggio. Un pricing trasparente e stabile rispetto all'utilizzo rende più facile estendere la copertura senza temere che ogni nuovo alert o scansione si trasformi in un costo imprevisto. Anche un'unica UI condivisa aiuta, perché ingegneri, analisti e team di governance possono esaminare la stessa anomalia, lo stesso problema di timeliness, lo stesso errore di validazione o la stessa modifica allo schema senza scambiarsi screenshot.
L'errore principale è trattare la qualità in tempo reale come un'utility di nicchia. Nella pratica, fa parte contemporaneamente dell'observability della piattaforma, del business monitoring e dell'applicazione dei controlli. I team che centralizzano queste esigenze di solito dedicano meno tempo a riconciliare strumenti e più tempo a risolvere il vero problema dei dati.
Una checklist di rollout per fasi per iniziare
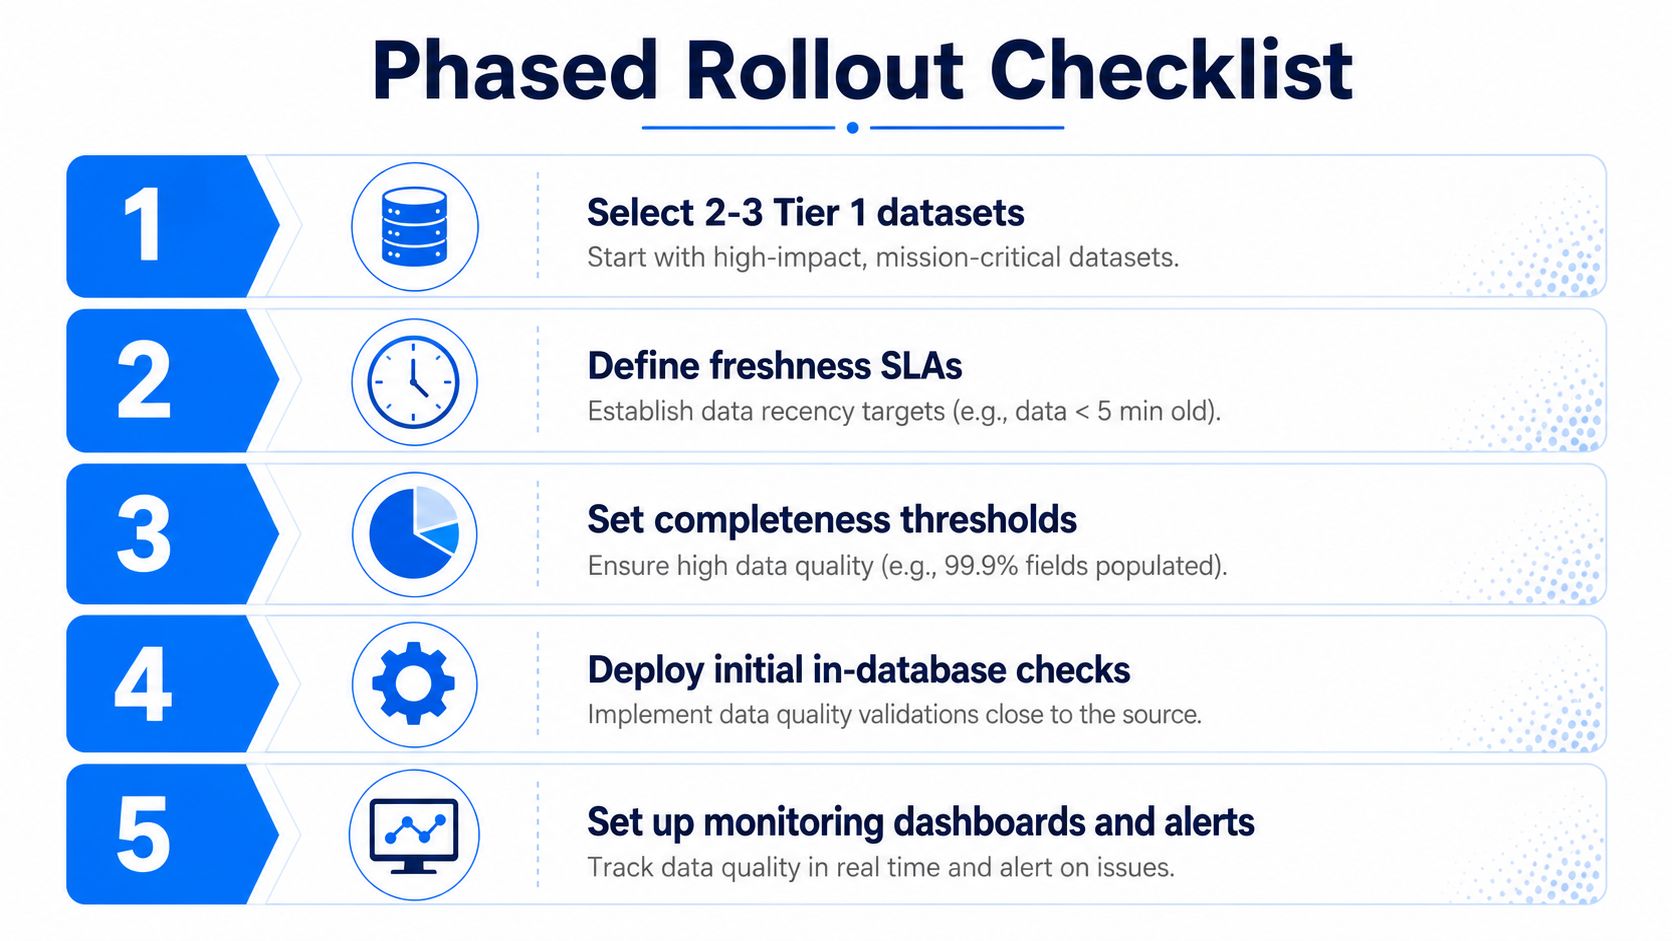
Iniziate in piccolo. Scegliete due o tre dataset di Tier 1 in cui dati non aggiornati o non validi creano un rischio di business evidente. Definite prima gli SLA di freschezza e completezza, poi abilitate l'esecuzione in-database, così che i controlli vengano eseguiti dove i dati già risiedono.
Un rollout che non crolla sotto il proprio peso
Selezionate i dataset giusti. Iniziate dalle tabelle che incidono direttamente su reporting, compliance o flussi rivolti ai clienti.
Definite gli SLA di freschezza. Rendete esplicita l'età accettabile dei dati.
Fissate le soglie di completezza. Decidete che cosa significa “utilizzabile” prima che scatti il primo alert.
Implementate i primi controlli in-database. Intercettate i difetti strutturali e basati su regole senza aggiungere ulteriori spostamenti di dati.
Attivate monitoraggio e alert. Collegate gli incidenti ai canali che il vostro team utilizza già.
L'errore da evitare è una copertura ampia prima di aver messo a punto ownership e soglie. Un progetto pilota rumoroso viene ignorato. Un progetto pilota mirato insegna al team come si comportano i controlli, ed è proprio questo l'obiettivo.
Se lavorate nei servizi finanziari, nella sanità, nelle telecomunicazioni o nel settore pubblico, vale lo stesso schema, solo con controlli e obblighi di reporting diversi. Lo scopo è rendere i dati affidabili lo stato predefinito della piattaforma, non un'esercitazione antincendio settimanale.
Se state costruendo questo modello operativo e cercate una piattaforma che mantenga i controlli all'interno del vostro ambiente, supporti l'esecuzione in-database e riunisca timeliness, validazione, rilevamento delle anomalie e tracciamento dello schema in un unico flusso di lavoro, visitate digna. È pensata per i team che hanno bisogno che la qualità dei dati in tempo reale funzioni come una disciplina operativa, non come un job batch con un intervallo più breve.
Domande frequenti
Che cos'è la qualità dei dati in tempo reale?
È la disciplina che intercetta i guasti mentre i dati sono ancora in movimento, anziché dopo che sono arrivati a destinazione. Non è un controllo batch più veloce, ma un modello operativo diverso, perché la finestra per intervenire si chiude mentre lo stream continua.
Quale dimensione viene a mancare per prima nello streaming?
La timeliness. Quando i dati sono continui, il ritardo smette di essere un dettaglio di pianificazione e diventa il difetto stesso: ecco perché la freschezza cambia la definizione operativa di qualità in un sistema in tempo reale.
Quando un ritardo va considerato un difetto di qualità?
Ogni volta che la dashboard dipende da dati sensibili al tempo. A quel punto un ritardo non è un fastidio della pipeline da tollerare, ma un'incapacità dei dati di essere ciò che dichiarano di essere, e merita lo stesso trattamento di un valore errato.
Perché la qualità batch smette di funzionare?
Perché le sue ipotesi non reggono più. Il controllo batch si basa su una finestra in cui i dati restano fermi abbastanza a lungo da poter essere ispezionati e, quando questa finestra scompare, gli stessi controlli arrivano dopo le decisioni che avrebbero dovuto proteggere.
Che cosa cambia nell'architettura?
La collocazione del controllo più che il suo contenuto. Le domande su freschezza, volume, distribuzione e validità restano le stesse, ma devono essere poste su uno stream in movimento e produrre una risposta abbastanza rapida da essere utile.


