Qualità dei dati ETL: guida pratica a pipeline affidabili
|
6
min di lettura

La vostra pipeline è diventata verde alle 2:14 di notte. All'ora di colazione, il reparto finanza sta fissando righe di ricavi che non hanno senso, gli analisti chiedono se il data warehouse è rotto e il vostro strumento di orchestrazione continua a sostenere che tutto è andato a buon fine. Questo divario tra salute dei job e salute dei dati è il punto in cui, nella pratica, la qualità dei dati ETL di solito fallisce.
La parte difficile non è eseguire i controlli. È progettare controlli che si accorgano di quando i dati hanno cambiato comportamento, non solo di quando un task è andato in errore. Le pipeline ETL possono terminare in tempo, rispettare i conteggi delle righe e comunque trasferire a valle dati corrotti, obsoleti o strutturalmente incompatibili: ecco perché la qualità va misurata sui dati stessi, non sul flag di successo associato al job.
Indice
Quando pipeline verdi producono dati rotti
Perché lo stato di esecuzione non basta
Cosa si rompe di solito per primo
Le cinque dimensioni di qualità che ogni pipeline ETL deve monitorare
Perché i cinque pilastri devono lavorare insieme
Cosa intercetta davvero ciascuna dimensione
Validazione basata su regole e rilevamento delle anomalie basato sull'AI
Dove vince ciascun approccio
Come combinarli senza creare il caos degli alert
Meccanismi di validazione a livello di record che intercettano i difetti
Usate soglie, non solo conteggi
Controlli che ripagano nella pratica
Monitoraggio della tempestività e finestre di consegna previste
Il drift dello schema e come rilevarlo prima che si rompa qualcosa a valle
Rilevate il drift al confine
Reagite senza trasformare ogni modifica in un disservizio
Costruire nella pratica uno stack di qualità ETL a più livelli
Come matura di solito lo stack
Chi è responsabile di cosa nello stack
Idee sbagliate comuni e una checklist pratica per la qualità
Una checklist da applicare già questa settimana
Quando pipeline verdi producono dati rotti
Un'esecuzione verde può sembrare a posto fino al momento in cui qualcuno apre la dashboard e vede numeri che non corrispondono alla realtà. Il livello ETL può terminare correttamente mentre un sistema sorgente modifica un campo decimale, un file arriva semivuoto o una conversione di tipo trasforma valori validi in qualcosa che si carica ancora, ma non significa più ciò che significava. Quando finanza, operations o BI si accorgono del problema, l'incidente della pipeline è già acqua passata e la pulizia si è spostata a valle.
La ricerca storica sull'ETL è molto chiara sull'origine di questi guasti. Uno studio sui deployment ETL ha rilevato che job ETL che falliscono a metà, sistemi bloccati durante l'esecuzione e utenti che non trovano i dati nella destinazione perché le chiavi primarie sono state trasformate in modo errato erano tra i problemi più comuni, e che quegli stessi processi causavano problemi di accuratezza, tempestività, credibilità e coerenza di rappresentazione (studio sui guasti di qualità dei dati nell'ETL). La lezione è semplice. La pipeline stessa può introdurre il difetto, anche quando il sistema sorgente sembrava a posto.
Perché lo stato di esecuzione non basta
Gli strumenti di orchestrazione riportano soprattutto se un task è stato eseguito, non se i dati si sono comportati correttamente. Un job può completarsi nei tempi previsti e comunque consegnare caricamenti parziali, saltare una partizione o convertire valori durante la trasformazione. Ecco perché i controlli vanno collocati a livello di dati, non solo a livello di workflow.
Regola pratica: considerate ogni esecuzione ETL riuscita come non verificata finché i dati non superano i controlli di freschezza, di schema e a livello di record.
Il costo di sbagliare non è astratto. Secondo una stima di Gartner, la scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di dollari all'anno, e le sintesi di settore osservano che i dati errati possono causare una perdita di ricavi dal 15% al 25% in alcune aziende: ecco perché i controlli di qualità ETL precoci sono così importanti (costi della scarsa qualità dei dati). Eppler e Helfert hanno inoltre descritto 23 tipi di costo distinti legati a dati di bassa qualità, tra cui manutenzione, lavoro in eccesso, reinserimento dei dati, perdita di ricavi, perdita di clienti e rilavorazioni. Hanno anche individuato 10 categorie di costi per l'assicurazione della qualità dei dati, come ispezione, prevenzione dei difetti, riparazione, formazione e miglioramento dei processi. In parole semplici, il conto arriva comunque, che investiate nella qualità o no.
Cosa si rompe di solito per primo
I guasti che fanno più male sono quelli silenziosi. Un file arriva in ritardo ma si carica comunque. Un sistema sorgente aggiunge una colonna e il vostro parser la ignora. Un campo numerico diventa testo e il warehouse lo accetta dopo una conversione. Nessuno di questi problemi blocca necessariamente il job, ma tutti avvelenano i dati.
La risposta giusta è un monitoraggio a più livelli, non la speranza. Vi servono segnali comportamentali che vi dicano quando la pipeline produce dati che non corrispondono più alla struttura, alle tempistiche o alla distribuzione che vi aspettate. Questo significa guardare oltre l'esecuzione, dentro le proprietà dei record stessi.
Le cinque dimensioni di qualità che ogni pipeline ETL deve monitorare
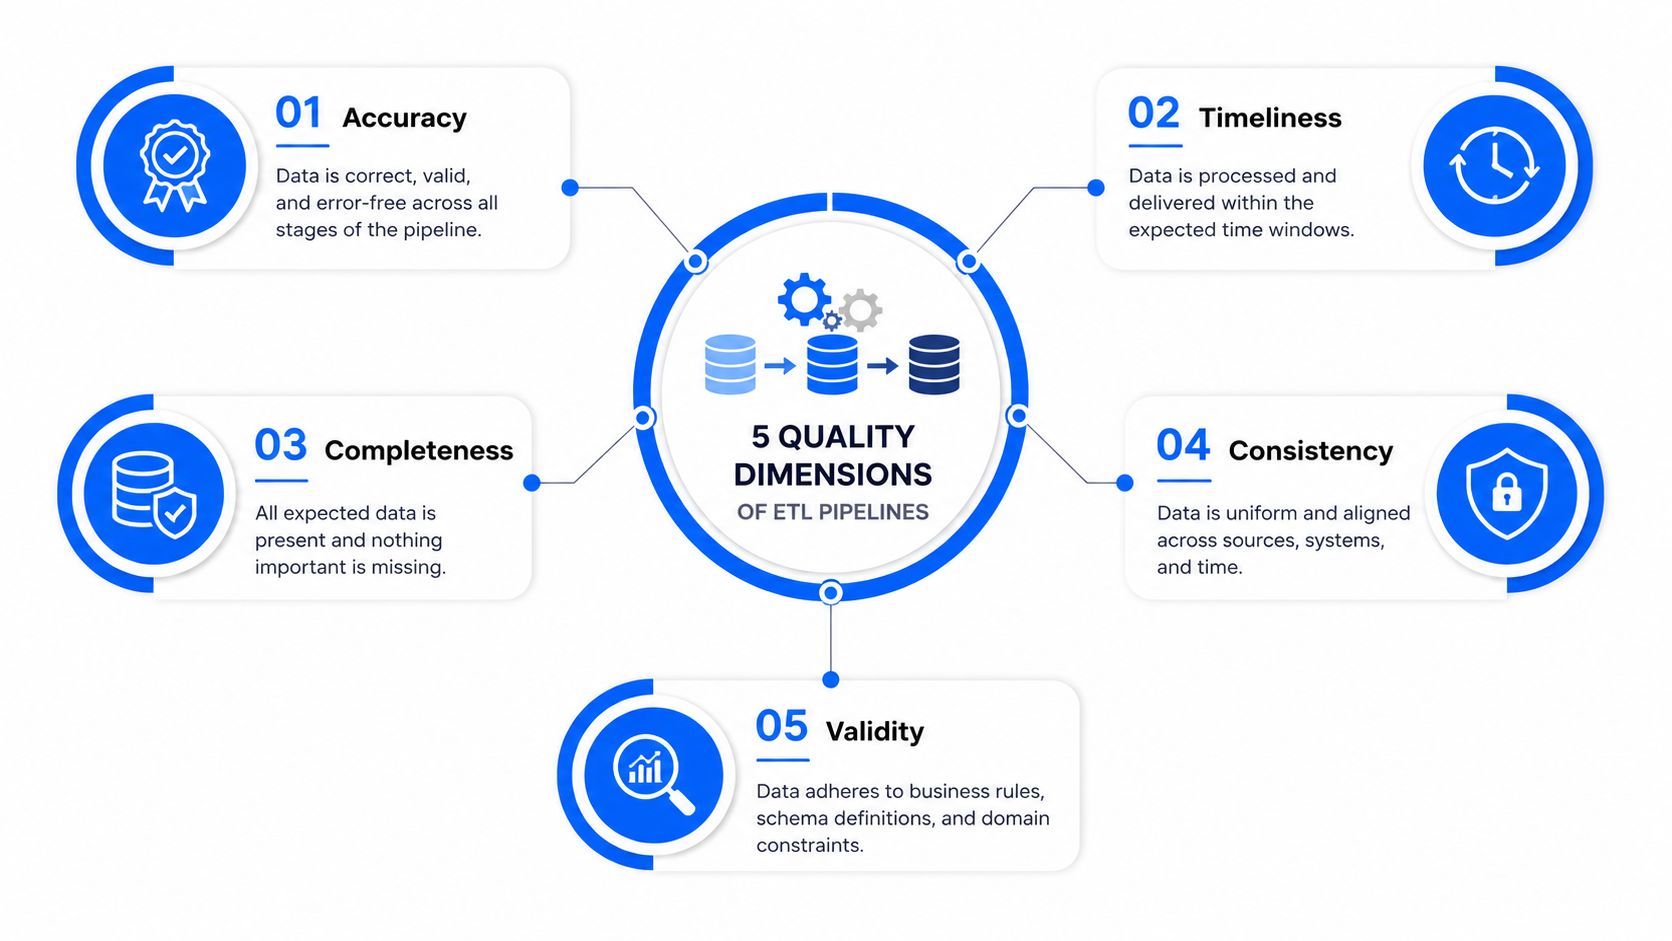
La qualità ETL funziona meglio quando smettete di trattarla come un punteggio unico. La ricerca moderna sull'osservabilità inquadra il problema intorno a freschezza, schema, volume, distribuzione e lineage, e questa suddivisione si sovrappone perfettamente alle dimensioni accademiche più tradizionali di accuratezza, completezza, coerenza, tempestività, validità e unicità (i pilastri della moderna osservabilità, panoramica accademica delle dimensioni di qualità ETL). Ciascuna intercetta una diversa modalità di guasto, e nessuna sostituisce le altre.
La freschezza vi dice se l'ultimo record valido sta arrivando. Lo schema intercetta il drift strutturale, comprese nuove colonne, campi rimossi e cambi di tipo. Il volume segnala cali o picchi improvvisi che suggeriscono troncamenti o duplicazioni. La distribuzione fa emergere variazioni più sottili, come cambiamenti nella percentuale di null o intervalli di valori spostati. Il lineage riconduce un problema alla fonte e al passaggio di trasformazione che lo ha introdotto.
Perché i cinque pilastri devono lavorare insieme
Se controllate solo lo schema, vi sfuggiranno dati obsoleti ma strutturalmente validi. Se controllate solo il volume, un caricamento errato può comunque passare perché il conteggio delle righe sembra normale. Se controllate solo la freschezza, potete comunque consegnare puntualmente un file strutturalmente sbagliato. Per questo si tratta di segnali comportamentali, non di caselle da spuntare intercambiabili.
Una buona risorsa per i team che vogliono costruire questa disciplina sono gli standard di qualità dei dati per la formazione, soprattutto se cercate di allineare analisti, ingegneri e responsabili della governance sulle stesse aspettative. L'obiettivo non è accumulare altri controlli. È rendere visibile la modalità di guasto giusta prima che il warehouse diventi l'unico posto in cui qualcuno se ne accorge.
Tengo anche un semplice riferimento interno per i team che vogliono una suddivisione più formale dei pilastri nelle dimensioni della qualità dei dati secondo digna. Un vocabolario condiviso di questo tipo conta quando team diversi usano le stesse parole per intendere cose diverse.
Cosa intercetta davvero ciascuna dimensione
Freschezza: intercetta consegne mancanti o in ritardo prima che le dashboard diventino obsolete.
Schema: intercetta modifiche strutturali non annunciate che rompono i consumatori o corrompono le mappature.
Volume: intercetta troncamenti, duplicazioni e caricamenti parziali.
Distribuzione: intercetta variazioni nelle percentuali di null, negli intervalli di valori e nella cardinalità che le regole riga per riga spesso non vedono.
Lineage: vi aiuta a ricondurre il guasto a un sistema sorgente, a un job o a un passaggio di trasformazione.
Un warehouse sembra sano solo quando controllate il livello giusto.
I deployment di osservabilità più solidi non chiedono a un'unica dimensione di fare tutto il lavoro. Usano ciascuna dimensione come una lente diversa sulla stessa pipeline, in modo che un problema venga intercettato dove è nato, non dopo che ha già condizionato il reporting a valle.
Validazione basata su regole e rilevamento delle anomalie basato sull'AI
La validazione basata su regole resta essenziale, ma copre solo ciò che già sapete di dovervi aspettare. Se un campo di ricavo non deve mai essere negativo, se un codice paese deve appartenere a un insieme definito o se una chiave esterna deve esistere prima che venga caricata una riga dei fatti, una regola dovrebbe imporlo. È un controllo rigido, e il controllo rigido è un bene.
Il problema è che le regole non vedono i comportamenti che cambiano senza violare un vincolo rigido. Una fonte può iniziare a inviare i record in ritardo, un campo può diventare più rumoroso, un join può perdere chiavi corrispondenti o una distribuzione può spostarsi abbastanza da danneggiare le analisi pur superando ogni controllo statico. È qui che il rilevamento delle anomalie si guadagna il suo posto. Per una panoramica più ampia di questo schema, vale la pena leggere la guida al rilevamento delle anomalie nell'ETL insieme all'approccio di digna al rilevamento delle anomalie.
Il compromesso pratico è semplice. Le regole sono precise e facili da spiegare. Il rilevamento delle anomalie copre un territorio più ampio, ma richiede una baseline e può generare rumore se non calibrate con cura responsabilità e alerting. Per la mia esperienza, i team finiscono nei guai quando trattano il rilevamento delle anomalie come un sostituto dei controlli deterministici. Non lo è.
Dove vince ciascun approccio
Dimensione | Validazione basata su regole | Rilevamento delle anomalie basato sull'AI |
|---|---|---|
Costo di configurazione | Più basso per i vincoli noti | Più alto, perché richiede una baseline di comportamento storico |
Copertura | Ristretta, ma esatta | Più ampia, intercetta drift e pattern insoliti |
Onere di manutenzione | Cresce con l'accumularsi delle regole | Cresce quando baseline, responsabili e calibrazione non vengono gestiti |
Tempo per ottenere insight | Immediato per i guasti definiti | Rapido una volta appresi i pattern, ma non sempre istantaneo dal primo giorno |
Punti ciechi | Incognite sconosciute e drift comportamentale | Invarianti di business rigidi e requisiti di policy espliciti |
Come combinarli senza creare il caos degli alert
Iniziate con le regole per gli invarianti che non vorreste mai allentare. Poi aggiungete sopra il rilevamento delle anomalie per le metriche che tendono a variare, come volume, percentuali di null e correlazioni tra campi. Se un record non supera uno dei due livelli, instradatelo in quarantena o in una coda di revisione invece di lasciarlo proseguire a valle.
Questo approccio mantiene anche i vostri controlli spiegabili. Gli ingegneri possono fare il debug di un vincolo non rispettato. Gli analisti possono capire perché una baseline è cambiata. I team di governance ottengono una registrazione di cosa è stato bloccato e perché. Se fatto bene, il sistema somiglia meno a un muro di controlli fragili e più a un insieme calibrato di guardrail.
Meccanismi di validazione a livello di record che intercettano i difetti
I controlli a livello di record funzionano solo quando sono legati all'impatto sul business, non a un semplice stato superato o fallito. Un campo nullable mancante in un dataset a basso rischio non equivale a una chiave mancante in una tabella dei fatti sui ricavi. Il controllo deve riflettere questa differenza, altrimenti diventa troppo rigido per sopravvivere o troppo permissivo per servire a qualcosa.
Il lavoro ETL in ambito clinico mostra quanto velocemente la qualità possa peggiorare quando le definizioni sono vaghe. In uno studio ospedaliero, i tassi di errore dell'estrazione manuale e quelli dell'esportazione automatizzata variavano a seconda che i campi ambigui fossero esclusi o meno, il che porta a una lezione semplice: l'automazione non garantisce la qualità e la chiarezza delle definizioni dei dati modifica sensibilmente i tassi di difetto.
Usate soglie, non solo conteggi
Un tasso di errore dello 0,1% su un caricamento di 50 milioni di righe è un problema operativo diverso rispetto allo stesso tasso su un batch di 1.000 righe. Il primo può nascondere decine di migliaia di righe errate. Il secondo può essere un campione piccolo ma critico, in cui anche un solo difetto conta.
Ecco perché i livelli di gravità sono importanti. Avviso, quarantena e arresto danno alla pipeline margine per reagire senza diventare al tempo stesso fragile e permissiva.
I meccanismi di validazione devono restare concreti. Un articolo del 2021 sulla validazione ETL raccomanda di verificare il numero corretto di colonne, i tipi di dati e i vincoli di colonna, oltre a presenza e ordine delle colonne per i flat file, insieme ai vincoli di chiave primaria, chiave esterna e indice univoco (articolo sui meccanismi di validazione). Questo resta l'ossatura di una validazione affidabile a livello di record.
Controlli che ripagano nella pratica
Rilevamento dei null: profilate le colonne e definite intervalli di densità accettabili, soprattutto per i campi di business obbligatori.
Applicazione delle chiavi: rifiutate chiavi primarie duplicate e chiavi esterne orfane prima che contaminino i join a valle.
Validazione del dominio: usate valori controllati per campi come i codici paese ISO e altre enumerazioni finite.
Soglie di business: esprimete le fasce di tolleranza dei ricavi, i limiti del tasso di reso o le soglie di cancellazione come percentuali delle righe in ingresso.
Fatti arrivati in ritardo: convalidate rispetto alle finestre di validità temporale, in modo che gli eventi finiscano nell'intervallo di tempo corretto.
Preferisco mettere in quarantena le righe ambigue piuttosto che lasciare che alterino il dataset attendibile. La quarantena dà ai produttori dei dati la possibilità di correggere la fonte o la mappatura senza trasformare il warehouse in un raccoglitore di rifiuti.
Regola operativa: se il team non sa spiegare perché una riga non valida può essere ignorata senza rischi, allora non può essere ignorata.
Un aspetto pratico. Non scrivete regole per ogni caso limite. Iniziate dai campi che determinano finanza, compliance, workflow dei clienti e addestramento dei modelli. È lì che i difetti di qualità diventano costosi più rapidamente.
Tipo di controllo | Cosa intercetta | Indicazioni sulle soglie | Azione consigliata |
|---|---|---|---|
Controlli sui null | Valori obbligatori mancanti | In base alla criticità del campo e alla dimensione del dataset | Avviso per i campi a basso rischio, quarantena per i campi critici |
Vincoli sulle chiavi | Duplicati e relazioni interrotte | Tolleranza zero per le chiavi identificative | Arresto o quarantena |
Regole di dominio | Codici non validi e valori fuori insieme | Usate elenchi finiti di valori ammessi | Rifiuto o instradamento alla remediation |
Controlli di intervallo | Outlier e valori impossibili | Definite limiti specifici per il business | Avviso sui limiti morbidi, quarantena sui limiti rigidi |
Validità temporale | Eventi in ritardo o con data errata | Convalidate rispetto alle finestre previste | Quarantena e rielaborazione se necessario |
Per i team che vogliono un insieme di controlli più ampio, la guida di digna a regole di validazione dei dati e qualità continua è un utile complemento a questi controlli a livello di record.
Monitoraggio della tempestività e finestre di consegna previste
Una pipeline può essere verde e consegnare comunque dati obsoleti. È questo che rompe le dashboard del mattino, non l'alert di un job fallito. La tempestività va trattata come uno SLA, con una finestra di consegna prevista legata al momento in cui il business usa il dataset.
Il controllo è semplice nel concetto e implacabile nella pratica. Confrontate l'arrivo previsto con quello effettivo, poi classificate l'esecuzione come anticipata, in ritardo, mancante o parziale. Un feed delle vendite che deve arrivare prima di una revisione dei ricavi alle 8:00 ha una finestra stretta, mentre un feed per il reporting pomeridiano può tollerarne una più ampia. Usate come riferimento la scadenza del business, non la pianificazione nello strumento di orchestrazione.
Il modo più pulito per definire questa finestra è imparare dai pattern delle esecuzioni precedenti, dalla cadenza dei commit della fonte e dal momento del consumo. Se il team controlla le dashboard all'inizio della giornata, uno slittamento di dieci minuti può contare. Se i dati vengono usati solo dopo pranzo, lo stesso ritardo può essere irrilevante. La guida di digna alle metriche di tempestività offre un quadro utile per definire queste finestre e misurarle in modo coerente.
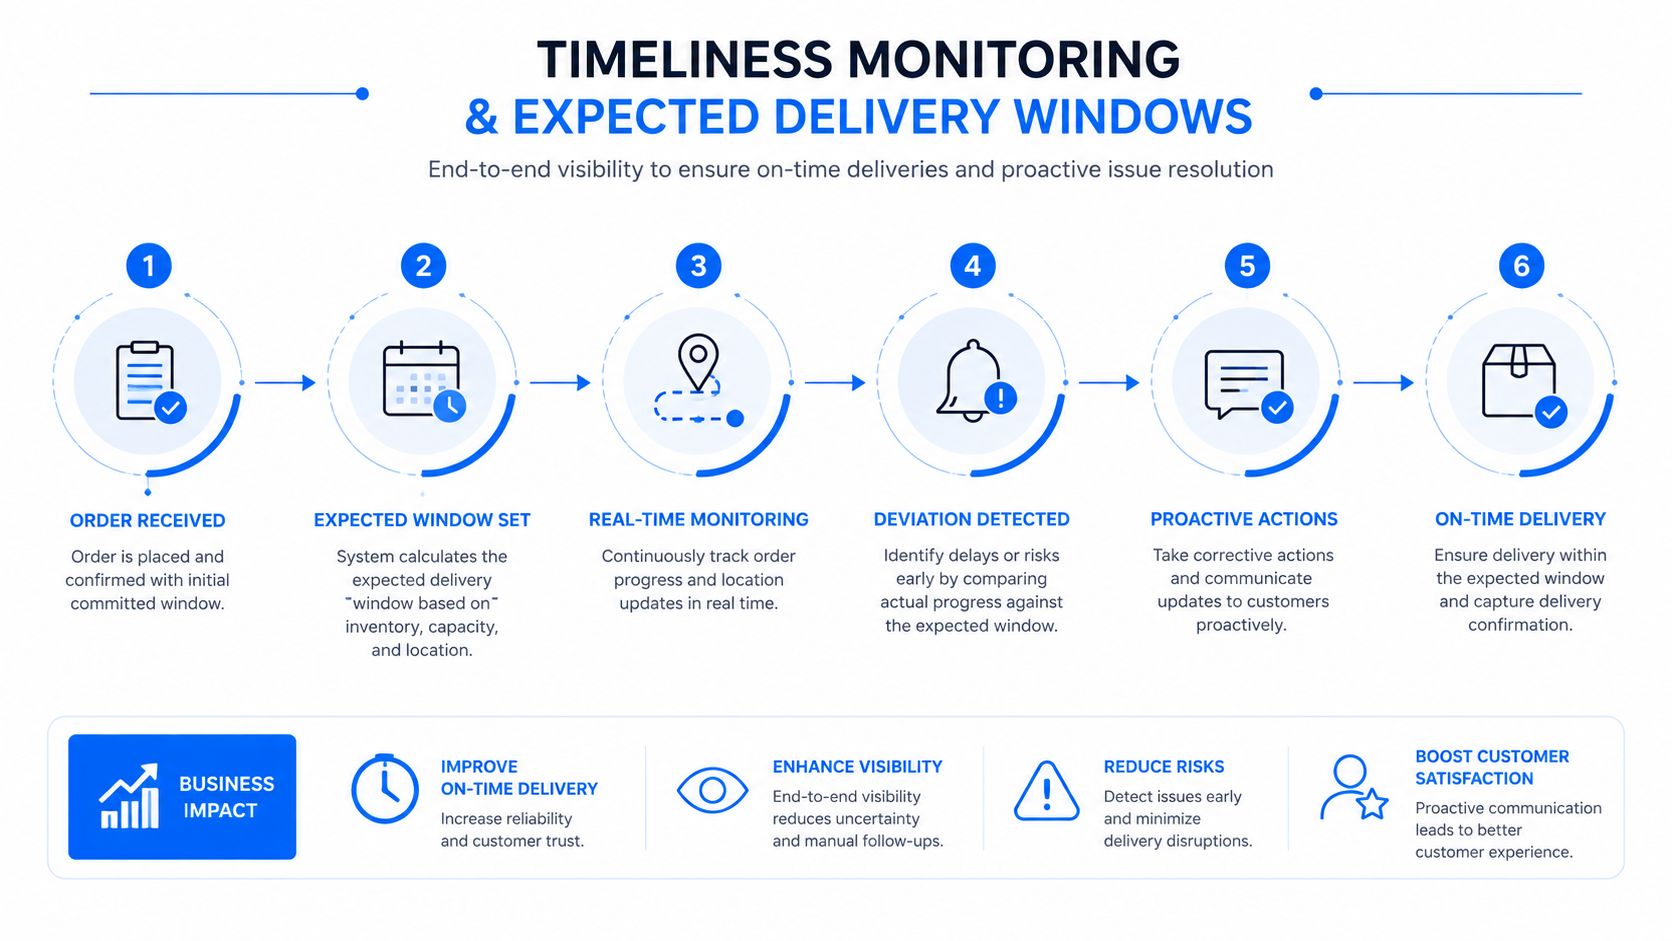
Monitorate più del timestamp finale. I controlli heartbeat mostrano se la fonte sta ancora producendo dati. I watermark mostrano fin dove è avanzata la pipeline. I marcatori di completamento incrementale mostrano se sono arrivate tutte le partizioni, ed è spesso lì che si nascondono i caricamenti parziali.
La policy degli alert dovrebbe riflettere il tipo di guasto, non solo l'esistenza di un ritardo.
Arrivi anticipati: di solito innocui, ma utili quando indicano una modifica della pianificazione a monte.
Arrivi in ritardo: generate un alert quando il ritardo supera la finestra di business del dataset.
Caricamenti mancanti: escalation rapida se i dati mancano prima di una scadenza di consumo nota.
Caricamenti parziali: trattateli come ad alto rischio quando i gruppi di file o le partizioni previsti sono incompleti.
La distinzione utile è tra uno slittamento di routine e un ritardo che manderà all'aria una riunione del consiglio di amministrazione o un workflow dei clienti. Questa decisione appartiene alla policy di monitoraggio, non alla testa di qualcuno alle 7:50 del mattino. Il controllo della tempestività funziona quando dà al team il tempo di agire e quando intercetta l'obsolescenza silenziosa prima che qualcuno si fidi dei numeri.
Il drift dello schema e come rilevarlo prima che si rompa qualcosa a valle
Il drift dello schema è silenzioso perché spesso la pipeline continua a funzionare mentre i consumatori intorno a lei si rompono. I sistemi sorgente cambiano struttura senza preavviso e il caricamento sembra comunque riuscito finché una dashboard, un modello o un job a valle non iniziano a fallire su campi mancanti o ristrutturati. Ecco perché il drift dello schema appartiene allo stesso livello di controllo della validazione e del monitoraggio della tempestività, non a una coda di pulizia a posteriori. La definizione pratica di drift è la modifica non annunciata o graduale della struttura di una fonte nel tempo rispetto allo schema della pipeline, motivo per cui richiede un monitoraggio attivo anziché un'approvazione una tantum (definizione di schema drift).
Il modo utile di pensare al drift è per tipo. Il drift additivo introduce nuove colonne. Il drift sottrattivo rimuove campi che i consumatori si aspettano. Il drift mutativo modifica tipo, precisione o nullabilità. Sono modalità di guasto diverse, quindi richiedono risposte diverse. Una modifica sicura per l'ingestione può comunque rompere un semantic layer a valle o il set di feature di un modello.
Lo schema drift spiegato illustra chiaramente il problema operativo. Se la struttura cambia e nessuno se ne accorge fino al momento del consumo, il costo si manifesta più tardi sotto forma di join errati, cast falliti o perdita silenziosa di dati.
Rilevate il drift al confine
I controlli di contratto dovrebbero essere eseguiti mentre i dati attraversano il confine di ingestione. I registri di schema versionati aiutano quando i sistemi a monte evolvono in modo deliberato. I job di confronto che mettono a confronto snapshot DDL intercettano le modifiche sfuggite alla code review. I controlli di inferenza possono segnalare colonne inattese anche quando il produttore non le ha mai annunciate.
I meccanismi contano. La validazione rispetto alla struttura dichiarata dovrebbe coprire presenza, tipo, vincoli e ordine delle colonne per i flat file, oltre ai controlli su chiave primaria, chiave esterna e unicità dove queste regole si applicano. Non sono controlli affascinanti, ma evitano molti problemi prima che si propaghino alle tabelle e ai report a valle.
Reagite senza trasformare ogni modifica in un disservizio
Tipo di drift | Esempio di modifica | Metodo di rilevamento | Risposta consigliata |
|---|---|---|---|
Additivo | Nuovo campo aggiunto a un payload | Confronto degli schemi, inferenza, controllo di contratto | Consentire l'aggiunta nullable, poi aggiornare i modelli a valle |
Sottrattivo | Colonna esistente rimossa | Validazione al confine, confronto degli snapshot | Bloccare o instradare a un livello di compatibilità |
Mutativo | Modifiche di tipo o precisione | Validazione dei tipi, confronto con il registro | Quarantena, mappatura accurata e versionamento del contratto |
Le policy di blocco rigido sembrano sicure finché non creano più incidenti di quanti ne prevengano. Ho visto team rifiutare modifiche additive innocue e poi passare lo sprint successivo a sbloccare manualmente i consumatori. Un'evoluzione retrocompatibile di solito funziona meglio. Aggiunte nullable, transizioni con doppia scrittura e caricamenti a valle rieseguibili sono più sicuri che fingere che gli schemi non cambino mai.
Progettate tenendo conto del drift e i controlli resteranno utili più a lungo. Date per scontato che lo schema sia fisso e la prossima release a monte vi smentirà.
Costruire nella pratica uno stack di qualità ETL a più livelli
Un'esecuzione ETL verde può comunque consegnare dati errati. Di solito succede perché un singolo controllo fa troppo, mentre il guasto reale si trova un livello più in là. Uno stack di qualità utile separa questi compiti. I controlli a livello di riga vengono eseguiti in linea durante l'estrazione o la trasformazione. Il rilevamento delle anomalie a livello di aggregazione viene eseguito ai confini di caricamento. I controlli di freschezza e lineage vengono eseguiti dopo il commit, quando potete confermare che il dataset è arrivato e ricostruirne il percorso.
Questa suddivisione conta nella pratica. Le regole statiche sono brave a intercettare pattern errati noti. Il monitoraggio comportamentale intercetta drift, ritardi e variazioni sottili che le regole fisse non vedono.
Come matura di solito lo stack
La prima versione dovrebbe essere leggera. Iniziate con sonde non bloccanti a ogni passaggio tra le fasi, così il team può vedere cosa è cambiato prima di decidere se fermare il caricamento. Man mano che il segnale migliora, promuovete i controlli che intercettano difetti reali a gate dell'orchestrazione. Mantenete gli altri come alert o percorsi di quarantena.
Un errore comune è trattare ogni problema come una questione di scrittura di regole. I team si ritrovano con logiche fragili che bloccano modifiche innocue e continuano a non vedere drift significativi. Lo schema più solido è il controllo a più livelli, in cui profiling delle distribuzioni, alert sulle finestre di arrivo e contratti di schema consapevoli del lineage coprono ciascuno una diversa porzione di rischio. Gli strumenti esatti variano. Il principio di progettazione no.
Un caso di settore rende chiaro questo compromesso. Un'implementazione descritta in materiale ITSV ha sostituito migliaia di regole di validazione statiche con profiling, alert sulla tempestività e contratti di schema, riducendo il rumore degli alert e facendo emergere prima i drift con impatto sui ricavi. Quel risultato riguarda meno lo stack specifico e più l'adeguatezza. I gate rigidi dovrebbero gestire i guasti che rompono i consumatori. Tutto il resto dovrebbe informare gli operatori senza trasformare la variabilità di routine in un disservizio.
Chi è responsabile di cosa nello stack
Data engineer: responsabili dei confini della pipeline, dei contratti di schema e dell'instradamento dei guasti.
Analytics engineer: responsabili delle aspettative lato modello, dei controlli sulle distribuzioni e della validazione semantica.
Team di governance: responsabili degli standard, della policy di gravità e dei percorsi di escalation.
Responsabili di business: responsabili del significato dell'alert, soprattutto quando una riga è tecnicamente valida ma commercialmente sbagliata.
Costruite lo stack di controllo come costruite la pipeline: con responsabilità, test e percorsi di rollback.
digna si adatta a questo modello perché funziona nell'ambiente del cliente e combina rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record, tracciamento dello schema e metriche di piattaforma. Il punto non è l'etichetta del fornitore. Il punto è che i controlli restano vicini ai dati e il modello operativo resta all'interno dell'ambiente in cui gira la pipeline.
Trattate lo stack come una superficie di prodotto, non come un progetto una tantum. Profilate ogni dataset, assegnate ogni modalità di guasto a un unico responsabile, collegate gli alert al team che può intervenire e ritirate i controlli quando un altro livello copre la stessa lacuna in modo più pulito. La qualità regge quando lo stack viene mantenuto con disciplina, non quando il numero di regole continua a crescere.
Idee sbagliate comuni e una checklist pratica per la qualità
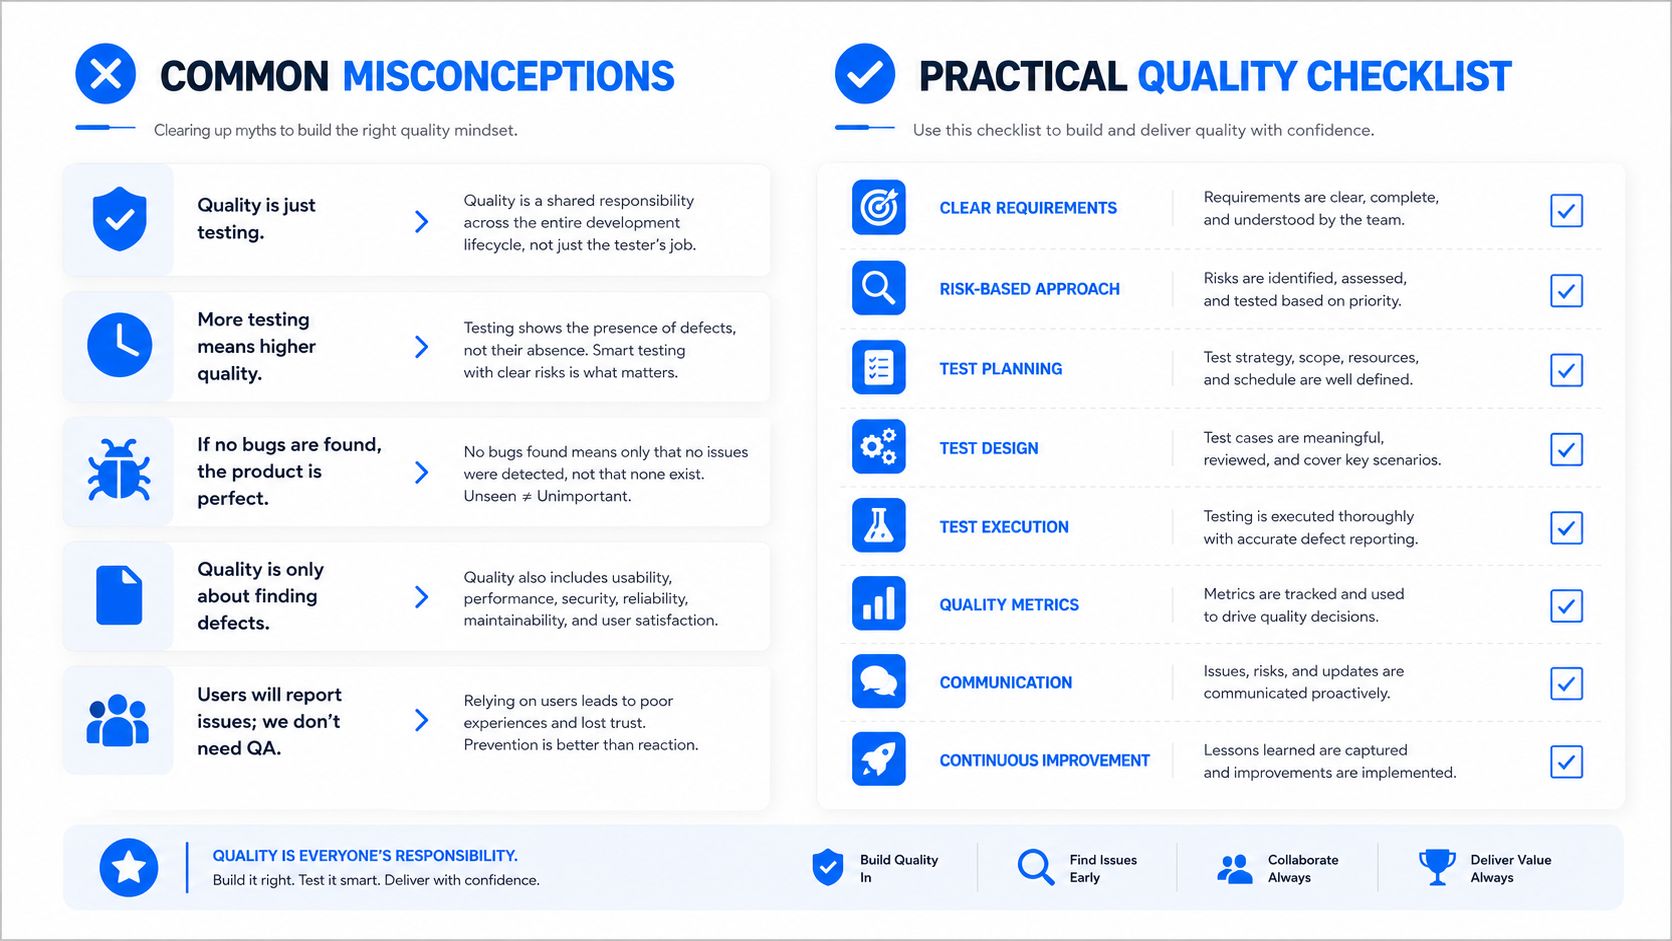
La prima idea sbagliata è che più regole significhino automaticamente una qualità migliore. In realtà, accumulare controlli statici di solito genera alert fatigue, pipeline fragili e una lunga coda di regole di cui nessuno si fida. La seconda idea sbagliata è che una pipeline verde significhi dati affidabili. Non è così, perché il job può riuscire mentre il payload è obsoleto, alterato o strutturalmente sbagliato. La terza è che il drift dello schema sia un problema di migrazione una tantum. Non lo è: è continuo.
Questi errori scompaiono quando separate il compito di ciascun controllo. Le regole misurano ciò che è previsto. Le anomalie intercettano l'imprevisto. Il rilevamento del drift osserva la struttura mentre cambia nel tempo. Se il team mescola questi compiti, il risultato è un monitoraggio rumoroso e una risposta lenta agli incidenti.
Una checklist da applicare già questa settimana
Profilate prima la fonte: conoscete le forme dei campi, i pattern dei null e le distribuzioni prima di scrivere regole.
Sostituite le soglie statiche con baseline mobili: usate il comportamento osservato quando il dataset è per natura variabile.
Generate alert sull'assenza, non solo sulla presenza: i dati mancanti sono spesso il primo segnale di un caricamento non riuscito.
Versionate ogni schema: trattate le modifiche strutturali come eventi gestiti, non come sorprese.
Assegnate un responsabile umano a ogni alert: gli alert senza responsabile diventano rumore di fondo.
I programmi più duraturi non inseguono regole perfette. Costruiscono osservabilità, definiscono responsabilità chiare e lasciano che il modello di controllo evolva insieme alla pipeline. È questa la differenza tra un sistema che sembra pulito e uno che resta affidabile quando il comportamento della fonte cambia.
Se state rafforzando la qualità dei dati ETL su data warehouse, data lake e pipeline di streaming, iniziate con controlli che osservano il comportamento dei dati, non solo lo stato dei task. digna aiuta i team a monitorare anomalie, drift dello schema, tempestività e validazione all'interno del proprio ambiente, così i controlli restano vicini ai dati e le responsabilità restano chiare. Visitate digna per vedere come questo approccio si adatta al vostro stack.
Domande frequenti
Perché le pipeline ETL verdi producono comunque dati rotti?
Perché gli strumenti di orchestrazione riportano soprattutto se un task è stato eseguito, non se i dati si sono comportati correttamente. La regola pratica è considerare ogni esecuzione ETL riuscita come non verificata finché i dati non superano i controlli di freschezza, di schema e a livello di record.
Quali dimensioni di qualità dovrebbe monitorare ogni pipeline ETL?
Cinque, perché un punteggio unico nasconde il guasto. La freschezza vi dice se l'ultimo record valido sta arrivando, mentre le altre coprono volume, schema, distribuzione e validità a livello di record. Ciascuna intercetta una diversa classe di guasti, quindi è trattarle separatamente che rende utile il segnale.
Quali guasti ETL fanno più male?
Quelli silenziosi. Una pipeline che si blocca si fa notare e viene sistemata; un'esecuzione che si completa mentre scarta silenziosamente una partizione, converte un tipo o ammette record non validi arriva fino a una dashboard prima che qualcuno si ponga una domanda.
Quanto costa una scarsa qualità dei dati ETL?
Gartner stima il costo della scarsa qualità dei dati in media 12,9 milioni di dollari all'anno per organizzazione, e le sintesi di settore osservano che i dati errati possono causare una perdita di ricavi dal 15% al 25% in alcune aziende. I controlli precoci contano perché il costo cresce a ogni passaggio a valle.
La risposta è testare di più?
La risposta è un monitoraggio a più livelli, non la speranza o una suite di test più lunga. I controlli deterministici intercettano le violazioni di regole note, i controlli statistici intercettano i comportamenti che le regole non descrivono e il tracciamento dello schema intercetta le modifiche strutturali; nessun singolo livello copre gli altri due.


