Data quality in Databricks: guida pratica per il 2026
|
8
min di lettura

Probabilmente conoscete quel momento. Una dashboard che alle 20 sembrava a posto è sbagliata all'ora di colazione, e la prima domanda non è “cosa si è rotto”, ma “dove si è rotto”. Un calo di righe nella tabella sorgente, una modifica dello schema in un file a monte arrivato in ritardo o una pipeline che ha mancato la sua finestra possono produrre tutti lo stesso sintomo: un numero sbagliato davanti al business.
Ecco perché la data quality in Databricks è più facile da capire come sistema a livelli che come singola funzionalità. Il livello di storage vi offre un comportamento di scrittura solido e lo storico. Il monitoraggio a livello di tabella sorveglia drift, tabelle obsolete e dati mancanti. L'applicazione delle regole a livello di record gestisce le regole di business che le sole tabelle non possono dedurre.
Indice
Cosa significa davvero data quality in Databricks
Il livello di storage risponde a “la scrittura è avvenuta correttamente?”
Il livello di monitoraggio risponde a “questa tabella sembra sana?”
Il livello di validazione risponde a “questa riga dovrebbe essere ammessa?”
Come Delta Lake fornisce le fondamenta dello storage
Prima scrivere in modo pulito, poi giudicare il significato
Usare lo storico come strumento forense
Monitoraggio nativo con Lakehouse Monitoring e Unity Catalog
Cosa osserva davvero l'automazione
Come funziona il modello di freschezza e completezza
Validazione a livello di record e pattern di quarantena
Prima la quarantena, poi decidere cosa fare della riga errata
Le expectation sono un tipo diverso di protezione
Strumenti open source e commerciali che si integrano con Databricks
Scegliere lo strumento in base al compito, non al marchio
Pattern architetturali per i controlli di qualità nel database
L'elaborazione esterna è più facile da avviare, ma sposta i dati
L'esecuzione nel database mantiene i controlli dove risiedono i dati
Distribuire digna come livello di osservabilità su Databricks
Associare il prodotto al livello, non al logo
Mantenere semplice la forma del deployment
Best practice e una breve checklist da applicare questa settimana
Gli anti-pattern da evitare
Una checklist per il lunedì mattina
Cosa significa davvero data quality in Databricks
Di solito un data engineer scopre il problema nel modo peggiore. Il reparto finanza chiede perché i ricavi di ieri non tornano, il team BI dice che la dashboard è cambiata durante la notte e il responsabile della pipeline inizia a controllare i log prima che qualcuno abbia una teoria. A quel punto, “data quality” è solo il termine ombrello per una serie di guasti diversi che sembrano tutti un report rotto.
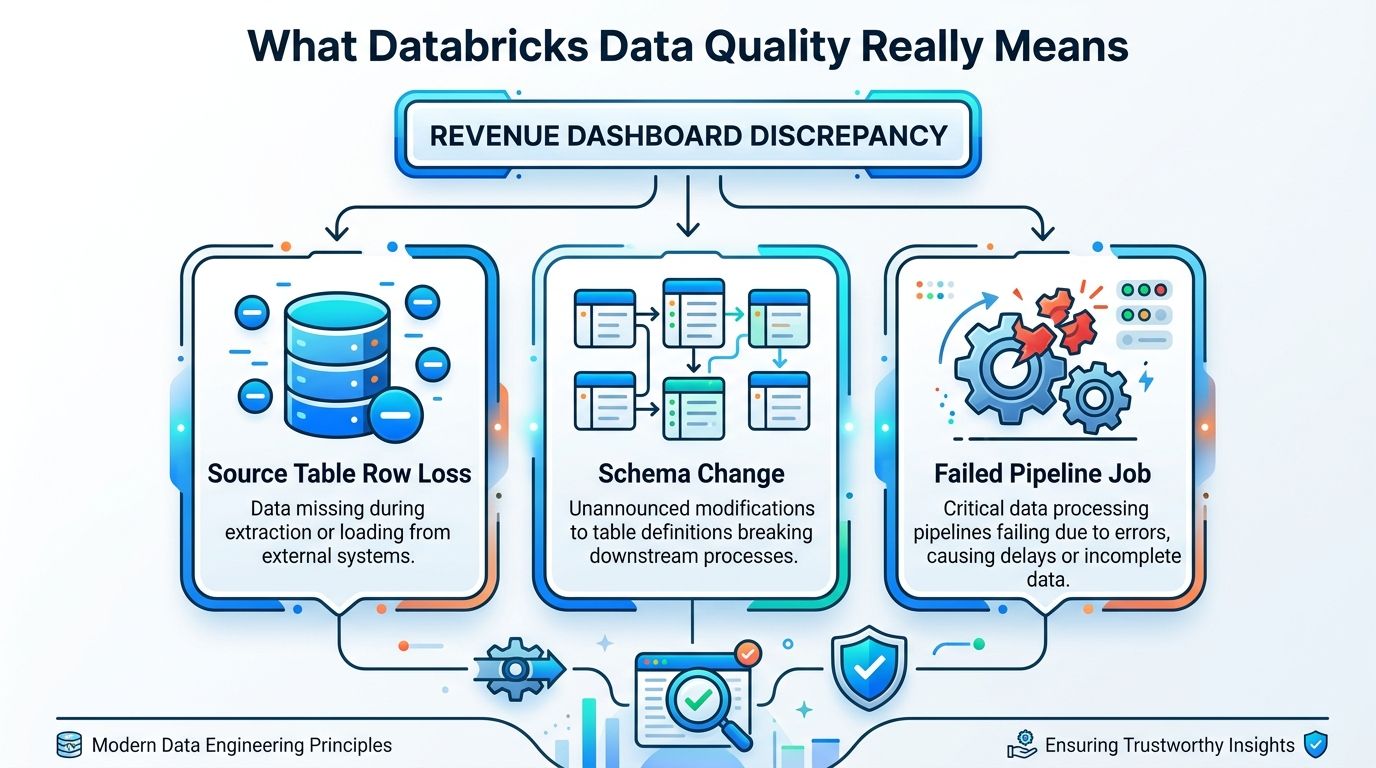
Il modello mentale utile consiste nel suddividere il problema in tre livelli. Primo, il livello di storage protegge il modo in cui i dati arrivano e cambiano. Secondo, il livello di monitoraggio osserva le tabelle alla ricerca di sintomi come obsolescenza, scritture incomplete e schema drift. Terzo, il livello di validazione controlla le righe effettive e le regole di business prima che i record errati possano viaggiare a valle.
Il livello di storage risponde a “la scrittura è avvenuta correttamente?”
Le fondamenta di storage di Databricks contano perché riducono la probabilità che una tabella resti scritta a metà o strutturalmente incoerente. È un problema diverso dal chiedersi se i dati siano semanticamente corretti. Una riga di ricavi può essere memorizzata perfettamente ed essere comunque sbagliata per il business.
Il livello di monitoraggio risponde a “questa tabella sembra sana?”
Lakehouse Monitoring e il monitoraggio della data quality di Unity Catalog affrontano questo aspetto. Databricks usa pattern appresi, segnali di freschezza e controlli di completezza per segnalare le tabelle che sembrano anomale, senza richiedere una soglia scritta a mano per ogni dataset. Anche la documentazione di Azure Databricks di Microsoft indica che i risultati sono disponibili a livello di catalogo, schema e tabella, e che i responsabili possono usare una tabella di logging per cercare anomalie in un intero metastore, come descritto nella documentazione sul monitoraggio della data quality di Azure Databricks.
Il livello di validazione risponde a “questa riga dovrebbe essere ammessa?”
È in questo livello che vivono le regole di business. Una tabella può essere fresca e completa e contenere comunque un codice di sinistro non valido, un prezzo fuori intervallo o un flag regolamentare che non avrebbe mai dovuto passare. Databricks supporta pattern di gestione a livello di record, ma resta una questione separata rispetto alla salute della tabella.
Regola pratica: se potete descrivere il problema come “la tabella sembra insolita”, usate il monitoraggio. Se dovete decidere se una riga specifica è valida, usate la validazione.
Come Delta Lake fornisce le fondamenta dello storage
Partite dalla parte di Databricks che è facile trascurare proprio perché funziona correttamente in background. Delta Lake vi offre il comportamento di scrittura e lo storico che rendono possibile applicare la qualità a livello di storage, così non dovete fare debug di file misteriosi a posteriori. Il punto non è che lo storage risolva tutto. Il punto è che impedisce a molta corruzione di basso livello di diventare il vostro problema quotidiano.

Prima scrivere in modo pulito, poi giudicare il significato
In una pipeline medallion, Bronze è dove arriva l'ingestione disordinata, Silver è dove si pulisce e si standardizza, e Gold è dove i fatti curati supportano le analytics. Il compito di Delta è rendere ogni scrittura abbastanza affidabile da permettere al livello successivo di fidarsi dello stato della tabella. Per questo le garanzie dello storage sono un'assicurazione economica, mentre il giudizio semantico appartiene ai livelli più alti dello stack.
L'applicazione dello schema in scrittura è un buon esempio. Se una pipeline tenta di caricare dati che non corrispondono alla definizione della tabella, il livello di storage può rifiutarli invece di modificare la tabella in qualcosa che i job a valle interpretano male. Se consentite intenzionalmente l'evoluzione dello schema, lo fate di proposito, non per caso.
Un livello di storage pulito non significa una logica di business pulita. Significa che è meno probabile che i dati sbagliati diventino un fatto persistente.
Usare lo storico come strumento forense
Il time travel è l'altro elemento che conta nella pratica. Quando la dashboard è cambiata, dovete sapere quando il record errato è entrato nella tabella, quale versione esisteva prima e se il problema è iniziato in Bronze, Silver o Gold. Lo storico di Delta vi aiuta a restringere il campo senza tirare a indovinare.
Constraint ed expectation si collocano poi sopra queste fondamenta. Non sostituiscono il monitoraggio, ma creano una soglia minima di correttezza. Se rifiutate presto i record incompatibili, mettete in quarantena le righe errate invece di mescolarle a quelle valide e mantenete intenzionale l'evoluzione delle tabelle, date a ogni controllo di qualità successivo un segnale molto più pulito.
Il risultato è semplice. Le garanzie dello storage fermano i danni evitabili. Il monitoraggio individua drift e dati obsoleti. La validazione gestisce la logica di business che richiede ancora regole esplicite.
Monitoraggio nativo con Lakehouse Monitoring e Unity Catalog
Il monitoraggio nativo di Databricks dà il meglio quando volete che la piattaforma noti comportamenti insoliti senza chiedere al vostro team di scrivere a mano i controlli per ogni tabella. Lakehouse Monitoring è stato introdotto come funzionalità GA per profilare, diagnosticare e applicare la data quality, e Databricks afferma che calcola metriche per qualsiasi tabella Delta in Unity Catalog, costruendo automaticamente dashboard che tracciano trend e anomalie nel tempo. Il sistema crea inoltre due tabelle di metriche per ogni tabella monitorata, una per le metriche di profilo e una per le metriche di drift, offrendovi una registrazione persistente di cosa è cambiato e quando, come descritto nell'annuncio della GA di Databricks Lakehouse Monitoring.
Cosa osserva davvero l'automazione
I segnali integrati sono incentrati sulle tabelle. Databricks traccia freschezza e completezza in base al comportamento storico, e la documentazione sul monitoraggio di Unity Catalog descrive un approccio di rilevamento delle anomalie a livello di schema che analizza tutte le tabelle di uno schema, dà priorità a quelle importanti e salta, quando opportuno, le tabelle a basso impatto. Il monitoraggio predefinito viene eseguito ogni ora e salta le scansioni quando non ci si aspetta ancora che una tabella sia cambiata, riducendo controlli rumorosi e calcolo sprecato, come documentato nella guida al monitoraggio della data quality di Unity Catalog.
Come funziona il modello di freschezza e completezza
La freschezza si basa sullo storico dei commit e sull'orario previsto del commit successivo. Una tabella è considerata obsoleta quando un commit arriva insolitamente in ritardo. La completezza si basa sui conteggi storici delle righe in una finestra di 24 ore, e una tabella è considerata incompleta quando le scritture delle ultime 24 ore scendono sotto il limite inferiore dell'intervallo appreso, secondo la documentazione di Databricks sul monitoraggio di Azure Databricks. È utile perché evita soglie rigide che si rompono ogni volta che il ritmo normale di una pipeline cambia.
La piattaforma fa emergere anche segnali correlati come la percentuale di valori nulli e il drift delle distribuzioni. Questo conta perché una tabella può sembrare ancora “puntuale” mentre la sua forma cambia in un modo che rompe le ipotesi a valle.
Scorciatoia utile: il monitoraggio nativo dà il meglio quando la domanda è “questo dataset si è comportato come al solito?”
Per chi vuole un termine di paragone, la forma operativa di questo livello è simile a uno schermo radar gestito, mentre un livello di osservabilità dedicato come l'approccio di digna al monitoraggio di Databricks viene spesso usato quando i team vogliono un'ispezione più profonda nel database, una copertura di regole più ampia o un'unica vista su più segnali.
Validazione a livello di record e pattern di quarantena
Il monitoraggio vi dice che una tabella non va. La validazione vi dice quali righe sono colpevoli. La distinzione conta perché freschezza e completezza non possono dirvi se un codice di sinistro è valido, se un prezzo rientra in una fascia approvata o se un record dovrebbe essere inviato a una coda di revisione manuale.
Prima la quarantena, poi decidere cosa fare della riga errata
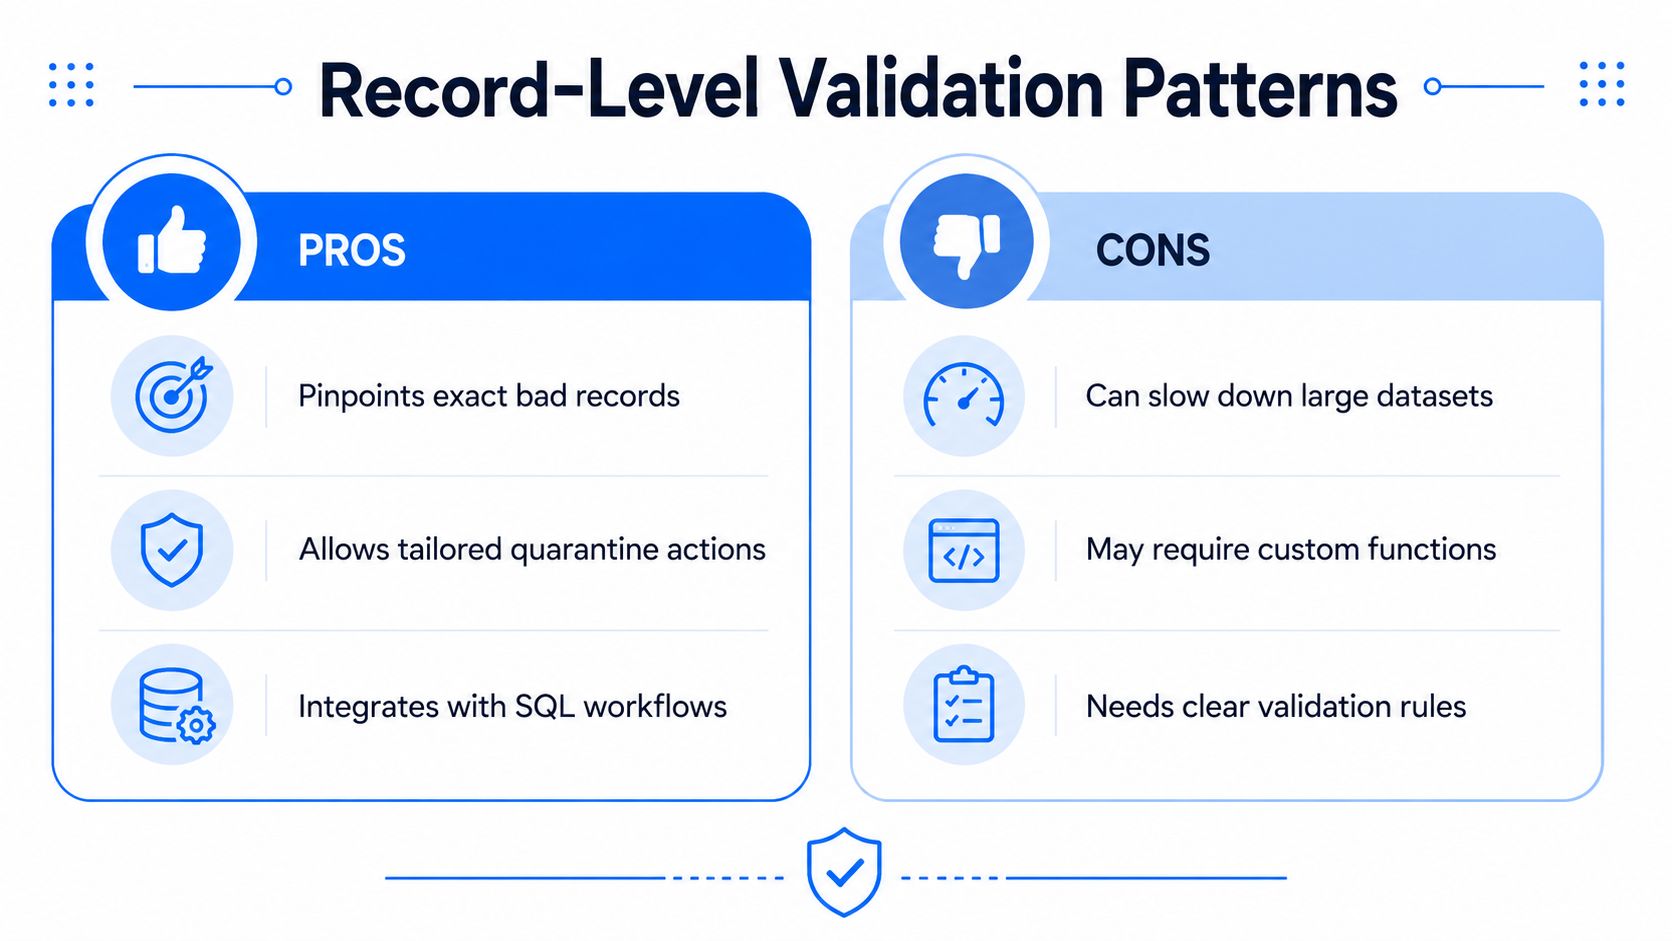
Databricks supporta trasformazioni in stile SQL che usano filtri e clausole WHERE per mettere in quarantena i record errati, così che non si propaghino a valle. Supporta anche la logica CASE WHEN ... OTHERWISE per le eccezioni prevedibili alle regole di business, come mostrato nelle linee guida di Databricks sulla validazione. In pratica, una tabella Bronze può contenere i dati grezzi, una tabella di quarantena può contenere le eccezioni e Silver può restare abbastanza pulita per i job e i report a valle.
Questo pattern è particolarmente utile quando il guasto è deterministico. Se un campo manca, un codice non è valido o un valore viola una regola nota, non serve un rilevatore probabilistico per capire che qualcosa non va. Serve una diramazione che instradi correttamente la riga.
Le expectation sono un tipo diverso di protezione
Databricks supporta anche le expectation su materialized view e streaming table, inclusa l'eliminazione dei record nulli, così che i problemi di qualità emergano prima di raggiungere i consumatori, secondo l'annuncio di Lakehouse Monitoring di Databricks. È utile per controlli circoscritti e ben definiti. Lo è meno quando il set di regole è ampio, instabile o soggetto a forti esigenze di audit.
La domanda di progettazione a cui i team prima o poi arrivano è semplice. Databricks deve contenere la logica effettiva delle regole di business, o deve essere il luogo in cui osservare e smistare i problemi di qualità mentre un livello dedicato gestisce le regole stesse? Per la maggior parte degli ambienti regolamentati o in rapida evoluzione, la risposta non è l'una o l'altra cosa. Di solito sono entrambe, con monitoraggio e governance delle regole tenuti abbastanza separati da evitare che gli alert diventino un groviglio.
Tenete la tabella di quarantena vicino alla pipeline. Se un record richiede una revisione umana, non seppellitelo nei log.
Strumenti open source e commerciali che si integrano con Databricks
L'ecosistema intorno a Databricks è più ampio del monitoraggio nativo. Strumenti open source come Great Expectations, Soda Core, Deequ e i test di dbt sono spesso usati per controlli leggeri vicino alla pipeline, soprattutto quando un team vuole definizioni esplicite delle regole e un esito chiaro di superamento o fallimento. Le piattaforme commerciali di osservabilità di solito si collocano un livello più in alto, collegandosi tramite JDBC, le API di Unity Catalog o letture Delta dirette per monitorare le tabelle in tutto il metastore.
Categoria | Compito principale | Luogo di esecuzione |
|---|---|---|
Test di pipeline open source | Validare regole note durante l'ingestione o la trasformazione | All'interno di job, notebook o flussi CI |
Strumenti di osservabilità a livello di tabella | Osservare salute, trend e anomalie a livello di intero schema | Nel warehouse, tramite Unity Catalog o con letture Delta |
Piattaforme commerciali nel database | Mantenere i dati residenti mentre si calcolano metriche e baseline | All'interno dell'ambiente Databricks del cliente |
Scegliere lo strumento in base al compito, non al marchio
Se l'obiettivo è “impedire che arrivino righe errate”, i test di pipeline bastano. Se l'obiettivo è “mostrami la salute dell'intero metastore”, l'osservabilità a livello di schema è più adatta. Se l'obiettivo è “non spostare i dati regolamentati fuori dal warehouse”, allora l'esecuzione nel database diventa il fattore decisivo.
Quest'ultimo punto è dove emerge il limite in Databricks stesso. Le linee guida recenti di Databricks indicano che il supporto per ulteriori controlli come percentuale di valori nulli, unicità e validità arriverà prossimamente nel percorso nativo di rilevamento delle anomalie, un chiaro segnale che il set di funzionalità integrate è ancora in espansione. Per i team che hanno bisogno oggi di una validazione granulare, è proprio in questo vuoto che gli strumenti esterni continuano a giustificare il loro posto.
Non pensate di aver bisogno di un unico strumento che faccia tutto. Vi serve un livello per i test di pipeline, un altro per l'osservabilità delle tabelle e un terzo per l'applicazione delle regole di business, quando le regole non possono essere ridotte a una soglia generica.
Pattern architetturali per i controlli di qualità nel database
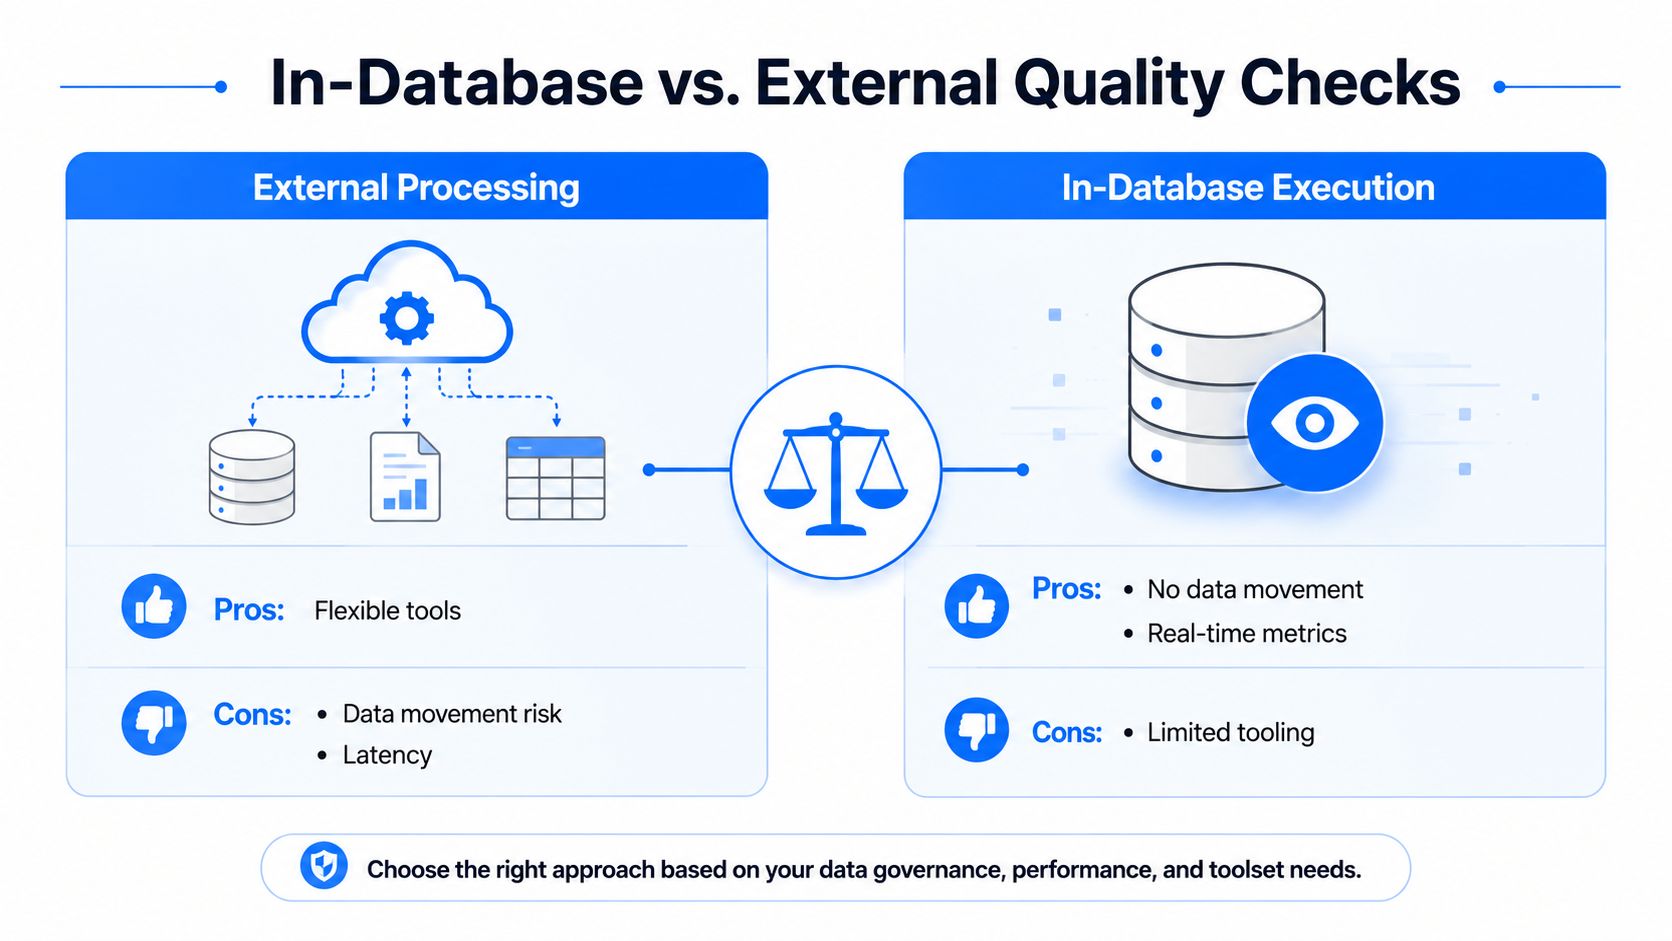
La decisione architetturale riguarda in realtà lo spostamento dei dati. Un approccio estrae campioni o scansioni complete da Databricks, li valuta altrove e poi rimanda indietro i risultati. L'altro esegue metriche, analisi del drift e validazione all'interno del workspace, così che i dati restino all'interno del perimetro del cliente.
L'elaborazione esterna è più facile da avviare, ma sposta i dati
Gli strumenti esterni sono spesso più semplici da distribuire perché usano API familiari e possono girare in un piano di controllo separato. Il compromesso è evidente. Una volta copiati i dati di produzione all'esterno per l'ispezione, avete aggiunto spostamento, latenza e una superficie più ampia per le revisioni di governance.
L'esecuzione nel database mantiene i controlli dove risiedono i dati
L'esecuzione nel database è preferibile quando il warehouse è grande, i dati sono sensibili o il team ha bisogno di visibilità quasi in tempo reale senza esportare record. Questo conta nella finanza, nella sanità e nel settore pubblico, dove spesso i dati di produzione non possono proprio lasciare il perimetro del cliente. Scala anche meglio quando si analizzano molte tabelle Delta, perché il calcolo opera già nello stesso ambiente della sorgente.
Ecco il modo più chiaro per decidere.
Usate l'elaborazione esterna quando vi servono una configurazione rapida, un ampio supporto dell'ecosistema o un esecutore di test leggero.
Usate l'esecuzione nel database quando la residenza dei dati conta, i volumi di scansione sono elevati o l'osservabilità deve restare vicina alla sorgente.
Usate entrambe quando volete test di pipeline al momento dell'ingestione e osservabilità delle tabelle sull'intero patrimonio di dati.
La scelta architetturale riguarda meno le mode e più il controllo. Gli strumenti esterni sono flessibili. I controlli nel database sono più sicuri per i dati sensibili e di solito più efficienti su larga scala.
Distribuire digna come livello di osservabilità su Databricks
Un deployment pratico di solito inizia separando le responsabilità. Databricks mantiene il lakehouse e l'esecuzione delle pipeline. Un livello di osservabilità come la soluzione digna per Databricks gira all'interno dell'ambiente del cliente, calcola metriche sulle tabelle Delta configurate e presenta i risultati in un'interfaccia unificata, senza chiedere ai dati di lasciare il perimetro.
Associare il prodotto al livello, non al logo
Il modello mentale più chiaro è allineare i componenti del prodotto ai livelli descritti sopra. Data Anomalies e Data Analytics corrispondono al livello di monitoraggio delle tabelle. Schema Tracker corrisponde al rilevamento del drift strutturale. Timeliness copre il monitoraggio della freschezza e degli arrivi in ritardo. Data Validation è il livello delle regole a livello di record, ovvero il punto in cui il monitoraggio nativo lascia ancora spazio a una logica di business più esplicita.
Questa corrispondenza conta perché evita sovrapposizioni fini a se stesse. Databricks vi offre già un monitoraggio nativo di freschezza e completezza a livello di schema. Un livello di osservabilità separato ha senso quando volete controlli più ampi sulle regole di business, calcolo delle metriche nel database e un luogo in cui esaminare insieme trend, modifiche allo schema e tempi di consegna.
Mantenere semplice la forma del deployment
Un pattern comune consiste nel registrare le tabelle Delta più importanti, lasciare che la piattaforma apprenda le baseline sul posto e poi convogliare anomalie, modifiche allo schema e violazioni delle regole in un'unica vista operativa. È particolarmente utile quando engineering, analytics e governance hanno tutti bisogno delle stesse evidenze ma non vogliono tre strumenti separati.
Il valore qui non sta in “più alert”. Sta in una separazione più chiara tra rilevamento e giudizio. Databricks può continuare a fare ciò che già fa bene, mentre un livello di osservabilità dedicato gestisce i controlli che richiedono una validazione più esplicita, un'ispezione più rigorosa o un'interfaccia migliore per il triage.
L'implementazione migliore è quella in cui i team di piattaforma capiscono a colpo d'occhio se il problema è un ritardo dei dati, un drift strutturale o un record errato.
Best practice e una breve checklist da applicare questa settimana
L'ordine giusto è semplice. Usate i constraint Delta come base minima, Lakehouse Monitoring come radar predefinito a livello di tabella e un livello di validazione dedicato per le regole di business che richiedono una gestione esplicita. Se confondete questi confini, gli alert diventano rumorosi e l'analisi delle cause principali rallenta.
Gli anti-pattern da evitare
Il primo errore è cercare di esprimere la semantica di business come soglie di anomalia. Una soglia può dirvi che una tabella è insolita. Non può dirvi se un numero di polizza è legittimo o se un codice di rimborso è conforme. Il secondo errore è saltare la quarantena e lasciare che i record sospetti contaminino i livelli a valle. Il terzo è dare per scontato che il monitoraggio di Unity Catalog sostituisca la governance delle regole a livello di riga. Non è così.
Una checklist per il lunedì mattina
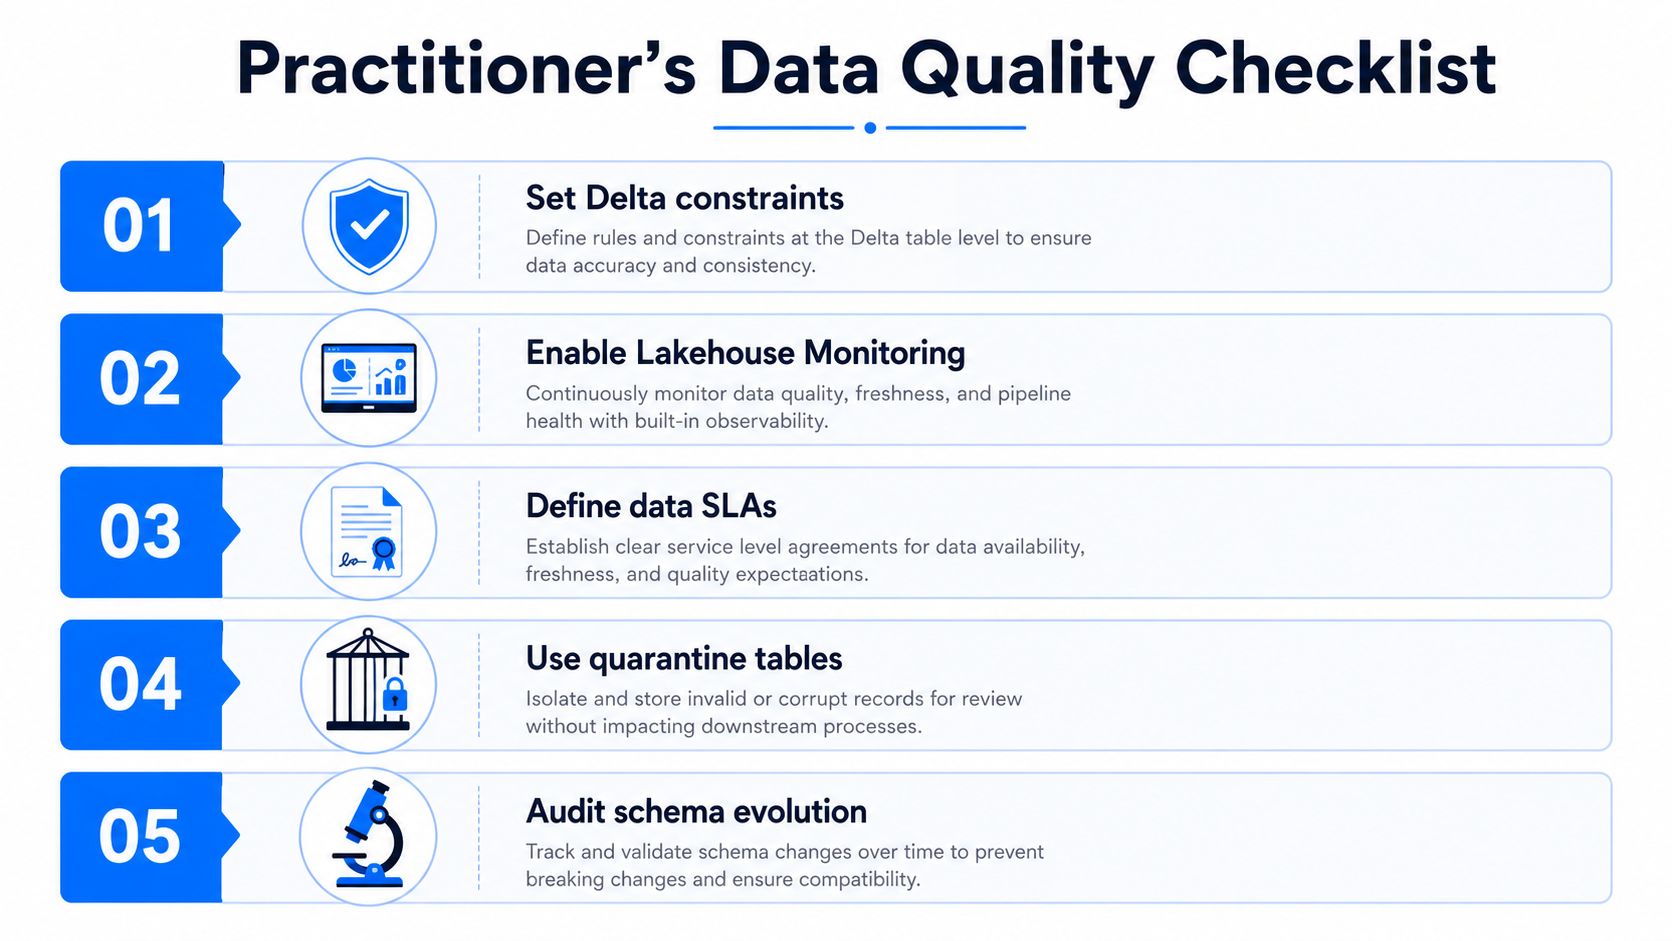
Impostate i constraint Delta. Assicuratevi che il livello di storage blocchi le incompatibilità evidenti prima che arrivino.
Attivate Lakehouse Monitoring. Lasciate che il monitoraggio a livello di schema osservi freschezza, completezza e drift.
Definite gli SLA sui dati. Stabilite cosa significano in ritardo, incompleto o obsoleto per le vostre tabelle critiche.
Usate tabelle di quarantena. Instradate le righe non valide in un luogo visibile invece di nasconderle nei log.
Verificate l'evoluzione dello schema. Controllate se le modifiche erano intenzionali prima che raggiungano Silver o Gold.
Questi cinque punti bastano a far emergere la maggior parte dei punti deboli di un ambiente Databricks. Impongono anche una conversazione utile con il business. Se una tabella è sana ma il report è ancora sbagliato, il problema è probabilmente nella logica di validazione, non nel livello di monitoraggio.
digna offre ai team un livello di osservabilità nel database per Databricks che sorveglia anomalie, tempestività, modifiche allo schema e validazione a livello di record senza spostare i dati di produzione fuori dall'ambiente del cliente. Se state cercando di separare la salute delle tabelle dall'applicazione delle regole di business, visitate digna e vedete come questo approccio a livelli si adatta al vostro lakehouse.
Vedete come digna lo fa nella pratica: monitorare la data quality nel lakehouse Databricks.
Domande frequenti
Come funziona la data quality in Databricks?
La data quality in Databricks funziona al meglio come tre livelli. Lo storage Delta Lake protegge il modo in cui i dati arrivano, con l'applicazione dello schema e lo storico delle tabelle. Lakehouse Monitoring e Unity Catalog sorvegliano le tabelle alla ricerca di obsolescenza, scritture incomplete e drift. Un livello di validazione controlla poi le singole righe rispetto alle regole di business prima che i record errati viaggino a valle.
Come rileva Unity Catalog le tabelle obsolete o incomplete?
La freschezza si basa sullo storico dei commit: una tabella viene segnalata come obsoleta quando un commit arriva insolitamente in ritardo rispetto al commit successivo previsto. La completezza usa i conteggi storici delle righe in una finestra di 24 ore, quindi una tabella risulta incompleta quando le scritture recenti scendono sotto l'intervallo appreso. Il monitoraggio predefinito viene eseguito ogni ora.
Cosa crea Lakehouse Monitoring per ogni tabella monitorata?
Per ogni tabella Delta monitorata in Unity Catalog, Lakehouse Monitoring crea due tabelle di metriche, una per le metriche di profilo e una per le metriche di drift. Costruisce inoltre dashboard che tracciano trend e anomalie nel tempo, offrendo ai team una registrazione persistente di cosa è cambiato nella tabella e quando.
Come si mettono in quarantena i record errati in Databricks?
Usate trasformazioni in stile SQL con filtri e clausole WHERE, più la logica CASE WHEN ... OTHERWISE per le eccezioni prevedibili alle regole di business. Un pattern comune mantiene i dati grezzi in Bronze, instrada le righe non valide verso una tabella di quarantena e mantiene Silver pulita per i job a valle. Tenete quella tabella di quarantena vicino alla pipeline, non sepolta nei log.
Il monitoraggio di Unity Catalog sostituisce la validazione dei dati a livello di riga?
No. Il monitoraggio di Unity Catalog può dirvi che una tabella sembra insolita, ma non può giudicare se un numero di polizza è legittimo o se un codice di rimborso è conforme. L'articolo raccomanda i constraint Delta come base minima, Lakehouse Monitoring come radar a livello di tabella e un livello di validazione dedicato per le regole di business.


