Pianificare la migrazione dei dati nel modo giusto
|
8
min di lettura

L'83% dei progetti di migrazione dei dati fallisce, e questo numero dovrebbe cambiare il vostro modo di pianificare una migrazione. Il problema di solito non è il trasferimento in sé, ma il lavoro che i team saltano prima che si sposti la prima riga: inventario, profilazione, mapping, test e progettazione del rollback. È per questo che tanti progetti crollano dopo un cutover che sulla carta sembra “concluso” (analisi di settore).
Un buon piano di migrazione è uno strumento di gestione del rischio. Indica dove i dati sono disordinati, dove lo schema si romperà, quali utenti di business hanno bisogno di accesso in parallelo e quanto tempo serve per la validazione prima che qualcuno dia l'approvazione finale. Per questo la stessa analisi che cita il tasso di fallimento dell'83% raccomanda anche di dedicare il 20-25% della tempistica complessiva ad assessment e pianificazione, più il 30-40% ai test: una migrazione di 12 settimane riserverebbe quindi in genere circa 2,5-3 settimane alla pianificazione e 3,5-5 settimane alla validazione (analisi di settore).
Questa disciplina sui tempi è importante perché la pianificazione non è un esercizio di calendario. È il momento in cui i team decidono se stanno spostando un carico di lavoro ben compreso o se stanno scommettendo su delle ipotesi. Un utile benchmark esterno sui tempi di implementazione è una tempistica realistica per il software logistico, che mostra come una consegna per fasi batta un lancio compresso quando le dipendenze sono reali (tempistica di implementazione di Coreties). Per una visione più ampia delle modalità di fallimento più comuni, si abbina bene anche alle insidie pratiche discusse nella guida di digna ai problemi di migrazione.
Indice
Perché la maggior parte delle migrazioni fallisce prima che si sposti la prima riga
Sicurezza, compliance e una checklist di pianificazione davvero utilizzabile
Perché la maggior parte delle migrazioni fallisce prima che si sposti la prima riga
La verità nuda e cruda è che l'83% dei progetti di migrazione dei dati fallisce, e la maggior parte di questi fallimenti inizia molto prima del giorno dell'esecuzione (analisi di settore). Il job di estrazione gira. Il job di caricamento gira. Poi il team scopre che l'inventario delle sorgenti era incompleto, che le trasformazioni non sono mai state verificate su dati simili a quelli di produzione o che il cutover è stato pianificato come un rilascio software invece che come un evento controllato sui dati.
La leva decisiva è nella pianificazione
La stessa analisi che fornisce il dato sui fallimenti indica anche la ripartizione dei tempi che funziona meglio nella pratica. Un piano solido dedica il 20-25% della tempistica ad assessment e pianificazione e il 30-40% ai test. In un programma di 12 settimane, restano circa 2,5-3 settimane per la pianificazione e 3,5-5 settimane per la validazione. Non è overhead. È il lavoro vero e proprio.
Se un team comprime la pianificazione in pochi giorni, di solito significa che l'inventario è superficiale, che le regole di business sono sepolte nella conoscenza tacita e che il piano di fallback esiste solo nella testa di qualcuno. Quando il primo caricamento fallisce, il progetto è già in modalità rilavorazione. Per questo il piano di migrazione va letto come un documento di controllo, non come una presentazione.
Regola pratica: se il calendario non lascia spazio ad almeno un dry run con volumi di produzione, il calendario è troppo aggressivo.
La differenza emerge nei progetti che trattano il cutover come un evento provato in anticipo. Le linee guida di AWS sulla migrazione illustrano chiaramente la sequenza: descrivere la sorgente, definire la destinazione, testare prima e dismettere il vecchio sistema solo dopo che quello nuovo è rimasto stabile per un certo periodo (linee guida AWS sulla migrazione dei dati). Questa sequenza è l'esatto opposto di “muoversi in fretta e sperare”.

Le migrazioni più affidabili che ho visto non sono mai state le più veloci. Sono state quelle in cui il team ha dato alla pianificazione abbastanza spazio per far emergere presto le parti critiche, quando c'era ancora tempo per cambiare perimetro, sequenza o strumenti. È anche lì che emergono i costi nascosti: il budget di riserva per il supporto al rollback, le esecuzioni di validazione aggiuntive e una finestra di audit post-cutover più lunga. Se non riservate tempo per confrontare i conteggi, riconciliare le eccezioni e osservare le prime query in produzione, il piano smette di essere un piano nel momento in cui gli utenti iniziano a fare affidamento sul nuovo sistema.
Per i team che vogliono un obiettivo di calendario concreto, una tempistica realistica per il software logistico è un utile punto di riferimento, perché impone la stessa disciplina: test per fasi, prove del cutover e spazio per la stabilizzazione, invece di dare per scontato che il primo caricamento racconti tutta la storia.
La pianificazione ha bisogno anche di un luogo in cui registrare le modalità di fallimento che di solito vengono liquidate con superficialità. Un piano di migrazione chiaro dovrebbe indicare il responsabile della validazione, il trigger di rollback, il metodo di riconciliazione e i segnali di observability che stabiliranno se il sistema è sano dopo il cutover. È qui che i progetti mantengono il controllo o scivolano nelle congetture. Se volete ridurre le sorprese evitabili, vale la pena includere nella revisione del piano l'approfondimento di digna sulle insidie più comuni della migrazione dei dati e su come risolverle, prima che qualcuno inizi a spostare dati.
Perimetro, discovery e inventario dei sistemi sorgente
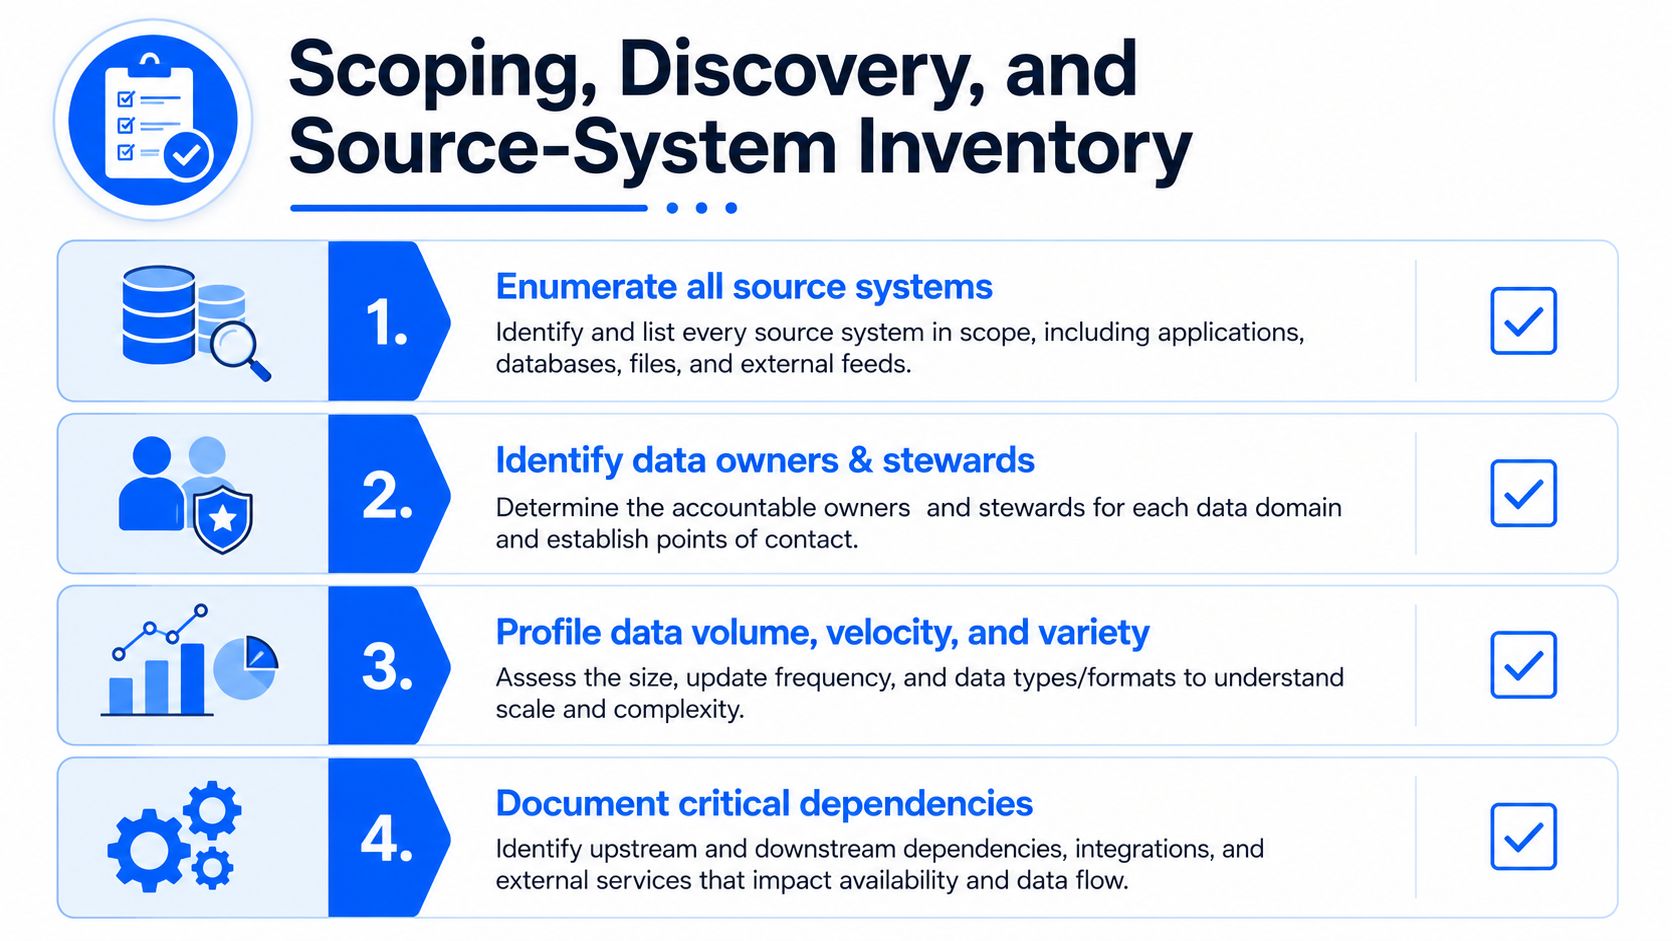
La discovery è il momento in cui i buoni programmi di migrazione smettono di tirare a indovinare. Prima di discutere di strumenti o di stile di cutover, il team ha bisogno di un inventario completo dei sistemi sorgente che indichi ogni sistema, responsabile, frequenza di aggiornamento, classe di sensibilità e consumatore a valle. Un carico di lavoro senza responsabile può comunque essere critico per il business, ed è esattamente così che le migrazioni vengono colte alla sprovvista.
Costruire l'inventario come un asset operativo
Iniziate elencando ogni sorgente, non solo i database di produzione più evidenti. Includete repliche di reporting, estrazioni dipartimentali, file depositati e sistemi secondari che alimentano i flussi di finanza, operations o compliance. Per ciascuno, registrate il responsabile, il data steward, la pianificazione, i requisiti di conservazione e chi ne dipende a valle.
Poi profilate i dati. Una buona profilazione esamina conteggi dei record, tassi di valori nulli, distribuzioni dei valori, anomalie e righe orfane (best practice di filefeed). È lì che emergono le sorprese, come una colonna con una cardinalità molto più alta del previsto, una slowly changing dimension mai documentata o una tabella che tutti consideravano dismessa ma che alimenta ancora un report mensile.
Una volta che l'inventario è visibile, create un documento di mapping campo per campo. Significa collegamenti espliciti tra campi sorgente e target, conversioni di tipo, regole di trasformazione e gestione di valori nulli e predefiniti. L'obiettivo non è solo spostare i dati, ma rendere ogni ipotesi verificabile prima che l'engineering inizi a collegare le pipeline.
Una fase di discovery della migrazione è completa solo quando qualcuno sa spiegare, campo per campo, che cosa cambia, che cosa resta e che cosa si rompe se la sorgente si modifica.
Chiudere la discovery con una verifica delle dipendenze
Una checklist pratica di completamento della discovery dovrebbe includere quattro elementi. Primo, ogni sorgente ha un responsabile. Secondo, ogni tabella importante ha un profilo. Terzo, ogni consumatore a valle è identificato. Quarto, ogni regola non ovvia è messa per iscritto, non lasciata nella cronologia di una chat.
Quando queste quattro caselle sono spuntate, la discussione sull'architettura diventa concreta. Senza di esse, l'architettura è solo una speculazione corredata di diagrammi.
Scegliere una strategia di cutover adeguata al rischio
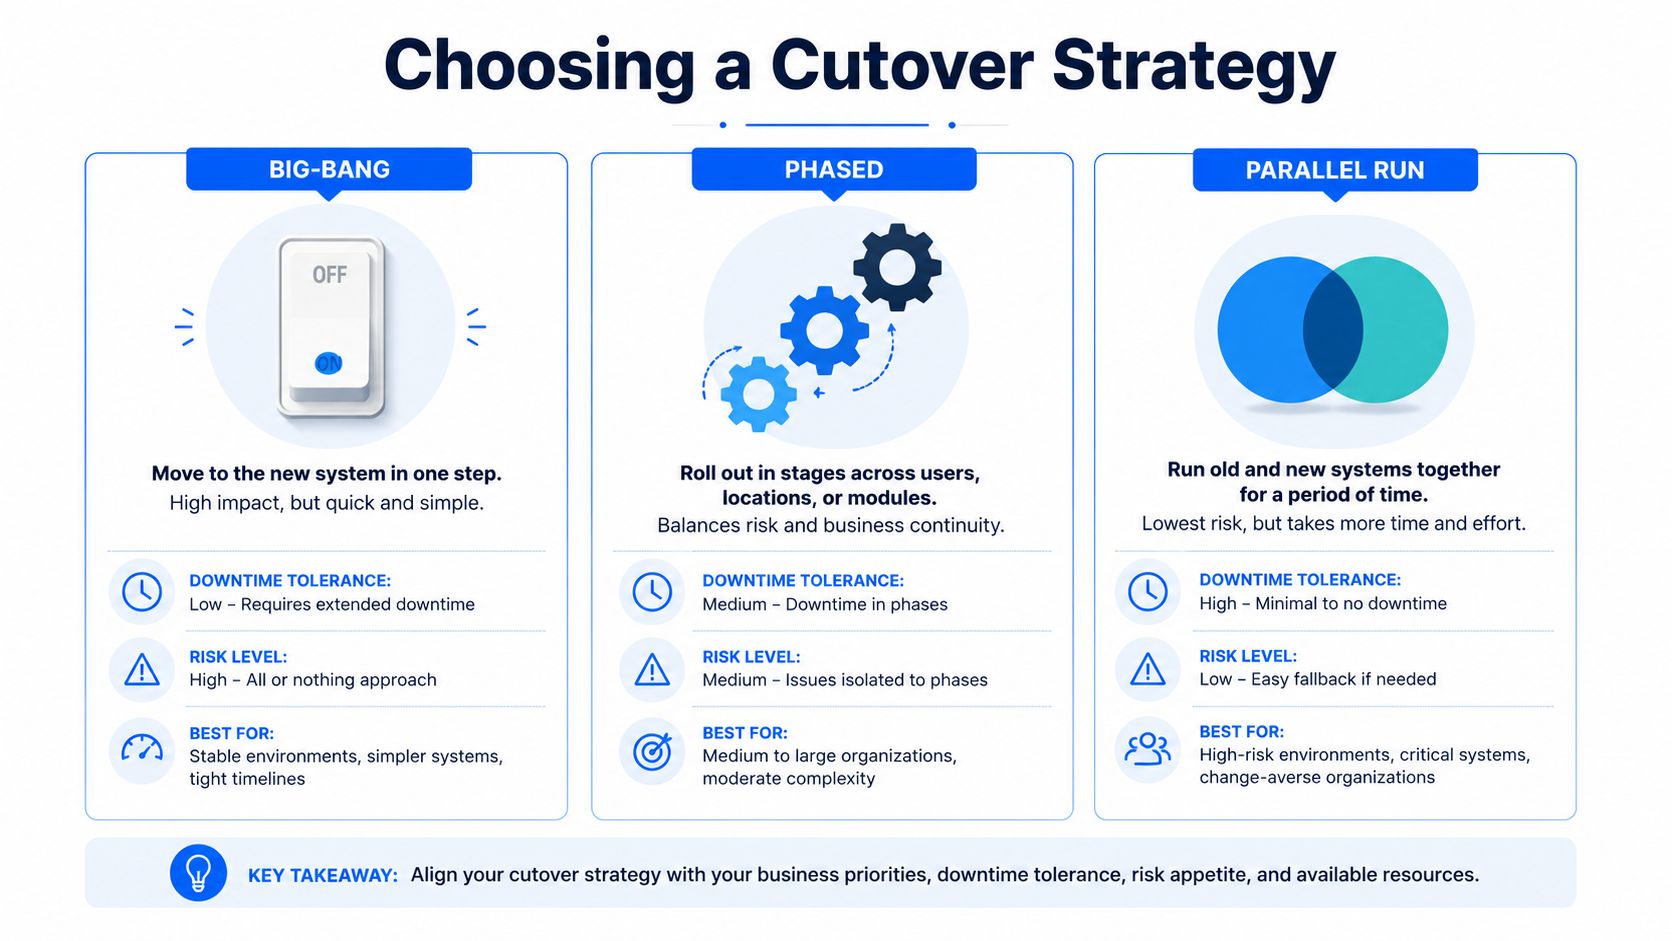
La strategia di cutover giusta dipende da ciò che il business può tollerare quando qualcosa va storto. Big bang, cutover per fasi e parallel run sono tutti pattern validi, ma risolvono problemi diversi. A guidare la scelta devono essere la tolleranza ai fermi, il volume dei dati, la criticità regolamentare e la complessità del rollback, non le preferenze personali.
Il big bang funziona solo quando il raggio d'impatto è ridotto
Il cutover big bang è il più semplice da descrivere e il più difficile da cui riprendersi. È adatto a sistemi con volumi ridotti, dipendenze chiare e un percorso di rollback testato, non presunto. Se il carico di lavoro è importante dal punto di vista operativo ma non è sottoposto a controlli di audit stringenti, e sorgente e target sono abbastanza simili da rendere accettabile un breve congelamento, il big bang può essere la strada più pulita.
Il cutover per fasi si adatta al caso opposto. Se il sistema ha dipendenze complesse, molti consumatori o funzioni di business che possono essere spostate per gradi, l'approccio per fasi è più sicuro, perché ogni ondata diventa un punto di validazione. Il parallel run dà il meglio quando la fiducia conta più della velocità, perché il vecchio e il nuovo sistema restano attivi abbastanza a lungo da consentire al team di confrontare gli output e intercettare le derive.
Usare il margine di budget come verifica di realtà
Un modello pratico di migrazione raccomanda un budget di riserva del 10-25% oltre alla stima di base (linee guida di RudderStack sulla migrazione). Questo margine non è un cuscinetto per l'ottimismo. Riflette la quantità di rilavorazione che tende a emergere quando il team inizia a confrontare i dati reali, a correggere i casi limite delle trasformazioni e a gestire i problemi di accesso sotto carico reale.
Un modo utile di ragionare è questo. Se il business non può tollerare totali errati, report obsoleti o una finestra di riconciliazione prolungata, il cutover dovrebbe orientarsi verso un approccio per fasi o in parallelo. Se il rollback è costoso, il big bang è di solito la scelta sbagliata. In ambito finanziario e sanitario, numeri sottoposti ad audit e requisiti di compliance aumentano il costo di sbagliare il primo passaggio, quindi il pattern più sicuro è di solito quello con più visibilità e meno drammi.
La parte difficile è che molte guide pubbliche si fermano alle checklist e non quantificano mai il margine in base al tipo o alla criticità della migrazione (discussione sul piano di Network Installers). Questa lacuna conta. Senza una regola sul margine, i team fingono che ogni migrazione sia un lavoro di consegna lineare, e le migrazioni raramente lo sono.
Pianificazione di schema, trasformazioni e compatibilità
Una volta scelto lo stile di cutover, inizia la pianificazione tecnica. Prima che venga eseguito qualsiasi job di estrazione, il team ha bisogno di uno schema target con DDL versionato, di un catalogo delle trasformazioni e di una matrice di compatibilità. Senza questi artefatti, le incongruenze di schema si trasformano in sorprese in produzione.
Rendere esplicito il target
Lo schema target deve essere messo per iscritto come oggetto controllato, non lasciato implicito nella piattaforma di destinazione. Un DDL versionato offre all'engineering un punto di riferimento stabile, cosa importante quando i sistemi sorgente evolvono durante il progetto. Se il target continua a cambiare mentre si testano i caricamenti, nessuno può capire se un errore è causato dai dati o dal modello.
Il catalogo delle trasformazioni deve indicare ogni regola di business che interessa una colonna: conversioni di tipo, cambi di precisione, adeguamenti di fuso orario, valori predefiniti e gestione dei valori nulli. Se una regola è importante per il business, ha bisogno di un responsabile. Se nessuno ne è responsabile, non è una regola, è un'ipotesi.
Costruire una matrice di compatibilità prima del primo caricamento
Una matrice di compatibilità rende visibili in un unico punto le differenze tra sorgente e target. Deve segnalare le incongruenze di tipo, codifica, precisione e fuso orario, così il team può decidere se convertire, troncare, preservare o rifiutare. I fallimenti silenziosi iniziano spesso qui, soprattutto quando le stringhe vengono accorciate senza preavviso o i timestamp passano da un fuso orario all'altro e nessuno se ne accorge finché un report a valle non risulta sbagliato.
Questo è anche il punto in cui la pianificazione dell'observability deve allinearsi al piano dello schema. Schema Tracker di digna è progettato per segnalare modifiche strutturali come colonne aggiunte o rimosse e cambi di tipo di dato, quindi gli artefatti prodotti qui dagli ingegneri dovrebbero corrispondere alle modifiche che il livello di monitoraggio deve intercettare. Questo allineamento evita uno scollamento tra ciò che il team di migrazione pensa di aver costruito e ciò che la piattaforma è in grado di osservare.
Regola empirica: se una modifica di schema può rompere una dashboard, deve essere scritta nel catalogo delle trasformazioni, non lasciata da scoprire durante la validazione.
Per il passaggio di consegne all'engineering, il set minimo di documenti dovrebbe essere semplice: DDL target, specifica del mapping dei campi, catalogo delle trasformazioni e matrice di compatibilità. Quando questi quattro elementi sono chiari, il codice di estrazione ha un contratto da rispettare.
Validazione, dry run e observability durante la migrazione
La validazione va trattata come un flusso continuo di segnali, non come un controllo una tantum. Un solo test a pieno volume non basta quando sistema target, dati sorgente e trasformazioni interagiscono sotto la pressione della produzione. Una base migliore è eseguire almeno tre migrazioni di test complete con estrazioni a volumi di produzione, usando poi la terza per confermare che il processo regga in condizioni realistiche.
I dry run devono dimostrare più della semplice caricabilità
Il primo dry run di solito fa emergere permessi mancanti, disallineamenti di schema e ipotesi errate sui volumi. Il secondo rivela spesso casi limite delle trasformazioni e difetti di pulizia. Il terzo è quello che conta, perché mostra se il processo è ripetibile e non frutto della fortuna.
Un modello pratico raccomanda anche un margine del 50% sulla stima complessiva dei tempi per coprire ritardi imprevisti. Può sembrare prudente, finché un dry run a volumi di produzione non richiede più tempo del previsto perché una tabella dipendente è più grande di quanto il team pensasse, o perché una query di validazione deve essere riscritta per evitare di bloccare la sorgente. Un modello di piano di migrazione dei dati di Concentrus sottolinea lo stesso punto, obbligando i team a mettere a budget il lavoro che emerge solo dopo la prima prova.
La scelta di pianificazione giusta è progettare la validazione attorno ai dati di business di cui le persone si fidano. Significa conteggi delle righe, totali di controllo, tassi di valori nulli, variazioni delle distribuzioni, modifiche di schema e tempestività rispetto all'arrivo atteso. Significa anche confrontare questi segnali durante l'esecuzione, non dopo che la sorgente è stata dismessa.
Il monitoraggio deve intercettare le derive finché il team può ancora intervenire
Strumenti come digna si inseriscono qui in modo naturale. Anomaly detection, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema sono progettati per mantenere attivi i controlli per tutta la finestra di cutover, non solo agli estremi. In una migrazione questo conta, perché un'ipotesi sbagliata può nascondersi in un calcolo mentre il caricamento sembra comunque riuscito.
La guida di digna alla validazione durante le migrazioni segue la stessa disciplina: stabilire baseline sulla sorgente, profilare i campi, mappare le relazioni e monitorare la coerenza dello schema durante lo spostamento. Questo approccio funziona perché si concentra sul fatto che i dati abbiano ancora lo stesso significato una volta arrivati a destinazione.
Un pattern di fallimento comune è facile da non notare. Una colonna sorgente che contiene un totale numerico viene convertita in un tipo diverso nel target e il caricamento si completa senza errori. I conteggi delle righe coincidono, ma i totali a valle no. La catena di segnali lo intercetta perché i controlli a livello di record, i confronti sugli aggregati e il tracciamento dello schema non dicono tutti la stessa cosa: è esattamente la discrepanza che un buono stack di observability dovrebbe far emergere prima che il business veda il report errato.
Runbook di cutover, rollback e riconciliazione
Un runbook di cutover deve leggersi come un piano operativo, non come un elenco di attività. Ogni fase ha bisogno di un responsabile, di un trigger e di una condizione di arresto. È così che una migrazione resta sotto controllo quando il conto alla rovescia parte e il nervosismo sale.
Definire le fasi prima di congelare la sorgente
La sequenza abituale è semplice: congelamento pre-cutover, finestra di dual-write o di sola lettura, switchover, verifica post-cutover e dismissione della sorgente. AWS raccomanda inoltre di attendere un periodo di funzionamento stabile in produzione prima di ritirare il vecchio sistema, e le checklist di settore prevedono comunemente una finestra di audit post-cutover di 2-4 settimane prima della dismissione della sorgente (linee guida AWS sulla migrazione dei dati).
I trigger di rollback devono essere misurabili. Picchi del tasso di errore, discrepanze di riconciliazione e scostamenti finanziari sono tutti esempi validi, ma richiedono soglie concordate prima del lancio, non negoziate durante la gestione dell'incidente. Se la capacità di rollback sul sistema legacy deve restare attiva, va mantenuta in funzione abbastanza a lungo da essere utile.
Con la riconciliazione la fiducia diventa dimostrabile
La riconciliazione deve confrontare conteggi delle righe, totali di controllo e valori campione dei campi tra sorgente e target. Deve basarsi su strumenti o script di confronto, non su un'archeologia manuale tra fogli di calcolo. La verifica post-cutover deve proseguire per tutta la finestra di audit, perché alcuni errori emergono solo quando i flussi di business iniziano a usare il nuovo sistema a ritmo normale (checklist di Rivery).
Il runbook deve assegnare chi monitora ciascun segnale. Il DBA su accessi e comportamento dei caricamenti. Il team applicativo sugli errori delle applicazioni. Il data engineer sugli script di riconciliazione. Il business owner sull'approvazione dei flussi chiave. Questa suddivisione evita che l'incidente diventi un problema di tutti e una responsabilità di nessuno.
Il rollback non è un segno di fallimento. È la prova che il team ha pianificato per la realtà invece che per la scena.
Quando il runbook è chiaro, la migrazione sembra meno un salto nel vuoto e più una sequenza di condizioni che devono essere tutte soddisfatte prima di ritirare la sorgente.
Sicurezza, compliance e una checklist di pianificazione davvero utilizzabile
Sicurezza e compliance devono essere integrate negli stessi artefatti che guidano la migrazione, non aggiunte alla fine. Crittografia in transito e a riposo, gestione delle chiavi, controlli di accesso sulle estrazioni di staging e audit logging per ogni trasformazione fanno parte del piano, perché una migrazione che sposta i dati in sicurezza ma non lascia una traccia di audit fallisce comunque sul piano della governance.
Mantenere attiva la validazione dopo il go-live
È nella fase post-cutover che molti piani si rompono. Gli esperti di dominio devono spesso restare coinvolti per mesi, soprattutto quando il business si basa su confronti report per report, dual write o controlli continui su campi calcolati e relazioni. Alcune linee guida indipendenti di professionisti del settore arrivano a sostenere lunghe finestre di sovrapposizione e un coinvolgimento prolungato degli esperti, perché una deriva silenziosa è più facile da non notare di un errore bloccante (framework di migrazione di Particle41).
Per questo la checklist deve trattare il post-cutover come una fase, non come una nota a piè di pagina. Continuate a monitorare l'arrivo dei dati, gli output delle regole di business e l'integrità delle relazioni mentre gli utenti iniziano a fare affidamento sul nuovo sistema. Se qualcosa sembra stabile il primo giorno ma deriva nella terza settimana, il piano non era ancora finito.
Usare un'unica checklist organizzata per fasi
Perimetro: inventariate ogni sorgente, responsabile, dipendenza e consumatore, poi profilate conteggi, valori nulli, distribuzioni e anomalie.
Architettura: definite lo schema target, il catalogo delle trasformazioni, la matrice di compatibilità e il percorso di rollback.
Validazione: eseguite più migrazioni di test a pieno volume, confrontate totali e campioni e mantenete attivi i controlli sullo schema.
Cutover: congelate, effettuate lo switch, riconciliate e monitorate per tutta la finestra di audit.
Post-cutover: mantenete coinvolti gli esperti di dominio, sorvegliate le derive silenziose e ritirate la sorgente solo dopo aver dimostrato la stabilità.
È questa la differenza tra un progetto che va in produzione senza intoppi e uno che erode la fiducia. Pianificare bene la migrazione dei dati non significa far sembrare completo il piano, ma dimostrare che il business può fidarsi del nuovo sistema quando quello vecchio sarà finalmente dismesso.
Se state pianificando una migrazione e volete controlli che continuino a funzionare dopo il cutover, visitate digna. È progettato per rilevare anomalie, validare i record, monitorare la tempestività e segnalare le modifiche di schema mentre i vostri dati restano nel vostro ambiente. Offre così ai team di migrazione un modo pratico per individuare le derive prima che gli utenti inizino ad aprire ticket.
Poiché la matrice di compatibilità deve corrispondere alle modifiche strutturali che il vostro monitoraggio deve intercettare, scoprite come digna Schema Tracker segnala colonne aggiunte, colonne rimosse e cambi di tipo di dato durante e dopo una migrazione.
Domande frequenti
Perché la maggior parte dei progetti di migrazione dei dati fallisce?
La maggior parte fallisce per il lavoro saltato prima che si sposti la prima riga, non per il trasferimento in sé. L'articolo cita un tasso di fallimento dell'83% e indica inventari delle sorgenti incompleti, trasformazioni mai testate su dati simili a quelli di produzione e cutover pianificati come rilasci software invece che come eventi controllati sui dati.
Quanta parte della tempistica di una migrazione va dedicata a pianificazione e test?
Prevedete di dedicare il 20-25% della tempistica ad assessment e pianificazione e il 30-40% ai test. In una migrazione di 12 settimane, significa circa 2,5-3 settimane per la pianificazione e 3,5-5 settimane per la validazione, con spazio per almeno un dry run a volumi di produzione.
Come scegliere tra cutover big bang, per fasi e in parallelo?
Adattate la strategia alla tolleranza ai fermi, al volume dei dati, alla criticità regolamentare e alla complessità del rollback. Il big bang è adatto a sistemi con volumi ridotti e un percorso di rollback testato, l'approccio per fasi si adatta a dipendenze complesse perché ogni ondata diventa un punto di validazione, e il parallel run funziona meglio quando la fiducia conta più della velocità.
Quante migrazioni di test bisogna eseguire prima del cutover?
Eseguite almeno tre migrazioni di test complete con estrazioni a volumi di produzione. La prima di solito fa emergere problemi di permessi, disallineamenti di schema e ipotesi sui volumi, la seconda rivela i casi limite delle trasformazioni e la terza mostra se il processo è ripetibile. Un margine del 50% sulla stima complessiva dei tempi copre i ritardi che queste prove portano alla luce.
Per quanto tempo va mantenuto il sistema sorgente dopo il cutover?
Mantenetelo finché il nuovo sistema non si è dimostrato stabile, cosa che le checklist di settore fissano comunemente in una finestra di audit post-cutover di 2-4 settimane. In quel periodo, riconciliate conteggi delle righe, totali di controllo e valori campione dei campi, e mantenete attiva la capacità di rollback abbastanza a lungo da essere utile.


