Monitoraggio dei dati in tempo reale
|
7
min di lettura

Venerdì una dashboard sembrava a posto. Lunedì mattina il top management aveva già discusso i numeri, il team vendite aveva ridefinito le priorità degli account e il reparto finance aveva riutilizzato lo stesso dataset per una previsione. Poi qualcuno si è accorto che il caricamento del fine settimana si era bloccato. I grafici erano “verdi” perché lo strumento di BI funzionava correttamente. I dati sottostanti no.
È il divario in cui si trovano oggi molti team. Hanno il monitoraggio dell'infrastruttura, i log delle pipeline, la cronologia delle query del data warehouse e forse qualche controllo sul numero di righe. Ma continuano a non vedere i problemi che contano di più: dati che arrivano in ritardo, modifiche silenziose dello schema, drift nei campi chiave e record che tecnicamente sono arrivati ma di cui non ci si dovrebbe fidare. Il monitoraggio dei dati in tempo reale inizia a ripagare solo quando copre i dati stessi, non soltanto i sistemi che li circondano.
Il cambiamento pratico è questo: smettete di considerare il monitoraggio una questione esclusivamente operativa. Trattatelo come un livello di controllo che attraversa ingestion, trasformazione, archiviazione e consegna. I team che lo fanno bene intercettano i report obsoleti prima di una riunione del management, impediscono che feature errate raggiungano le dashboard rivolte ai clienti ed evitano di esportare dati sensibili solo per osservarli.
Indice
Perché il monitoraggio in tempo reale non è più facoltativo
Il monitoraggio dei dati in tempo reale è diventato un requisito di business nel momento in cui i team hanno iniziato a prendere decisioni quotidiane basandosi su dashboard live anziché su report statici. Se un report critico diventa obsoleto durante un fine settimana e nessuno se ne accorge, il problema non è solo tecnico. I manager agiscono su un quadro sbagliato, gli analisti perdono ore a riconciliare i numeri e la fiducia nella piattaforma dati diminuisce.
Sono cambiate le dimensioni e le aspettative. Si prevede che il mercato della data observability crescerà da 1,7 miliardi di USD nel 2025 a 9,7 miliardi di USD entro il 2034, con un CAGR del 21,3%, segno di un ampio spostamento verso una gestione proattiva della salute dei dati, anziché un troubleshooting occasionale, secondo Fortune Business Insights sul mercato della data observability.
Questa crescita ha senso dal punto di vista di chi lavora sul campo. I team di solito monitorano già calcolo, storage, uptime delle API e stato dell'orchestratore. Ma questi controlli non rispondono alle domande che interessano agli stakeholder:
I dati di vendita sono arrivati quando dovevano?
La modifica di schema di ieri ha compromesso i modelli a valle?
Un sistema sorgente ha iniziato a inviare valori al di fuori del pattern normale?
La dashboard si è aggiornata con record incompleti?
Un monitoraggio in tempo reale che vi dice solo che la pipeline è stata eseguita è incompleto. Un job andato a buon fine può comunque pubblicare dati errati.
Molti team confondono l'observability con semplici health check. Non sono la stessa cosa. Un data warehouse può essere attivo, un job dbt può terminare e una dashboard può comunque essere sbagliata perché i dati sono arrivati in ritardo, hanno cambiato forma o hanno subito un drift inosservato. Questa distinzione è centrale quando si confrontano data observability e data quality.
Il vero costo è l'erosione della fiducia
I guasti più difficili da recuperare non sono quelli rumorosi, ma quelli silenziosi. I job che falliscono attirano l'attenzione. I problemi silenziosi dei dati persistono abbastanza a lungo da diffondersi nel reporting per il management, nelle sincronizzazioni di reverse ETL e nelle feature dei modelli.
Un approccio maturo al monitoraggio dei dati in tempo reale esiste per far emergere questi problemi prima che li scoprano gli utenti. Ecco perché non è più facoltativo. Protegge le decisioni, non solo le pipeline.
Architetture fondamentali per acquisire i dati in movimento
Alcuni team sentono “tempo reale” e pensano subito a Kafka, Flink e a uno stack di streaming completo. A volte è la scelta giusta. Spesso no. L'architettura dovrebbe seguire la finestra decisionale che volete supportare.
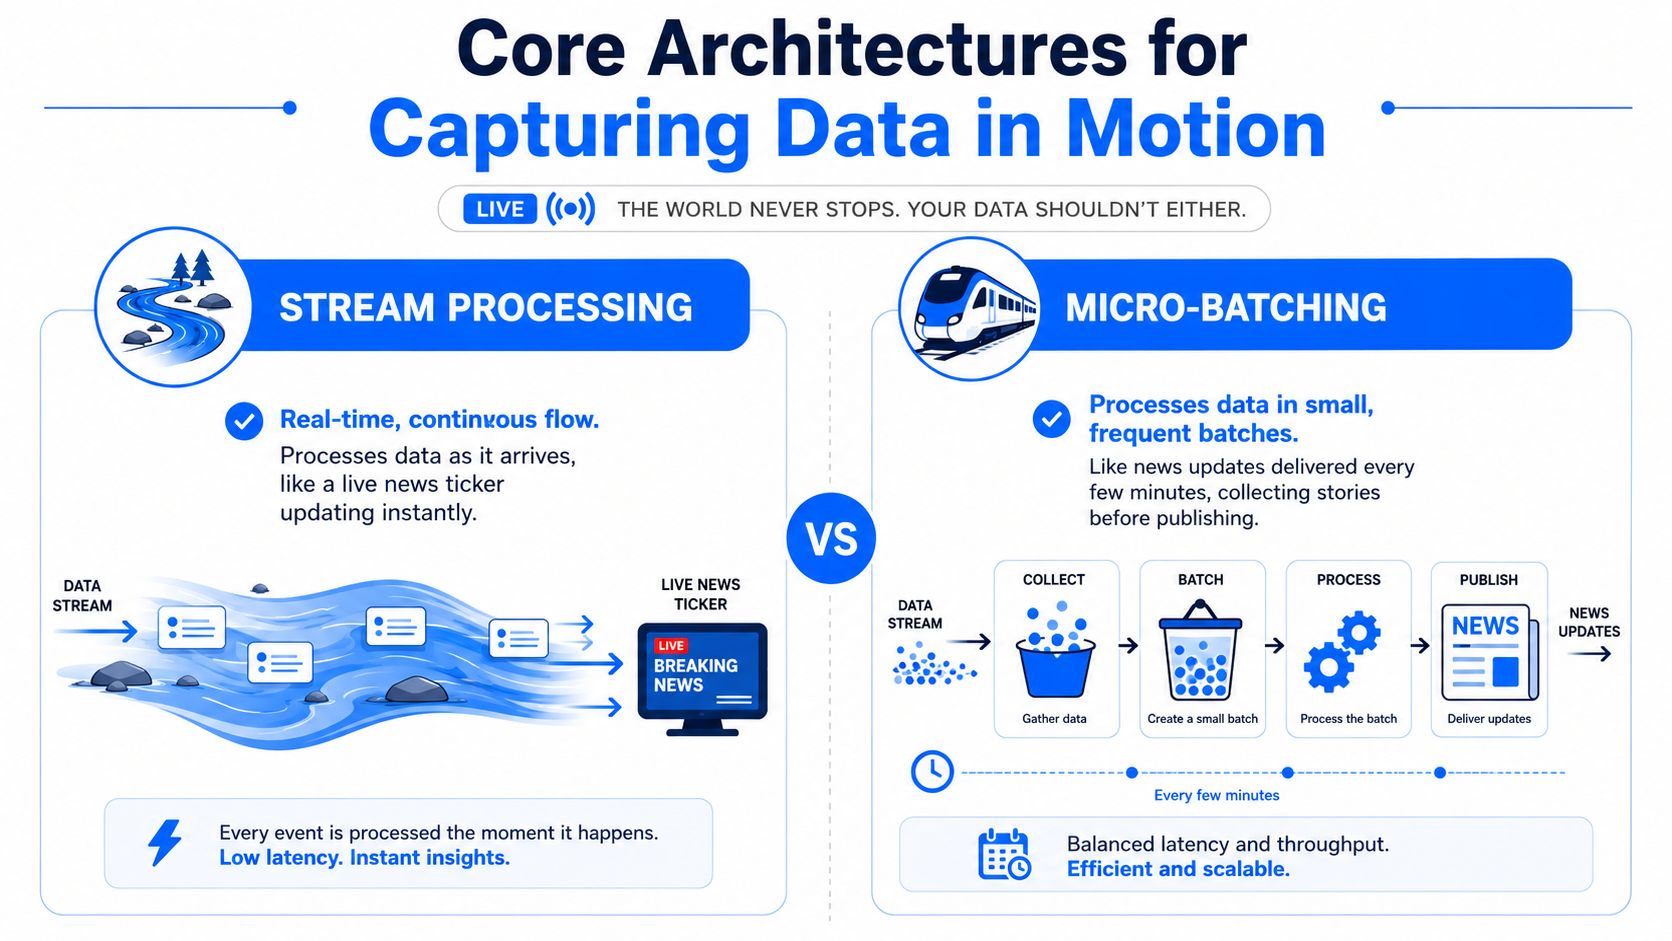
Streaming e micro-batching risolvono problemi diversi
Un modo semplice per spiegare il compromesso è il confronto tra un notiziario in diretta e i bollettini a orari prestabiliti.
Lo stream processing si comporta come la diretta: gli eventi vengono elaborati man mano che arrivano. Il micro-batching si comporta come aggiornamenti frequenti delle notizie: il sistema raccoglie gli eventi in un breve intervallo e poi li elabora insieme. Entrambi possono essere utili. Semplicemente ottimizzano aspetti diversi.
Un breve confronto rende il compromesso più chiaro:
Approccio | Ideale per | Punto di forza | Costo principale |
|---|---|---|---|
Streaming | Rilevamento frodi, alert industriali, cicli di controllo operativo | Latenza minima | Maggiore complessità operativa |
Micro-batching | Dashboard, analytics operativa, molti flussi di lavoro di business | Più semplice ed economico da gestire | Accetta un piccolo ritardo |
La definizione tecnica è importante. L'elaborazione dei dati in tempo reale fornisce risultati con una latenza misurata in secondi o millisecondi, distinguendo il vero tempo reale, sotto il secondo, dal quasi tempo reale, da qualche secondo a qualche minuto. Livelli di stream processing come Apache Flink calcolano aggregati al volo per rilevare istantaneamente le anomalie, come descritto nella panoramica di Splunk sui dati in tempo reale.
Questa distinzione evita molti errori di architettura. Non costruite un sistema sotto il secondo per una dashboard che nessuno consulta più di qualche volta al giorno. E non affidatevi a micro-batch di cinque minuti per un caso d'uso in cui ogni secondo conta.
Il monitoraggio in-database cambia il modello di sicurezza
C'è un'altra scelta architetturale spesso sottovalutata: dove viene eseguita la logica di monitoraggio?
Gli strumenti di monitoraggio SaaS tradizionali spesso trasferiscono metadati, campioni o dati grezzi in un ambiente controllato dal fornitore. Può funzionare in alcuni casi, ma aggiunge spostamenti di dati, aumenta il carico di revisione per i team di sicurezza e può essere difficile da giustificare negli ambienti regolamentati.
Un design in-database cambia l'equazione:
I dati restano dove sono, nel vostro data warehouse, data lake, private cloud o ambiente on-premises.
Le metriche vengono calcolate vicino ai dati, il che riduce gli spostamenti e spesso semplifica la gestione della latenza.
Le revisioni di sicurezza sono più semplici perché non create un ulteriore percorso di copia verso l'esterno.
Le tabelle sensibili dal punto di vista della privacy restano sotto il vostro controllo, anche mentre vengono monitorate.
Regola pratica: se il vostro strumento di monitoraggio richiede un accesso ampio per esportare i dati di produzione, trattatelo come una decisione di architettura, non come una funzionalità da spuntare.
Questo conta ancora di più quando si ha a che fare con modifiche strutturali. Lo schema drift tende a compromettere i consumatori a valle senza che nessuno se ne accorga, soprattutto quando i produttori aggiungono colonne, cambiano tipi o modificano payload annidati senza coordinamento. Un'utile introduzione a questa modalità di guasto è questa spiegazione dello schema drift e delle rotture delle pipeline.
Ciò che funziona in pratica è adattare l'architettura all'urgenza e mantenere il monitoraggio vicino ai dati. Ciò che non funziona è copiare grandi volumi in un ambiente di monitoraggio separato sperando che più strumenti compensino una maggiore distanza.
I sei pilastri della salute dei dati in tempo reale
Il monitoraggio diventa confuso quando i team non concordano su cosa significhi “in salute”. La soluzione è definire un piccolo insieme di segnali che riflettano il comportamento dei dati in movimento. Nel lavoro operativo, considero il monitoraggio dei dati in tempo reale come sei pilastri: latenza, throughput, accuratezza, completezza, freshness e disponibilità.
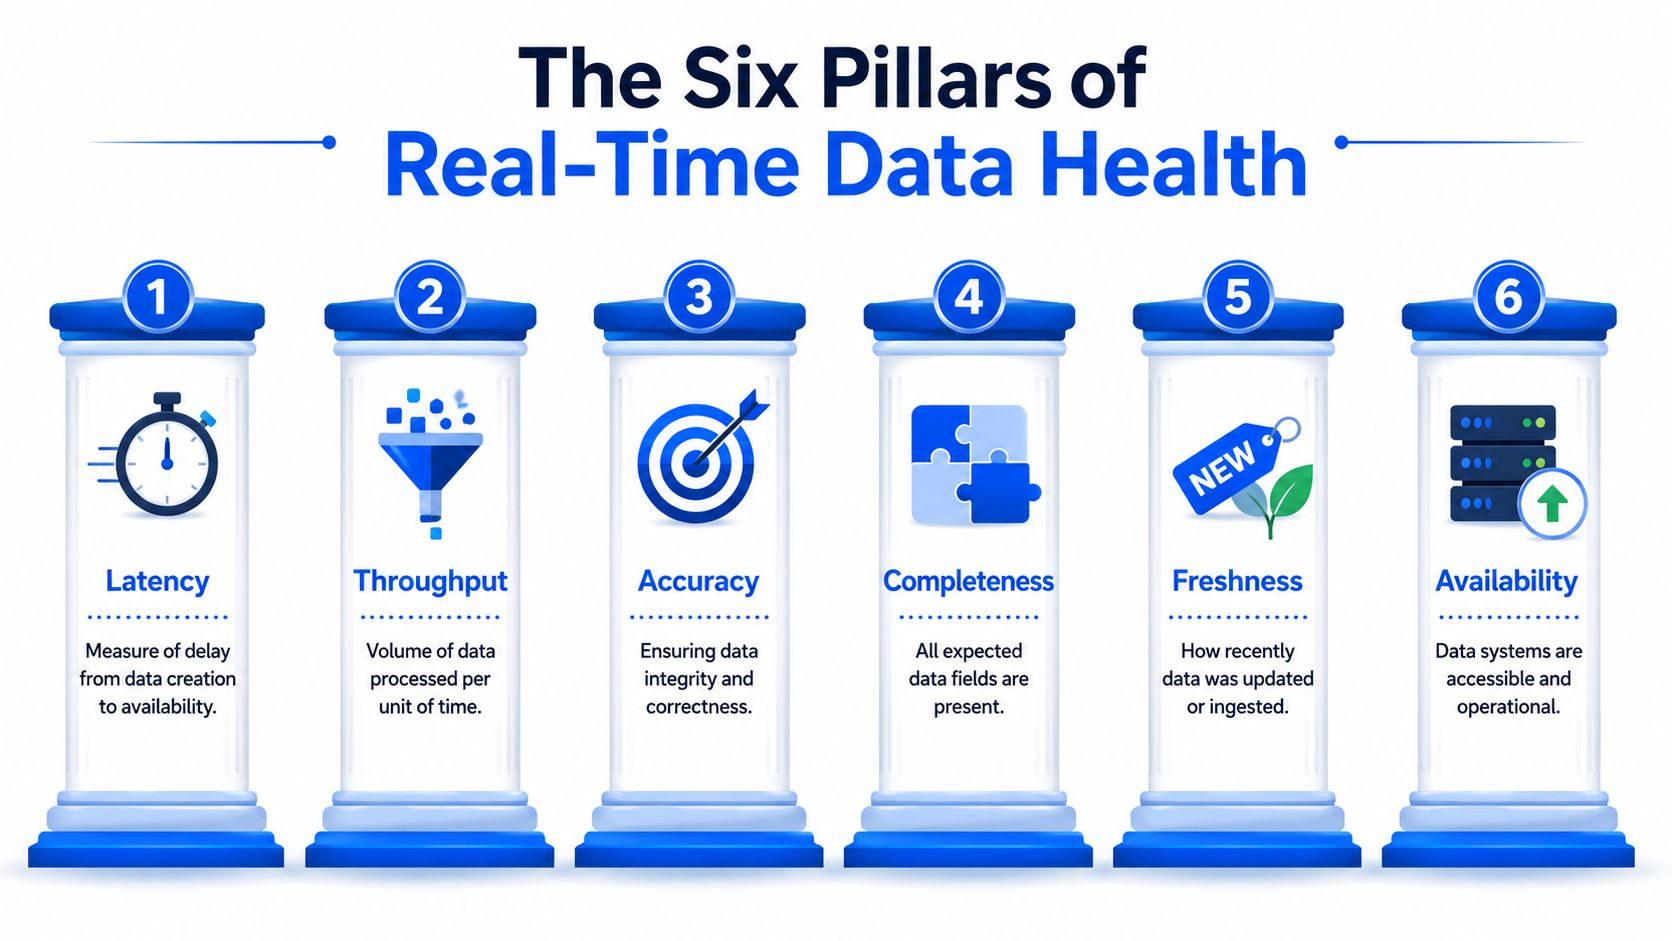
Come si presentano i segnali di buona salute
Considerate questi pilastri come rilevatori di guasti diversi, non come metriche intercambiabili.
La latenza è il ritardo tra la creazione dell'evento e la sua effettiva disponibilità. In pratica, vi dice se la pipeline sta tenendo il passo con il processo di business che supporta.
Il throughput è il volume elaborato nel tempo. I cali possono segnalare errori di ingestion, throttling, interruzioni delle sorgenti o consumatori bloccati.
L'accuratezza verifica se i valori sono corretti. Una riga può arrivare puntuale ed essere comunque sbagliata.
La completezza verifica se i record o i campi attesi sono presenti. I caricamenti parziali spesso sembrano riusciti finché un modello o una dashboard a valle non rivela le lacune.
La freshness misura quanto sono vecchi i dati nel momento in cui qualcuno li utilizza. È ciò che di solito intendono gli utenti di business quando chiedono se una dashboard è aggiornata.
La disponibilità vi dice se il sistema di dati monitorato può essere interrogato o servito.
Un modo rapido per ricordare la differenza è questo:
Pilastro | Domanda pratica |
|---|---|
Latenza | Quanto tempo ci è voluto perché arrivassero? |
Throughput | Ne stiamo elaborando abbastanza? |
Accuratezza | I valori sono corretti? |
Completezza | Manca qualcosa? |
Freshness | Quanto è vecchio ciò che vedono gli utenti? |
Disponibilità | I team riescono ad accedervi? |
Dove iniziano di solito i guasti silenziosi
La parte difficile non è definire questi pilastri, ma riconoscerne i pattern di guasto abbastanza presto da poter intervenire.
Tempestività e freshness vengono confuse continuamente. Un feed può arrivare esattamente in orario ma contenere record sorgente vecchi. Oppure può contenere dati attuali ma arrivare abbastanza tardi da mancare la scadenza del reporting. Sono incidenti diversi e richiedono responsabili diversi.
I segnali di anomalia sono un altro punto cieco comune. Una metrica può restare entro le soglie statiche pur discostandosi dal suo normale pattern giornaliero o settimanale. Ecco perché le baseline apprese di solito superano le soglie scritte a mano quando l'ambiente diventa complesso.
Poi c'è lo schema drift, che spesso ha origine al di fuori del team dati. Un team applicativo rilascia una modifica, l'ingestion dei dati grezzi “funziona” ancora e solo più tardi trasformazioni, modelli semantici o feature di ML iniziano a fallire o a produrre risultati senza senso.
Una pipeline in tempo reale in salute non equivale a un dataset in tempo reale in salute.
Per i team che desiderano un framework più ampio intorno a questi controlli, le dimensioni della qualità dei dati e come misurarle su larga scala sono un utile punto di riferimento. La lezione operativa principale è più semplice: misurate abbastanza dimensioni da intercettare i guasti silenziosi, ma non così tante che nessuno riesca più a capire quale alert sia importante.
Progettare alert e SLA che le persone usino davvero
La maggior parte dei sistemi di alerting fallisce per un motivo banale: generano troppo rumore, troppo poco contesto o entrambi. Gli ingegneri li silenziano, gli stakeholder smettono di fidarsene e gli unici alert che ricevono attenzione sono quelli che arrivano quando gli utenti hanno già notato il problema.
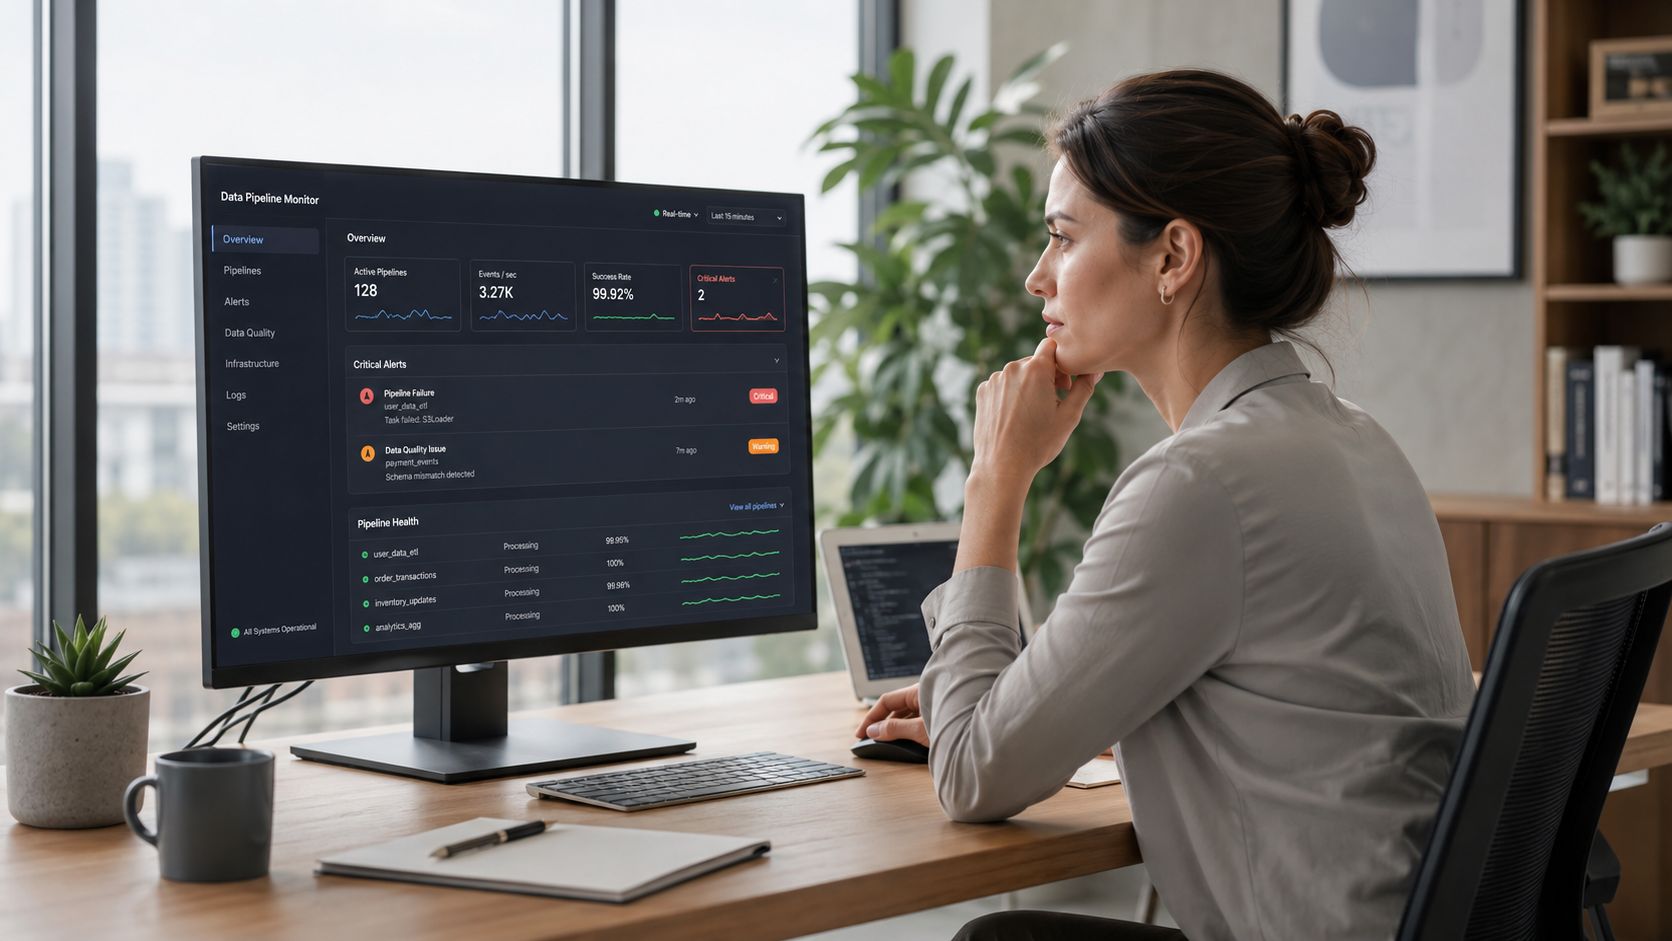
Le soglie statiche generano rumore
Una regola statica come “invia un alert se il volume cala del 10%” sembra sensata finché non la si applica a dati di produzione reali. I fine settimana sono diversi dai giorni feriali. La fine del mese si comporta diversamente dalla metà del mese. Lanci di prodotto, backfill e stagionalità dei clienti distorcono i pattern normali.
Ecco perché le soglie statiche invecchiano male. Non si adattano, quindi i team finiscono con uno di due esiti negativi:
Troppo sensibili, il che genera alert fatigue.
Troppo permissive, il che fa perdere gli incidenti che contano.
Funziona meglio ancorare l'alerting al comportamento atteso e alle scadenze di business. Se un feed dei ricavi deve arrivare prima che il reparto finance chiuda il reporting, l'alert dovrebbe fare riferimento a questa dipendenza. Se un flusso di monitoraggio dei pazienti deve restare aggiornato per i flussi di lavoro clinici, l'alert dovrebbe riflettere il rischio operativo di dati in ritardo, mancanti o sospetti.
Un buon alerting parte dall'impatto sul business
La sanità lo rende evidente. Solo negli Stati Uniti, si prevede che il numero di persone che utilizzano sistemi di Remote Patient Monitoring crescerà fino a 70,6 milioni entro la fine del 2025, il che aumenta la posta in gioco per dati sanitari live tempestivi e affidabili, secondo le statistiche di HealthArc sul monitoraggio remoto dei pazienti. In questo contesto, i falsi positivi sprecano l'attenzione clinica e gli alert mancati possono essere anche peggio.
La stessa logica di progettazione vale anche al di fuori della sanità. Uno SLA dovrebbe rispondere a tre domande:
Quale processo di business dipende da questo dataset?
Quando i dati devono essere corretti e disponibili?
Chi è responsabile della risposta quando non lo sono?
Non definite gli SLA in base a ciò che è facile da misurare. Definiteli in base al momento oltre il quale i dati errati diventano costosi.
Un buon alert indica il dataset coinvolto, cosa è cambiato, quando è iniziato, il comportamento atteso rispetto a quello effettivo, il probabile impatto a valle e chi deve intervenire per primo. Dovrebbe inoltre sopprimere i duplicati e raggruppare i guasti correlati. Nessuno ha bisogno di dieci alert per un'unica causa radice.
Integrare il monitoraggio nelle pipeline di dati
Se il monitoraggio vive in una dashboard separata che nessuno controlla, non è integrato: è decorazione. Il monitoraggio dei dati in tempo reale diventa operativo quando si colloca lungo il percorso che i dati già compiono.
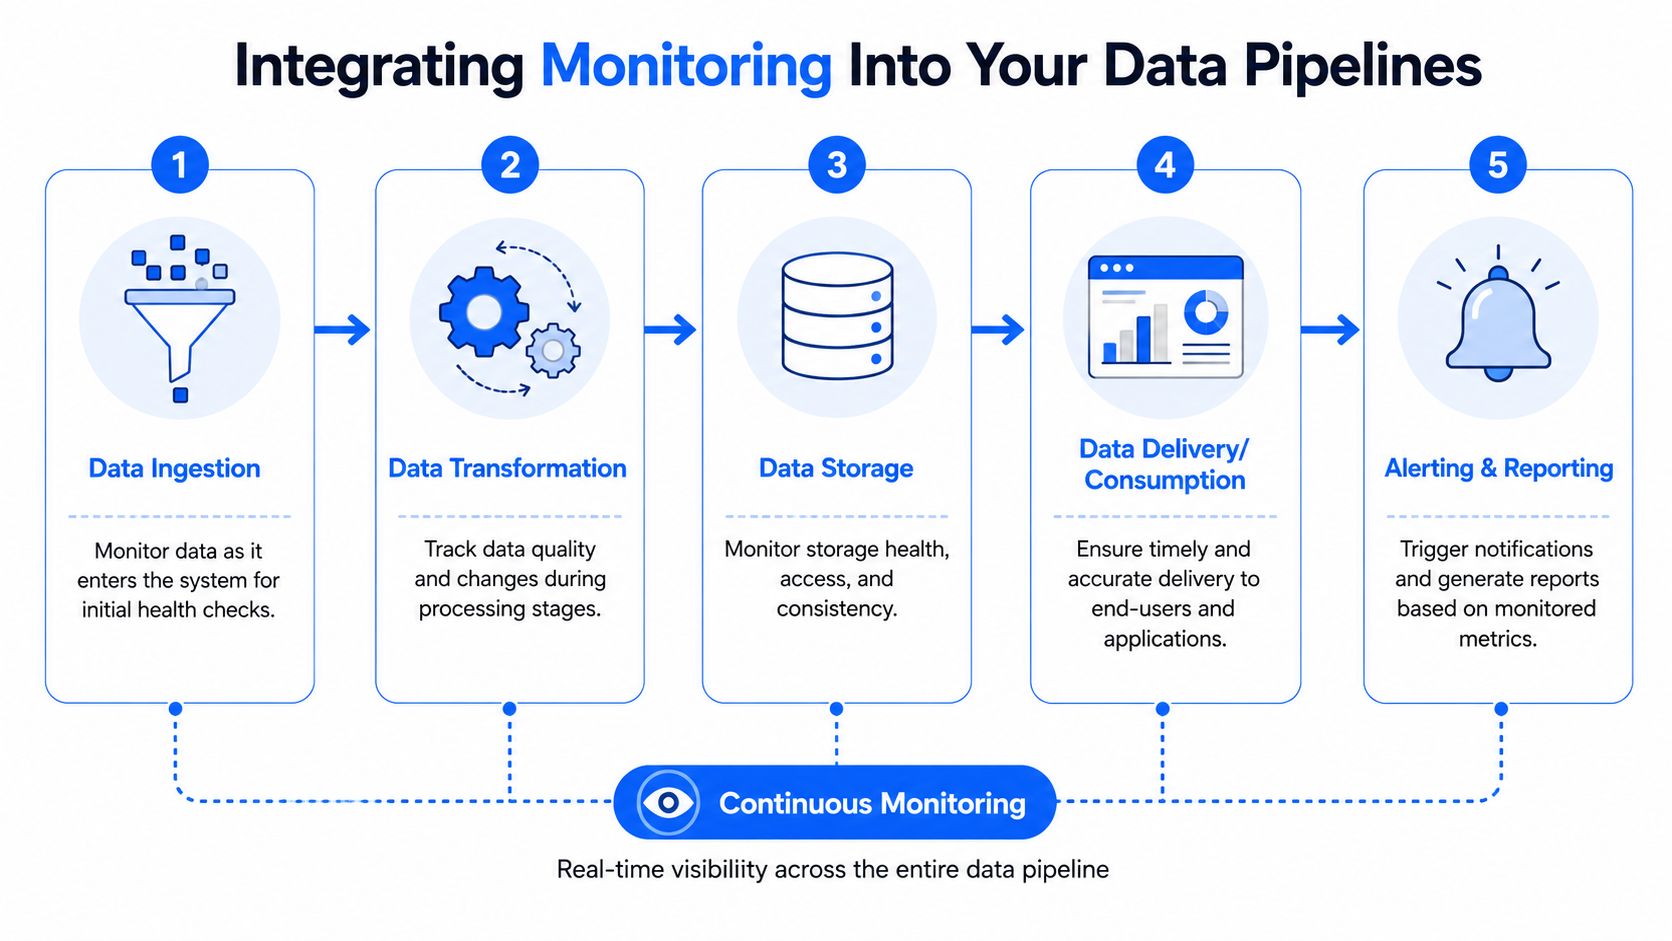
Posizionate i controlli dove i dati cambiano stato
In uno stack moderno ci sono quattro punti in cui i dati cambiano significato. Sono questi i punti che vale la pena monitorare.
In fase di ingestion si controllano i pattern di arrivo, la continuità delle sorgenti, i picchi di duplicati e le modifiche dello schema dei dati grezzi.
Dopo la trasformazione si convalidano regole di business, comportamento dei valori null, join, presupposti referenziali e aggregati anomali.
Nei livelli di archiviazione e serving si verificano freshness, tempistiche di pubblicazione e se tabelle o viste riflettono il ciclo di aggiornamento atteso.
Prima del consumo si filtrano gli output ad alto rischio che alimentano dashboard di BI, API, job di reverse ETL o feature dei modelli.
Questa struttura è importante perché incidenti diversi appartengono a responsabili diversi. Un evento grezzo malformato di solito indica un problema a monte. Una trasformazione difettosa è di competenza del team dati. Un estratto obsoleto di una dashboard può riguardare la BI o l'infrastruttura di serving. Un buon monitoraggio accorcia i passaggi di consegna.
Rendete il monitoraggio parte dell'orchestrazione
Il pattern più pulito è rendere il monitoraggio eseguibile, non solo osservativo. Airflow, Dagster, dbt Cloud o altri orchestratori dovrebbero avviare i controlli come parte dell'esecuzione, non dopo che qualcuno si ricorda di dare un'occhiata a una console.
Un pattern pratico si presenta così:
Acquisite i dati e registrate i metadati di arrivo.
Eseguite controlli strutturali prima che la trasformazione prosegua.
Eseguite i job di trasformazione con asserzioni di qualità integrate.
Calcolate le metriche di monitoraggio all'interno del data warehouse o del data lake.
Bloccate, avvisate o pubblicate in base alla gravità e al rischio a valle.
In questo modo si crea un punto di controllo prima che i dati errati raggiungano i livelli di reporting. Migliora anche la gestione degli incidenti, perché la fase che ha fallito è già nota.
Ciò che non funziona è affidarsi interamente alla telemetria generica dei sistemi. CPU, memoria, stato dei pod e durata dei task possono dirvi se l'infrastruttura è sotto stress. Non possono dirvi se un file sorgente in ritardo ha reso obsoleta la dashboard del management o se una modifica del tipo di un campo ha compromesso una feature di un modello senza preavviso. Il segnale di monitoraggio deve accompagnare il ciclo di vita dei dati stesso.
Come scegliere la soluzione di monitoraggio in tempo reale
Una pipeline può essere verde su ogni dashboard dell'infrastruttura e continuare comunque a distribuire dati errati per ore. È questo il problema della scelta. Molti strumenti di monitoraggio sono bravissimi a dirvi se i job sono stati eseguiti, se i container sono rimasti attivi o se le query sono terminate. Meno strumenti sanno dirvi se i dati sono arrivati in ritardo, hanno cambiato forma o si sono allontanati dal comportamento normale abbastanza da compromettere una decisione a valle.
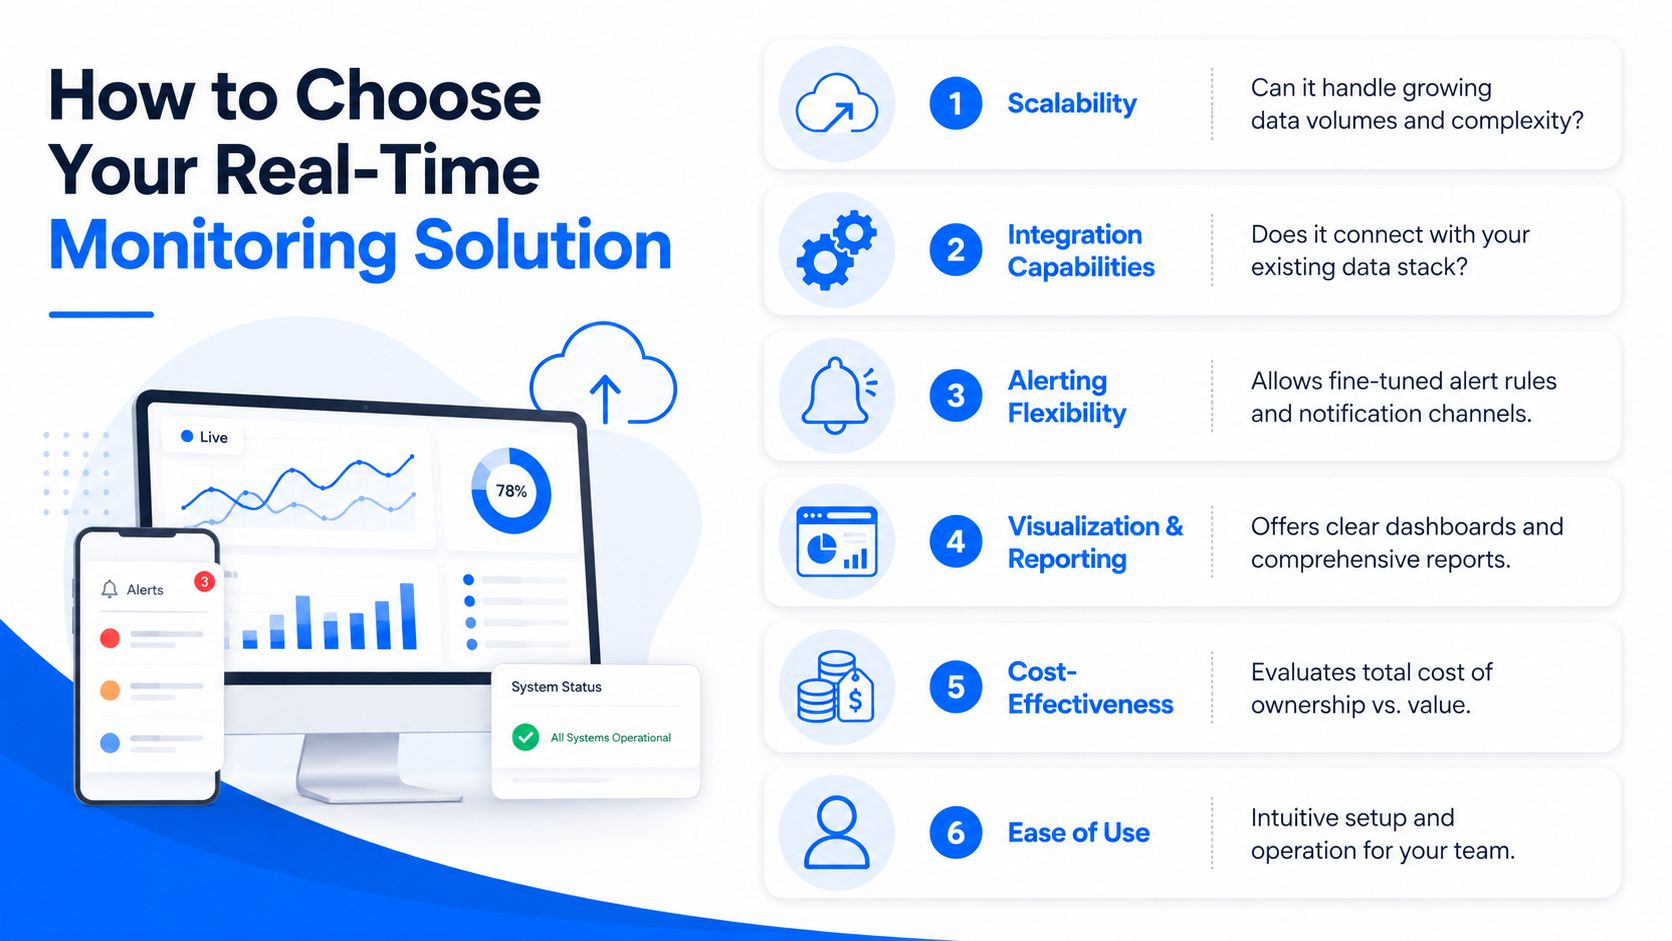
Domande che separano le promesse dalle capacità reali
Partite dalle modalità di guasto che dovete intercettare. Se il rischio principale sono gli eventi che arrivano in ritardo, la latenza di rilevamento e i controlli di freshness contano più di un grafico delle anomalie ben curato. Se il vostro team supporta modelli rivolti ai clienti o API operative, lo schema drift e le variazioni di distribuzione meritano di solito la priorità in termini di budget e di impegno di engineering.
Area di valutazione | Cosa chiedere |
|---|---|
Comportamento in tempo reale | Quale latenza di rilevamento e di alerting riesce a sostenere nel nostro ambiente, con carico normale e in condizioni di incidente? |
Copertura | Monitora freshness, qualità dei dati, modifiche dello schema e drift delle distribuzioni, o principalmente la telemetria dei sistemi? |
Integrazione | Si adatta al nostro data warehouse, data lake, livello di streaming, orchestratore e stack di alerting senza un pesante lavoro di engineering personalizzato? |
Azionabilità | Può instradare gli alert in base al responsabile del dataset, alle dipendenze e alla priorità di business? |
Sicurezza | Dove vengono calcolate le metriche, quali dati escono dal nostro ambiente e quale modello di accesso richiede lo strumento? |
Operatività | Il team dati può gestirlo come parte della normale responsabilità sulle pipeline, o diventerà un'altra piattaforma da mantenere? |
Chiedete a ogni fornitore di dimostrare il rilevamento su un guasto reale, non su una slide. Di solito voglio vedere tre test: un feed in ritardo, una modifica del tipo di una colonna e un problema di qualità realistico, come picchi di valori null o record duplicati. Questi casi rivelano il divario tra monitoraggio dei sistemi e monitoraggio dei dati più rapidamente di qualsiasi checklist di funzionalità.
Le dichiarazioni sulla latenza vanno contestualizzate. Come osservato da Symestic sul monitoraggio dei dati in tempo reale nella produzione industriale, alcuni ambienti misurano il successo in millisecondi perché il processo monitorato lo richiede. I team di analytics lavorano spesso con finestre più ampie, ma vale la stessa regola. Definite il ritardo massimo che il vostro business può tollerare per ogni dataset critico, quindi verificate lo strumento rispetto a quell'obiettivo in condizioni simili a quelle di produzione.
Un deployment rispettoso della privacy dovrebbe orientare la decisione
L'architettura conta quanto la copertura funzionale. Uno strumento che rileva il drift con precisione ma richiede un'ampia esportazione dei dati verso l'ambiente del fornitore può causare ritardi nelle approvazioni, controlli aggiuntivi e un secondo percorso di spostamento dei dati che il vostro team dovrà proteggere e mantenere.
Il pattern più solido è eseguire il monitoraggio dove i dati risiedono già. Calcolo delle metriche, valutazione delle regole e apprendimento delle baseline avvengono nel data warehouse, nel lakehouse o in un runtime privato. Questo riduce l'esposizione, mantiene i record sensibili al loro posto e di solito semplifica le revisioni di governance, perché il livello di monitoraggio non copia i dati di produzione in un ulteriore archivio SaaS.
Questo compromesso viene trascurato in molte guide all'acquisto. Confrontano dashboard, canali di alert e modelli di anomalia, ma ignorano il costo operativo di spostare i dati all'esterno solo per osservarli. Per i team regolamentati, o per qualsiasi team che voglia ridurre il raggio d'impatto, il monitoraggio in-database è spesso il design più pulito.
digna è un esempio di questo approccio. Copre anomaly detection, controlli di tempestività, schema tracking e validazione a livello di record, eseguendo l'analisi all'interno di ambienti controllati dal cliente anziché esportare i dati di produzione.
La scelta tra sviluppare internamente o acquistare segue la stessa logica. Sviluppare in proprio offre il pieno controllo, ma significa anche farsi carico di definizioni delle metriche, logica di drift, instradamento degli alert, archiviazione storica, flussi di triage e controlli di accesso. Acquistare aiuta solo se il prodotto elimina questo onere di engineering e si adatta comunque al vostro modello di sicurezza e alla vostra architettura dati.
Best practice per scalabilità e governance
Il rollout tecnico è la parte facile rispetto a mantenere utile il monitoraggio dopo la prima ondata di configurazione. I team perdono slancio quando le responsabilità sono vaghe, gli alert si accumulano e nessuno chiude il cerchio con i produttori a monte.
Abitudini operative che mantengono utile il monitoraggio
Alcune abitudini fanno una differenza sproporzionata:
Assegnate chiaramente i data owner. Ogni dataset critico ha bisogno di un responsabile nominato per le decisioni sulla qualità e di un percorso di escalation per gli incidenti.
Distinguete la gravità dal rumore. Non tutte le anomalie meritano una chiamata di reperibilità. Collegate la gravità all'impatto sul business e al raggio d'impatto a valle.
Analizzate gli incidenti ricorrenti. Se lo stesso alert scatta ripetutamente, correggete la sorgente o regolate il controllo. Non abituatevi al problema.
Versionate le vostre aspettative. Schemi, pianificazioni e regole di business cambiano. La governance ha bisogno di un processo di gestione delle modifiche, non di conoscenza tribale.
Mantenete le evidenze vicino ai dati. Cronologia delle metriche, risultati delle validazioni e contesto degli incidenti dovrebbero essere facili da consultare dove gli ingegneri lavorano già.
L'obiettivo più ampio è culturale. Il monitoraggio dovrebbe portare il team dal debugging reattivo a un'affidabilità gestita. Questo accade solo quando i controlli sono integrati nella pipeline, i responsabili sanno di cosa rispondono e l'organizzazione tratta la qualità dei dati come una disciplina operativa anziché come un'attività di pulizia.
Il monitoraggio dei dati in tempo reale funziona quando colma il divario tra la salute dei sistemi e la veridicità dei dati. È questo lo standard verso cui vale la pena lavorare.
Se il vostro team desidera un monitoraggio dei dati in tempo reale che copra tempestività, anomalie, modifiche dello schema e validazione a livello di record senza esportare i dati di produzione, vale la pena valutare digna. Esegue l'analisi all'interno di ambienti controllati dal cliente, il che è ideale per i team che necessitano di un'observability moderna con un'architettura rispettosa della privacy.
Per un'alternativa basata su baseline apprese alle soglie di volume statiche, eseguita all'interno di ambienti controllati dal cliente, consultate l'anomaly detection con digna Data Anomalies.
Domande frequenti
Che cos'è il monitoraggio dei dati in tempo reale?
Il monitoraggio dei dati in tempo reale è un livello di controllo che attraversa ingestion, trasformazione, archiviazione e consegna e verifica i dati stessi, non solo i sistemi che li circondano. Il suo compito è intercettare dati in ritardo, modifiche silenziose dello schema, drift nei campi chiave e record incompleti prima che una dashboard obsoleta arrivi a una riunione del management.
Qual è la differenza tra streaming e micro-batching?
Lo streaming elabora gli eventi man mano che arrivano, come un notiziario in diretta, ed è adatto al rilevamento delle frodi o agli alert industriali, al prezzo di una maggiore complessità operativa. Il micro-batching raccoglie gli eventi in un breve intervallo, come i bollettini a orari prestabiliti, ed è più semplice ed economico per le dashboard. Il vero tempo reale significa una latenza inferiore a un secondo.
Quali metriche dovrebbe monitorare il monitoraggio dei dati in tempo reale?
L'articolo definisce sei pilastri: latenza, throughput, accuratezza, completezza, freshness e disponibilità. Ciascuno risponde a una domanda diversa, da quanto tempo hanno impiegato i dati ad arrivare a se i team riescono ad accedervi. La freshness, cioè quanto sono vecchi i dati quando qualcuno li utilizza, è ciò che gli utenti di business intendono di solito per dati aggiornati.
Perché le soglie di alert statiche causano alert fatigue?
Una regola come inviare un alert quando il volume cala del 10% ignora che fine settimana, chiusure di fine mese, lanci di prodotto e backfill modificano tutti i pattern normali. Le soglie statiche finiscono per essere troppo sensibili, causando affaticamento, o troppo permissive, perdendo incidenti reali. Funzionano meglio le baseline apprese e gli alert legati alle scadenze di business, come una chiusura contabile.
Dove dovrebbero essere eseguiti i controlli di qualità dei dati in una pipeline?
Posizionate i controlli nei quattro punti in cui i dati cambiano stato: ingestion, dopo la trasformazione, nei livelli di archiviazione e serving e prima del consumo da parte di dashboard, API, reverse ETL o feature dei modelli. Idealmente, orchestratori come Airflow, Dagster o dbt Cloud li avviano durante l'esecuzione, per poi bloccare, avvisare o pubblicare in base alla gravità.


