Perché i job Databricks diventano imprevedibili e come i team rilevano per tempo l'instabilità
|
5
min di lettura
Gli ambienti Databricks sono progettati per l'elasticità. I cluster scalano, i carichi di lavoro evolvono e i volumi di dati crescono di continuo. Questa flessibilità è potente, ma introduce anche una sfida che molte aziende prima o poi si trovano ad affrontare:
job che un tempo si comportavano in modo prevedibile iniziano a oscillare in termini di runtime, utilizzo di DBU e costi.
Le pipeline continuano ad andare a buon fine. Le dashboard continuano ad aggiornarsi. Niente sembra “rotto”. Eppure la prevedibilità operativa si erode.
Capire perché succede e come rilevarlo per tempo è fondamentale per i team che utilizzano Databricks come piattaforma di dati e IA in produzione.
In Databricks l'instabilità riguarda il comportamento, non i fallimenti
Nei sistemi tradizionali, instabilità significava spesso sovraccarico del sistema o limiti dell'hardware. L'instabilità in Databricks è diversa.
Poiché i cluster scalano automaticamente e i carichi di lavoro si distribuiscono in modo dinamico, l'instabilità si manifesta come:
Aumento del consumo di DBU per gli stessi job
Varianza crescente della durata di esecuzione
Prestazioni imprevedibili dei task
Eventi di ridimensionamento dei cluster più frequenti
I job possono completarsi con successo, eppure il loro comportamento cambia nel tempo. Questi cambiamenti sono spesso invisibili nelle dashboard che si concentrano solo su successo/fallimento.
Che cosa rende imprevedibili i job Databricks?
1. La crescita dei dati modifica i piani di esecuzione
Man mano che i volumi di dati crescono:
Gli shuffle aumentano
I join diventano più pesanti
Le strategie di partizionamento si degradano
L'efficacia del caching cambia
Anche senza modifiche al codice, i piani di esecuzione di Spark cambiano. Ne derivano un maggiore utilizzo di DBU e runtime più lunghi.
Il job continua a “funzionare”, ma consuma più risorse di calcolo di prima.
2. Deriva della logica in notebook e pipeline
I carichi di lavoro Databricks evolvono rapidamente.
I team aggiungono:
Join aggiuntivi
Ulteriori aggregazioni
Nuovi calcoli di feature ML
Filtri più ampi
Ogni modifica aggiunge overhead. Prese singolarmente, le modifiche sembrano minime. Nell'arco di mesi, alterano profondamente il comportamento del carico di lavoro.
3. L'auto-scaling maschera i problemi di risorse
L'auto-scaling è al tempo stesso un punto di forza e un punto cieco.
Quando i carichi di lavoro richiedono più risorse di calcolo:
I cluster si espandono automaticamente
I job terminano con successo
I costi aumentano silenziosamente
Invece di fallire, il sistema assorbe le inefficienze, nascondendo le regressioni di prestazioni dietro un'infrastruttura elastica.
Il primo segnale si presenta spesso come un aumento del consumo di DBU, non come un errore.
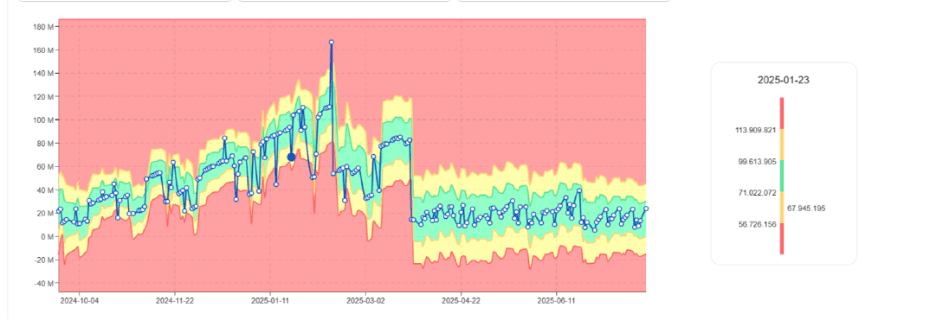
Andamento dell'utilizzo di DBU in graduale aumento per lo stesso job
4. Skew e squilibrio degli shuffle
Il data skew fa sì che alcuni task elaborino quantità di dati sproporzionate.
In Databricks si manifesta come:
Task di lunga durata
Straggler
Maggiore varianza nella durata degli stage
Poiché Spark distribuisce i task in modo dinamico, lo skew produce runtime instabili e un consumo di DBU imprevedibile.
5. Comportamento dei retry e fallimenti nascosti
I retry dei task sono comuni nei sistemi distribuiti.
Problemi transitori, pressione sulla memoria o perdita di executor possono innescare retry che:
Aumentano il runtime
Gonfiano il consumo di DBU
Aggiungono volatilità
I job vanno a buon fine, ma l'instabilità aumenta.
6. Stagionalità dei carichi di lavoro
I job Databricks riflettono spesso i cicli di business:
Elaborazioni di fine mese
Picchi di reporting settimanali
Pianificazioni di riaddestramento dei modelli
Senza modellare questi pattern, i team o ignorano le anomalie o vengono sommersi da falsi allarmi.
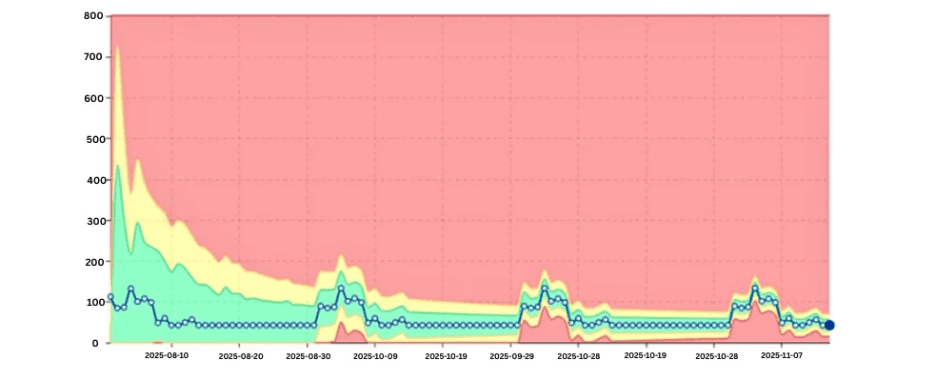
Pattern stagionale di DBU con picchi attesi
Perché il monitoraggio tradizionale non coglie i segnali precoci
La maggior parte dei team si affida a:
Metriche di successo/fallimento dei job
Dashboard dei costi
Viste sull'utilizzo dei cluster
Questi strumenti mostrano i risultati, non i cambiamenti di comportamento.
Non rivelano:
Job che diventano più costosi nel tempo
Variabilità crescente del runtime
Cambiamenti strutturali nell'esecuzione dei carichi di lavoro
L'instabilità inizia molto prima che vengano superate le soglie.
Il passaggio al monitoraggio comportamentale
Rilevare per tempo l'instabilità richiede di analizzare come si comportano i carichi di lavoro nel tempo, non solo se vanno a buon fine.
I segnali chiave includono:
Trend di utilizzo delle DBU
Evoluzione del runtime
Varianza della durata dei task
Frequenza di scaling dei cluster
Trasformando queste metriche in serie temporali, i team possono identificare deriva, volatilità e cambiamenti strutturali.
Rilevare per tempo l'instabilità
Apprendere il comportamento normale dei job
Invece di soglie fisse sulle DBU, gli approcci moderni apprendono:
L'intervallo tipico di DBU per ogni job
I pattern di runtime attesi
Il comportamento normale dei cluster
Man mano che i carichi di lavoro si stabilizzano, gli intervalli di comportamento accettabile si restringono.
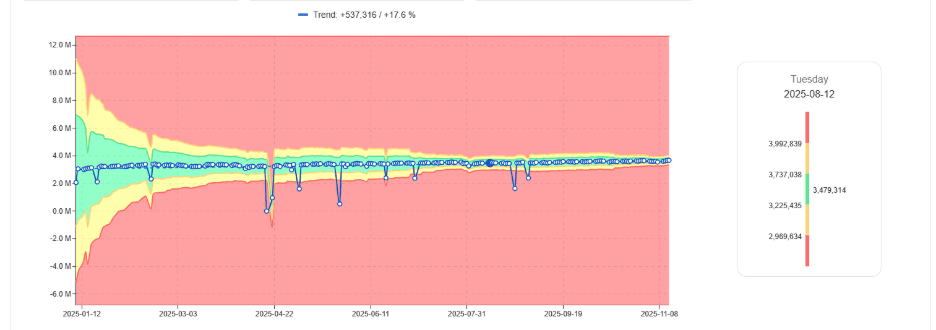
Banda normale di DBU appresa che si restringe nel tempo
Individuare la deriva graduale delle DBU
Uno dei maggiori fattori di costo è la crescita lenta delle DBU.
Confrontando l'utilizzo attuale con le baseline storiche, i team possono individuare quali job consumano progressivamente più risorse di calcolo.
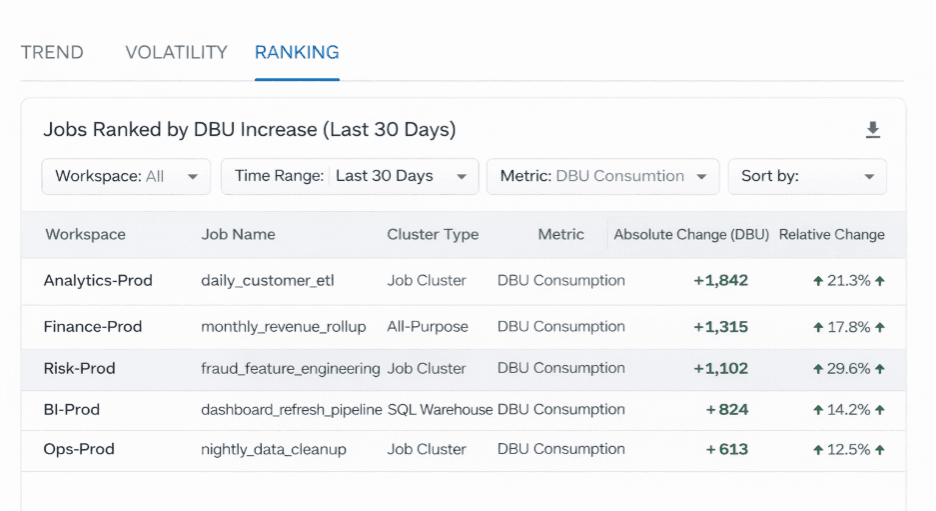
Job ordinati in base all'aumento mese su mese delle DBU
Misurare la volatilità del runtime
Anche se il runtime medio resta costante, una varianza elevata segnala instabilità.
I job volatili sono più difficili da pianificare e hanno maggiori probabilità di causare ritardi a valle.
Tenere conto della stagionalità
I sistemi comportamentali distinguono i picchi ciclici attesi dalle anomalie reali, riducendo il rumore degli alert.
Il ruolo di digna
digna analizza nel tempo le metriche dei carichi di lavoro Databricks, come consumo di DBU, runtime e comportamento dei volumi. Invece di limiti statici, utilizza l'IA per apprendere i pattern normali e rilevare per tempo le deviazioni non plausibili, che si tratti di picchi improvvisi o di una deriva graduale.
Questo consente ai team di far emergere i problemi prima che compaiano nei report sui costi o come violazioni degli SLA.
Per saperne di più su questo approccio basato sulle anomalie:
digna Data Anomalies | Guardate la demo
Perché il rilevamento precoce è importante
Quando l'instabilità viene rilevata per tempo, le organizzazioni possono:
Ottimizzare le query prima che i costi aumentino
Stabilizzare le pipeline prima che gli SLA ne risentano
Ridurre le emergenze continue
Migliorare la prevedibilità per i team FinOps
Considerazione finale
I job Databricks raramente falliscono del tutto. Diventano imprevedibili.
Questa imprevedibilità è visibile nel comportamento mutevole delle DBU, nella variabilità del runtime e nell'evoluzione dei pattern di esecuzione: segnali che il monitoraggio statico non riesce a cogliere.
I team che adottano il monitoraggio comportamentale ottengono una visibilità precoce sull'instabilità e mantengono il controllo mentre i loro ambienti Databricks crescono.
Scoprite come digna lo fa nella pratica: qualità dei dati per Databricks.
Domande frequenti
Perché i job Databricks diventano imprevedibili senza fallire?
Perché l'auto-scaling e la distribuzione dinamica dei task assorbono le inefficienze invece di fallire. I job continuano ad andare a buon fine e le dashboard ad aggiornarsi, ma l'instabilità si manifesta come aumento del consumo di DBU per gli stessi job, varianza crescente del runtime, prestazioni imprevedibili dei task ed eventi di ridimensionamento dei cluster più frequenti, nessuno dei quali viene rivelato dal monitoraggio di successo/fallimento.
Che cosa fa aumentare il consumo di DBU per lo stesso job Databricks?
La crescita dei dati è una causa comune: con l'aumento dei volumi crescono gli shuffle, i join diventano più pesanti, le strategie di partizionamento si degradano e l'efficacia del caching cambia, quindi i piani di esecuzione di Spark si modificano anche senza cambiamenti al codice. A questo si aggiunge la deriva della logica, perché i team continuano ad aggiungere join, aggregazioni, calcoli di feature ML e filtri più ampi.
In che modo l'auto-scaling nasconde i problemi di prestazioni in Databricks?
Quando un carico di lavoro richiede più risorse di calcolo, i cluster si espandono automaticamente e il job termina comunque con successo, quindi la regressione resta nascosta dietro un'infrastruttura elastica. I costi aumentano silenziosamente invece di produrre un errore. L'articolo osserva che il primo segnale è spesso un trend crescente del consumo di DBU per lo stesso job, non un fallimento.
Quali segnali aiutano a rilevare per tempo l'instabilità dei job Databricks?
Il monitoraggio comportamentale traccia quattro segnali chiave come serie temporali: trend di utilizzo delle DBU, evoluzione del runtime, varianza della durata dei task e frequenza di scaling dei cluster. Apprendere un intervallo tipico di DBU e un runtime atteso per ogni job, invece di fissare soglie statiche sulle DBU, consente ai team di individuare deriva graduale, volatilità e cambiamenti strutturali prima che le soglie vengano superate.
Come può il monitoraggio di Databricks evitare falsi allarmi dovuti ai picchi di fine mese?
Modellando la stagionalità. I job Databricks seguono spesso cicli di business come le elaborazioni di fine mese, i picchi di reporting settimanali e le pianificazioni di riaddestramento dei modelli. I sistemi comportamentali apprendono questi picchi ciclici attesi e li distinguono dalle anomalie reali; senza questo, i team o ignorano le anomalie o vengono sommersi da falsi allarmi.


